HTTP QUERY method ใหม่ใน RFC 10008 ปิดช่องว่างระหว่าง GET กับ POST ที่ค้างมา 30 ปี
HTTP QUERY คือ method ใหม่ที่เพิ่งเป็นมาตรฐานใน RFC 10008 เมื่อ June 2026 · ใช้ส่ง query ยาว ๆ ไว้ใน body ได้เหมือน POST แต่ยัง cache และ retry ได้ปลอดภัยเหมือน GET จึงช่วยแก้ปัญหาที่นักพัฒนาเว็บเจอมานานว่าจะวาง query ก้อนใหญ่ไว้ตรงไหนดี

ในสถาปัตยกรรมเว็บ การสื่อสารระหว่าง Client กับ Server จะต้องระบุ HTTP Method เพื่อบอกเจตนาของคำขอ โดย 2 Method ที่ใช้งานแพร่หลายที่สุดคือ GET (การดึงข้อมูลมาอ่าน) และ POST (การส่งข้อมูลไปประมวลผล) ทว่าปัญหาจะเกิดขึ้นทันทีเมื่อเราต้องการส่งคำค้นหาหรือ Query ที่มีความซับซ้อนสูง เช่น GraphQL Query ขนาดยาว หรือเงื่อนไขการค้นหาที่มีฟิลเตอร์ซ้อนกันหลายชั้น
หากเลือกใช้ GET เราจำเป็นต้องนำพารามิเตอร์ทั้งหมดไปต่อท้าย URL (Query String) ซึ่งหากข้อมูลยาวเกินไปจะเสี่ยงต่อการถูกจำกัดความยาว ข้อมูลสำคัญอาจหลุดไปบันทึกใน Access Log และ URL ที่เปลี่ยนไปตามตัวแปรยังทำให้ระบบ Caching ทำงานได้ไม่เต็มประสิทธิภาพ แต่หากเลี่ยงไปใช้ POST เพื่อแนบข้อมูลใน Request Body ตัว Server และระบบเครือข่ายตัวกลาง (Proxy/CDN) จะถือว่าคำขอนั้นอาจมีการแก้ไขข้อมูล ทำให้ไม่สามารถทำ Caching และไม่สามารถ Retry คำขอซ้ำได้อย่างปลอดภัยเมื่อเกิดปัญหาเครือข่าย
ปัญหานี้เป็นช่องว่างที่นักพัฒนาเว็บเผชิญมานานหลายสิบปี จนกระทั่ง IETF ได้ประกาศรับรองมาตรฐาน HTTP QUERY ภายใต้ RFC 10008 ในเดือนมิถุนายน 2026 โดย Method ใหม่นี้ผสานจุดเด่นของทั้งสองฝั่งเข้าด้วยกัน คือสามารถแนบเนื้อหาค้นหาไว้ใน Request Body ได้เหมือน POST ในขณะที่ยังคงสถานะความปลอดภัย (Safe) และคุณสมบัติผลลัพธ์คงที่ (Idempotent) เหมือน GET ทำให้ระบบเครือข่ายสามารถ Cache และ Retry ได้อย่างมั่นใจ
ทำไม GET และ POST ถึงตอบโจทย์ได้ไม่สมบูรณ์
ข้อจำกัดไม่ได้เกิดจากข้อบกพร่องของ GET หรือ POST แต่เกิดจากการที่ทั้งคู่ถูกสร้างขึ้นมาเพื่อวัตถุประสงค์คนละด้าน
ตามมาตรฐาน HTTP ข้อกำหนดของ GET คือเป็น Safe Method (อ่านอย่างเดียว ไม่แก้ไขข้อมูลบนเซิร์ฟเวอร์) และเป็น Idempotent (การส่งซ้ำหลายครั้งต้องได้ผลลัพธ์เหมือนเดิม) คุณสมบัติสองข้อนี้ทำให้ CDN หรือ Caching Proxy สามารถบันทึกผลลัพธ์เก็บไว้ และระบบสามารถส่งคำขอซ้ำอัตโนมัติเมื่อสัญญาณสะดุด แต่ข้อจำกัดของ GET คือไม่มีโครงสร้าง Request Body ตามมาตรฐาน การส่งข้อมูลทั้งหมดจึงต้องพึ่งพา URL เพียงอย่างเดียว
ในทางกลับกัน POST อนุญาตให้แนบข้อมูลขนาดใหญ่ใน Request Body ได้ไม่จำกัด แต่โดยนิยามแล้ว POST ถือเป็น Unsafe และ Non-idempotent ซึ่งระบบจะตีความว่าอาจเป็นการสร้างหรือแก้ไขข้อมูล เช่น การตัดเงินหรือการส่งคำสั่งซื้อ ระบบเครือข่ายจึงไม่สามารถบันทึก Cache และไม่กล้าส่งคำขอซ้ำ เพราะอาจทำให้เกิดการประมวลผลซ้ำซ้อน การใช้ POST สำหรับงานค้นหาข้อมูลจึงต้องยอมแลกด้วยการสูญเสียประสิทธิภาพด้าน Caching ทั้งหมด
HTTP QUERY จุดสมดุลระหว่างสองขั้ว
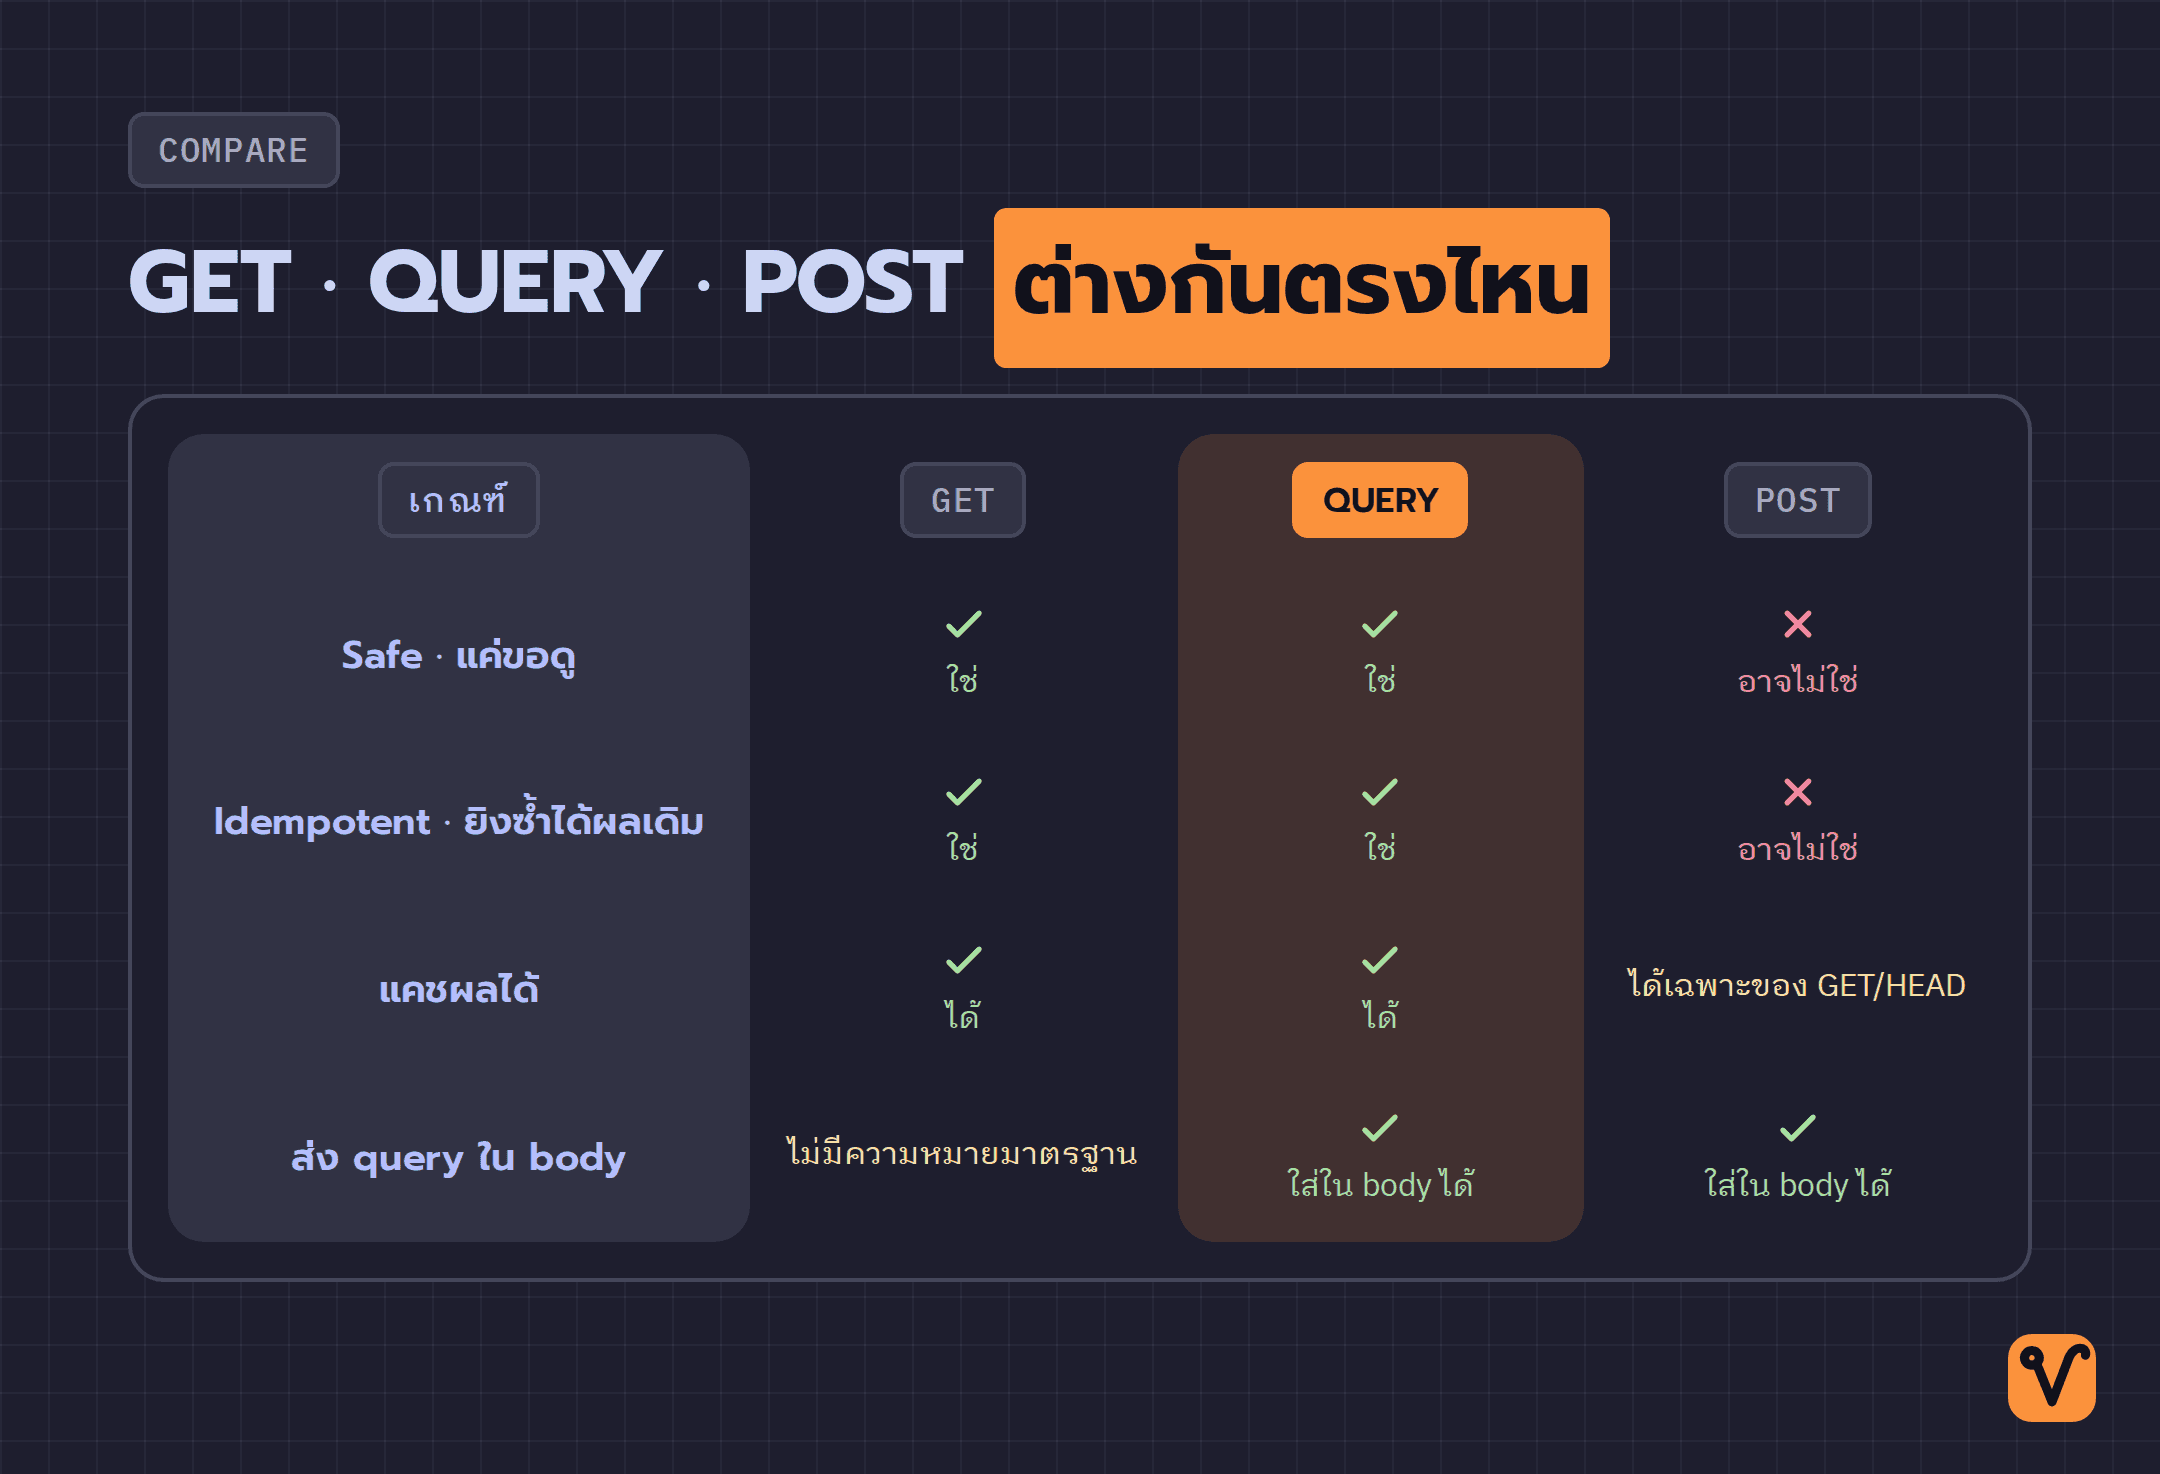
QUERY ออกแบบมาเพื่อปิดช่องว่างนี้โดยเฉพาะ โดยเปิดให้ส่งเนื้อหาคำค้นหาผ่าน Request Body ได้อย่างอิสระ ขณะเดียวกันก็ประกาศสถานะอย่างเป็นทางการว่าเป็น Safe และ Idempotent เมื่อระบบเครือข่ายทราบว่าคำขอนี้ไม่มีการเปลี่ยนแปลงข้อมูล จึงสามารถเปิดใช้งาน Caching และ Retry ได้ตามปกติ แม้ว่า Query จะอยู่ใน Body ก็ตาม
| คุณสมบัติ | GET | QUERY | POST |
|---|---|---|---|
| Safe (อ่านอย่างเดียว ไม่แก้ไขข้อมูล) | ใช่ | ใช่ | ไม่ใช่ (โดยนิยาม) |
| Idempotent (ส่งซ้ำได้ผลลัพธ์คงเดิม) | ใช่ | ใช่ | ไม่ใช่ (โดยนิยาม) |
| รองรับการทำ Cache ตามมาตรฐาน | ได้ | ได้ | ได้เฉพาะบางกรณี |
| รองรับการส่ง Query ใน Request Body | ไม่มีมาตรฐานรองรับ | รองรับเต็มรูปแบบ | รองรับเต็มรูปแบบ |
หลักการเลือกใช้งานสามารถสรุปได้ง่ายๆ หากเป็นคำค้นหาสั้นๆ ทั่วไป การใช้ GET ต่อท้าย URL ยังคงสะดวกที่สุด หากเป็นการส่งข้อมูลเพื่อบันทึกหรือปรับปรุงฐานข้อมูล ให้ใช้ POST แต่หากเป็นงานค้นหาข้อมูลที่มีเงื่อนไขซับซ้อนและต้องการประสิทธิภาพการทำ Cache ควบคู่กัน นี่คือหน้าที่ของ QUERY โดยตรง
รูปแบบการทำงานจริงของ QUERY
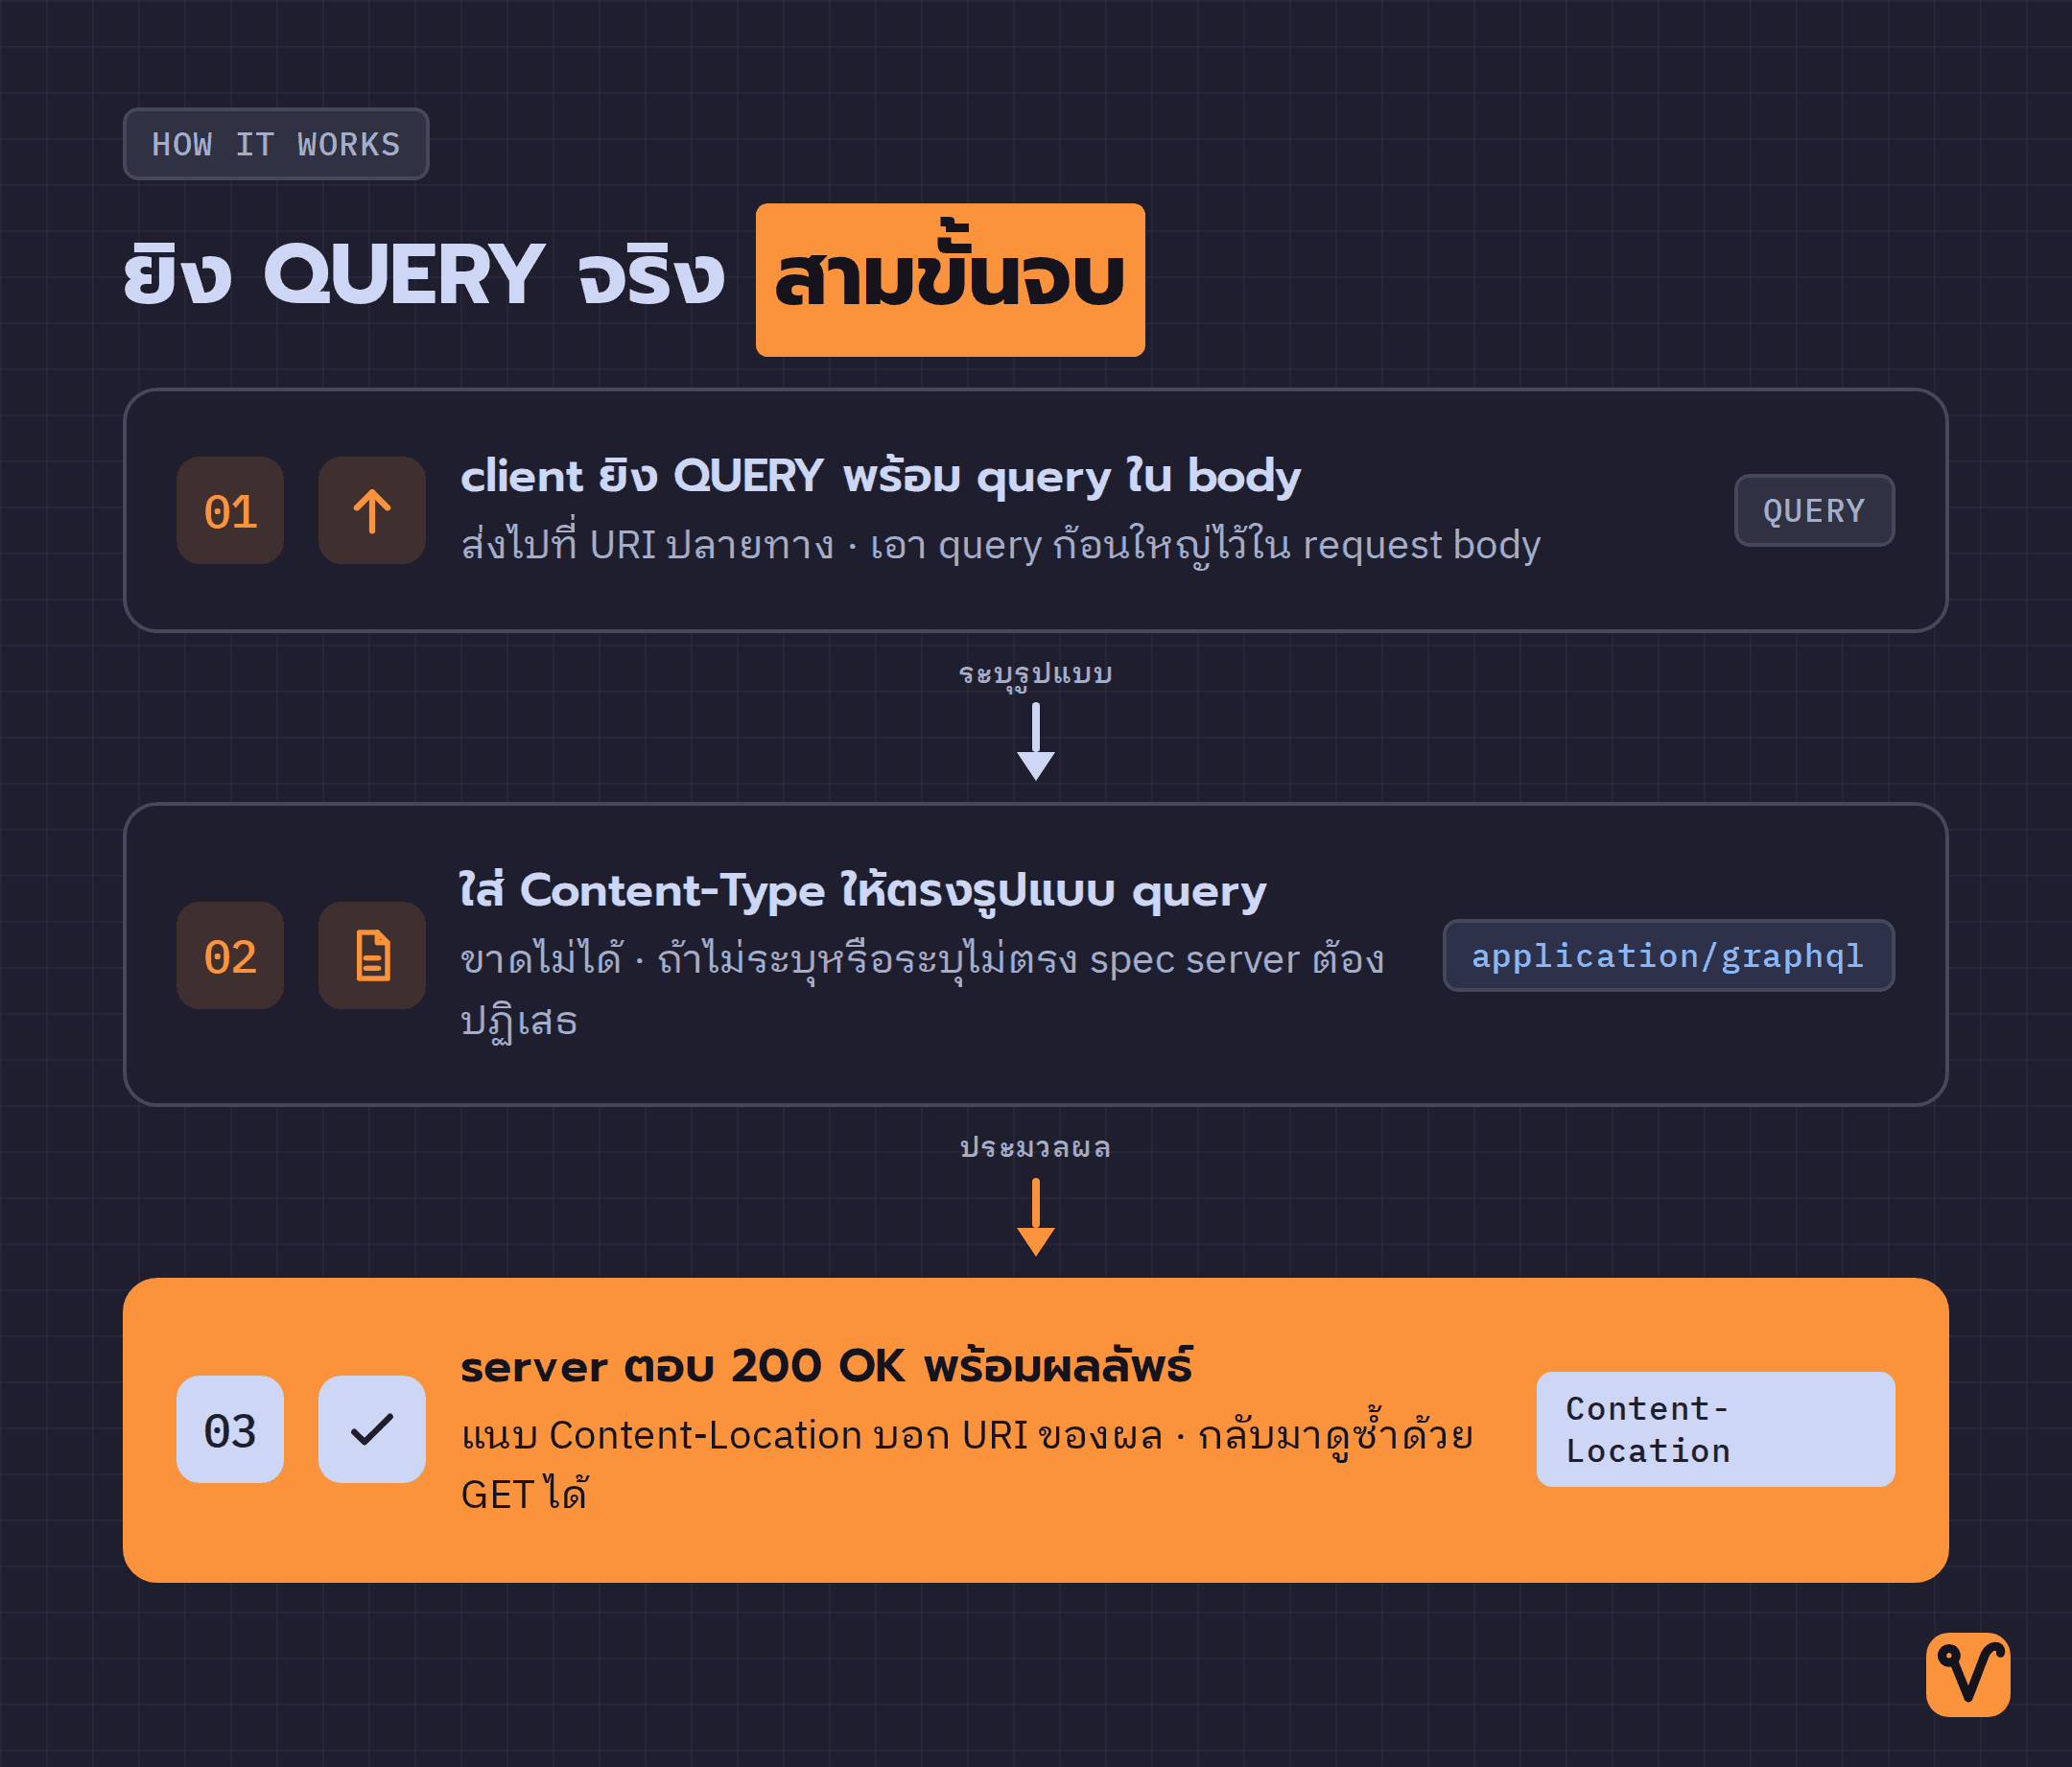
การทำงานของ QUERY มีโครงสร้างที่เข้าใจง่ายและสอดคล้องกับมาตรฐานเดิม
- Client ส่งคำขอด้วย Method
QUERYไปยัง URI ปลายทาง พร้อมแนบคำค้นหาไว้ใน Request Body - ระบุ
Content-Typeให้ตรงกับรูปแบบของ Query เช่นapplication/graphqlสำหรับภาษา GraphQL หรือapplication/sqlสำหรับคำสั่ง SQL - Server ประมวลผลคำค้นหากับ Resource ปลายทาง แล้วส่งสถานะ
200 OKกลับมาพร้อมข้อมูลผลลัพธ์
กรณีตัวอย่างที่เห็นภาพชัดที่สุดคือการใช้งานร่วมกับ GraphQL จากเดิมที่ต้องส่งผ่าน POST ทำให้แคชไม่ได้ เมื่อเปลี่ยนมาใช้ QUERY ฝั่ง Client สามารถส่ง Request Body พร้อม Header Content-Type: application/graphql ไปยัง /api/graphql จากนั้น Server สามารถตอบกลับพร้อม Header Content-Location เพื่อระบุ URI ของผลลัพธ์ชุดนั้น ซึ่งเปิดทางให้ Client ดึงผลลัพธ์เดิมซ้ำผ่าน GET ในภายหลังได้
สิ่งที่ต้องระมัดระวังคือการระบุ Content-Type เนื่องจากมาตรฐาน RFC 10008 กำหนดให้ Server ต้องปฏิเสธคำขอทันทีหาก Client ไม่ระบุประเภทของ Query หรือระบุไม่ตรงกับเนื้อหาใน Body เพื่อให้มั่นใจว่าระบบประมวลผลไวยากรณ์ได้อย่างถูกต้อง
นอกจากนี้ Server ยังสามารถส่ง Header Accept-Query เช่น Accept-Query: application/graphql, application/sql เพื่อแจ้งให้ Client ทราบล่วงหน้าว่ารองรับภาษาค้นหาใดบ้าง ช่วยให้การทำงานร่วมกันระหว่างระบบมีความยืดหยุ่นยิ่งขึ้น
ข้อจำกัดและความพร้อมในการนำไปใช้งานจริง
แม้ว่า QUERY จะเป็นมาตรฐานที่มีประโยชน์อย่างมาก แต่ในทางปฏิบัติยังคงมีประเด็นที่ต้องคำนึงถึงในระยะเปลี่ยนผ่าน
- การรองรับบนเบราว์เซอร์: ปัจจุบันเบราว์เซอร์หลักยังไม่รองรับ
QUERYแบบ Native บน API อย่างfetch()การใช้งานในปัจจุบันจึงเหมาะกับการสื่อสารระหว่าง Server กับ Server หรือ Microservices ภายในที่เราควบคุมได้ทั้งสองฝั่ง - นโยบาย CORS: เนื่องจาก
QUERYยังไม่ได้ถูกจัดอยู่ในกลุ่ม CORS-safelisted Methods การเรียกใช้งานข้ามโดเมนบนเว็บจะต้องผ่านขั้นตอน PreflightOPTIONSก่อนเสมอ - ความซับซ้อนของ Cache Key: การแคชผลลัพธ์ของ
QUERYมีความซับซ้อนกว่าGETเนื่องจาก Cache Engine ต้องนำเนื้อหาใน Request Body มาร่วมคำนวณเป็น Cache Key ด้วย ไม่สามารถใช้เพียง URL เหมือนในอดีต
เมื่อพิจารณาภาพรวมแล้ว QUERY คือการเติมเต็มชิ้นส่วนสำคัญของโปรโตคอล HTTP ที่ขาดหายไปนาน การทำความเข้าใจและเริ่มทดลองปรับใช้ตั้งแต่เนิ่นๆ จะช่วยให้ทีมพัฒนาเตรียมพร้อมรับมือกับ Ecosystem ที่กำลังขยายตัวในอนาคต
ที่มา:
- เอกสาร RFC 10008: HTTP QUERY Method จาก RFC Editor
- บทความ QUERY: Expert Guide to HTTP methods จาก http.dev
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
ChatGPT Work ฉบับเข้าใจง่าย มอบงานให้ AI ทำจนจบ ตั้งแต่งานแรกจนถึงงานอัตโนมัติ พร้อม workflow ใช้ได้จริง 8 แบบ
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin