Kythe ของ Google ใช้กราฟเดียวเชื่อมเครื่องมือสำหรับโค้ดทุกภาษา จึงลดความซับซ้อนของงานเชื่อมต่อจาก O(L×C×B) เหลือ O(L+C+B)
Kythe โปรเจกต์โอเพนซอร์สของ Google ให้เครื่องมืออ่านโค้ดทุกภาษาใช้กราฟกลางร่วมกัน งานเชื่อม L ภาษา C Client B Build System จึงลดจาก O(L×C×B) เหลือ O(L+C+B)
Kythe โปรเจกต์โอเพนซอร์สจาก Google เกิดขึ้นเพื่อแก้ปัญหาเดียว คือเครื่องมือที่ทำงานกับโค้ดมีให้เลือกเยอะ แต่คู่ที่ทำงานร่วมกันได้ดีจริงกลับมีน้อยมาก และเอกสารของโปรเจกต์ระบุว่าแม้แต่ทีมเล็กอย่างสตาร์ทอัพก็ใช้ชุดเครื่องมือพัฒนาที่ครอบคลุมหลายภาษาอยู่แล้ว
ลองนึกภาพโปรเจกต์ที่มีหลายภาษาอยู่ในคลังเก็บโค้ดเดียวกัน ฝั่งหน้าบ้านเขียนด้วย TypeScript ส่วนระบบหลังบ้านเขียนด้วย Go และมีสคริปต์ Python คอยทำงานเบื้องหลัง ถ้าคุณใช้คำสั่ง Go to Definition เพื่อไปยังจุดประกาศโค้ดบนชื่อจุดรับส่งข้อมูลในไฟล์ TypeScript ลองถามตัวเองดูสองข้อ ข้อแรก โปรแกรมเขียนโค้ดพาคุณข้ามไปถึงฟังก์ชัน Go ที่รับคำขอข้อมูลนี้ในอีกโฟลเดอร์ได้ไหม ข้อสอง มีเครื่องมือตัวไหนบอกได้ไหมว่าสคริปต์ Python ที่เรียกจุดรับส่งข้อมูลเดียวกันตอนกลางคืนเกี่ยวข้องกันด้วยหรือเปล่า ถ้าทำไม่ได้ทั้งสองข้อ นั่นคือเส้นแบ่งระหว่างภาษา จุดที่เครื่องมือของภาษาหนึ่งไปต่อไม่ได้ และการหาคำตอบว่าใครเรียกใครข้ามฝั่งก็ตกเป็นภาระที่ต้องมานั่งไล่เอง เอกสารของ Kythe ชี้ว่าปัญหาไม่ได้อยู่แค่เครื่องมือของภาษาใดภาษาหนึ่ง แต่อยู่ที่เครื่องมือของทุกภาษาในโปรเจกต์ต้องคุยกันได้
Google เองก็เจอปัญหานี้เช่นกัน แต่เจอในระดับคลังโค้ดภายในขนาดมหึมาที่มีโค้ดหลายภาษารวมกัน จนใหญ่เกินกว่าจะเปิดด้วย IDE หรือโปรแกรมพัฒนาโค้ดแบบครบวงจรบนเครื่องคอมพิวเตอร์ทั่วไปได้ เอกสาร Overview ของ Kythe บน kythe.io ระบุไว้ชัดเจนว่า วิศวกรต้องเสียเวลาไปมากกับการเชื่อมต่อเครื่องมือใหม่เข้ากับโปรเจกต์ และมักลงเอยด้วยการสร้างเครื่องมือขึ้นมาซ้ำซ้อนกับสิ่งที่ Compiler หรือ IDE เคยแก้ไปแล้ว เพียงเพราะเครื่องมือเดิมไม่รองรับการทำงานร่วมกับเครื่องมือตัวอื่นในทีม ส่วนวิธีแก้ด้วยการบังคับให้ทุกคนใช้เครื่องมือชุดเดียวกัน เอกสารก็ชี้ว่าขยายระบบต่อได้ยาก เพราะการเพิ่มเครื่องมือใหม่แต่ละครั้งมีต้นทุนสูงมาก แถมประสิทธิภาพการทำงานของนักพัฒนายังลดฮวบเมื่อถูกบังคับให้ใช้เครื่องมือที่ไม่ถนัด
ทางออกของ Google คือแทนที่จะให้เครื่องมือแต่ละตัวคุยกันตรงๆ ก็เปลี่ยนมาให้ทุกตัวสื่อสารผ่าน "ภาษากลาง" เดียวกัน ซึ่งก็คือกราฟความสัมพันธ์ของโค้ด และแนวคิดนี้มีประโยชน์กับทุกคนที่ต้องการสร้างเครื่องมืออ่านโค้ด แม้คุณจะไม่เคยติดตั้ง Kythe เลยก็ตาม
ปัญหาความซับซ้อนระดับ L×C×B
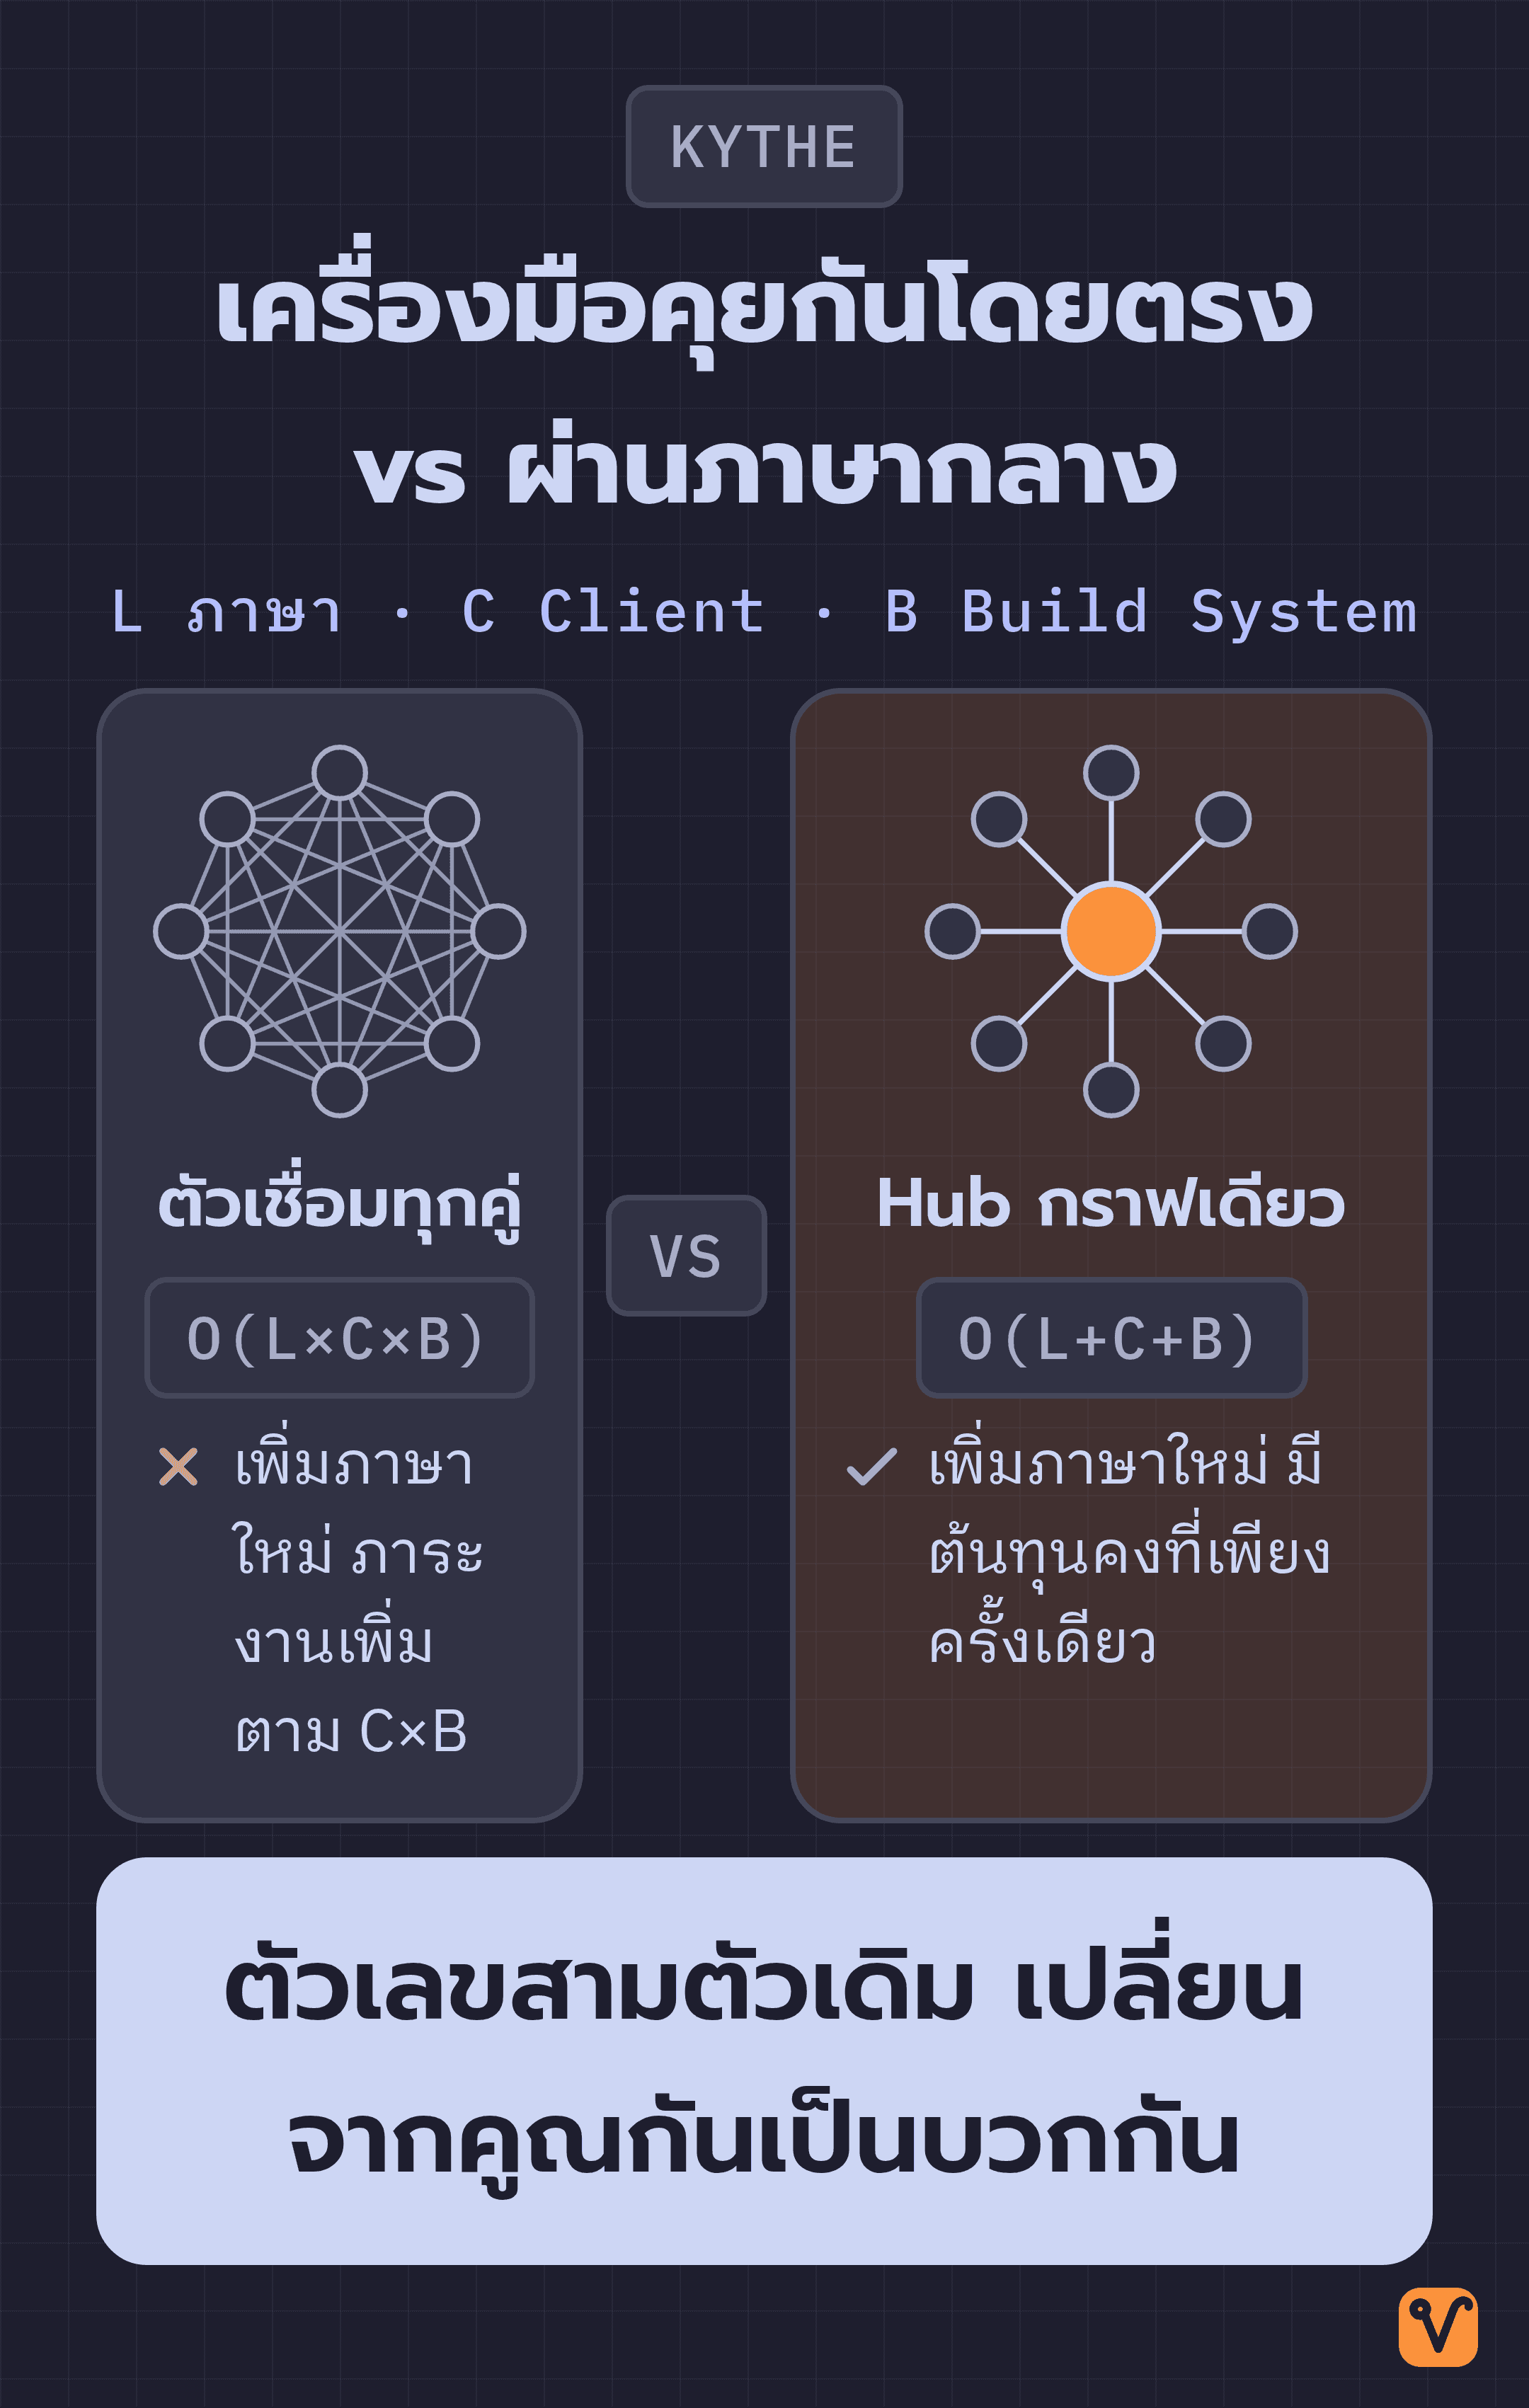
เอกสารของ Kythe อธิบายปัญหานี้ด้วยตัวแปร 3 ตัว ได้แก่
- L (Languages) คือจำนวนภาษาที่ใช้ในโปรเจกต์
- C (Clients) คือเครื่องมือที่นักพัฒนาใช้งานจริง เช่น Editor, IDE หรือ Code Browser สำหรับเปิดดูโค้ด
- B (Build Systems) คือระบบที่ใช้คอมไพล์และประกอบโค้ดเป็นโปรแกรม เช่น Maven หรือ Bazel
ถ้าเราต้องเขียนตัวเชื่อมให้ทุกคู่คุยกันโดยตรง ในกรณีที่แย่ที่สุด ความซับซ้อนของงานเชื่อมต่อจะพุ่งไปถึง O(L×C×B) ลองนับของทีมคุณเองในหัว นับภาษาที่ใช้ นับ Editor ที่คนในทีมใช้ นับ Build System แล้วนำตัวเลขทั้งสามมาคูณกัน นั่นคือขนาดของงานเชื่อมต่อโดยประมาณถ้าให้ทุกคู่คุยกันเอง และทุกครั้งที่เพิ่มภาษาใหม่ งานที่งอกขึ้นมาก็โตตามจำนวน Editor คูณจำนวน Build System ซ้ำร้ายตัวเชื่อมแต่ละชิ้นยังต้องเข้าใจทั้งโครงสร้างภาษา ตัว Editor และ Build System ไปพร้อมกันทั้งหมด
Kythe จึงเข้ามาทำหน้าที่เป็น Hub หรือศูนย์กลางคอยประสานงานแทน โดยเครื่องมือแต่ละตัวมีต้นทุนคงที่ล่วงหน้าเพียงครั้งเดียวโดยประมาณ ในการแปลงข้อมูลให้อยู่ในรูปภาษากลาง จากนั้นก็ทำงานร่วมกับเครื่องมือตัวอื่นในระบบได้ทันที ความซับซ้อนของงานจึงลดลงเหลือเพียง O(L+C+B) ตัวเลขสามตัวเดิมของทีมคุณเปลี่ยนจากคูณกันเป็นบวกกัน และการเพิ่มภาษาใหม่ก็เหลือแค่ต้นทุนคงที่เพียงครั้งเดียว คือการทำให้ภาษานั้นส่งข้อมูลออกมาเป็นกราฟตามภาษากลาง
ข้อควรระวังคือ คำว่า Hub ในที่นี้ไม่ได้หมายถึงโปรแกรมหรือเซิร์ฟเวอร์ตัวกลางที่ต้องติดตั้ง แต่หมายถึงข้อตกลงร่วมอย่างโปรโตคอลและรูปแบบข้อมูลที่เครื่องมือทุกตัวยอมรับร่วมกัน ข้อดีตามที่เอกสารระบุไว้คือ เราสามารถแยกงานวิเคราะห์โค้ดแต่ละภาษาออกไปเป็นบริการแยกต่างหากได้ ทำให้เครื่องมือฝั่ง Client ขนาดเบาอย่าง Editor หรือ Code Browser มีหน้าที่แค่ดึงผลลัพธ์ไปแสดงผลเท่านั้น
ภาษากลางคือกราฟ ไม่ใช่ข้อความ
โครงสร้างกราฟใน Kythe ประกอบด้วย Node ที่ทำหน้าที่เป็นจุดข้อมูล และ Edge ที่ทำหน้าที่เป็นเส้นเชื่อมโยง โดย Node ใช้แทนสิ่งต่างๆ ที่ประกาศไว้ในโค้ด เช่น ฟังก์ชัน ตัวแปร หรือชนิดข้อมูล ส่วน Edge ใช้แทนความสัมพันธ์ระหว่างสิ่งเหล่านั้น เช่น ฟังก์ชันนี้ประกาศไว้ที่ไหน เรียกใช้จากจุดใด หรือตัวแปรนี้มีชนิดข้อมูลเป็นอะไร
เอกสารระบุว่ากราฟนี้เก็บข้อมูลไว้ 2 ระดับควบคู่กัน:
- ระดับ Metadata หรือข้อมูลกำกับของ Build System และ Compiler
- ระดับความหมายเชิงลึกของโค้ดแบบ Semantic เช่น จุดประกาศ จุดเรียกใช้งาน ชนิดข้อมูล ตลอดจนความสัมพันธ์ข้ามภาษา
ข้อมูลระดับที่สองนี้เองที่ทำให้เราตอบคำถามได้ว่า "มีโค้ดจากภาษาอื่นเรียกใช้ฟังก์ชันนี้หรือไม่" เพราะคำตอบไม่ได้มาจากการค้นหาข้อความด้วย Grep ที่อาศัยแค่ชื่อสะกดตรงกัน แต่ได้มาจากเส้นเชื่อม Edge ที่ตัววิเคราะห์ของแต่ละภาษาอ่านผลการคอมไพล์แล้วบันทึกลงกราฟไว้
นอกจากนี้ ผังโครงสร้างข้อมูลอย่าง Schema ของกราฟ ยังออกแบบมาให้ต่อยอดได้อย่างอิสระ โดย Kythe เตรียมโครงสร้างย่อยสำหรับกรณีทั่วไปไว้ให้ชุดหนึ่ง และเปิดให้ทีมพัฒนากำหนดชนิดของ Node และ Edge ใหม่ๆ เพิ่มเติมได้เองโดยไม่ต้องรอส่วนกลางอนุมัติ ถ้ามีรูปแบบความสัมพันธ์เฉพาะที่ยังไม่มีใครนิยามไว้ ก็เพิ่มเข้าไปได้ทันที
เอกสารยังระบุถึงหลักการออกแบบสำคัญ 3 ข้อที่คนพัฒนาเครื่องมืออ่านโค้ดทุกคนควรจำ:
- การทำงานร่วมกันข้ามระบบไม่จำเป็นต้องมีข้อมูลครบทุกอย่าง: เครื่องมือต้องยืดหยุ่นและทำงานต่อได้ แม้ข้อมูลที่ได้รับจะไม่ครบถ้วน
- มีข้อมูลบางส่วน ดีกว่าไม่มีข้อมูลเลยในเกือบทุกกรณี
- ข้อมูลไม่ครบยังดีกว่าข้อมูลผิดพลาด
หลักการข้อที่สองและข้อที่สามอาจฟังดูคล้ายกัน แต่มุ่งเน้นคนละมุม ข้อสองบอกว่าอย่าเพิ่งทิ้งผลลัพธ์ที่มีประโยชน์เพียงเพราะมันยังไม่สมบูรณ์ร้อยเปอร์เซ็นต์ ส่วนข้อสามย้ำว่า ถ้าไม่มั่นใจในความถูกต้อง ให้เว้นว่างไว้ ดีกว่าใส่ข้อมูลที่ไม่ถูกต้องลงไปเพื่อให้ดูเหมือนมีข้อมูลครบ
Kythe มีอะไรให้ใช้งานจริงบ้าง
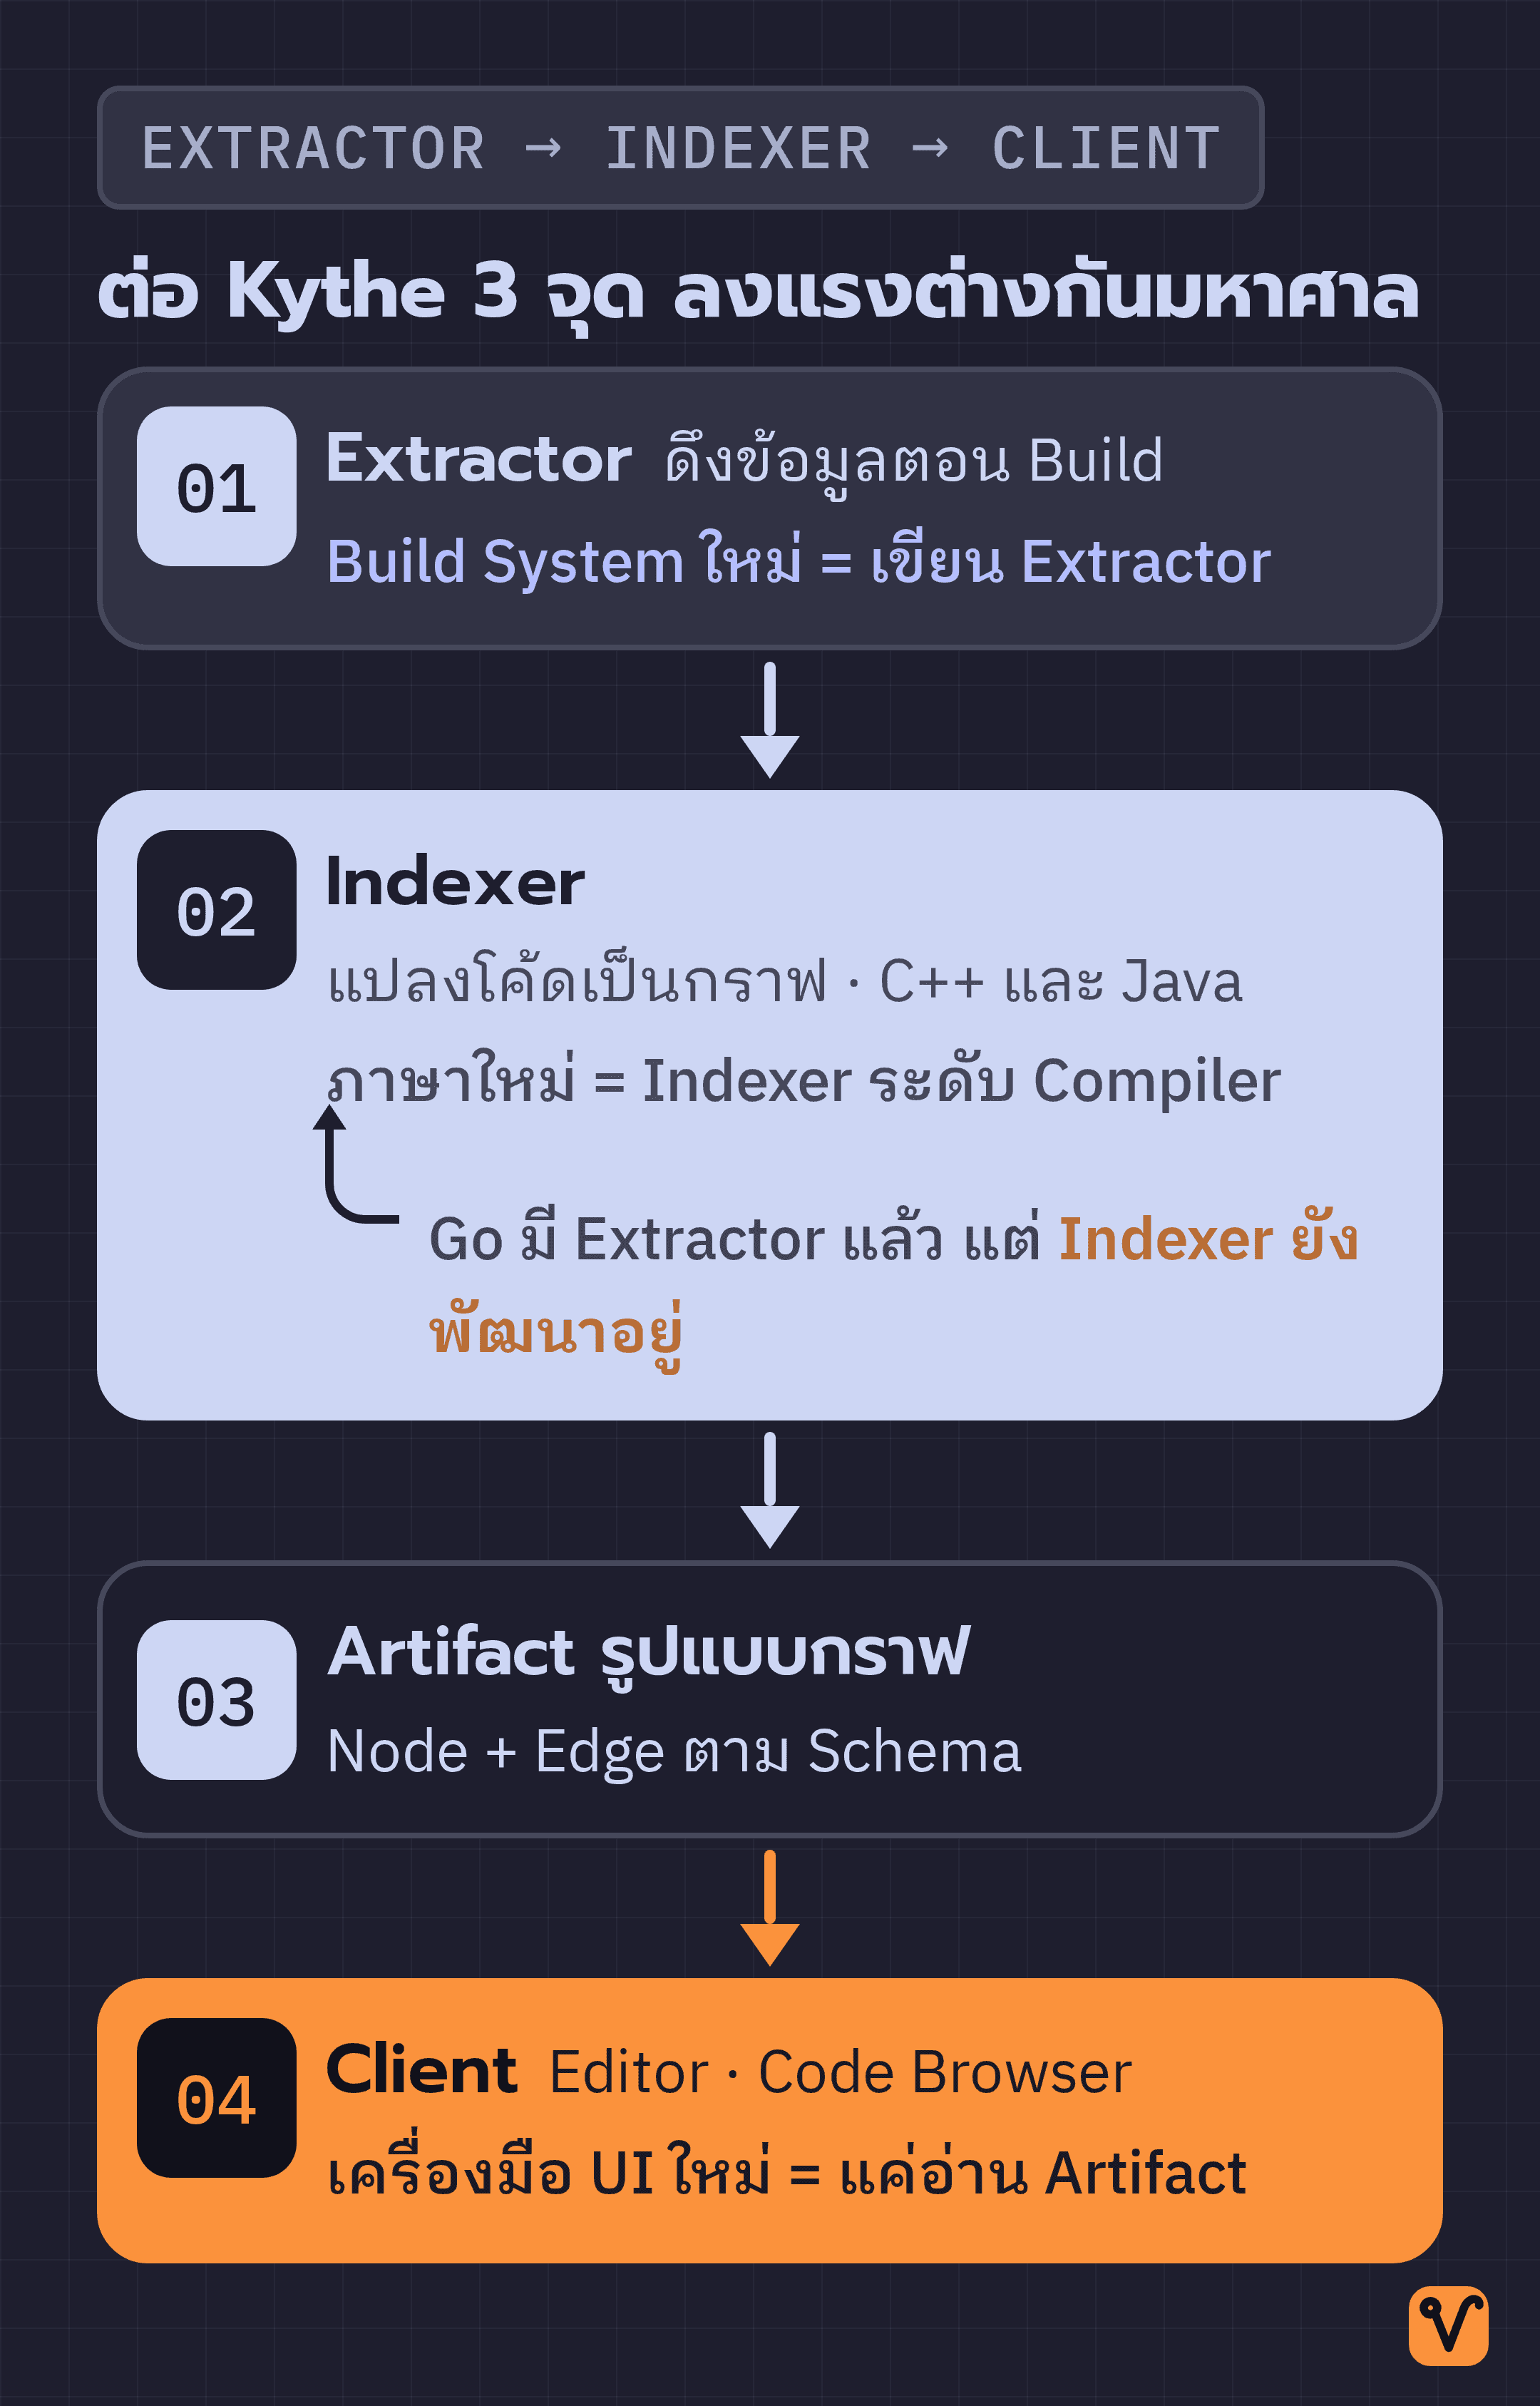
เอกสารทางการแบ่งสิ่งที่ Kythe มีให้ใช้เป็น 3 ส่วนหลัก:
- Storage Format สำหรับเก็บกราฟ: รูปแบบการจัดเก็บข้อมูลที่ไม่ขึ้นกับภาษาใดภาษาหนึ่ง มีโครงสร้างเรียบง่าย ถ่ายโอนสะดวก ออกแบบมาเพื่อให้ Compiler ที่ผ่านการปรับแต่งสามารถส่งข้อมูลออกมาได้ง่าย และฝั่ง Client ก็เปิดอ่านได้สะดวก
- Schema ของกราฟ: ครอบคลุมข้อมูล Cross-reference ที่บอกว่าสิ่งหนึ่งประกาศไว้ที่ไหนและมีจุดใดเรียกใช้บ้าง โดยเน้นภาษา C++ และ Java เป็นหลัก เอกสารระบุว่าภาษา Go กำลังจะตามมา นอกจากนี้ยังมีเครื่องมือสำหรับเพิ่มโครงสร้างใหม่ลงใน Schema และชุดทดสอบเพื่อยืนยันว่า Analyzer ทำงานถูกต้องตามข้อกำหนด
- เครื่องมือ Analyzer และโค้ดตัวอย่าง
หน้าแรกของ Kythe ระบุเครื่องมือที่มีให้ใช้ในปัจจุบันดังนี้:
- Indexer เครื่องมือแปลงข้อมูลโค้ดเป็นกราฟ สำหรับภาษา C++ และ Java
- Extractor ทำหน้าที่ดึงข้อมูลระหว่างการคอมไพล์ รองรับทั้ง javac, Maven, CMake, Go และ Bazel
- Verifier เครื่องมือตรวจสอบที่ไม่ผูกกับภาษาใดภาษาหนึ่ง สำหรับทดสอบว่า Indexer ส่งออกข้อมูลถูกต้องตาม Schema หรือไม่
- Cross-reference Service ตัวอย่างบริการสำหรับตอบคำถามเรื่องความสัมพันธ์ของโค้ดผ่าน HTTP
- เครื่องมือ Command-line สำหรับจัดการไฟล์กราฟผลลัพธ์อย่าง Artifact ที่ Indexer สร้างขึ้น
จุดที่ชวนสับสนคือความแตกต่างระหว่าง Extractor กับ Indexer เพราะทั้งสองทำงานคนละขั้นตอน:
- Extractor ทำงานในขั้นตอนการ Build มีหน้าที่ดึงข้อมูลแวดล้อมที่จำเป็นต่อการคอมไพล์ออกมา เพื่อให้เครื่องมือวิเคราะห์นำไปรันร่วมกับ Dependency หรือไฟล์ส่วนประกอบภายนอกได้อย่างถูกต้อง
- Indexer คือตัววิเคราะห์ฝั่งภาษา มีหน้าที่อ่านผลลัพธ์จากขั้นตอนข้างต้น แล้วแปลงข้อมูลออกมาเป็นกราฟ
ตัวอย่างที่เห็นภาพชัดเจนที่สุดคือภาษา Go บนหน้าเว็บของ Kythe มี Extractor สำหรับ Go ให้ใช้งานแล้ว แต่ฝั่ง Indexer ยังมีเพียง C++ และ Java เท่านั้น โดยเอกสารระบุว่าตัว Indexer ของ Go ยังอยู่ระหว่างการพัฒนา ดังนั้น ถ้าถามว่า Kythe รองรับ Go หรือไม่ จึงต้องถามต่อว่าหมายถึงรองรับในฝั่ง Extractor หรือ Indexer
การเชื่อมสิ่งใหม่เข้ากับ Kythe แบ่งเป็น 3 กรณี ซึ่งยากง่ายต่างกันอย่างชัดเจน:
- การเพิ่มภาษาใหม่: ต้องปรับแต่ง Compiler ให้ส่งออกข้อมูลในรูปแบบของ Kythe ได้ ซึ่งหมายความว่าต้องสร้าง Indexer สำหรับภาษานั้นขึ้นมา
- การเพิ่ม Build System ใหม่: ต้องเขียน Extractor เพื่อดึงข้อมูลระหว่างขั้นตอนการ Build ของระบบนั้นๆ ออกมา
- การเพิ่มเครื่องมือฝั่ง UI หรือ Client: ทำได้ง่ายที่สุด เพราะเพียงแค่อ่านไฟล์ Artifact ของกราฟได้ และเข้าใจกฎการตั้งชื่อโหนดอย่าง Naming Scheme ก็เพียงพอแล้ว โดยไม่ต้องเข้าใจโครงสร้างภายในของภาษานั้นเลย
ถ้าคิดจะพัฒนาเครื่องมือต่อยอดบน Kythe ควรกำหนดทิศทางให้ชัดเจนตั้งแต่แรก เพราะต้องลงแรงต่างกันมหาศาล การทำเครื่องมือฝั่ง UI นำข้อมูลที่มีอยู่แล้วไปใช้งานต่อได้ทันทีเพียงแค่เรียนรู้ Naming Scheme ส่วนฝั่งภาษาจะต้องลงลึกไปถึงระดับ Compiler ซึ่งซับซ้อนกว่ามาก นอกจากนี้ เอกสารยังระบุว่าโครงสร้างข้อมูลของ Kythe มีลักษณะแบนราบ ไม่ซับซ้อน และถ่ายโอนง่าย จึงนำไปแปลงเป็นตารางฐานข้อมูล เพื่อสร้างบริการหรือระบบแสดงผลข้อมูลของตัวเองได้อย่างรวดเร็ว
Release v0.0.76 บ่งบอกว่า Kythe ยังคงพัฒนาอยู่
เวอร์ชันล่าสุดบน GitHub ของ Kythe คือ v0.0.76 ที่ปล่อยออกมาเมื่อวันที่ 16 กรกฎาคม 2026 รายการเปลี่ยนแปลงในรอบนี้มี 2 ข้อ และทั้งคู่เป็นการปรับปรุงฝั่ง Rust Extractor โดยผู้พัฒนาคนเดียวกัน ข้อแรกคือการย้าย Root Module หรือโมดูลหลัก ไปไว้ที่จุดเริ่มต้นของรายการ source_file และข้อสองคือการกำหนดค่า is_workspace_member เพื่อระบุว่ากำลังเก็บข้อมูลจาก Crate ใดของ Rust ทั้งสองข้อนี้เป็นการปรับปรุงจุดเล็กๆ ในตัว Rust Extractor เดิมที่มีอยู่แล้ว และฝั่ง Indexer บนหน้าแรกก็ยังคงระบุเฉพาะ C++ และ Java เช่นเดิม
ปัจจุบันตัวคลังโค้ดบน GitHub มียอดดาวราว 2.2k มี Issue ที่เปิดอยู่ 235 รายการ และ Pull Request ที่รอจัดการอีก 43 รายการ ไฟล์ Release แจกจ่ายในรูปแบบไฟล์บีบอัด tar.gz ขนาด 337 MB พร้อมค่า SHA-256 สำหรับยืนยันความถูกต้อง ภาพรวมจึงแสดงให้เห็นว่านี่คือโปรเจกต์ที่ยังคงปล่อยเวอร์ชันใหม่อย่างต่อเนื่องและยังมีงานอยู่ระหว่างดำเนินการ ไม่ใช่โปรเจกต์ที่ถูกทิ้งร้าง
สองเรื่องสำคัญที่ต้องเข้าใจให้ชัด
เรื่องแรก Kythe ไม่ใช่เครื่องมือสำเร็จรูปที่ติดตั้งคืนนี้แล้วพรุ่งนี้ใช้งานได้ทันที ตัวไฟล์ Release เป็นแพ็กเกจขนาด 337 MB และหัวใจสำคัญในการนำไปใช้กับโปรเจกต์คือ Extractor ที่ต้องผูกกับ Build System ของคุณ โดยหน้าแรกของ Kythe ระบุรายชื่อไว้ ได้แก่ javac, Maven, CMake, Go และ Bazel ถ้าโปรเจกต์ของคุณใช้ระบบ Build ที่ไม่อยู่ในรายชื่อนั้น สิ่งแรกที่ต้องหาให้เจอคือ Extractor ที่ดึงข้อมูลจากระบบนั้นได้ และถ้าภาษาที่คุณใช้ยังไม่มี Indexer งานชิ้นนั้นก็คือการลงไปแตะระดับ Compiler
เรื่องที่สอง เอกสารระบุขอบเขตที่ไม่ใช่เป้าหมายไว้อย่างชัดเจน Kythe ไม่ได้สร้างขึ้นมาเพื่อเป็น Compiler หรือ Optimizer สำหรับปรับแต่งโค้ด เพราะตัวกราฟตั้งใจเก็บเฉพาะข้อมูลเชิงความหมายระดับสูงที่มีโครงสร้างร่วมกันข้ามภาษา ไม่ใช่รายละเอียดการสร้างโค้ดที่ผูกติดกับภาษาใดภาษาหนึ่ง และไม่ได้ตั้งใจมาแทนที่โครงสร้างข้อมูลระดับกลางอย่าง IR ของ Static Analyzer แต่เป้าหมายคือเปิดทางให้เครื่องมือเหล่านั้นส่งออกผลการวิเคราะห์ส่วนที่น่าสนใจมาแลกเปลี่ยนกันได้ เอกสารสรุปไว้อย่างกระชับว่า Kythe ไม่ได้ต้องการเป็นภาษากลางสากลอย่าง UNCOL ที่ทุกภาษาต้องแปลงเข้าหา แต่เป็นเพียงภาษาสำหรับแลกเปลี่ยนข้อมูลระหว่างเครื่องมือเท่านั้น
สิ่งที่นำไปปรับใช้ได้ทันที โดยไม่ต้องติดตั้ง Kythe
ถ้าในอนาคตคุณต้องเขียนเครื่องมือสำหรับอ่านหรือวิเคราะห์โค้ด ไม่ว่าจะเป็น Linter สำหรับตรวจเช็กโค้ดในทีม สคริปต์สรุปโครงสร้างของคลังโค้ด หรือระบบเตรียมบริบทให้ผู้ช่วยเขียนโค้ดอย่าง AI Coding Agent ลองตั้งคำถามง่ายๆ ดูว่า เครื่องมือนั้นกำลังแบกรับต้นทุนความซับซ้อนระดับ L×C×B อยู่หรือไม่
สัญญาณเตือนที่เห็นได้ชัดคือ เครื่องมือชิ้นเดียวต้องเข้าใจทั้งไวยากรณ์ภาษา รูปแบบการแสดงผล และวิธี Build ไปพร้อมๆ กัน จนเมื่อมีส่วนใดส่วนหนึ่งเปลี่ยน คุณก็ต้องรื้อเขียนใหม่ทั้งหมด
ถ้าเป็นเช่นนั้น แนวทางแก้ไขคือแยก "ส่วนดึงข้อมูล" ออกจาก "ส่วนแสดงผล" ตั้งแต่วันแรกตามแนวคิดของ Kythe โดยกำหนดให้ส่วนแรกมีหน้าที่เพียงสกัดข้อมูลเกี่ยวกับโค้ดออกมาในรูปแบบภาษากลางที่คุณกำหนดขึ้นเอง ที่ยอมให้ข้อมูลไม่สมบูรณ์ได้ แต่ต้องถูกต้องเสมอ จากนั้นให้เครื่องมืออย่าง Linter, สคริปต์ หรือ Agent ทำหน้าที่เป็นเพียง Client ที่รออ่านข้อมูลนั้น เมื่อมีภาษาใหม่เข้ามา คุณก็แตะเฉพาะส่วนสกัดข้อมูล และเมื่อต้องการหน้าจอหรือเครื่องมือตัวใหม่ คุณก็แตะเฉพาะฝั่งแสดงผล
เพราะท้ายที่สุดแล้ว การอ่านและเข้าใจโค้ดข้ามภาษาไม่ได้เกิดจากการสร้างเครื่องมือที่ฉลาดล้ำขึ้นเรื่อยๆ แต่เกิดจากการที่เครื่องมือแต่ละตัวยอมสื่อสารผ่านภาษากลางเดียวกัน
ที่มา:
- เว็บไซต์ Kythe จาก kythe.io
- บทความ Kythe - An Overview of Kythe จาก kythe.io
- หน้า release Release v0.0.76 · kythe/kythe จาก kythe/kythe (GitHub)
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin