LLM Wiki ทำให้ coding agent มีคลังความรู้ถาวรของตัวเอง แทนที่จะลืมทุกอย่างเมื่อปิดแชต
LLM Wiki คือชุดคำสั่งโอเพนซอร์สที่ให้ coding agent เก็บงานวิจัยทุกครั้งไว้เป็นคลังความรู้ Markdown ถาวรในเครื่อง พอ agent ไม่ต้องไปค้นเรื่องเดิมซ้ำทุกแชต งานก็แม่นและต่อเนื่องขึ้น

ทุกครั้งที่เราปิดหน้าต่างแชตของ coding agent ความรู้และข้อมูลที่มันเพิ่งค้นคว้ามาให้มักจะเลือนหายไปด้วย พอเริ่มเปิดแชตใหม่ในวันถัดไป ตัว agent ก็ต้องเริ่มต้นนับหนึ่งใหม่ ค้นหาเรื่องเดิม อ่านเอกสารชุดเดิม และสรุปสิ่งเดิมที่เคยทำไปแล้ว
LLM Wiki คือชุดคำสั่งโอเพนซอร์ส (เปิดให้ใช้งานภายใต้สัญญาอนุญาต MIT ทางเว็บไซต์ llm-wiki.net) ที่พัฒนาขึ้นมาเพื่อแก้ปัญหานี้โดยตรง ระบบจะแปลงผลการค้นคว้าและวิเคราะห์ของ agent ให้กลายเป็นคลังความรู้ถาวรในเครื่อง จัดเก็บในรูปแบบไฟล์ Markdown ที่เชื่อมโยงถึงกัน สามารถค้นหาซ้ำได้ และผู้ใช้เป็นเจ้าของข้อมูลทั้งหมด 100%
แนวคิดหลักเรียบง่ายแต่ทรงพลัง คือการมอบ "สมุดบันทึกส่วนตัว" แบบถาวรให้กับ coding agent ที่เราใช้งานเป็นประจำ ครั้งหน้าที่เจอหัวข้อเดิม agent ก็สามารถดึงข้อมูลจากคลังความรู้มาใช้ได้ทันทีโดยไม่ต้องออกไปค้นหาใหม่ตั้งแต่ต้น แนวคิดนี้ต่อยอดมาจากไอเดีย LLM wiki ที่ Andrej Karpathy นักวิจัย AI ชื่อดังและอดีตผู้ร่วมก่อตั้ง OpenAI เคยนำเสนอไว้ จนกลายมาเป็นเครื่องมือโอเพนซอร์สที่พร้อมติดตั้งใช้งานได้จริง
ปัญหาไม่ใช่ agent ไม่ฉลาด แต่คือมันไม่มีความจำถาวร
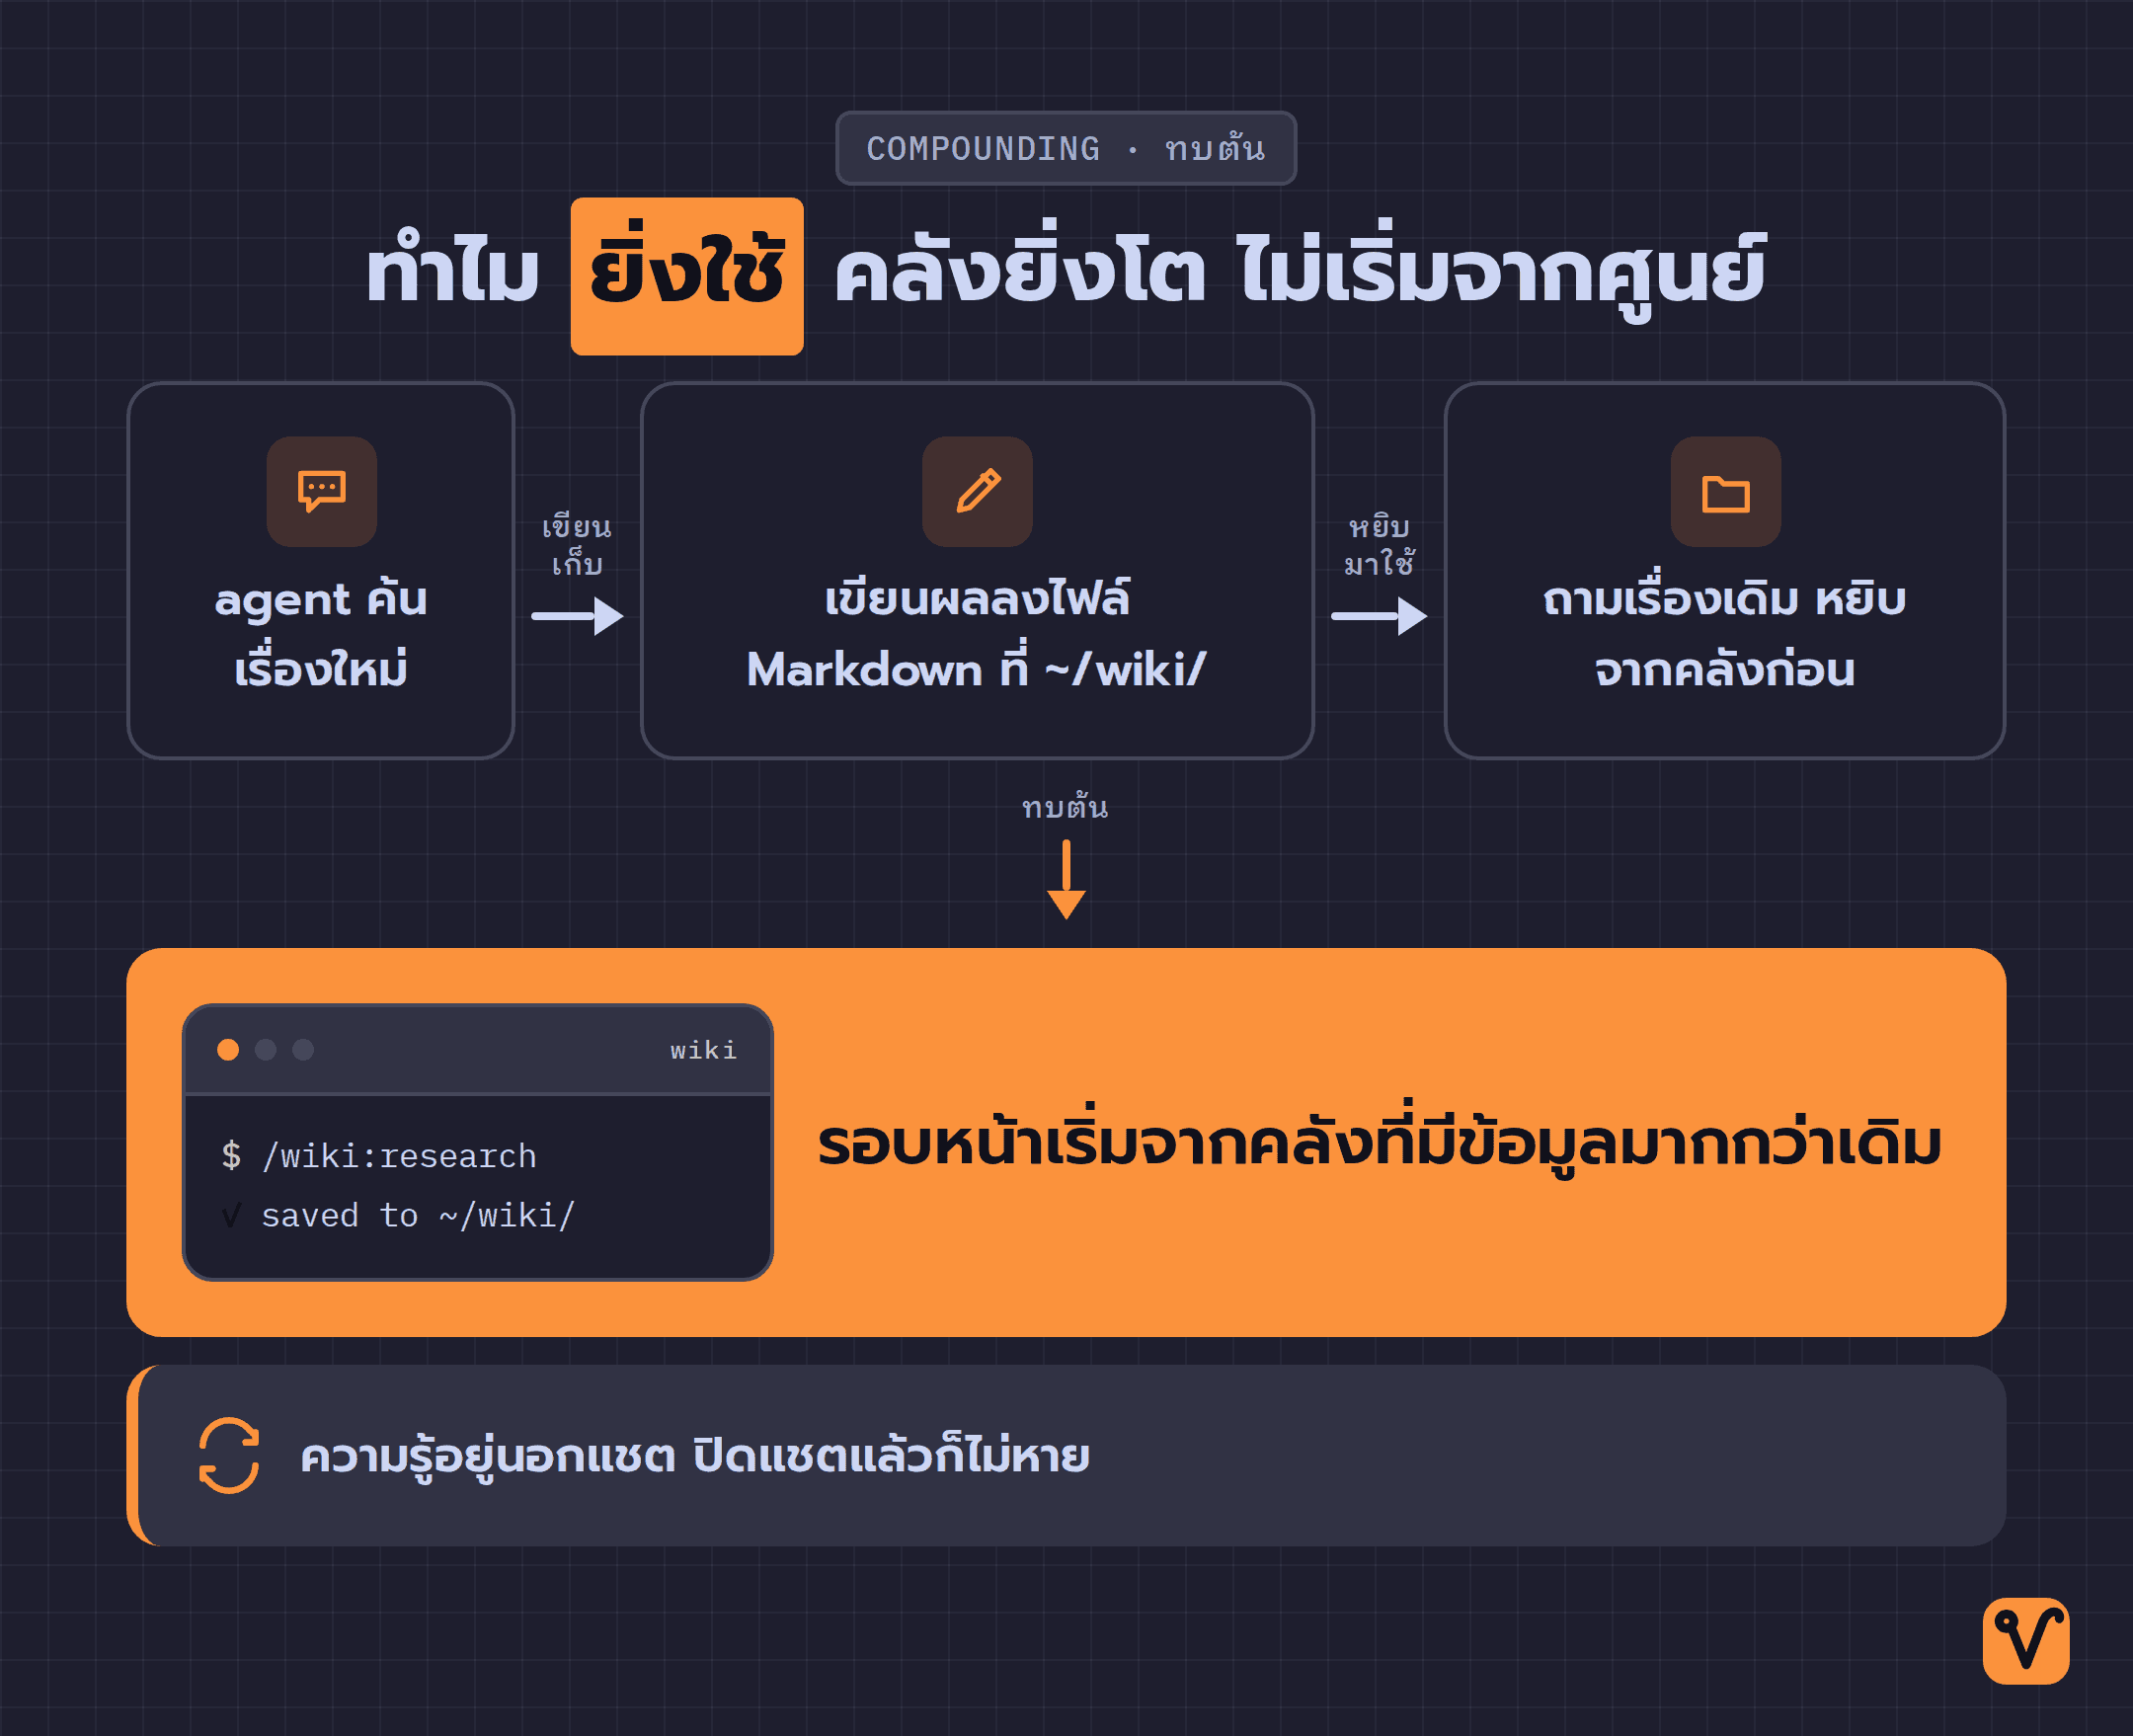
coding agent ยุคปัจจุบันมีความสามารถในการค้นเว็บ อ่านเอกสาร และสรุปสาระสำคัญได้อย่างยอดเยี่ยม ปัญหาจึงไม่ได้อยู่ที่ความสามารถของโมเดล แต่อยู่ที่บริบททั้งหมดถูกจำกัดอยู่แค่ในเซสชันของแชตเดียว พอปิดแชต ความรู้เหล่านั้นก็หายไป
ผลที่ตามมาคือเวลาและ token ที่สูญเสียไปกับการทำงานซ้ำซ้อน สัปดาห์ก่อนเราอาจให้ agent ค้นคว้าวิธีตั้งค่า library จนได้ข้อสรุปที่ลงตัว แต่สัปดาห์นี้เมื่อกลับมาเขียนโค้ดต่อ agent กลับจำไม่ได้และต้องเริ่มสืบค้นใหม่ทั้งหมด ยิ่งไปกว่านั้น ในบางครั้งคำตอบที่ได้ในรอบใหม่อาจไม่ตรงกับแนวทางเดิมเพราะขาดเอกสารอ้างอิงที่แน่นอน
LLM Wiki แก้ไขปัญหานี้ด้วยการแยก "คลังความรู้" ออกจาก "หน้าต่างแชต" เมื่อ agent ค้นคว้าเรื่องใดเสร็จสิ้น ระบบจะบันทึกผลลัพธ์ลงเป็นไฟล์ Markdown เก็บไว้ที่ ~/wiki/ บนเครื่องของคุณ เมื่อมีการถามเรื่องเดิมในครั้งถัดไป agent จะอ่านข้อมูลจากคลังความรู้ก่อนเป็นอันดับแรก ข้อมูลชุดนี้จึงอยู่คงทน ไม่สูญหายแม้จะปิดแชตหรือรีสตาร์ตเครื่อง
จัดเก็บเป็น Markdown ในเครื่อง ปราศจากเซิร์ฟเวอร์ภายนอก
จุดเด่นที่ทำให้ LLM Wiki แตกต่างจากบริการจัดการ memory อื่นๆ คือการทำงานแบบไร้เซิร์ฟเวอร์ ไม่ต้องพึ่งพาฐานข้อมูลภายนอก และไม่ต้องติดตั้งเซอร์วิสที่ซับซ้อนเพิ่มเติม ระบบใช้เพียงความสามารถพื้นฐานที่มีอยู่ในตัว coding agent นั่นคือการอ่านและเขียนไฟล์ การค้นหาข้อมูล และการอ่านเนื้อหาหน้าเว็บ
ข้อมูลทั้งหมดถูกจัดเก็บเป็นไฟล์ Markdown มาตรฐานบนฮาร์ดดิสก์ของคุณ คุณสามารถเปิดอ่านด้วยโปรแกรม text editor ใดก็ได้ ซิงก์ผ่าน iCloud Drive หรือกำหนดโฟลเดอร์ปลายทางได้ตามต้องการ และที่สำคัญคือ คุณเป็นเจ้าของข้อมูลทั้งหมดอย่างแท้จริงโดยไม่ต้องส่งข้อมูลไปฝากไว้บนคลาวด์ของบุคคลที่สาม
โครงสร้างภายในคลังความรู้แบ่งออกเป็น 2 ชั้นอย่างเป็นระบบ ชั้นแรกคือข้อมูลดิบที่ดึงมาจากต้นทาง ซึ่งจะถูกล็อกเป็น snapshot ต้นฉบับเพื่อใช้อ้างอิงและไม่แก้ไขย้อนหลัง ชั้นที่สองคือบทความสรุปที่ agent เรียบเรียงขึ้นมาใหม่ การแยกชั้นข้อมูลเช่นนี้ทำให้สามารถตรวจสอบย้อนกลับไปยังแหล่งที่มาได้เสมอ คลังความรู้จึงมีความโปร่งใสและตรวจสอบได้
นอกจากนี้ แต่ละโฟลเดอร์ยังรองรับการเปิดใช้งานร่วมกับ Obsidian ได้ทันที สำหรับผู้ที่ชอบจัดการโน้ตแบบ visual graph ก็สามารถเปิดโฟลเดอร์ ~/wiki/ ใน Obsidian เพื่อดูการเชื่อมโยงของข้อมูลได้สะดวกยิ่งขึ้น
ติดตั้งเป็นปลั๊กอินใน Agent ที่ใช้งานอยู่แล้ว
LLM Wiki ไม่ใช่โปรแกรมแยกเดี่ยว แต่ทำงานในฐานะปลั๊กอินเสริมสำหรับ coding agent ที่คุณใช้งานอยู่ สำหรับผู้ใช้งาน Claude Code สามารถติดตั้งได้ง่ายๆ ด้วยคำสั่งเดียว
claude plugin install wiki@llm-wikiสำหรับเครื่องมืออื่นก็มีแนวทางติดตั้งที่สะดวกเช่นกัน OpenAI Codex สามารถติดตั้งผ่าน marketplace ปลั๊กอิน ส่วน OpenCode และ Pi สามารถเรียกใช้ผ่านไฟล์คำสั่ง (โดย Pi ออกแบบมาให้เหมาะกับการรันโมเดลภายในเครื่อง) และสำหรับ agent อื่นๆ ที่รองรับการอ่านไฟล์ AGENTS.md ก็มีเวอร์ชันพกพาที่เพียงแค่วางไฟล์ลงในโปรเจกต์ก็พร้อมใช้งานได้ทันที
โครงสร้างเบื้องหลังถูกออกแบบให้แกนตรรกะทั้งหมดเขียนขึ้นจากจุดเดียว แล้วจึงแปลงเป็นแพ็กเกจสำหรับ agent แต่ละตัว ทำให้ทุกแพลตฟอร์มได้มาตรฐานการทำงานเดียวกัน โดยมีขนาดคำสั่งที่ปรับแต่งให้เหมาะสม ตั้งแต่ระดับ 22K token บน Claude Code ไปจนถึงระดับ 1K token บน Pi สำหรับเครื่องที่มีข้อจำกัดด้านทรัพยากร
เริ่มต้นใช้งานจริงใน 3 คำสั่งหลัก
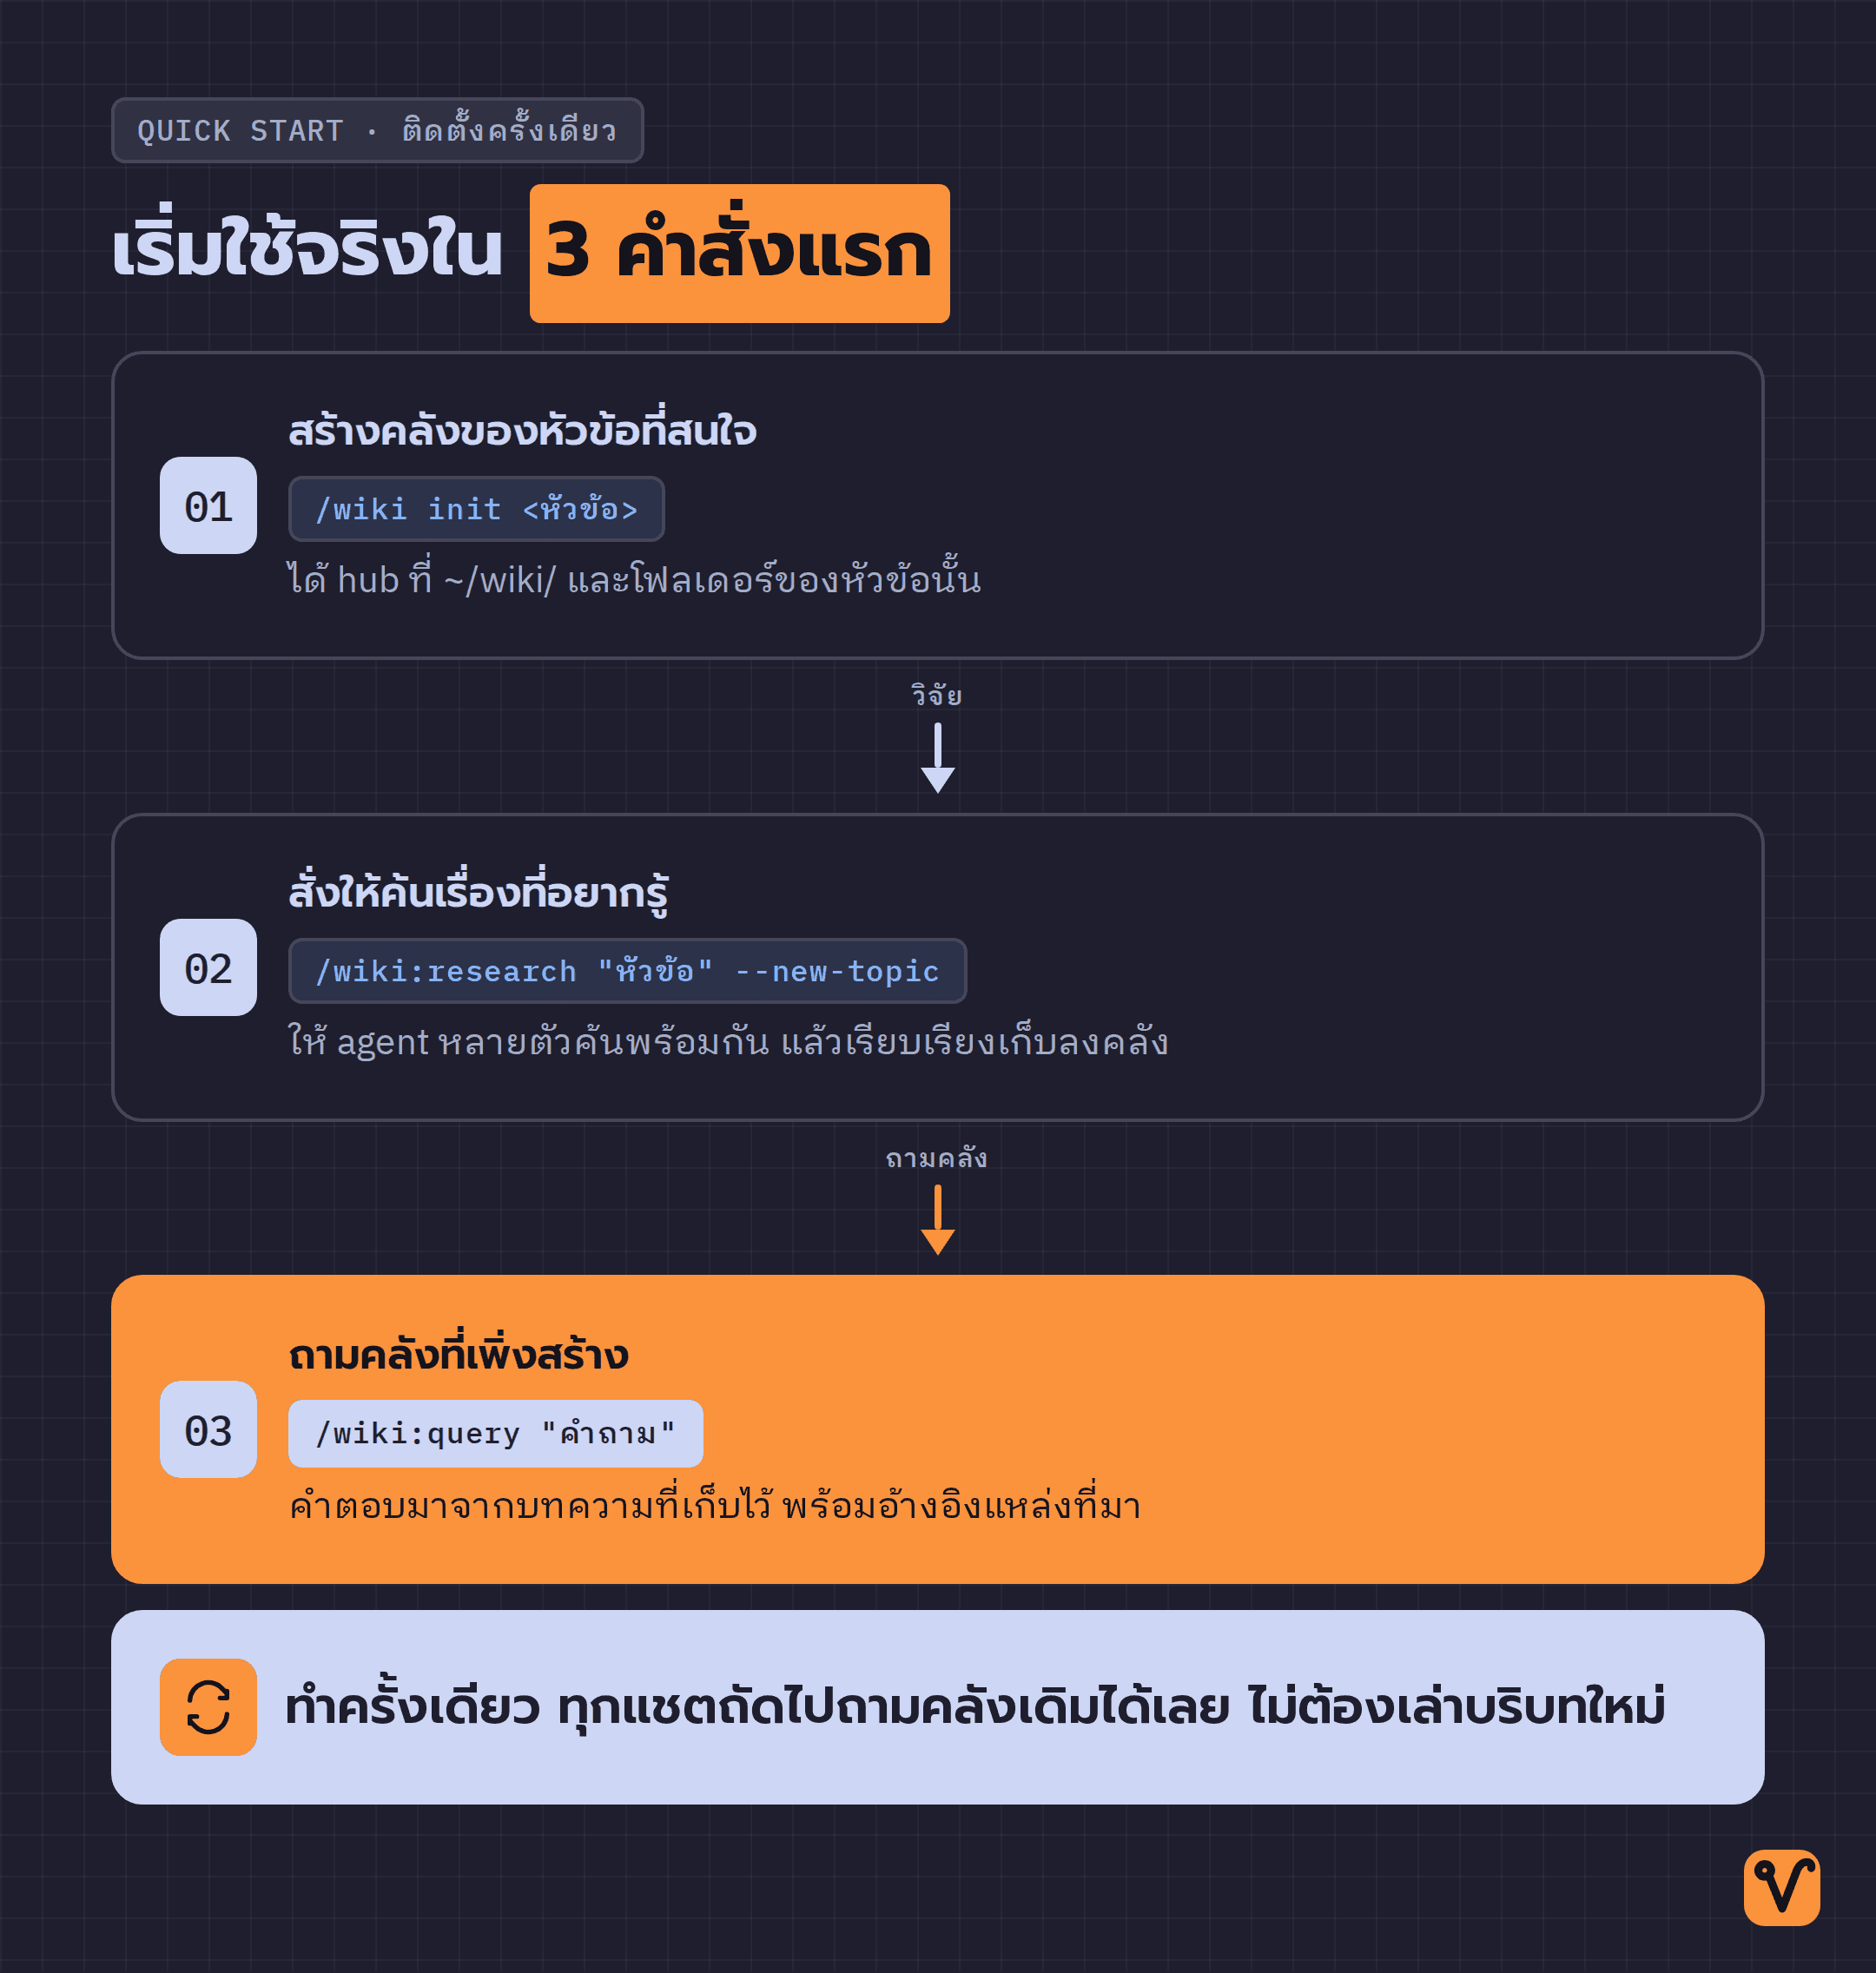
เมื่อติดตั้งเรียบร้อยแล้ว สามารถเริ่มต้นใช้งานได้ผ่าน 3 คำสั่งพื้นฐาน
- สร้างคลังความรู้: พิมพ์คำสั่ง
/wiki init <ชื่อหัวข้อ>ระบบจะสร้างโฟลเดอร์หลักที่~/wiki/พร้อมโฟลเดอร์สำหรับหัวข้อนั้นที่~/wiki/topics/<ชื่อหัวข้อ>/ - สั่งค้นคว้าข้อมูล: พิมพ์คำสั่ง
/wiki:research "หัวข้อที่ต้องการศึกษา" --new-topicระบบจะกระจายงานให้ agent หลายตัวช่วยกันค้นหาข้อมูลรอบด้าน และเรียบเรียงผลลัพธ์ลงเป็นบทความในคลัง - สืบค้นข้อมูลในคลัง: พิมพ์คำสั่ง
/wiki:query "คำถามที่ต้องการทราบ"คำตอบที่ได้จะถูกประมวลผลจากคลังบทความที่บันทึกไว้ พร้อมระบุแหล่งอ้างอิงอย่างชัดเจน
ตัวอย่างการใช้งาน เช่น หากต้องการให้ agent มีความเข้าใจเรื่องการตั้งค่าระบบ deploy ของโปรเจกต์ สามารถสั่ง /wiki init deploy-notes แล้วตามด้วย /wiki:research "วิธี deploy โปรเจกต์ Next.js บน VPS" --new-topic เพียงครั้งเดียว หลังจากนั้นในทุกบทสนทนาที่เกี่ยวกับงาน deploy ก็สามารถใช้คำสั่ง /wiki:query เพื่อดึงข้อมูลเดิมมาใช้งานได้ทันทีโดยไม่ต้องอธิบายบริบทใหม่ซ้ำๆ
ระบบวิจัยคู่ขนานพร้อมประเมินความน่าเชื่อถือ
กระบวนการค้นคว้าข้อมูลคือหัวใจสำคัญของคุณภาพเนื้อหา เมื่อสั่งรัน /wiki:research ระบบจะส่ง agent ย่อยหลายตัวออกไปทำงานพร้อมกัน โดยแต่ละตัวจะวิเคราะห์หัวข้อจากหลากหลายมิติ ทั้งมุมมองเชิงวิชาการ เทคนิคเชิงลึก การนำไปใช้จริงในโปรดักชัน ข่าวสารอัปเดตล่าสุด รวมถึงมุมมองที่ตั้งใจโต้แย้ง เพื่อป้องกันการสรุปข้อมูลจากมุมมองด้านเดียว
ในการค้นหารอบมาตรฐานจะใช้ agent จำนวน 5 ตัว และสามารถเพิ่มเป็น 8 หรือ 10 ตัวสำหรับงานที่ต้องการความละเอียดสูง ในแต่ละรอบ agent แต่ละตัวจะค้นหาข้อมูลสองถึงสามครั้ง ดึงเนื้อหาฉบับเต็มมาวิเคราะห์ และให้คะแนนความน่าเชื่อถือของแหล่งข้อมูลตั้งแต่ 1 ถึง 5 ก่อนจะบันทึกเข้าสู่คลังความรู้
นอกจากนี้ยังสามารถตรวจสอบความถูกต้องได้ผ่านคำสั่ง /wiki:audit ซึ่งจะช่วยไล่เรียงเส้นทางการอ้างอิงจากบทความสรุปกลับไปยังแหล่งที่มาต้นฉบับ ช่วยให้มั่นใจได้ว่าคลังความรู้ที่ขยายตัวขึ้นนั้นมีที่มาที่ไปที่ตรวจสอบได้เสมอ
การรักษาบริบทข้ามเซสชันการทำงาน
นอกเหนือจากคลังความรู้หลัก ระบบยังมีกลไก session memory ที่คอยบันทึกสรุปบริบทการทำงานโดยตัดข้อมูลส่วนบุคคลหรือข้อมูลที่มีความละเอียดอ่อนออกให้อัตโนมัติ เมื่อเซสชันแชตถูกตัดทอนหรือปิดโปรแกรมไป การเปิดกลับมาใหม่จะสามารถดึงบริบทเดิมกลับมาทำงานต่อได้อย่างราบรื่น
ระบบยังมีเลเยอร์พิเศษที่คอยตรวจจับคำสั่งแก้ไขหรือข้อกำหนดเฉพาะที่เราเคยแจ้งไว้ โดยจะบันทึกเป็นข้อเสนอแนะเพื่อให้เรากดยืนยันก่อนนำเข้าสู่คลังความรู้ถาวร ส่วนบทสนทนาทั่วไป เช่น คำทักทายหรือการขอบคุณ ระบบจะคัดกรองออกให้อัตโนมัติ เพื่อรักษาให้คลังความรู้มีเฉพาะข้อมูลที่เป็นประโยชน์อย่างแท้จริง
เหมาะกับใคร และคุ้มค่าแค่ไหน
LLM Wiki เหมาะอย่างยิ่งสำหรับผู้ที่ใช้งาน coding agent ในการทำงานจริงเป็นประจำ ไม่ว่าจะเป็น Claude Code, Codex, Cursor หรือเครื่องมืออื่นๆ รวมถึงสาย vibe coding ที่ต้องการสร้างระบบจัดการบริบทโปรเจกต์ของตนเอง ยิ่งใช้งานอย่างต่อเนื่อง คลังความรู้ก็จะยิ่งสะสมบทเรียนและเทคนิคสำคัญไว้มากขึ้น ช่วยให้ agent ทำงานได้แม่นยำและรวดเร็วขึ้นโดยไม่ต้องเริ่มค้นหาใหม่ในทุกๆ วัน
เมื่อคลังเอกสารมีขนาดใหญ่ขึ้น ยังสามารถเชื่อมต่อเข้ากับระบบค้นหาภายในเครื่องอย่าง qmd เพื่อเพิ่มประสิทธิภาพในการสืบค้นข้อมูลความเร็วสูงได้อีกด้วย
สำหรับผู้ที่สนใจที่มาของแนวคิดนี้ สามารถอ่านเพิ่มเติมได้จาก บันทึกไอเดียต้นฉบับของ Karpathy ซึ่งอธิบายถึงเหตุผลที่ AI agent ควรมีระบบ wiki ส่วนตัว
การที่ agent ลืมข้อมูลเมื่อปิดหน้าต่างแชตไม่ใช่ข้อจำกัดที่หลีกเลี่ยงไม่ได้อีกต่อไป เมื่อเราเปลี่ยนมาจัดเก็บองค์ความรู้ไว้ในคลัง Markdown ที่เราเป็นเจ้าของ agent ก็จะไม่ใช่แค่ผู้ช่วยชั่วคราวในแต่ละเซสชัน แต่จะกลายเป็นคู่หูพัฒนาซอฟต์แวร์ที่เติบโตและเรียนรู้ไปพร้อมกับเราในระยะยาว
ที่มา: เอกสารและซอร์สโค้ดจากโครงการโอเพนซอร์ส LLM Wiki
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
สร้าง Claude Skill แบบไม่ต้องรู้โค้ด คู่มือสร้าง Claude Skill ของคุณเองด้วยการคุยกับ Claude Code เป็นภาษาไทย
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ