KVarN กับ EAGLE ทำให้ LLM ในเครื่องตัวเองจุ context มากขึ้น 3-5 เท่า และพ่นโทเคนเร็วขึ้นเกือบเท่าตัว โดยไม่ต้องเปลี่ยนการ์ด
KVarN บีบ KV-cache ใน vLLM ให้รับ context ได้มากขึ้นหลายเท่าด้วย flag เดียว ส่วน EAGLE คือ speculative decoding ที่เพิ่ง merge เข้า llama.cpp เพื่อเร่งความเร็วโทเคน ทั้งคู่ทำงานบนการ์ดใบเดิม ไม่ต้องลงทุนเพิ่ม

KVarN และ EAGLE คือสองเทคนิคใหม่ที่เข้ามาช่วยให้การรันโมเดลภาษาขนาดใหญ่บนเครื่องตัวเอง (Local LLM) สามารถรองรับบริบทขนาดยาวได้มากขึ้นหลายเท่าตัว ควบคู่ไปกับการประมวลผลโทเคนได้รวดเร็วขึ้นอย่างเห็นได้ชัดบนการ์ดจอใบเดิม โดย KVarN เน้นการบีบอัดหน่วยความจำของโมเดลให้จุ context ได้มากขึ้น 3 ถึง 5 เท่า ในขณะที่ EAGLE เข้ามาช่วยเร่งความเร็วในการสร้างคำตอบด้วยเทคนิค Speculative Decoding ที่สั่งให้การ์ดจอประมวลผลล่วงหน้า ทั้งสองวิธีนี้เปิดใช้งานได้ง่ายๆ ด้วยคำสั่งเพียงไม่กี่บรรทัด
ทั้งสองเทคนิคเข้ามาแก้ปัญหาคนละมุมของการรันโมเดลบนเครื่องส่วนตัว ซึ่งมักจะติดคอขวดหลัก 2 เรื่อง คือ ใส่ context ได้ไม่ยาวพอ และความเร็วในการตอบสนองช้า สาเหตุสำคัญมาจาก VRAM บนการ์ดจอมีจำกัด เมื่อเราเปิดบทสนทนายาวๆ หรือป้อนเอกสารเข้าไปทั้งไฟล์ ส่วนที่เรียกว่า KV-cache (หน่วยความจำชั่วคราวที่โมเดลใช้จดจำบริบทที่อ่านไปแล้วระหว่างการพิมพ์ตอบ) จะขยายตัวจนเต็มความจุการ์ดจอ ส่งผลให้เราต้องคอยตัดทอนข้อความให้สั้นลง หรือต้องยอมให้ความเร็วในการตอบตกลงไปเรื่อยๆ
คอขวดแรกคือหน่วยความจำ ไม่ใช่ความเร็ว
ทุกครั้งที่โมเดลกำลังสร้างคำตอบ มันต้องบันทึกสิ่งที่อ่านและประมวลผลไปแล้วลงใน KV-cache เพื่อที่จะไม่ต้องคำนวณซ้ำตั้งแต่ต้น ยิ่งใส่ข้อความยาว ขนาดของ cache ก็ยิ่งโตขึ้นตาม และกินพื้นที่ VRAM โดยตรง เมื่อพื้นที่ cache เต็ม การ์ดจอก็ไม่สามารถรับข้อมูลเพิ่มได้ แม้พลังการคำนวณของชิปจะยังเหลืออยู่ก็ตาม
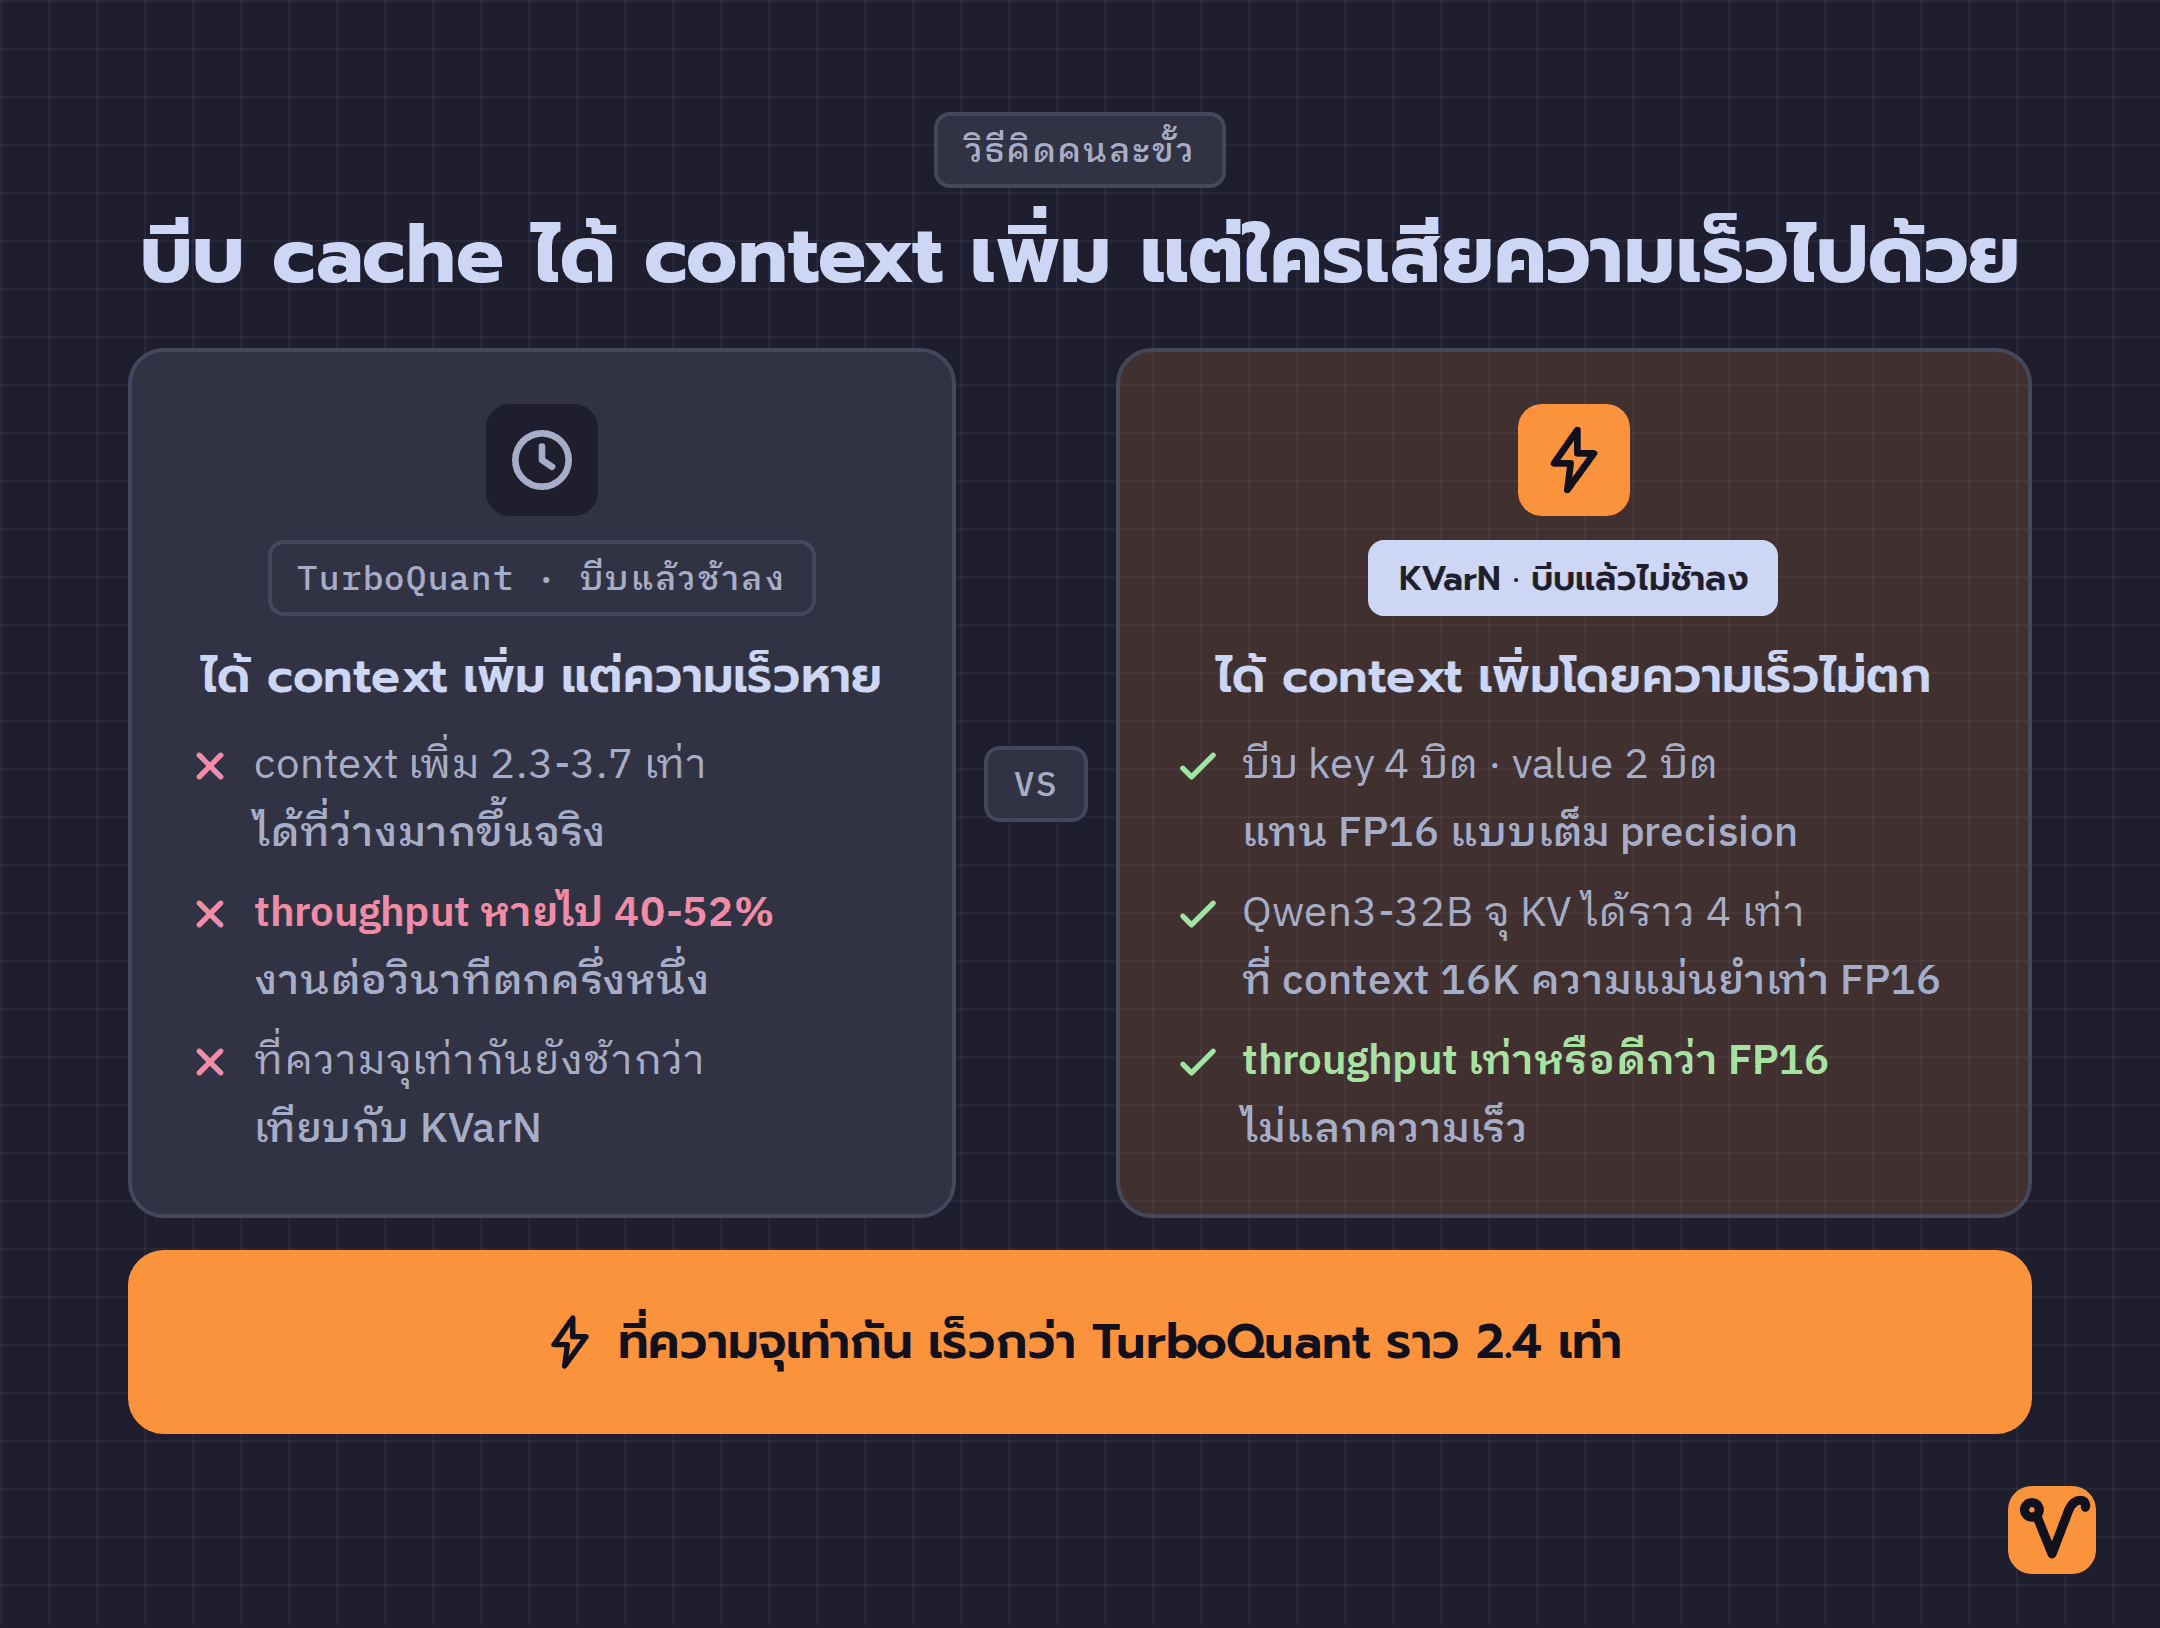
KVarN เข้ามาแก้ปัญหานี้ด้วยการทำ Quantization ให้กับ KV-cache นั่นคือการจัดเก็บข้อมูลด้วยจำนวนบิตที่น้อยลงแทนที่จะใช้ความละเอียดระดับ FP16 แบบเต็ม โดย preset มาตรฐานที่ปล่อยออกมาจะใช้ขนาด 4 บิตสำหรับ Key และ 2 บิตสำหรับ Value เมื่อขนาดข้อมูลต่อโทเคนเล็กลง พื้นที่ว่างเท่าเดิมจึงสามารถจุ context ได้ยาวขึ้นหลายเท่า จากผลการทดสอบบนโมเดล Qwen3-32B ที่ context ระดับ 16K พบว่า KVarN สามารถจุ KV-cache ได้มากกว่า FP16 ถึงราว 4 เท่า โดยที่ความแม่นยำในการแก้โจทย์คณิตศาสตร์ชุด AIME25 ยังคงเท่ากับ FP16 และ throughput (จำนวนโทเคนที่ประมวลผลได้ต่อวินาที) ไม่ตกลงเลย
จุดเด่นที่ทำให้ KVarN แตกต่างจากเทคนิค quantization อื่นๆ คือ ปกติแล้วการบีบอัด cache มักจะแลกมาด้วยความเร็วที่ลดลง เช่น เทคนิคอย่าง TurboQuant ช่วยเพิ่ม context ได้ 2.3 ถึง 3.7 เท่า แต่ throughput กลับลดลงถึง 40 ถึง 52% ในขณะที่ KVarN สามารถขยาย context ได้หลายเท่าโดยที่ throughput ไม่ต่ำไปกว่า FP16 และที่ระดับความจุเท่ากันยังทำงานได้เร็วกว่า TurboQuant ประมาณ 2.4 เท่า
คอขวดที่สองคือความเร็ว และการให้การ์ดจอเดาล่วงหน้า
อีกด้านหนึ่งคือความเร็วในการสร้างโทเคน ปัญหาทางสถาปัตยกรรมของการ์ดจอคือ หน่วยประมวลผลสามารถคำนวณตัวเลขได้เร็วกว่าการดึงข้อมูลเข้าออกจากหน่วยความจำอย่างมาก เมื่อรันโมเดลแบบทีละโทเคน การ์ดจอจึงมักต้องเสียเวลารอข้อมูล ทั้งที่ยังมีขุมพลังประมวลผลเหลืออยู่
เทคนิค Speculative Decoding ถูกคิดค้นขึ้นเพื่อนำเวลาว่างของการ์ดจอกลับมาใช้ให้เกิดประโยชน์ โดยใช้โมเดลขนาดเล็กมาช่วยคาดเดาโทเคนถัดไปล่วงหน้าหลายๆ ตัวพร้อมกัน จากนั้นส่งให้โมเดลตัวหลักตรวจสอบความถูกต้องเพียงรอบเดียว หากทายถูก โมเดลจะสามารถสร้างโทเคนได้หลายตัวในรอบเดียวแทนที่จะได้ทีละตัว และหากทายผิด ก็แทบไม่เสียเวลาอะไรเพิ่มเติมเพราะเป็นการใช้งานจังหวะที่การ์ดจอว่างอยู่แล้ว การที่ EAGLE ถูกผนวกเข้าไปใน llama.cpp จึงช่วยเพิ่มความเร็วในการตอบสนองได้อย่างชัดเจนโดยไม่ต้องแก้ไขค่าน้ำหนัก (weights) ของโมเดลเลย
ใน llama.cpp ยังมีตัวเลือกของ Speculative Decoding ให้ปรับใช้ตามประเภทของงาน:
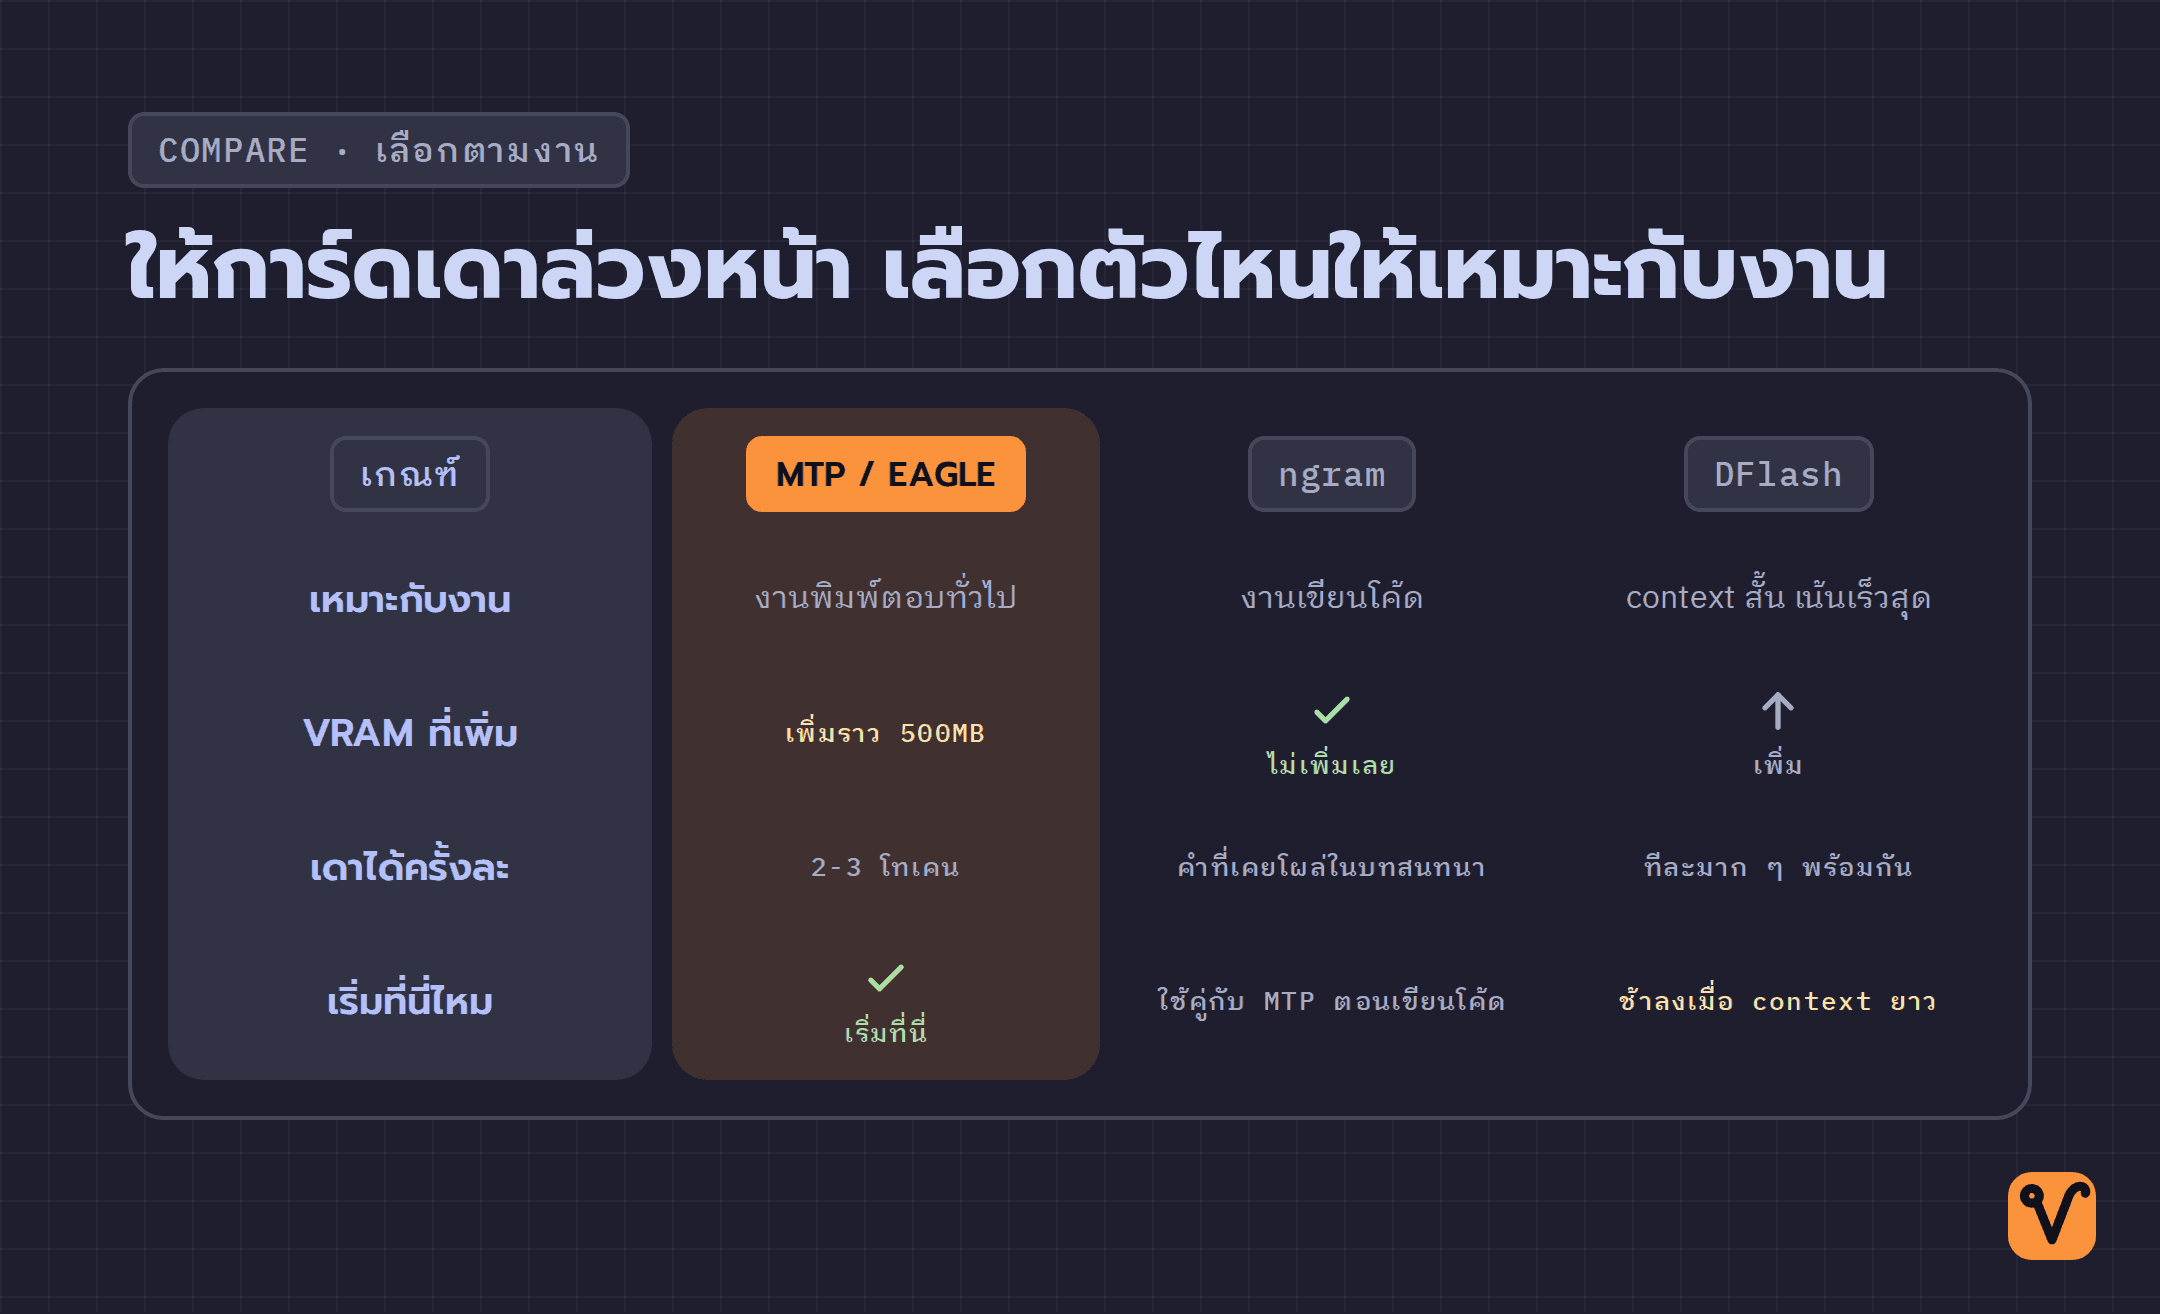
- EAGLE หรือ MTP เหมาะสำหรับการสร้างข้อความทั่วไป โดย MTP จะใช้โมเดลตัวเดาขนาดเล็กที่ฝังมากับโมเดลหลัก กิน VRAM เพิ่มเพียงประมาณ 500MB และสามารถทายคำล่วงหน้าได้ครั้งละ 2 ถึง 3 โทเคน
- ngram เหมาะสำหรับงานเขียนโค้ดโดยเฉพาะ โดยอาศัยการคาดเดาจากรูปแบบคำที่เคยปรากฏในบริบทก่อนหน้า มีจุดเด่นคือไม่กินพื้นที่ VRAM เพิ่มเติมเลย
- DFlash เหมาะสำหรับงานที่บริบทสั้นแต่ต้องการความเร็วสูงสุด โดยเดาโทเคนพร้อมกันทีละมากๆ แต่ประสิทธิภาพจะลดลงเมื่อบริบทเริ่มยาวขึ้น
หากยังไม่แน่ใจว่าควรเริ่มต้นอย่างไร แนะนำให้เลือกใช้ MTP เป็นหลักเพราะใช้ VRAM น้อยและทำงานได้ดีกับงานทั่วไป หากเน้นงานเขียนโค้ดก็สามารถเปิดใช้งานคู่กับ ngram ได้โดยไม่เปลืองทรัพยากรการ์ดจอ
คำสั่งเริ่มต้นใช้งานจริง
ทั้งสองเทคนิคสามารถเปิดใช้งานได้ทันทีโดยไม่ต้องแปลงโมเดลใหม่ สำหรับ KVarN ซึ่งทำงานบนเอนจิน vLLM สามารถตั้งค่าได้ดังนี้:
- ติดตั้ง KVarN ลงใน vLLM ด้วยคำสั่ง:
VLLM_USE_PRECOMPILED=1 pip install -e .- เมื่อสั่งรันโมเดล ให้เพิ่มพารามิเตอร์ต่อไปนี้:
--kv-cache-dtype kvarn_k4v2_g128 --block-size 128เพียงเพิ่มคำสั่งในข้อที่สอง ตัวระบบก็จะรองรับ context ที่ยาวขึ้นได้ทันที และหากใช้งานบนการ์ดจอเดี่ยวที่มี VRAM จำกัด สามารถเพิ่มออปชัน VLLM_MEMORY_PROFILER_ESTIMATE_CUDAGRAPHS=0 เพื่อช่วยคืนพื้นที่หน่วยความจำให้ใช้งานได้เต็มที่ยิ่งขึ้น
สำหรับฝั่ง llama.cpp สามารถเปิดใช้งาน Speculative Decoding ได้ผ่าน flag --spec-type และหากต้องการผสานหลายรูปแบบเข้าด้วยกัน ก็สามารถระบุคำสั่งซ้อนกันได้ เช่น --spec-type draft-mtp,ngram-mod เพื่อให้ทั้ง MTP และ ngram ร่วมกันคาดเดาคำ
ข้อพิจารณาในการนำไปใช้งานจริง
แม้เทคนิคเหล่านี้จะมีประโยชน์อย่างมาก แต่ก็มีข้อแลกเปลี่ยนที่ต้องทำความเข้าใจ เช่น KVarN เมื่อนำไปใช้กับโมเดลที่มีสถาปัตยกรรมเฉพาะอย่าง GLM-4.7-Flash จะสามารถเพิ่ม context ได้ถึง 2.77 เท่า (จาก 313K เป็น 865K โทเคน) โดยรักษาความแม่นยำไว้ได้เท่าเดิม แม้ว่า throughput อาจลดลงเล็กน้อยเหลือประมาณ 0.94 เท่า ซึ่งถือเป็นข้อแลกเปลี่ยนที่คุ้มค่าเมื่อเทียบกับพื้นที่รับข้อมูลที่เพิ่มขึ้นเกือบ 3 เท่า
ส่วนฝั่ง Speculative Decoding การเปิด MTP จะต้องใช้ VRAM เพิ่มขึ้น และในบางกรณีอาจส่งผลต่อความแม่นยำในการเรียกใช้เครื่องมือ (Tool calling) หรือการประมวลผลภาพ การเลือกใช้งานจึงควรพิจารณาตามลักษณะของงาน และทดสอบวัดประสิทธิภาพจริงก่อนนำไปใช้งานเป็นหลัก
นอกจากนี้ ในการทดสอบเทคนิคบีบอัด cache ควรเน้นการทดสอบสืบค้นข้อมูลจาก context ยาวๆ หลายรอบอย่างต่อเนื่อง เพื่อตรวจดูว่ามีข้อผิดพลาดสะสมหรือไม่ เพราะการทดสอบเพียงรอบเดียวอาจไม่สะท้อนผลลัพธ์ในการใช้งานระยะยาวได้อย่างแท้จริง
การรีดประสิทธิภาพของโมเดลบนเครื่องตัวเอง ไม่จำเป็นต้องจบลงด้วยการเปลี่ยนฮาร์ดแวร์ใหม่เสมอไป แต่เริ่มต้นได้จากการทำความเข้าใจคอขวดของการ์ดจอที่มีอยู่ แล้วเลือกใช้เครื่องมือที่ช่วยปลดล็อกประสิทธิภาพนั้นออกมาให้คุ้มค่าที่สุด
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Vibe Coding สำหรับคนไม่ใช่โปรแกรมเมอร์ ใช้ Claude Code สร้าง landing page, mini app และ prototype จริงโดยไม่ต้องเขียนโค้ด
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Vibecoding · The Developer's Playbook
ฉบับภาษาไทย 10 บท พา dev สร้าง Personal Finance Tracker (LINE OA + AI จัดหมวดอัตโนมัติ) ตั้งแต่โครงโปรเจกต์บรรทัดแรกจนแอปทำงานจริงบน server