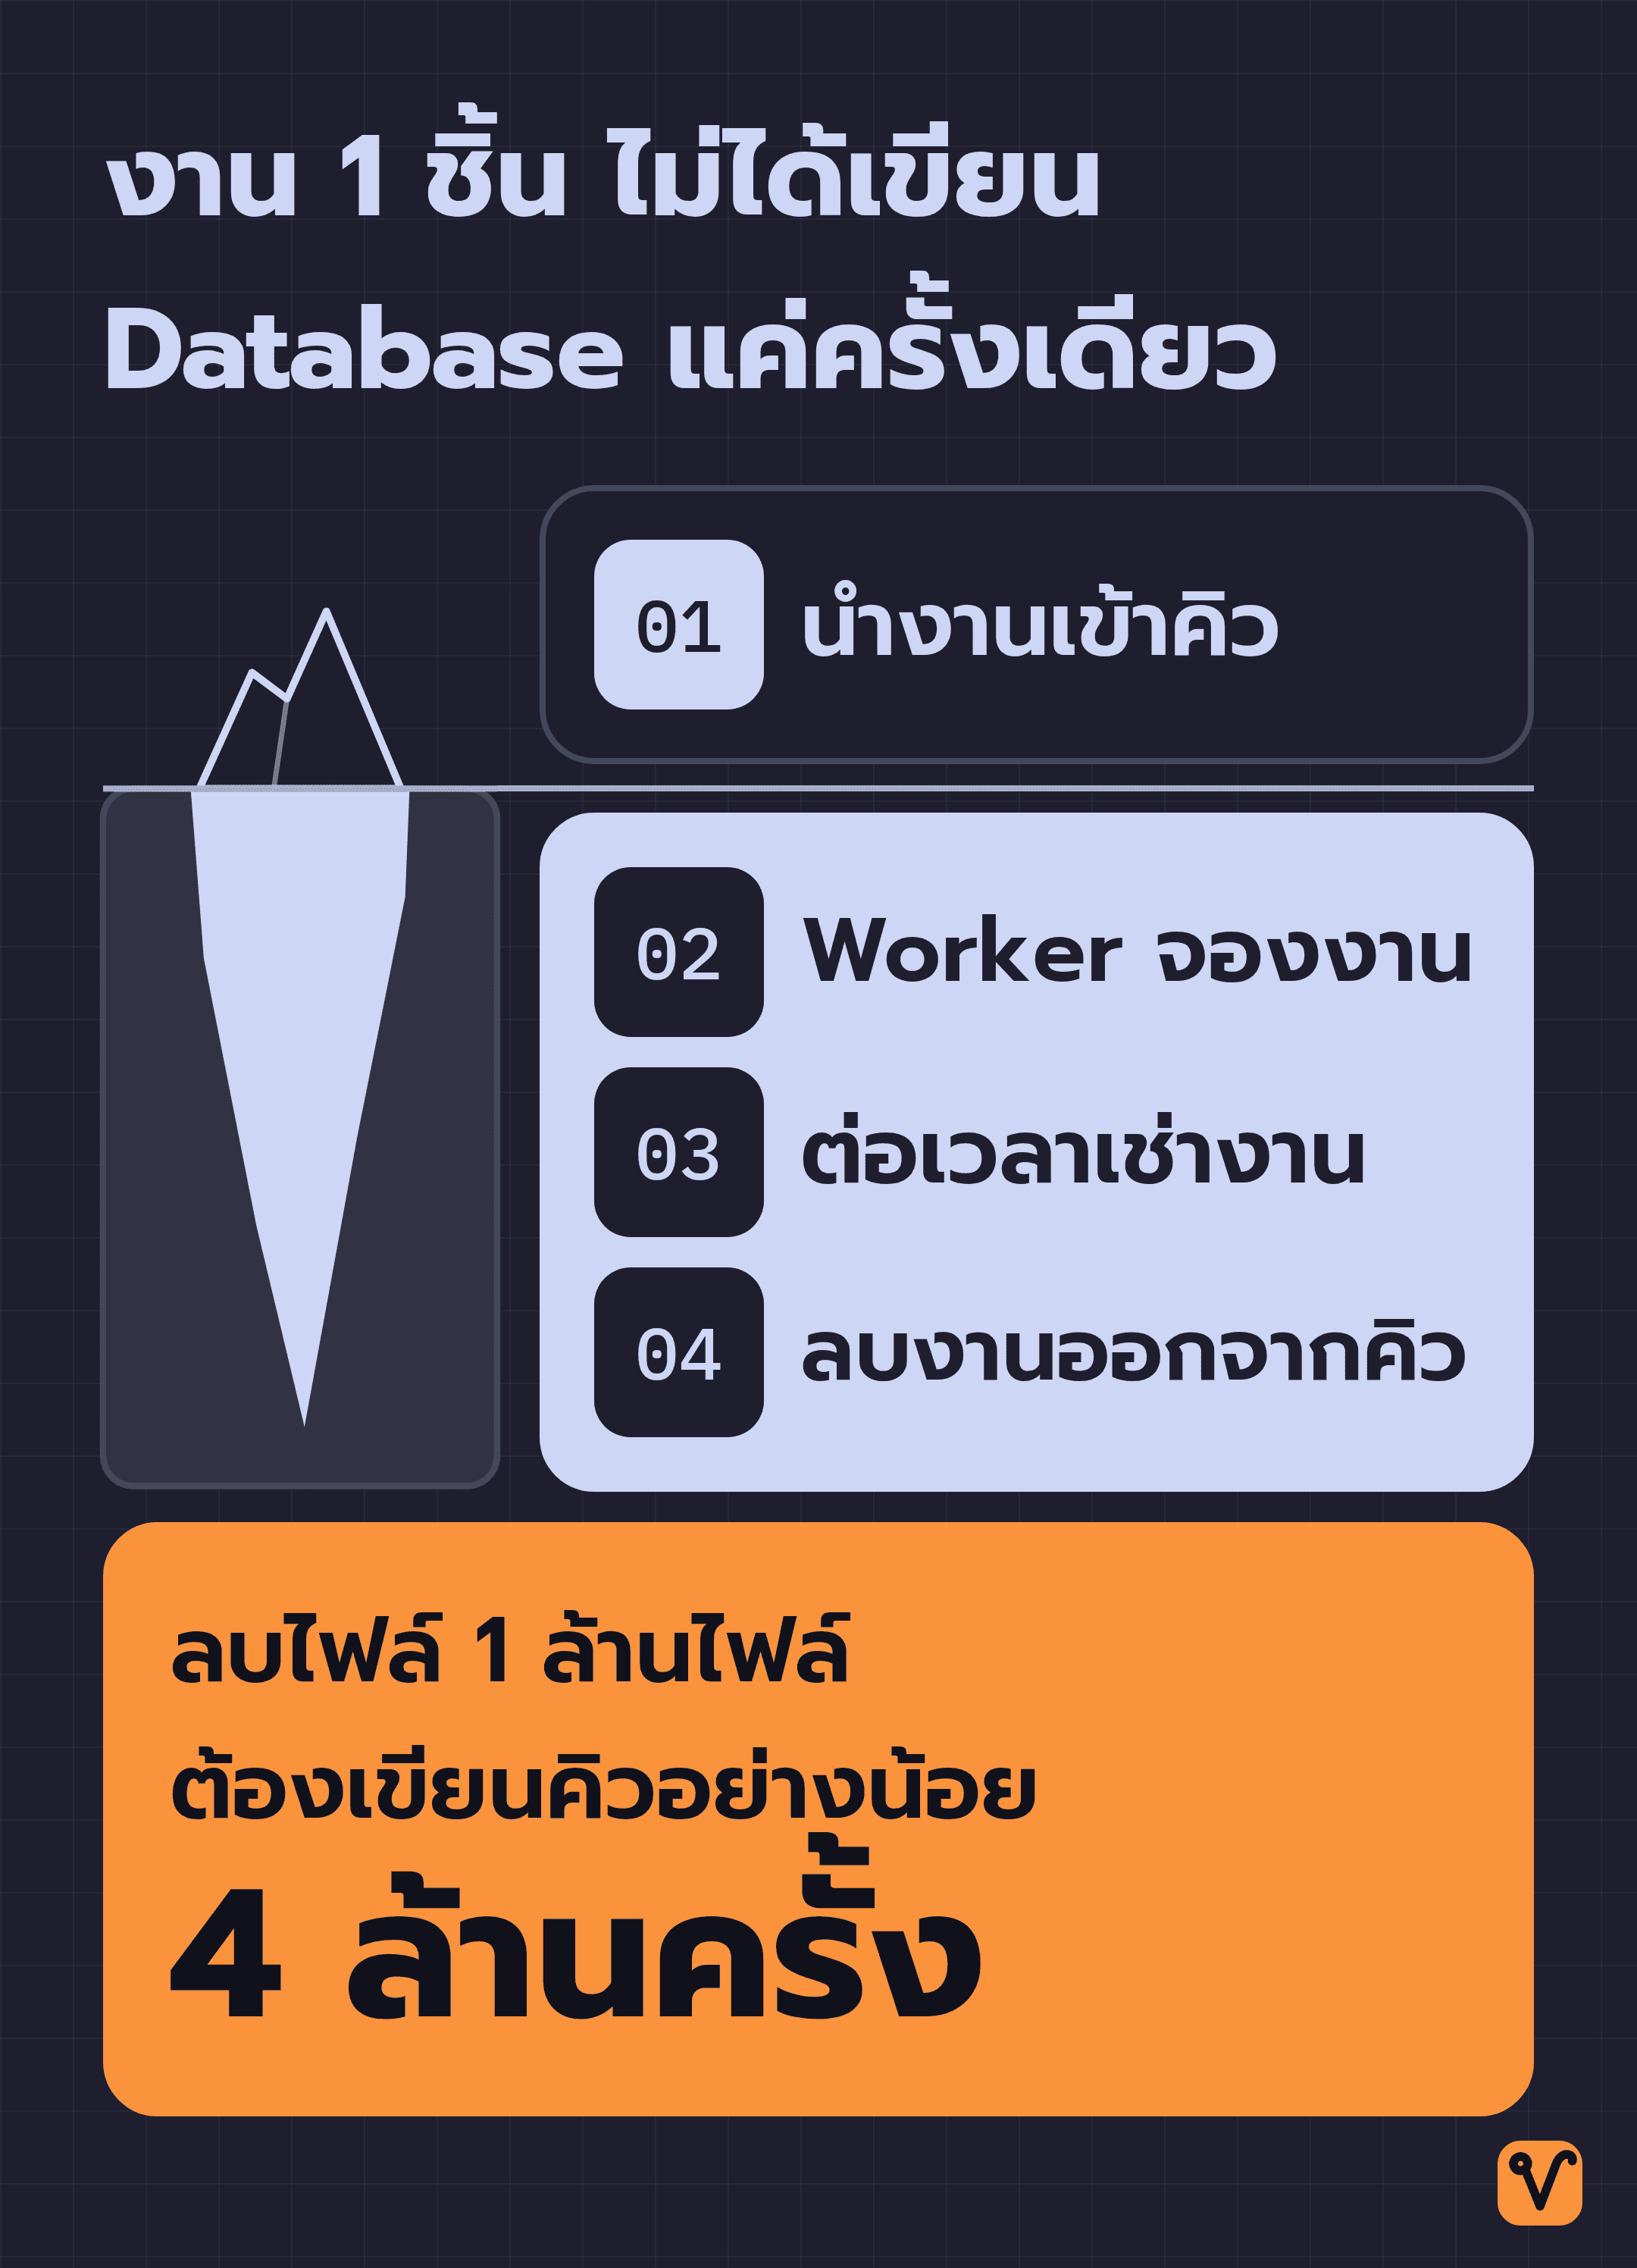
Tigris ใช้ Database เป็นคิวงานมาตลอด ก่อนย้ายงานส่วนใหญ่ไป Kafka ทีมคำนวณคร่าวๆ ว่าคิวแบบเดิมต้องเขียนอย่างน้อย 4 ล้านครั้งเพื่อลบไฟล์ล้านไฟล์
Tigris ใช้ FoundationDB เป็นทั้ง Database และคิวงาน จนคิวเริ่มแย่งทรัพยากรกับผู้ใช้ งานไหนย้ายไป Kafka งานไหนอยู่ต่อ ขึ้นกับว่าถ้าพลาดแล้วจะเสียหายแค่ไหน
เราใช้ Database ที่มีอยู่แล้วทำเป็นคิวงานไปก่อนได้ไหม? สำหรับ Tigris ผู้ให้บริการ Cloud Storage แบบกระจายข้อมูลหลายภูมิภาค ที่รองรับ S3 API คำตอบคือ "ได้" และทีมงานก็ทำแบบนั้นมาตลอดจนถึงวันที่ระบบเริ่มรับไม่ไหว
โจทย์นี้เกิดขึ้นเมื่อระบบเริ่มมีงานเบื้องหลังที่ไม่จำเป็นต้องประมวลผลให้เสร็จทันทีที่ผู้ใช้ส่งคำขอ สำหรับ Tigris คือเมื่อผู้ใช้อัปโหลดไฟล์เข้ามาที่ภูมิภาคหนึ่ง ระบบจะต้องคัดลอกไฟล์นั้นส่งต่อไปยังภูมิภาคอื่นๆ ด้วย งานเบื้องหลังที่ต้องรอทำตามมาเหล่านี้จำเป็นต้องมีที่พักงาน และที่พักงานตรงนั้นก็คือ "คิวงาน"
Database เพียงตัวเดียวที่ Tigris ใช้มาตลอดคือ FoundationDB ซึ่งเป็นฐานข้อมูลแบบ Key-Value โดยข้อมูลทุกอย่างของระบบ ตั้งแต่ข้อมูลลูกค้า ข้อมูลกำกับไฟล์ บันทึกการคัดลอกข้อมูลข้ามภูมิภาค ไปจนถึงคิวงาน ทั้งหมดเก็บรวมไว้ที่นี่ที่เดียว
แต่เมื่อปริมาณงานเพิ่มขึ้นเรื่อยๆ จนระบบคิวเริ่มแย่งทรัพยากรกับคำขอหลักของผู้ใช้งาน ทีมงานจึงตัดสินใจย้ายงานส่วนใหญ่ไปไว้บน Kafka ซึ่งเป็นระบบรับส่งข้อความภายนอกที่แยกต่างหากจาก Database โดยยังคงเหลืองานบางส่วนไว้ที่เดิม เกณฑ์ตัดสินใจแบ่งงานระหว่างสองฝั่งนี้อยู่ที่ว่า "ถ้างานนั้นพลาด ระบบจะเสียหายแค่ไหน"
ทีมงาน Tigris เล่าประสบการณ์นี้ไว้ในบล็อกของบริษัทเมื่อวันที่ 22 กันยายน 2026 พร้อมตัวเลขที่ทีมคำนวณคร่าวๆ ว่า การลบไฟล์ 1 ล้านไฟล์ด้วยระบบคิวแบบเดิม ต้องเขียนคิวลง Database อย่างน้อย 4 ล้านครั้ง
ถ้าคุณกำลังตัดสินใจเลือกวิธีทำคิวให้กับโปรเจกต์ใหม่ หรือรู้สึกว่าคิวใน Database ที่ใช้อยู่เริ่มช้าลง กรณีศึกษานี้จะช่วยให้เห็นทั้งข้อดี ต้นทุนที่แฝงอยู่ และจังหวะที่ควรแยกคิวออกมา รวมถึงคนที่กำลังศึกษาเรื่องการออกแบบระบบหรือ system design ก็จะได้เห็นตัวอย่างการตัดสินใจเลือกสถาปัตยกรรมระบบจากข้อจำกัดจริงในการใช้งาน
บันทึกข้อมูลและคิวงานพร้อมกันในธุรกรรมเดียว
ลองนึกภาพตอนที่ผู้ใช้อัปโหลดไฟล์เข้ามาหนึ่งไฟล์ ระบบจะต้องเขียนข้อมูลสองอย่าง คือ 1) บันทึกว่ามีไฟล์นี้อยู่ในระบบ และ 2) ใส่งานที่ต้องประมวลผลต่อลงในคิว ถ้าคิวงานอยู่ใน Database ตัวเดียวกัน การเขียนทั้งสองอย่างนี้ก็รวบไว้ใน Transaction เดียวกันได้ทันที Database จึงรับประกันได้ว่าจะสำเร็จทั้งคู่ หรือถ้าพังก็จะไม่บันทึกทั้งคู่ ทำให้ไม่มีทางที่ระบบจะบันทึกไฟล์สำเร็จแต่งานในคิวหลุดหายไป
แต่ถ้าแยกคิวไปไว้อีกระบบ การอัปโหลดไฟล์ครั้งเดียวจะต้องเขียนข้อมูลแยกกันสองที่ คือต้องเขียนลง Database หนึ่งครั้ง และส่งงานเข้าระบบคิวอีกหนึ่งครั้ง ซึ่งการทำงานสองขั้นตอนนี้อาจสำเร็จหรือล้มเหลวแยกกันได้ ถ้าขั้นตอนแรกผ่านแต่ขั้นตอนหลังพัง ข้อมูลในระบบกับงานในคิวก็จะไม่ตรงกันทันที ปัญหานี้เรียกว่า dual-write แต่ตราบใดที่ทุกอย่างยังอยู่ใน FoundationDB ปัญหานี้จะไม่เกิดขึ้นเลย
ข้อดีอีกอย่างคือไม่ต้องมีระบบที่สองมาเพิ่มภาระการดูแล ทีม Tigris เล่าว่าในตอนแรกพวกเขาตั้งใจเลี่ยงการใช้ Kafka เพราะการดูแลคลัสเตอร์ของ Kafka ด้วยตัวเองเป็นงานที่ยุ่งยากซับซ้อนมาก
QuiCK: จัดการคิวงานด้วยการเลื่อนเวลาจอง
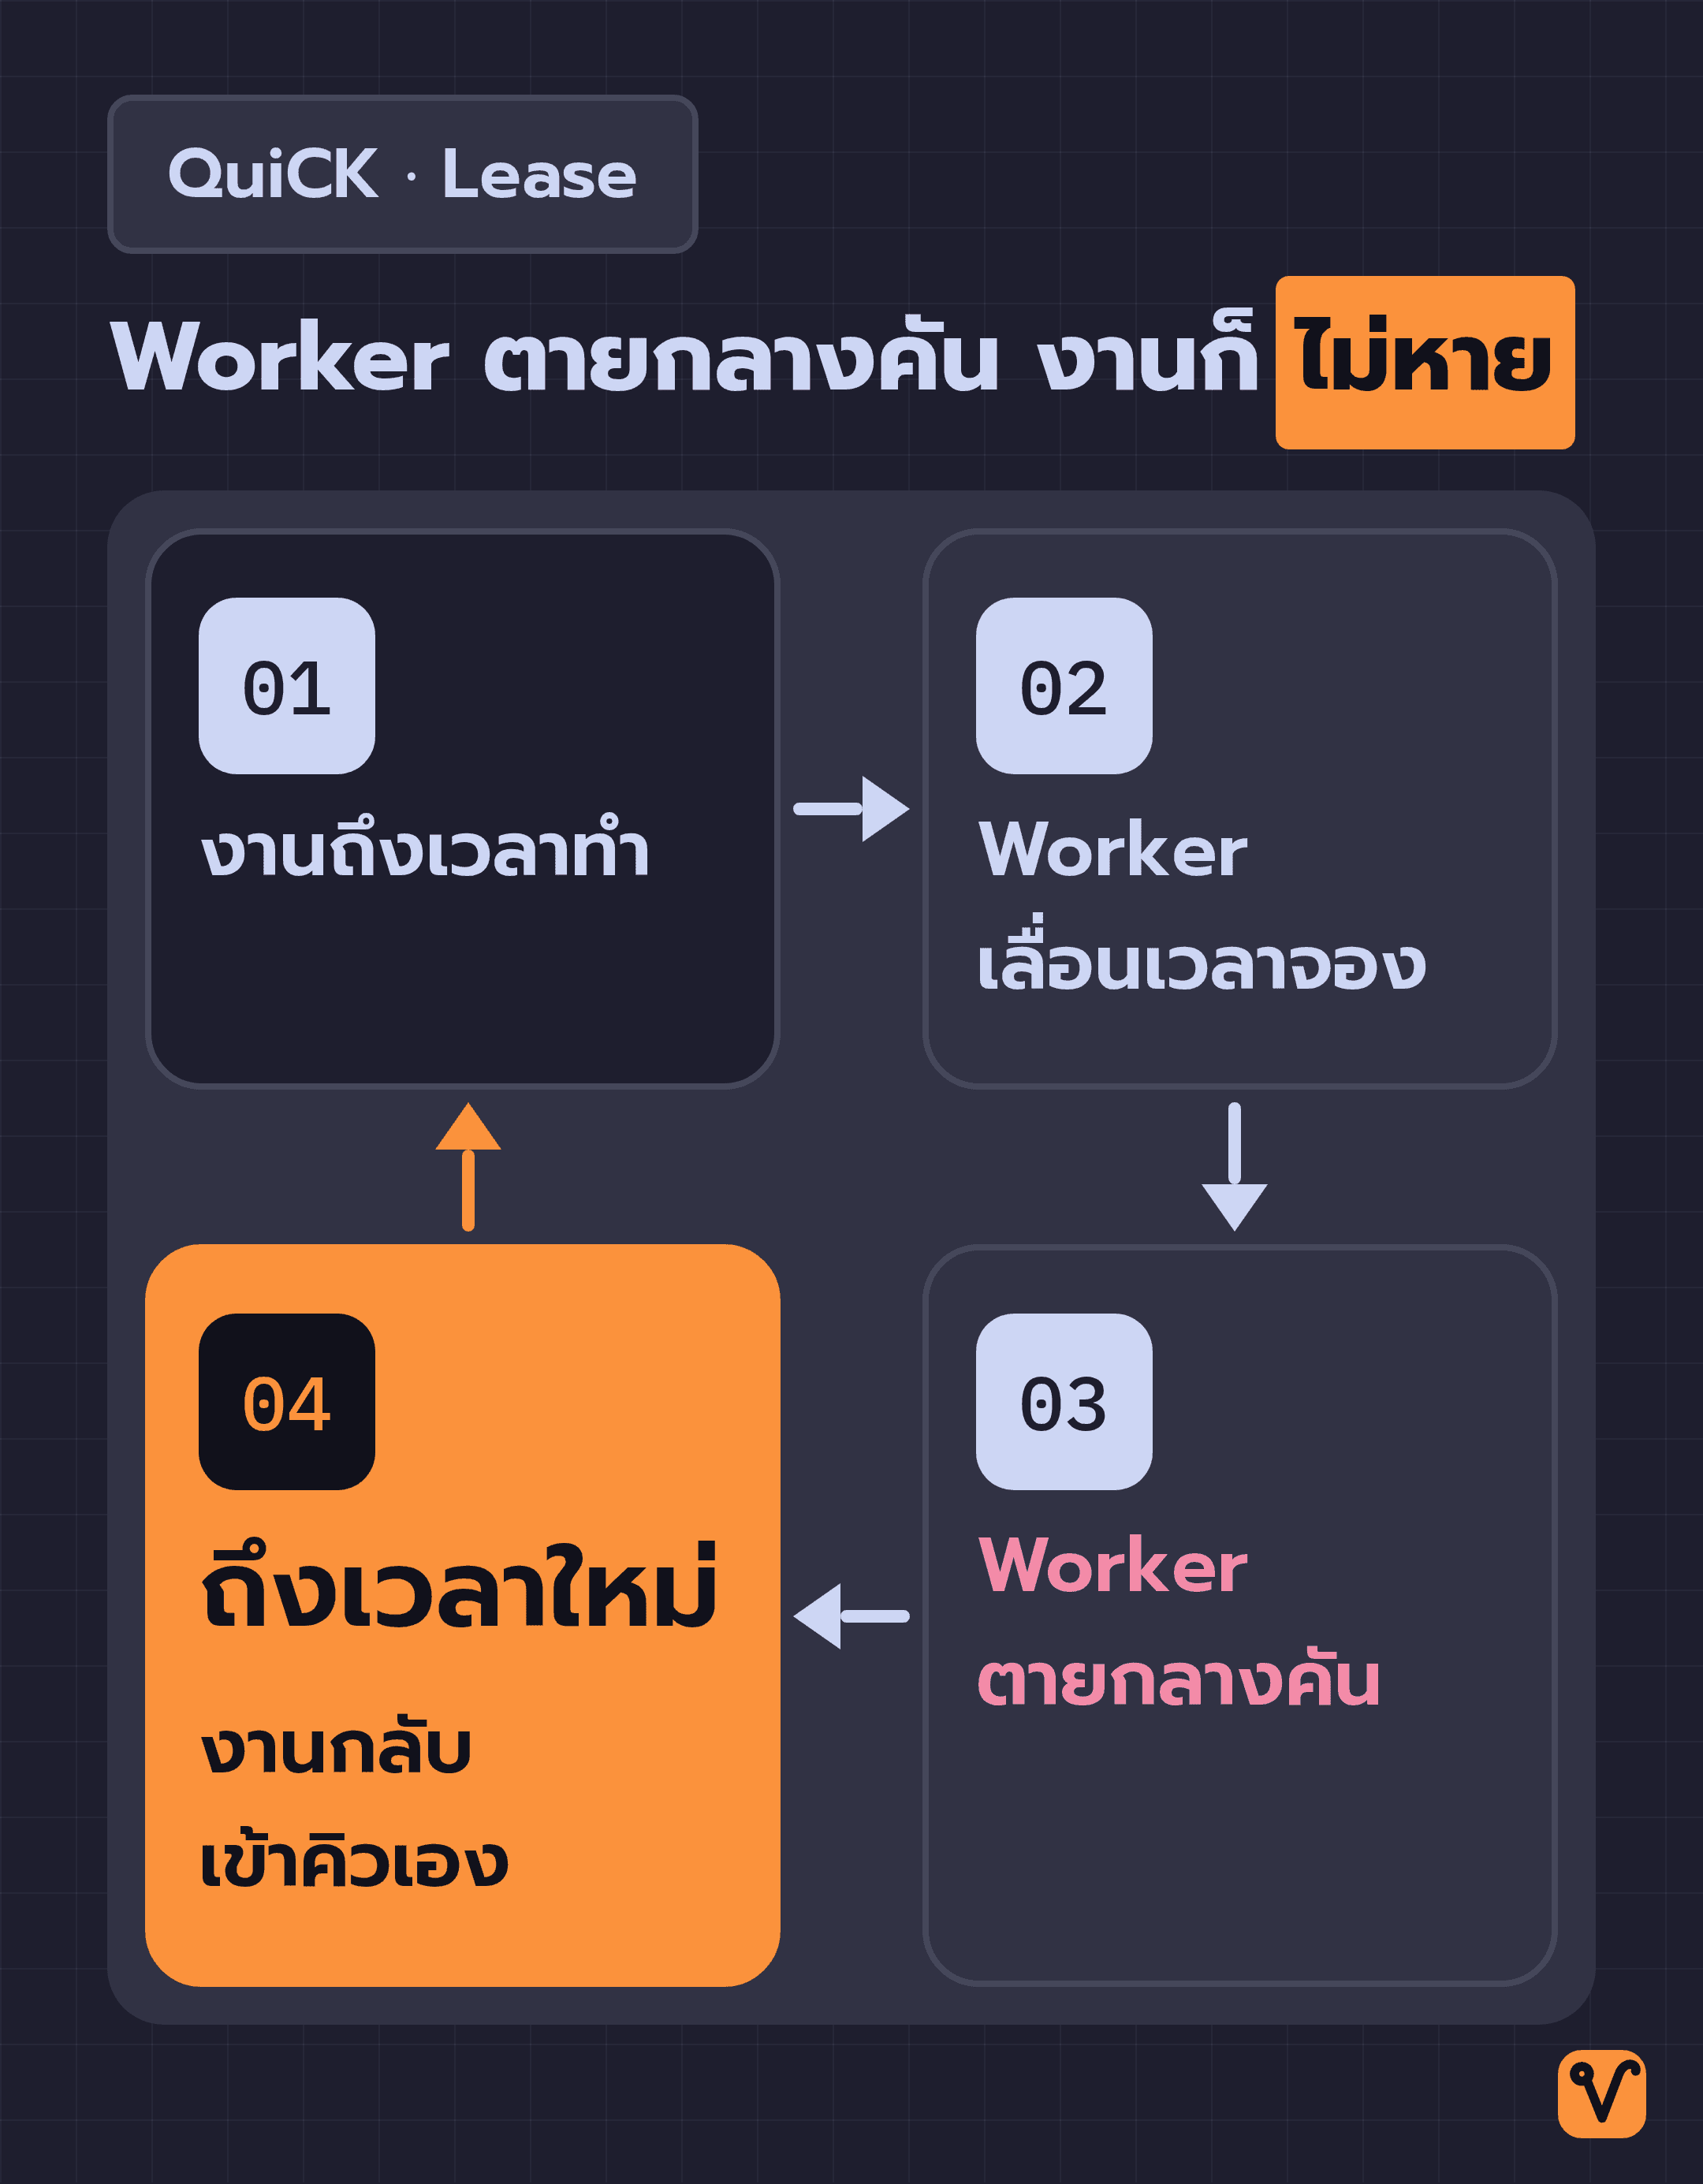
แค่นำคิวมาใส่ไว้ใน Database ยังไม่พอ เพราะระบบคิวแบบพื้นฐานมีจุดอ่อนสำคัญข้อหนึ่ง คือเมื่อ Worker ดึงงานจากคิวไปแล้ว คิวจะลบงานนั้นทิ้งทันที ถ้า Worker ตัวนั้นหยุดทำงานหรือดับไปกลางคัน ก็จะไม่เหลือหลักฐานให้ Worker ตัวอื่นรู้เลยว่ายังมีงานค้างอยู่ งานชิ้นนั้นก็จะหลุดหายไปเฉยๆ
สำหรับ Tigris งานที่หลุดหายส่งผลกระทบต่อผู้ใช้งานจริง เช่น เมื่องานคัดลอกไฟล์ที่อัปโหลดเข้าภูมิภาค Chicago หายไป ผู้ใช้ที่เข้าผ่านภูมิภาค Frankfurt ก็จะไม่เห็นไฟล์นั้นเลย
ทีมงานแก้ปัญหานี้ด้วยการนำแนวคิดของ QuiCK ระบบคิวที่ Apple ออกแบบมาใช้กับ CloudKit มาปรับใช้ หัวใจสำคัญของ QuiCK คือการใส่ "เวลา" เข้าไปเป็นส่วนหนึ่งของ Key ที่ใช้ระบุชื่องาน ทำให้งานทุกชิ้นมีเวลาติดอยู่เสมอว่าสามารถเริ่มประมวลผลได้ตั้งแต่เมื่อไหร่
Worker แต่ละตัวจะคอยค้นหาและถามคิวเป็นระยะว่ามีงานไหนที่ถึงเวลาทำแล้วบ้าง เมื่อเลือกงานได้ Worker จะไม่ลบงานออกจาก Database แต่จะ "เลื่อนเวลา" ของงานนั้นออกไปข้างหน้า ทำให้ Worker ตัวอื่นมองไม่เห็นงานนี้ชั่วคราว เพราะเวลายังมาไม่ถึง
หลังจากนั้นผลลัพธ์จะออกได้สองทาง:
- ถ้าทำงานเสร็จ: Worker จะเป็นตัวลบงานนั้นทิ้งออกจากระบบ
- ถ้า Worker ตายกลางคัน: ก็ไม่ต้องมีใครคอยมาตามแก้ เพราะพอนาฬิกาเดินไปถึงเวลาใหม่ที่ตั้งไว้ งานก็จะปรากฏกลับเข้ามาในคิวให้ Worker ตัวอื่นดึงไปทำต่อได้เอง ส่วนงานไหนที่ต้องใช้เวลานาน Worker ก็จะคอยขยายเวลาหรือต่อสัญญาเช่าให้ตัวเองไปเรื่อยๆ จนกว่าจะเสร็จ
ให้ลองนึกภาพเหมือนการเลือกที่นั่งในแอปจองตั๋วหนัง เมื่อเรากดเลือกที่นั่ง แอปจะล็อกที่นั่งนั้นไว้ให้เราชั่วคราวไม่กี่นาที ถ้าเราไม่จ่ายเงินในเวลาที่กำหนด ระบบก็จะปล่อยที่นั่งกลับไปเป็นที่ว่างให้คนอื่นเลือกได้เอง โดยไม่ต้องมีพนักงานมากดปลดล็อก การเลื่อนเวลาของ Worker ก็คือการกันงานไว้ชั่วคราวในลักษณะเดียวกัน
จุดสำคัญคือ Worker ไม่ได้เป็นเจ้าของงานถาวร แต่แค่ "เช่า" งานไปทำชั่วคราวตามสัญญาเช่าเวลา (Lease) ที่กำหนดไว้สำหรับงานแต่ละประเภท ดังนั้นถ้า Worker ตายไป งานก็จะล่าช้าไปอย่างมากที่สุดแค่หนึ่งรอบระยะเวลาเช่า แต่ไม่มีทางที่งานจะสูญหายแน่นอน
ต้นทุนที่มองไม่เห็นในช่วงเริ่มต้น
แน่นอนว่าข้อดีเหล่านี้ไม่ได้มาฟรีๆ Tigris จึงสรุปต้นทุนและภาระที่ตามมาไว้ 3 ข้อหลัก:
ข้อแรก: งานหนึ่งชิ้นไม่ได้เขียน Database แค่ครั้งเดียว เริ่มจากตอนนำงานเข้าคิว (1 ครั้ง) ตอน Worker จองงาน (1 ครั้ง) ตอนต่อเวลาเช่างาน (อย่างน้อย 1 ครั้ง) และตอนลบงานทิ้งเมื่อทำเสร็จ (1 ครั้ง) ยิ่งบริษัทเพิ่มฟีเจอร์ใหม่ๆ มากขึ้น ปริมาณการเขียนคิวลง Database ก็ยิ่งเพิ่มขึ้นมหาศาลตามไปด้วย
ข้อสอง: การค้นหางานต้องอาศัยการสแกนข้อมูลตามช่วงแบบ Range Scan Worker ทุกตัวต้องคอยอ่านคิวซ้ำๆ เพื่อเช็กว่ามีงานไหนที่ถึงเวลาทำแล้วบ้าง ซึ่งคำสั่งค้นหาข้อมูลเหล่านี้ทำงานอยู่บน Database ตัวเดียวกันกับที่คอยตอบคำขอของผู้ใช้ จึงแย่งทรัพยากรกันตรงๆ
ข้อสาม: ต้องเขียนโค้ดเองทั้งหมด เพราะ Apple เผยแพร่ QuiCK ออกมาเฉพาะในรูปแบบ Research Paper โดยไม่ได้เปิด Source Code ให้เอามาใช้ได้เลย วิศวกรใหม่ที่เข้ามาในทีมจึงต้องมาทำความเข้าใจโค้ดระบบคิวชุดนี้ทั้งหมดตั้งแต่ต้น ทีมงาน Tigris สรุปไว้สั้นๆ เลยว่า ทักษะแบบนี้เรียนรู้ไม่ได้จากแค่การอ่านเอกสารงานวิจัยเพียงอย่างเดียว
นอกจาก 3 ข้อนี้แล้ว ยังมีปัญหาจุกจิกที่ทีมต้องตามแก้อีก 2 เรื่อง:
- ปัญหางานตกหล่นจากการสุ่ม: เดิมที QuiCK ออกแบบให้ Worker ใช้วิธีสุ่มหยิบงาน เพื่อลดโอกาสที่ Worker สองตัวจะหยิบงานชิ้นเดียวกันชนกัน แต่การสุ่มก็ทำให้มีงานบางชิ้นที่โชคร้าย ไม่มีใครสุ่มโดนสักที Tigris จึงเลิกสุ่ม แล้วแบ่งงานออกเป็นช่องคู่ขนานที่เรียกว่า Lanes โดยใช้ค่า Hash ของชื่องานกระจายงานลงแต่ละช่อง Worker แต่ละตัวรับผิดชอบแค่ไม่กี่ช่อง และเมื่อการจองงานแต่ละครั้งเปลี่ยนค่าเวลาในชื่องาน งานจึงย้ายช่องไปเรื่อยๆ ไม่ติดค้างอยู่ในช่องเดิม
- นาฬิกาของทุกเครื่องต้องตรงกันเสมอ: เพราะทั้งชื่องานและระบบคิวพึ่งค่าเวลา (Timestamp) เป็นหลัก นาฬิกาของเซิร์ฟเวอร์ทุกเครื่องในระบบจึงต้องตรงกันเสมออย่างเคร่งครัด
วันที่ FoundationDB เริ่มรับการเขียนไม่ไหว
ต้นทุนเรื่องการเขียนข้อมูลคือจุดที่พาระบบไปถึงขีดจำกัด เพราะ FoundationDB รับมือกับการเขียนต่อเนื่องปริมาณมากในคลัสเตอร์เดียวได้ไม่ดี
แม้ FoundationDB จะ Commit ได้เร็วมาก แต่หลังจากนั้น Storage Server ส่วนที่คอยเก็บข้อมูลจริง ยังต้องนำข้อมูลจากบันทึกธุรกรรมไปเขียนลงพื้นที่เก็บจริงและทำ Replication ต่อ ถ้าเครื่องเหล่านี้บันทึกข้อมูลตามไม่ทัน Ratekeeper ตัวควบคุมจังหวะของระบบ จะหน่วงและชะลอคำขอทั้งหมดในระบบให้ช้าลงพร้อมกัน เพื่อรอให้ Storage Server บันทึกข้อมูลได้ทัน
สำหรับ Tigris ทุกครั้งที่ผู้ใช้อัปโหลดไฟล์ จะมีงานเขียนอื่นๆ ตามมาอีกหลายทอด และงานทั้งหมดก็ลงมารวมอยู่ที่คลัสเตอร์เดียวกัน พอลูกค้าเริ่มนำข้อมูลมาเก็บมากขึ้น อาการหน่วงนี้ก็เกิดขึ้นบ่อยขึ้นเรื่อยๆ จนลูกค้าเริ่มสังเกตเห็นความล่าช้าในการคัดลอกข้อมูลข้ามภูมิภาคได้เอง
ทางออกจริงๆ มีเพียง 2 ทาง คือ 1) แยก FoundationDB ออกเป็นหลายคลัสเตอร์ หรือ 2) เพิ่มเครื่องเซิร์ฟเวอร์ แต่ทางเลือกหลังติดปัญหาเรื่องค่าใช้จ่ายด้าน RAM ที่แพงมาก จนถึงขั้นที่ทีมต้องยอมลดสเปก RAM ของเครื่องลงครึ่งหนึ่ง สุดท้าย Tigris จึงยอมนำ Kafka เข้ามารับหน้าที่คิวงาน ทั้งที่ตอนแรกตั้งใจหลีกเลี่ยงมาตลอด
งานไหนย้ายไป Kafka งานไหนควรอยู่ที่เดิม
Tigris ไม่ได้ทิ้งระบบคิวใน FoundationDB ไปทั้งหมด คิวเดิมยังคงทำงานอยู่ แต่ทีมงานแบ่งงานในระบบออกเป็น 3 กลุ่มตามความเหมาะสม:
| กลุ่มงาน | คิวอยู่ที่ไหน | เหตุผล |
|---|---|---|
| งานที่เกิดจากคำสั่ง S3 API หรือจากเหตุการณ์ต่างๆ ในระบบ | Kafka | ย้ายออกไปแล้วช่วยประหยัดปริมาณการเขียนลง Database ได้มากที่สุด |
| งานที่ต้องคอยสแกนหา เช่น ไฟล์ที่หมดอายุตาม TTL หรือไฟล์ที่ต้องเปลี่ยนสถานะตามวงจรอายุข้อมูล (Lifecycle) | FoundationDB ยังเป็นตัวสแกนหา แต่ส่งงานที่พบไปเข้าคิวที่ Kafka | ยังใช้ Database ค้นหาข้อมูลเหมือนเดิม แต่ย้ายภาระการจัดการคิวออกไป |
| การคัดลอกข้อมูลข้ามภูมิภาคด้วย Replication | FoundationDB | เพื่อหลีกเลี่ยงปัญหา Dual-write และใช้การเขียนที่ประหยัดได้จากงานกลุ่มอื่นมารองรับงานสำคัญกลุ่มนี้แทน |
แค่ลบไฟล์ 1 ไฟล์ ต้องเขียน FoundationDB กี่ครั้ง?
ทีมงานยก "กระบวนการลบไฟล์" มาเป็นตัวอย่างที่เห็นภาพชัดที่สุดว่าประหยัดการเขียนไปได้มากแค่ไหน
ในระบบขนาดใหญ่แบบ Tigris การสั่งลบไฟล์ไม่ได้ลบข้อมูลจริงทิ้งทันที แต่ระบบจะเขียน Tombstone ทับไว้ก่อนเพื่อระบุว่าไฟล์นี้ถูกลบแล้ว แล้วค่อยมีกระบวนการตามมาเก็บกวาดข้อมูลจริงทีหลัง
การเก็บกวาดข้อมูลจะแบ่งออกเป็น 2 ชั้น:
- งานประจำระดับ Bucket: คอยสแกนหา Tombstone ที่พ้นระยะเวลาเก็บรักษาแล้ว
- งานเก็บกวาดรายไฟล์ (1 งานต่อ 1 Tombstone): คอยตรวจสอบความถูกต้องอีกครั้ง ก่อนลบ Tombstone พร้อมข้อมูลไฟล์จริงทิ้งไป
ถ้านับเฉพาะการเขียนลง FoundationDB เพื่อลบ Tombstone เพียง 1 รายการ จะมีขั้นตอนดังนี้:
| การเขียนลง FoundationDB | คิวแบบ QuiCK เดิม | หลังย้ายไปใช้ Kafka |
|---|---|---|
| เขียน Tombstone ทับไฟล์ | มี | มี |
| ส่งงานเก็บกวาดเข้าคิว | มี | ไม่มี |
| Worker จองงานตามสัญญา Lease | มี | ไม่มี |
| Worker ต่อเวลาจอง (อย่างน้อย 1 ครั้ง) | มี | ไม่มี |
| ลบงานออกจากคิวเมื่อเสร็จ | มี | ไม่มี |
| ลบ Tombstone พร้อมข้อมูลจริง | มี | มี |
| รวมการเขียนต่อไฟล์ | 6 ครั้ง | 2 ครั้ง |
จะเห็นว่า 4 ใน 6 ครั้งที่เกิดขึ้น เป็นการเขียนเพื่อจัดการตัวคิวเองล้วนๆ และตัวเลขนี้ยังไม่นับงานประจำระดับ Bucket ที่ต้องมาคอยสแกนหา Tombstone ซึ่งต้องเขียนข้อมูลอีกถึง 4 ครั้ง แถมยังต้องสแกนข้อมูลทั้ง Bucket อีกด้วย
ทีมนำตัวเลข 4 ครั้งต่อไฟล์นี้ไปคำนวณคร่าวๆ ต่อ ได้ผลว่าการลบไฟล์ 1 ล้านไฟล์ต้องเขียนคิวลง Database อย่างน้อย 4 ล้านครั้ง
แต่พอย้ายมาใช้ Kafka งานประจำที่คอยสแกนระดับ Bucket ก็ตัดทิ้งไปได้เลย เซิร์ฟเวอร์ของ Tigris เพียงแค่เขียน Tombstone ลงใน FoundationDB แล้วส่งข้อความเข้าไปยัง Topic ของงานเก็บกวาดใน Kafka
เนื่องจากข้อความใน Kafka เรียงตามลำดับเวลาของการลบอยู่แล้ว ฝั่ง Worker จึงแค่อ่านไล่จากข้อความเก่าสุดไปเรื่อยๆ โดยมี Offset ทำหน้าที่แทนการเลื่อนเวลาจองของ QuiCK ได้ทันที ทำให้ไม่ต้องเขียนข้อมูลอะไรเพิ่มลงใน FoundationDB อีกเลย
แน่นอนว่าสิ่งที่ต้องแลกมาคือ Kafka มีระบบ Transaction แยกต่างหากจาก FoundationDB ทำให้ปัญหา Dual-write ย้อนกลับมาในงานกลุ่มนี้ แต่ทีมงานประเมินแล้วว่า "ถ้าเกิดข้อผิดพลาดขึ้น ระบบจะเสียหายแค่ไหน?" ถ้า FoundationDB เขียน Tombstone สำเร็จ แต่ฝั่ง Kafka พัง ผลที่ตามมาคือ Tombstone จะค้างอยู่ในระบบนานกว่าปกติเท่านั้น ไม่ได้ทำให้ข้อมูลของผู้ใช้สูญหาย ทีมงานจึงยอมรับความเสี่ยงตรงนี้ได้
ในทางกลับกัน งานคัดลอกข้อมูลข้ามภูมิภาคด้วย Replication ยังคงต้องอยู่ใน FoundationDB ตามเดิม เพื่อตัดปัญหา Dual-write เพราะถ้างานส่วนนี้หลุดหายไป ผู้ใช้ใน Frankfurt ก็จะไม่เห็นไฟล์ที่เพิ่งอัปโหลดเข้ามาจาก Chicago เส้นแบ่งการตัดสินใจจึงอยู่ที่ว่า "ถ้างานนั้นพลาด ผู้ใช้จะได้รับความเสียหายแค่ไหน"
เสียงสะท้อนว่า Kafka เองก็ไม่ใช่คิวงานที่ดีเสมอไป
เมื่อวันที่ 30 กันยายน มีคนนำบทความของ Tigris ไปเปิดประเด็นพูดคุยบนเว็บบอร์ด Lobsters ความเห็นในเธรดมาจากคนไม่กี่คน และแย้งกันไปคนละมุม:
- มีคนในเธรดเล่าว่า จากที่เคยเห็นหลายที่นำ Kafka มาทำเป็นคิวงาน มักพบว่ามันไม่ค่อยเข้ากับงานลักษณะนี้เท่าไหร่ หรือไม่ก็ต้องเขียนโค้ดขึ้นมาจัดการเองอีกมาก เพื่อรับมือกับกรณีที่ต้องดึงข้อความมาประมวลผลซ้ำ
- อีกคนชี้ว่า คิวแบบจัดลำดับความสำคัญ (Priority Queue) ทำบน Kafka ได้ไม่ดี ทั้งการแทรกงานที่ด่วนกว่า และการยกเลิกงานเก่าที่ค้างอยู่ในคิวแต่ไม่ต้องทำแล้ว
- บางคนชอบแพลตฟอร์มรับส่งข้อความคู่แข่งอย่าง NATS JetStream มากกว่า เพราะดูแลและใช้งานง่ายกว่า Kafka แทบทุกด้าน
- แต่ก็มีอีกคนที่เล่าว่า เคยใช้ JetStream เป็นคิวงานแล้วเจอปัญหา Throughput หรืออัตราความเร็วในการส่งผ่านข้อมูลต่ำเกินไป (แม้จะยอมรับว่าอาจตั้งค่าไม่ถูกวิธี) และเมื่ออ่านผลวิเคราะห์ NATS 2.12.1 ของ Jepsen ทีมทดสอบระบบ ในประเด็นความถูกต้องของข้อมูลแล้ว ก็ตัดสินใจไม่ใช้
- ขณะที่อีกความเห็นเสนอทางสายกลางที่นำไปปรับใช้ได้จริงว่า ถ้าทีมพร้อมใช้ NATS กับทุกงานแทน Kafka อยู่แล้ว การเลือก NATS ก็ตอบโจทย์ แต่ถ้าในระบบมี Kafka รันอยู่เดิมแล้ว การนำคิวมาไว้ที่ Kafka ย่อมดีกว่าการเพิ่มระบบใหม่ที่ต้องคอยดูแลอีกตัว
- ส่วนข้อโต้แย้งที่ตรงจุดที่สุดบอกว่า บทความนี้ไม่ได้ทำให้เชื่อว่า Database ทั่วไปไม่เหมาะกับการทำคิว แต่ทำให้เชื่อว่า FoundationDB ไม่เหมาะกับงานส่วนใหญ่ อย่างไรก็ดี ในเธรดเดียวกันก็มีคนที่ทุกวันนี้ต้องทนดูแลคิวบน Oracle DB ที่คนก่อนหน้าทำทิ้งไว้ และย้ำว่าไม่เห็นด้วยกับการนำ Database มาทำเป็นคิวงานเลย
เมื่ออ่านความคิดเห็นทั้งสองฝั่งคู่กัน บทเรียนของ Tigris จึงเป็นกรณีศึกษาของ Database ชนิดหนึ่งภายใต้ปริมาณงานระดับหนึ่ง มากกว่าจะสรุปเป็นกฎตายตัวที่ใช้ตัดสินได้กับทุกระบบ
4 คำถามช่วยตัดสินใจ ก่อนเลือกที่วางคิวงาน
จากกรณีศึกษานี้ มี 4 คำถามสำคัญที่ควรใช้ประเมินระบบของคุณ ทั้งตอนเริ่มออกแบบระบบใหม่ และในวันที่คิวเดิมเริ่มช้าลง:
- งานนี้ต้องบันทึกพร้อมข้อมูลหลักในธุรกรรมเดียวกันหรือไม่? ถ้างานหลุดหายแล้วผู้ใช้จะเห็นข้อมูลไม่ครบถ้วน เช่นงานคัดลอกข้อมูลของ Tigris งานนั้นควรอยู่ใน Database เดียวกับข้อมูลหลัก แต่ถ้างานพลาดแล้วส่งผลแค่ช้าลงชั่วคราว เช่นกรณี Tombstone ที่ค้างนานขึ้น ก็แยกออกไปไว้ในคิวภายนอกได้
- ปริมาณงานในคิวเริ่มแย่งทรัพยากรกับผู้ใช้งานหรือยัง? ลองดูว่าการเขียนและการสแกนข้อมูลของคิวเริ่มทำให้คำขอจากผู้ใช้ช้าลงหรือไม่ ในกรณีของ Tigris เมื่อถึงจุดวิกฤต Database จะหน่วงคำขอของทุกคนพร้อมกัน จนลูกค้าเริ่มสังเกตเห็นความช้าได้เอง
- ต้องการจัดลำดับความสำคัญ หรือต้อง Retry (สั่งประมวลผลซ้ำ) ทีละงานแบบละเอียดไหม? ระบบอย่าง QuiCK ใส่ลำดับความสำคัญไว้ในชื่องานได้ และจัดการงานทีละชิ้นผ่านการต่อเวลาเช่าได้อย่างแม่นยำ ขณะที่ในเธรดมีคนเห็นว่าการจัดลำดับความสำคัญของคิวบน Kafka ทำได้ไม่ดี และมีคนเจอว่าต้องเขียนโค้ดจัดการการอ่านข้อความซ้ำเองอีกมาก
- ทีมงานพร้อมดูแลรักษาระบบแค่ไหน? ทุกระบบที่เพิ่มเข้ามาหมายถึงภาระที่ต้องคอยดูแลจัดการต่อ Tigris เลือกเลี่ยง Kafka ในช่วงแรกก็เพราะเหตุนี้ แต่ในทางกลับกัน การเขียนระบบคิวขึ้นมาเองจากเอกสารงานวิจัยวิชาการ ก็เป็นภาระอีกแบบ เพราะคนใหม่ที่เข้าทีมต้องใช้เวลาเรียนรู้โค้ดเฉพาะทางชุดนั้นทั้งหมด
Tigris เองไม่ได้มองว่าการย้ายมา Kafka ครั้งนี้คือคำตอบสุดท้าย ทีมงานระบุว่าทางนี้น่าจะช่วยรองรับการเติบโตไปจนถึงขีดจำกัดถัดไป หรือจนกว่าทีมจะพร้อมลงแรงแยกคลัสเตอร์ของ FoundationDB อย่างจริงจัง
หัวใจสำคัญจึงไม่ใช่การตัดสินว่า "Database" กับ "Kafka" ตัวไหนดีกว่ากัน แต่อยู่ที่ว่าคิวแบบไหนที่ทีมของคุณดูแลไหวกับปริมาณงานจริงในวันนี้ และมีสัญญาณเตือนอะไรบ้างที่จะบอกว่าถึงเวลาย้าย ก่อนที่ลูกค้าจะเริ่มสังเกตเห็นปัญหาความล่าช้าด้วยตัวเอง
ที่มา:
- บทความ We used a database as a message queue. Now we use Kafka. จาก Tigris
- บทความ We used a database as a message queue. Now we use Kafka จาก Lobsters
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin