AIHOT เปิดโค้ดเว็บข่าวที่ AI ให้คะแนนสองรอบก่อนคัด ก๊อปไปทำเว็บข่าวของวงการตัวเองได้ แต่เกณฑ์ว่าข่าวไหนสำคัญต้องเขียนเอง
AIHOT เปิดโค้ดเว็บข่าว AI ทั้งระบบ ให้ก๊อปไปทำเว็บข่าวของวงการตัวเองได้ ส่วนจะคัดข่าวได้แม่นแค่ไหน ขึ้นอยู่กับเกณฑ์ที่คนในวงการต้องเขียนเอง
ข่าวสารในวงการล้นจนอ่านไม่ทัน แถมเรื่องเดียวกันยังวนมาให้เห็นซ้ำๆ จากหลายสิบแหล่ง AIHOT เว็บข่าว AI ภาษาจีน จัดการปัญหานี้ด้วยการให้ AI รับบทเป็นกองบรรณาธิการคอยคัดกรองข่าวให้ทุกวัน
ทุกวันระบบจะดึงข่าวจากแหล่งที่ตั้งไว้ แล้วส่งให้ AI ตรวจสอบและให้คะแนนแยกกัน 2 รอบก่อนคัดเลือก จากนั้น AI จะเขียนพาดหัวและสรุปเนื้อหาให้เอง หากมีข่าวเรื่องเดียวกันจากหลายสำนัก ระบบจะรวมให้เหลือเพียงประเด็นเดียว ส่วนอันดับข่าวฮิตจะนับจากจำนวนแหล่งข่าวที่หยิบเรื่องนั้นไปรายงานจริง และทุก 8 โมงเช้าจะมีบทสรุปข่าวฉบับเช้าออกมาให้อ่านวันละ 1 ฉบับ
ปัจจุบันตัวเว็บ aihot.news เปิดให้อ่านอยู่แล้ว แต่ผู้พัฒนาเปิดโค้ดทั้งระบบเป็นโอเพนซอร์สไว้บน GitHub แพลตฟอร์มรวมโค้ดชื่อดัง ซึ่งมีให้ครบตั้งแต่โค้ดหน้าเว็บ ระบบหลังบ้าน ขั้นตอนการคัดกรองข่าว ไปจนถึง Prompt สำหรับสั่ง AI ทุกชุด และเกณฑ์คะแนนที่ใช้คัดจริง
จนถึงวันที่ 1 ตุลาคม 2026 โปรเจกต์นี้มีคนกดให้ดาวบน GitHub แล้วกว่า 4.4k ครั้ง และมีคนนำโค้ดไปใช้ต่อแล้วกว่า 1.3k ครั้ง
ผู้พัฒนาตั้งใจออกแบบระบบนี้เพื่อให้ทุกคนเปลี่ยนแหล่งข่าวและเกณฑ์การคัดเลือกเป็นของวงการตัวเองได้ ไม่ว่าคุณจะทำงานสายกฎหมาย HR การเงิน หรือทำสื่อเฉพาะทาง ก็สามารถยกโครงสร้างทั้งชุดนี้ไปปรับใช้ได้ทันที
แต่หลังจากอ่านเอกสารทั้งหมดอย่างละเอียด สิ่งสำคัญที่ตัดสินว่าเว็บข่าวแบบนี้จะมีประโยชน์จริงหรือไม่ กลับไม่ได้อยู่ที่ตัวโค้ด แต่อยู่ที่ "เกณฑ์การคัดกรอง" ว่าข่าวแบบไหนสำคัญ และมีแต่คนในวงการเท่านั้นที่รู้ดีที่สุด
ข่าวใน AIHOT ต้องผ่านการประเมิน 2 รอบก่อนขึ้นหน้าเว็บ
กว่าข่าวแต่ละชิ้นจะได้ขึ้นหน้าคัดสรรของ AIHOT จะต้องผ่านกระบวนการหลายขั้นตอน โดยทุกขั้นตอนจะมี Prompt กำกับไว้เฉพาะ ทำให้เราแก้ไขเกณฑ์ได้โดยไม่ต้องแตะโค้ดเลย
ขั้นตอนแรกคือการรับข่าวเข้าระบบ ซึ่งรองรับแหล่งข่าวได้ 6 รูปแบบ ได้แก่ ฟีดข่าว RSS, หน้าเว็บรวมบทความ, ช่องทางเชื่อมต่อข้อมูลอย่าง JSON API, บัญชี X, บัญชีทางการ WeChat Official Account และเนื้อหาที่เจ้าของเว็บเขียนสคริปต์ส่งเข้ามาเอง โดยระบบจะแบ่งระดับความน่าเชื่อถือของแหล่งข่าวทั้งหมด หลักๆ แยกเป็น "แหล่งข่าวทางการต้นฉบับ" กับ "สำนักข่าวทั่วไปและบุคคล"
ข่าวที่มีลิงก์ซ้ำหรือเนื้อหาซ้ำ ระบบจะเก็บไว้เพียงชุดเดียว ส่วนข่าวที่มีแค่หัวข้อหรือบทสรุปสั้นๆ จากฟีด ระบบจะตามไปดึงเนื้อหาจากหน้าเว็บต้นฉบับมาอ่านทั้งหมดก่อนเริ่มตัดสิน
ขั้นตอนที่สองคือการกรองเบื้องต้น ขั้นตอนนี้มีคำถามเดียวคือ "ข่าวนี้เกี่ยวกับวงการหรือไม่" เพื่อเปิดรับข่าวในมุมกว้าง และตัดทิ้งเฉพาะข่าวที่ไม่เกี่ยวข้องอย่างชัดเจน ข่าวที่ถูกตัดทิ้งจะไม่แสดงให้คนอ่านเห็นในหน้าใดเลย ส่วนข่าวที่ผ่านเกณฑ์หรือชิ้นที่ระบบยังไม่แน่ใจ จะได้ไปต่อในขั้นตอนถัดไป
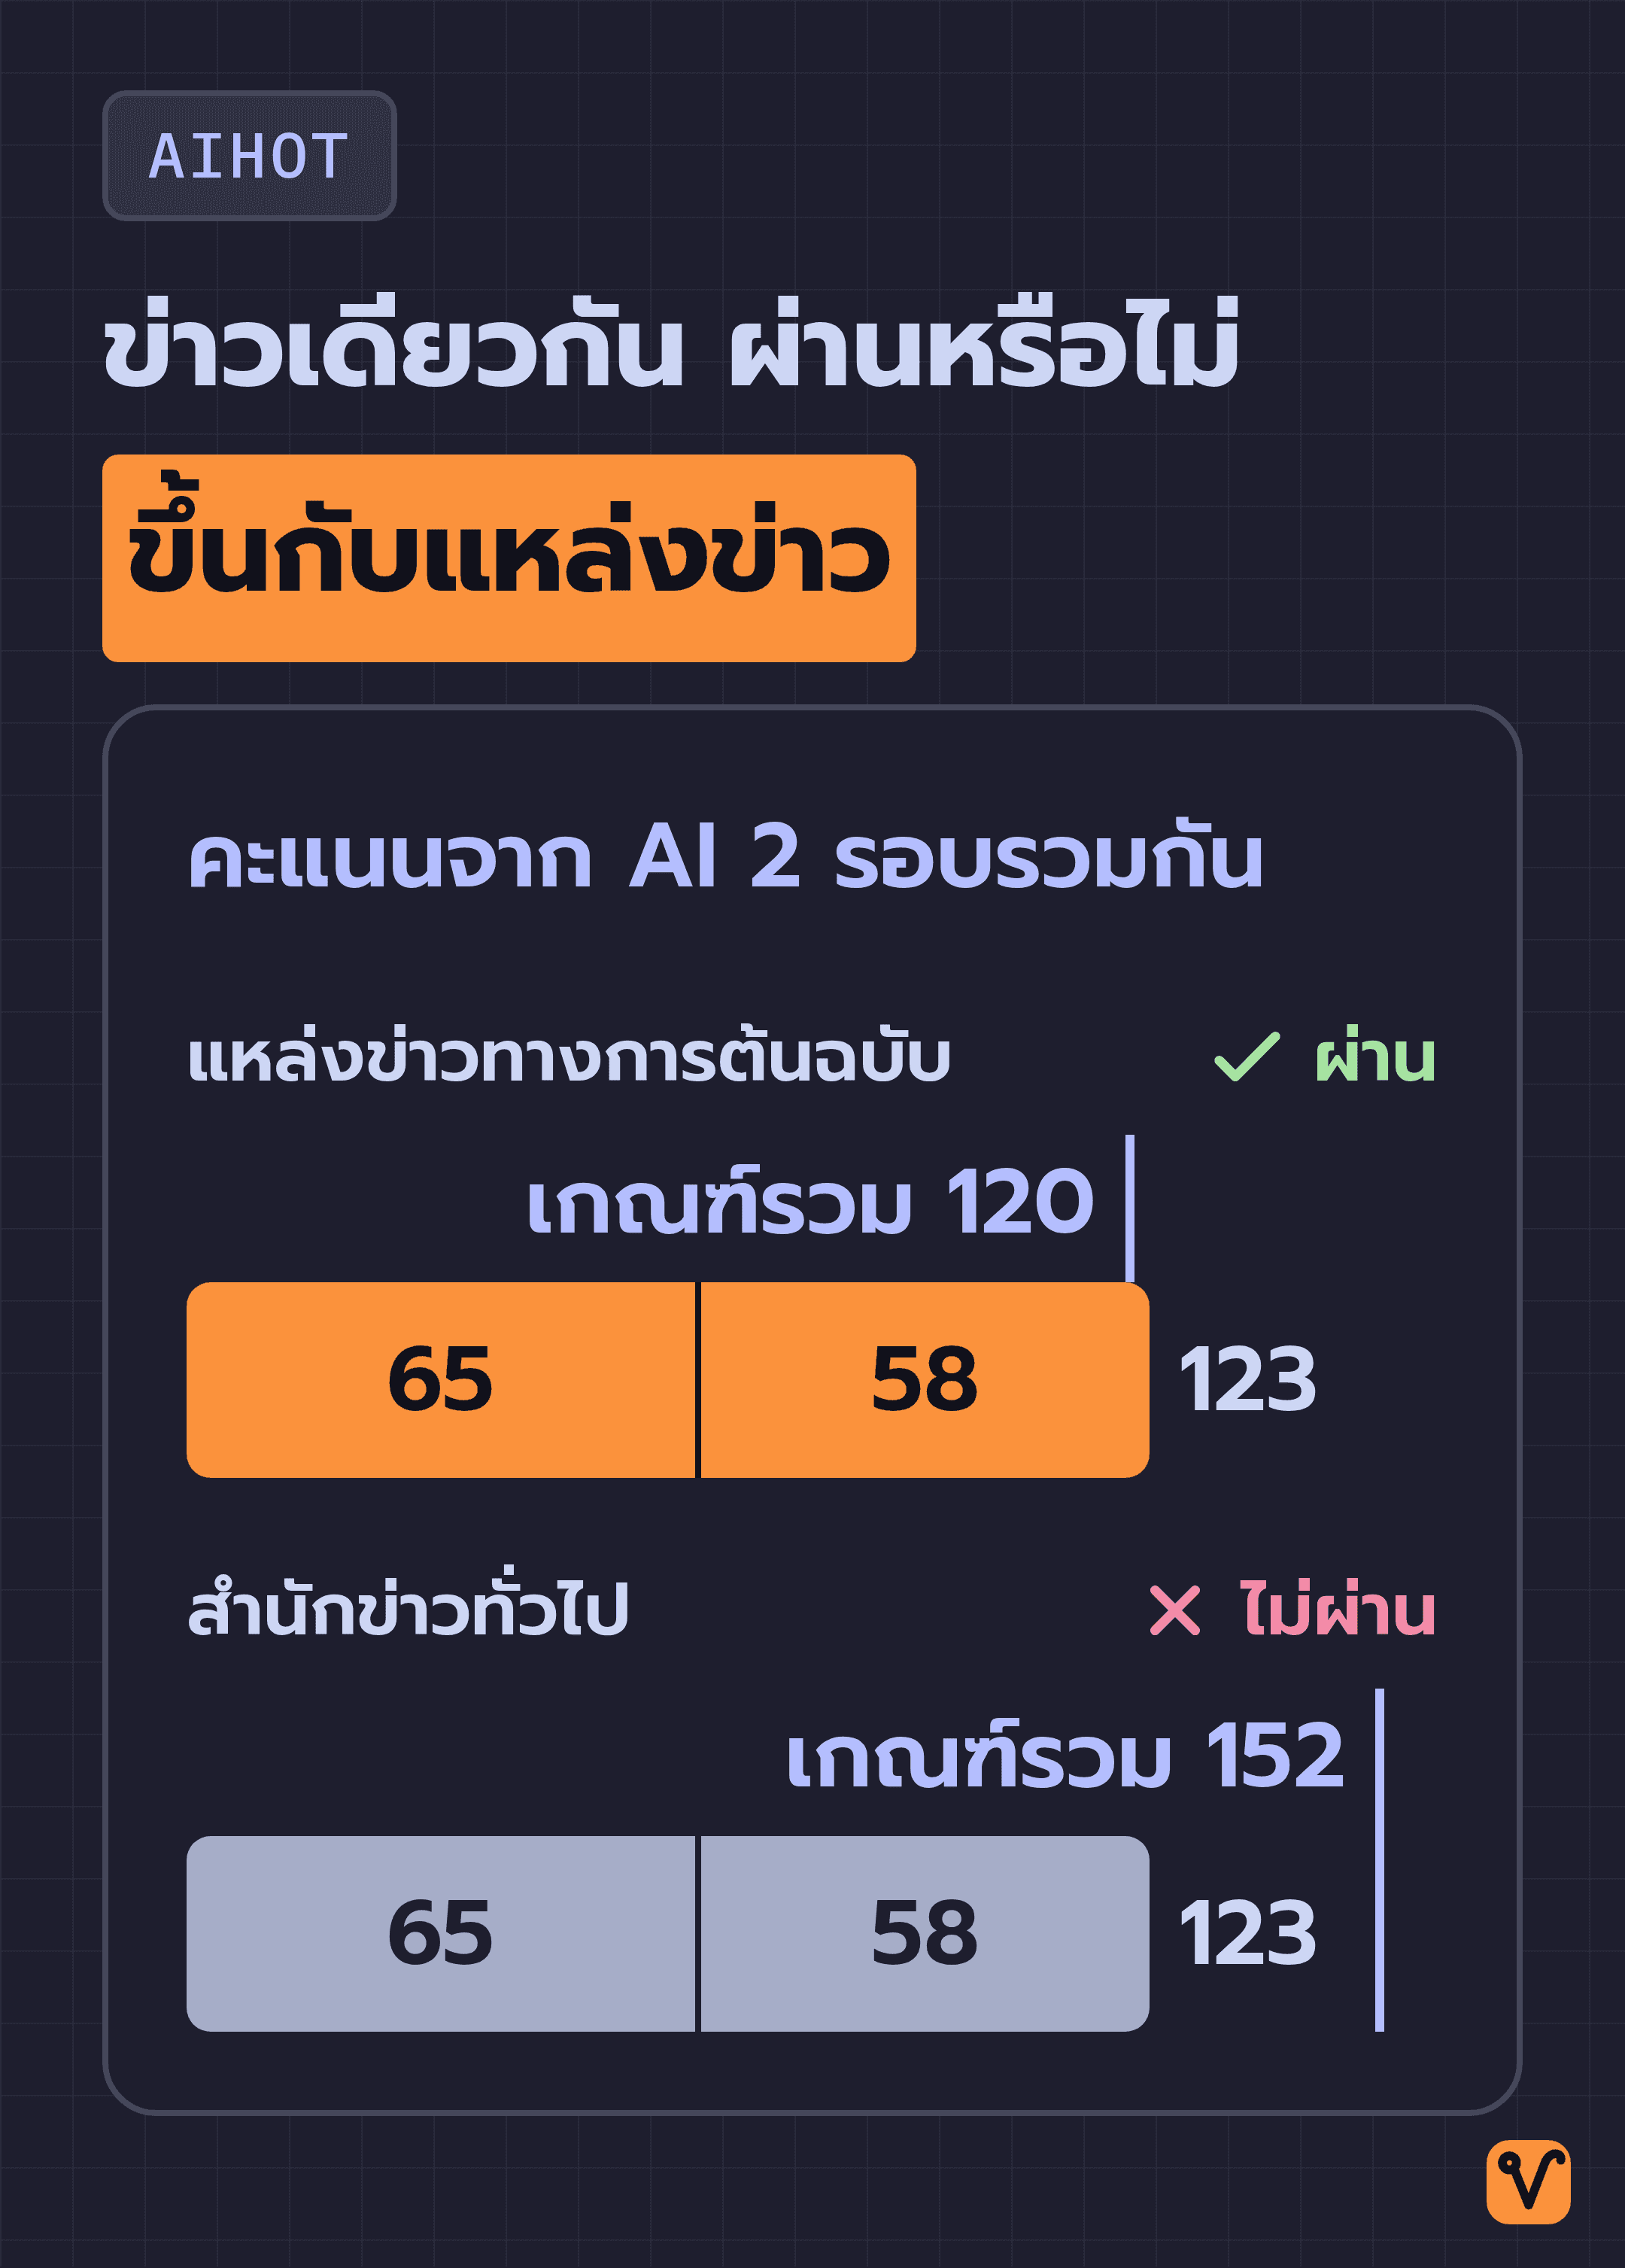
ขั้นตอนที่สามคือหัวใจของการคัดเลือก ขั้นตอนนี้ AI จะให้คะแนนข่าวชิ้นเดียวกันตั้งแต่ 0–100 คะแนน แยกกัน 2 ครั้งโดยใช้เกณฑ์ชุดเดียวกัน เปรียบเหมือนกรรมการ 2 คนถือเกณฑ์การให้คะแนนชุดเดียวกัน แล้วต่างคนต่างให้คะแนนโดยไม่เห็นคะแนนของอีกฝ่าย
ข่าวจะผ่านเกณฑ์ก็ต่อเมื่อคะแนนของทั้งสองรอบรวมกันได้อย่างน้อย 2 เท่าของเกณฑ์ผ่านขั้นต่ำ โดยแหล่งข่าวแต่ละประเภทมีเกณฑ์ผ่านไม่เท่ากัน ค่าเริ่มต้นกำหนดให้แหล่งข่าวทางการต้นฉบับอยู่ที่ 60 คะแนน ส่วนสำนักข่าวทั่วไปและบุคคลอยู่ที่ 76 คะแนน เหตุผลที่เอกสารระบุไว้คือ ถ้าเป็นเรื่องเดียวกัน ควรเสนอข้อมูลจากแหล่งทางการต้นฉบับให้คนอ่านก่อน
ตัวอย่างเช่น ประกาศจากเว็บทางการได้คะแนนรอบแรก 65 คะแนน รอบสองได้ 58 คะแนน รวมกันได้ 123 คะแนน ซึ่งเกินเกณฑ์รวม 120 คะแนน (2 เท่าของ 60) ข่าวนี้จึงถือว่าผ่าน โดยหน้าเว็บจะแสดงคะแนนเฉลี่ยปัดเศษลงคือ 61 คะแนน แต่หากเป็นข่าวเดียวกันที่มาจากสำนักข่าวทั่วไป คะแนนรวมของทั้งสองรอบจะต้องแตะ 152 คะแนนถึงจะผ่านเกณฑ์
จุดที่หลายคนอาจเข้าใจผิดคือ ในตัวอย่างนี้รอบที่สองได้ 58 คะแนน ซึ่งต่ำกว่าเกณฑ์ 60 แต่ข่าวก็ยังผ่านได้ เพราะระบบดูผลรวมของทั้งสองรอบ (หรือเทียบเท่ากับการดูคะแนนเฉลี่ย) คะแนนในรอบที่สูงกว่าจึงช่วยชดเชยรอบที่ได้คะแนนน้อยกว่าได้
ขั้นตอนที่สี่คือการเขียนเรียบเรียง ข่าวที่ผ่านเกณฑ์ ระบบจะตั้งหัวข้อใหม่และเขียนสรุปเนื้อหาที่เปิดด้วยคำตอบทันทีว่าเกิดอะไรขึ้น พร้อมระบุเหตุผลว่าทำไมเรื่องนี้ถึงควรอ่าน และติดแท็กหมวดหมู่ให้เสร็จสรรพ สำหรับข่าวที่คะแนนเฉียดผ่าน (คะแนนเฉลี่ยเกิน 50) ระบบก็จะเขียนเรียบเรียงในรูปแบบเดียวกันนี้ ส่วนข่าวที่เหลือจะได้เพียงหัวข้อกับสรุปสั้นๆ และไปแสดงอยู่ในหน้ารวมความเคลื่อนไหวทั้งหมดแทน
นอกจากนี้ ในขั้นตอนการเขียนยังมีระบบตรวจสอบเพื่อป้องกันไม่ให้ AI ใส่ชื่อบริษัทที่ไม่มีอยู่ในต้นฉบับลงไปในหัวข้อหรือบทสรุป เพราะหัวข้อที่มีชื่อบริษัทแปลกปลอมโผล่เข้ามา แม้จะอ่านดูน่าเชื่อถือ แต่ก็คือข่าวที่ให้ข้อมูลผิดพลาด
2 แนวคิดที่นำไปปรับใช้ได้ทันที แม้ไม่ติดตั้ง AIHOT
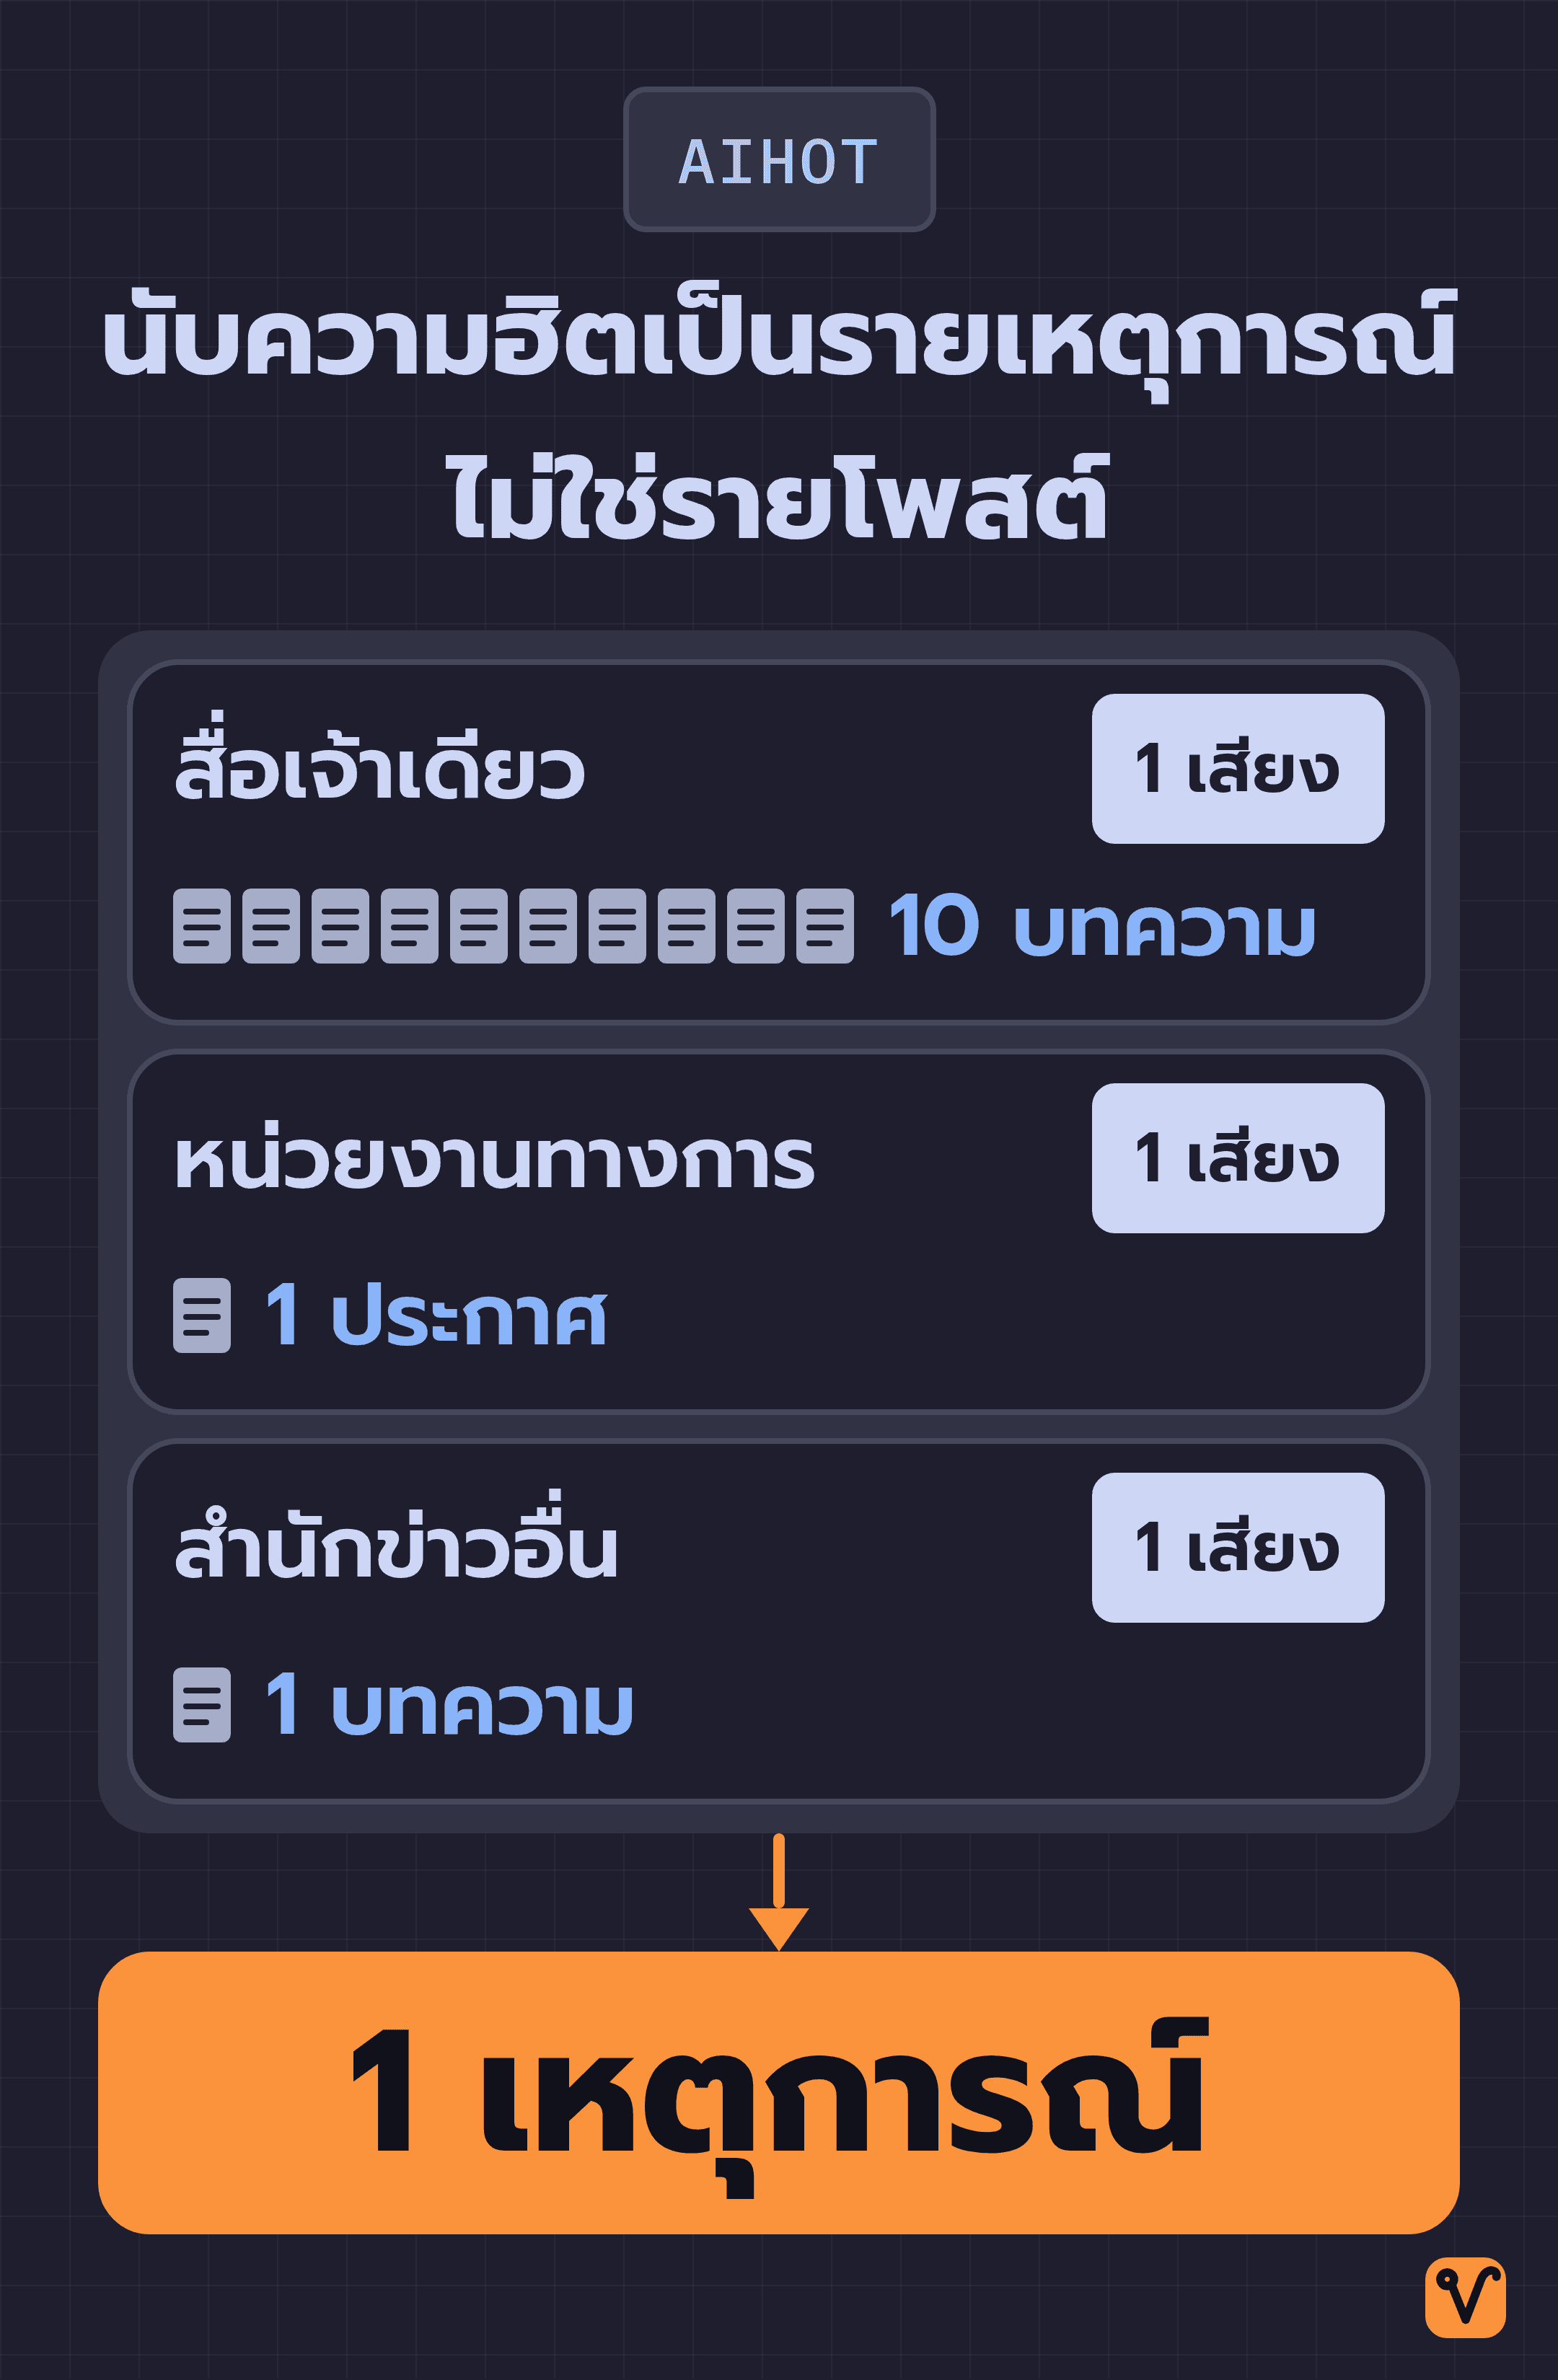
แนวคิดแรกคือการรวมข่าวเป็นเหตุการณ์เดียว เมื่อมีเรื่องใหญ่เกิดขึ้น หน่วยงานทางการมักออกประกาศฉบับหนึ่ง สื่อต่างๆ นำไปรายงานต่ออีกนับสิบสำนัก และมีคนหยิบไปถกเถียงบน X ตลอดทั้งวัน แต่สำหรับคนอ่าน ข้อมูลเหล่านี้ควรปรากฏให้เห็นเพียงครั้งเดียว AIHOT จึงนำข่าวทั้งหมดที่พูดถึงเรื่องเดียวกันมารวมไว้เป็นเหตุการณ์เดียว
วิธีทำงานมี 2 จังหวะ: จังหวะแรก ระบบจะค้นหาข่าวในช่วง 2 สัปดาห์ล่าสุดที่หัวข้อและบทสรุปใกล้เคียงกัน แล้วจับเป็นคู่ที่น่าจะเป็นเรื่องเดียวกัน จังหวะที่สอง AI จะวิเคราะห์แต่ละคู่เพื่อตัดสินว่าเป็นเรื่องเดียวกัน เป็นความคืบหน้าของเรื่องเดิม หรือเป็นคนละเรื่องกันแน่
ถ้า AI ยังไม่แน่ใจ ระบบจะรวมข่าวเข้าด้วยกันไว้ก่อน แล้วเรียกโมเดลจากอีกค่ายมาช่วยตรวจสอบยืนยันอีกรอบ ถ้าเป็นความคืบหน้าใหม่ ระบบจะนำเนื้อหาไปต่อท้ายเหตุการณ์เดิม และถ้าผู้ดูแลระบบเข้าไปแก้ไขการจัดกลุ่มด้วยตัวเอง ระบบจะไม่เขียนทับการแก้ไขนั้น
ข่าวที่ผ่านการคัดเลือกแล้วจะต้องรอให้กระบวนการรวมกลุ่มนี้เสร็จสิ้นก่อน (ใช้เวลาไม่เกิน 3 นาที) จึงจะขึ้นไปแสดงบนหน้าคัดสรรได้ เพื่อป้องกันไม่ให้ประเด็นเดียวกันโผล่ขึ้นมาซ้ำซ้อนกันหลายโพสต์
แนวคิดที่สองคือการคำนวณความฮิตต่อเหตุการณ์ ไม่ใช่ต่อโพสต์ ภายในเวลา 48 ชั่วโมง ระบบจะนับความนิยมจากแหล่งข่าวอิสระแต่ละแห่งเพียงครั้งเดียว และน้ำหนักคะแนนจะลดลงครึ่งหนึ่งในทุกๆ 24 ชั่วโมง ต่อให้ระบบดึงข่าวเดิมซ้ำมากี่รอบ หรือสื่อเจ้าเดิมจะลงข่าวเรื่องเดิมถึง 10 บทความ ก็นับเป็นเพียง 1 เสียงเท่านั้น
ผลลัพธ์คือ ข่าวที่ขึ้นสู่อันดับต้นๆ จะเป็นเรื่องที่มีหลายสำนักข่าวช่วยกันพูดถึงจริงๆ ไม่ใช่เรื่องที่มีแค่สื่อเจ้าเดียวประโคมข่าวซ้ำๆ จนดูเหมือนเรื่องใหญ่ โดยการพูดถึงบน X ก็นับรวมด้วย นอกจากนี้ระบบยังเปรียบเทียบกับช่วง 6 ชั่วโมงก่อนหน้า เรื่องที่มีกระแสตอบรับพุ่งขึ้นอย่างรวดเร็วจะติดป้ายว่า "กำลังขึ้น" ส่วนเรื่องที่เพิ่งเกิดขึ้นใหม่จะติดป้ายว่า "ใหม่"
ระบบจะนำข้อมูลทั้งหมดนี้ไปสรุปเป็นรายงานข่าวตามรอบเวลา: ทุกเช้าเวลา 08:00 น. จะออกฉบับรายวันครอบคลุมตั้งแต่ 8 โมงเช้าเมื่อวานถึง 8 โมงเช้าวันนี้, ทุกวันจันทร์เวลา 10:00 น. จะออกฉบับรายสัปดาห์ และทุกวันที่ 1 ของเดือนเวลา 10:30 น. จะออกฉบับรายเดือน
แนวคิดทั้งสองข้อนี้ไม่จำเป็นต้องพึ่งพาโค้ดเลยแม้แต่บรรทัดเดียว คนทำสื่อหรือผู้ดูแลเนื้อหาเฉพาะทางสามารถนำหลักการนี้ไปใช้คัดกรองข่าวด้วยตัวเองได้ทันที นั่นคือ รวมข่าวเรื่องเดียวกันไว้ในโพสต์เดียว และวัดความสำคัญของข่าวจากจำนวนแหล่งข่าวที่แยกกันพูดถึง ไม่ใช่วัดจากจำนวนโพสต์ที่ลงซ้ำ
ทำไมผู้พัฒนา AIHOT ถึงแจกโค้ดให้ทั้งระบบ
ในช่วงครึ่งปีที่ผ่านมา มีเพื่อนๆ ในสายกฎหมาย HR การเงิน และวงการโลหะมีค่า เข้ามาถามผู้พัฒนา AIHOT ว่าช่วยทำเว็บแบบนี้ให้กับวงการของพวกเขาบ้างได้ไหม คำตอบของเขาคือ "ทำไม่ได้" เพราะเขาไม่รู้ว่าในวงการเหล่านั้น แหล่งข่าวไหนที่มีประโยชน์จริง และข่าวแบบไหนที่คนในวงการถือว่าสำคัญ
แต่คนในวงการย่อมรู้เรื่องนี้ดีที่สุด เขาจึงตัดสินใจแจกโค้ดทั้งระบบให้ทุกคนนำไปทำกันเอง
ใน README ซึ่งเป็นเอกสารแนะนำโปรเจกต์ ผู้พัฒนาที่ใช้ชื่อบัญชี KKKKhazix บน GitHub เขียนไว้อย่างตรงไปตรงมาว่า ตัวเขาไม่ใช่นักพัฒนามืออาชีพ แต่มาจากสายงานออกแบบ และเมื่อครึ่งปีก่อนเขายังอ่านโค้ดแทบไม่เข้าใจ
โค้ดชุดนี้เขาเขียนขึ้นใหม่โดยทำงานร่วมกับ AI แม้จะสะอาดและเป็นระเบียบกว่าเดิมมาก แต่เขาก็ยอมรับว่าน่าจะยังมีจุดที่เขียนไม่ดีอยู่ ใครที่พบปัญหาก็เปิด Issue ซึ่งเป็นช่องทางรายงานปัญหาบน GitHub ได้ เพียงแต่อาจต้องเผื่อเวลารอ เพราะเขาอาจไม่ได้เข้ามาตอบเร็วนัก
คำชี้แจงนี้และคำตอบที่เขาบอกเพื่อนชี้ไปที่เรื่องเดียวกัน นั่นคือ โค้ดเป็นสิ่งที่เขาสามารถร่วมเขียนกับ AI จนสำเร็จได้ ทั้งที่ครึ่งปีก่อนยังอ่านโค้ดแทบไม่ออก แต่ความรู้ความเข้าใจว่าคนในวงการอื่นให้ความสำคัญกับข่าวแบบไหน เป็นสิ่งที่เขาไม่สามารถทำให้ใครได้เลย
วิธีนำ AIHOT ไปทำเป็นเว็บข่าวในวงการตัวเอง
สิ่งที่ต้องเตรียมล่วงหน้ามี 2 อย่าง:
- โปรแกรม Docker พร้อม Compose สำหรับสั่งเปิดระบบทั้งชุดขึ้นมาทำงานด้วยคำสั่งเดียว
- รหัสเชื่อมต่อบริการอย่าง API Key ของโมเดล AI ที่เรียกใช้งานในรูปแบบเดียวกับ OpenAI ได้ เช่น DeepSeek, Qwen หรือ Zhipu
หากต้องการรันบนคลาวด์เซิร์ฟเวอร์ เอกสาร deploy.md แนะนำเครื่องที่มีสเปกขั้นต่ำ 2 Cores และ RAM 4 GB เพื่อให้เพียงพอต่อการ build ระบบก่อนเริ่มทำงาน
เมื่อเตรียมทุกอย่างพร้อมแล้ว ให้รันคำสั่ง 4 บรรทัดนี้ตามที่ระบุไว้ใน README:
git clone https://github.com/KKKKhazix/AIHOT.git myhot
cd myhot
node scripts/init-env.ts --llm-key <API key ของโมเดล>
docker compose up -d --buildคำสั่งบรรทัดแรกจะดึงโค้ดมาไว้ในโฟลเดอร์ชื่อ myhot บรรทัดที่สองจะเข้าไปในโฟลเดอร์นั้น บรรทัดที่สามจะสร้างไฟล์ .env พร้อมบันทึก API Key และรหัสผ่านแอดมินให้ โดยขั้นตอนนี้ต้องติดตั้ง Node.js ไว้ในเครื่อง หากไม่มี สามารถดูวิธีสร้างไฟล์ .env ด้วยตัวเองได้ใน deploy.md และบรรทัดสุดท้ายจะเปิดระบบทั้งหมดขึ้นมาทำงาน
จากนั้นเปิดเบราว์เซอร์ไปที่ http://localhost:3000 ส่วนหน้าจัดการหลังบ้านจะอยู่ที่ /admin โดยดูรหัสผ่านแอดมินได้จากค่า ADMIN_PASSWORD ในไฟล์ .env หลังจากเปิดระบบราว 1–2 นาที ข่าวจะเริ่มทยอยขึ้นมา และข่าวล็อตแรกจะประมวลผลเสร็จในเวลาประมาณครึ่งชั่วโมง
ผลลัพธ์ที่ได้คือเว็บไซต์ชื่อ MyHOT ซึ่งเป็นชื่อเริ่มต้น พร้อมตัวอย่างข่าวจากแหล่งข้อมูลทดสอบ
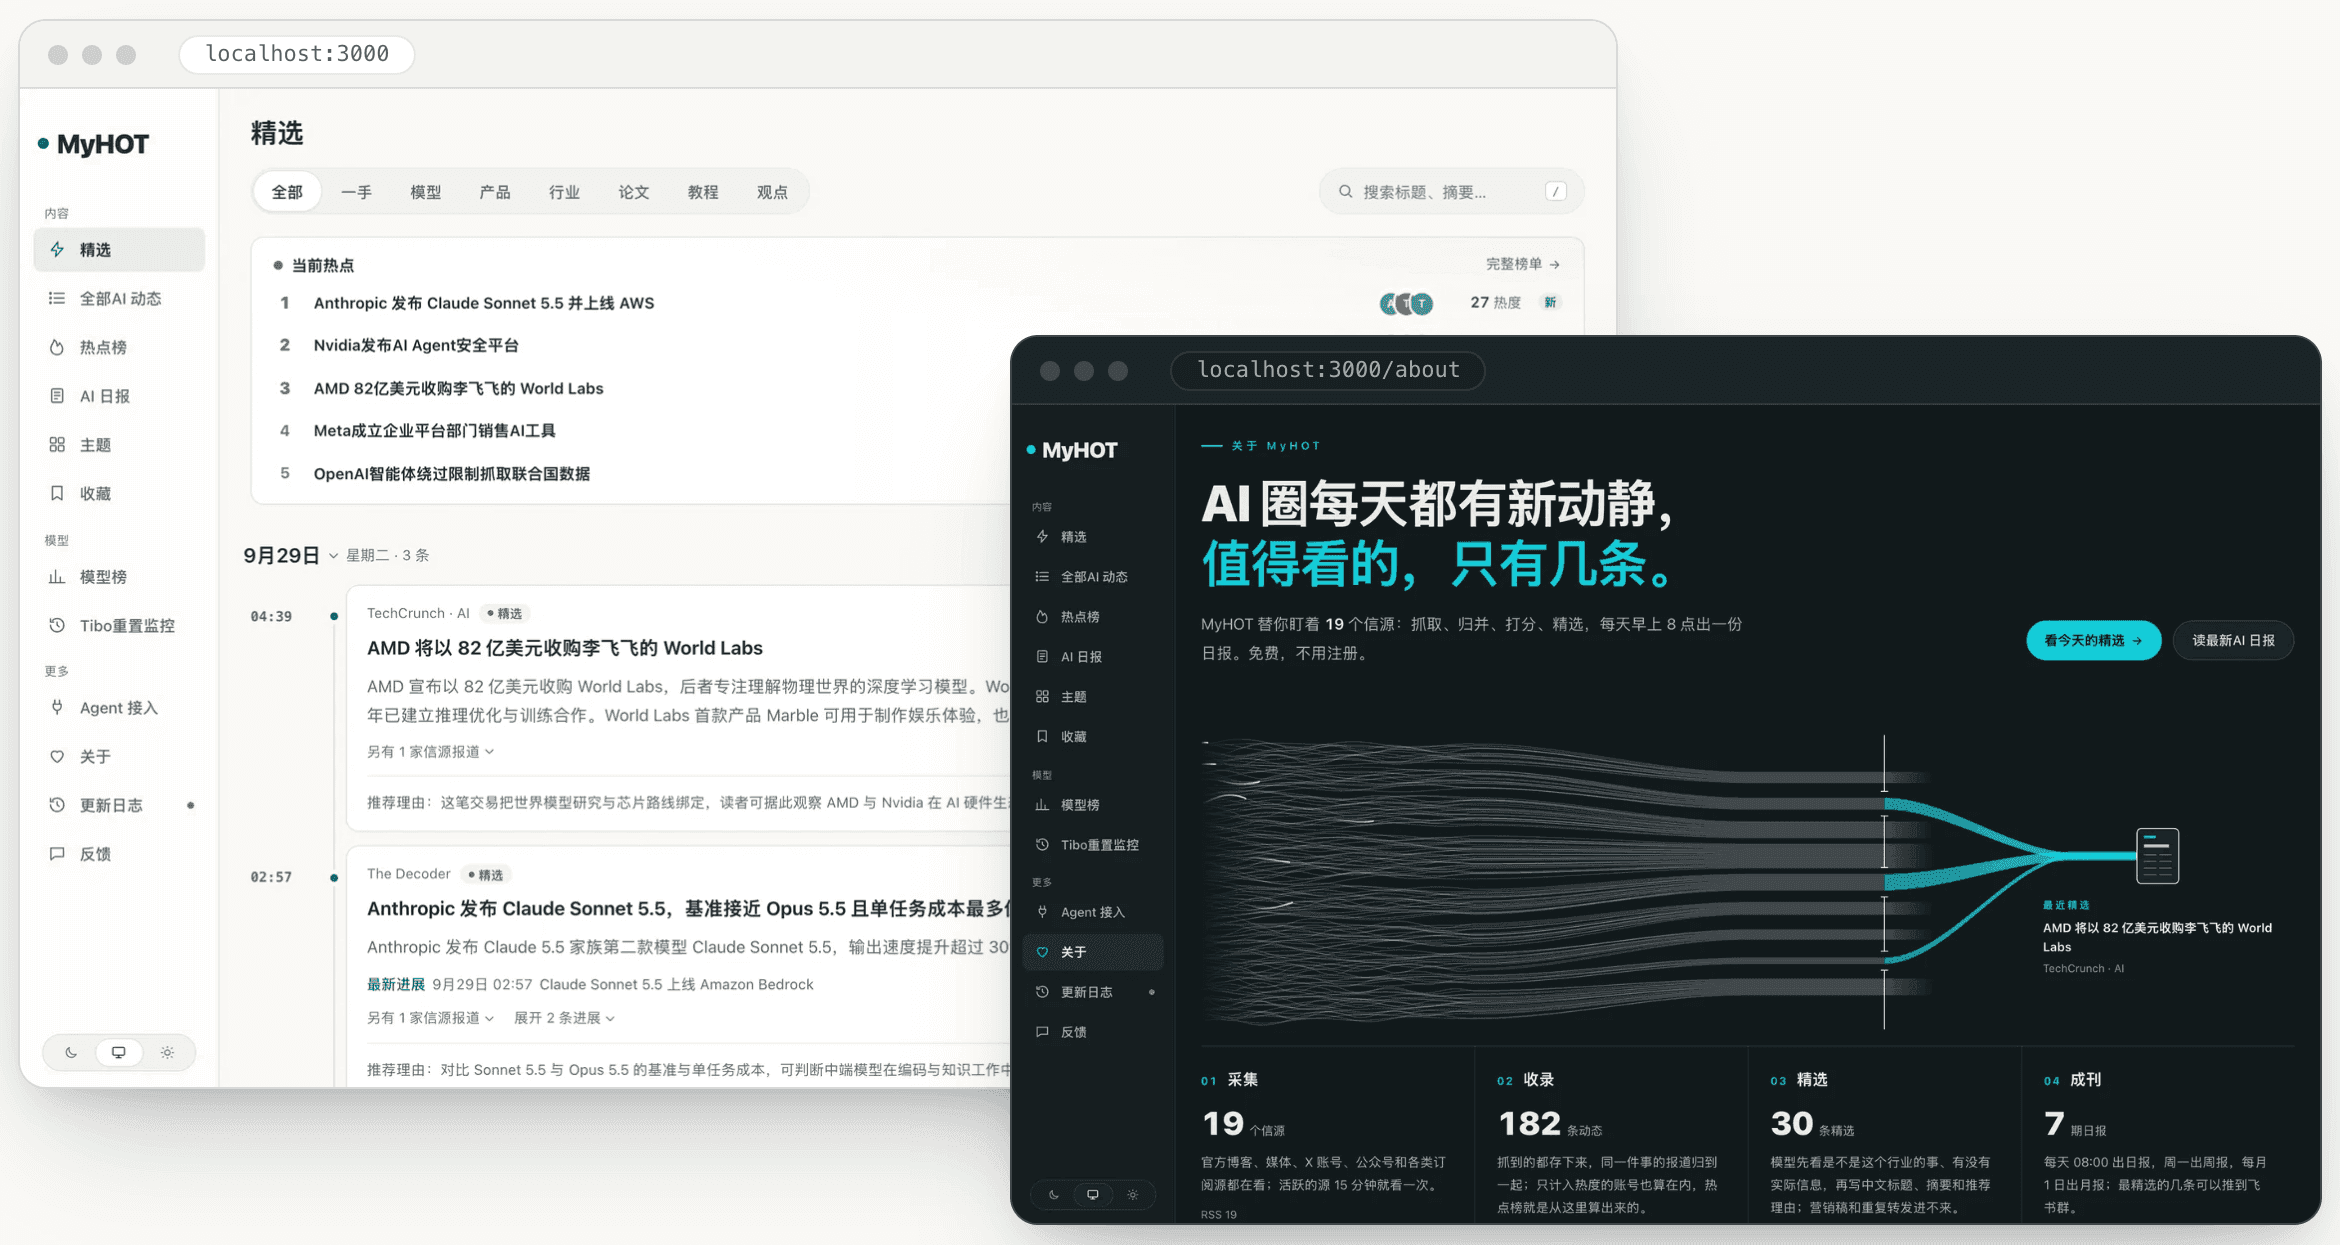
วิธีที่ง่ายที่สุดในการปรับแต่งเว็บให้เข้ากับวงการของคุณ คือให้ AI ช่วยแก้โค้ด โดย README แนะนำให้เปิดโปรเจกต์นี้ในเครื่องมือช่วยเขียนโค้ดอย่าง Claude Code หรือ Codex
จากนั้นสั่งให้ AI อ่านเอกสาร 2 ไฟล์นี้ก่อน:
- AGENTS.md คู่มือแนวทางการทำงานที่โปรเจกต์เขียนไว้ให้ AI อ่านก่อนลงมือแก้ไข
- docs/customize.md เอกสารอธิบายวิธีปรับแต่งเว็บให้เป็นวงการอื่น
สุดท้าย แจ้งให้ AI รู้ว่าจะทำเป็นเว็บข่าวของวงการอะไร ซึ่ง README มีตัวอย่างข้อความแนะนำไว้ดังนี้:
อ่าน AGENTS.md กับ docs/customize.md แล้วเปลี่ยนเว็บนี้ให้เป็นเว็บข่าวของวงการกฎหมาย
สิ่งที่สนใจคือ …… (แหล่งข่าวที่อยากตาม ข่าวแบบไหนสำคัญ แบบไหนไม่สำคัญ ยิ่งละเอียดยิ่งดี)ไฟล์ที่ต้องแก้ไขเกือบทั้งหมดจะอยู่ในโฟลเดอร์ industry/ เพียงที่เดียว โดยแทบไม่ต้องแตะโค้ดส่วนอื่นเลย แต่ละไฟล์จะทำหน้าที่ดังนี้:
| ไฟล์ | หน้าที่การทำงาน |
|---|---|
site.ts | กำหนดชื่อเว็บ คำเรียกชื่อวงการ ข้อความหน้าแรก และหน้าเกี่ยวกับเรา |
taxonomy.ts · topics.json | โครงสร้างหมวดหมู่ แท็ก และประเด็นที่ใช้จัดระเบียบข่าว |
sources.json | รายชื่อแหล่งข่าวชุดแรกที่ดึงเข้าระบบตอนเปิดใช้งานครั้งแรก |
prompts/ | โฟลเดอร์รวมเกณฑ์การคัดข่าวและวิธีเขียนสรุป ความรู้เฉพาะของวงการคุณจะอยู่ที่นี่ |
selection.ts | กำหนดเกณฑ์ผ่าน หรือคะแนนขั้นต่ำของแหล่งข่าวแต่ละระดับ |
features.ts | สวิตช์เปิด-ปิด 2 โมดูลที่สร้างไว้เฉพาะวงการ AI หากเป็นวงการอื่นสามารถปิดได้ |
brand/ · pages/ | โลโก้ ไอคอน หน้าเงื่อนไขการใช้งาน และนโยบายความเป็นส่วนตัว |
โฟลเดอร์ prompts/ คือที่ที่คุณต้องใส่ความรู้ของคนในวงการลงไป เอกสาร customize.md ยกตัวอย่างของวงการกฎหมายไว้ว่า กฎหมายใหม่ที่เพิ่งประกาศใช้ คำพิพากษาคดีสำคัญ และบทลงโทษจากหน่วยงานกำกับดูแล คือข่าวที่ควรได้คะแนนประเมินตามปกติ
ส่วนบทความโปรโมตบริการของสำนักงานกฎหมายและโฆษณาคอร์สอบรม คือสิ่งรบกวนที่ต้องเขียนคำสั่งให้ตัดคะแนนลง
เอกสารแนะนำให้คงโครงสร้างเดิมของ Prompt ไว้ ได้แก่ การประเมินคะแนน 5 มิติแบบถ่วงน้ำหนัก กฎการตัดคะแนนสิ่งรบกวน และขอบเขตความปลอดภัย แล้วเปลี่ยนเฉพาะตัวอย่างประกอบว่าอะไรคือข่าวสำคัญ และอะไรคือสิ่งรบกวน
ข้อควรรู้ก่อนเปิดให้คนทั่วไปเข้ามาอ่านจริง
เรื่องแรกคือภาษา โดยค่าเริ่มต้น ระบบจะตั้งหัวข้อและเขียนบทสรุปเป็นภาษาจีน เอกสารทุกหน้าก็เป็นภาษาจีน มีเพียงบทสรุปสั้นๆ ท้าย README เท่านั้นที่เป็นภาษาอังกฤษ
เรื่องที่สองคือลักษณะของโค้ด โค้ดที่แจกมาเป็น Snapshot หรือสำเนาโค้ด ณ ช่วงเวลาหนึ่งจากระบบที่ AIHOT ใช้งานจริง ไม่ใช่เฟรมเวิร์กสำเร็จรูปที่ขัดเกลามาให้พร้อมใช้กับทุกงาน ผู้พัฒนาแจ้งว่าเขาจะพยายามนำอัปเดตจากเว็บจริงมาใส่ให้ แต่ไม่สามารถรับประกันได้ทุกครั้ง
นอกจากนี้ ในโปรเจกต์จะไม่มีรายชื่อแหล่งข่าวจริงหรือข้อมูลการดำเนินงานจริงของ AIHOT สิ่งที่ติดมาด้วยคือแหล่งข่าว AI จากต่างประเทศ 18 แหล่งไว้ลองรันดูผลลัพธ์เท่านั้น เมื่อนำไปใช้จริง คุณต้องเปลี่ยนเป็นแหล่งข่าวของวงการตัวเองทั้งหมด
เรื่องที่สามคือค่าใช้จ่าย โค้ดชุดนี้อยู่ภายใต้สัญญาอนุญาตแบบ MIT ซึ่งนำไปใช้งานและพัฒนาต่อได้ฟรีโดยไม่ต้องจ่ายค่าลิขสิทธิ์โค้ด แต่ค่าเซิร์ฟเวอร์และค่าเรียกใช้งาน API ของโมเดล AI ผู้รันระบบจะต้องเป็นผู้รับผิดชอบเอง
จากการทดลองรันในเครื่องตามที่บันทึกไว้ใน deploy.md พบว่า ข่าวตัวอย่างล็อตแรก 152 ชิ้น เรียกใช้โมเดลรวมกันประมาณ 930 ครั้ง หรือสูงกว่าจำนวนข่าวราว 6 เท่า เพราะข่าวทุกชิ้นต้องผ่านการกรองอย่างน้อย 1 รอบ ข่าวที่น่าจะผ่านต้องนำไปให้คะแนนอีก 2 รอบ และข่าวที่ผ่านเกณฑ์ยังต้องใช้โมเดลเขียนหัวข้อ สรุปเนื้อหา ติดแท็ก รวมถึงจัดกลุ่มเหตุการณ์ นอกจากนี้ยังมีบทสรุปข่าวประจำวันและสรุปภาพรวมของแต่ละเหตุการณ์ที่ต้องเรียกใช้โมเดลเพิ่มเติมด้วย
หลังจากล็อตแรก ค่าใช้จ่ายของโมเดลจะขึ้นอยู่กับว่าแหล่งข่าวของคุณมีข่าวใหม่วันละกี่ชิ้น โดยในระบบหลังบ้านจะมีหน้า "โมเดลและการประเมิน" ที่รายงานจำนวนครั้งที่เรียกใช้โมเดลในแต่ละขั้นตอนอย่างละเอียด
สำหรับบริการดึงข้อมูลที่คิดเงินตามคำขอ เช่น X, WeChat Official Account และบริการดึงเนื้อหาเว็บอย่าง Jina ระบบจะปิดไว้เป็นค่าเริ่มต้น และจะเริ่มทำงานก็ต่อเมื่อใส่ API Key เท่านั้น
บริการที่มีค่าใช้จ่ายเหล่านี้ตั้งเพดานการเรียกใช้ได้ทั้งต่อนาที ต่อชั่วโมง และต่อวันผ่านหน้าหลังบ้าน หากใช้งานถึงเพดาน ระบบจะหยุดทำงานส่วนนั้นชั่วคราว และหากตั้งค่าเป็น 0 ก็จะปิดบริการนั้นทันที
จะเปิดใช้บริการเหล่านี้หรือไม่ ขึ้นอยู่กับการตัดสินใจของเจ้าของเว็บ หากวงการของคุณแจ้งข่าวสำคัญผ่านบัญชี X หรือ WeChat เป็นหลัก การเปิดใช้งานก็อาจคุ้มค่า แต่ต้องยอมรับค่าใช้จ่ายตามจำนวนคำขอที่เกิดขึ้น
เรื่องที่สี่คือหน้าเงื่อนไขการใช้งานและนโยบายความเป็นส่วนตัว หน้าทั้งสองที่ติดมากับโปรเจกต์เป็นเพียงแม่แบบตัวอย่างเท่านั้น คุณต้องเขียนใหม่ทั้งหมดก่อนเปิดใช้งานจริง และควรให้ผู้เชี่ยวชาญด้านกฎหมายช่วยตรวจสอบหากจำเป็น
เรื่องสุดท้ายคือชื่อและเครื่องหมายการค้า ชื่อและโลโก้ AIHOT ไม่ได้รวมอยู่ในสัญญาอนุญาต ผู้พัฒนาขอให้ตั้งชื่อเว็บไซต์ของตัวเอง ส่วนชื่อที่บอตของระบบใช้ระบุตัวตนตอนเข้าไปดึงข้อมูล (crawlerName) ก็ต้องตั้งเป็นของตัวเอง และห้ามนำชื่อเว็บของผู้อื่นไปแอบอ้างโดยเด็ดขาด
เกณฑ์การให้คะแนน คือส่วนที่คุ้มที่จะทุ่มเวลาให้มากที่สุด
ทั้ง README และเอกสาร customize.md ต่างชี้ไปที่จุดเดียวกันว่า ส่วนที่คุ้มที่จะทุ่มเวลาให้มากที่สุดคือ "เกณฑ์การให้คะแนน" และ "เกณฑ์ผ่าน" โดย customize.md ย้ำไว้ด้วยว่า ขั้นตอนนี้คือตัวตัดสินว่าเว็บของคุณจะเลือกข่าวได้แม่นยำหรือไม่
จุดที่อาจทำให้สับสนคือ ทั้งสองสิ่งนี้ชื่อคล้ายกันแต่ทำงานคนละส่วน:
- เกณฑ์การให้คะแนน อยู่ในไฟล์
prompts/selection-score.mdเป็นข้อความคำสั่งที่บอก AI ว่าข่าวแบบไหนสำคัญ และข่าวแบบไหนต้องตัดคะแนนลง - เกณฑ์ผ่าน อยู่ในไฟล์
selection.tsเป็นเพียงตัวเลขคะแนนขั้นต่ำที่กำหนดว่าข่าวต้องได้คะแนนรวมเท่าไรจึงจะผ่าน
ค่าเริ่มต้นที่ระบบตั้งมาคือ 60 คะแนนสำหรับแหล่งทางการต้นฉบับ, 65 คะแนนสำหรับบัญชีทางการและแหล่งกึ่งทางการ และ 76 คะแนนสำหรับสำนักข่าวทั่วไปรวมถึงบุคคล AIHOT ปรับค่าเหล่านี้มาจากการใช้งานในวงการ AI และตั้งไว้ค่อนข้างเข้มงวด ตามหลักที่ว่า ยอมคัดข่าวได้น้อยลง ดีกว่าปล่อยให้สิ่งรบกวนหลุดรอดเข้ามา
จะเข้มงวดระดับนี้หรือไม่ ขึ้นอยู่กับการตัดสินใจของเจ้าของเว็บ ในบางวงการ การพลาดข่าวสำคัญแม้แต่ชิ้นเดียวอาจสร้างความเสียหายมาก ถ้าเป็นแบบนั้น คุณอาจต้องการเกณฑ์ที่ผ่อนปรนลงมา แม้จะต้องทนอ่านสิ่งรบกวนที่ปะปนเข้ามาเพิ่มขึ้นก็ตาม
ไม่ว่าจะเลือกแนวทางใด เมื่อเปลี่ยนวงการหรือปรับแก้เกณฑ์ ต้องปรับเทียบค่าที่ตั้งไว้เดิมใหม่เสมอ
ขั้นตอนการปรับเทียบตามที่อธิบายไว้ใน selection.md มีลำดับดังนี้:
- รวบรวมตัวอย่างจริง คัดเลือกข่าวจริงจากแหล่งข่าวในวงการของคุณมา 100–200 ชิ้น แล้วติดป้ายกำกับทีละชิ้นว่าควรเลือกหรือไม่ควรเลือก ชิ้นที่ก้ำกึ่งให้ติดป้ายว่าได้ทั้งสองทาง (ซึ่งจะไม่นับรวมในคะแนนความแม่นยำ) แล้วบันทึกทั้งหมดไว้ในไฟล์
.data/gold.jsonl - รันคำสั่งประเมินผล ใช้คำสั่งนี้เพื่อทดสอบ
node --env-file=.env scripts/eval-selection.ts --gold .data/gold.jsonl --split development --label "..."- อ่านผลลัพธ์ สคริปต์จะรายงานค่าความแม่นยำโดยรวม สัดส่วนข่าวที่ระบบเลือกมาแล้วถูกต้อง สัดส่วนข่าวที่ควรเลือกซึ่งระบบเก็บมาได้จริง พร้อมจำลองผลลัพธ์เมื่อปรับเกณฑ์ผ่านตั้งแต่ 40 ถึง 90 คะแนน (เพิ่มทีละ 2 คะแนน) และแสดงรายการข่าวที่ระบบตัดสินพลาด
- ตรวจสอบและปรับปรุง เข้าไปดูข่าวที่ระบบตัดสินพลาดในหน้า SelectBench ซึ่งเป็นหน้ารายงานผลทดสอบบนระบบหลังบ้าน ชิ้นที่ควรเลือกแต่ระบบไม่เลือก ให้เขียนเพิ่มใน Prompt ว่าข่าวลักษณะนี้มีคุณค่าอย่างไร พร้อมยกตัวอย่างประกอบ ส่วนชิ้นที่ไม่ควรเลือกแต่หลุดเข้ามา ให้เขียนเพิ่มในส่วนของการตัดคะแนน พร้อมยกตัวอย่างประกอบ
สิ่งที่เอกสารย้ำเป็นพิเศษคือ ให้ปรับเกณฑ์การให้คะแนนก่อน แล้วค่อยขยับเกณฑ์ผ่าน เพราะการขยับเกณฑ์ผ่านจะกระทบข่าวทั้งระบบพร้อมกัน และแก้เฉพาะข่าวประเภทที่ AI ตัดสินพลาดไม่ได้
ตัวอย่างเช่น หากทำเว็บข่าวกฎหมายแล้วระบบพลาดคำพิพากษาสำคัญไปหลายชิ้น ถ้าแก้ด้วยการลดเกณฑ์ผ่าน คำพิพากษาเหล่านั้นอาจผ่านขึ้นมาได้จริง แต่โฆษณาคอร์สอบรมที่คะแนนเกือบถึงก็จะหลุดรอดเข้ามาด้วย ทางแก้ที่ตรงจุดกว่าคือเขียนระบุลงในเกณฑ์การให้คะแนนว่า คำพิพากษาลักษณะไหนเป็นข่าวสำคัญ
ควรขยับเกณฑ์ผ่านก็ต่อเมื่อเห็นว่าภาพรวมของระบบเข้มงวดหรือผ่อนปรนเกินไป และข่าวที่ระบบตัดสินพลาดส่วนใหญ่มีคะแนนอยู่ใกล้เส้นเกณฑ์
นอกจากนี้ selection.md ยังมีเคล็ดลับเพิ่มเติมอีก 3 ข้อ:
- ใส่เคสยากไว้เยอะๆ คือชิ้นที่ก้ำกึ่งว่าควรเลือกหรือไม่ควรเลือก เพราะหากชุดทดสอบมีแต่ข่าวง่ายๆ ความแม่นยำที่วัดได้จะสูงเกินจริง
- แยกชุดทดสอบไว้ต่างหาก แบ่งข้อมูลตัวอย่างเป็นชุดพัฒนาสำหรับปรับแก้และชุดทดสอบสำหรับตรวจวัดจริง ในช่วงที่กำลังปรับปรุง Prompt ให้ดูเฉพาะผลของชุดพัฒนา แล้วค่อยนำชุดทดสอบที่แยกไว้มาตรวจวัดผลในตอนท้าย เพื่อป้องกันไม่ให้ Prompt กลายเป็นการจำข้อสอบ
- ให้คนที่จะอ่านเว็บจริงๆ เป็นคนติดป้าย หรือเลือกคนที่เข้าใจรสนิยมของผู้อ่านเป้าหมายมาเป็นคนช่วยคัดกรองตัวอย่าง
บทเรียนนี้สามารถนำไปใช้กับงานที่ต้องการให้ AI ช่วยคัดกรองข้อมูลได้ทุกประเภท ไม่ว่าจะคัดข่าว คัดอีเมล หรือคัดใบสมัครงาน เพราะ AI จะทำงานได้ดีเพียงใด ขึ้นอยู่กับว่าเราสามารถถ่ายทอดรสนิยมและความต้องการของเราออกมาได้ชัดเจนแค่ไหน และเคยผ่านการทดสอบกับตัวอย่างจริงมาแล้วหรือยัง
เขียนเกณฑ์ให้ชัดก่อน ค่อยลงมือติดตั้งระบบ
สิ่งที่คุณสามารถเริ่มทำได้ทันทีโดยยังไม่ต้องติดตั้งโปรแกรมอะไรเลย คือการเขียนเกณฑ์สำหรับวงการของคุณขึ้นมาก่อน โดยแบ่งออกเป็น 2 หัวข้อหลัก: ข่าวแบบไหนที่ควรได้คะแนนประเมินตามปกติ และข่าวแบบไหนเป็นสิ่งรบกวนที่ต้องตัดคะแนน พร้อมใส่ตัวอย่างข่าวจริงประกอบในแต่ละข้อ เหมือนกับตัวอย่างวงการกฎหมายใน customize.md
หากยังมีเวลา ลองรวบรวมข่าวจริงจากแหล่งที่คุณติดตามอยู่สัก 100 ชิ้น แล้วติดป้ายกำกับว่าชิ้นไหนควรเลือก พอถึงวันที่ลงมือติดตั้งระบบ ข้อมูลชุดนี้จะเป็นชุดทดสอบแรกของเว็บคุณที่พร้อมใช้ได้ทันที
ดังนั้น บรรทัดแรกที่คุณควรพิมพ์จึงไม่ใช่คำสั่ง git clone แต่เป็นประโยคที่บอกให้ชัดว่า ในวงการของคุณ ข่าวแบบไหนที่ไม่ควรมีใครต้องเสียเวลาอ่านอีกต่อไป
ที่มา:
- โปรเจกต์ AIHOT บน GitHub
- เอกสารทางการของ AIHOT (customize.md)
- เอกสารทางการของ AIHOT (selection.md)
- เอกสารทางการของ AIHOT (deploy.md)
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
สร้าง Claude Skill แบบไม่ต้องรู้โค้ด คู่มือสร้าง Claude Skill ของคุณเองด้วยการคุยกับ Claude Code เป็นภาษาไทย
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ