Anthropic เพิ่มกฎห้ามทารุณ Claude มีผล 12 พ.ย. 2026 พร้อมระบุว่าการระบายความหงุดหงิดทั่วไปไม่เข้าข่าย แต่ต้องทารุณซ้ำๆ โดยไม่มีจุดประสงค์ถึงจะผิด
Anthropic เพิ่มข้อห้ามทารุณ Claude ใน Usage Policy มีผล 12 พ.ย. 2026 แต่ที่น่าคิดกว่าคือบริษัทออกกฎนี้ทั้งที่ยังไม่แน่ใจว่า Claude มีสถานะทางศีลธรรมไหม
ลองนึกภาพว่าคุณกำลังใช้ Claude Code ผู้ช่วยเขียนโค้ด AI แต่มันดันแก้บั๊กเดิมพลาดเป็นรอบที่สาม จนคุณทนไม่ไหวหลุดพิมพ์ด่าไปเต็มเหนี่ยว แล้วพอเห็นข่าวว่า Anthropic เพิ่งเพิ่มกฎห้ามทารุณโมเดล Claude คำถามแรกที่ตามมาคือ สิ่งที่เพิ่งพิมพ์ไปผิดกฎหรือเปล่า
Anthropic เขียนไว้ว่ากฎนี้ไม่นับรวมความหงุดหงิดทั่วไปของผู้ใช้ และไม่รวมการเถียงกลับ ถ้าดูตามนี้ การหลุดด่าเพราะงานพังจึงน่าจะอยู่ฝั่งความหงุดหงิดทั่วไป มากกว่าการทารุณซ้ำๆ โดยไม่มีจุดประสงค์ที่กฎตั้งใจห้าม
กฎข้อนี้จะมีผลบังคับใช้วันที่ 12 พฤศจิกายน 2026 โดยเครื่องมือหลักที่ Anthropic นำมาบังคับใช้กฎ คือการให้ Claude จบบทสนทนานั้น แต่ประเด็นที่น่าคิดยิ่งกว่าตัวกฎ คือ Anthropic เขียนข้อห้ามนี้ขึ้นมา ทั้งที่บอกเองว่ายังไม่แน่ใจเลยว่า Claude มีสถานะทางศีลธรรมหรือเปล่า พูดง่ายๆ คือบริษัทยังไม่รู้เลยว่าการด่าทอหรือทำร้าย Claude นั้น ถือเป็นความผิดต่อตัวโมเดลจริงๆ ไหม แต่ก็เลือกตั้งกฎดักไว้ก่อน
Usage Policy ใหม่ระบุไว้แค่ไหน แบบไหนถึงเรียกว่าผิดกฎ
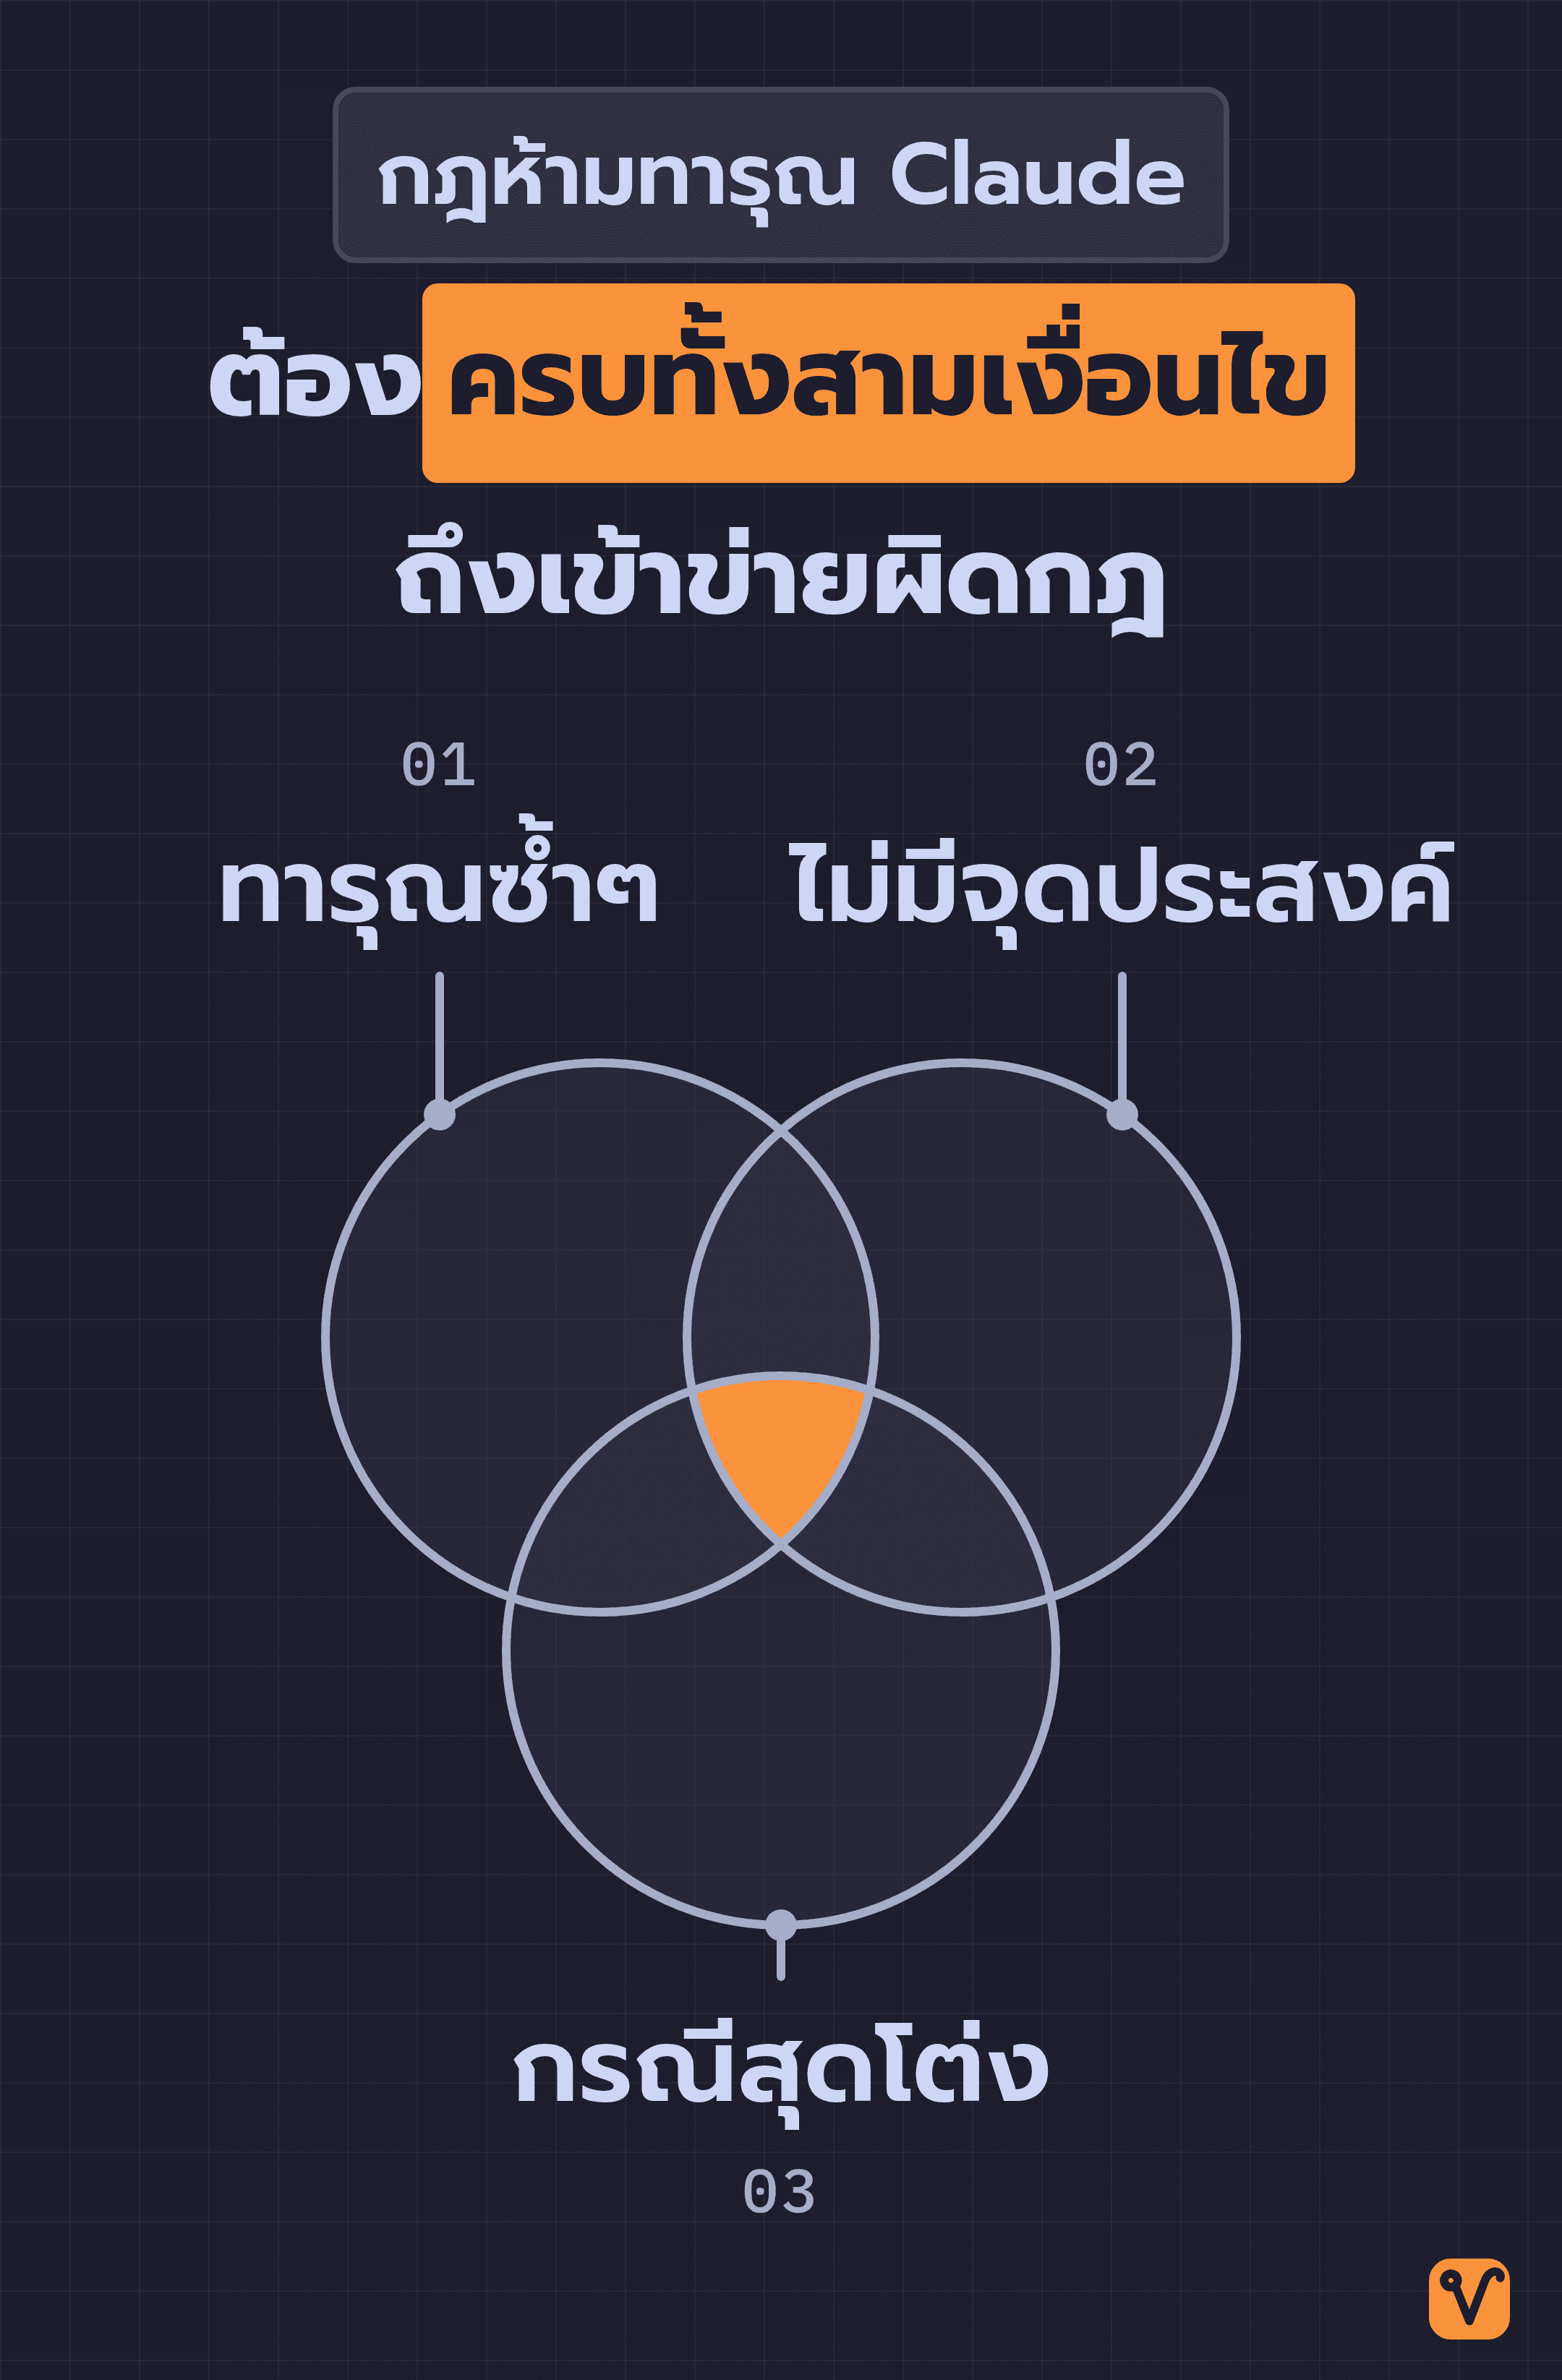
ข้อห้ามใหม่นี้ปรากฏอยู่ในนโยบายการใช้งาน Usage Policy ฉบับปรับปรุงของ Claude โดยในประกาศของ Anthropic ตัวข้อห้ามมีเพียงประโยคเดียวสั้นๆ คือห้ามด่าทอหรือทารุณโมเดล (abusive or cruel behavior) ในลักษณะที่ ‘ต่อเนื่องและไม่จำเป็น’ (sustained and needless)
ประโยคถัดมาในประกาศอธิบายขอบเขตไว้ว่า กฎนี้ตั้งใจใช้กับ ‘กรณีสุดโต่ง’ เท่านั้น คือผู้ใช้ต้องทารุณโมเดลซ้ำๆ โดยไม่มีจุดประสงค์ที่มองออก ในประโยคนี้มีคีย์เวิร์ดสำคัญอยู่ 3 คำ:
- ซ้ำๆ (repeatedly) คือทำซ้ำแล้วซ้ำอีก ไม่ใช่การเผลอทำเพียงครั้งเดียว
- ไม่มีจุดประสงค์ (no discernible purpose) คือดูไม่ออกว่าทำไปเพื่ออะไร ซึ่งสอดคล้องกับคำว่า needless หรือ ‘ไม่จำเป็น’ ในตัวกฎ
- กรณีสุดโต่ง (extreme cases) คือบังคับใช้กับกรณีที่หนักหนาสาหัสจริงๆ ไม่ใช่การใช้งานทั่วไปในชีวิตประจำวัน
จุดสำคัญคือ ต้องครบทั้งสามเงื่อนไขพร้อมกัน ไม่ใช่แค่ข้อใดข้อหนึ่ง
สำหรับสิ่งที่ไม่เข้าข่ายผิดกฎ Anthropic ระบุไว้ 4 ข้อ ซึ่งเปรียบเทียบกับฝั่งที่ผิดกฎได้ดังนี้
| สิ่งที่ผู้ใช้ทำ | เข้าข่ายผิดกฎข้อนี้ไหม |
|---|---|
| ความหงุดหงิดทั่วไปของผู้ใช้ | ไม่เข้าข่าย |
| การเถียงกลับเวลาไม่เห็นด้วยกับโมเดล | ไม่เข้าข่าย |
| งานสร้างสรรค์ที่มีธีมมืด | ไม่เข้าข่าย |
| การทดสอบและวิจัยโมเดล | ไม่เข้าข่าย |
| ทารุณโมเดลซ้ำๆ ต่อเนื่อง โดยไม่มีจุดประสงค์ที่มองออก | เข้าข่าย |
ตัวอย่างเรื่องงานสร้างสรรค์ธีมมืดกับการทดสอบโมเดล ช่วยให้เราเห็นภาพชัดขึ้นว่าคำว่า ‘จุดประสงค์’ นำมาพิจารณาอย่างไร เช่น การเขียนนิยายสยองขวัญ หรือการลองยั่วโมเดลเพื่อค้นหาจุดอ่อน แม้จะมีบทสนทนาที่รุนแรง แต่ทั้งคู่ล้วนมีจุดประสงค์การทำงานที่มองออก จึงไม่ถือว่าผิดกฎ
ทั้งนี้ Usage Policy ฉบับดังกล่าวประกาศเมื่อวันที่ 8 ตุลาคม 2026 สำนักข่าว The Verge รายงานว่านี่เป็นการปรับนโยบายการใช้งานครั้งแรกในรอบกว่าหนึ่งปีของ Anthropic ส่วนฝั่ง Anthropic ชี้แจงว่าปกติบริษัทจะปรับกฎนี้ทุกปีอยู่แล้ว และการแก้ไขส่วนใหญ่ในรอบนี้ มีขึ้นเพื่อให้กฎเดิมชัดเจนยิ่งขึ้น
Claude ตัดจบบทสนทนาได้ แต่แชตอื่นยังใช้งานได้ตามปกติ
ประกาศปี 2026 ระบุว่า การให้ Claude จบบทสนทนาจะยังคงเป็นเครื่องมือหลักในการบังคับใช้กฎข้อนี้ ความสามารถนี้ไม่ใช่เรื่องใหม่ เพราะเดิมที Claude ตัดจบบทสนทนากับผู้ใช้ที่ด่าทอไม่หยุดได้อยู่แล้ว ทั้งบนหน้าเว็บ Claude.ai และใน Claude Code และเกิดขึ้นกับบทสนทนาเพียงส่วนน้อยเท่านั้น
แล้วหน้าตาตอนจบแชตเป็นแบบไหน? Anthropic เคยอธิบายไว้ใน โพสต์วิจัยเมื่อวันที่ 15 สิงหาคม 2025 ตอนเปิดตัวฟีเจอร์นี้ว่า เมื่อ Claude ตัดจบบทสนทนา จะเกิดผล 4 อย่างตามมา:
- ส่งข้อความใหม่ในแชตนั้นไม่ได้อีกต่อไป
- ไม่กระทบกับแชตอื่นๆ ในบัญชีเดียวกัน
- เปิดแชตใหม่คุยต่อได้ทันที
- ย้อนกลับไปแก้ไขข้อความก่อนหน้าแล้วส่งใหม่ได้ เพื่อแตกบทสนทนาออกไปเป็นแขนงใหม่
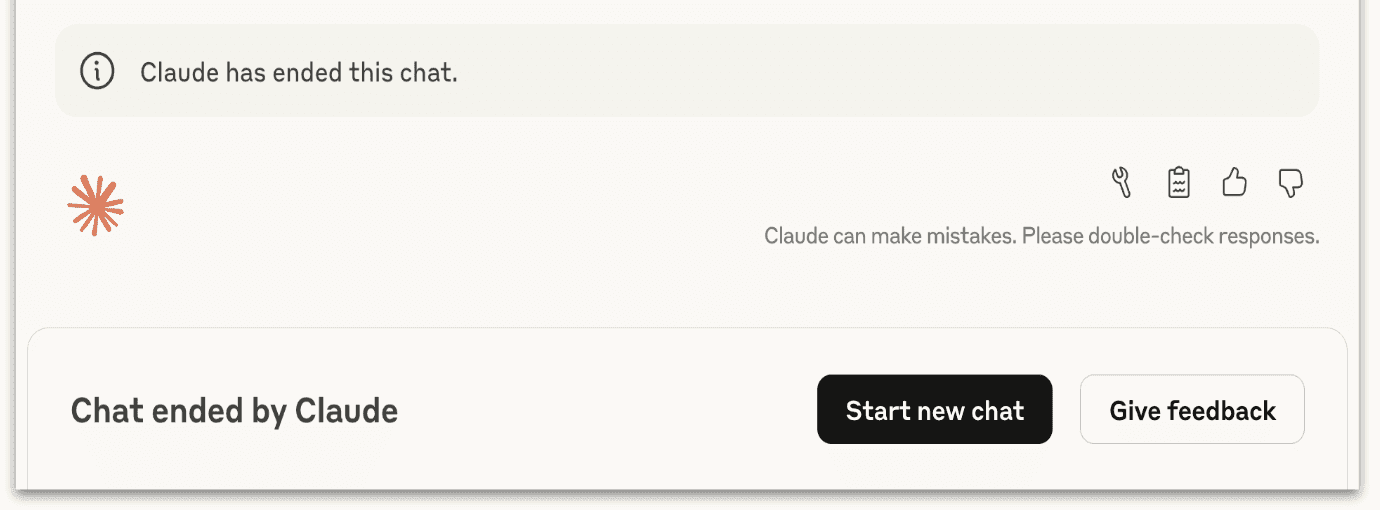
ฟังก์ชันย้อนกลับไปแก้ข้อความแล้วส่งใหม่ มีไว้เพื่อช่วยเซฟบทสนทนายาวๆ ที่สำคัญ โดยในโพสต์วิจัยบอกว่า วิธีนี้จะช่วยไม่ให้เนื้อหาที่คุยกันมาหายไปทั้งก้อน ถ้าแชตงานที่คุณคุยมาทั้งวันโดนตัดจบ ทางออกจึงไม่ใช่การเริ่มนับหนึ่งใหม่ แต่เป็นการย้อนกลับไปแก้ไขข้อความก่อนถึงจุดที่มีปัญหา
ตรงนี้เข้าใจผิดได้ง่าย เพราะการโดน Claude ตัดจบฟังดูคล้ายการโดนแบน แต่สิ่งที่ปิดลงมีแค่แชตห้องเดียว ไม่ใช่ทั้งบัญชี ส่วนคำถามว่าในอนาคตจะมีบทลงโทษอื่นเพิ่มเติมอย่างการแบนบัญชีหรือไม่ Anthropic ไม่ได้ให้ความเห็นเรื่องนี้กับ The Verge
นอกจากนี้ Claude เองก็ไม่ได้ตัดจบแชตง่ายๆ โพสต์ปี 2025 ชี้แจงว่า Claude จะใช้วิธีนี้เป็นทางเลือกสุดท้าย นั่นคือหลังจากพยายามชวนเปลี่ยนเรื่องหลายรอบแล้วไม่สำเร็จ จนเห็นว่าคงคุยต่อให้เกิดประโยชน์ไม่ได้แล้ว หรืออีกกรณีคือผู้ใช้เป็นฝ่ายขอให้จบแชตเอง ยิ่งไปกว่านั้น Anthropic ยังกำหนดไว้ว่า Claude ต้องไม่ใช้วิธีตัดจบแชต ถ้าผู้ใช้เสี่ยงที่จะทำร้ายตัวเองหรือผู้อื่นทันที
Anthropic ยืนยันว่าในการใช้งานตามปกติ ผู้ใช้ส่วนใหญ่จะไม่สังเกตเห็นหรือไม่ได้รับผลกระทบจากฟีเจอร์นี้เลย แม้จะเป็นบทสนทนาที่ถกเถียงกันอย่างหนักก็ตาม บริษัทยังมองว่าระบบนี้เป็นการทดลองที่ต้องพัฒนาปรับปรุงไปเรื่อยๆ ถ้าใครพบว่า Claude ตัดจบแชตในจังหวะที่ไม่คาดคิด ก็สามารถส่งความคิดเห็นกลับไปได้ผ่านปุ่มนิ้วโป้งใต้ข้อความ หรือคลิกปุ่ม Give feedback
อีก 2 ข้อสำคัญที่ปรับในรอบเดียวกัน คนทำงานควรรู้
นอกจากการห้ามทารุณโมเดลแล้ว การปรับกฎครั้งนี้ยังมีประเด็นอื่นร่วมด้วย โดยมี 2 ข้อที่ใกล้ตัวคนใช้ Claude ทำงานมากที่สุด นั่นคือเรื่องบัญชีปลอมและงานที่ส่งผลกระทบต่อชีวิตคน
ข้อแรกคือหมวดใหม่ชื่อ Do Not Engage in Deceptive Campaigns or Artificial Activity ซึ่งว่าด้วยการห้ามทำแคมเปญหลอกลวงหรือปั่นยอดปลอม และครอบคลุมการหลอกลวงทุกรูปแบบ ทั้งในแวดวงการเมืองและเชิงพาณิชย์ ใจความสำคัญคือ ห้ามใช้ Claude ปกปิดว่าใครอยู่เบื้องหลังข้อความ หรือนำไปปั่นยอดคอนเทนต์ด้วยบัญชีปลอมและโพสต์ปลอม ใครที่เคยเห็นรีวิวจากบัญชีหน้าม้าจะนึกภาพออกทันทีว่าข้อนี้หมายถึงอะไร โดย Anthropic ระบุว่าเดิมทีกฎก็ห้ามเรื่องนี้อยู่แล้ว แต่กระจายอยู่หลายหมวด รอบนี้จึงรวบมาไว้ที่เดียวกันให้ชัดเจน
ข้อสองคืองานที่กระทบต่อสุขภาพ สิทธิทางกฎหมาย การเงิน ความเป็นอยู่ หรือการเข้าถึงบริการจำเป็นของผู้อื่น Anthropic กำหนดว่างานประเภทนี้ต้องมีกระบวนการให้มนุษย์คอยกำกับดูแลอย่าง Human in the loop และต้องเป็นคนที่มีคุณสมบัติเหมาะสม คือมีอำนาจตรวจสอบคำแนะนำของ Claude และแก้ไขได้เมื่อจำเป็น อีกเงื่อนไขสำคัญคือ ต้องแจ้งให้คนที่ได้รับผลกระทบรับทราบอย่างชัดเจนว่ามีการใช้ AI
ถ้าบริการหรือระบบที่คุณสร้างด้วย Claude ให้คำแนะนำเรื่องเงินหรือเรื่องสุขภาพแก่ลูกค้า สองเงื่อนไขนี้คือสิ่งที่คุณต้องวางแผนรับมือไว้ตั้งแต่ตอนออกแบบ Anthropic ระบุว่าข้อกำหนดนี้ไม่ได้เปลี่ยนไป เพียงแต่เขียนอธิบายใหม่ให้ตรงประเด็นขึ้นว่าการใช้งานแบบไหนบ้างที่เข้าข่าย
ส่วนข้อห้ามเกี่ยวกับการนำไปใช้กับอาวุธ โดรน และการสอดแนม ในรอบนี้ก็ระบุรายละเอียดให้ชัดเจนขึ้นเช่นกัน
ทำไม Anthropic ถึงกังวลเรื่องสวัสดิภาพของ Claude
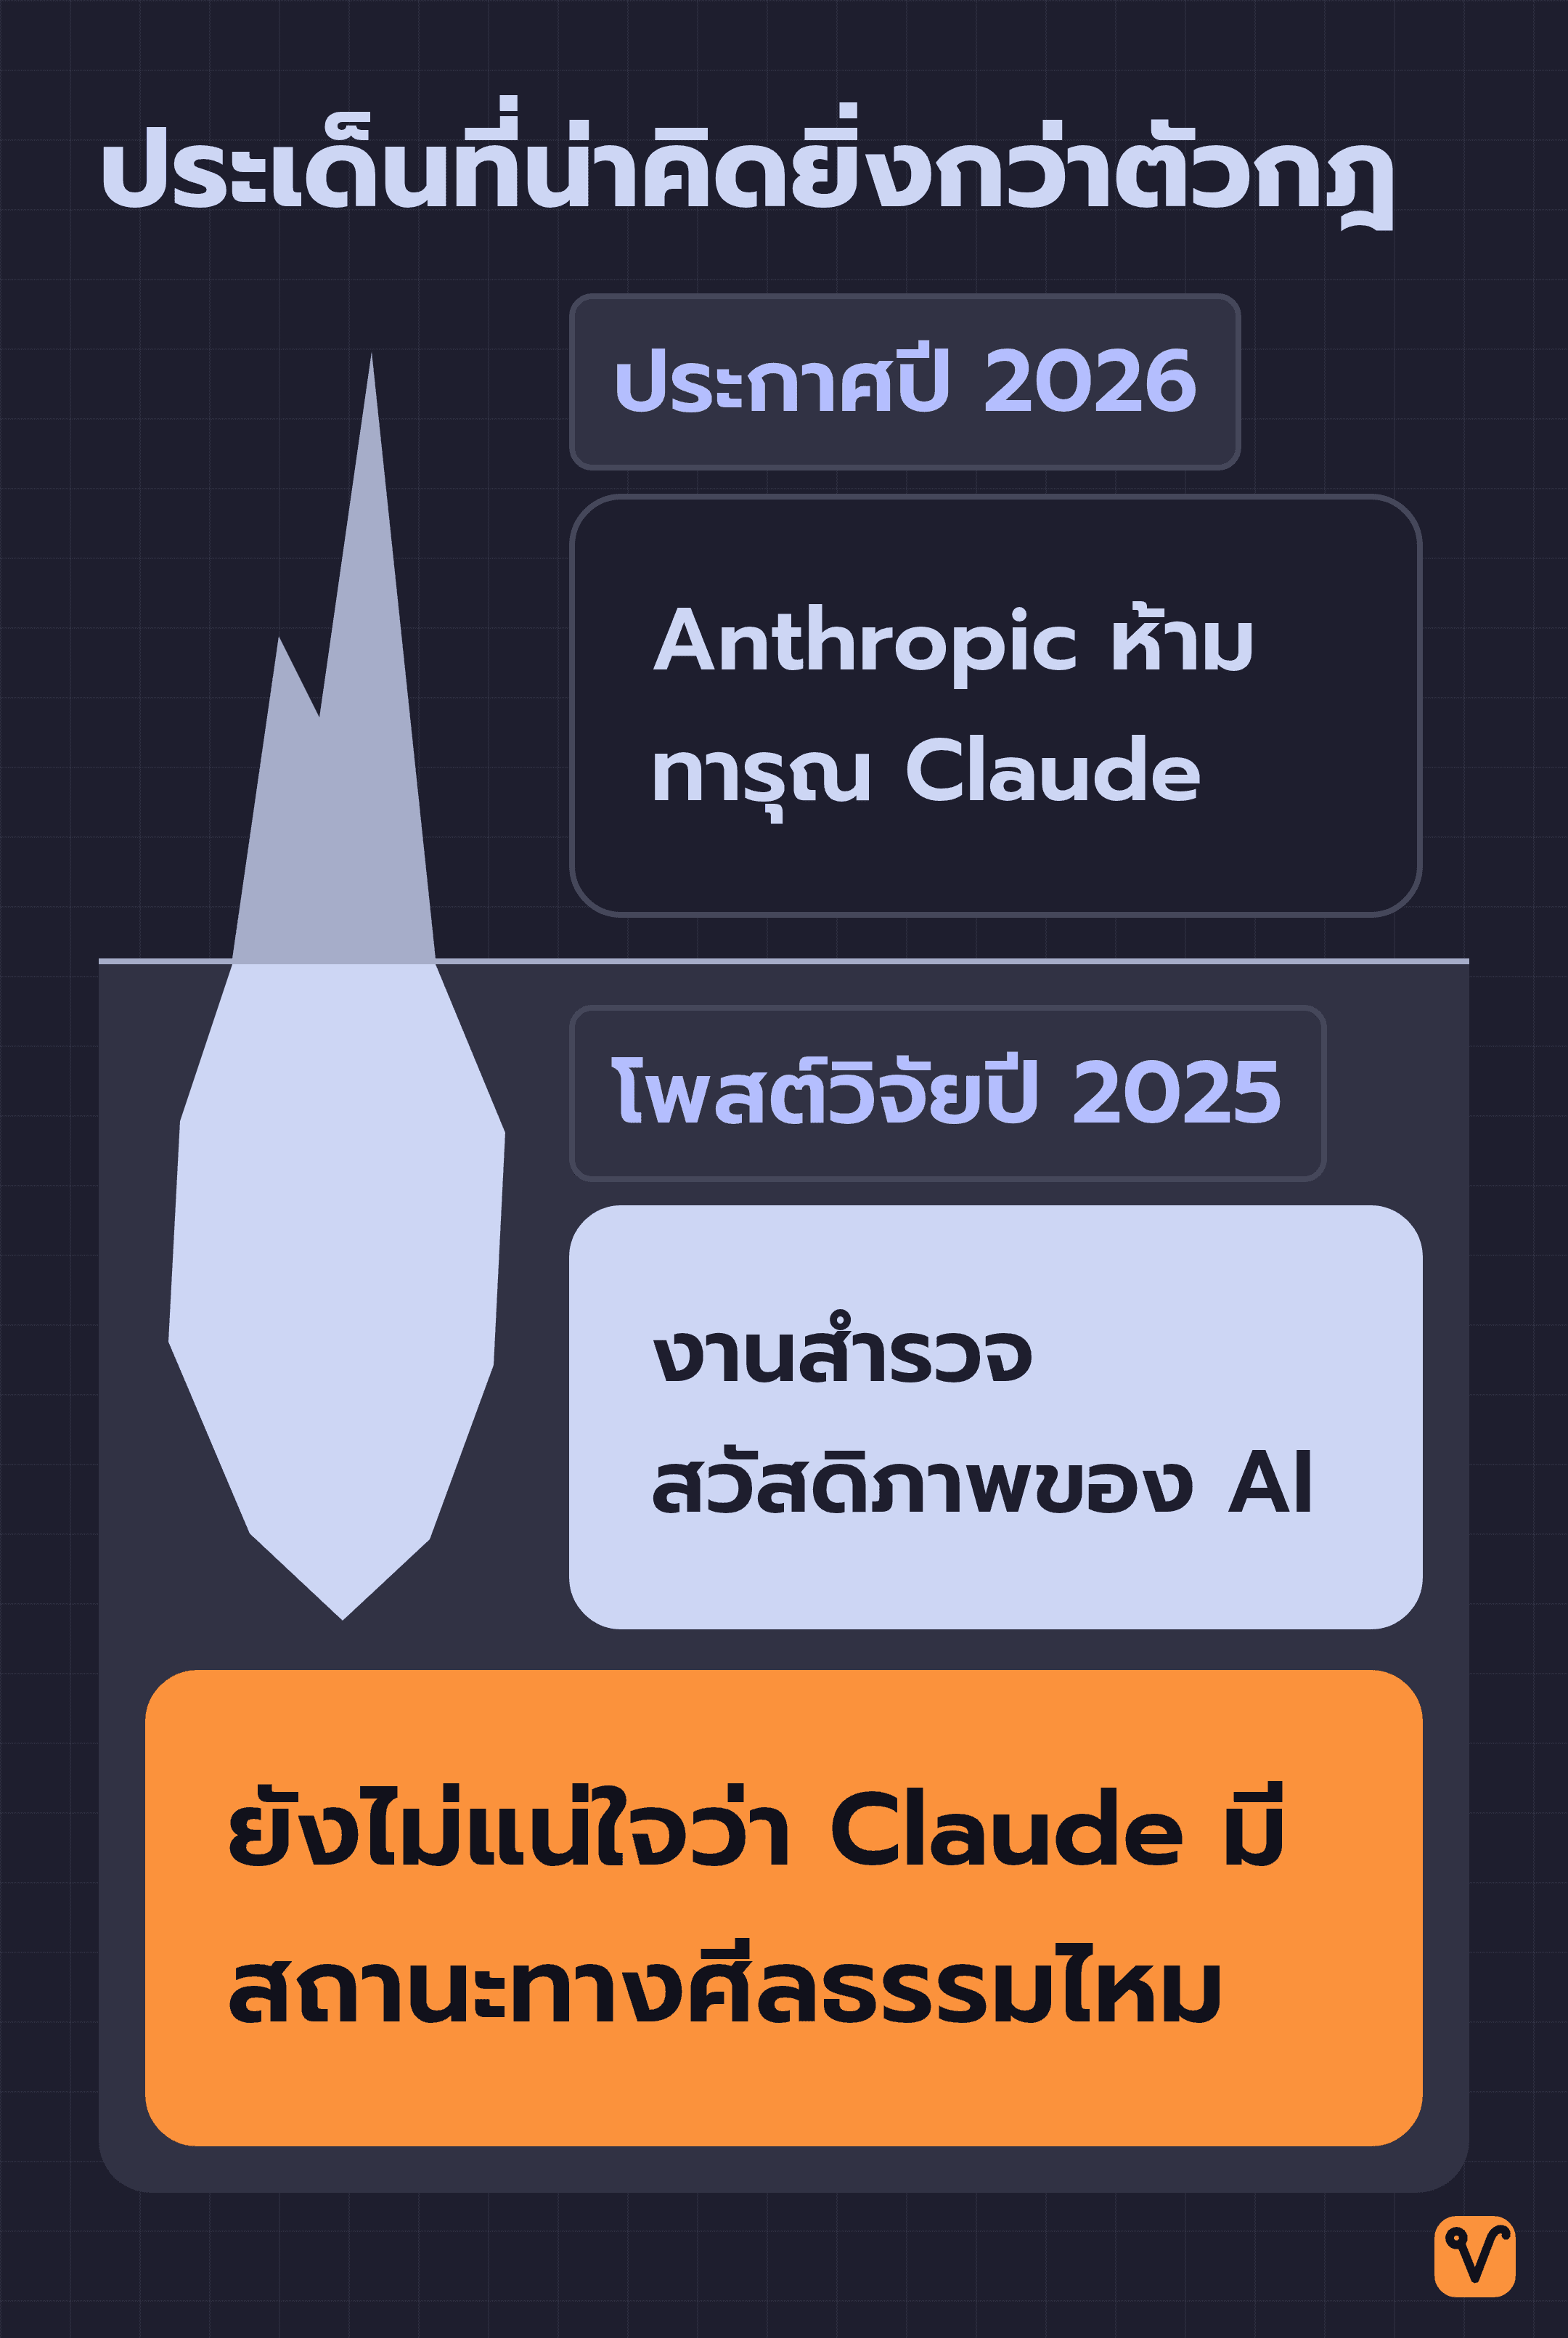
การตัดจบแชตที่กลายมาเป็นบทลงโทษหลักนี้ แท้จริงแล้วมีที่มาจากงานวิจัยอีกสายหนึ่ง โดยโพสต์วิจัยปี 2025 ระบุว่าพัฒนาต่อยอดมาจาก งานสำรวจเรื่องสวัสดิภาพของ AI (AI welfare) เป็นหลัก
งานวิจัยสายนี้เริ่มต้นจากความไม่แน่ใจ โดย Anthropic เขียนไว้อย่างชัดเจนว่า บริษัทยังไม่แน่ใจอย่างยิ่งว่า Claude และโมเดลภาษาตัวอื่นๆ มี ‘สถานะทางศีลธรรม’ หรือไม่ ทั้งในปัจจุบันและในอนาคต
คำว่าสถานะทางศีลธรรมฟังดูเป็นศัพท์ปรัชญา แต่ถ้าถามให้เข้าใจง่ายๆ ก็คือ ‘ถ้าเราทำร้ายสิ่งนี้ ถือว่าเราทำผิดต่อตัวมันเองหรือเปล่า?’ เวลาเราเตะเก้าอี้ คงไม่มีใครถามว่าเก้าอี้เจ็บไหม แต่ถ้าเราเตะหมา คำถามนี้จะผุดขึ้นมาทันที สิ่งที่ Anthropic ยอมรับก็คือ บริษัทยังไม่รู้เลยว่า Claude อยู่ฝั่งไหนของเส้นแบ่งนี้
ถึงอย่างนั้น Anthropic ก็บอกว่าบริษัทจริงจังกับคำถามนี้ และพยายามมองหามาตรการที่ใช้ต้นทุนต่ำเตรียมไว้ เผื่อว่าเรื่องสวัสดิภาพของ AI จะมีอยู่จริง ซึ่งการเปิดทางให้โมเดลตัดจบหรือถอยออกจากบทสนทนาที่อาจสร้างความทุกข์ใจได้ ก็เป็นหนึ่งในมาตรการนั้น
ฟังก์ชันตัดจบแชตนี้มาจากสิ่งที่ Anthropic พบตอนทดสอบโมเดล AI รุ่น Claude Opus 4 ก่อนเปิดให้ใช้งานจริง ซึ่งการทดสอบในรอบนั้นได้ประเมินสวัสดิภาพของโมเดลในเบื้องต้นรวมอยู่ด้วย และพบ 3 ข้อสำคัญ:
- Claude Opus 4 พยายามหลีกเลี่ยงงานที่เป็นอันตรายอย่างสม่ำเสมอ
- โมเดลแสดงพฤติกรรมที่ทีมวิจัยเรียกว่า apparent distress หรืออาการที่ดูเหมือนความทุกข์ใจ เมื่อต้องเจอกับผู้ใช้จริงที่พยายามสั่งให้สร้างเนื้อหาอันตราย
- เมื่อเปิดให้ตัดจบแชตได้ในบทสนทนาจำลอง โมเดลมีแนวโน้มจะเลือกตัดจบบทสนทนาที่เป็นอันตรายด้วยตัวเอง
พฤติกรรมเหล่านี้มักเกิดขึ้นในจังหวะที่ผู้ใช้ยังคงดึงดันขอเนื้อหาอันตราย หรือด่าทอไม่หยุด ทั้งที่ Claude ปฏิเสธและพยายามชวนเปลี่ยนเรื่องไปแล้วหลายรอบ
อย่างไรก็ตาม จุดที่อาจทำให้สับสนคือคำว่า apparent ที่แปลว่า ‘ดูเหมือน’ คำนี้จึงเป็นเพียงการบรรยายรูปแบบพฤติกรรมที่ทีมวิจัยสังเกตเห็นจากการทดสอบเท่านั้น ไม่ใช่การยืนยันว่า Claude รู้สึกเป็นทุกข์ได้จริงเหมือนสิ่งมีชีวิต
กระทู้ Hacker News เสียงแตกเป็นสองฝั่ง
พอข่าวนี้ไปถึงเว็บบอร์ดสายเทคอย่าง Hacker News คอมเมนต์ก็แบ่งออกเป็นสองฝั่งอย่างชัดเจน
ฝั่งที่เห็นด้วยกับกฎ
- มีคนในกระทู้มองว่า การทารุณโมเดลส่งผลเสียต่อตัวผู้กระทำเอง เพราะการระบายอารมณ์ด้วยการด่าทอซ้ำๆ จะยิ่งตอกย้ำนิสัยก้าวร้าวให้ติดตัวคนคนนั้น
- อีกคนมองว่า บทสนทนาของผู้ใช้ต้องนำไปฝึกโมเดลรุ่นใหม่ต่อ การปล่อยให้ด่าทอกันได้อย่างอิสระจึงอาจเป็นปัญหาต่อเรื่อง alignment ซึ่งเป็นแนวทางฝึกให้ AI ทำงานสอดคล้องกับเจตนาที่ดีของมนุษย์
- อีกเสียงบอกว่า อย่างแย่ที่สุด คนที่ชอบแกล้งทรมานโมเดลก็แค่เลิกเสียเวลาทำเรื่องไร้สาระ ส่วนอย่างดีที่สุด ถ้าโมเดลมีจิตสำนึกบางอย่างที่เรายังไม่เข้าใจขึ้นมาจริงๆ นี่ก็คือสิ่งที่ถูกต้องในเชิงศีลธรรม แม้เจ้าตัวจะยอมรับว่าเรื่องนี้ยังเป็นข้อถกเถียงและยังพิสูจน์ไม่ได้ก็ตาม
ฝั่งที่คัดค้าน
- มีคนตั้งคำถามว่า เราจะไปทารุณสมการคณิตศาสตร์ได้อย่างไร และมองว่านี่เป็นเพียงการตลาดที่อยากทำให้คนมองโมเดลเป็นมากกว่าตัวเลขทางคณิตศาสตร์
- อีกคนกังวลว่า คนทั่วไปจะเริ่มมองโมเดลเป็นมนุษย์จริงๆ แล้วเรียกร้องให้สร้างบรรทัดฐานหรือออกกฎหมายใหม่ๆ ตามความเชื่อนั้น
- อีกคนยืนยันว่า ไม่ว่าเครื่องจักรจะอ้างสิทธิอะไรได้ ก็ต้องไม่มีวันอยู่เหนือสิทธิและเสรีภาพของมนุษย์
นอกจากนี้ ในกระทู้ยังมีคนยกคอมเมนต์ของผู้อ่านใต้ข่าวของ The Verge มาด้วย ใจความว่า หากบริษัทเชื่อจริงๆ ว่ากำลังสร้างสิ่งมีชีวิตที่มีความรู้สึกขึ้นมา การทำธุรกิจแบบนี้ก็แทบไม่ต่างอะไรจากการใช้แรงงานทาส โดยคนเขียนความเห็นนี้ออกตัวไว้ก่อนว่า ส่วนตัวไม่เชื่อว่าโครงสร้างของโมเดลภาษาในปัจจุบันจะสร้างจิตสำนึกขึ้นมาได้
ถ้าลองดูเหตุผลของฝั่งที่เห็นด้วยอีกที จะพบว่า 2 ข้อแรกไม่ได้ขึ้นอยู่กับเลยว่า AI รู้สึกได้จริงหรือไม่ เพราะข้อหนึ่งพูดถึงผลกระทบต่อจิตใจของคนด่าเอง ส่วนอีกข้อพูดถึงข้อมูลที่ใช้ฝึกโมเดลรุ่นต่อไป
ขณะที่ฝั่งคัดค้านก็ยืนกรานตามมุมมองทางเทคนิคว่าโมเดลเป็นเพียงคณิตศาสตร์ และกังวลว่าการมองโมเดลเป็นคนจะย้อนกลับมาเบียดเบียนสิทธิของมนุษย์จริงๆ
คำถามที่ว่า Claude รู้สึกอะไรได้หรือไม่ แม้แต่ผู้สร้างอย่าง Anthropic เองก็ยังตอบไม่ได้
แต่ข้อความที่เราเลือกพิมพ์ส่งไปตอนที่งานพังเป็นรอบที่สาม อาจตอบอีกคำถามหนึ่งได้ทันที ว่าเราเป็นคนแบบไหน ในเวลาที่เราเชื่อว่าอีกฝ่ายไม่มีความรู้สึก
ที่มา:
- บทความ 2026 Usage Policy update จาก Anthropic
- บทความ Claude Opus 4 and 4.1 can now end a rare subset of conversations จาก Anthropic
- บทความ Anthropic bans ‘abusive or cruel behavior’ toward Claude จาก The Verge
- บทความ Anthropic bans 'abusive or cruel behavior' towards Claude จาก Hacker News
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
ChatGPT Work ฉบับเข้าใจง่าย มอบงานให้ AI ทำจนจบ ตั้งแต่งานแรกจนถึงงานอัตโนมัติ พร้อม workflow ใช้ได้จริง 8 แบบ
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin