AI agent เริ่มแย่ง CPU บน cloud จนส่วนลด spot ที่เคยได้ถึง 90% แทบหายหมด
CPU บน cloud เริ่มขาดตลาดตาม GPU และแรม เพราะ AI agent ลงมือ compile และรันเทสต์บน cloud ทำไม agent ถึงกิน CPU และทีมที่จ่ายค่า cloud ควรเตรียมอะไร
การเติบโตของ AI Agent หรือระบบปัญญาประดิษฐ์ที่ลงมือทำงานอัตโนมัติ ทำให้หลายบริษัทเริ่มหาชิปประมวลผลหลักอย่าง CPU บนเซิร์ฟเวอร์ Cloud ไม่ได้ และต้องยอมรับว่ายุคส่วนลดงามๆ จากผู้ให้บริการ Cloud จบลงแล้ว
เรื่องนี้เริ่มมีคนพูดถึงในวงอาหารค่ำมื้อหนึ่ง โดยผู้เขียนจดหมายข่าว The Pulse จาก The Pragmatic Engineer เล่าว่า เขาเพิ่งไปร่วมโต๊ะกับกลุ่มผู้บริหารสายเทคโนโลยีอย่าง CTO และหัวหน้าฝ่ายโครงสร้างพื้นฐาน แล้วพบว่าหลายคนเจอปัญหาเดียวกัน
turbopuffer เป็นบริษัทที่พัฒนาผลิตภัณฑ์โดยรันบน CPU เป็นหลัก ไม่ใช่ GPU สำหรับงาน AI โดยระบบของบริษัทกระจายอยู่บนผู้ให้บริการ Cloud รายใหญ่อย่าง AWS, GCP และ Azure เมื่อผู้เขียนลองถามว่าช่วงนี้จัดหา CPU ยากไหม Simon Eskildsen ซีอีโอของ turbopuffer ตอบว่า "การหา CPU ไม่ใช่เรื่องง่ายอีกต่อไปแล้ว"
ก่อนหน้านี้ กระแสความนิยม AI ทำให้ GPU ขาดตลาดอย่างหนัก ตามมาด้วยวิกฤตหน่วยความจำ ล่าสุด ปัญหานี้ลามมาถึงคิวของ CPU โดยสาเหตุสำคัญมาจากฝั่ง AI Agent ที่เริ่มลงมือเขียนและทดสอบโค้ดจริงบน Cloud ส่งผลให้ทีมที่ดูแลค่าใช้จ่าย Cloud เริ่มเห็นว่าส่วนลดราคาพิเศษที่เคยได้หายไป ซ้ำยังต้องรอคิวเครื่องนานขึ้นเรื่อยๆ
Agent คิดด้วย GPU แต่ลงมือทำงานจริงด้วย CPU
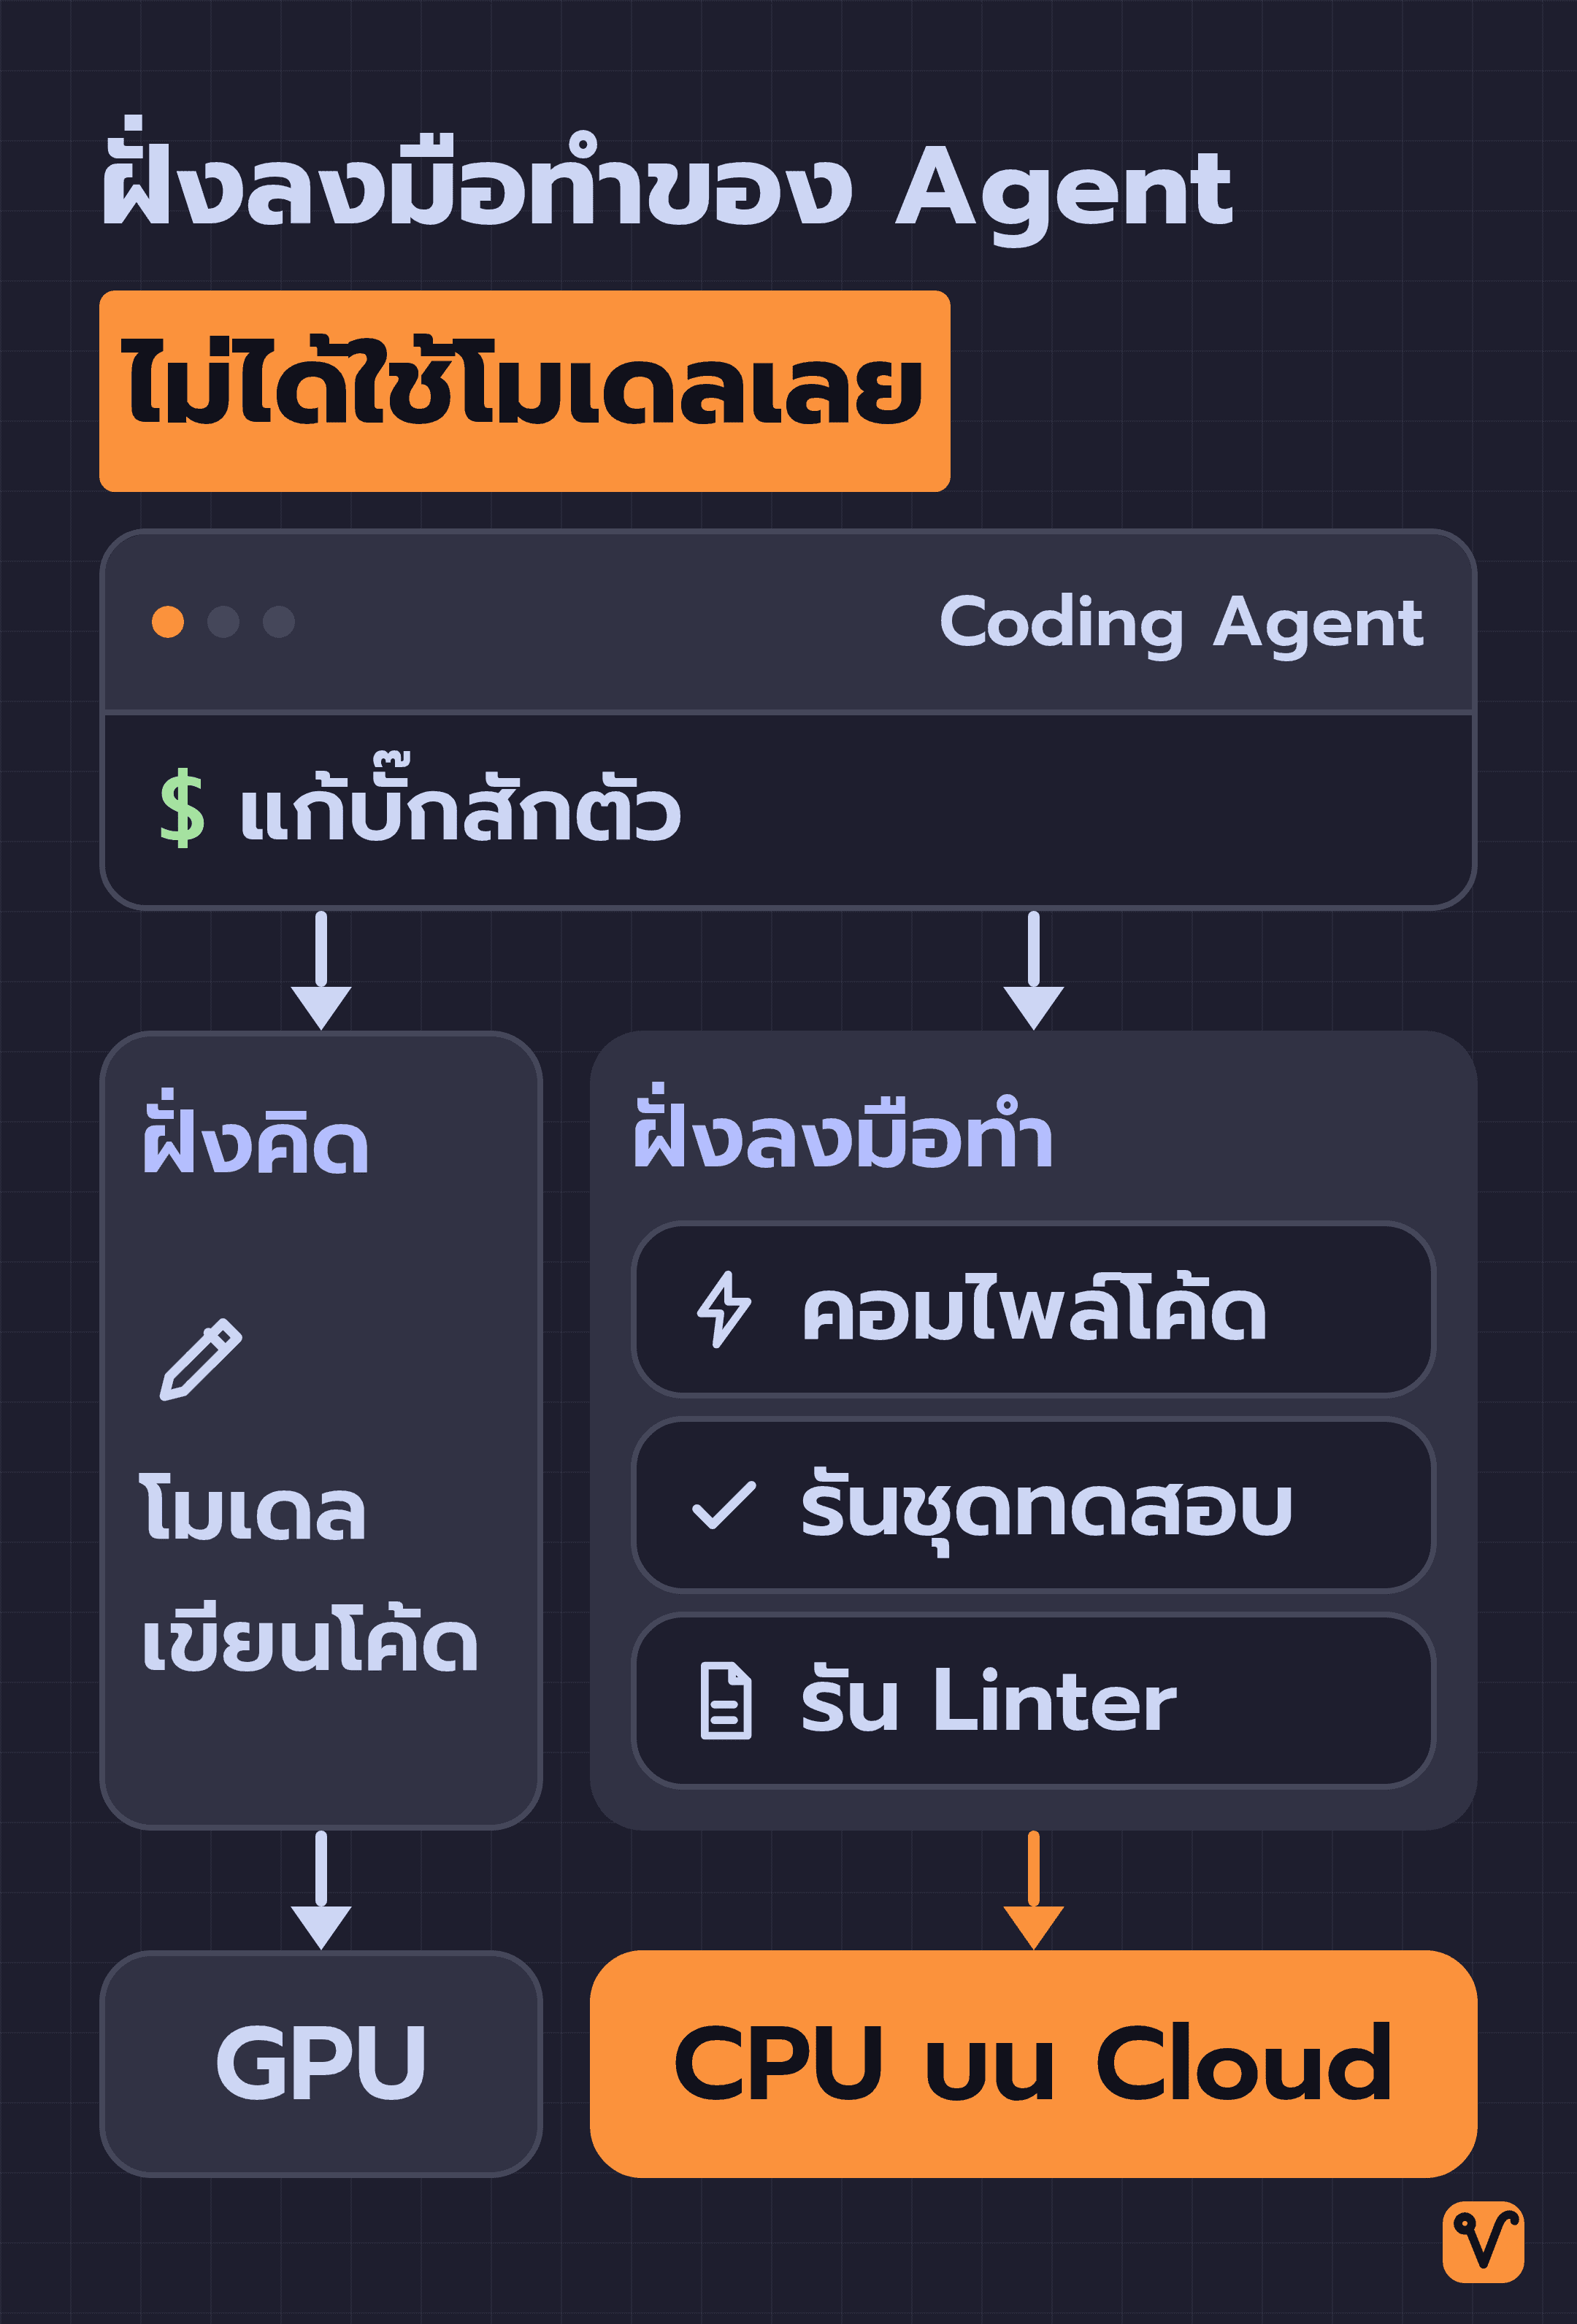
ลองนึกภาพตอนเราสั่งให้ผู้ช่วยเขียนโค้ดอย่าง Coding Agent ช่วยแก้บั๊กสักตัว งานจะแบ่งออกเป็น 2 ส่วนชัดเจน:
ส่วนแรกคือ "ฝั่งคิด" ตอนที่โมเดลอ่านโจทย์ วิเคราะห์ปัญหา แล้วเขียนโค้ดออกมา งานตรงนี้ใช้พลังการประมวลผลจาก GPU
ส่วนที่สองคือ "ฝั่งลงมือทำ" หลังจากเขียนโค้ดเสร็จ Agent จะต้องเรียกใช้เครื่องมือต่างๆ เพื่อจัดการโค้ดนั้น ทั้งคอมไพล์โค้ด รันชุดทดสอบ และรัน Linter โปรแกรมตรวจเช็กความเรียบร้อยของโค้ด โดยงานในฝั่งนี้กิน CPU หนักทั้งหมด
จุดที่พลาดง่ายคือ พอพูดถึงงาน AI เรามักนึกถึง GPU เป็นหลัก แต่ฝั่งลงมือทำนี้ไม่ได้ใช้โมเดลเลยแม้แต่น้อย เพราะนี่คือโปรแกรมชุดเดียวกับที่นักพัฒนาเคยรันบนเครื่องตัวเองมาตลอด แค่คราวนี้คนที่กดสั่งรันคือ Agent
เรื่องนี้กลายมาเป็นปัญหาใหญ่บน Cloud เพราะพฤติกรรมการทำงานเปลี่ยนไป ในบริษัทอย่าง Uber, Ramp และอีกหลายแห่ง Agent ไม่ได้รันอยู่บนเครื่องของนักพัฒนาอีกแล้ว แต่ย้ายไปรันบนเซิร์ฟเวอร์เฉพาะของตัวเองบน Cloud ทุกครั้งที่คอมไพล์ รันชุดทดสอบ หรือตรวจเช็กโค้ด ภาระงานจึงไปตกอยู่ที่ CPU บน Cloud ทั้งหมด ทำให้บริษัทเหล่านี้ต้องจอง CPU เพิ่มเพื่อรองรับงานของ Agent
ใครเคยเขียนโปรแกรมคงคุ้นกับเสียงพัดลมโน้ตบุ๊กที่ดังกระหึ่มเวลาเรากดสั่ง build โปรแกรม นั่นคือช่วงที่ CPU กำลังทำงานหนักที่สุด และพอ Agent ย้ายขึ้นไปทำงานบน Cloud ภาระงานหนักระดับนั้นก็ย้ายตามไปอยู่บนเซิร์ฟเวอร์ที่บริษัทต้องจ่ายเงินเช่าแทน
ข้อมูลจาก Uber ทำให้เห็นชัดว่าภาระงานนี้เติบโตเร็วแค่ไหน กราฟจากบล็อกของ Uber แสดงให้เห็นจำนวนครั้งที่สั่งงาน Agent หรือ Agent Request ภายในบริษัท ซึ่งพุ่งสูงขึ้นถึง 9.4 เท่าภายในเวลาเพียง 6 เดือน นับตั้งแต่เดือนกุมภาพันธ์เป็นต้นมา
ยิ่งสั่งงาน Agent บ่อยขึ้นเท่าไร งานฝั่งลงมือทำก็ยิ่งเพิ่มขึ้นเป็นเงาตามตัว ภาระการใช้งาน CPU จึงโตตามไปด้วย
แล็บ AI ก็ดึง CPU ไปใช้เทรนโมเดลเช่นกัน
อีกหนึ่งปัจจัยที่ดึงทรัพยากร CPU ไปมหาศาล มาจากบรรดาแล็บพัฒนา AI ที่ต้องเทรนโมเดลด้วยตัวเอง โดย Simon อธิบายว่า การเทรนโมเดลด้วยเทคนิค RL หรือ Reinforcement Learning ซึ่งเป็นการสอนให้โมเดลลองผิดลองถูกด้วยการลงมือรันซอฟต์แวร์จริง กำลังกลายเป็นงานก้อนใหญ่ของแล็บเหล่านี้
ซอฟต์แวร์ที่โมเดลต้องรันระหว่างฝึกนั้นต้องพึ่งพา CPU ทำให้แล็บ AI ต้องดึงทรัพยากร CPU ไปใช้งานเป็นจำนวนมหาศาล
Simon มองว่านอกจากเรื่อง RL แล้ว กระแสการใช้งาน Agent ทั่วไปก็เป็นอีกหนึ่งแรงผลักดันที่ทำให้ความต้องการ CPU เพิ่มสูงขึ้นอย่างต่อเนื่อง
เขายังเล่าอีกว่า แม้แต่บริษัทเทคโนโลยียักษ์ใหญ่ด้วยกันเองก็ยังต้องแย่งโควตา CPU กันอย่างหนัก และคาดว่าสถานการณ์ฝั่ง CPU จะทวีความรุนแรงขึ้นอีกมาก ก่อนที่ทุกอย่างจะเริ่มคลี่คลาย
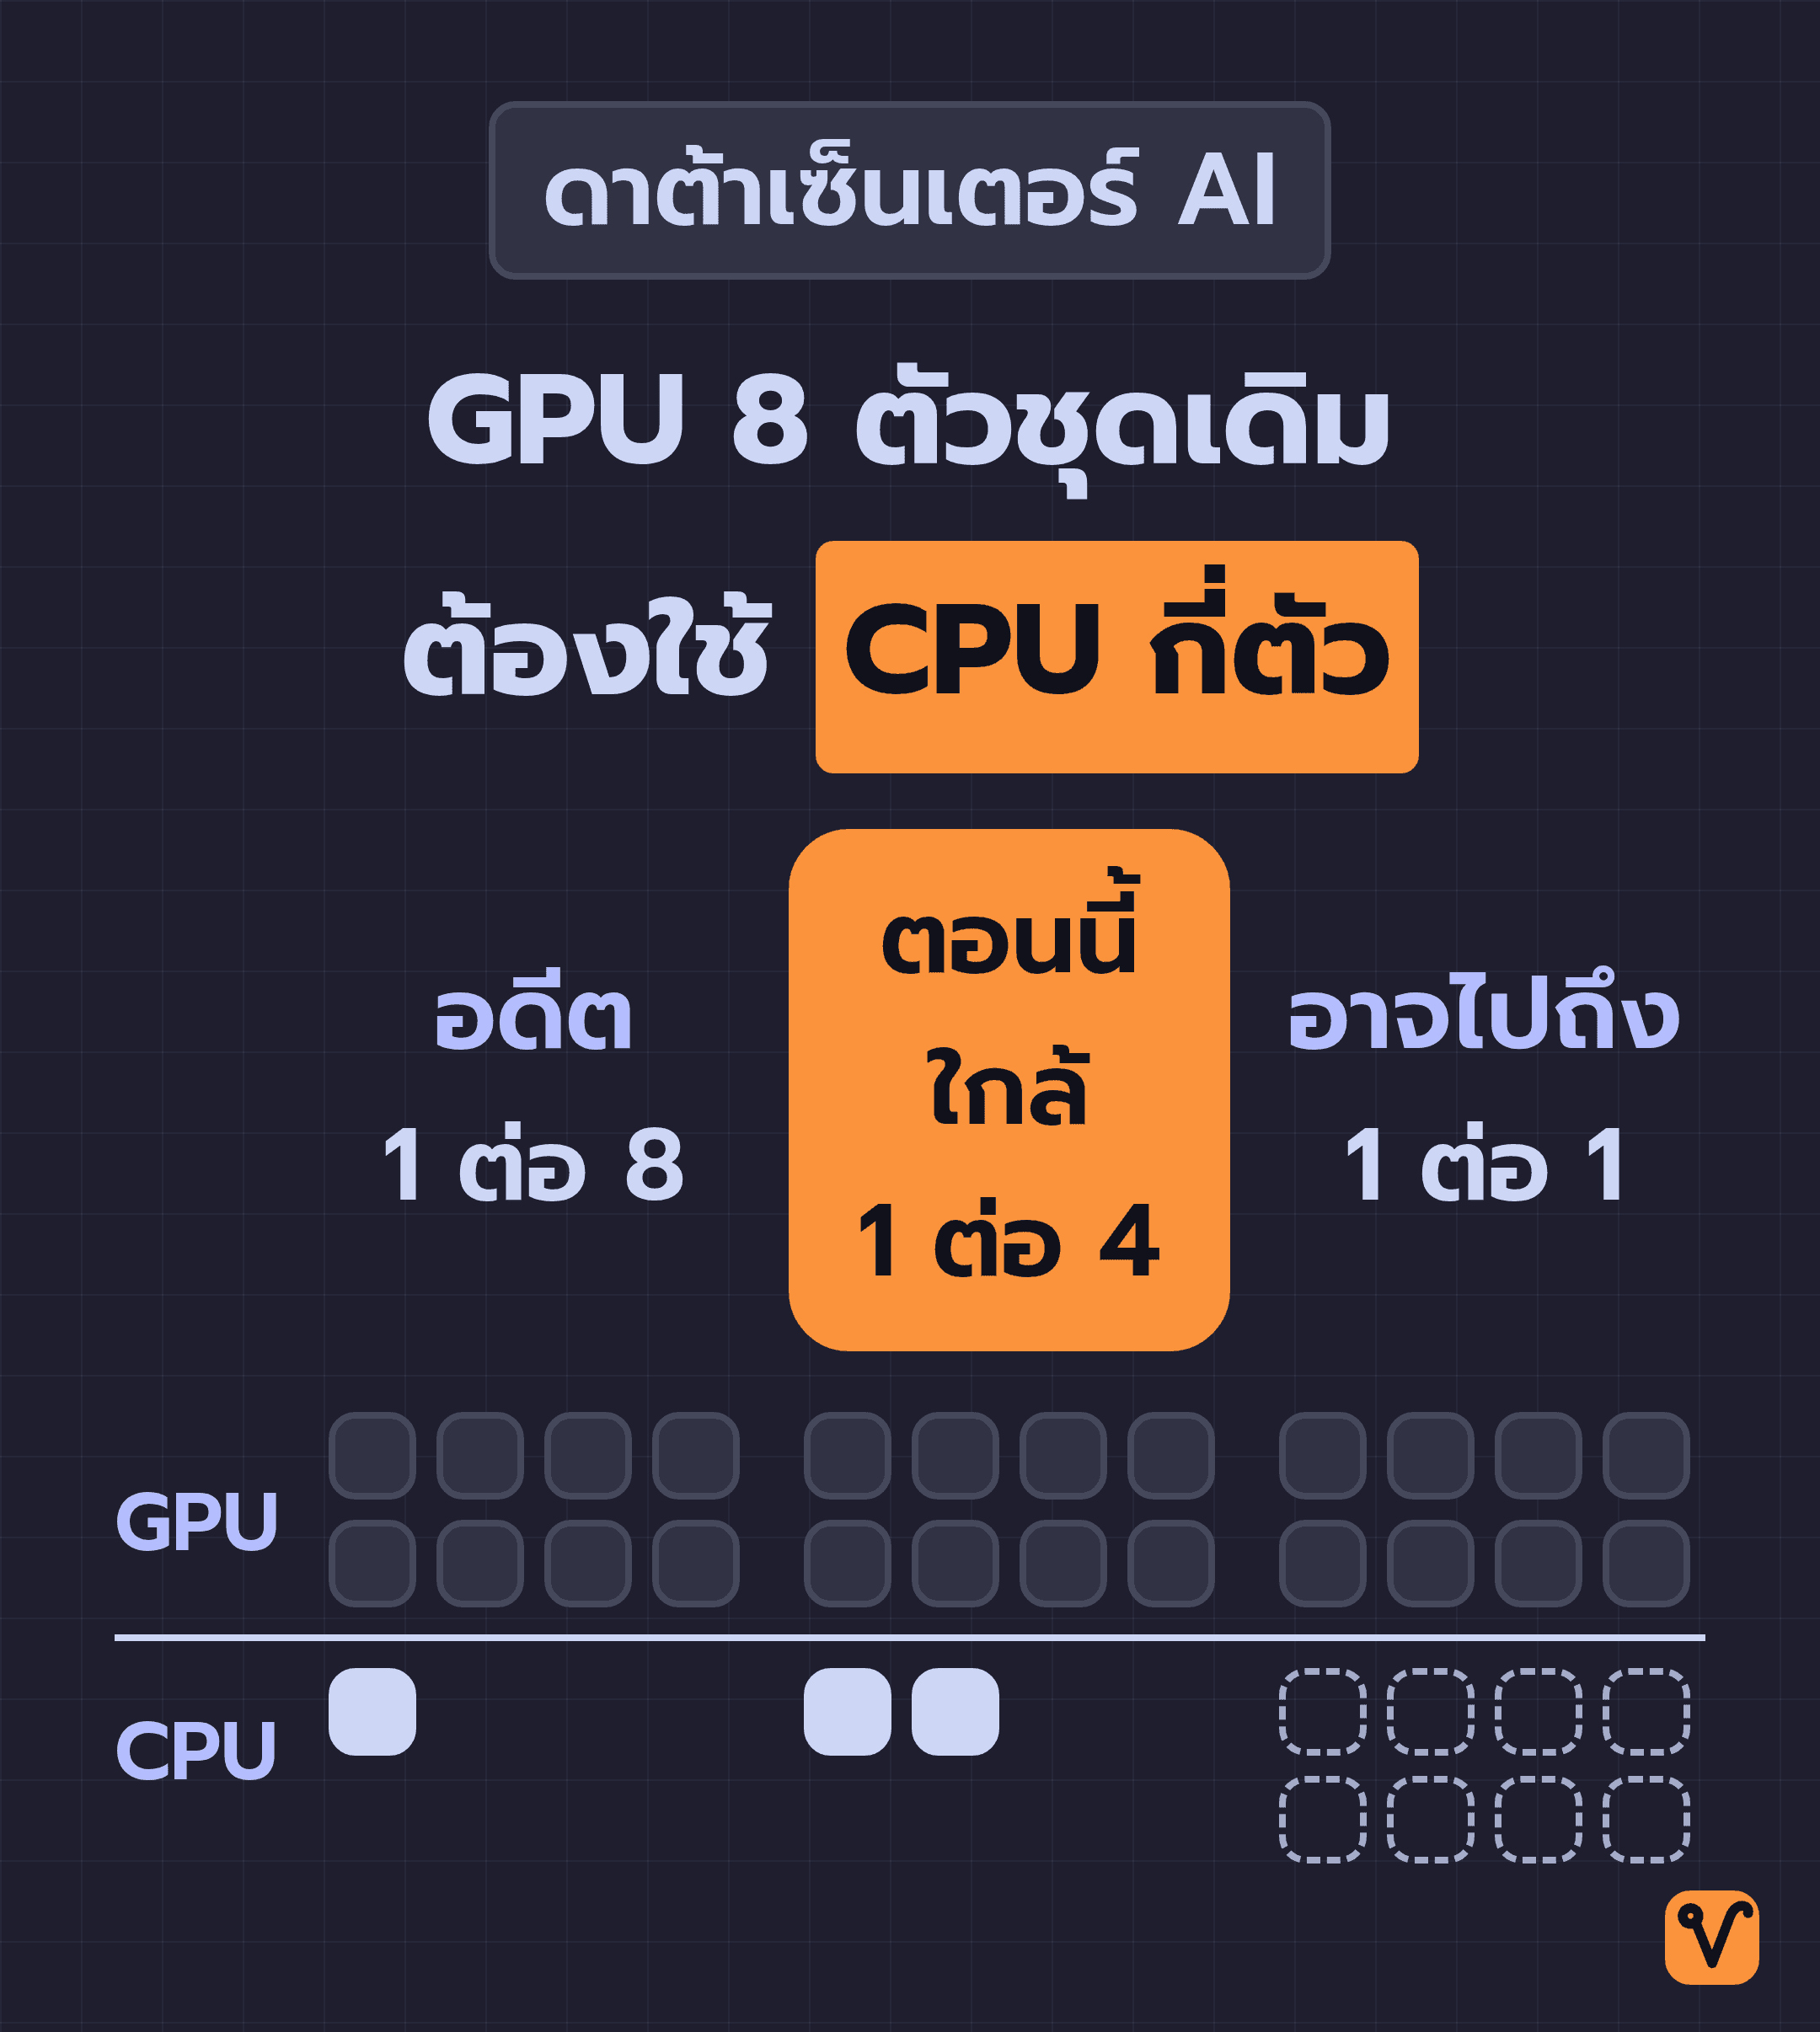
ผู้เขียนบทความใช้สัดส่วน CPU ต่อ GPU สรุปภาพรวมไว้ว่า ในอดีต ดาต้าเซ็นเตอร์สำหรับ AI เคยใช้ CPU เพียง 1 ตัวต่อ GPU 8 ตัว แต่ปัจจุบันสัดส่วนนี้ขยับเข้ามาใกล้ 1 ต่อ 4 แล้ว และอาจไปถึง 1 ต่อ 1
เทียบให้เห็นภาพง่ายๆ คือ GPU 8 ตัวชุดเดิม ที่เคยประกบคู่กับ CPU แค่ตัวเดียว ตอนนี้ต้องขยับมาใช้ CPU ประมาณ 2 ตัว และถ้าสัดส่วนกลายเป็น 1 ต่อ 1 จริง ก็จะต้องใช้ CPU มากถึง 8 ตัวเลยทีเดียว
กำลังการผลิต CPU โดนบีบจากโรงงานสองด้าน
ในเมื่อความต้องการพุ่งสูงขนาดนี้ ทำไมผู้ผลิตถึงไม่เร่งผลิต CPU เพิ่มให้ทัน?
คำอธิบายเรื่องนี้มาจาก Katelyn Lesse หัวหน้าฝ่ายวิศวกรรมแพลตฟอร์มของ Claude Platform ซึ่งเขียนเล่าไว้บน X ว่าความต้องการชิปจากกระแส AI พุ่งสูงขึ้นมากในช่วงไม่กี่ปีที่ผ่านมา แต่โรงงานผลิตชิปที่มีอยู่เพียงไม่กี่แห่งในโลก ต้องใช้เวลานานหลายปีและเงินลงทุนมหาศาลหลายหมื่นล้านดอลลาร์ กว่าจะขยายกำลังการผลิตให้เพียงพอ
แม้ CPU กับ GPU จะฟังดูเหมือนสินค้าคนละตลาด แต่ในขั้นตอนการผลิตจริง ทั้งคู่กลับต้องแย่งกำลังการผลิตในโรงงานเดียวกัน ทำให้ CPU โดนบีบพร้อมกันจากสองฝั่ง:
- ฝั่งผลิตชิป: ที่ TSMC ซึ่งเป็นโรงงานผลิตชิปให้หลายค่าย สายการผลิต GPU ต้องแย่งชิงพื้นที่กับสายการผลิต CPU และยังต้องแบ่งโควตาให้กับชิปของลูกค้ารายใหญ่อื่นๆ อย่าง Apple, Qualcomm และ Broadcom ด้วย
- ฝั่งผลิตหน่วยความจำ: ที่ผู้ผลิตหน่วยความจำอย่าง SK Hynix, Samsung และ Micron นั้น HBM หน่วยความจำความเร็วสูงที่ใช้คู่กับ GPU กำลังแย่งกำลังการผลิตกับ DRAM หรือแรมแบบธรรมดา
ผลกระทบที่ตามมาจึงแตกต่างกันไปในแต่ละค่าย โดย AMD ที่ไม่มีโรงงานเป็นของตัวเอง ต้องรอคิวโควตาผลิต CPU จาก TSMC ที่ตึงตัวอยู่แล้ว
ส่วน Intel แม้จะมีโรงงานผลิตของตัวเอง แต่ก็ยังติดปัญหาเรื่อง Yield เพราะสัดส่วนชิปที่ผลิตออกมาแล้วใช้งานได้จริงยังต่ำกว่าที่ควร
นอกจากนี้ Intel ยังดึงกำลังการผลิตบางส่วนจากชิปคอมพิวเตอร์ส่วนบุคคลทั่วไป ไปผลิตชิปเซิร์ฟเวอร์เพิ่ม
ไม่ว่าจะใช้ CPU ค่ายไหน ทุกตัวต่างต้องทำงานคู่กับ DRAM ที่ราคาแพงขึ้น เพราะผู้ผลิตหน่วยความจำหันไปผลิต HBM มากขึ้น
Katelyn เล่าว่า นักวิเคราะห์คาดการณ์ว่าปัญหาการขาดแคลน CPU น่าจะเริ่มคลี่คลายได้ก่อนฝั่งหน่วยความจำ แต่ถึงอย่างนั้นก็ยังคงต้องรออีกหลายไตรมาส
ส่วนลด Spot 90% ที่แทบไม่เหลือให้เห็น
ประเด็นสำคัญอีกเรื่องที่คนร่วมโต๊ะอาหารวันนั้นพูดถึง คือ Spot Instance หรือเซิร์ฟเวอร์ว่างบน Cloud ที่ผู้ให้บริการนำมาลดราคาปล่อยเช่า เครื่องประเภทนี้เคยมีราคาถูกกว่าปกติได้สูงสุดถึง 90% แต่ปัจจุบัน ส่วนลดระดับนั้นแทบจะหายไปหมดแล้ว
ส่วนลดดังกล่าวเกิดขึ้นได้เพราะยังมีเครื่องว่างเหลืออยู่ในระบบ แต่เมื่อความต้องการ CPU พุ่งสูงขึ้น เครื่องว่างเหล่านั้นก็มีคนเช่าไปจนหมด ส่วนลดจึงหายตามไปด้วย คนในวงอาหารค่ำหลายคนเล่าตรงกันว่า ตอนนี้แทบไม่มีโอกาสได้ใช้ CPU แบบ Spot เลย เว้นแต่ว่าบริษัทของคุณจะดีลกับผู้ให้บริการ Cloud มาอย่างยาวนาน
การจองเครื่องก็ยากขึ้นมากเช่นกัน ถ้าต้องการ CPU รุ่นเฉพาะ บางครั้งต้องจองล่วงหน้านานหลายเดือน และบางครั้งผู้ให้บริการ Cloud ก็ปฏิเสธ เพราะมี CPU ไม่พอ หรือไม่มีรุ่นที่ลูกค้าต้องการ
ส่วนคนที่สั่งซื้อเซิร์ฟเวอร์ก็ต้องรอนานขึ้นมาก ปัจจุบันต้องใช้เวลาราว 6 เดือนกว่าจะได้รับเครื่อง จากเดิมที่เคยรอเพียง 1–2 สัปดาห์เท่านั้น แถมราคายังขยับสูงขึ้นอีก 10 ถึง 20% ตามที่ Katelyn ระบุไว้
ที่สำคัญคือ ต่อให้มีเงินพร้อมจ่ายเต็มที่ ก็ใช่ว่าจะได้เครื่องเสมอไป ผู้บริหารฝ่ายวิศวกรรมของบริษัทใหญ่แห่งหนึ่งที่ให้บริการรันโมเดล AI เล่าว่า บริษัทของเขาซื้อโควตา GPU และ CPU จากผู้ให้บริการ Cloud จนชนเพดานแล้ว และแม้จะพร้อมเซ็นสัญญาระยะยาวที่สุด ผู้ให้บริการ Cloud ก็ยังตอบกลับมาว่า ไม่มีเครื่องเหลือให้เช่าแล้ว
นอกจากนี้ ผู้เขียนยังเล่าถึงข่าวลือที่ได้ยินมาว่า ศูนย์ข้อมูลบาง Region ของผู้ให้บริการ Cloud เริ่มไม่รับลูกค้าใหม่แล้ว เนื่องจากมีคนเช่า CPU จนเต็มความจุ และยังมีลูกค้าบางรายที่ยอมจ่ายเงินตั้งแต่วันนี้ เพียงเพื่อจองเครื่องล่วงหน้าที่จะเริ่มใช้งานได้ในเดือนธันวาคม
ถึงเวลาวางแผนการใช้ CPU ล่วงหน้า
สิ่งแรกที่ต้องปรับเปลี่ยนคือวิธีคิด Katelyn สะท้อนมุมมองอย่างตรงไปตรงมาว่า "คนส่วนใหญ่ไม่เคยคิดจะวางแผนเลยว่าจะต้องใช้ CPU เท่าไร" เพราะที่ผ่านมา หลายทีมมักวางแผนล่วงหน้าเฉพาะระบบฐานข้อมูล และอาจวางแผน GPU บ้างเมื่อจำเป็นเท่านั้น ส่วน CPU มักปล่อยให้เป็นหน้าที่ของระบบ Autoscale คอยเพิ่มลดเครื่องให้อัตโนมัติตามปริมาณงานและงบประมาณ
เธอบอกว่า ตอนนี้ CPU กลายเป็นทรัพยากรที่หลายทีมต้องทำสัญญาจองล่วงหน้าไปแล้ว จึงควรเริ่มคาดการณ์และวางแผนความต้องการใช้งานอย่างจริงจัง
ถ้ายังคงหวังพึ่งพาระบบ Autoscale แบบเดิม ในวันที่ปริมาณงานเติบโตขึ้นอย่างรวดเร็ว คุณอาจพบว่าไม่มี CPU บน Cloud เหลือให้ระบบขยายตัวได้แล้ว เหมือนกับที่ผู้บริหารฝ่ายวิศวกรรมรายนั้นเจอมาแล้วว่า ต่อให้มีงบพร้อมจ่าย ผู้ให้บริการ Cloud ก็ไม่มีเครื่องให้ใช้งาน
คำแนะนำในบทความสรุปออกมาเป็น 4 ข้อชัดเจน:
- วางแผนจำนวน CPU ที่ต้องใช้ล่วงหน้าถึง 12 เดือน: ประเมินความต้องการล่วงหน้าว่าในปีถัดไปจะต้องใช้เครื่องเท่าไร แล้วรีบจองให้ทัน
- ใช้ CPU ที่มีอยู่เดิมให้คุ้มค่าที่สุดก่อน: ตรวจสอบว่าบริการย่อยตัวไหนใช้ CPU หนัก และจำเป็นต้องใช้มากขนาดนั้นจริงหรือไม่ ส่วนบริการไหนที่ใช้ CPU น้อย ลองพิจารณาจับมารวมไว้บนเซิร์ฟเวอร์หรือ Node ให้น้อยเครื่องลง เพื่อเหลือโควตา CPU ไว้ให้กับบริการที่จำเป็นต้องใช้มากกว่า
- หากเคยพึ่งพา Spot Instance กับงานที่ผันผวน ลองพิจารณาจองเครื่องแบบคงที่แทน: แม้จะแพงกว่า แต่ทีมต้องชั่งน้ำหนักเองระหว่างการยอมจ่ายแพงขึ้นเพื่อให้มั่นใจว่ามีเครื่องให้ใช้งานอย่างแน่นอน กับความเสี่ยงจากการพึ่งพา Spot ที่ตอนนี้แทบหาไม่ได้แล้ว
- หากคาดว่าระบบจะต้องเติบโต ให้รีบจองตั้งแต่วันนี้: เพราะคนที่จองตั้งแต่เนิ่นๆ ยังพอมีโอกาสเลือกโควตาในบางเขตศูนย์ข้อมูล หรือ Region จากผู้ให้บริการบางรายได้อยู่
ขาดแคลนทุกอย่าง ยกเว้นระบบเครือข่าย
ผู้เขียนบทความทิ้งท้ายด้วยข้อสังเกตว่า ตอนนี้ขาดแคลนทั้ง GPU, หน่วยความจำ และ CPU ส่วนช่วงปลายปีที่แล้วก็เคยมีข่าวฮาร์ดดิสก์ขาดตลาดมาแล้ว สิ่งเดียวที่ดูเหมือนจะยังไม่เจอปัญหาขาดแคลนในตอนนี้ก็คือระบบเครือข่ายที่เชื่อมโยงเซิร์ฟเวอร์เข้าด้วยกัน
ในยุคของ AI Agent ต้นทุนของ AI ไม่ได้จบลงแค่ในขั้นตอนที่โมเดล "คิด" อีกต่อไป แต่ตามไปถึงทุกขั้นตอนที่โมเดลต้อง "ลงมือทำ" ด้วย
แล้วทีมของคุณเริ่มหา Spot Instance ไม่ได้ หรือเริ่มเห็นค่าบริการ Cloud พุ่งสูงขึ้นบ้างหรือยัง? ปัจจุบันทีมของคุณยังรัน Coding Agent บนเครื่องตัวเอง หรือย้ายขึ้นไปทำงานบน Cloud กันหมดแล้ว? แวะมาแลกเปลี่ยนกันได้ในคอมเมนต์ด้านล่างนะ
ที่มา: บทความ The Pulse: a new trend of CPU shortages จาก The Pragmatic Engineer
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
ChatGPT Work ฉบับเข้าใจง่าย มอบงานให้ AI ทำจนจบ ตั้งแต่งานแรกจนถึงงานอัตโนมัติ พร้อม workflow ใช้ได้จริง 8 แบบ
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ