เปิดหน้าเว็บแล้วโมเดล AI ทำงานในเครื่องเลย · Gemma 4 E2B รันในเบราว์เซอร์ผ่าน WebGPU ได้จริง
Gemma 4 E2B คือโมเดล AI ไซซ์จิ๋วของ Google ที่ออกแบบมาให้รันบนเครื่องตัวเอง ตอนนี้มีเดโมที่รันมันในเบราว์เซอร์ล้วนๆ ผ่าน WebGPU ไม่ต้องลงโปรแกรม ไม่ต้องต่อเซิร์ฟเวอร์ และข้อมูลไม่ออกจากเครื่องเลย
เปิดเว็บเบราว์เซอร์หน้าเดียว รอโหลดโมเดลลงเครื่องสักครู่ แล้วพิมพ์แชตคุยกับ AI ได้ทันทีโดยไม่ต้องส่งข้อความไปหาเซิร์ฟเวอร์ภายนอกและไม่ต้องต่อ API ให้ยุ่งยาก ทุกอย่างถูกประมวลผลบนชิปกราฟิกในเครื่องเราเอง นี่คือสิ่งที่ทีม webml-community ทำให้เห็นจริงผ่าน Gemma 4 E2B โมเดลขนาดเล็กจาก Google ที่ออกแบบมาเพื่อรันบนอุปกรณ์ของผู้ใช้งานโดยตรง
เดโมนี้รัน Gemma 4 E2B บนเบราว์เซอร์ล้วนๆ ผ่านมาตรฐาน WebGPU ซึ่งเป็น API เร่งความเร็วกราฟิกที่มีในเบราว์เซอร์ยุคใหม่อยู่แล้ว โดยผู้พัฒนาสามารถทำความเร็วได้สูงถึง 255 tokens ต่อวินาที บนเครื่อง MacBook ชิป Apple M4 Max ซึ่งเร็วพอให้ข้อความไหลออกมาอย่างต่อเนื่องแทบจะทันทีโดยไม่ต้องรอ สิ่งที่น่าทึ่งคือทั้งหมดนี้ทำงานได้โดยไม่ต้องติดตั้งซอฟต์แวร์หรือไดรเวอร์อะไรเพิ่ม แค่เปิดแท็บเบราว์เซอร์ขึ้นมาก็พร้อมใช้งาน
การรันโมเดลในเครื่องตัวเองมีความหมายอย่างไร
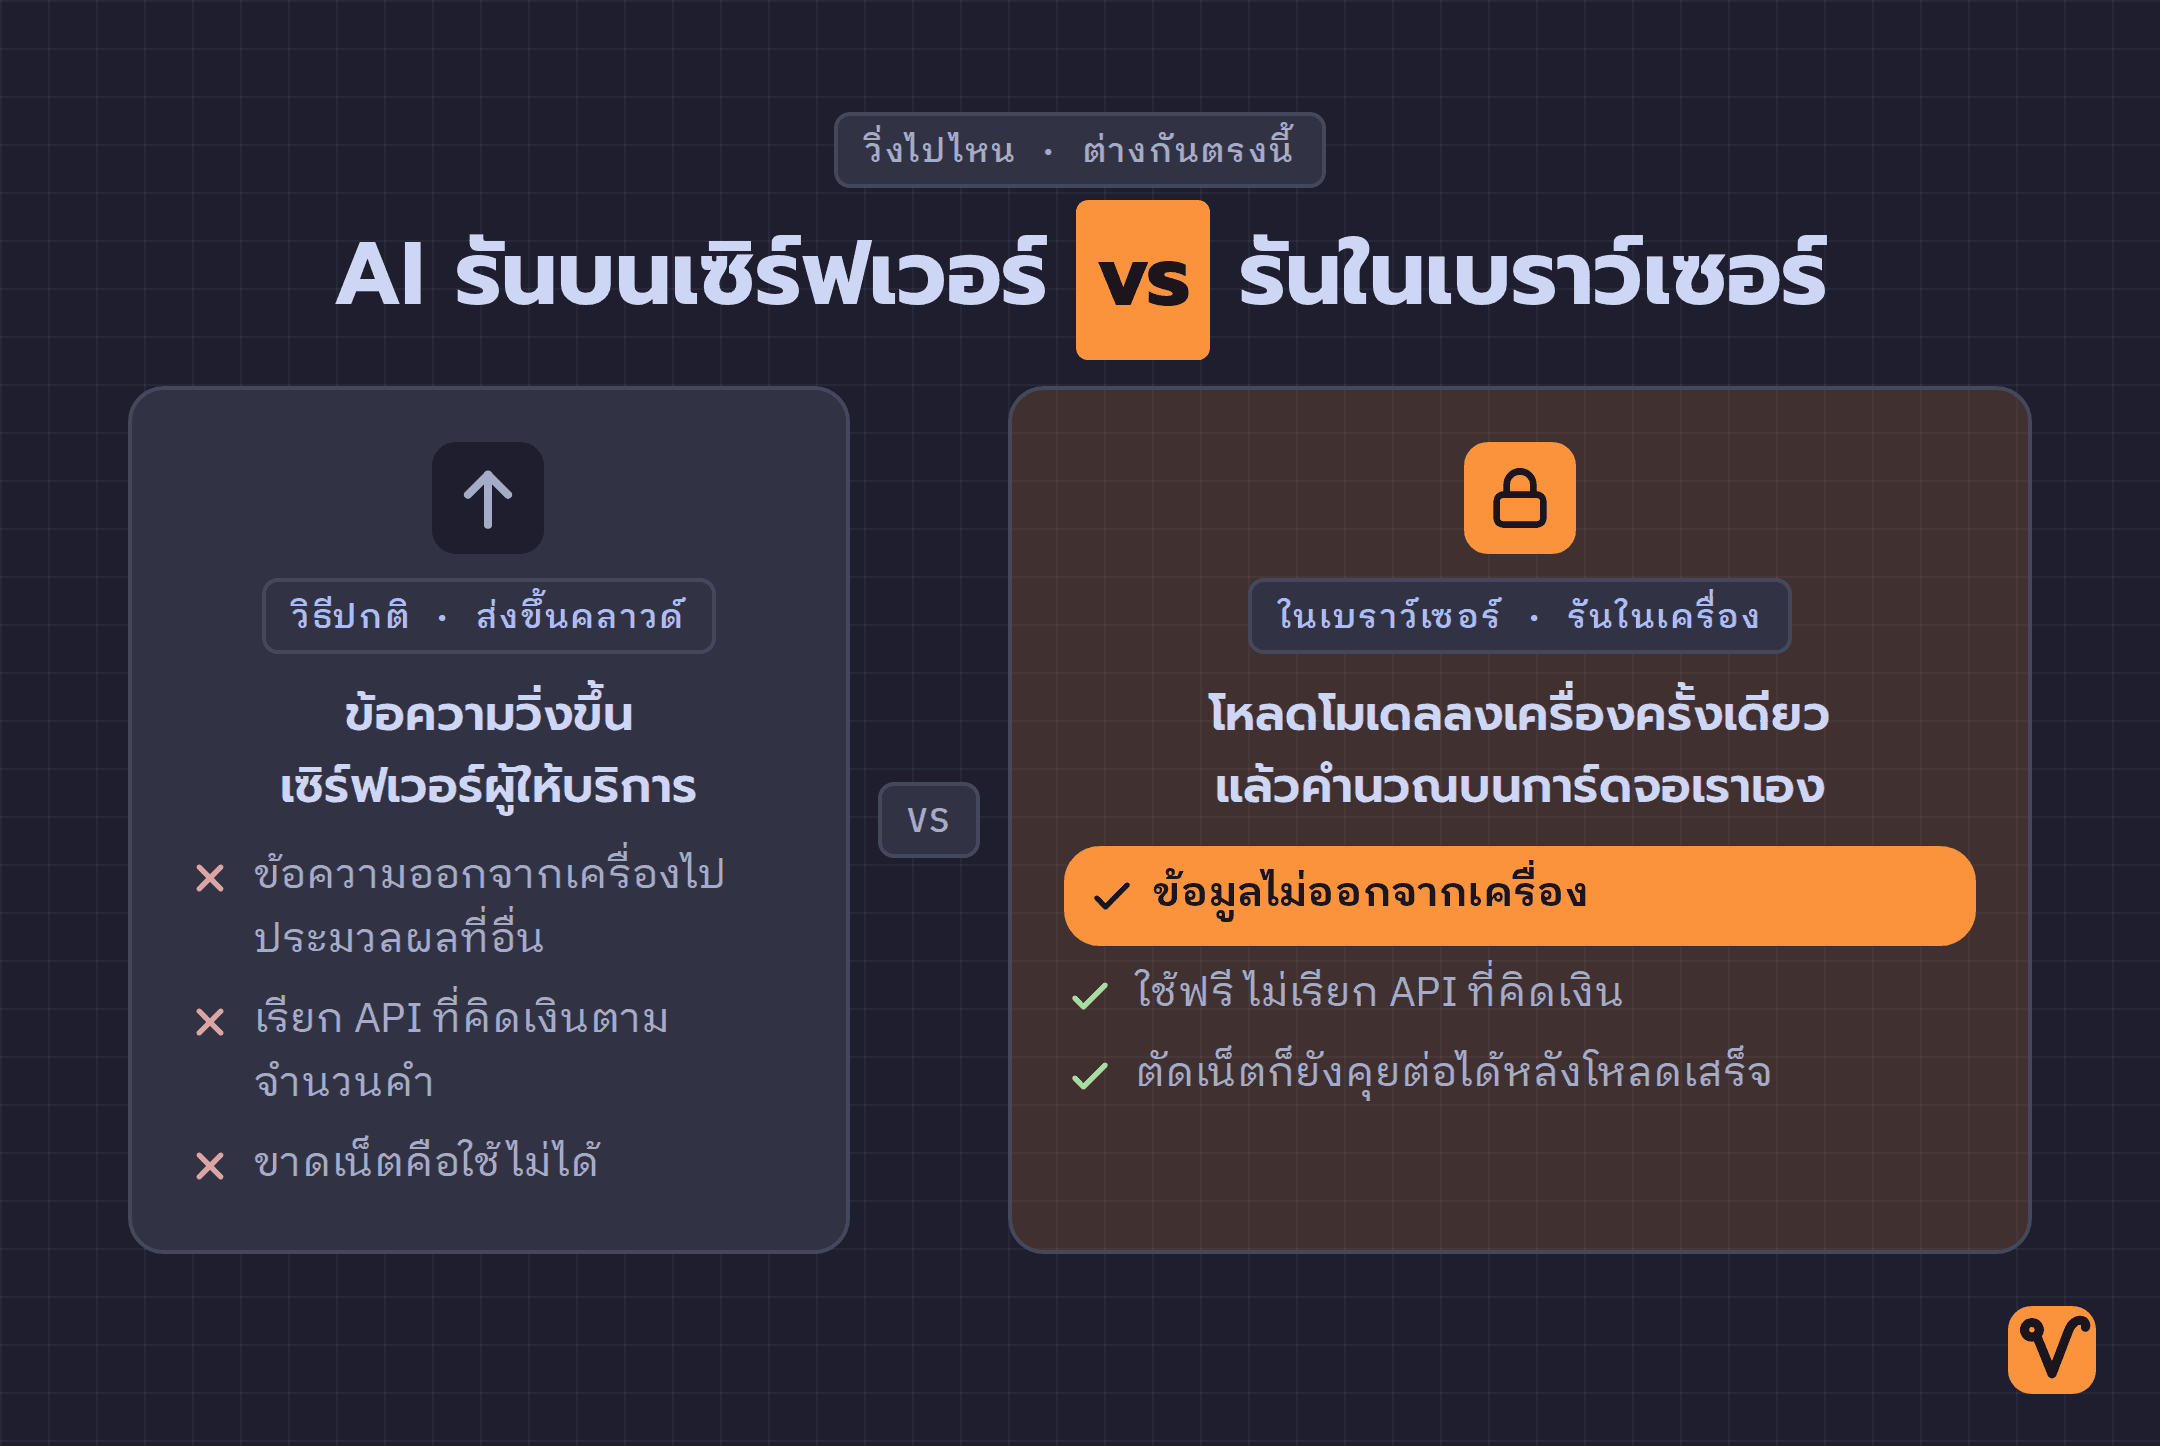
เวลาที่เราใช้บริการ AI ทั่วไป ข้อความและพรอมต์จะถูกส่งขึ้นไปประมวลผลบนคลาวด์เซิร์ฟเวอร์ของผู้ให้บริการ แล้วจึงส่งคำตอบกลับมา แต่เดโมนี้เปลี่ยนวิธีคิดใหม่ทั้งหมด ด้วยการดาวน์โหลดน้ำหนักโมเดลมาเก็บไว้ที่แคชของเบราว์เซอร์ แล้วให้การ์ดจอในเครื่องเราทำหน้าที่คำนวณทั้งหมด
ประโยชน์หลักของการรัน Local AI แบบนี้มี 3 เรื่องชัดเจน:
- ความเป็นส่วนตัวสูงสุด (Privacy): ข้อมูลและข้อความทั้งหมดไม่เคยหลุดออกจากเครื่อง
- ประหยัดค่าใช้จ่าย: ใช้งานได้ฟรี ไม่ต้องจ่ายค่า API ตามจำนวน token
- ทำงานออฟไลน์ได้ (Offline Ready): เมื่อดาวน์โหลดโมเดลเสร็จแล้ว แม้จะตัดการเชื่อมต่ออินเทอร์เน็ตก็ยังเปิดใช้งานและพิมพ์คุยได้ตามปกติ
ทำไมต้องเป็น Gemma 4 E2B ไม่ใช่โมเดลตัวเต็ม
หัวใจสำคัญที่ทำให้การรันในเบราว์เซอร์เป็นไปได้คือขนาดของโมเดล แม้ว่าตระกูล Gemma 4 จะมีขนาดใหญ่ระดับหลายหมื่นล้านพารามิเตอร์ แต่เวอร์ชันที่นำมาใช้คือ E2B ซึ่งเป็นโมเดลขนาดกะทัดรัดที่สุด ออกแบบมาสำหรับรันบนอุปกรณ์ส่วนบุคคลและสมาร์ตโฟนโดยเฉพาะ
E2B มีพารามิเตอร์ที่ใช้คำนวณจริง (Effective Parameters) อยู่ที่ราว 2.3 พันล้านพารามิเตอร์ นอกจากนี้เวอร์ชันในเดโมยังผ่านการทำ QAT (Quantization-Aware Training) บีบอัดขนาดน้ำหนักโมเดลลงมาเหลือระดับ 2-bit สำหรับเลเยอร์ถอดรหัส พร้อมปรับแต่งหน่วยความจำ KV Cache ให้กินแรมน้อยลง ทั้งหมดนี้ทำให้โมเดลมีขนาดเล็กพอที่จะโหลดเข้าเบราว์เซอร์ได้รวดเร็วและยังตอบคำถามได้รู้เรื่อง
ยิ่งไปกว่านั้น E2B ยังรองรับ Context Window สูงถึง 128K tokens รองรับข้อมูลทั้งข้อความ รูปภาพ และเสียง และเปิดให้ใช้งานภายใต้สัญญาอนุญาตแบบ Apache 2.0 ตามนโยบายของ Gemma ทำให้สามารถนำไปพัฒนาต่อยอดในโปรเจกต์จริงได้ทันที
ทำความเข้าใจตัวเลขความเร็ว 255 Tokens ต่อวินาที
ตัวเลขความเร็ว 255 tokens ต่อวินาทีเป็นผลลัพธ์ที่น่าประทับใจ แต่ควรเข้าใจบริบทของการทดสอบด้วยว่า ตัวเลขนี้วัดบนฮาร์ดแวร์ระดับท็อปอย่าง MacBook Pro ชิป M4 Max ไม่ใช่ความเร็วมาตรฐานที่ทุกอุปกรณ์จะทำได้เท่ากัน
ความเร็วในการประมวลผลจริงจะขึ้นอยู่กับประสิทธิภาพของชิปและชิปกราฟิกในแต่ละเครื่อง หากใช้เครื่องที่มีสเปกรองลงมา ความเร็วก็จะลดหลั่นกันไป ดังนั้นควรมองตัวเลขนี้เป็นขีดความสามารถสูงสุดที่เป็นไปได้บนเครื่องสเปกสูง และสิ่งสำคัญคือโมเดลนี้มีความเร็วที่เพียงพอต่อการใช้งานจริงในชีวิตประจำวัน
AI ที่เคยต้องพึ่งพาเซิร์ฟเวอร์ขนาดใหญ่ ตอนนี้มีขนาดเล็กและเบาพอที่จะทำงานจบได้ในแท็บเบราว์เซอร์เดียว
ศักยภาพและข้อจำกัดของ Gemma 4 E2B
การลดขนาดโมเดลให้เล็กลงย่อมต้องแลกกับความสามารถบางอย่าง E2B รับมือกับงานทั่วไปได้ดี แต่ไม่ได้มีความฉลาดเทียบเท่าโมเดลขนาดใหญ่ ในการทดสอบความรู้ทั่วไปอย่าง MMLU-Pro ตัว E2B ทำคะแนนได้ราว 60% ในขณะที่โมเดลรุ่นพี่อย่าง Gemma 4 31B ทำได้ถึง 85% โดยเฉพาะงานที่ต้องใช้ตรรกะซับซ้อนหรืองานเขียนโค้ดขั้นสูง
นี่คือข้อแลกเปลี่ยนที่ตรงไปตรงมา เรายอมลดความสามารถเชิงลึกบางส่วน เพื่อแลกกับความคล่องตัว ความเป็นส่วนตัว และการทำงานได้แบบออฟไลน์ สำหรับงานสรุปเนื้อหา ร่างอีเมล ตอบคำถามทั่วไป หรือการทดลองระบบ E2B ตอบโจทย์ได้ดีเยี่ยม แต่หากเป็นงานวิเคราะห์ที่ต้องการความแม่นยำสูงสุด โมเดลขนาดใหญ่บนคลาวด์ยังคงมีความได้เปรียบ
| ข้อดีที่ได้รับ | สิ่งที่ต้องแลกเปลี่ยน |
|---|---|
| ประมวลผลในเครื่อง ข้อมูลปลอดภัย 100% | ใช้ทรัพยากรการ์ดจอของเครื่องตัวเอง |
| ใช้งานได้ฟรี ทำงานแบบออฟไลน์ได้ | ต้องดาวน์โหลดไฟล์โมเดลขนาดใหญ่ในครั้งแรก |
| ไม่ต้องติดตั้งโปรแกรม เปิดผ่านเว็บได้เลย | ความสามารถในการคิดวิเคราะห์น้อยกว่าโมเดลตัวใหญ่ |
วิธีเริ่มต้นทดลองใช้งาน
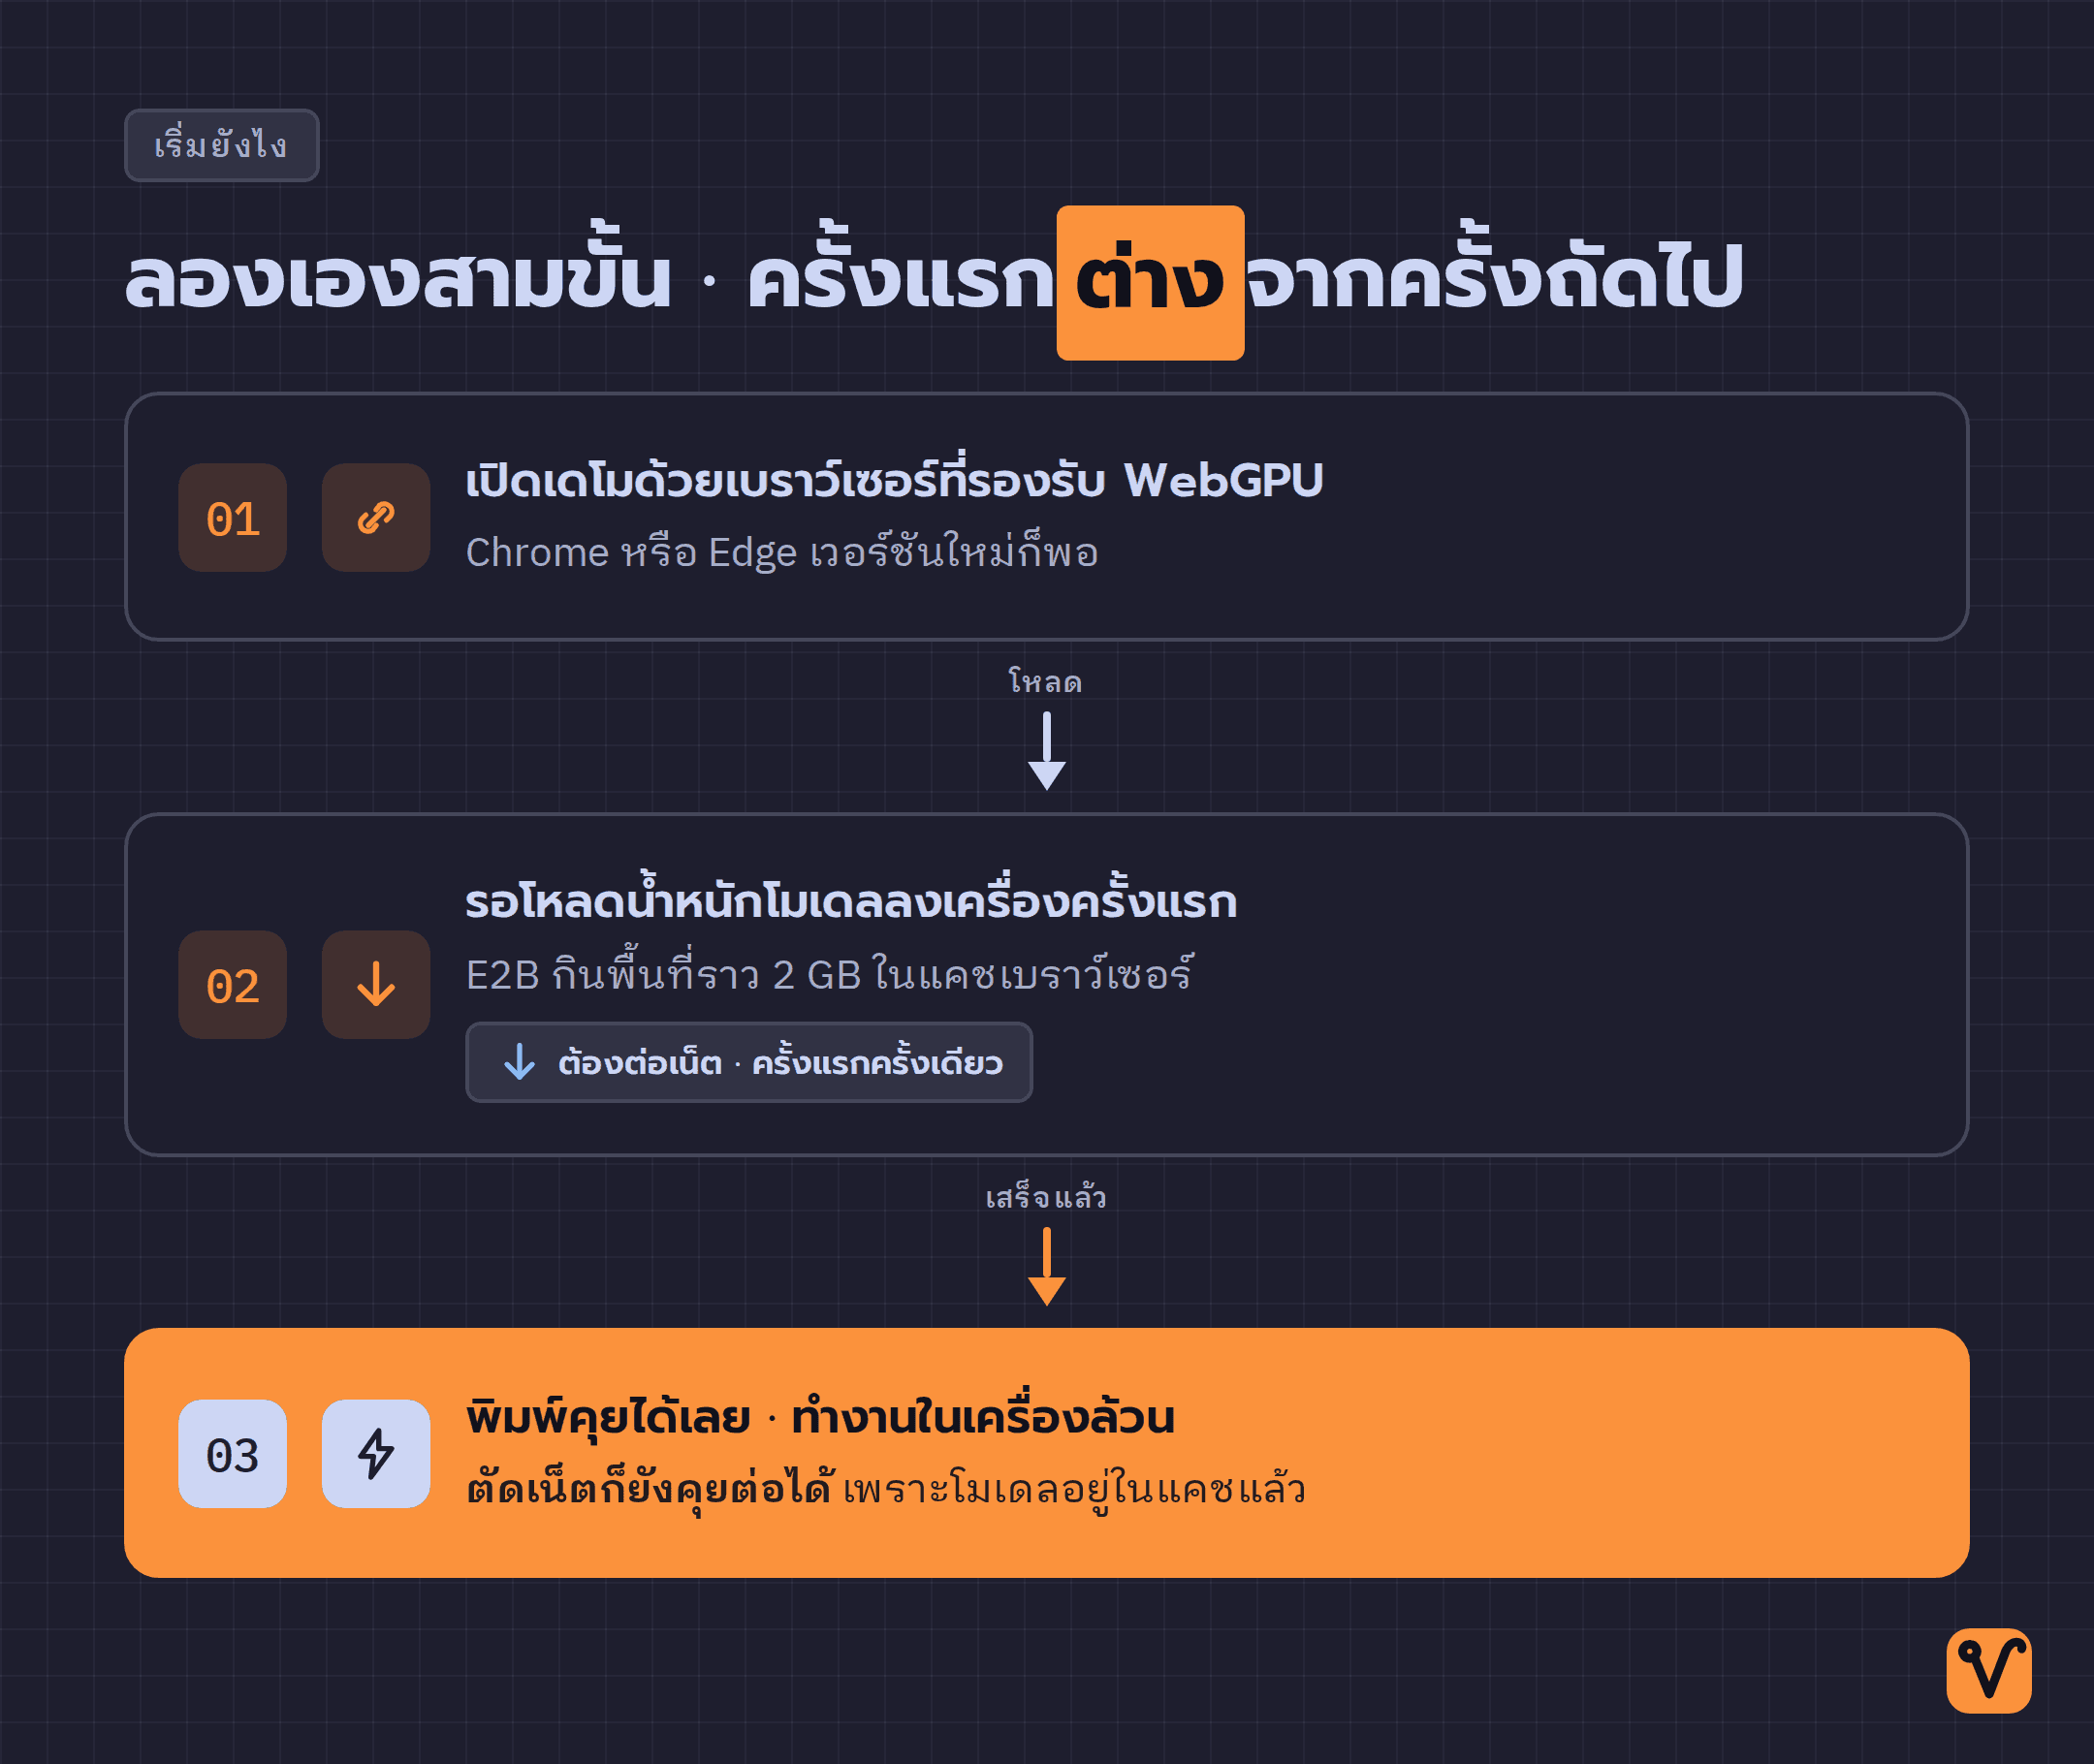
การทดลองใช้งานทำได้ง่ายและสะดวก โดยมีขั้นตอนหลักดังนี้:
- เปิดหน้าเดโมด้วยเบราว์เซอร์ที่รองรับ WebGPU เช่น Google Chrome หรือ Microsoft Edge เวอร์ชันล่าสุด สำหรับ Safari แนะนำให้ใช้เวอร์ชันทดลอง ส่วน Firefox จำเป็นต้องเปิดการตั้งค่า WebGPU ในหน้า Config เพิ่มเติม
- รอให้ระบบดาวน์โหลดไฟล์โมเดลลงเครื่องในครั้งแรก ตัวไฟล์ E2B ใช้พื้นที่ประมาณ 2 GB ในเบราว์เซอร์แคช ซึ่งขั้นตอนนี้ต้องใช้อินเทอร์เน็ตในการโหลด
- เมื่อดาวน์โหลดเสร็จสมบูรณ์ สามารถเริ่มพิมพ์คุยได้ทันที หลังจากนี้ระบบจะประมวลผลในเครื่องทั้งหมด ต่อให้ปิดเน็ตก็ยังใช้งานต่อได้ตามปกติ
จุดเด่นอีกอย่างของโปรเจกต์นี้คือ โค้ด WebGPU Kernel ทั้งหมดถูกเปิดเผยให้เข้าไปศึกษาและนำไปพัฒนาต่อได้ ใครที่สนใจเทคนิคการแปลงโมเดล AI ให้รันบนการ์ดจอผ่านเบราว์เซอร์ สามารถเข้าไปดูโค้ดจริงได้โดยตรง
ก้าวต่อไปของ Local AI บนเบราว์เซอร์
เดโมนี้ไม่ได้บอกว่า AI บนเบราว์เซอร์จะเข้ามาแทนที่โมเดลขนาดใหญ่บนคลาวด์ได้ทั้งหมดในทันที แต่แสดงให้เห็นชัดเจนว่า เส้นแบ่งระหว่างงานที่ "ต้องพึ่งเซิร์ฟเวอร์" กับงานที่ "รันจบได้ในเครื่องตัวเอง" กำลังแคบลงเรื่อยๆ
เมื่อโมเดลได้รับการปรับปรุงให้มีขนาดเล็กลงแต่ฉลาดขึ้น ประกอบกับฮาร์ดแวร์ของผู้ใช้งานที่มีประสิทธิภาพสูงขึ้น งานหลายอย่างที่เราเคยต้องส่งข้อมูลขึ้นคลาวด์ก็สามารถจัดการจบได้ในแท็บเบราว์เซอร์เดียว คำถามสำคัญต่อจากนี้จึงไม่ใช่ว่า AI รันบนเบราว์เซอร์ได้หรือไม่ แต่เป็นเราจะเลือกเอางานไหนมาประมวลผลในเครื่องเพื่อความปลอดภัยและความเป็นส่วนตัวสูงสุด
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin