Perplexity เปิดตัว Brain · ความจำที่ทำให้ AI agent จำงานเก่าได้ ยิ่งใช้ยิ่งถูกลง 13%
Perplexity เปิดตัว Brain · ระบบความจำที่ให้ AI agent จำงานที่เคยทำมา แทนที่จะเริ่มจากศูนย์ทุกครั้ง จุดที่ต่างคือมันจำ "งานของ agent" ว่าอะไรเวิร์กอะไรไม่เวิร์ก ไม่ใช่จำรสนิยมของคนใช้

Perplexity เปิดตัว Brain ระบบความจำใหม่ที่ช่วยให้ AI agent บน Perplexity Computer สามารถจดจำบริบทและงานที่เคยทำไว้ในอดีตได้ แทนที่จะต้องเริ่มต้นนับหนึ่งใหม่ทุกครั้งที่สั่งงาน Perplexity Computer คือ agent ที่ช่วยทำงานหลายขั้นตอนแบบอัตโนมัติ ปัญหาเดิมคือเมื่อจบงานหนึ่งรอบ มันจะลืมทุกอย่างไปทั้งหมด พอต้องทำงานลักษณะเดิมในครั้งถัดไป ก็ต้องเริ่มค้นหาข้อมูลและลองผิดลองถูกใหม่ตั้งแต่ต้น
Brain ถูกออกแบบมาเพื่อแก้ปัญหานี้โดยเฉพาะ ด้วยจุดเด่นสำคัญคือ ยิ่งใช้งานบ่อย ตัว agent ยิ่งทำงานได้เก่งขึ้นและประหยัดต้นทุนลง เพราะระบบจะจดจำว่าวิธีไหนทำงานได้ผล วิธีไหนเป็นทางตัน และจุดไหนที่มนุษย์เคยเข้ามาช่วยปรับแก้ ที่น่าสนใจคือสิ่งที่ Brain บันทึกไว้ไม่ใช่ความจำ AI ทั่วไปแบบที่เราคุ้นเคย แต่เป็นวิธีทำงานของตัว agent เอง
ความจำที่จำ "งานของ AI" ไม่ใช่จำรสนิยมของเรา
ความจำของ AI ทั่วไปที่เราเห็นในแชตบอต มักเป็นการจดจำข้อมูลส่วนตัวของผู้ใช้งาน เช่น เราชอบคำตอบสไตล์ไหน ทำงานสายอะไร หรืออยากให้เรียกชื่อว่าอะไร เพื่อนำมาปรับโทนการสนทนาให้ถูกใจเรามากขึ้น
แต่สิ่งที่ Brain จำคือ กระบวนการทำงานของตัว agent เอง ในการรันงานแต่ละครั้ง agent เลือกใช้เครื่องมือตัวไหน ดึงข้อมูลจากแหล่งใดแล้วได้ผลลัพธ์ที่ถูกต้อง แหล่งไหนให้ข้อมูลผิดพลาด และจุดไหนที่ผู้ใช้สั่งแก้ไขคำตอบ นี่คือความจำด้านกระบวนการทำงาน (procedural memory) ไม่ใช่การจำรสนิยมส่วนบุคคล
ความแตกต่างนี้ทำให้เกิดวงจรการเรียนรู้ที่พัฒนาขึ้นเรื่อยๆ เมื่อ agent จำได้ว่าแหล่งข้อมูลไหนเชื่อถือได้ ในรอบถัดไปก็ไม่ต้องเสียเวลาค้นหาใหม่ทั้งหมด ยิ่งทำงานลักษณะเดิมซ้ำหลายครั้ง agent ก็ยิ่งหาเส้นทางที่แม่นยำและรวดเร็วขึ้นได้เอง
งานวันนี้กลายเป็นความจำของพรุ่งนี้ได้อย่างไร
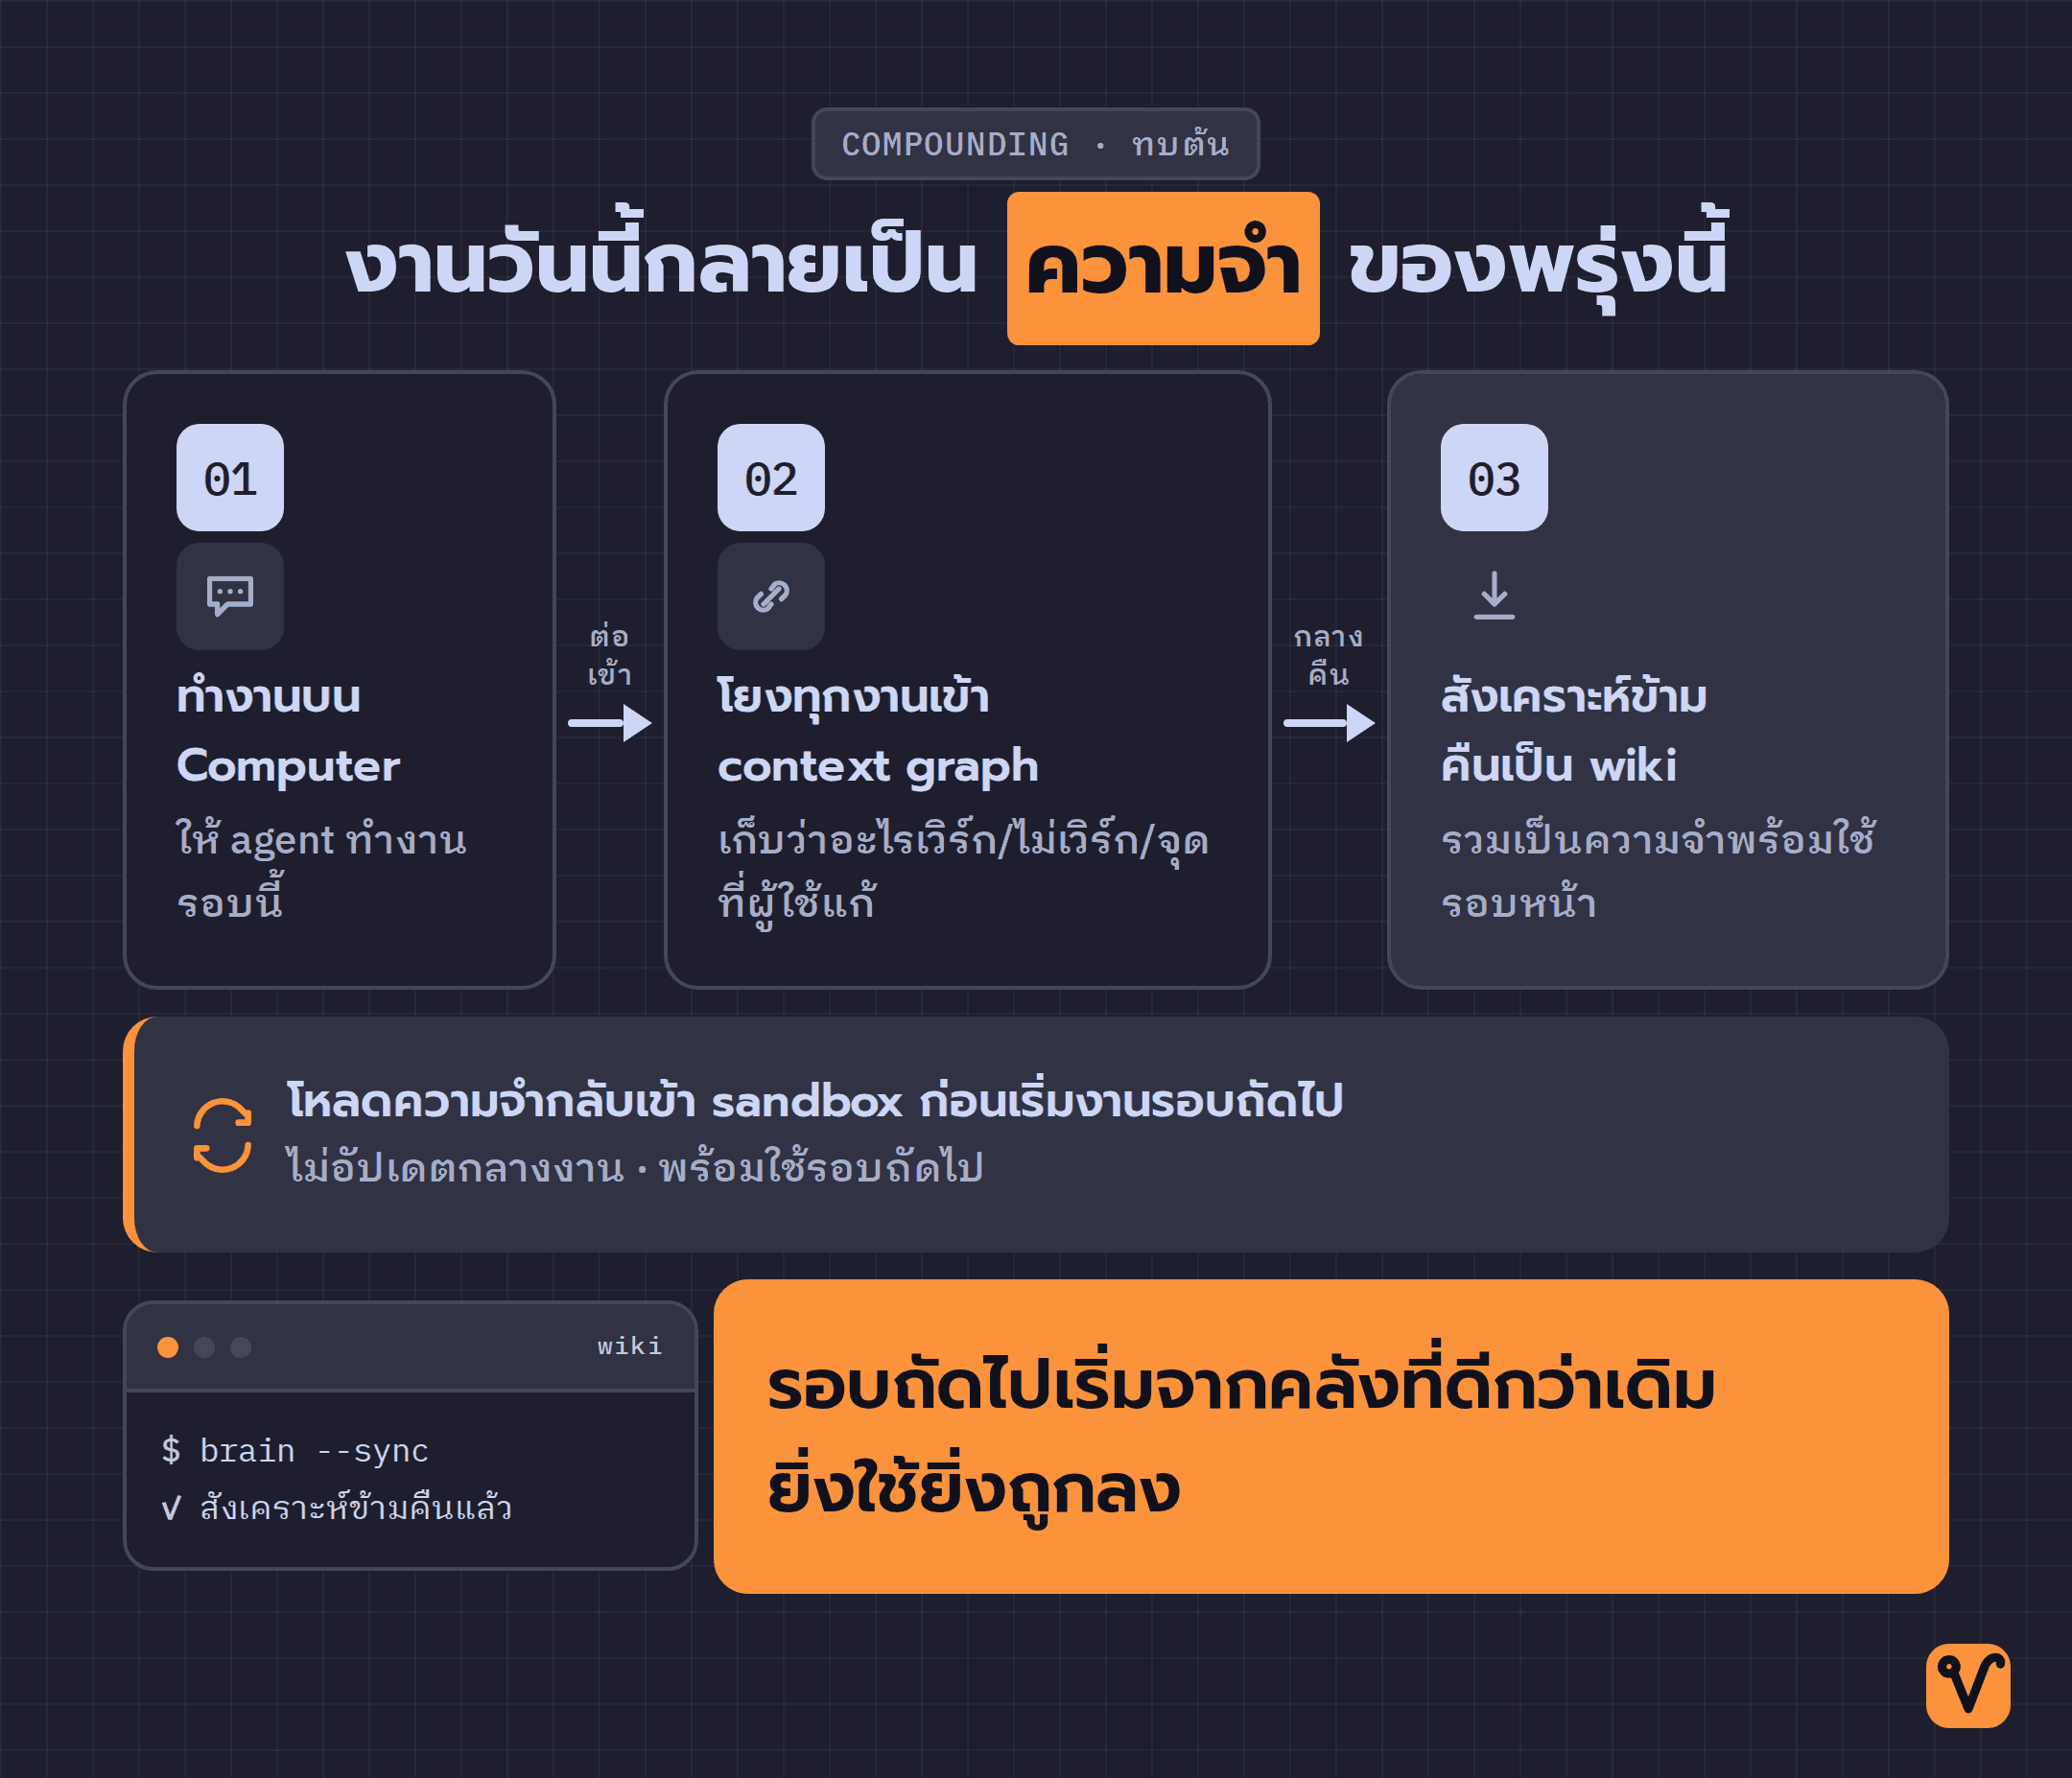
กลไกการทำงานของ Brain ไม่ได้ซับซ้อนเกินเข้าใจ แต่จุดที่น่าสนใจคือการแบ่งการทำงานออกเป็นสองช่วงเวลาอย่างชัดเจน ระหว่างช่วงทำงานจริงกับช่วงพักงาน
ทุกครั้งที่ Perplexity Computer ทำงานเสร็จสิ้น Brain จะบันทึกสิ่งที่เกิดขึ้นลงใน context graph ซึ่งทำหน้าที่เหมือนแผนที่เชื่อมโยงว่า งานนี้ใช้ connector ตัวไหน ได้ข้อมูลมาจากที่ใด จุดไหนติดขัด และผู้ใช้ปรับแก้จุดไหนบ้าง ความจำแต่ละรายการในแผนที่นี้สามารถตรวจสอบย้อนกลับไปยัง session ไฟล์ต้นทาง หรือแหล่งอ้างอิงได้อย่างโปร่งใส ไม่ใช่ความจำลอยๆ ที่ไร้ที่มา
ส่วนสำคัญคือกระบวนการที่เกิดขึ้น ในช่วงข้ามคืน โดยค่าเริ่มต้น Brain จะนำข้อมูลทั้งหมดใน context graph มาสังเคราะห์และเรียบเรียงเป็นหน้าเอกสารลงใน personal wiki ซึ่งเป็นสมุดบันทึกส่วนตัวที่แยกตามผู้ใช้ โครงการ และหมวดหมู่งาน พอถึงการทำงานรอบใหม่ ระบบจะโหลดข้อมูล wiki ชุดนี้กลับเข้าสู่ sandbox ของ Computer ให้อัตโนมัติ ทำให้ agent เริ่มงานใหม่พร้อมบริบทที่พร้อมใช้งานทันที
ของจริงในงานซ้ำๆ ที่ทำเป็นประจำ
เราจะเห็นประโยชน์ของ Brain ได้ชัดเจนที่สุดในงานที่ต้องทำซ้ำๆ สม่ำเสมอ เช่น สายงานข้อมูลที่ต้องตรวจสอบ data pipeline ทุกสัปดาห์ เมื่อ Brain จำได้ว่าแหล่งข้อมูลไหนเชื่อถือได้และเคยแก้ไขจุดใดไปบ้าง การตรวจสอบในรอบถัดไปก็จะเริ่มจากแผนที่ที่สมบูรณ์ขึ้นโดยไม่ต้องสำรวจใหม่หมด
ทีม support ที่คอยคัดแยก ticket ก็เช่นกัน เมื่อ Brain เรียนรู้ว่าข้อมูลแหล่งใดเคยช่วยแก้ไขปัญหาลักษณะนี้ได้สำเร็จ ครั้งถัดไปก็สามารถส่งต่อเรื่องไปยังแผนกที่ถูกต้องได้รวดเร็วขึ้น ส่วนนักพัฒนาที่ต้องไล่ debug ข้ามหลาย repository เมื่อ agent จำได้ว่าไฟล์ไหนคือจุดสำคัญจากรอบก่อน ก็จะเข้าถึงต้นตอของปัญหาได้โดยใช้จำนวนรอบการเรียกโมเดลน้อยลง
หัวใจร่วมกันของทั้งสามกรณีคือ งานไม่ต้องเริ่มนับหนึ่งใหม่ ระบบจะเก็บเกี่ยวบทเรียนจากรอบก่อนหน้ามาส่งต่อให้รอบต่อไปเสมอ
ตัวเลขจากการทดสอบของ Perplexity และข้อสังเกต
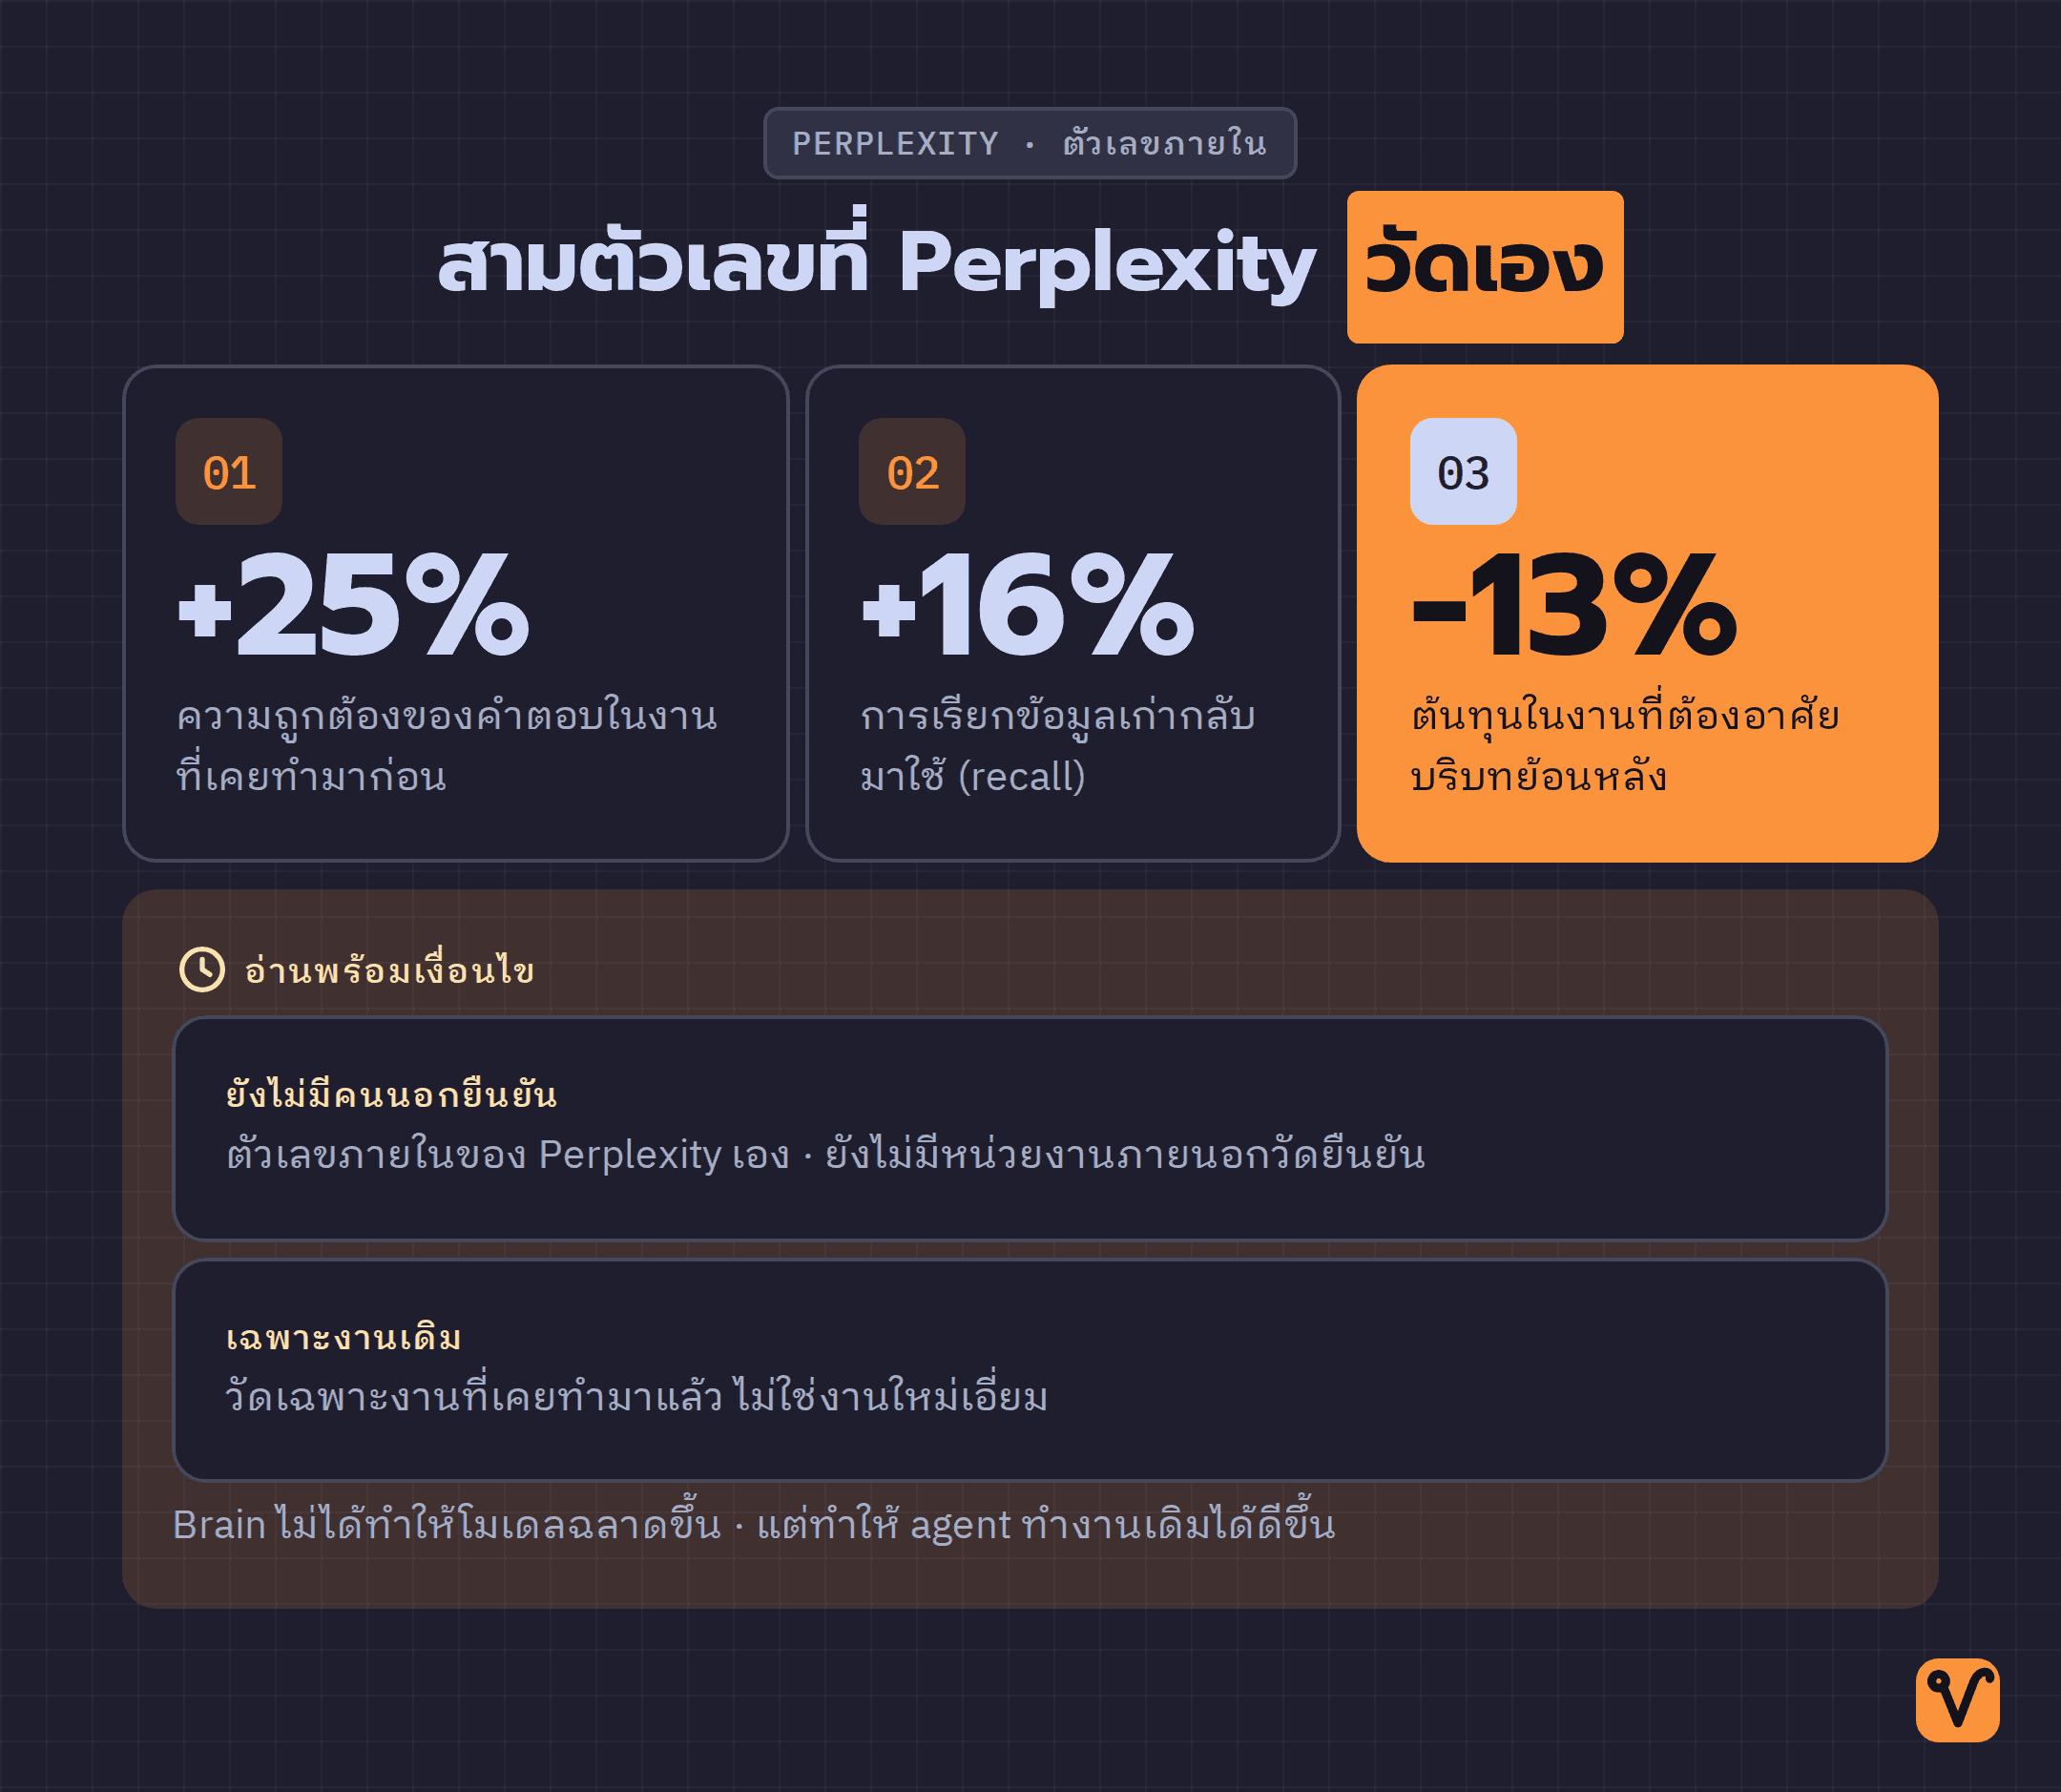
Perplexity ได้เปิดเผยตัวเลขจากการทดสอบภายใน สำหรับงานที่ Perplexity Computer เคยทำมาก่อนและต้องอาศัยบริบทเดิม
- ความถูกต้องของคำตอบเพิ่มขึ้น 25% ในงานที่เคยทำมาก่อน
- ความสามารถในการดึงข้อมูลเก่ากลับมาใช้ (recall) เพิ่มขึ้น 16%
- ต้นทุนค่าใช้จ่ายลดลง 13% ในงานที่ต้องใช้บริบทย้อนหลัง
ตัวเลขเหล่านี้น่าสนใจ แต่มี 2 ข้อที่ควรทำความเข้าใจควบคู่กัน ข้อแรก นี่เป็นผลทดสอบภายในของ Perplexity เองที่ยังไม่มีการประเมินจากหน่วยงานภายนอก ข้อสอง ตัวเลขนี้วัดเฉพาะงานที่ เคยทำมาแล้ว ไม่ใช่งานใหม่ที่ไม่เคยพบมาก่อน Brain ไม่ได้ทำให้ตัวโมเดล LLM ฉลาดขึ้น แต่ช่วยให้ agent ทำงานเดิมได้เชี่ยวชาญขึ้น ส่วนการถ่ายโอนความรู้ข้ามประเภทงานยังคงเป็นโจทย์ที่ต้องรอดูกันต่อไป
เรื่องต้นทุนก็มีมุมมองที่ชัดเจน ในช่วงแรกที่ agent ต้องโหลดบริบทเก่าเข้ามาอ่านจะใช้ token เพิ่มขึ้น แต่ Perplexity มองว่าเป็นการลงทุนเพื่อให้การใช้ token ในระยะยาวคุ้มค่ายิ่งขึ้น สรุปง่ายๆ คือยอมจ่ายต้นทุนเพิ่มในตอนเริ่มต้นเพื่อให้การทำงานซ้ำในอนาคตถูกลงและเร็วขึ้น
สถานะการเปิดใช้งานและสิทธิ์ในข้อมูล
ปัจจุบัน Brain ยังอยู่ในสถานะ research preview โดยเปิดให้ใช้งานเฉพาะสมาชิกระดับ Perplexity Max และ Enterprise Max เท่านั้น ซึ่งแพ็กเกจ Max มีค่าบริการอยู่ที่ 200 ดอลลาร์ต่อเดือน ผู้ใช้สามารถเข้าไปดูและจัดการข้อมูลความจำได้ผ่านเมนู Customize ในแถบด้านข้าง
อีกประเด็นสำคัญสำหรับองค์กรคือ context graph ทั้งหมดถูกจัดเก็บบนโครงสร้างพื้นฐานของ Perplexity แม้ว่าผู้ใช้จะสามารถตรวจสอบ แก้ไข หรือลบข้อมูลความจำแต่ละรายการได้ แต่คลังความรู้ที่สะสมไว้ทั้งหมดจะอยู่บนระบบของผู้ให้บริการ ไม่ได้อยู่บนเซิร์ฟเวอร์ส่วนตัวขององค์กร ซึ่งเป็นจุดที่ทีมความปลอดภัยต้องประเมินก่อนนำไปใช้งานอย่างจริงจัง
แนวคิดระบบความจำสำหรับ AI ไม่ใช่เรื่องใหม่ทั้งหมด ในวงการมีการทดลองให้ agent บันทึกการทำงานของตัวเองมาระยะหนึ่งแล้ว แต่สิ่งที่ Perplexity ทำคือการผสานระบบนี้เข้ากับแพลตฟอร์ม Computer จนกลายเป็นฟีเจอร์ที่พร้อมใช้งานได้ทันที
สิ่งที่ Brain สะท้อนให้เห็นชัดเจนคือ ประสิทธิภาพของ AI agent ในงานจริงไม่ได้ขึ้นอยู่กับขนาดของโมเดลเพียงอย่างเดียว แต่อยู่ที่ความสามารถในการจดจำและเรียนรู้จากข้อผิดพลาดในอดีตด้วย
ที่มา:
- บทความ Perplexity Launches Brain, Self-Improving Memory System จาก MarkTechPost
- บทความ Perplexity's AI Agent Now Has a Brain That Learns From Its Own Mistakes จาก Decrypt
- โพสต์ Perplexity (@perplexity_ai) on X จาก Perplexity
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
ChatGPT Work ฉบับเข้าใจง่าย มอบงานให้ AI ทำจนจบ ตั้งแต่งานแรกจนถึงงานอัตโนมัติ พร้อม workflow ใช้ได้จริง 8 แบบ
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ