RRT-355M โมเดลภาษาที่ลอง 'ตัด softmax' ออกจากชั้น attention เพื่อให้อ่านบริบทยาว ๆ ได้โดยกิน VRAM น้อยลง
RRT-355M คือโมเดลภาษาทดลองขนาด GPT-2 ที่ลองถอด softmax ออกจากชั้น attention แล้วใช้การเปิด-ปิดเส้นเชื่อมระหว่างคำแทน จุดที่น่าจับตาคือมันออกแบบมาเพื่ออ่านข้อความยาว ๆ โดยกินแรมการ์ดจอน้อยลง

ในโลกของโมเดลภาษาขนาดใหญ่ (LLM) มีชิ้นส่วนพื้นฐานชิ้นหนึ่งที่เกือบทุกโมเดลใช้ตรงกันมาตลอด นั่นคือฟังก์ชัน softmax ภายในชั้น attention แต่ล่าสุดมีงานวิจัยทดลองชื่อ RRT-355M ที่กล้าถอดชิ้นส่วนนี้ออก แล้วเปลี่ยนวิธีคำนวณใหม่ทั้งหมด RRT-355M ไม่ได้สร้างขึ้นมาเพื่อแข่งกับโมเดลยักษ์อย่าง GPT หรือ Claude แต่เป็นโมเดลขนาดเล็กระดับ GPT-2 Medium (ประมาณ 354 ล้านพารามิเตอร์) ที่นักวิจัยอิสระพัฒนาขึ้นมาเพื่อพิสูจน์สมมติฐานสำคัญเพียงข้อเดียวว่า ถ้าเราตัด softmax ทิ้งไป โมเดลจะสามารถอ่านและประมวลผลข้อความขนาดยาวได้โดยกินแรมการ์ดจอ (VRAM) น้อยลงจริงหรือไม่
ความน่าสนใจของงานนี้ไม่ได้อยู่ที่คะแนนสอบ แต่คือความกล้าแตะโครงสร้างพื้นฐานที่คนส่วนใหญ่คิดว่าแตะต้องไม่ได้ เพื่อให้เห็นภาพว่าทำไมเรื่องนี้ถึงสำคัญ เราต้องเข้าใจก่อนว่า softmax ทำงานอย่างไร และทำไมมันถึงเป็นสาเหตุหลักที่ทำให้การอ่านข้อความยาวๆ กินทรัพยากรการ์ดจอมหาศาล
Attention คือการลากเส้นเชื่อมโยงระหว่างทุกคู่คำ
หัวใจหลักของสถาปัตยกรรม Transformer คือกลไก attention ซึ่งทำหน้าที่วิเคราะห์ว่าในประโยคหนึ่ง คำแต่ละคำมีความสัมพันธ์กับคำไหนบ้าง เช่น เมื่อโมเดลอ่านเจอคำสรรพนามอย่าง "มัน" กลไกนี้จะต้องหาความเชื่อมโยงย้อนกลับไปว่า "มัน" หมายถึงคำนามคำไหนที่ปรากฏอยู่ก่อนหน้า
ปัญหาคือตามมาตรฐานเดิม attention จะคำนวณเส้นความสัมพันธ์แบบ ทุกคำจับคู่กับทุกคำ หากข้อความมี 10 คำ โมเดลจะต้องคำนวณเส้นความสัมพันธ์ 100 เส้น แต่ถ้าข้อความยาวขึ้นเป็น 1,000 คำ จำนวนเส้นจะพุ่งขึ้นเป็น 1,000,000 เส้นในทันที เพราะการคำนวณขยายตัวแบบยกกำลังสองตามความยาวข้อความ ยิ่งข้อความยาวเท่าไร แรมการ์ดจอที่ต้องใช้เก็บเมทริกซ์ความสัมพันธ์นี้ก็ยิ่งบานปลาย นี่คือสาเหตุที่การให้ AI อ่านเอกสารยาวทั้งเล่มมีค่าใช้จ่ายสูงมาก
Softmax คือกฎเหล็กที่บังคับให้น้ำหนักทุกเส้นรวมกันได้ 100%
หลังจากกลไก attention ให้คะแนนความเข้ากันได้ของแต่ละคู่คำแล้ว ขั้นตอนถัดมาคือการนำคะแนนดิบไปผ่านฟังก์ชัน softmax เพื่อเกลี่ยให้กลายเป็นค่าน้ำหนักความน่าจะเป็น โดยมีกฎตายตัวว่า ผลรวมของน้ำหนักความสัมพันธ์ทั้งหมดในแถวเดียวกันต้องเท่ากับ 100% เสมอ
ผลพวงของกฎนี้คือ เส้นเชื่อมโยงทุกเส้นจะต้องได้รับค่าน้ำหนักที่มากกว่าศูนย์เสมอ แม้จะเป็นคู่คำที่อยู่ห่างกันมากและแทบไม่มีความเกี่ยวข้องกันเลยก็ตาม ฟังก์ชัน softmax จะไม่ยอมตัดค่าน้ำหนักให้กลายเป็นศูนย์สนิท ส่งผลให้การ์ดจอต้องเก็บข้อมูลเส้นเชื่อมโยงที่ไม่จำเป็นทั้งหมดไว้ใน VRAM อยู่ตลอดเวลา
เปลี่ยนจากการเกลี่ยน้ำหนัก เป็นกลไกเปิดปิดเส้นเชื่อม
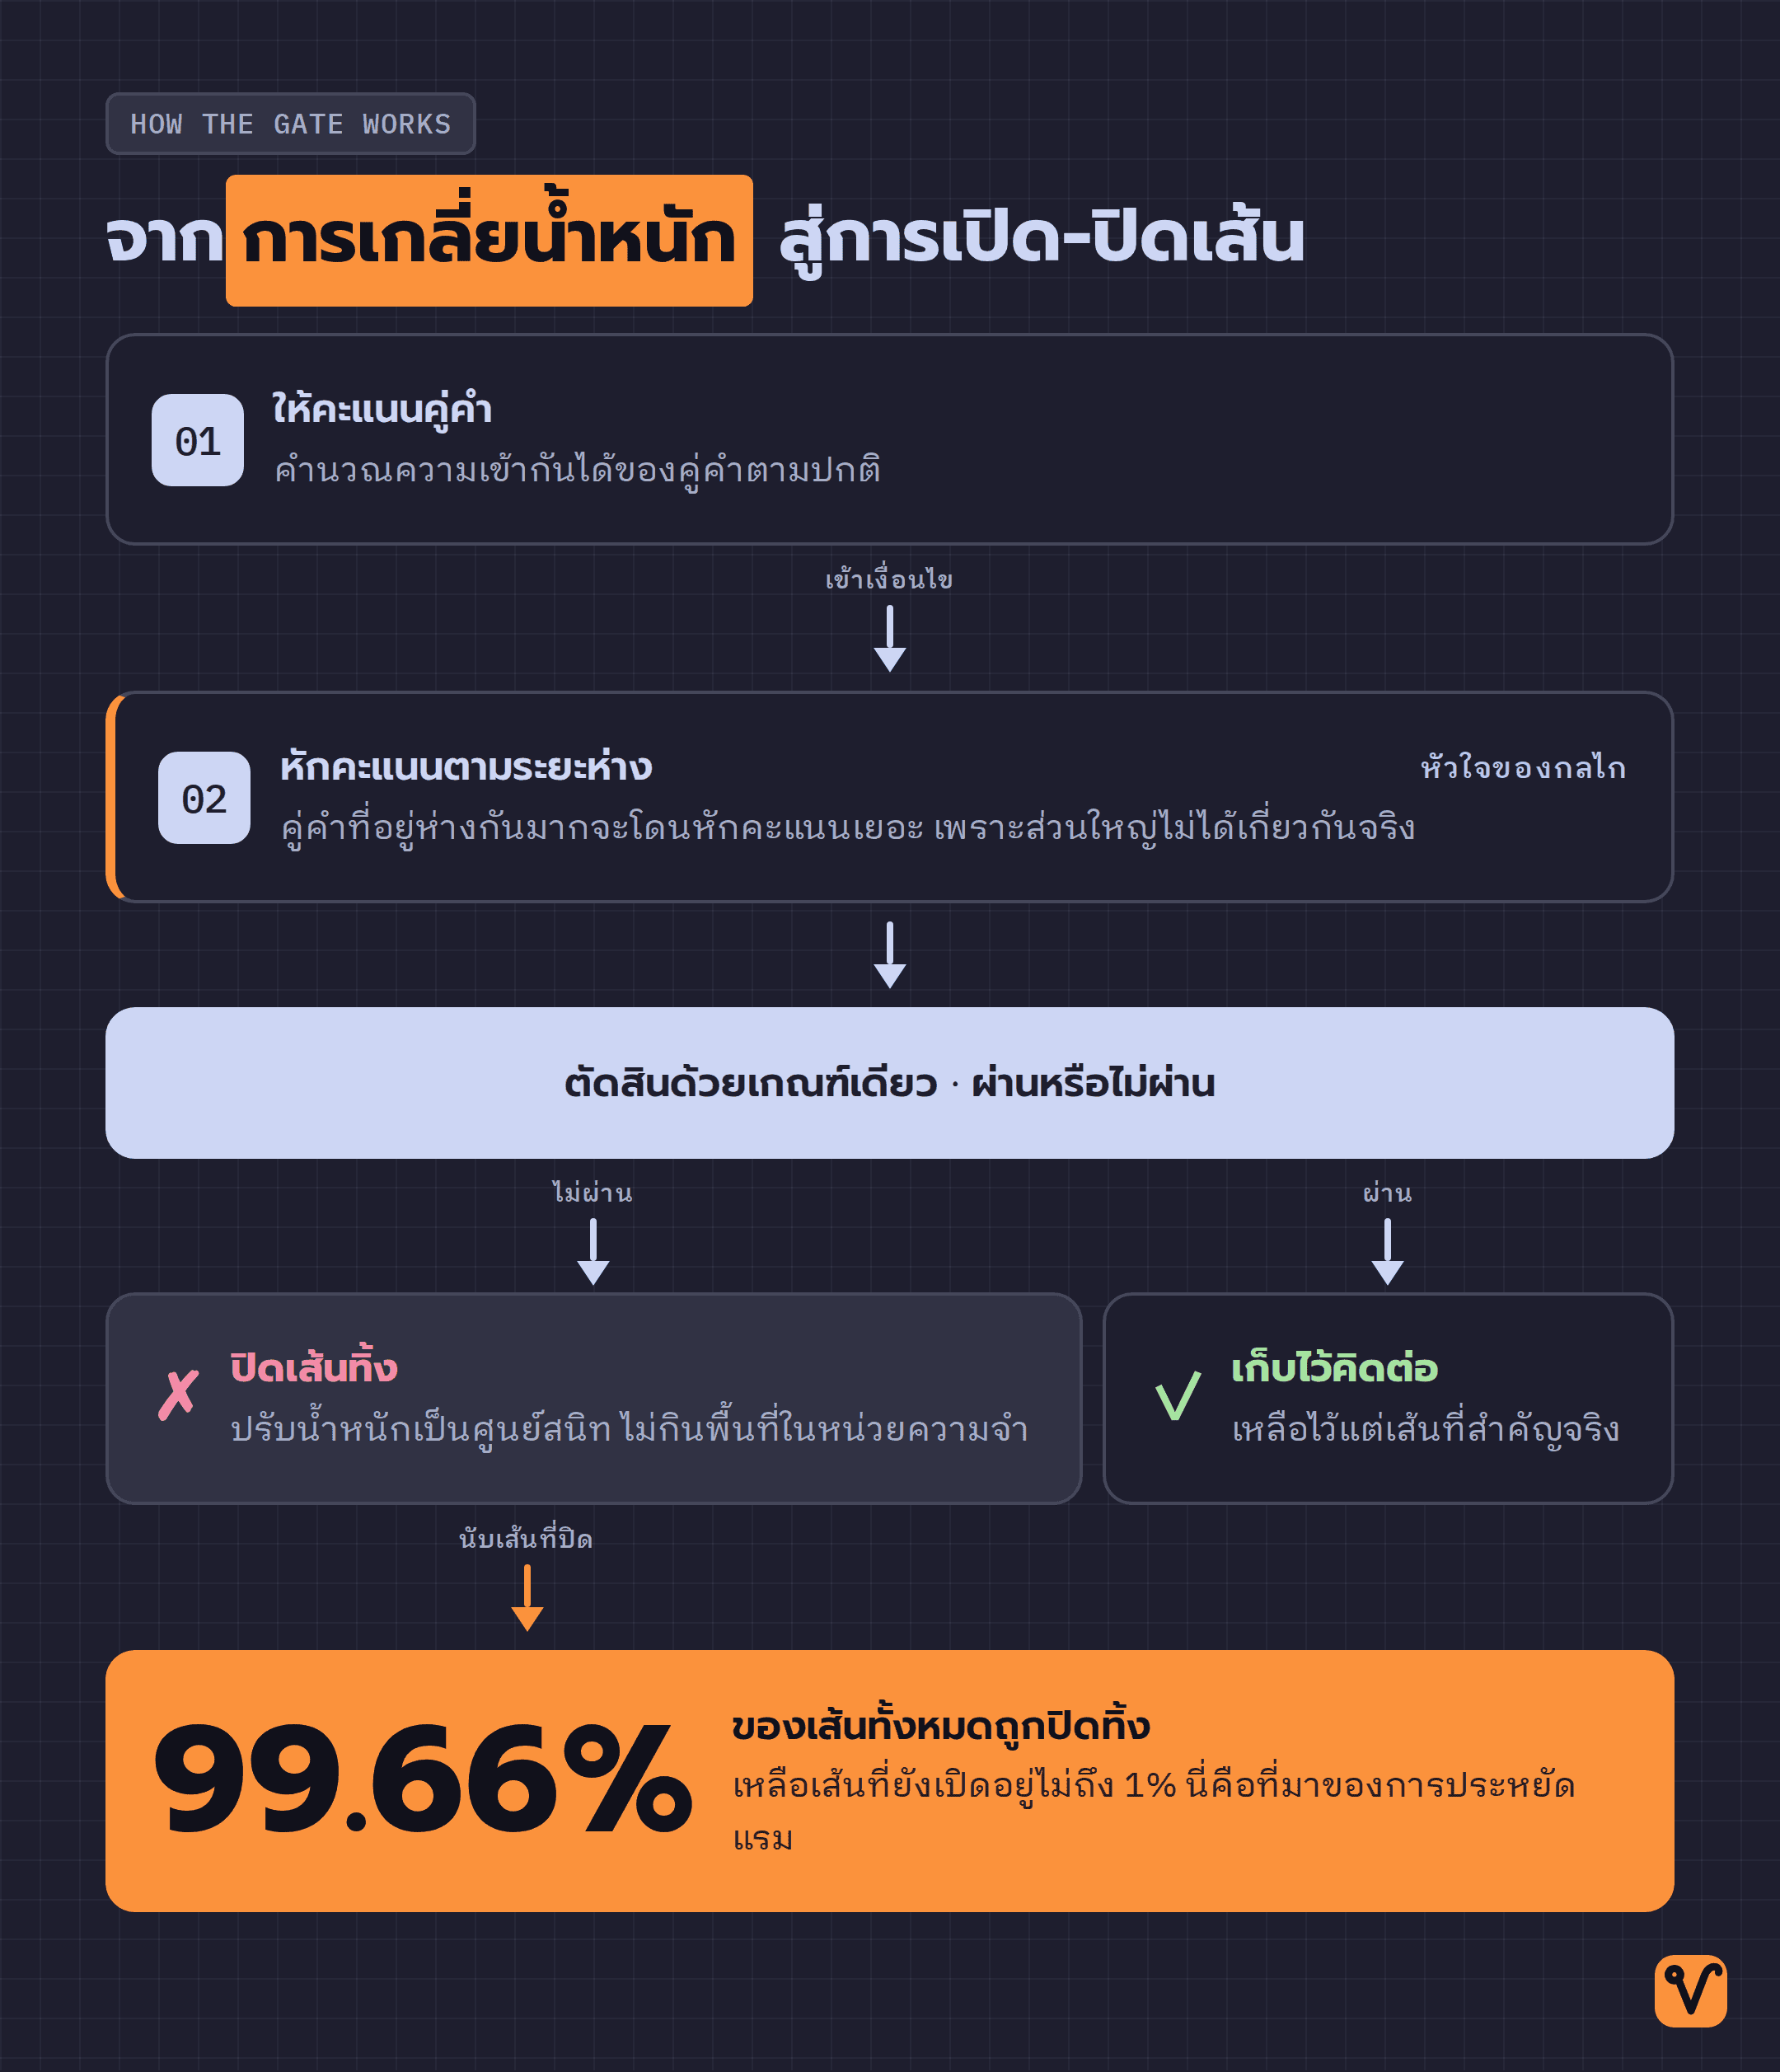
แทนที่จะใช้ softmax มาเกลี่ยน้ำหนักให้ทุกเส้น RRT-355M ได้เปลี่ยนมาใช้กลไกเปิดปิดแบบกำหนดได้ (Deterministic Gate) ซึ่งมีขั้นตอนการทำงานดังนี้
- คำนวณคะแนนความเข้ากันได้ของแต่ละคู่คำตามปกติ
- หักคะแนนลดทอนตามระยะห่าง โดยคู่คำที่อยู่ห่างกันมากจะถูกหักคะแนนอย่างหนัก เพราะโดยธรรมชาติมักไม่ได้มีความเกี่ยวข้องกันโดยตรง
- หากคะแนนสุทธิหลังหักลบแล้วต่ำกว่าเกณฑ์ที่กำหนด ระบบจะ ปิดการเชื่อมต่อของคู่นั้นทันที และตั้งค่าน้ำหนักให้เป็นศูนย์สนิท
- เก็บเฉพาะเส้นที่มีคะแนนผ่านเกณฑ์เท่านั้นไปคำนวณต่อ
การหักคะแนนตามระยะทางช่วยให้ระบบสามารถตัดเส้นเชื่อมโยงระหว่างคำที่อยู่ไกลๆ ออกไปได้เกือบทั้งหมด ผู้สร้างรายงานว่าในระหว่างการเทรน มีเส้นเชื่อมโยงถูกตัดทิ้งเป็นศูนย์ไปถึง 99.66% นั่นหมายความว่าจากเมทริกซ์ความสัมพันธ์ทั้งหมด มีเส้นที่เปิดใช้งานจริงอยู่ไม่ถึง 1% เท่านั้น ช่องว่างมหาศาลนี้เองคือจุดเริ่มต้นของการประหยัดหน่วยความจำ
เคอร์เนล GPU ที่ข้ามบล็อกว่างได้จริง
การรู้ว่าข้อมูลส่วนใหญ่เป็นศูนย์เป็นเรื่องหนึ่ง แต่การทำให้การ์ดจอประมวลผลเร็วขึ้นจริงเป็นอีกเรื่องหนึ่ง เพราะโดยปกติ GPU จะคำนวณทุกช่องตารางอย่างซื่อตรงไม่ว่าค่าข้างในจะเป็นศูนย์หรือไม่ ผู้พัฒนาจึงเขียนโปรแกรมควบคุม GPU ระดับล่างด้วยภาษา Triton เพื่อให้ระบบตรวจเช็กก่อนว่าในแต่ละบล็อกการคำนวณมีเส้นที่เปิดอยู่หรือไม่ หากพบว่าบล็อกไหนไม่มีข้อมูลที่ต้องใช้เลย ระบบจะ ข้ามการประมวลผลบล็อกนั้นไปทั้งบล็อกทันที
ผลการทดสอบเคอร์เนลชี้ว่า ที่ความยาวข้อความ 2,048 โทเคน เคอร์เนลสามารถข้ามการคำนวณไปได้ถึง 34% ของบล็อกทั้งหมด และเมื่อขยายความยาวข้อความเป็น 8,192 โทเคน ตัวเลขการข้ามบล็อกพุ่งสูงขึ้นถึง 55% ยิ่งบริบทยาวขึ้น สัดส่วนช่องว่างยิ่งมากขึ้น การข้ามการคำนวณจึงยิ่งคุ้มค่าและช่วยลดการใช้ VRAM ได้อย่างชัดเจน
ความแม่นยำที่ยอมแลก เพื่อลดภาระหน่วยความจำ
คำถามสำคัญคือ เมื่อตัดเส้นเชื่อมโยงทิ้งไปเกือบหมด ความฉลาดของโมเดลจะลดลงหรือไม่ ผู้พัฒนาได้นำ RRT-355M ไปทดสอบบนชุดวัดมาตรฐาน CORE ซึ่งรวมข้อสอบประเมินภาษาไว้ 22 รายการ แล้วนำคะแนนไปเปรียบเทียบกับโมเดลในระดับขนาดเดียวกัน
| โมเดล | คะแนน CORE |
|---|---|
| GPT-2 124M (ฐานเทียบล่างสุด) | 0.1211 |
| RRT-355M (งานนี้) | 0.1558 |
| GPT-2 medium (ขนาดเท่ากัน) | 0.1770 |
| Pythia 410M (รุ่นใหม่กว่า) | 0.1895 |
ผลการทดสอบแสดงให้เห็นว่า RRT-355M ทำคะแนนได้ดีกว่า GPT-2 รุ่นเล็กอย่างชัดเจน แต่ยังตามหลัง GPT-2 Medium ที่มีขนาดพารามิเตอร์เท่ากันอยู่ประมาณ 0.02 คะแนน ซึ่งผู้สร้างสรุปไว้อย่างตรงไปตรงมาว่าเป็น "การแลกเปลี่ยนที่ควบคุมได้ ไม่ใช่การพังทลายของประสิทธิภาพ" ในบางภารกิจ เช่น งานตอบคำถามเชิงเหตุผล RRT-355M ทำได้ดีกว่า GPT-2 Medium ด้วยซ้ำ แต่ในงานที่ต้องค้นหาและจดจำรายละเอียดที่อยู่ห่างกันมากๆ ประสิทธิภาพจะลดลง เพราะกลไกการตัดเส้นระยะไกลทำให้การดึงข้อมูลข้ามจุดทำได้ยากขึ้น
นี่คือความชัดเจนของงานวิจัยชิ้นนี้ ซึ่งไม่ได้อ้างว่าการตัด softmax คือยาวิเศษที่ได้ผลลัพธ์ฟรีๆ แต่เป็นการยอมสละความแม่นยำในจุดที่ไกลออกไปเล็กน้อย เพื่อแลกกับการประหยัดแรมมหาศาลในการอ่านข้อความยาว
คุณค่าของงานทดลองขนาดเล็กชิ้นนี้
แน่นอนว่า RRT-355M ยังห่างไกลจากการนำไปใช้งานจริงแทนโมเดลระดับเรือธงในปัจจุบัน แต่นี่คืองานพิสูจน์แนวคิดที่น่าชื่นชมของนักพัฒนาคนเดียว ซึ่งเทรนโมเดลด้วยชุดข้อมูล 11,500 ล้านโทเคน บนชิป H100 จำนวน 4 ใบ เพื่อพิสูจน์ให้เห็นในเชิงประจักษ์ว่า โมเดลภาษาที่ไม่ต้องพึ่งพากฎ 100% ของ softmax ก็สามารถเรียนรู้และเข้าใจภาษาได้เป็นอย่างดี
ผู้ที่สนใจศึกษาโค้ดและกลไกเปิดปิดเส้นเชื่อมนี้ สามารถเข้าไปดาวน์โหลด weights ได้ที่ RRT-Foundation บน Hugging Face หรือเข้าไปดูโค้ดต้นฉบับได้ที่คลัง RRT-LLM-FOUNDATION
สิ่งที่งานวิจัยนี้ทิ้งไว้ให้เราคิดต่อคือ หากโมเดลทดลองขนาดเล็กยังสามารถตัดเส้นเชื่อมโยงทิ้งไปได้มากกว่า 99% โดยที่ยังคงความสามารถทางภาษาไว้ได้ แล้วในโมเดลขนาดยักษ์ที่เราใช้งานกันอยู่ทุกวันนี้ จะยังมีทรัพยากรการคำนวณที่สูญเปล่าแฝงอยู่อีกมากเพียงใด
ที่มา: โพสต์ I released a softmax-free attention model at GPT-2 scale จาก r/MachineLearning
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin