Claude Fable 5.2 คว้าอันดับ 1 คะแนนรวมของ Artificial Analysis ราคาต่อ token ลดลงจาก 5.1 ราว 20% แต่ถ้าเปิด effort สูงสุด ค่าใช้จ่ายจะพุ่งถึง 26.54 ดอลลาร์ต่องาน ส่วนผู้ใช้ Pro ลองได้โดยไม่เสียเครดิตเพิ่มจนถึง 16 พ.ย.
Claude Fable 5.2 เก่งขึ้นชัดเจนทั้งงานโค้ดและงานใช้คอมพิวเตอร์ ในราคาต่อ token ที่ถูกลง แต่จะคุ้มจริงต้องเลือก effort ให้พอดีกับงาน ไม่ใช่เปิดสูงสุดทุกงาน
Anthropic ผู้พัฒนาโมเดลตระกูล Claude เปิดตัว Claude Fable 5.2 อย่างเป็นทางการเมื่อวันที่ 9 พ.ย. 2026 โดยเป็นโมเดลตัวท็อปรุ่นล่าสุด และเปิดตัวพร้อมกับโมเดลคู่แฝดอย่าง Mythos 5.2 การเปิดตัวครั้งนี้มาพร้อมโปรโมชันพิเศษสำหรับแผน Pro, Max, Ultra, Team และ Enterprise บางประเภท แต่ไม่รวมแผน Free ผู้ใช้แผน Pro จึงทดลองใช้ Fable ได้โดยไม่เสียเครดิตเพิ่มจนถึงวันที่ 16 พ.ย. นี้ ซึ่งปกติการใช้ Fable บนแผน Pro จะต้องหักจากเครดิตการใช้งาน
Mythos 5.2 คือโมเดลตัวเดียวกับ Fable 5.2 แต่ถอดระบบป้องกันอย่าง safeguard ด้านความปลอดภัยไซเบอร์และชีววิทยาออกบางส่วน จึงเปิดให้ใช้เฉพาะองค์กรที่ผ่านการตรวจสอบและเข้าร่วมโครงการด้านไซเบอร์หรือวิทยาศาสตร์ชีวภาพเท่านั้น โดยคิดค่าบริการเท่ากับ Fable 5.2
จุดเด่นหลักของ Fable 5.2 เมื่อเทียบกับรุ่นก่อน คือเขียนโค้ดและใช้งานคอมพิวเตอร์ได้เก่งขึ้นอย่างเห็นได้ชัด ทั้งยังสร้างข้อความได้เร็วขึ้นสูงสุด 30% ในราคาต่อ token ที่ถูกลง โดย token คือหน่วยวัดปริมาณข้อความที่ใช้คิดค่าบริการ เว็บจัดอันดับโมเดล AI ชื่อดังอย่าง Artificial Analysis จัดให้ Fable 5.2 ขึ้นอันดับ 1 ด้วยคะแนนรวม 65 คะแนน ทว่าคะแนนระดับท็อปนี้แลกมาด้วยการเปิดให้โมเดลคิดในระดับสูงสุด ซึ่งทำให้ค่าใช้จ่ายต่องานพุ่งสูงขึ้นตามไปด้วย ดังนั้นวิธีใช้โมเดลนี้ให้คุ้มที่สุดจึงไม่ใช่การสั่งให้คิดหนักสุดทุกงาน แต่คือการเลือกระดับการคิดให้พอดีกับความซับซ้อนของแต่ละงาน
Fable 5.2 เก่งขึ้นจากรุ่น 5.1 ตรงไหนบ้าง
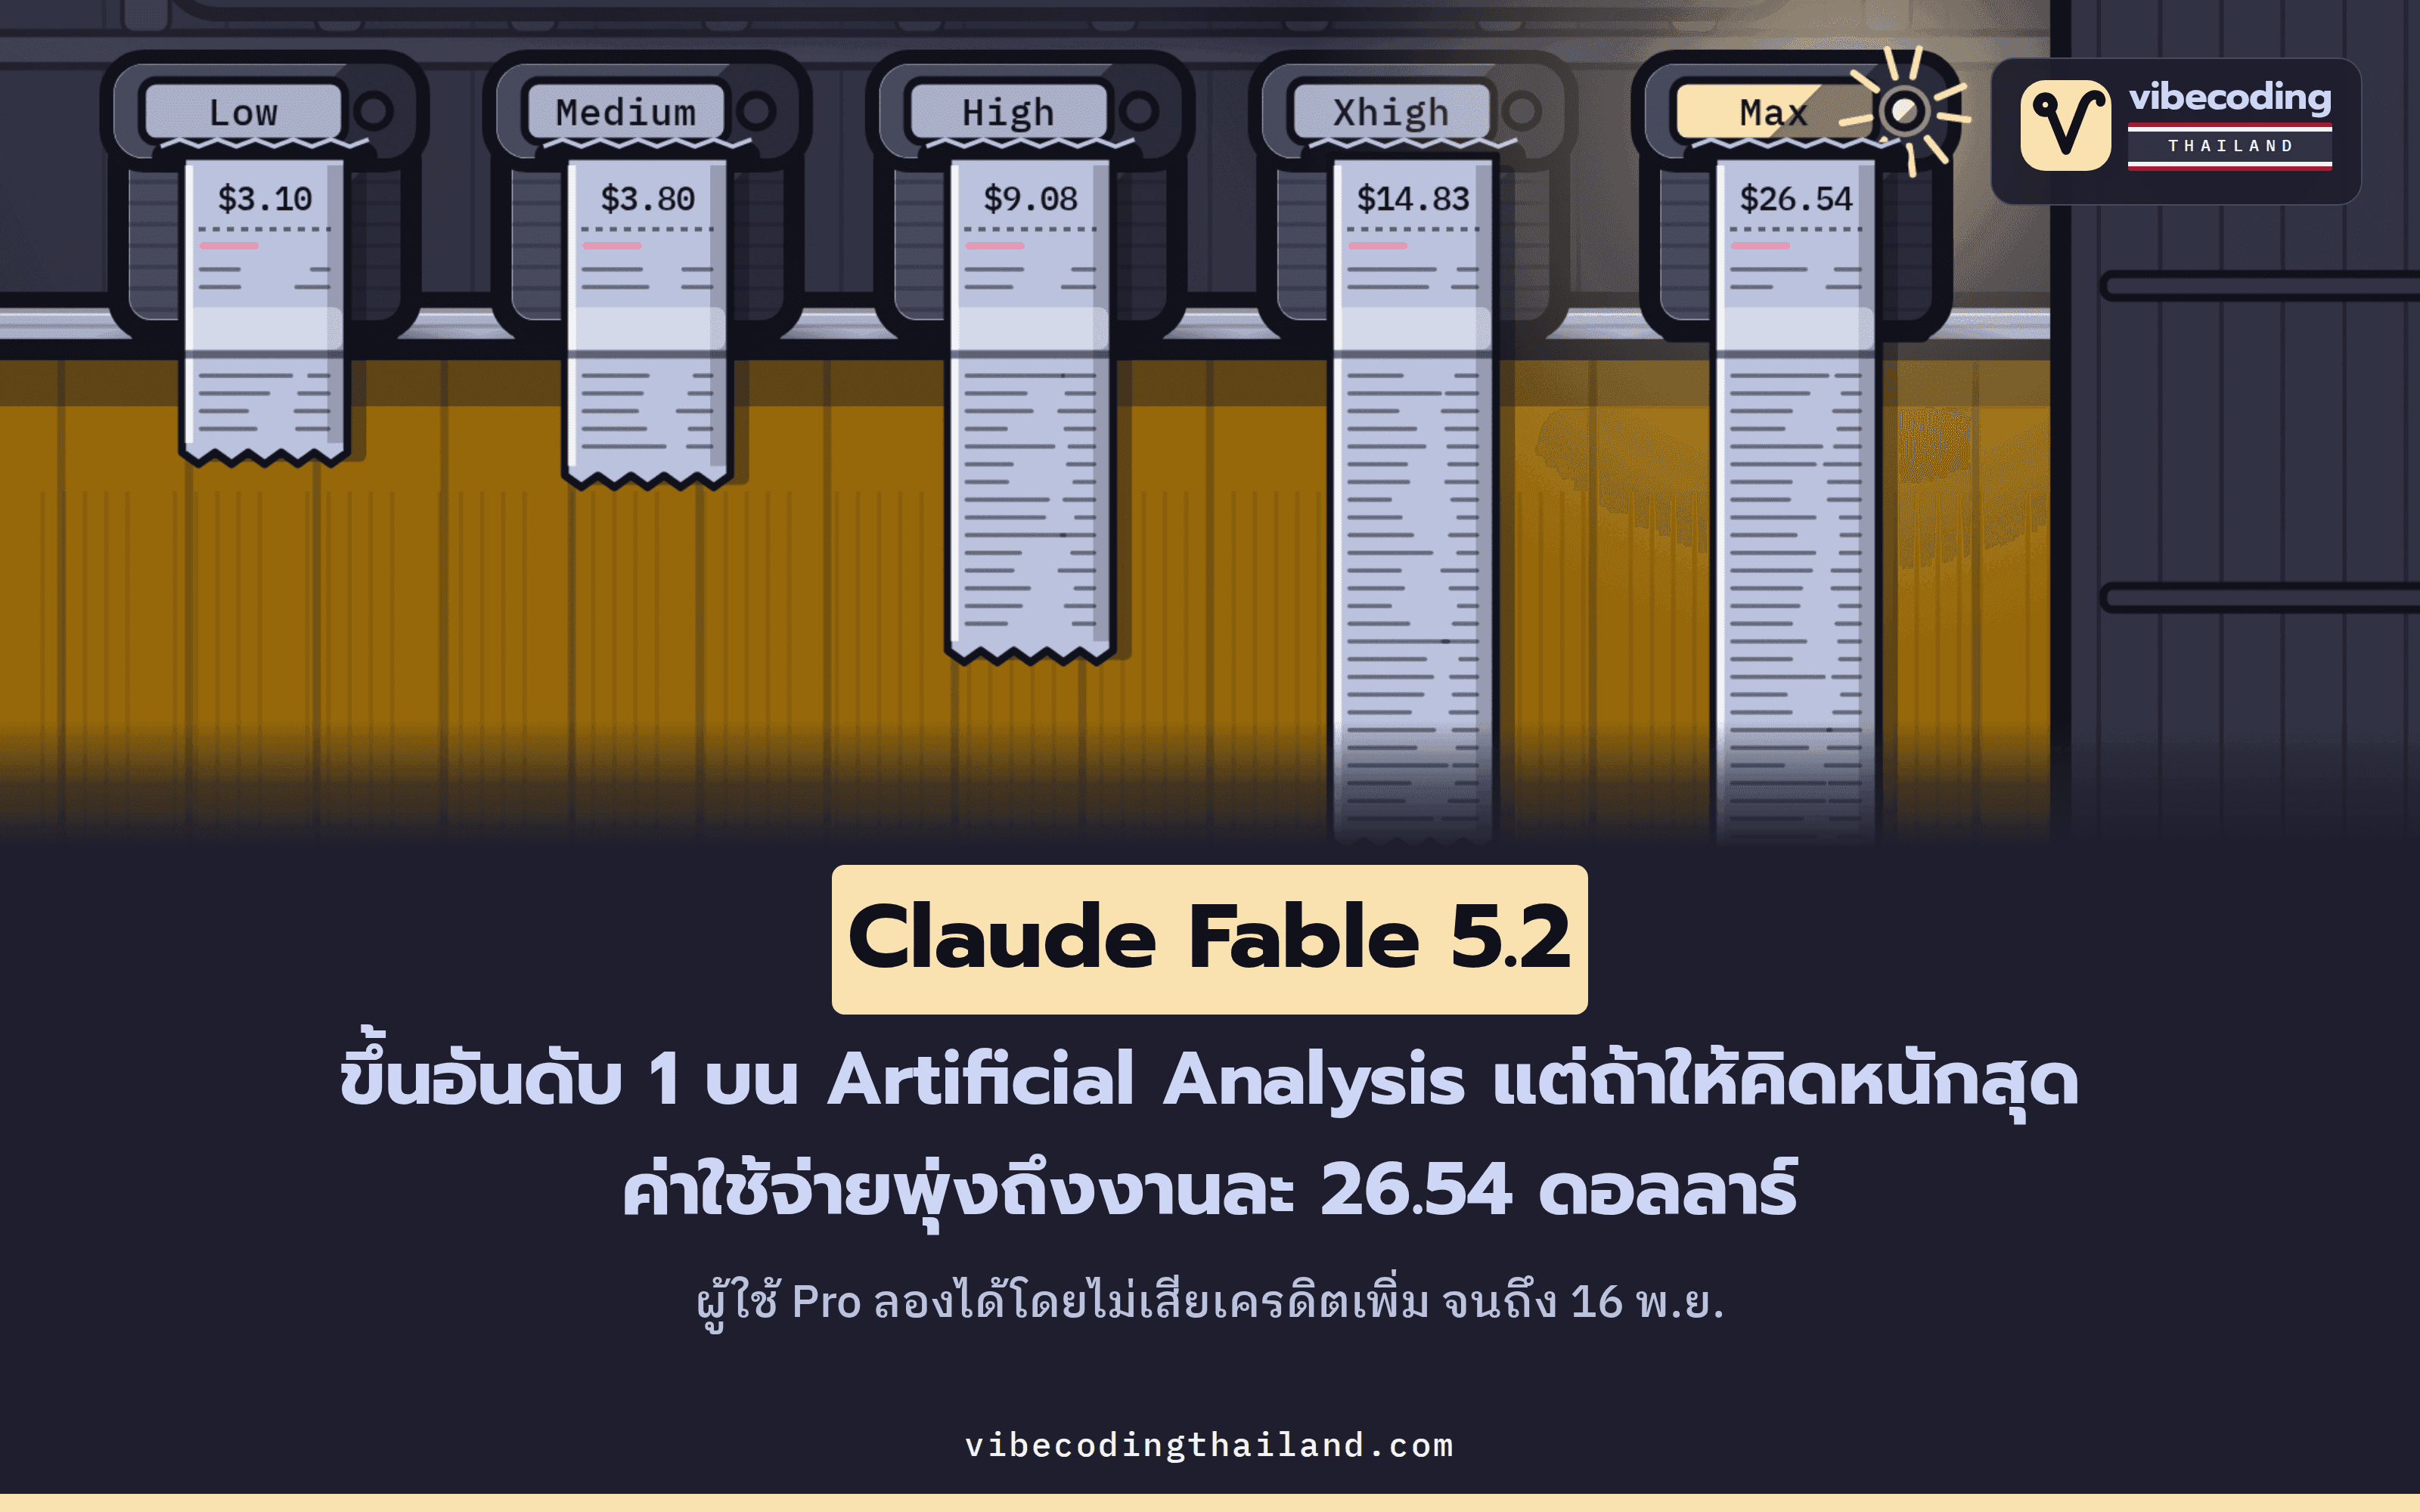
ประสิทธิภาพและผลทดสอบของ Fable 5.2 ส่วนใหญ่ขึ้นอยู่กับค่าที่เรียกว่า effort หรือระดับการคิด ซึ่งเป็นตัวกำหนดว่าโมเดลควรคิดวิเคราะห์ลึกแค่ไหนก่อนตอบ โดยมีทั้งหมด 5 ระดับ คือ Low, Medium, High, Xhigh และ Max ยิ่งตั้งค่าไว้สูง โมเดลก็จะยิ่งใช้เวลาคิดนานขึ้นก่อนจะเริ่มพิมพ์คำตอบ
สำหรับการใช้งานบนแอป Claude ทั่วไปและเครื่องมือช่วยเขียนโค้ดอย่าง Claude Code ระบบจะตั้งค่าเริ่มต้นไว้ที่ระดับ Medium ซึ่ง Anthropic ระบุว่า ที่ระดับนี้ Fable 5.2 สามารถแก้โจทย์ยากๆ ได้สำเร็จโดยใช้จำนวน token น้อยกว่า Fable 5.1 รุ่นก่อนหน้า
ส่วนที่ดีขึ้นจากรุ่นก่อนในด้านอื่นๆ มีดังนี้
- กลุ่มผู้ทดสอบช่วงแรกพบว่า โมเดลสื่อสารได้ชัดเจนกว่า Fable และ Mythos รุ่นก่อนๆ
- สร้างข้อความได้เร็วขึ้นสูงสุด 30% เมื่อเทียบกับรุ่น 5.1
- ระบบ safeguard บล็อกคำสั่งน้อยลงราว 55% จากการทดสอบเบื้องต้นบน claude.ai, Claude Code และ Cowork โดยคำสั่งด้านความปลอดภัยไซเบอร์โดนบล็อกน้อยลงราว 60% และด้านชีววิทยาลดลงราว 40%
ส่วนสเปกอื่นที่ควรรู้ของรุ่นนี้ ได้แก่
- มี fast mode ให้เลือกใช้ เป็นโหมดเสริมที่ช่วยให้สร้างข้อความเร็วขึ้นสูงสุด 2.5 เท่า แลกกับค่าบริการที่สูงขึ้น
- รองรับ context window หรือปริมาณข้อความที่โมเดลอ่านและเข้าใจได้ในรอบเดียว สูงถึง 1 ล้าน token และสร้างข้อความตอบกลับได้ยาวสูงสุด 128K token
- ระบบปรับเวลาคิดอัตโนมัติอย่าง adaptive thinking เปิดอยู่ตลอดเวลาและปิดไม่ได้
ตารางด้านล่างแสดงคะแนนเปรียบเทียบตามที่ Anthropic รายงาน โดยทดสอบแต่ละรุ่นที่ระดับ effort สูงสุดที่รุ่นนั้นรองรับ และเปิดระบบ safeguard ไว้ทั้งหมด ส่วนสองรายการแรกเป็นการทดสอบงานเขียนโค้ดแบบเอเจนต์ คือให้ AI เขียน รัน และแก้บั๊กเองต่อเนื่องหลายขั้นตอน:
| ชุดทดสอบ | วัดอะไร | Fable 5.2 | Fable 5.1 |
|---|---|---|---|
| FrontierSWE v2 | เขียนโค้ดแบบเอเจนต์ | 69.9% | 56.3% |
| FrontierCode 2.0 | เขียนโค้ดแบบเอเจนต์ (วัดที่ Xhigh) | 49.1% | 32.4% |
| OSWorld 2.1 | ใช้คอมพิวเตอร์แทนคนผ่านหน้าจอ | 89.3% | 83.5% |
| Terminal-Bench-Science 0.1 | ทำงานวิจัยวิทยาศาสตร์แบบเอเจนต์ | 74.6% | 52.6% |
| Humanity's Last Exam (ใช้เครื่องมือได้) | ให้เหตุผลกับโจทย์ยากหลายสาขาวิชา | 74.2% | 65.6% |
จุดที่คะแนนทิ้งห่างกันมากที่สุดคือชุดทดสอบงานวิจัยวิทยาศาสตร์อย่าง Terminal-Bench-Science ซึ่ง Fable 5.2 ทำคะแนนนำรุ่นเดิมถึง 22 คะแนน รองลงมาคือ FrontierCode ที่ทิ้งห่างเกือบ 17 คะแนน ส่วนงานใช้คอมพิวเตอร์ผ่านหน้าจออย่าง OSWorld มีส่วนต่างน้อยที่สุดที่ราว 6 คะแนน ซึ่งรุ่น 5.1 เดิมก็ทำคะแนนได้เกิน 80% อยู่แล้ว
อย่างไรก็ตาม จุดที่ต้องระวังคือ ตัวเลขในตารางนี้ไม่ได้วัดที่ระดับ Medium ซึ่งเป็นค่าเริ่มต้นในแอป Claude แต่มาจากการทดสอบที่ระดับ effort สูงสุดของแต่ละรุ่น ยกเว้น FrontierCode ที่วัดที่ระดับ Xhigh
เดโมเอเจนต์พันตัว กับรายละเอียดที่ไม่ควรมองข้าม
ในการเปิดตัวครั้งนี้ Anthropic เผยแพร่เดโมที่น่าทึ่งหลายตัวอย่าง ตัวอย่างแรกคือการสร้างระบบปฏิบัติการโดยเริ่มจากโฟลเดอร์ว่างเปล่า วิศวกรของ Anthropic สั่งให้ Fable 5.2 ออกแบบระบบปฏิบัติการต้นแบบ โมเดลจึงแบ่งงานให้ subagent กว่า 1,000 ตัว ซึ่งเป็นเอเจนต์ย่อยที่รับงานเฉพาะด้านไปทำ ทั้งหมดช่วยกันเขียนโค้ด ทดสอบระบบ และไล่แก้ข้อผิดพลาดต่อเนื่องตลอด 24 ชั่วโมง นานถึง 8 วันเต็ม
ผลลัพธ์ที่ได้คือระบบปฏิบัติการที่บูตใช้งานบนแล็ปท็อปได้จริง มีเคอร์เนลของตัวเอง มีไดรเวอร์รองรับดิสก์ คีย์บอร์ด และเครือข่าย มีระบบไฟล์ที่เก็บข้อมูลได้ถาวร มีระบบหน้าต่าง หน้าจอเข้าสู่ระบบ ตัวติดตั้ง และยังมี Claude ฝังมาในระบบปฏิบัติการอีกด้วย
เดโมตัวที่สองคือการแปลงโค้ดระบบสำคัญที่ใช้งานจริงจากภาษา Python ไปเป็นภาษา Rust ส่งผลให้ระบบดังกล่าวเริ่มทำงานได้เร็วขึ้นราว 26 เท่า ทั้งยังใช้ทรัพยากรได้คุ้มขึ้นและเสถียรขึ้น แต่ต้องย้ำว่าทีมเอเจนต์ที่ทำงานนี้รันบน Fable 5.2 เวอร์ชันก่อนเปิดตัวจริง ไม่ใช่เวอร์ชันเดียวกับที่เปิดให้ใช้ทั่วไปตอนนี้ ตามที่ Anthropic ระบุไว้ในบทความเปิดตัว
เดโมตัวที่สามเป็นงานด้านคณิตศาสตร์ โดยทีมเอเจนต์ Fable 5.2 ราว 1,000 ตัว ช่วยกันแปลงบทพิสูจน์ทฤษฎีบทสุดท้ายของแฟร์มาต์ให้อยู่ในรูปภาษา Lean ซึ่งเป็นภาษาโปรแกรมที่คอมพิวเตอร์ใช้ตรวจความถูกต้องของบทพิสูจน์ได้ทีละขั้นตอน งานนี้เสร็จภายในเวลาเพียง 30 ชั่วโมง และแทบไม่ต้องมีคนเข้าไปช่วยเลย
จุดที่อาจทำให้สับสนคือ งานนี้ไม่ใช่การคิดค้นบทพิสูจน์ขึ้นใหม่ แต่เป็นการนำบทพิสูจน์ที่นักคณิตศาสตร์เขียนไว้แล้วมาเขียนใหม่ในรูปแบบที่คอมพิวเตอร์ตรวจได้ทุกขั้นตอน ส่วนประสิทธิภาพก็ดีขึ้นมากเมื่อเทียบกับรอบก่อน เพราะครั้งก่อน Anthropic เคยลองทำงานนี้ด้วย Claude รุ่นวิจัยภายในที่ยังไม่เปิดตัว และต้องใช้เวลานานถึง 11 วัน แต่รอบนี้ Fable 5.2 ใช้ token เพียงหนึ่งในสามของครั้งก่อน แถมยังได้บทพิสูจน์ที่กระชับและสั้นลงถึง 7 เท่า
ส่วน Opus 5.5 ซึ่งเป็นโมเดลระดับสูงอีกสายของ Claude เมื่อทดสอบด้วยทีมเอเจนต์ 1,000 ตัวเท่ากัน กลับทำงานไปได้เพียง 26% เท่านั้นในเวลา 18 ชั่วโมง
เดโมทั้งสามชิ้นนี้แสดงให้เห็นว่าโมเดลทำได้มากที่สุดแค่ไหนเมื่อปล่อยให้ทำงานเองต่อเนื่องเป็นเวลานาน ซึ่งต่างจากการแชตถามตอบทั่วไปอย่างสิ้นเชิง และการให้โมเดลคิดและประมวลผลหนักต่อเนื่องแบบนี้เองคือปัจจัยหลักที่ทำให้ค่าใช้จ่ายในการประมวลผลพุ่งขึ้นอย่างรวดเร็ว
ราคาต่อ token ถูกลง แต่ค่าใช้จ่ายต่องานอาจไม่ได้ถูกลงเสมอไป
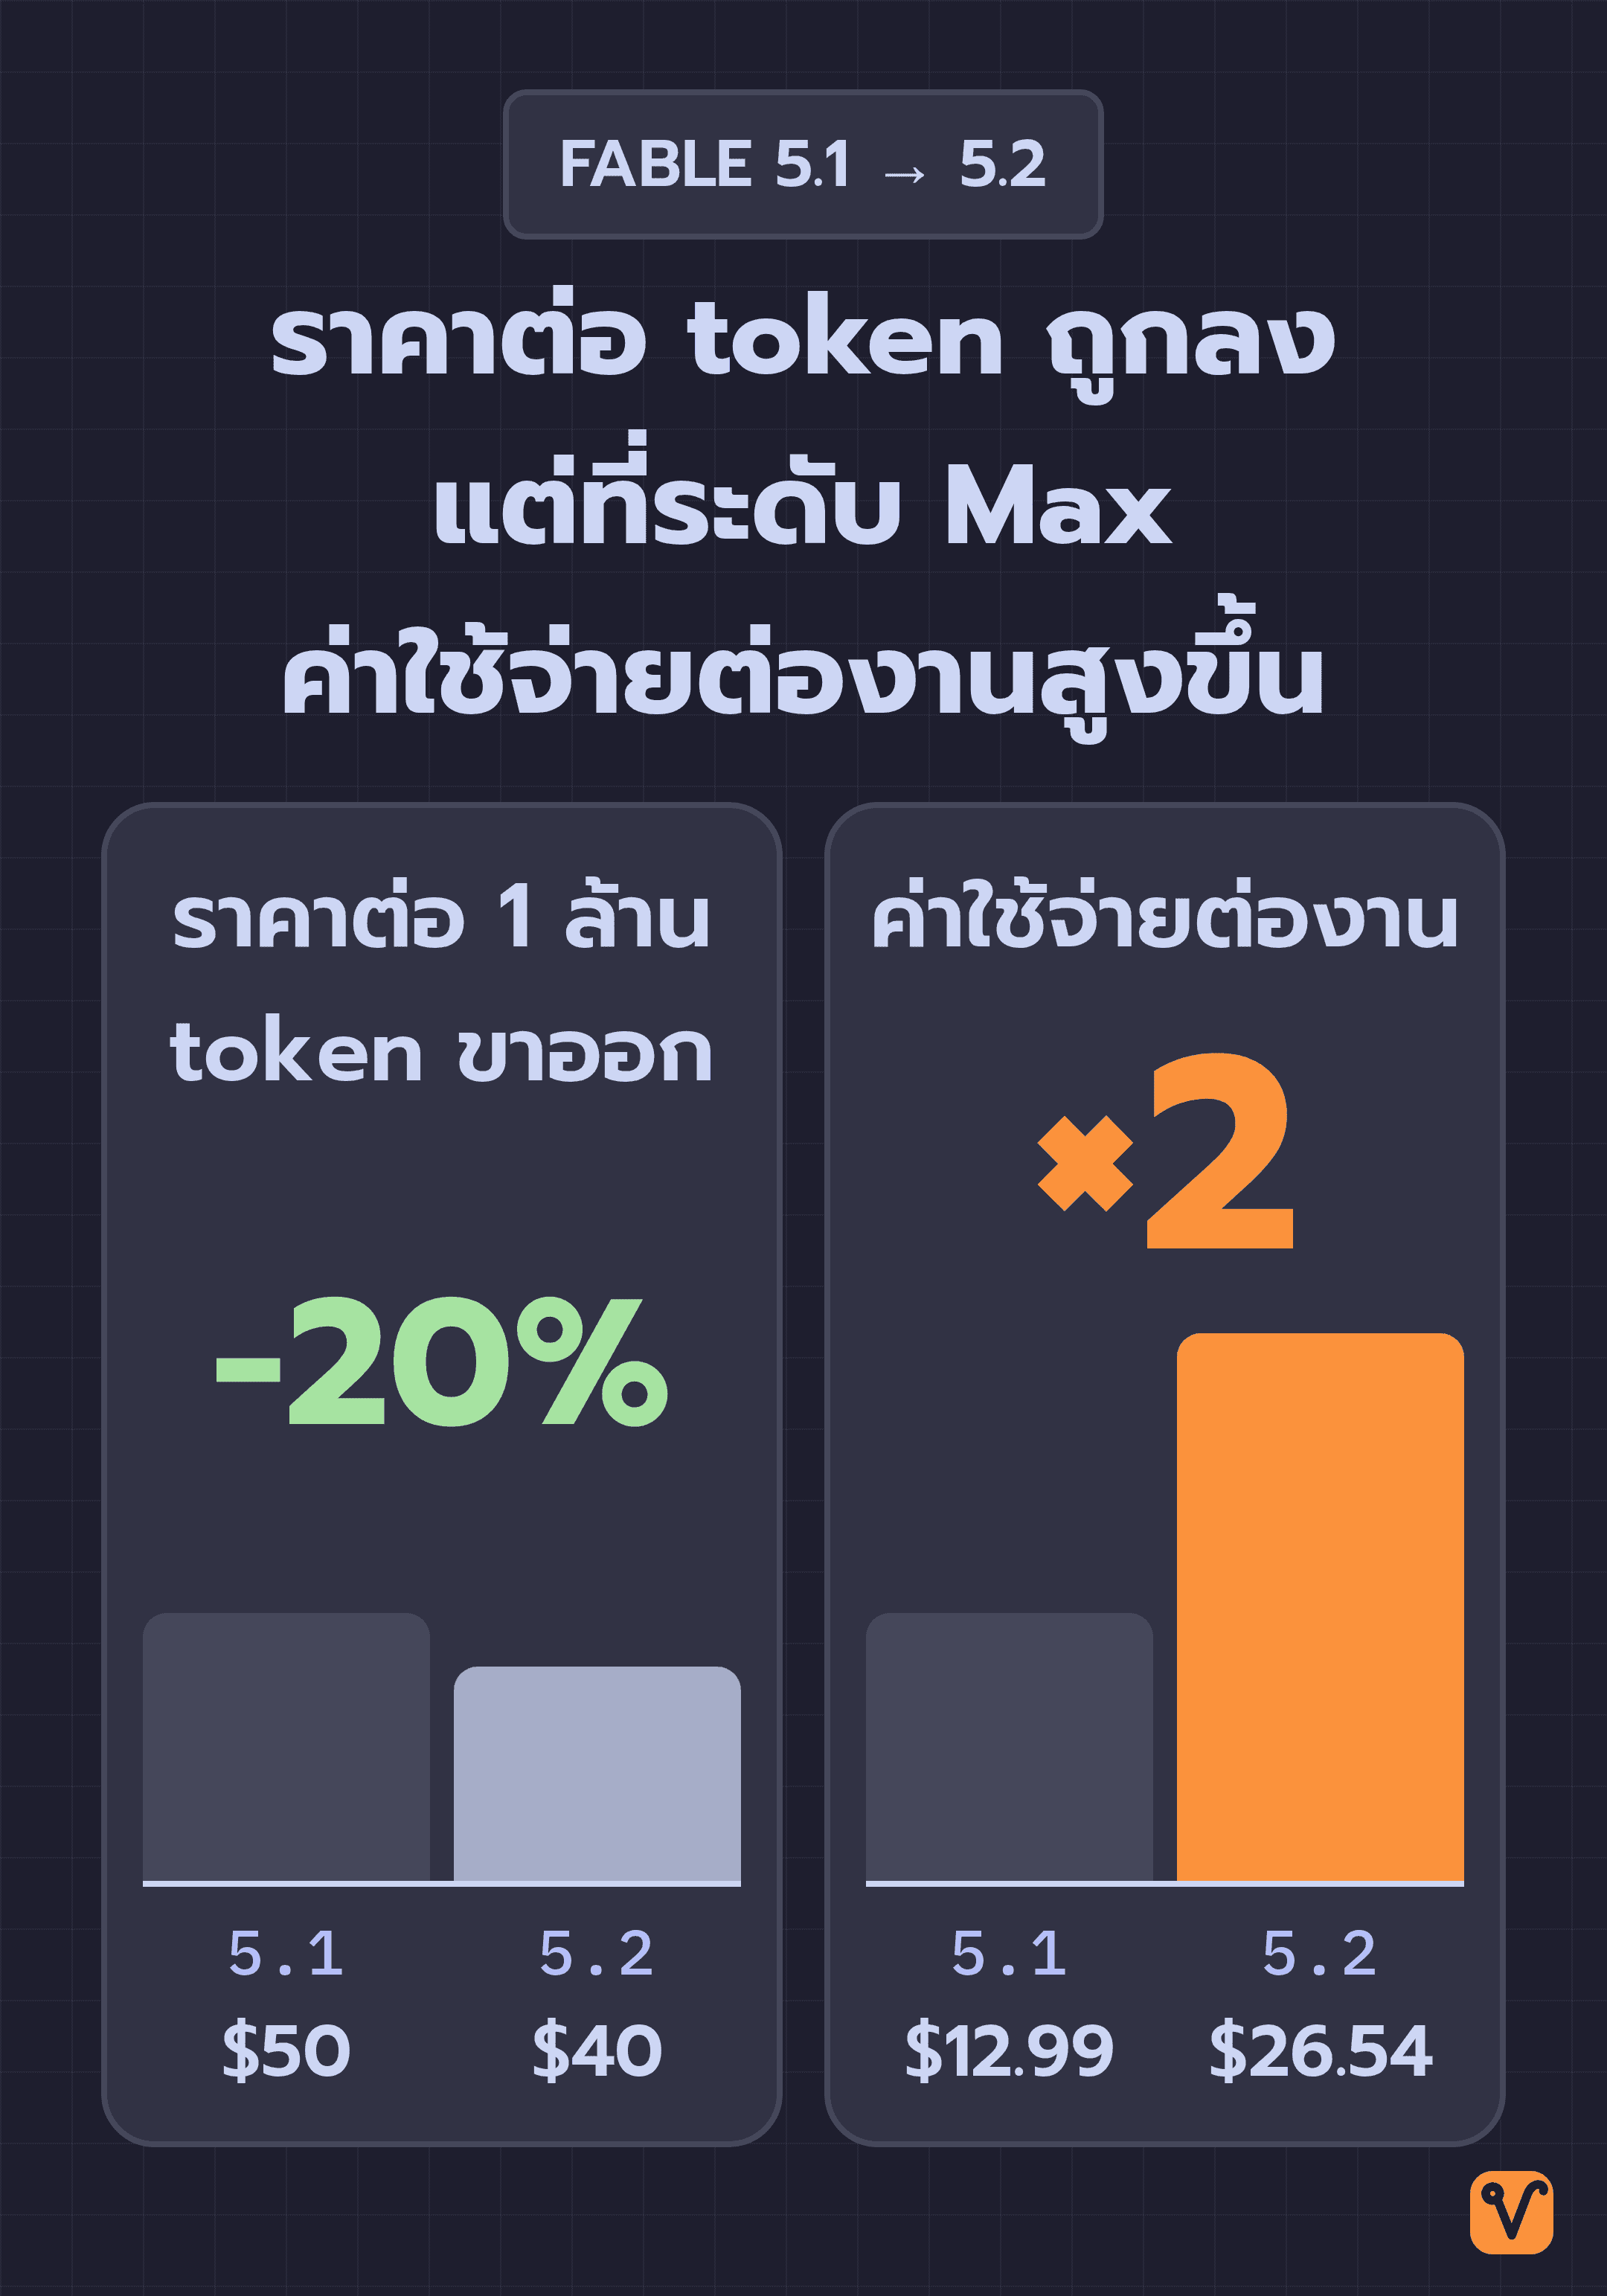
ค่าบริการของ Fable 5.2 ผ่าน API ซึ่งเป็นช่องทางเชื่อมต่อสำหรับนักพัฒนา อยู่ที่ 8 ดอลลาร์ต่อ 1 ล้าน token ขาเข้า คือข้อความที่เราส่งให้โมเดล และ 40 ดอลลาร์ต่อ 1 ล้าน token ขาออก คือข้อความที่โมเดลตอบกลับมา ลดลงจากรุ่น 5.1 เดิมที่คิด 10 ดอลลาร์และ 50 ดอลลาร์ตามลำดับ หรือคิดเป็นราคาต่อ token ที่ถูกลงราว 20%
แต่ตัวเลขที่ผู้ใช้ต้องดูควบคู่กันคือ "ค่าใช้จ่ายเฉลี่ยต่องาน" ซึ่ง Artificial Analysis วัดจากการให้โมเดลแก้โจทย์ในชุดทดสอบรวม และพบว่าถ้าให้โมเดลคิดหนักที่สุดที่ระดับ Max ค่าใช้จ่ายเฉลี่ยต่องานของ Fable 5.2 จะพุ่งสูงถึงราว 26.54 ดอลลาร์
ประเด็นราคานี้กลายเป็นหัวข้อถกเถียงในชุมชน Reddit ห้อง r/ClaudeAI จากกระทู้ที่ตั้งข้อสังเกตว่า Fable 5.2 ไม่ได้ถูกกว่ารุ่น 5.1 จริงอย่างที่โฆษณา กราฟที่เจ้าของกระทู้นำมาแสดงชี้ว่า เมื่อตั้งค่าไว้ที่ระดับ Max ค่าใช้จ่ายต่องานของ Fable 5.2 อยู่ที่ 26.54 ดอลลาร์ ขณะที่รุ่น 5.1 อยู่ที่ประมาณ 12.99 ดอลลาร์ ต่างกันมากกว่าเท่าตัว
อย่างไรก็ตาม ผู้ใช้อีกฝั่งในกระทู้แย้งว่า การเทียบเฉพาะที่ระดับ Max อาจทำให้เข้าใจคลาดเคลื่อนได้ ส่วนบทสรุปอัตโนมัติของกระทู้ระบุว่า เสียงส่วนใหญ่มองว่าการเปิดระดับ Max ทำให้ Fable 5.2 คิดเกินความจำเป็น และแนะนำให้เทียบกันที่ระดับการคิดที่คุ้มกว่า เช่น ระดับ Medium ถ้าเน้นประหยัดงบ หรือระดับ High ถ้าเน้นผลลัพธ์ของงาน
ถึงอย่างนั้น ระดับที่ต่ำกว่า Max ก็ยังมีความเห็นต่างกันอยู่ ผู้ใช้รายหนึ่งบอกว่าทุกระดับที่สูงกว่า Medium ล้วนแพงกว่ารุ่น 5.1 ในระดับเดียวกัน ขณะที่อีกคนแย้งว่าถ้าดูที่ระดับ Medium บนกราฟเดียวกัน จะเห็นชัดว่า Fable 5.2 ค่าใช้จ่ายถูกกว่า 5.1 ทั้งนี้ ความเห็นทั้งหมดเป็นเพียงข้อถกเถียงในเว็บบอร์ด ไม่ใช่ผลทดสอบทางการชุดใหม่
สาเหตุของเรื่องนี้เข้าใจได้ง่ายเมื่อเราแยกตัวเลขสองส่วนออกจากกัน:
- ราคาต่อ token คือราคาต่อหน่วย
- ค่าใช้จ่ายต่องาน คือราคาต่อหน่วยคูณด้วยจำนวน token ทั้งหมดที่โมเดลใช้ในงานนั้น
เมื่อเปิดระดับ Max โมเดลจะใช้เวลาคิดทบทวนอย่างละเอียดและเขียนโค้ดหรือคำตอบออกมายาวมาก ทำให้ปริมาณ token ขาออกพุ่งขึ้นมหาศาล จนราคาต่อหน่วยที่ลดลง 20% ชดเชยปริมาณ token ที่เพิ่มขึ้นไม่ไหว ค่าใช้จ่ายรวมต่องานจึงยังสูงขึ้นอยู่ดี
ปริมาณ token ที่เพิ่มขึ้นนี้มีตัวเลขให้เห็นชัด ตอนที่ Artificial Analysis รันการทดสอบทั้งหมดที่ระดับ Max นั้น Fable 5.2 สร้าง token ขาออกไปมากถึง 275 ล้าน token ขณะที่ค่ากลางของโมเดลคู่แข่งในกลุ่มราคาใกล้เคียงกันใช้ไปเพียง 72.8 ล้าน token เท่านั้น แปลว่า Fable 5.2 เขียนข้อความออกมามากกว่าค่ากลางเกือบ 4 เท่า
หน้าข้อมูลของ Artificial Analysis จึงได้สรุปไว้ว่า แม้ Fable 5.2 จะจัดเป็นหนึ่งในโมเดลที่ฉลาดที่สุดในปัจจุบัน แต่ก็มีค่าใช้จ่ายสูงเป็นพิเศษเมื่อเทียบกับโมเดลในกลุ่มราคาเดียวกัน ทั้งยังใช้เวลาประมวลผลต่องานค่อนข้างนานและสร้างคำตอบที่ยาวมาก
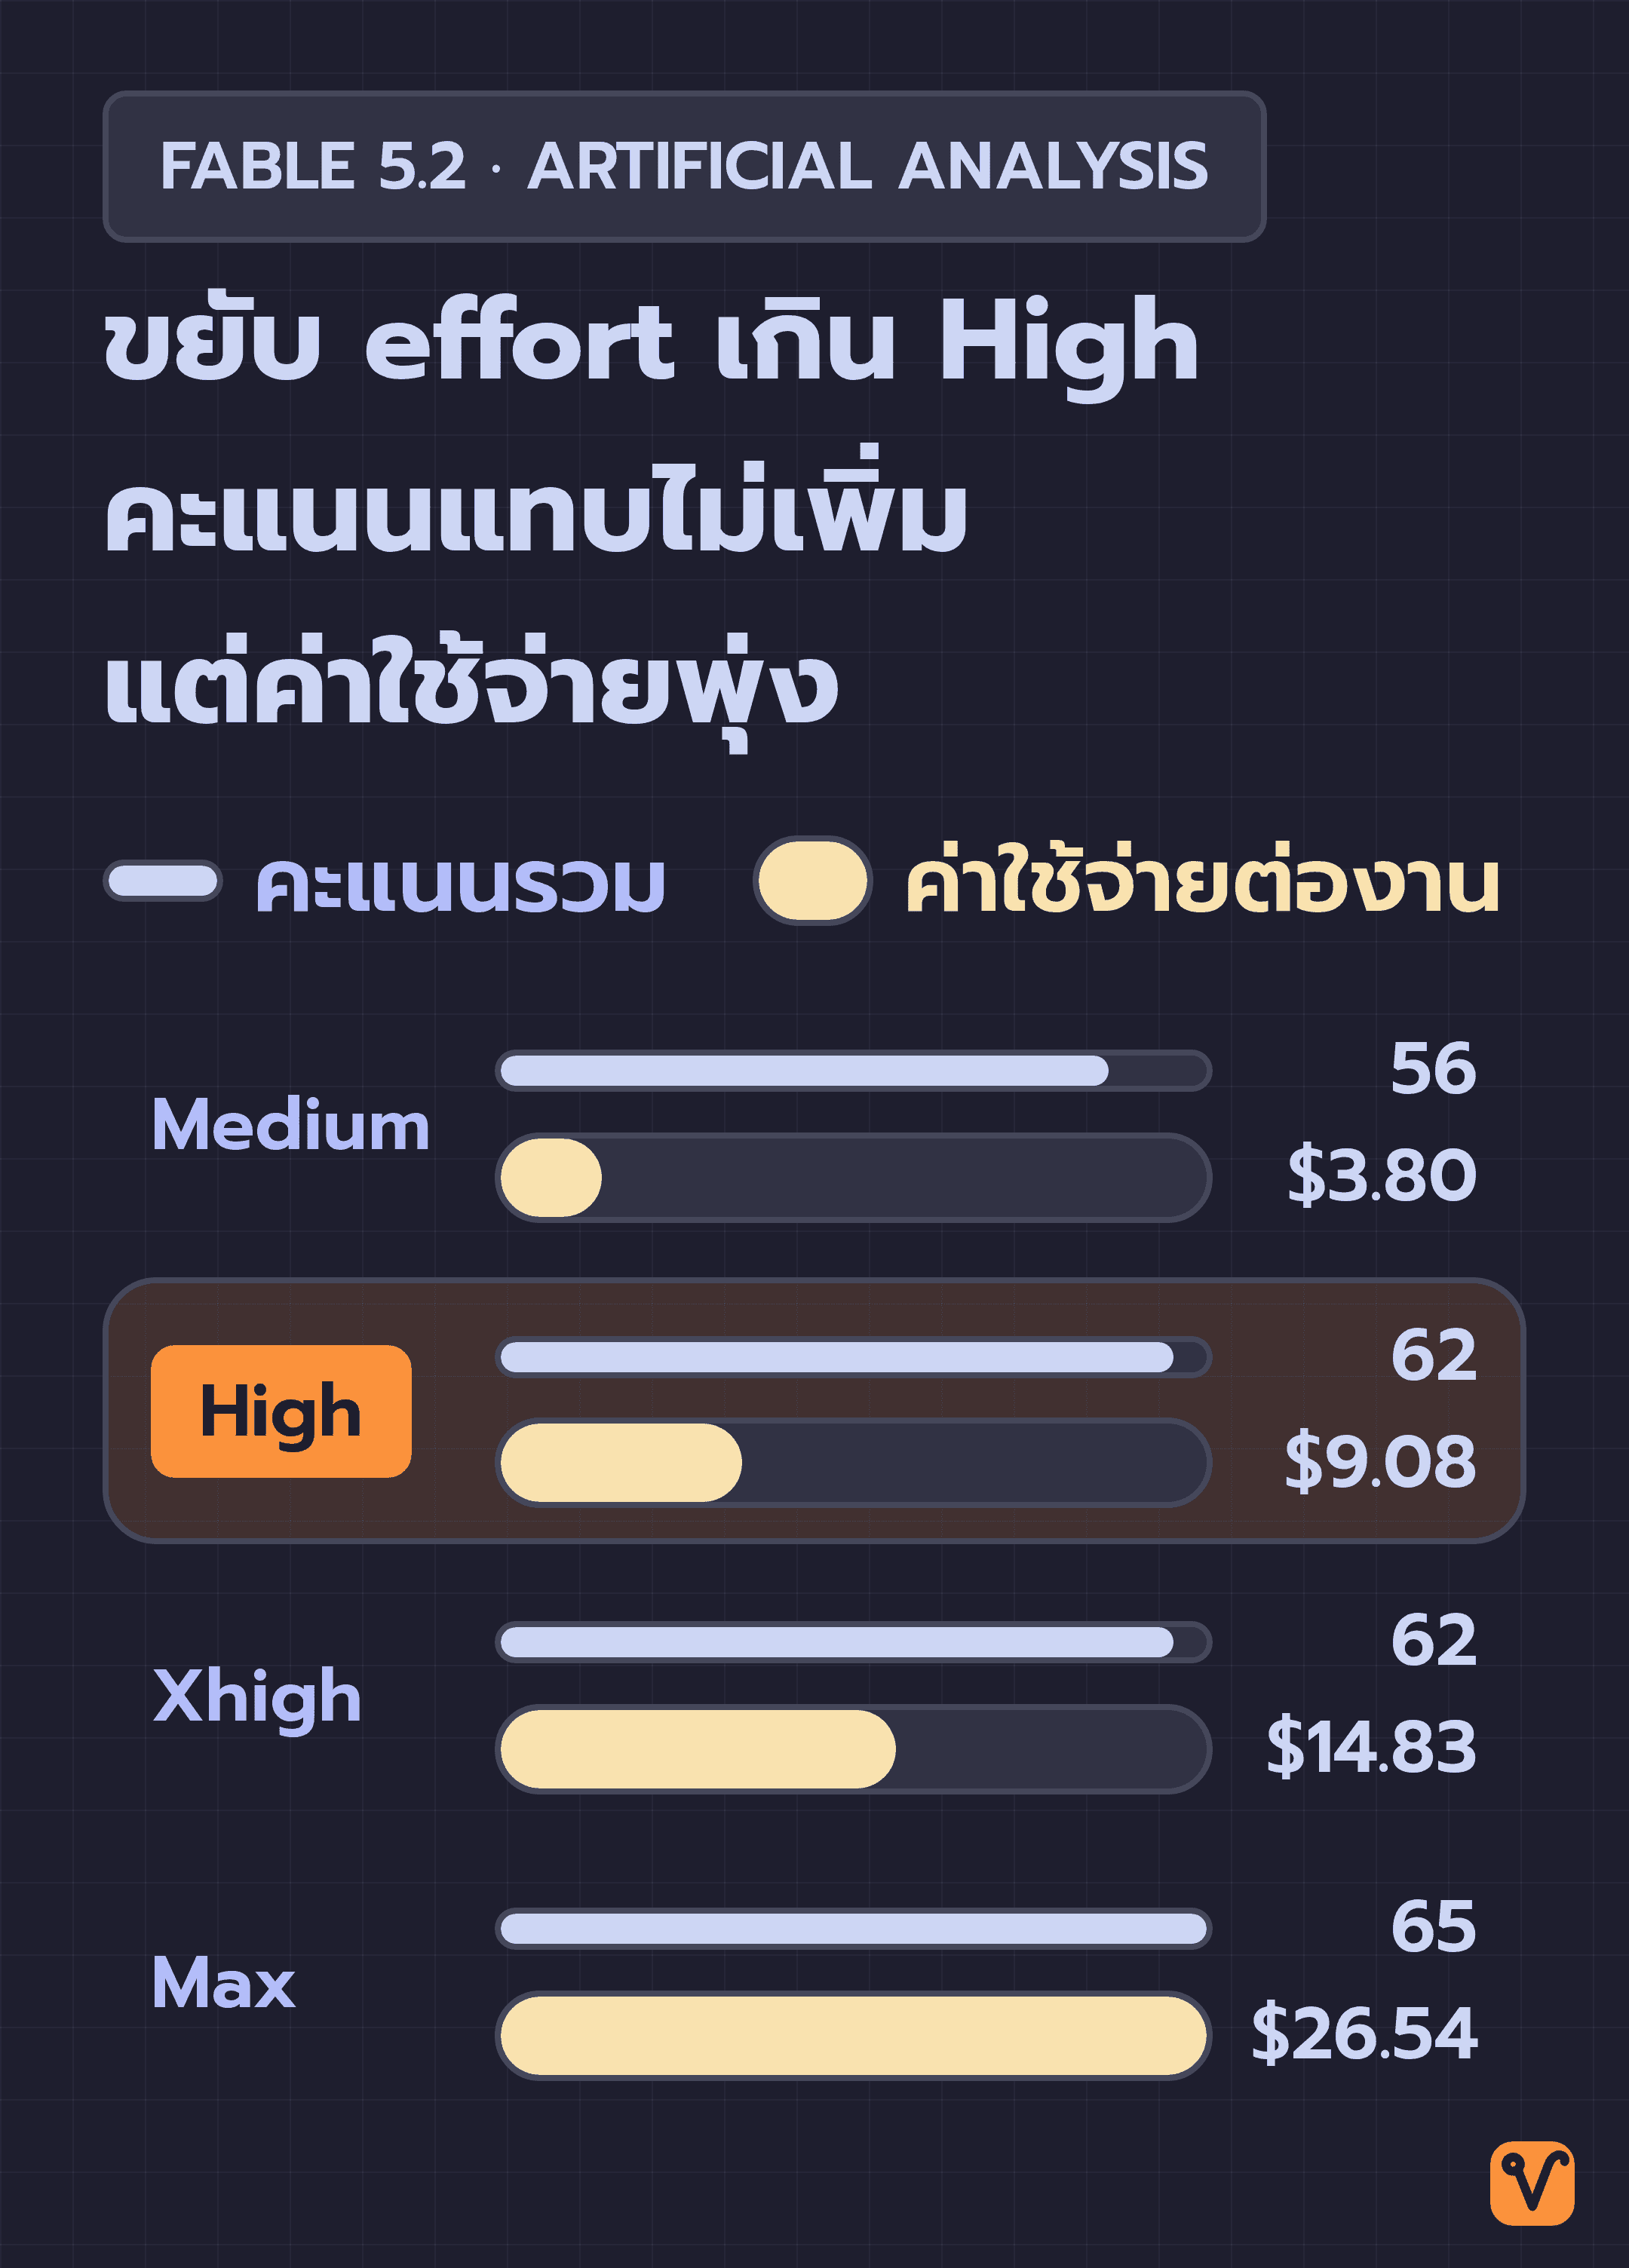
ตารางด้านล่างแสดงคะแนนรวมและค่าใช้จ่ายเฉลี่ยต่องานในแต่ละระดับ effort จาก LLM Leaderboard ของ Artificial Analysis (ข้อมูล ณ วันที่ 10 พ.ย. 2026 ตัวเลขอาจเปลี่ยนได้ในการทดสอบรอบถัดไป):
| โมเดล (effort) | คะแนนรวม | ค่าใช้จ่ายต่องาน | เวลาต่องาน |
|---|---|---|---|
| Fable 5.2 (Max) | 65 | $26.54 | 44.1 นาที |
| Fable 5.2 (Xhigh) | 62 | $14.83 | 26.3 นาที |
| Fable 5.2 (High) | 62 | $9.08 | 17.7 นาที |
| Fable 5.2 (Medium) | 56 | $3.80 | 8.3 นาที |
| Fable 5.2 (Low) | 54 | $3.10 | 6.5 นาที |
| Opus 5.5 (Max) | 59 | $10.04 | 25.1 นาที |
เมื่อเปรียบเทียบระหว่างระดับ High กับ Xhigh จะพบว่าได้คะแนนรวมเท่ากันที่ 62 คะแนน แต่ Xhigh มีค่าใช้จ่ายสูงกว่าถึงราว 60% ส่วนการขยับจากระดับ High ขึ้นไปเป็น Max ได้คะแนนเพิ่มเพียง 3 คะแนน แต่ต้องแลกกับค่าใช้จ่ายที่เพิ่มขึ้นเกือบ 3 เท่า และต้องรอนานขึ้นถึงราว 2.5 เท่า
อีกจุดที่อาจทำให้สับสน คือข้อมูลที่ Anthropic เคยระบุว่า Fable 5.2 ที่ระดับ High ทำคะแนนได้ใกล้เคียงกับ Opus 5.5 ที่ระดับ Max โดยมีค่าใช้จ่ายต่องานเพียงราวครึ่งเดียว ต้องย้ำว่าตัวเลขนี้เทียบกับ Opus 5.5 ไม่ใช่รุ่น 5.1 และวัดจากชุดทดสอบ FrontierCode 2.0 เท่านั้น แต่หากดูจากคะแนนรวมของ Artificial Analysis จะพบว่าโมเดลทั้งสองมีค่าใช้จ่ายต่องานใกล้เคียงกันมาก คือ 9.08 ดอลลาร์เทียบกับ 10.04 ดอลลาร์ โดย Fable 5.2 ที่ระดับ High ได้คะแนนนำอยู่ที่ 62 ต่อ 59 คะแนน เนื่องจากตัวเลขทั้งสองชุดมาจากแบบทดสอบคนละชุด จึงไม่สามารถนำมาหักล้างกันโดยตรงได้
เลือกระดับ effort ให้เหมาะกับงาน
จากข้อมูลการทดสอบทั้งหมด สรุปแนวทางการเลือกระดับ effort ให้เหมาะสมและคุ้มค่าได้ดังนี้:
- งานทั่วไปในชีวิตประจำวัน: แนะนำให้ใช้ระดับ Medium ซึ่งเป็นค่าเริ่มต้นบนหน้าเว็บและในแอปอยู่แล้ว
- งานซับซ้อนที่ต้องคิดหลายขั้นตอน: แนะนำให้ลองขยับมาใช้ระดับ High เพราะคะแนนรวมของ Artificial Analysis ชี้ว่าระดับนี้ได้คะแนนเท่ากับระดับ Xhigh แต่ค่าบริการถูกกว่ามาก
- ระดับ Max: ควรเก็บไว้ใช้เฉพาะงานที่ซับซ้อนอย่างยิ่งและไม่เร่งรีบเท่านั้น เพราะ Artificial Analysis วัดเวลาประมวลผลเฉลี่ยต่องานได้นานถึงราว 44 นาที และต้องรอนานเกือบ 4 นาทีกว่าโมเดลจะเริ่มพิมพ์คำตอบแรกออกมา
- ผู้ใช้งาน API หรือ Claude Code ที่ต้องการความเร็วสูง: สามารถเปิดใช้งาน fast mode เพิ่มเติมได้ โดยมีค่าบริการอยู่ที่ 16 ดอลลาร์ต่อ 1 ล้าน token ขาเข้า และ 80 ดอลลาร์ต่อ 1 ล้าน token ขาออก หรือคิดเป็น 2 เท่าของราคาปกติ
ข้อควรระวังสำคัญคือ ค่าเริ่มต้นของแต่ละช่องทางนั้นไม่เท่ากัน:
- ใช้งานผ่านหน้าเว็บ/แอป Claude และ Claude Code ค่าเริ่มต้นจะอยู่ที่ Medium
- ใช้งานผ่าน API ค่าเริ่มต้นจะอยู่ที่ High
สำหรับฝั่งนักพัฒนา เอกสารทางการของ Anthropic แนะนำให้เริ่มต้นที่ระดับ High เนื่องจากความสามารถหลักๆ ที่เพิ่มขึ้นในรุ่นนี้จะเริ่มเห็นชัดตั้งแต่ระดับนี้ขึ้นไป จากนั้นเมื่อทดสอบแล้วพบว่าได้ผลดีขึ้นจริง จึงค่อยขยับไปใช้ Xhigh กับงานเขียนโค้ดหรืองานเอเจนต์ที่ยาวและยากเป็นพิเศษ ส่วนระดับ Max แนะนำให้เก็บไว้ใช้เพื่อทดสอบขีดจำกัดสูงสุดของโมเดล หรือใช้งานเฉพาะบางกรณีที่ไม่จำกัดเวลาและจำนวน token
อีกเรื่องที่ควรรู้คือ การพิมพ์ในพรอมต์หรือข้อความสั่งงานว่า "ตอบเลย ไม่ต้องคิดนาน" จะใช้กับรุ่น 5.2 ไม่ได้ผลเหมือนตอนรุ่น 5.1 อีกต่อไป เพราะจากการทดสอบของ Anthropic คำสั่งแบบนี้หยุดการคิดของ Fable 5.2 ไม่ได้เมื่อตั้งค่าไว้ตั้งแต่ระดับ Medium ขึ้นไป และถ้าตั้งไว้ที่ระดับ High ขึ้นไป โมเดลจะคิดวิเคราะห์ก่อนตอบแทบทุกครั้ง ดังนั้นถ้ารู้สึกว่าโมเดลตอบงานง่ายๆ ช้าหรือเปลืองเกินไป ทางแก้ที่ถูกคือลดระดับ effort ลง ไม่ใช่เขียนพรอมต์สั่งเพิ่ม
ในภาพรวม Anthropic แนะนำให้เริ่มทำงานเขียนโค้ดและ knowledge work ส่วนใหญ่ด้วย Opus 5.5 ก่อน แล้วจึงค่อยขยับมาใช้ตระกูล Fable กับงานเชิงเทคนิคขนาดใหญ่ที่ซับซ้อนสูง ส่วนผู้ใช้ Claude Code ดูวิธีตั้งค่าระดับการคิดได้ที่บทความ effort level ใน Claude Code
โปรเปิดตัว Fable 5.2 ใครได้สิทธิ์อะไร ถึงวันไหน
โปรโมชันเปิดตัวครั้งนี้ครอบคลุมโมเดลตระกูล Fable ทุกรุ่น ทั้ง 5.2, 5.1 และ 5 โดยสิทธิประโยชน์แบ่งออกเป็น 2 รูปแบบหลัก คือ สิทธิ์ใช้ Fable ในแพ็กเกจโดยไม่ต้องจ่ายเครดิตเพิ่ม และสิทธิ์กดรีเซ็ตโควตาอย่าง Limit Reset เพื่อคืนโควตาที่ใช้ไปแล้วให้กลับมาเต็มอีกครั้ง
การกด reset จะคืนโควตารายสัปดาห์ส่วนที่ใช้กับ Fable ไปแล้ว และสำหรับบัญชีที่มีลิมิตรอบ 5 ชั่วโมง ก็จะเติมโควตารอบนั้นให้กลับมาเต็มด้วย ทั้งนี้ การ reset เป็นเพียงการเติมโควตาเดิมให้เต็ม ไม่ใช่การเพิ่มเพดานลิมิต
| แผน | ได้อะไร | ใช้ได้ถึง |
|---|---|---|
| Pro และที่นั่ง standard ของ Team | ใช้ Fable ในแผนได้ไม่เกิน 50% ของลิมิตรายสัปดาห์ โดยไม่เสียเครดิตเพิ่ม ตั้งแต่ 9 พ.ย. และได้ reset 1 ครั้ง | 16 พ.ย. 23:59 น. เวลาแปซิฟิก (ตรงกับ 17 พ.ย. 14:59 น. เวลาไทย) |
| Max, Ultra, ที่นั่ง premium ของ Team และที่นั่ง premium ของ Enterprise แบบคิดตามที่นั่งรุ่นเดิม | reset 1, 2 หรือ 3 ครั้งตามอายุการเป็นสมาชิก | 8 มี.ค. 2027 23:59 น. เวลาแปซิฟิก |
| Free, ที่นั่ง standard ของ Enterprise รุ่นเดิม, Enterprise แบบ self-serve, Enterprise แบบคิดตามการใช้งาน และแผน Enterprise ที่รองรับ HIPAA | ไม่ได้รับโปรนี้ | - |
สำหรับผู้ใช้แผน Max, Ultra และที่นั่งแบบ premium จำนวนสิทธิ์ reset จะนับตามอายุการเป็นสมาชิกตั้งแต่เริ่มจ่ายบิลแรก:
- เป็นสมาชิกไม่ถึง 6 เดือน: ได้สิทธิ์ reset 1 ครั้ง
- เป็นสมาชิก 6 ถึง 12 เดือน: ได้สิทธิ์ reset 2 ครั้ง
- เป็นสมาชิกมากกว่า 12 เดือน: ได้สิทธิ์ reset 3 ครั้ง
ไม่ว่าแผนไหน สิทธิ์ reset จะให้เฉพาะบัญชีที่ชำระเงินอยู่แล้วก่อนวันที่ 9 พ.ย. เวลา 10:00 น. ตามเวลาแปซิฟิกเท่านั้น
วิธีใช้สิทธิ์ reset คือเข้าไปที่ Settings > Usage หาหัวข้อ Limit resets แล้วกด "Reset for free" จะกดเมื่อไหร่ก็ได้ก่อนวันหมดอายุ โดยไม่ต้องรอให้ลิมิตหมดเกลี้ยงก่อน แต่ควรเลือกจังหวะกดให้ดี เพราะการ reset จะคืนโควตาเฉพาะส่วนที่เราใช้ไปแล้วเท่านั้น และเมื่อกดยืนยันแล้วจะยกเลิกไม่ได้ ถ้ากดตอนที่เพิ่งใช้ไปเพียงเล็กน้อย ก็จะได้โควตาคืนมาเพียงเล็กน้อยเช่นกัน
ก่อนเริ่มใช้งานจริง มีอีก 3 ข้อสำคัญที่ควรทราบ:
- ระบบจะไม่สลับโมเดลเริ่มต้นในแอปมาเป็น Fable ให้อัตโนมัติ ผู้ใช้งานต้องเลือกเปลี่ยนโมเดลจากเมนูด้วยตัวเอง
- ศูนย์ช่วยเหลือของ Claude เตือนไว้ชัดเจนว่า Fable จะกินโควตาเร็วกว่าโมเดลอื่นๆ ของ Claude
- เมื่อใช้ครบโควตา 50% ของแผน หรือเมื่อหมดสัปดาห์โปรโมชันแล้ว ผู้ใช้แผน Pro ที่เปิดใช้เครดิตไว้จะกลับไปจ่ายค่าใช้ Fable ด้วยเครดิตการใช้งานตามปกติ ส่วนโควตาที่ใช้ไม่หมดในสัปดาห์นั้นจะยกยอดไปใช้ในสัปดาห์ถัดไปไม่ได้
สำหรับนักพัฒนา เช็กจุดที่อาจเกิด error ก่อนเปลี่ยน model ID
โมเดลรุ่นนี้ใช้ model ID หรือรหัสระบุชื่อโมเดลในโค้ด คือ claude-fable-5-2 ซึ่งเรียกใช้ได้ทั้งบน Claude API, Amazon Bedrock, Google Cloud และ Microsoft Foundry การอัปเกรดจากรุ่น 5.1 เริ่มได้ง่ายๆ ด้วยการเปลี่ยนชื่อโมเดลจาก claude-fable-5-1 เป็น claude-fable-5-2 แต่ก่อนจะสลับ ควรเช็กจุดที่อาจทำให้ระบบเดิมเกิดข้อผิดพลาดต่อไปนี้:
- thinking block เข้ากันได้เฉพาะรุ่นเดียวกัน: ข้อความส่วนการคิดวิเคราะห์ก่อนตอบอย่าง thinking block ของรุ่น 5.2 จะอ่านและส่งต่อได้เฉพาะระหว่าง Fable 5.2 กับ Mythos 5.2 เท่านั้น หากสลับไปใช้โมเดลรุ่นอื่นกลางคัน บริบทการคิดที่ประมวลผลไว้จะหายไปทันที
- การแก้ไขข้อความย้อนหลัง: ถ้าแก้ไขข้อความในรอบก่อนหน้า จะนำ thinking block เดิมมาใช้ต่อไม่ได้ และถ้าโค้ดฝั่งแอปพลิเคชันไม่ได้รองรับเคสนี้ไว้ ระบบจะตอบกลับเป็น error 400 ทันที แต่สำหรับผู้ใช้ Claude Code, claude.ai, Managed Agents หรือ Agent SDK ระบบจะจัดการให้อัตโนมัติโดยไม่ต้องแก้โค้ดเอง
- เครื่องมือควบคุมคอมพิวเตอร์เวอร์ชันเก่า: การเรียกใช้เครื่องมือ
computer_20251124ตัวเดิมจะได้ error 400 กลับมาบนทุกแพลตฟอร์ม ยกเว้น Amazon Bedrock ให้อัปเกรดไปใช้เวอร์ชันใหม่คือcomputer_toolset_20260801 - advisor tool รุ่นเบต้า: ถ้าให้ Fable 5.2 เป็นตัวลงมือทำงาน ตัวที่ทำหน้าที่ให้คำปรึกษาก็ต้องเป็น Fable 5.2 หรือ Mythos 5.2 เท่านั้น
นักพัฒนาอ่านขั้นตอนและรายละเอียดการอัปเกรดทั้งหมดได้ที่ Fable 5.2 migration guide
งานที่ Fable 5.2 ไม่รับ และพฤติกรรมของโมเดลที่ควรรู้
Fable 5.2 มีระบบคัดกรองความปลอดภัยที่บล็อกคำสั่งด้านความปลอดภัยไซเบอร์ที่เสี่ยงสูง รวมถึงงานวิจัยด้านชีววิทยาส่วนใหญ่ งานไซเบอร์ที่ถูกปฏิเสธ ได้แก่ การทดสอบเจาะระบบ การเขียนโค้ดเพื่อโจมตีช่องโหว่ และการวิเคราะห์หาช่องโหว่จากไฟล์ไบนารีของโปรแกรม ทั้งนี้ ถ้าคำขอโดนบล็อก ระบบจะให้โมเดลรุ่นอื่นตอบแทน คือ Opus 4.8 สำหรับงานด้านไซเบอร์ และ Opus 5 สำหรับงานวิจัยชีววิทยา
ถ้างานหลักขององค์กรคุณเกี่ยวข้องกับความปลอดภัยไซเบอร์ Anthropic เปิดให้สมัครเข้าร่วม Cyber Verification Program เพื่อขอสิทธิ์ใช้ Mythos 5.2 ส่วนงานวิจัยด้านชีววิทยายื่นสมัครได้ผ่าน Life Sciences Verification Program และถ้าอยากรู้เหตุผลว่าทำไมโมเดลตัวเดียวกันถึงต้องแยกเป็นสองชื่อ อ่านเพิ่มเติมได้ที่บทความ Claude Fable 5 กับ Mythos 5
นอกจากนี้ เอกสารสำหรับนักพัฒนายังเตือนถึงพฤติกรรมเฉพาะตัวของ Fable 5.2 ไว้อีก 2 ข้อ:
- หยุดทำงานก่อนทำเสร็จ: ในงานที่มีหลายขั้นตอนต่อเนื่องกัน บางครั้งโมเดลจะสรุปงานรอบนั้นด้วยการทำรายการสิ่งที่ต้องทำต่อ หรือเสนอตัวว่าจะช่วยทำขั้นตอนต่อไปให้ แทนที่จะลงมือทำให้เสร็จทั้งหมดในคราวเดียว อาการนี้มักเกิดขึ้นบ่อยขึ้นเมื่อตั้งค่า effort ไว้ที่ระดับ Low และ Medium
- ไม่กล้าแก้โค้ดรอบข้างโดยพลการ: ในการทดสอบของ Anthropic กับงานโค้ดขนาดเล็ก ถ้าไม่ได้บอกในพรอมต์ให้ชัดว่าโค้ดเป็นของใคร โมเดลมีแนวโน้มจะเขียนโค้ดต่อเติมจากของเดิม และทำเพียงแจ้งจุดผิดพลาดใกล้เคียงที่พบ แทนที่จะลงมือแก้ให้ทันที ทางแก้ที่เอกสารแนะนำคือบอกให้ชัดในคำสั่งว่าโค้ดเป็นของเรา เช่น
โค้ดในโปรเจกต์นี้เป็นของเรา หากเจอปัญหาหรือจุดผิดพลาดในส่วนที่เกี่ยวข้องให้ช่วยแก้ไขได้เลย
ใช้สัปดาห์โปรทดสอบกับงานจริงของตัวเอง
สำหรับผู้ใช้งานแผน Pro หรือผู้ใช้ที่นั่ง standard ในแผน Team วิธีใช้ประโยชน์จากสัปดาห์โปรโมชันนี้ให้คุ้มค่าที่สุด คือเอางานจริงที่คุณเคยสั่งให้ Fable 5.1 หรือ Opus 5.5 ทำ มาลองซ้ำกับ Fable 5.2 โดยเริ่มที่ระดับ Medium ก่อน แล้วค่อยลองขยับเป็นระดับ High กับงานชิ้นเดียวกันเพื่อดูความแตกต่าง
ระหว่างนั้นควรสังเกต 2 เรื่องไปพร้อมกัน คือผลลัพธ์ของงานดีขึ้นจริงไหม และโควตาลดลงเร็วแค่ไหน เพราะคะแนนทดสอบบนตารางของคนอื่นเป็นเพียงค่าเฉลี่ยจากชุดโจทย์ที่เขากำหนดเอง มีแต่งานจริงของคุณเท่านั้นที่จะบอกได้ว่าระดับการคิดแค่ไหนถึงจะพอดีและคุ้มที่สุด
การเลือกระดับ effort ในแต่ละครั้ง จึงเปรียบเสมือนการกำหนดงบประมาณและเวลาให้กับงานชิ้นนั้นไปในตัว
ที่มา:
- เอกสารทางการของ Claude Fable 5.2
- บทความ What's new in Claude Fable 5.2 จาก Claude Platform Docs
- บทความ Claude Fable 5.2 launch offers จาก Claude Help Center
- บทความ Claude Fable 5.2 (max) - Intelligence, Performance & Price Analysis จาก Artificial Analysis
- บทความ LLM Leaderboard จาก Artificial Analysis
- บทความ r/ClaudeAI thread on Fable 5.2 cost per task จาก r/ClaudeAI
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin