Claude Sonnet 5.5 ราคาต่อ token เท่า Sonnet 5 แต่ Anthropic บอกว่าค่าใช้จ่ายต่องานถูกลงได้ถึง 30%
Claude Sonnet 5.5 ทำงานเดิมโดยใช้ token น้อยลง ค่าใช้จ่ายต่องานจึงลดลงทั้งที่ราคาต่อหน่วยเท่าเดิม ดูวิธีเลือกว่างานไหนใช้ Sonnet และงานไหนควรใช้ Opus 5.5
Anthropic เปิดตัว Claude Sonnet 5.5 โมเดล AI รุ่นใหม่ล่าสุด โดยตั้งราคาต่อ token ไว้เท่ากับรุ่นก่อนหน้าอย่าง Sonnet 5 แต่ผลการทดสอบของ Anthropic ชี้ว่าค่าใช้จ่ายจริงในการทำงานแต่ละชิ้นกลับลดลงได้สูงสุดถึง 30% แถมยังตอบเร็วขึ้นกว่าเดิมเกิน 30% อีกด้วย
ค่าใช้จ่ายที่ถูกลงไม่ได้มาจากการลดราคา แต่มาจากการที่ Sonnet 5.5 ทำงานชิ้นเดิมจนเสร็จโดยใช้ token น้อยลง
Sonnet 5.5 เป็นโมเดลลำดับที่สองในตระกูล Claude 5.5 ถัดจาก Claude Opus 5.5 ซึ่งออกแบบมาสำหรับงานที่ซับซ้อนสูงและต้องอาศัยการคิดตัดสินใจอย่างรอบคอบ ที่น่าสนใจคือ ในการทดสอบเขียนโค้ดบางชุด คะแนนของ Sonnet 5.5 ขยับขึ้นมาใกล้เคียงกับ Opus 5.5 มาก ทั้งที่ Opus มีราคาต่อ token แพงกว่าถึงเท่าตัว สำหรับคนที่ใช้งาน Claude ในชีวิตประจำวัน ข่าวนี้จึงไม่ใช่แค่เรื่องการประหยัดค่าใช้จ่าย แต่เป็นเรื่องการเลือกใช้งานให้ถูกทาง นั่นคือต้องรู้ว่างานแบบไหนเริ่มที่ Sonnet ได้เลย และงานแบบไหนที่ยังคุ้มค่าพอจะส่งให้ Opus จัดการ
ราคาต่อ token เท่าเดิม แต่ค่าใช้จ่ายต่องานลดลง
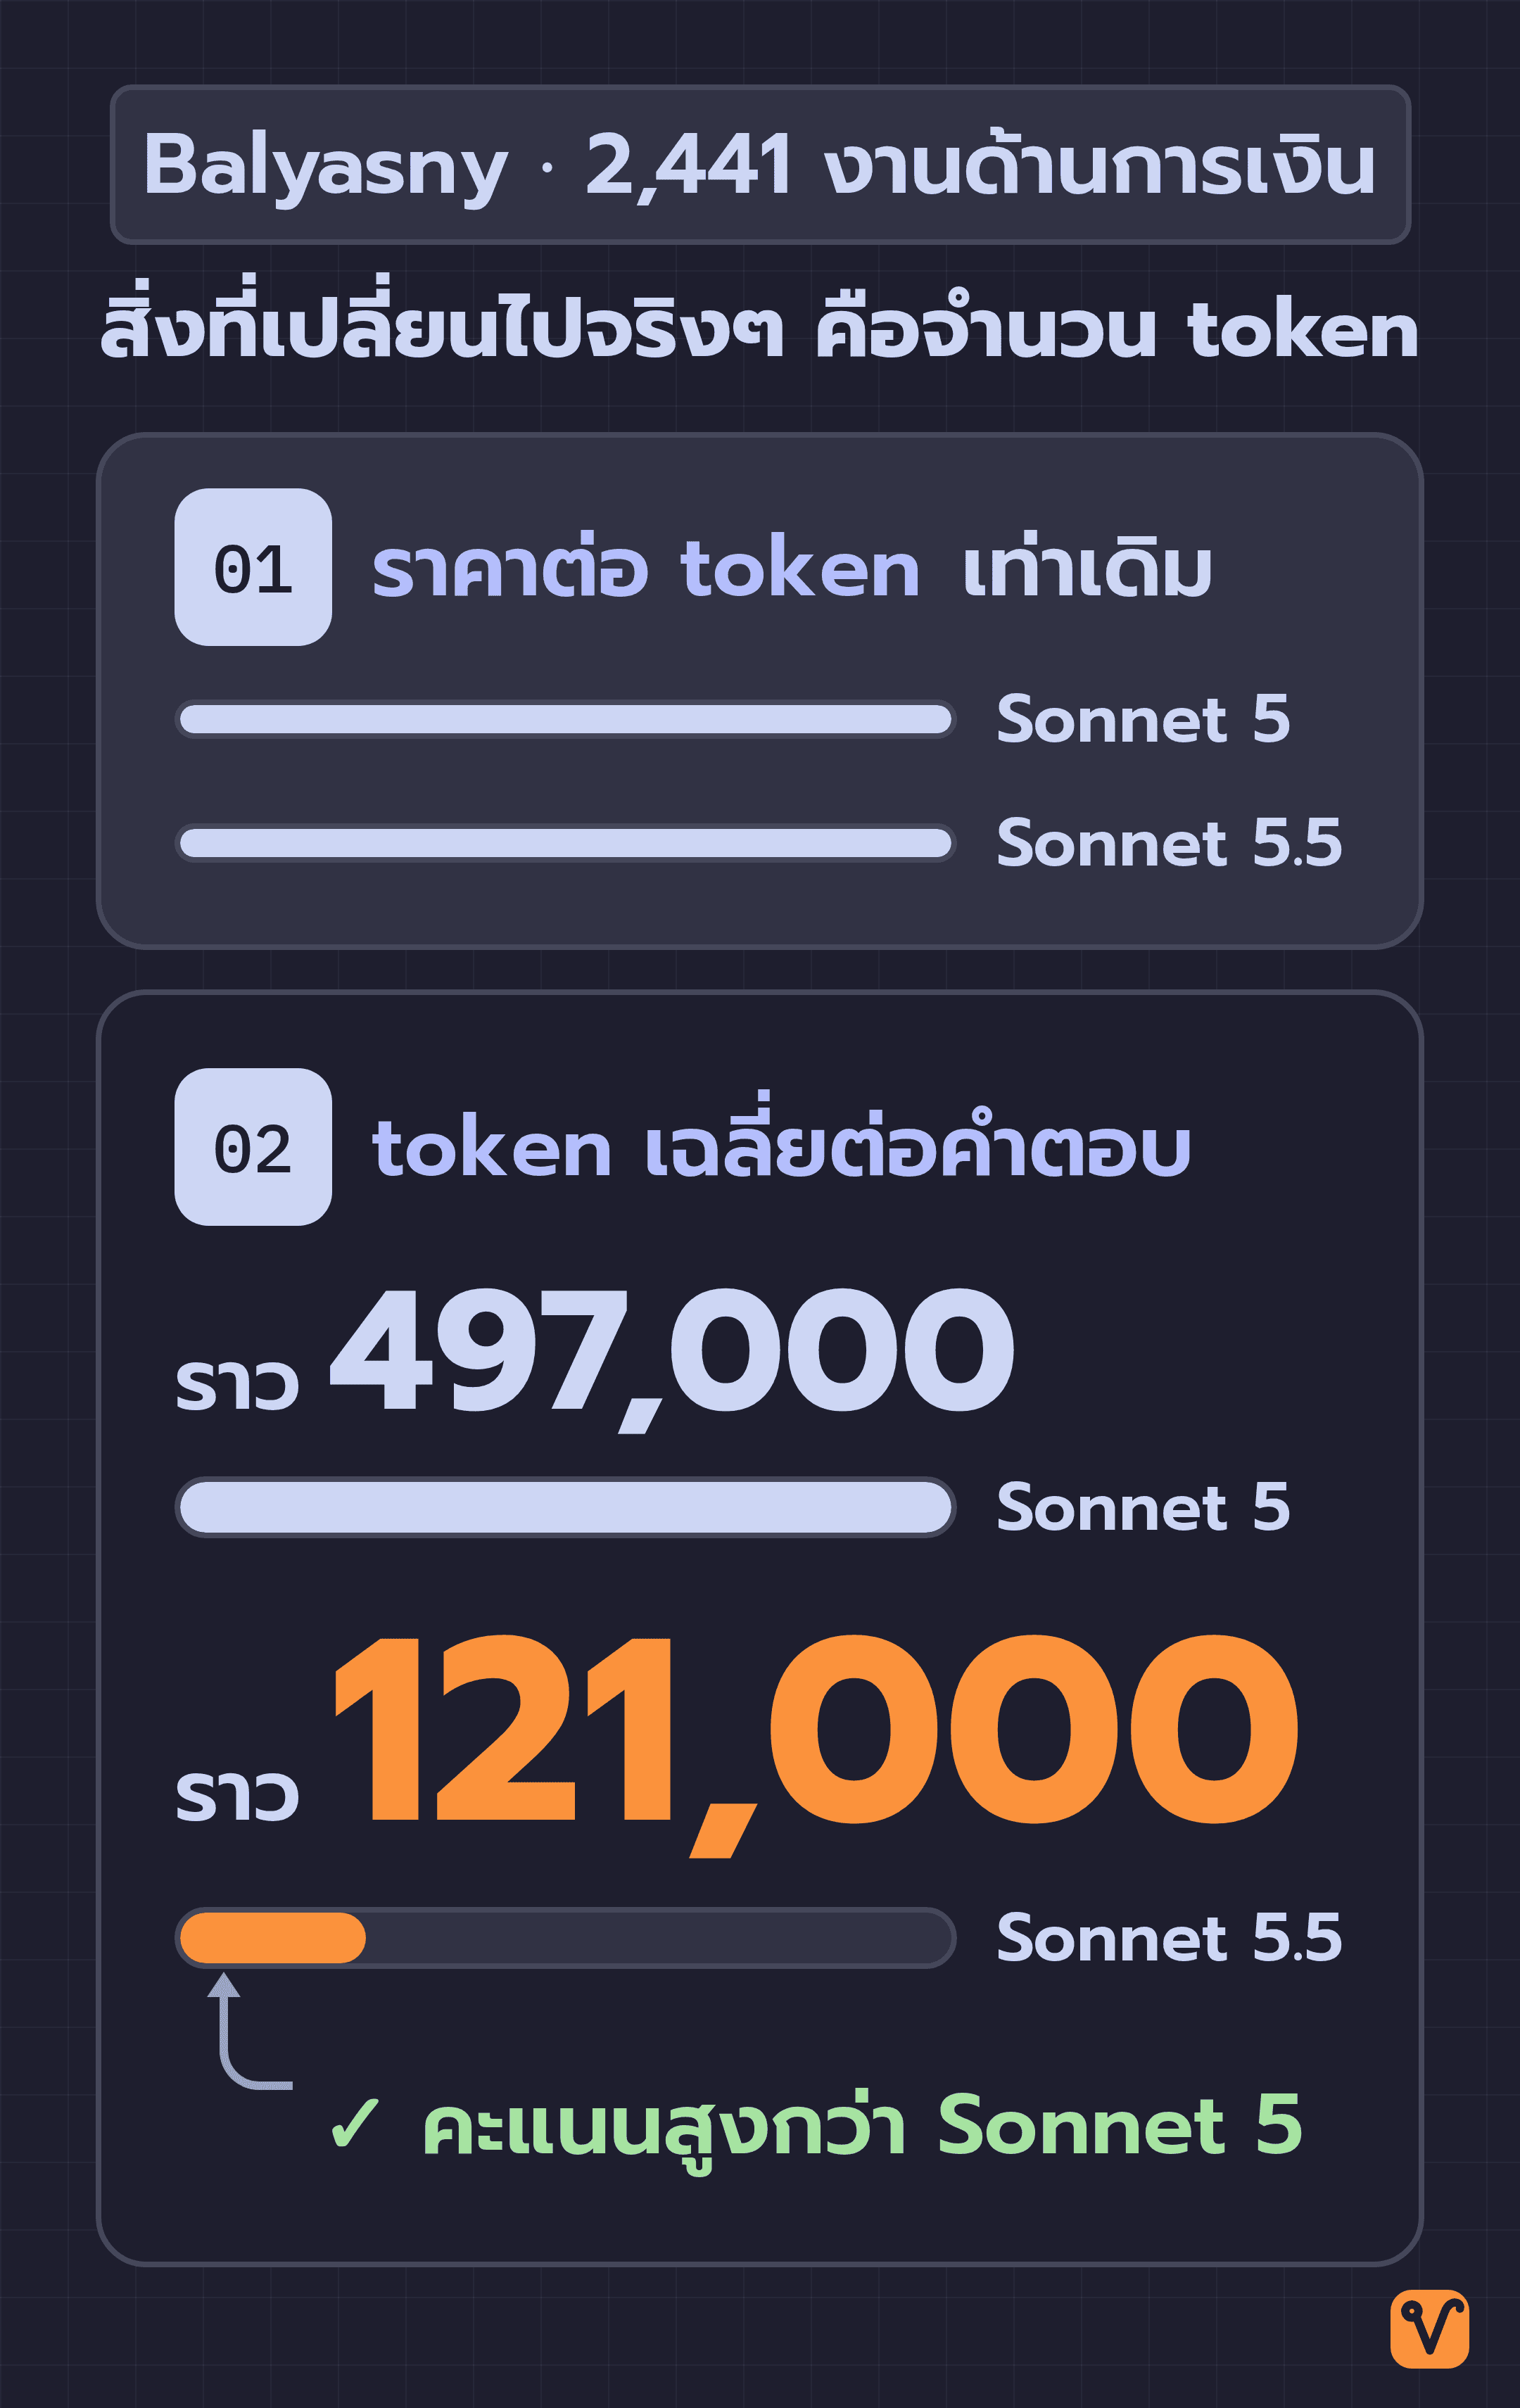
ค่าใช้จ่ายในการทำงานแต่ละชิ้น คำนวณจากตัวเลขสองส่วนคูณกัน คือ "ราคาต่อ token" กับ "จำนวน token ที่โมเดลใช้จนงานเสร็จ"
ในด้านราคา Sonnet 5.5 ยังคงคิดราคาเท่ากับ Sonnet 5 ทั้งค่า input หรือข้อความขาเข้าที่ $2 ต่อ 1 ล้าน token และค่า output หรือข้อความตอบกลับที่ $10 ต่อ 1 ล้าน token ส่วนค่าอ่านแคชก็อยู่ที่ $0.20 เท่าเดิม เมื่อนำมาเทียบกับ Opus 5.5 จะเห็นความแตกต่างดังนี้:
| ราคาต่อล้าน token | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| input (ข้อความที่ส่งเข้าไป) | $2 | $4 |
| output (ข้อความที่โมเดลเขียนตอบ) | $10 | $20 |
| เขียนลง cache | $2.50 | $5 |
| อ่านจาก cache | $0.20 | $0.20 |
Opus 5.5 คิดราคาแพงกว่าเท่าตัวในแทบทุกรายการ ยกเว้นเพียงค่าอ่านแคชที่ราคาเท่ากัน
สิ่งที่เปลี่ยนไปจริงๆ คือจำนวน token ที่ใช้ในแต่ละงาน กลุ่มผู้ทดสอบช่วงแรกสังเกตว่า Sonnet 5.5 มักจะรวบคำสั่งเรียกใช้เครื่องมือภายนอกอย่าง tool call หลายรายการ เช่น การอ่านไฟล์หรือการรันคำสั่ง ไว้ในรอบเดียวได้บ่อยกว่า Sonnet 5 งานจึงเสร็จด้วยขั้นตอนที่น้อยลง ทำให้ค่าใช้จ่ายลดลงตามไปด้วย
ตัวอย่างที่เห็นภาพชัดเจนที่สุดมาจาก Balyasny Asset Management บริษัทบริหารสินทรัพย์ที่นำโมเดลไปทดสอบกับงานด้านการเงินจริงถึง 2,441 งาน ครอบคลุมตั้งแต่การถามตอบ ดึงข้อมูล วิเคราะห์ ไปจนถึงพยากรณ์ ผลปรากฏว่า Sonnet 5.5 ทำคะแนนได้สูงกว่า Sonnet 5 แต่ใช้ token เฉลี่ยเพียงราว 121,000 token ต่อคำตอบ ขณะที่ Sonnet 5 ต้องใช้ถึงราว 497,000 token แม้ตัวเลขนี้จะมาจากการทดสอบเฉพาะของบริษัทเดียว และไม่ได้รับประกันว่างานรูปแบบอื่นจะประหยัดได้เท่านี้ แต่ก็แสดงให้เห็นชัดเจนถึงประสิทธิภาพในการประหยัด token
จุดหนึ่งที่อาจทำให้สับสน คือในประกาศของ Anthropic มีตัวเลข 30% อยู่สองตัว ตัวแรกคือค่าใช้จ่ายต่องานที่ลดลงได้ถึง 30% ส่วนตัวที่สองคือความเร็วในการเขียนคำตอบที่เพิ่มขึ้นเกิน 30% ตัวเลขทั้งสองไม่ใช่ส่วนลดในตารางราคา และคำว่า "ได้ถึง 30%" ก็ระบุชัดเจนว่าเป็นเพดานสูงสุด ไม่ใช่ว่าทุกงานจะได้ส่วนลดเท่ากันหมด
Sonnet 5.5 ไล่ทัน Opus 5.5 ในบางชุดทดสอบ
งานเขียนโค้ดคือจุดที่ Sonnet 5.5 ทิ้งห่างจากรุ่นก่อนหน้าชัดเป็นพิเศษ โดยตารางด้านล่างนี้อ้างอิงจาก Benchmark ชุดทดสอบมาตรฐานที่ใช้ประเมินความสามารถของโมเดล ตามที่ Anthropic รายงานไว้:
| ชุดทดสอบ | Sonnet 5 | Sonnet 5.5 | Opus 5.5 |
|---|---|---|---|
| Terminal-Bench 4.0 (งานหลายขั้นตอนผ่านหน้าจอพิมพ์คำสั่ง) | 10.3% | 70.6% | 66.4% |
| CursorBench 4.0 (งานจริงจากโปรแกรมเขียนโค้ด Cursor) | 34.1% | 55.5% | 57.8% |
| FrontierCode 1.1 (แก้โค้ดจนนำไปรวมในโปรเจกต์ได้โดยคนไม่ต้องแก้ต่อ) | 42.4% | 52.1% | 54.4% |
| GDPval-AA v2.1 (งานจริงจาก 44 อาชีพ หน่วยเป็นแต้ม) | 1449 | 1844 | 1846 |
คะแนน Opus 5.5 ใน Terminal-Bench เป็นคะแนนสูงสุดที่ Opus ทำได้ในชุดนั้น
จากตารางนี้ Terminal-Bench คือชุดที่มีการเปลี่ยนแปลงมากที่สุด คะแนนพุ่งจาก 10.3% ขึ้นไปถึง 70.6% จนแซงหน้า Opus 5.5 ได้ด้วย ส่วน CursorBench ที่จำลองงานเขียนโค้ดจากการใช้งานจริง คะแนนที่ดีที่สุดของ Sonnet 5.5 ก็ตามหลัง Opus 5.5 เพียงราวสองคะแนน นอกจากนี้ ในชุดทดสอบทั่วไปอย่าง GDPval-AA ที่นำงานจริงจาก 9 อุตสาหกรรมหลักมาประเมิน ทั้งสองโมเดลก็ทำคะแนนได้แทบจะเสมอกัน
แต่ในประกาศเดียวกัน Anthropic ระบุไว้ชัดเจนว่า คะแนน Benchmark สะท้อนความสามารถของโมเดลได้เพียงด้านเดียว ผลการทดสอบจากทั้ง Anthropic เองและผู้ใช้งานภายนอกยังชี้ตรงกันว่า Opus 5.5 ยังคงเหนือกว่าอย่างเห็นได้ชัดในงานปลายเปิดที่ซับซ้อนสูง และต้องตัดสินใจอย่างต่อเนื่อง ดังนั้น คะแนนทดสอบที่ใกล้เคียงกันจึงบอกแค่ว่า Sonnet 5.5 ทำข้อสอบมาตรฐานเหล่านี้ได้ดีขึ้นมาก แต่ไม่ได้แปลว่าจะนำมาใช้แทน Opus 5.5 ได้ในทุกงาน
ระดับ Effort คุมทั้งคะแนนและค่าใช้จ่าย
อีกหนึ่งตัวแปรสำคัญที่กำหนดค่าใช้จ่ายของ Sonnet 5.5 คือระดับ effort ที่กำหนดว่าโมเดลจะใช้เวลาคิดทบทวนมากน้อยแค่ไหน โดยมีให้เลือก 5 ขั้น ได้แก่ Low, Medium, High, Xhigh และ Max ถ้าตั้งไว้ระดับต่ำ Claude จะตอบเร็วและใช้ token น้อย เหมาะกับงานประจำทั่วไป แต่ถ้าตั้งไว้ระดับสูง โมเดลจะใช้เวลาคิดนานขึ้นและตรวจทานงานตัวเองอย่างละเอียดขึ้น แม้ต้นทุนต่องานจะสูงขึ้นตาม แต่คุณภาพของงานก็มักจะดีขึ้นเช่นกัน
ค่าเริ่มต้นของ effort จะขึ้นอยู่กับช่องทางที่คุณใช้งาน ถ้าใช้ผ่าน Claude Code เครื่องมือช่วยเขียนโค้ดของ Anthropic หรือผ่านแอป Claude ทั่วไป ระบบจะตั้งค่าเริ่มต้นไว้ที่ระดับ Medium แต่สำหรับนักพัฒนาที่เรียกใช้ผ่าน Claude Platform ทาง API ระบบจะเริ่มต้นที่ระดับ High ซึ่งสูงกว่าหนึ่งขั้น ถ้าไม่ได้เข้าไปตั้งค่าเอง งานประจำทั่วไปที่ส่งผ่าน API ก็อาจทำให้คุณจ่ายเงินเกินความจำเป็นโดยไม่รู้ตัว ทั้งนี้ Anthropic ได้จัดทำ คู่มือเลือกระดับ effort เพื่อแนะนำวิธีเลือกให้เหมาะกับแต่ละลักษณะงานไว้แล้ว
จุดเด่นของ Sonnet 5.5 ที่ต่างจากรุ่นก่อน คือไม่จำเป็นต้องตั้งค่า effort ไว้สูงก็ทำคะแนนได้ดี ในชุดทดสอบหลายตัว Sonnet 5.5 ที่ตั้งไว้เพียง Low หรือ Medium ก็ทำคะแนนแซงหน้าคะแนนที่ดีที่สุดของ Sonnet 5 ได้แล้ว ด้วยต้นทุนต่องานเพียงราว 1 ใน 10 ของที่ Sonnet 5 ต้องใช้เพื่อให้ได้คะแนนระดับนั้น
ตัวอย่างที่เห็นภาพชัดที่สุดคือ Terminal-Bench ในชุดนี้ เมื่อตั้งไว้ที่ระดับ Medium ซึ่งเป็นค่าเริ่มต้นในแอป Claude อยู่แล้ว Sonnet 5.5 ทำคะแนนทิ้งห่างคะแนนที่ดีที่สุดของ Sonnet 5 ไปไกล ด้วยต้นทุนต่องานที่ไม่ถึง 1 ใน 10 (ตัวเลข 1 ใน 10 นี้ไม่ได้ขัดกับตัวเลขที่ลดลง 30% ข้างต้น เพราะเป็นการเปรียบเทียบคนละคู่ กรณีนี้คือการนำ Sonnet 5.5 ที่ตั้งไว้ระดับต่ำ ไปเทียบกับ Sonnet 5 ในจุดที่ทำคะแนนได้สูงสุด)
ตรงนี้เป็นจุดที่พลาดง่าย เพราะชื่อ "Max" ชวนให้คิดว่าจะได้งานที่ดีที่สุดเสมอ แต่ในชุดทดสอบ FrontierCode คะแนน 52.1% ในตารางด้านบนมาจากระดับ Xhigh ส่วนระดับ Max กลับได้คะแนนเพียง 46.2% เท่านั้น
Anthropic อธิบายว่า เมื่อตั้งเป็นระดับ Max โมเดลจะเรียกใช้ฟีเจอร์รีวิวโค้ดของ Claude Code บ่อยขึ้น ซึ่งฟีเจอร์นี้จะแตกงานรีวิวออกไปยัง sub-agent หลายตัว ในสองกรณีที่ Cognition เข้าไปตรวจดู การแตกงานย่อยทำให้ประมวลผลนานจนหมดเวลา หรือไม่ก็เข้าไปแก้ไขโค้ดเกินขอบเขตที่สั่ง โดยเกณฑ์ของ FrontierCode จะหักคะแนนทันทีถ้ามีการแก้ไขเกินขอบเขต แม้การแก้นั้นจะทำได้ดีก็ตาม ระดับ effort ที่สูงขึ้นจึงหมายถึงโมเดล "ลงมือทำมากขึ้น" แต่ไม่ได้แปลว่าจะ "ตรงโจทย์ที่สั่งมากขึ้น" เสมอไป
อีกเรื่องที่ต้องรู้ก่อนจะเร่งระดับ effort ขึ้นไป คือ Anthropic ระบุว่า Sonnet 5.5 จะทำหน้าที่เสริม Opus 5.5 ได้คุ้มค่าที่สุดเมื่อตั้งค่าไว้ระดับต่ำ เพราะยังมีต้นทุนต่องานที่ถูกกว่ามาก แต่ถ้าตั้งไว้ระดับสูง แม้คะแนนอาจจะขึ้นไปเทียบเคียงกับ Opus ได้ แต่ต้นทุนต่องานก็จะพุ่งสูงตามขึ้นมาด้วย ถ้างานไหนต้องดัน Sonnet ไปจนสุดทุกครั้ง จุดเด่นเรื่องความคุ้มค่าด้านราคาก็แทบจะไม่เหลือ
งานไหนควรเริ่มที่ Sonnet 5.5 งานไหนยังต้องใช้ Opus 5.5
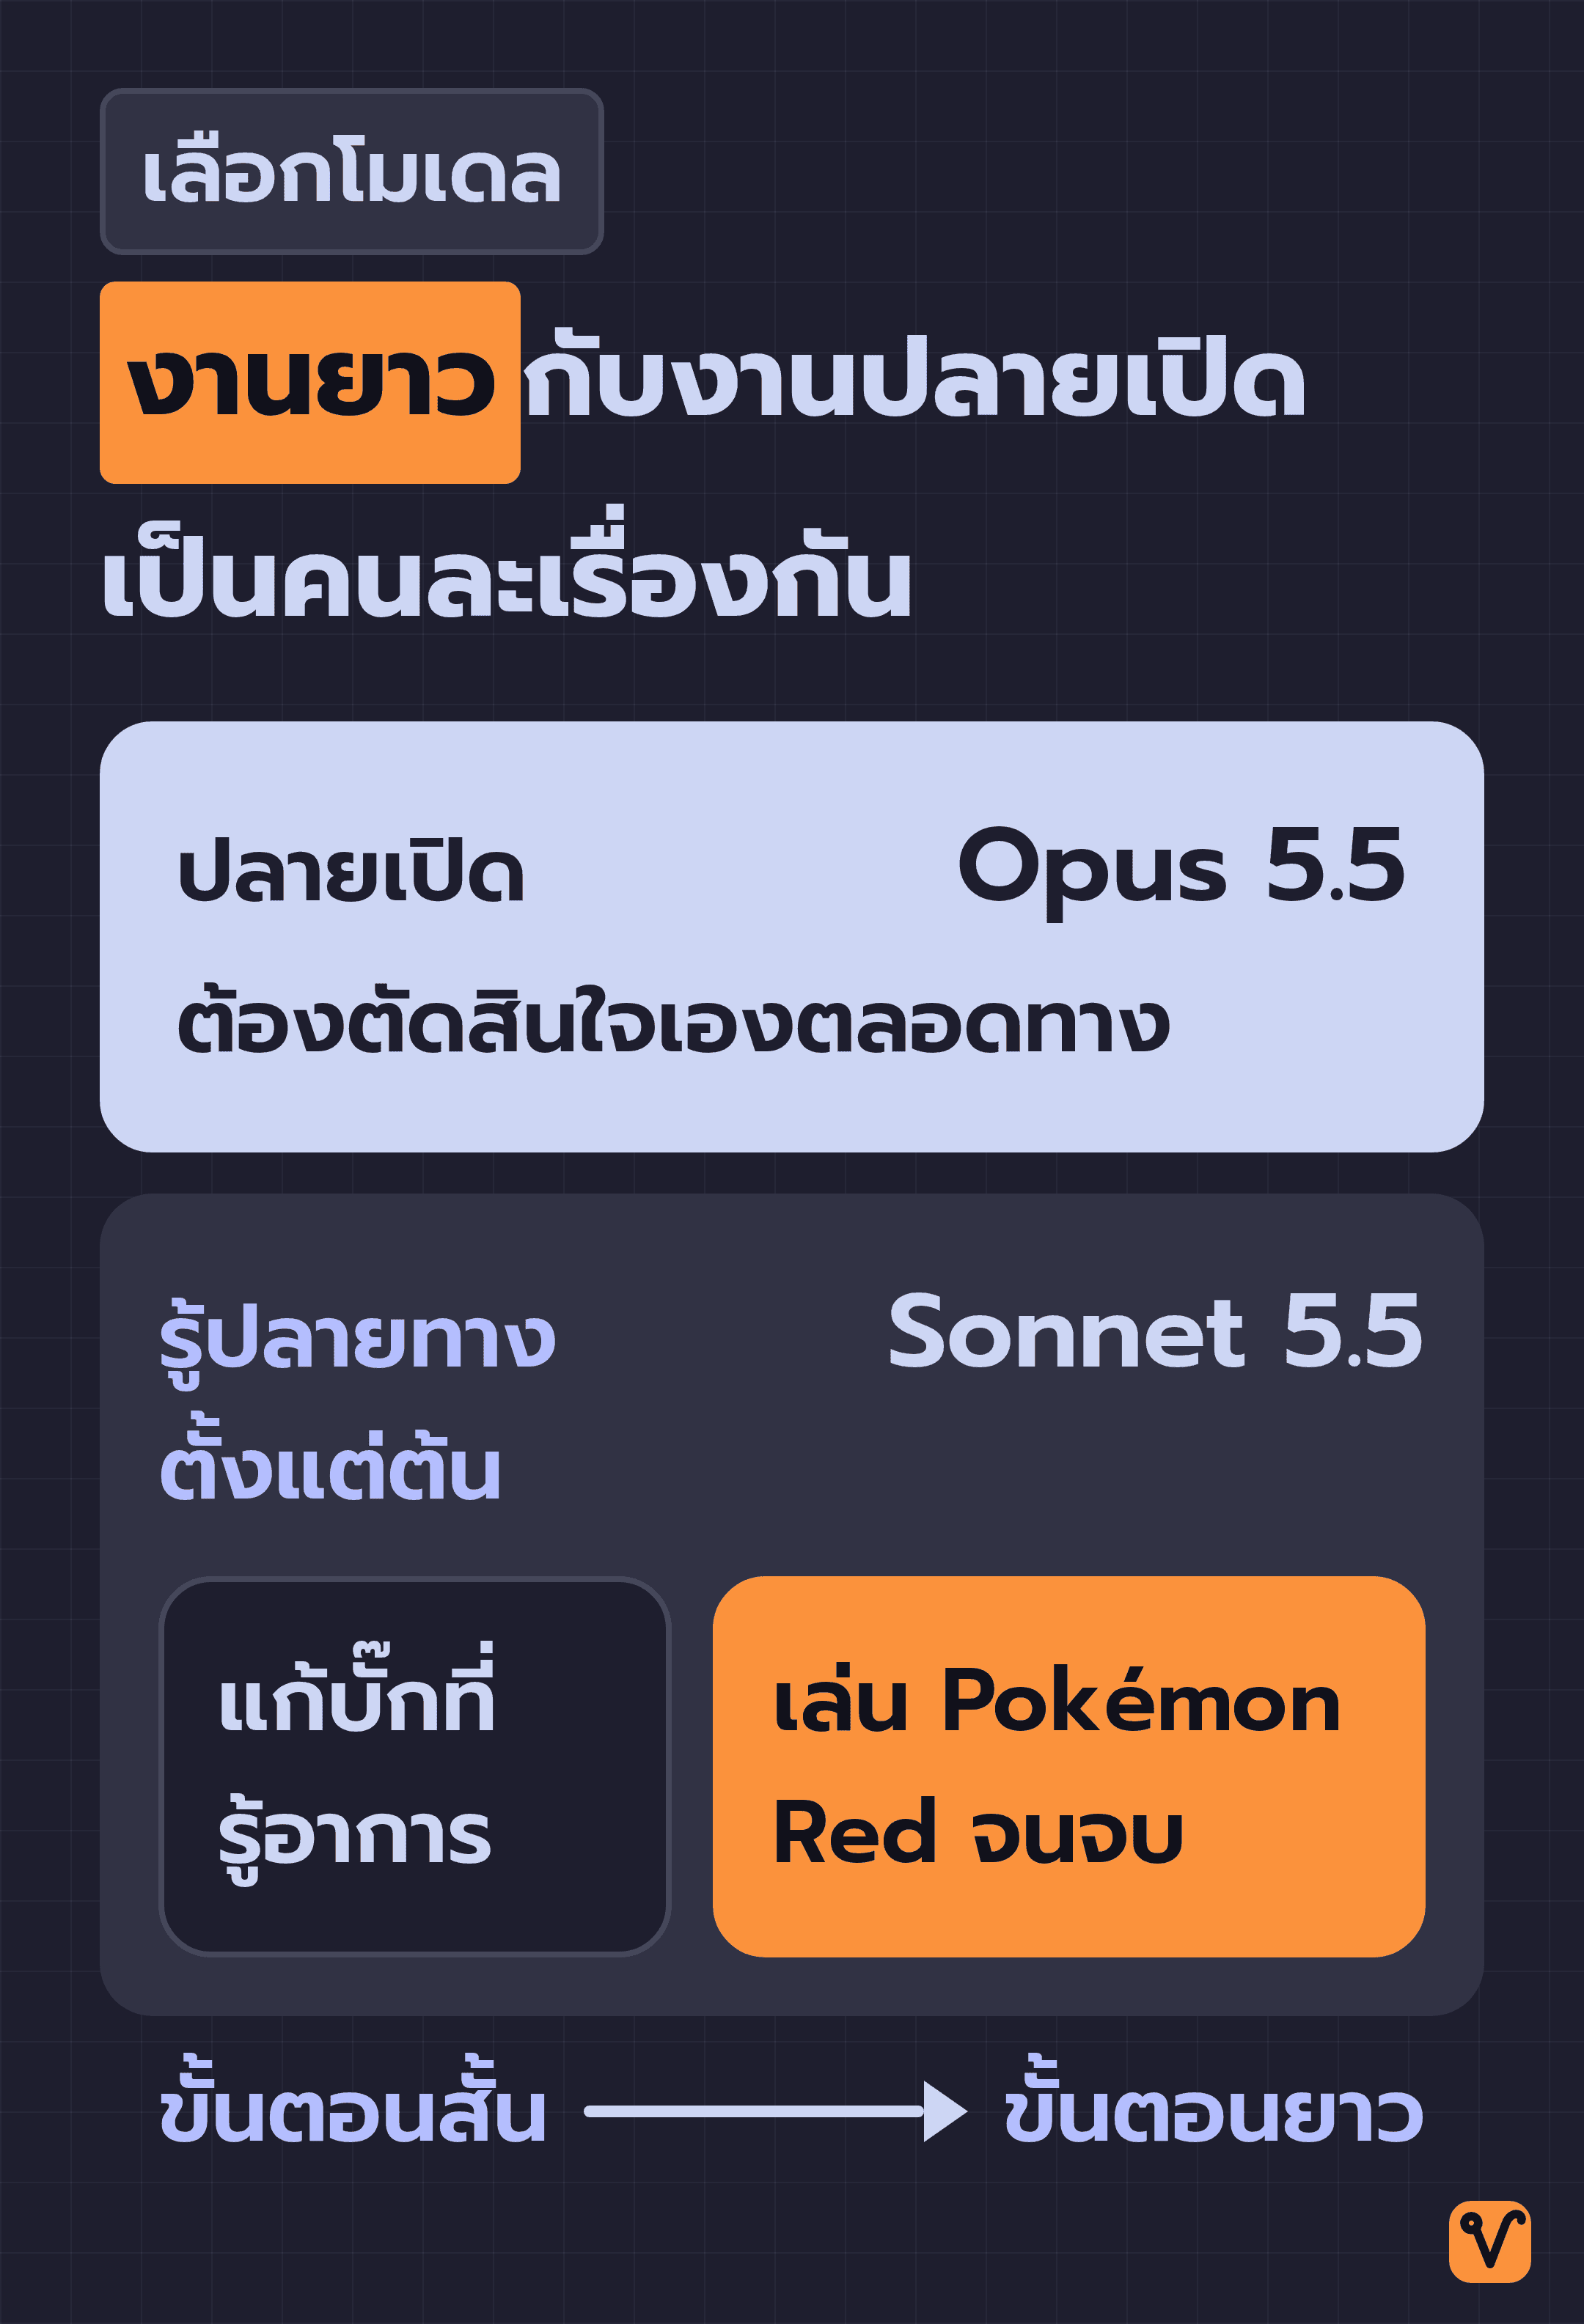
Anthropic แบ่งบทบาทของโมเดลทั้งสองตัวนี้ไว้อย่างชัดเจน โดย Sonnet 5.5 จะเก่งที่สุดกับงานประจำวันที่มีขอบเขตชัดเจน งานแก้บั๊ก และงานทำเอกสาร สไลด์นำเสนอ หรือสเปรดชีตที่ต้องออกมาเรียบร้อย ส่วน Opus 5.5 ออกแบบมาเพื่องานซับซ้อนที่ต้องอาศัยการคิดวิเคราะห์และใช้วิจารณญาณอย่างรอบคอบ
งานทดสอบภายในของ Anthropic ชิ้นหนึ่งช่วยให้เราเห็นภาพคำว่า "งานที่มีขอบเขตชัดเจน" ได้อย่างดี ทีมงานได้ป้อนเอกสารรายงานผลประกอบการรายไตรมาสของบริษัทมหาชนแห่งหนึ่ง พร้อมบันทึกการประชุมแถลงผลงาน และเทมเพลตสไลด์ ให้ Sonnet 5.5 ทำสไลด์สรุปผลการดำเนินงาน 10 หน้า ผลคือผู้เชี่ยวชาญ 2 คนลงความเห็นว่า สไลด์ดราฟต์แรกที่ได้สามารถนำไปส่งต่อได้ทันทีโดยไม่ต้องแก้ไขอะไรเพิ่ม
สังเกตได้ว่างานลักษณะนี้มีข้อมูลพร้อมตั้งแต่ก่อนเริ่ม เทมเพลตกำหนดหน้าตาไว้แล้ว และระบุจำนวนหน้าไว้อย่างชัดเจน ปลายทางของงานจึงเป็นสิ่งที่รู้ล่วงหน้าได้ตั้งแต่ต้น
จุดที่มักจะสับสนกันคือ "งานที่มีขั้นตอนยาว" กับ "งานปลายเปิด" นั้นไม่ใช่สิ่งเดียวกัน Sonnet 5.5 ทำงานยาวๆ ได้ดี และเป็นโมเดลตระกูล Sonnet ตัวแรกที่เล่นเกม Pokémon Red จนจบได้จากการดูเพียงภาพหน้าจอ แต่สิ่งที่ Opus 5.5 ยังคงเหนือกว่า คือโจทย์ปลายเปิดที่ตัวโมเดลต้องประเมินและตัดสินใจด้วยตัวเองไปตลอดกระบวนการ โดยที่ยังไม่มีใครกำหนดไว้ว่าผลลัพธ์สุดท้ายหน้าตาต้องออกมาเป็นแบบไหน
นักพัฒนาสายงานครีเอทีฟคนหนึ่งที่ได้ร่วมทดสอบ เล่าถึงแนวทางการใช้งานโมเดลทั้งสองตัวร่วมกันว่า ถ้าให้ Opus 5.5 วางสถาปัตยกรรมและกรอบใหญ่ของเกมไว้ให้เรียบร้อยแล้ว ก็มั่นใจที่จะให้ Sonnet 5.5 ลงมือเขียนโค้ดตามกรอบนั้นต่อ
ดังนั้น ในการใช้งานจริงจึงมีตัวเลือกให้ปรับ 2 ส่วน คือการเลือกโมเดลและการตั้งระดับ effort โดย ทั้งสองตัวเลือกนี้ทำงานคนละอย่าง หากสรุปเป็นแนวทางที่นำไปใช้ได้ทันที เราแนะนำดังนี้:
- เริ่มที่ Sonnet 5.5 ระดับ Medium: สำหรับงานที่รู้เป้าหมายและผลลัพธ์สุดท้ายชัดเจน เช่น การแก้บั๊กที่รู้อาการ การทำสไลด์ตามเทมเพลต หรือจัดเอกสารตามรูปแบบที่กำหนด วิธีนี้ทั้งประหยัดและรวดเร็วที่สุด ถ้าผลลัพธ์ยังไม่น่าพอใจ ค่อยปรับระดับ effort ขึ้นทีละขั้น
- ส่งต่อให้ Opus 5.5: สำหรับงานที่ต้องคิดวางแผนก่อนว่าควรทำอะไร และต้องอาศัยการตัดสินใจอย่างต่อเนื่องตลอดทาง แม้จะต้องแลกกับราคาต่อ token ที่แพงกว่าเท่าตัวก็ตาม
- ให้ Opus วางกรอบ แล้วให้ Sonnet ลงมือทำ: สำหรับโปรเจกต์ขนาดใหญ่ที่แยกขั้นตอนการคิดออกจากขั้นตอนการลงมือทำได้ เพื่อให้จ่ายค่า Opus เฉพาะส่วนที่ต้องใช้วิจารณญาณระดับสูงจริงๆ
ส่วนงานปริมาณมหาศาลที่เน้นต้นทุนต่อชิ้นให้ถูกที่สุดเป็นหลัก Anthropic แจ้งว่า Haiku 5.5 จะเปิดตัวตามมาในอีกไม่กี่สัปดาห์
ข้อควรรู้ก่อนย้ายงานมา Sonnet 5.5
ปัจจุบัน Sonnet 5.5 เปิดให้ใช้งานแล้วบนทุกแพลตฟอร์มหลัก รวมถึง Amazon Web Services, Google Cloud และ Microsoft Azure โดยนักพัฒนาสามารถเรียกใช้ผ่าน Claude Platform ด้วยชื่อโมเดล claude-sonnet-5-5 และเลือกใช้นโยบายไม่เก็บข้อมูลอย่าง Zero Data Retention ได้เช่นเดียวกับ Opus 5.5 อย่างไรก็ตาม ก่อนจะเริ่มย้ายระบบ มี 3 เรื่องสำคัญที่ควรตรวจสอบ:
เรื่องแรก สำหรับผู้ที่ปิดฟีเจอร์ thinking ที่โมเดลใช้คิดวิเคราะห์ก่อนตอบเอาไว้ จะต้องเปลี่ยนไปใช้ค่าใหม่ที่มีชื่อว่า between_tools ก่อนจะย้ายมาใช้ Sonnet 5.5 ค่านี้ยังคงปิดการคิดล่วงหน้าไว้เช่นเดิม ดูขั้นตอนได้จาก คู่มือย้ายรุ่น
เรื่องที่สอง คืองานด้านความปลอดภัยทางไซเบอร์ เนื่องจากความสามารถด้านนี้ของ Sonnet 5.5 พัฒนาขึ้นจากรุ่นก่อนหน้ามาก Anthropic จึงใช้ระบบป้องกันคล้ายกับที่ใช้กับ Opus 5.5 ถ้าเป็นงานที่มีความเสี่ยงสูง ระบบจะสลับกลับไปให้ Sonnet 5 ตอบแทน ซึ่งจะเห็นการสลับนี้ได้อย่างชัดเจน ส่วนการหาและแก้บั๊กในโค้ดตามงานพัฒนาซอฟต์แวร์ปกติยังทำได้เหมือนเดิม
เรื่องที่สาม คือระบบบัญชีผู้ใช้ Sonnet 5.5 ขยายระบบ preserved thinking ที่ผูกกระบวนการคิดของ Claude เข้ากับบัญชีผู้ใช้ที่สร้างเซสชันนั้นขึ้นมา นักพัฒนาส่วนใหญ่จะไม่เห็นความแตกต่าง ยกเว้นคนที่ต้องย้ายประวัติบทสนทนาข้ามบัญชี หรือสลับบัญชีระหว่างทำงานใน Claude Code ซึ่งควรเข้าไปศึกษาเอกสารนี้ล่วงหน้า
"ส่วนลด" ของ Sonnet 5.5 ไม่ได้อยู่ในตารางราคา แต่อยู่ที่ว่าคุณบอกได้ชัดแค่ไหนว่างานเสร็จแล้วต้องออกมาหน้าตาแบบไหน
ที่มา: เอกสารทางการของ Claude Sonnet 5.5
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin