Claude Opus 5.5 ทำงานส่วนใหญ่ได้ระดับ Fable 5.1 แต่ต้นทุนถูกกว่า Opus 5 ราว 40% ตามที่ Anthropic บอก
Claude Opus 5.5 ลดราคาต่อ token ลง 20% และสร้างข้อความเร็วขึ้นกว่า 30% ส่วนควรย้ายมาใช้เลยไหม ขึ้นอยู่กับว่าตอนนี้คุณใช้ Opus 5 หรือ Fable 5.1 อยู่
เวลาจะเลือกใช้ระบบปัญญาประดิษฐ์อย่าง Claude กับโปรเจกต์ขนาดใหญ่ ปัญหาที่มักเจอตลอดคือความลังเลว่าจะเลือกโมเดลตัวไหนดี ระหว่างเลือกโมเดลตัวท็อปที่ฉลาดที่สุด แต่ต้องจ่ายแพงและโควตาหมดไว หรือเลือกตัวที่ประหยัดกว่า แต่ก็ต้องมาลุ้นว่าผลงานจะออกมาดีพอไหม
ล่าสุดเมื่อวันที่ 22 กันยายน 2026 Anthropic ได้เปิดตัว Claude Opus 5.5 และตัวเลขในประกาศก็เข้ามาตอบโจทย์ช่องว่างนี้พอดี ทางผู้พัฒนาระบุว่า Opus 5.5 สามารถทำงานส่วนใหญ่ได้เทียบเท่ากับ Claude Fable 5.1 โมเดลรุ่นท็อปที่ราคาแพงกว่า ขณะที่ต้นทุนการรันก็ถูกกว่า Opus 5 รุ่นก่อนหน้าราว 40% Opus 5.5 เป็นโมเดลตัวแรกในตระกูล Claude 5.5 ส่วนรุ่น Sonnet 5.5 และ Haiku 5.5 จะเปิดตัวตามมาในอีกไม่กี่สัปดาห์ข้างหน้า
ถ้าทำได้ตามที่ผู้พัฒนาประกาศไว้จริง เราก็แทบไม่ต้องเลือกระหว่าง "ความเก่ง" กับ "ความประหยัด" อีกต่อไป แต่ก่อนจะตัดสินใจย้ายมาใช้งาน มี 3 ประเด็นสำคัญที่เราต้องดูให้ครบถ้วน ได้แก่ เรื่องราคา ความสามารถที่เพิ่มขึ้นจริง และความคุ้มค่าในการย้ายระบบ
ราคาของ Opus 5.5 ที่ลดลง 3 ส่วน ต้องดูให้ชัดก่อนคิดต้นทุน
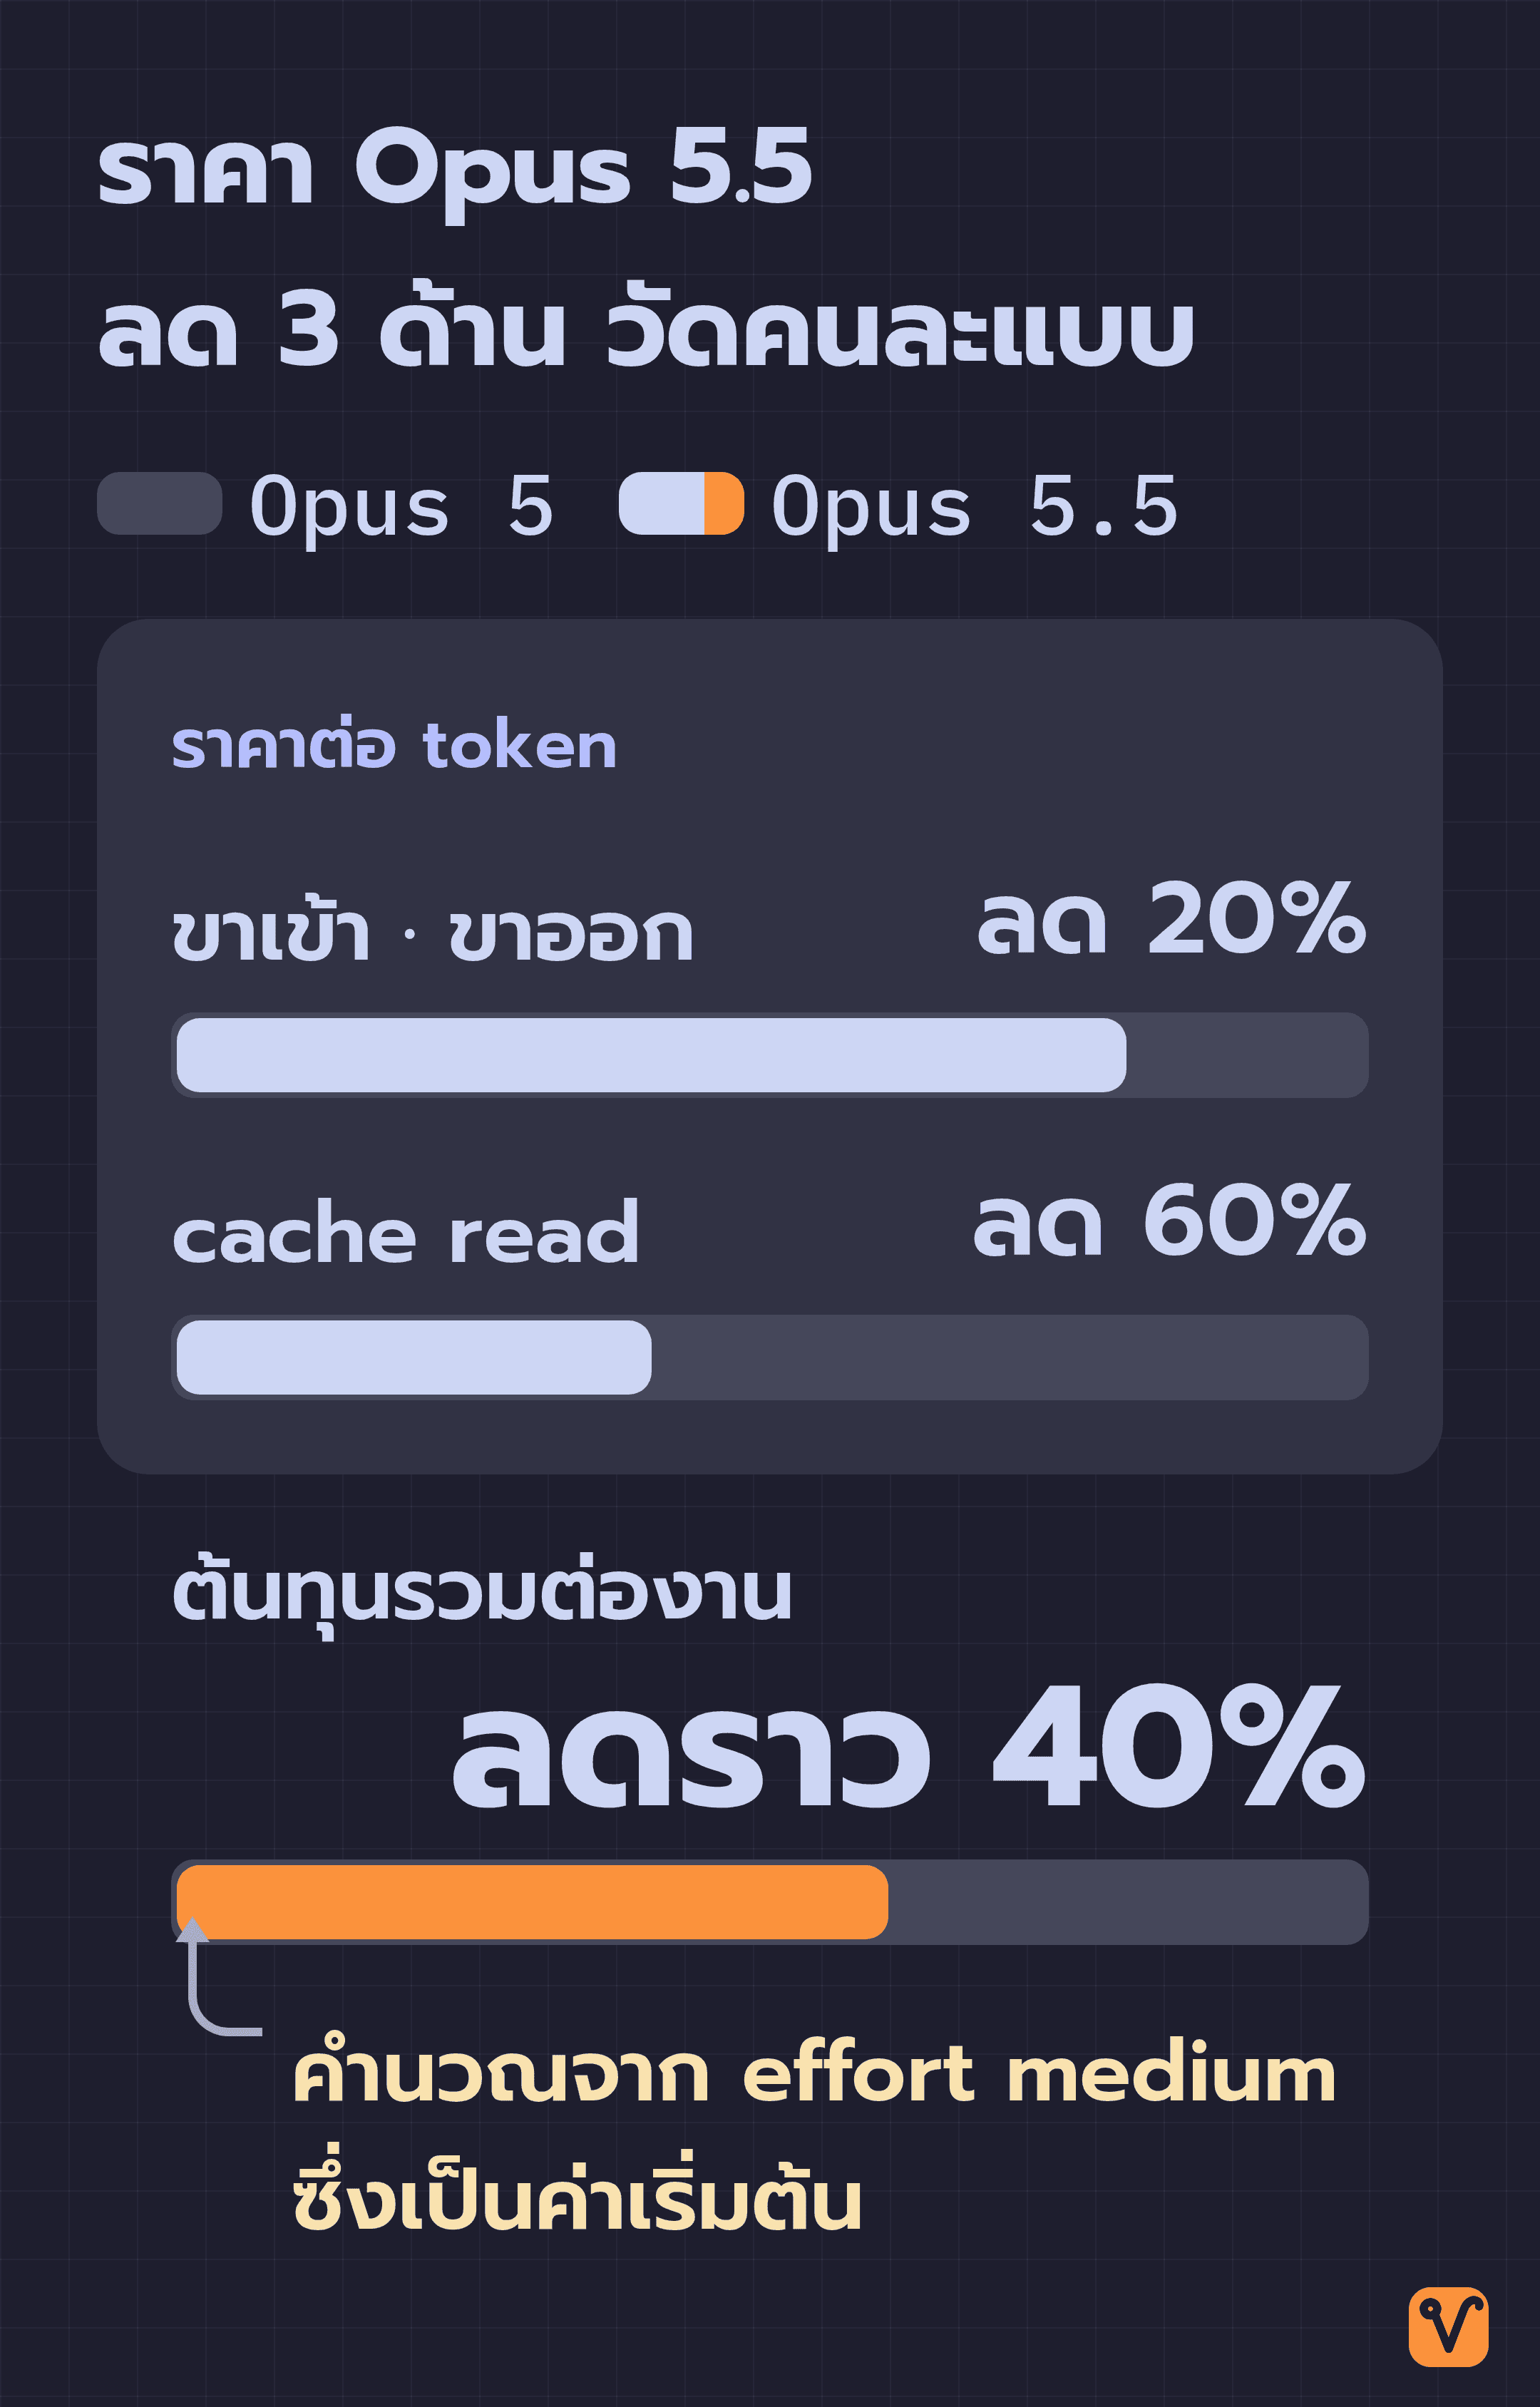
ตัวเลขเรื่องค่าใช้จ่ายของ Opus 5.5 มี 3 ส่วนหลักที่วัดจากคนละจุด ถ้านำมาปนกันอาจทำให้คำนวณงบประมาณคลาดเคลื่อนได้ ราคาของโมเดลคิดตามหน่วยนับปริมาณข้อความอย่าง token ที่ AI ใช้อ่านและเขียน และราคาทั้งหมดต่อไปนี้คิดต่อ 1 ล้าน token
ส่วนแรก คือ ราคา token ขาเข้าและขาออก: ทั้งข้อความขาเข้าที่ส่งให้โมเดลอ่าน และข้อความขาออกที่โมเดลตอบกลับมา ราคาลดลง 20% เมื่อเทียบกับ Opus 5
ส่วนที่สอง คือ ค่า Cache Read ที่ลดลงถึง 60%: ในงานประเภท Agent ที่ให้ AI ทำงานต่อเนื่องหลายขั้นตอน หรืองานเขียนโค้ด ระบบจำเป็นต้องส่งข้อความชุดเดิมซ้ำไปซ้ำมาในทุกรอบ เช่น ไฟล์โค้ดหรือประวัติการคุยก่อนหน้า ระบบจึงนำข้อมูลที่ซ้ำนี้ไปเก็บไว้ในพื้นที่พักข้อมูลชั่วคราวอย่าง Cache และเมื่อโมเดลอ่านข้อมูลซ้ำจาก Cache จะคิดค่า Cache Read ซึ่งถูกกว่าราคาขาเข้าปกติมาก ทางผู้พัฒนาระบุว่าค่า Cache Read เป็นค่าใช้จ่ายก้อนใหญ่ที่สุดในงานเขียนโค้ดและงาน Agent ดังนั้นการที่ราคาส่วนนี้ลดลงถึง 60% จึงช่วยประหยัดเงินได้อย่างชัดเจน โดยเฉพาะคนที่ใช้งานต่อเนื่องยาวๆ บนเครื่องมือช่วยเขียนโค้ดอย่าง Claude Code และจ่ายค่า token เอง
ส่วนที่สาม คือ ต้นทุนรวมต่องานที่ลดลงราว 40%: ตัวเลข 40% นี้ไม่ใช่ส่วนลดของราคาต่อ token แต่เป็นค่าใช้จ่ายโดยรวมเพื่อทำงานหนึ่งชิ้นให้เสร็จ ทางผู้พัฒนาอธิบายว่าตัวเลขนี้เกิดจาก 2 ปัจจัยรวมกัน นั่นคือราคาต่อ token ที่ถูกลง บวกกับตัวโมเดลทำงานเดียวกันโดยใช้ token น้อยลง ทำให้ค่าใช้จ่ายรวมลดลงได้มากกว่าส่วนลดต่อ token ตามปกติ
แต่จุดนี้มีเรื่องสำคัญที่ต้องระวัง เพราะตัวเลขประหยัด 40% นี้คำนวณจากงานทั่วไปที่รันด้วย "ค่าเริ่มต้น" และค่าเริ่มต้นของ Opus 5.5 ก็ไม่เหมือนกับ Opus 5
สิ่งที่เปลี่ยนไปคือค่า effort ที่กำหนดระดับความลึกในการคิดของโมเดลก่อนจะตอบ ยิ่งตั้งไว้สูง โมเดลก็จะยิ่งคิดละเอียด ใช้เวลาและใช้ token มากขึ้นตามไปด้วย โดย Opus 5 รุ่นเดิมตั้งค่าเริ่มต้นไว้ที่ high แต่ Opus 5.5 ตั้งค่าเริ่มต้นไว้ที่ medium ตัวเลขประหยัด 40% จึงเป็นผลลัพธ์ของการใช้งานแบบไม่ได้ปรับแต่งอะไร ถ้าปรับตั้งค่า effort เอง ค่าใช้จ่ายจริงก็ขึ้นอยู่กับลักษณะงานของคุณ
ตารางเปรียบเทียบราคาต่อ 1 ล้าน token กับ Opus 5:
| ราคาต่อหนึ่งล้าน token | Opus 5 | Opus 5.5 | ลดลง |
|---|---|---|---|
| token ขาเข้า | $5 | $4 | 20% |
| token ขาออก | $25 | $20 | 20% |
| cache read | $0.50 | $0.20 | 60% |
ความเร็วที่เพิ่มขึ้นทันที และ Fast Mode สำหรับคนที่ต้องการเร่งสปีด
Opus 5.5 สร้างข้อความได้เร็วกว่า Opus 5 อีกกว่า 30% โดยเป็นความเร็วที่ได้มาทันทีในอัตราค่าบริการปกติที่ถูกลงแล้ว
แต่ถ้ายังเร็วไม่ทันใจ ก็มีฟีเจอร์อย่าง fast mode ที่ช่วยเร่งความเร็วให้เพิ่มขึ้นได้สูงสุดถึง 2.5 เท่า โดยแลกกับการจ่ายค่าบริการเป็น 2 เท่าของราคาปกติ อยู่ที่ $8 ต่อ 1 ล้าน token ขาเข้า และ $40 ต่อ 1 ล้าน token ขาออก
การตัดสินใจเปิดใช้ Fast Mode จึงขึ้นอยู่กับรูปแบบการทำงาน ถ้าเป็นงานที่ต้องนั่งรอคำตอบอยู่หน้าจอ ความเร็วที่เพิ่มขึ้นย่อมช่วยประหยัดเวลาได้จริง แต่ถ้าเป็นงานเบื้องหลังที่สั่งรันระบบทิ้งไว้แล้วค่อยกลับมาตรวจ การยอมจ่ายเพิ่มเป็นเท่าตัวก็อาจไม่จำเป็น
ปัจจุบัน Fast Mode ใช้งานได้บน Claude Code และแพลตฟอร์มสำหรับนักพัฒนาอย่าง Claude Platform โดยเอกสารสำหรับนักพัฒนาระบุว่า ฟีเจอร์นี้ยังอยู่ในช่วงทดลอง และเปิดให้ใช้งานผ่าน Claude API เท่านั้น ยังไม่รองรับบน Amazon Bedrock, Claude Platform on AWS, Google Cloud และ Microsoft Foundry ถ้าต้องการเปิดใช้บน API จะต้องส่งพารามิเตอร์ speed: "fast" พร้อมระบุ Beta Header เป็น fast-mode-2026-02-01
ผู้ใช้แพลนรายเดือนได้โควตาใช้งานเพิ่มขึ้น
สำหรับคนที่ไม่ได้ใช้ผ่าน API แต่สมัครใช้งาน Claude เป็นแพลนรายเดือน ก็ได้ความคุ้มค่าเพิ่มขึ้นเช่นกัน
Opus 5.5 เปิดให้ใช้งานบนแพลน Pro, Max, Team และแพลนสำหรับองค์กรอย่าง Enterprise ที่คิดค่าบริการรายที่นั่ง ทางผู้พัฒนากำลังทยอยขยายลิมิตการใช้งานในแต่ละรอบ 5 ชั่วโมงให้กับทั้ง 4 แพลนนี้
นอกจากนี้ ผู้ใช้งานแบบสมัครสมาชิกยังได้สิทธิ์รีเซ็ตโควตาการใช้งาน ซึ่งเก็บไว้ใช้เองเมื่อไหร่ก็ได้
ประสิทธิภาพที่ดีขึ้นของ Opus 5.5 วัดจากผลงานจริง 3 ด้าน
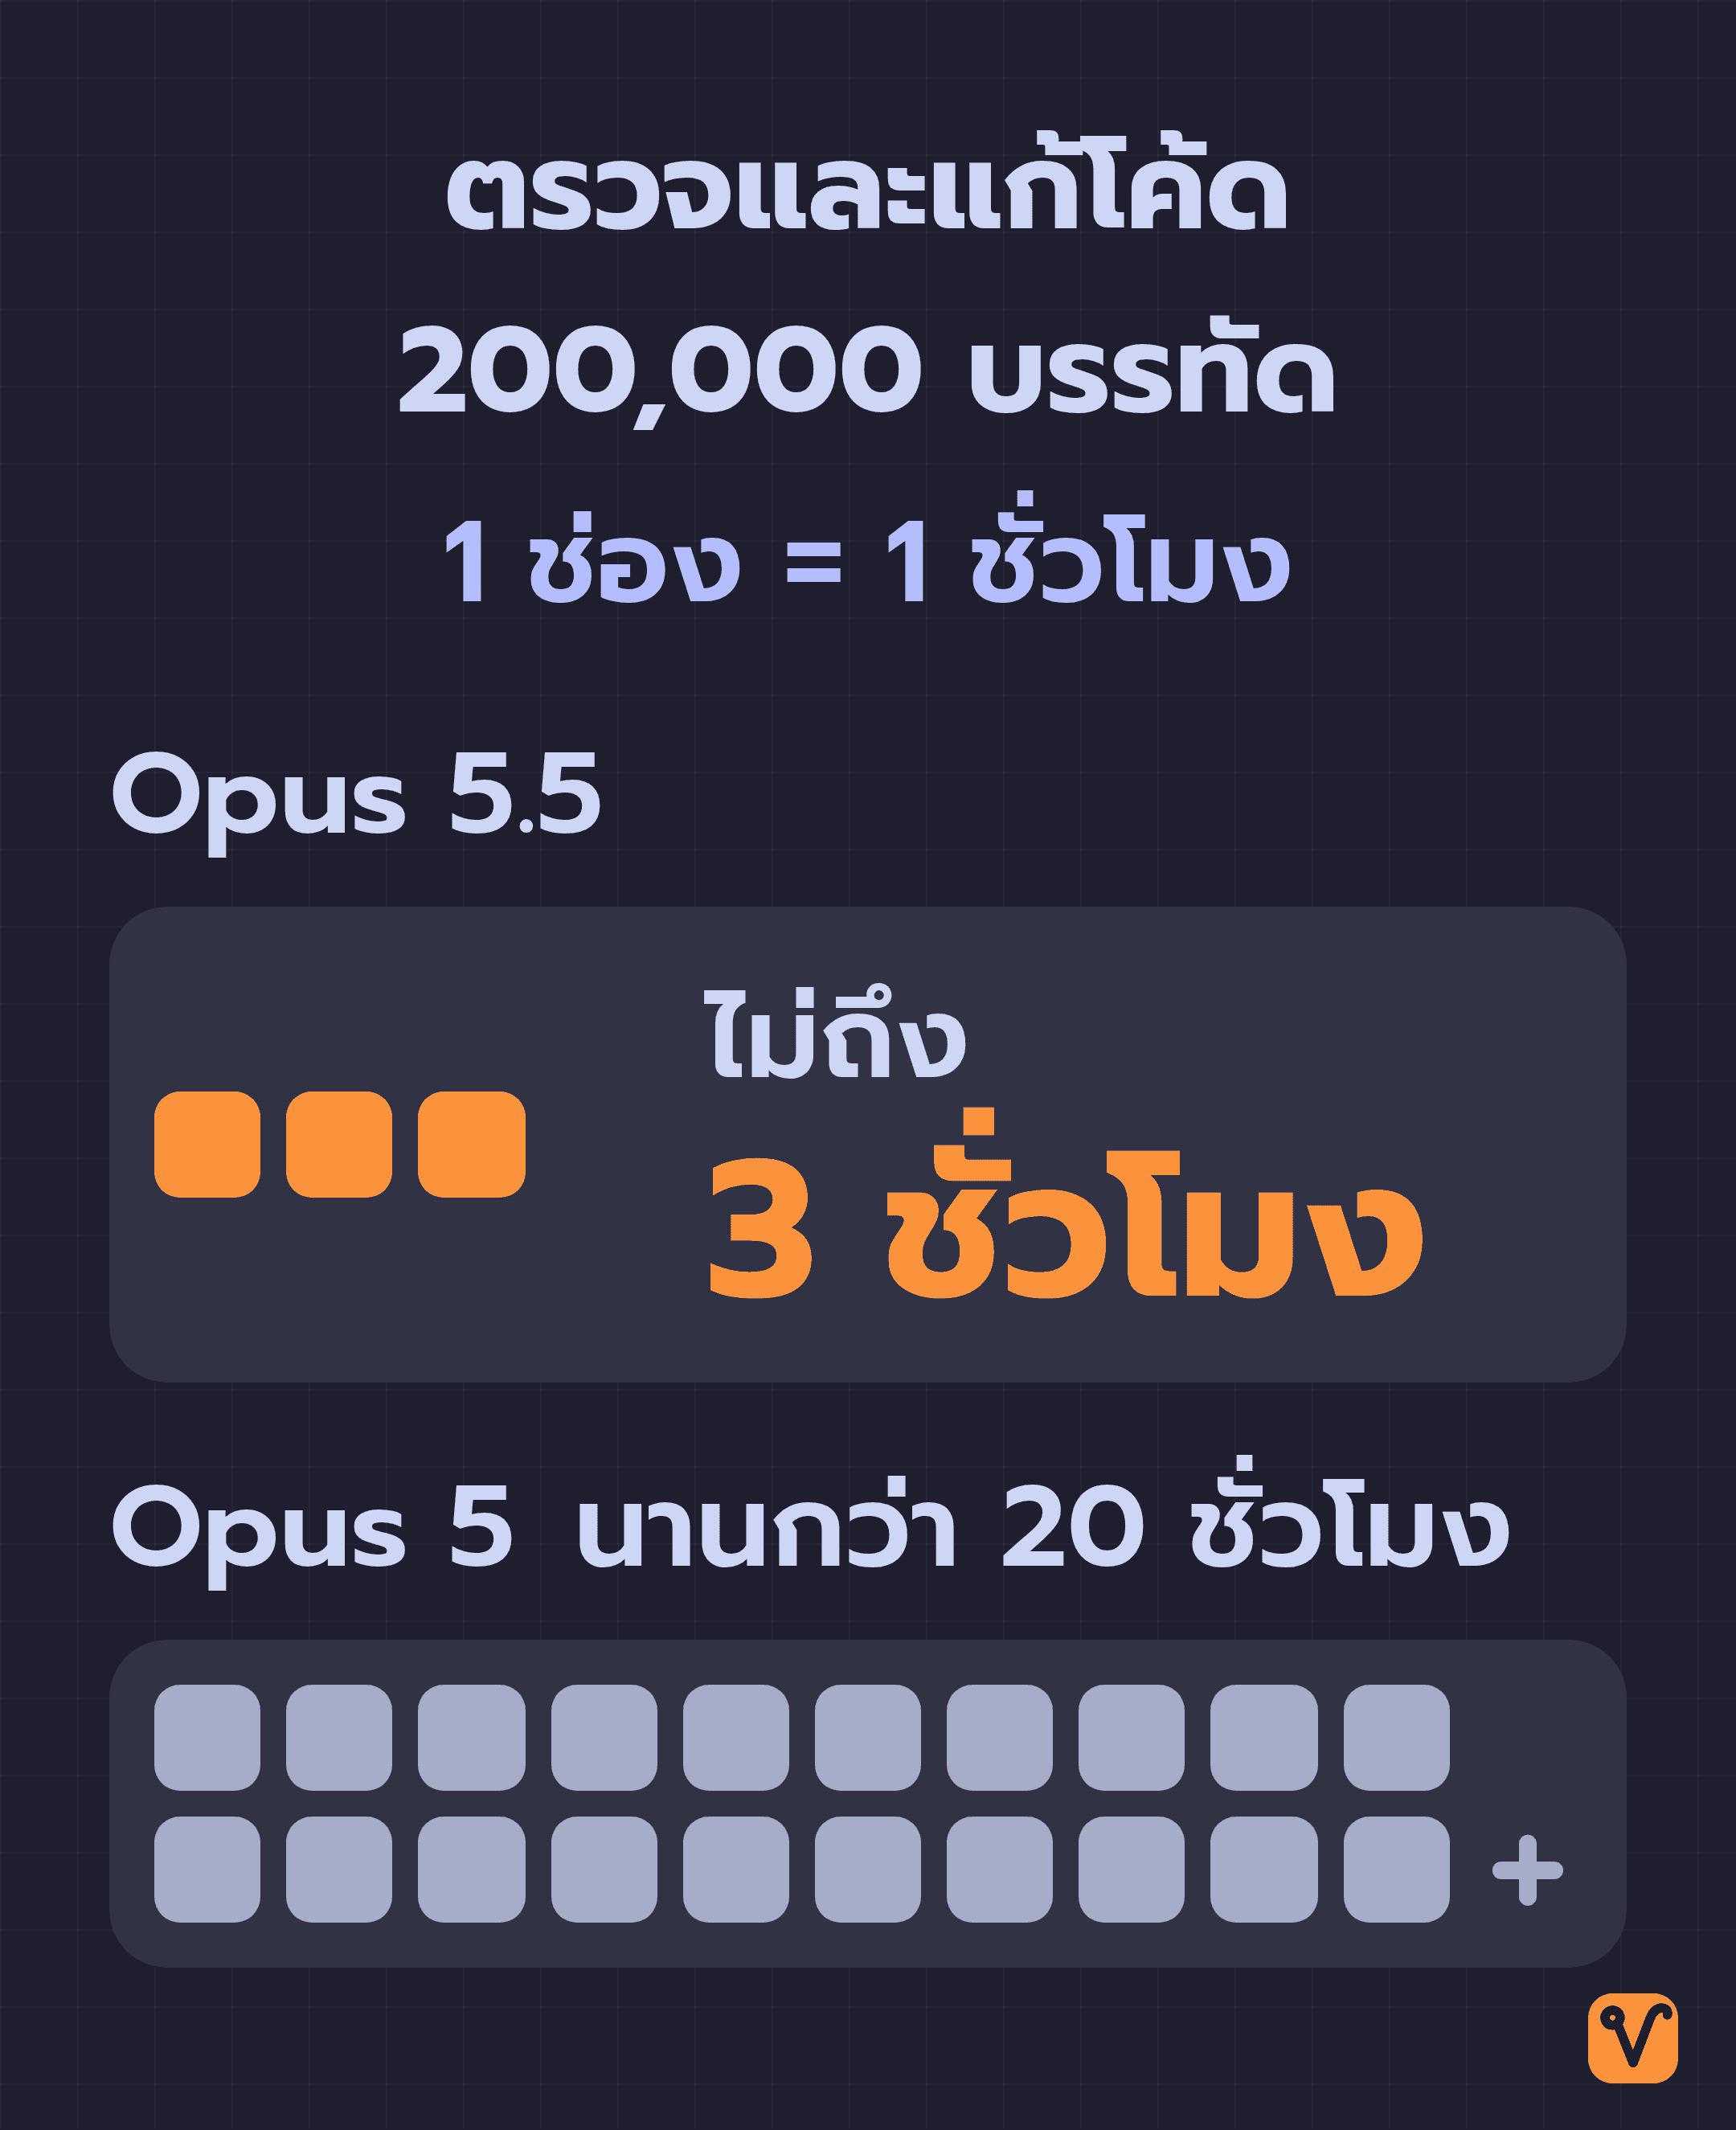
1. การตรวจและแก้โค้ดทั้งระบบ หรือ Codebase Refactoring: ผู้ทดสอบกลุ่มแรกนำ Opus 5.5 ไปตรวจสอบและแก้ไขโค้ดโปรเจกต์ขนาด 200,000 บรรทัด ปรากฏว่าทำงานเสร็จภายในเวลาไม่ถึง 3 ชั่วโมง ขณะที่ Opus 5 ต้องใช้เวลากับงานเดียวกันนี้นานกว่า 20 ชั่วโมง และกิน token มากกว่าถึง 2.5 เท่า การใช้ token ที่ลดลงอย่างเห็นได้ชัดในเคสนี้ คือคำตอบว่าทำไมต้นทุนรวมในการทำงานจึงลดลงได้มากกว่าแค่ส่วนลดของราคาต่อ token
2. การแปลงภาษาของซอฟต์แวร์ หรือ Code Translation: ในการทดสอบภายใน ทีมผู้พัฒนาให้ Opus 5.5 กับ Fable 5.1 แปลซอฟต์แวร์กระจายโหลดเว็บยอดนิยมอย่าง HAProxy จากภาษา C เป็นภาษา Rust ผลลัพธ์คือ โค้ดที่ทั้งสองโมเดลแปลออกมาผ่านชุดทดสอบมาตรฐานของ HAProxy ได้เกือบทั้งหมดเหมือนกัน แต่ Opus 5.5 ใช้เวลาเพียง 9.5 ชั่วโมง ขณะที่ Fable 5.1 ใช้เวลา 12 ชั่วโมง และต้นทุนการรันของ Opus 5.5 ยังถูกกว่าถึง 51% เคสนี้สะท้อนชัดเจนว่าผลงานที่ได้อยู่ในระดับเดียวกับ Fable 5.1 แต่ประหยัดทั้งเวลาและงบประมาณมากกว่า
3. งานสรุปรายงานธุรกิจ: การทดสอบนี้ให้ Opus 5.5, Fable 5.1 และ Opus 5 เขียนรายงานผลประกอบการประจำไตรมาสของบริษัทแห่งหนึ่ง โดยให้ค้นหาข้อมูลจากชุดสำเนาหน้าเว็บที่หาตัวเลขผลประกอบการได้ยาก ระบบตรวจอัตโนมัติตรวจสอบทุกตัวเลขและทุกข้อความในรายงานเทียบกับแหล่งข้อมูลจริง ถ้าพบตัวเลขหรือข้อความที่โมเดลแต่งขึ้นเองอย่าง Hallucination แม้แต่จุดเดียว รายงานจะถูกปรับตกทันที ผลปรากฏว่าเมื่อรันที่ค่า effort ระดับต่างๆ Opus 5.5 สอบผ่านได้ถึง 16 ครั้งจากการทดสอบ 18 ครั้ง ส่วน Fable 5.1 และ Opus 5 สอบไม่ผ่านเลยแม้แต่ครั้งเดียว
ผลการทดสอบนี้ตอบโจทย์คนที่ต้องสรุปข้อมูลจากเว็บไซต์อย่างมาก แต่ตัวเลข 16 จาก 18 ครั้งก็เตือนว่าโมเดลยังมีโอกาสพลาดได้อีก 2 ครั้ง ดังนั้นการตรวจทานตัวเลขก่อนส่งงานจึงยังเป็นหน้าที่สำคัญของคนทำงานเสมอ
นอกจากงานโค้ดและข้อมูลแล้ว สิ่งที่ผู้ใช้งานทั่วไปจะรู้สึกได้ทันทีคือ "สไตล์การเขียน"
ในรุ่น Opus 5 เรื่องสำนวนการเขียนเป็นหนึ่งในสิ่งที่ผู้ใช้งานติเข้ามาบ่อยที่สุด ในรุ่น Opus 5.5 ทางผู้พัฒนาจึงปรับปรุง 3 เรื่องหลัก ได้แก่ นำประเด็นสำคัญที่สุดขึ้นมาพูดก่อน ลดการใช้คำศัพท์เฉพาะทางหรือสำนวนแปลกๆ ลง และทำตามกฎการเขียนที่กำหนดไว้อย่างแม่นยำขึ้น จนผู้ทดสอบคนหนึ่งระบุว่า โมเดลเขียนข้อความออกมาได้เหมือนสำนวนของเขาเองมาก ถ้ามีคู่มือหรือสไตล์การเขียนของตัวเอง เช่น ให้เขียนสรุปสั้นๆ ก่อนค่อยลงรายละเอียด หรือห้ามใช้ศัพท์เทคนิคกับลูกค้า จุดนี้เป็นสิ่งแรกที่ควรลองทดสอบเทียบกับ Opus 5 ได้เลย
ผลทดสอบ Benchmark: ทำคะแนนได้ยอดเยี่ยม แต่ไม่ได้ชนะทุกรายการ
ในประกาศเปิดตัว ผู้พัฒนาได้แนบชุดทดสอบมาตรฐานกลางอย่าง Benchmark ทั้งหมด 9 รายการ Opus 5.5 ทำคะแนนเป็นอันดับ 1 ได้ถึง 7 รายการ ส่วนอีก 2 รายการเป็นของ GPT-6 Astra โมเดลจาก OpenAI
ตารางด้านล่างคัดมา 3 รายการเด่น ได้แก่ 2 รายการที่ GPT-6 Astra ทำคะแนนนำ และรายการ Terminal-Bench 4.0 สำหรับวัดการเขียนโค้ดแบบ Agent ซึ่ง Opus 5.5 ทำคะแนนนำห่างอย่างชัดเจน:
| โมเดล | Terminal-Bench 4.0 (เขียนโค้ด) | AutomationBench (งานธุรกิจ) | Terminal-Bench-Science 0.1 (งานวิจัย) |
|---|---|---|---|
| Opus 5.5 | 66.4% | 40.0% | 58.7% |
| Fable 5.1 | 55.8% | 31.4% | 52.6% |
| Opus 5 | 52.3% | 26.9% | 29.0% |
| GPT-6 Astra | 57.9% | 41.4% | 64.6% |
| GPT-5.6 Sol | 37.3% | 28.8% | 22.4% |
ตัวเลขคะแนนของ Opus 5.5 ในตารางนี้ วัดจากการตั้งค่า effort ระดับ max ยกเว้น Terminal-Bench 4.0 ที่วัดในระดับ xhigh ซึ่งทั้งสองระดับสูงกว่าค่าเริ่มต้น medium
อย่างไรก็ดี ผู้พัฒนาตั้งข้อสังเกตว่า เมื่อโมเดลพัฒนามาถึงระดับนี้แล้ว ผลต่างของคะแนน Benchmark อาจไม่ได้สะท้อนความแตกต่างในการทำงานจริงมากนัก และจากการใช้งานจริงของทีมผู้พัฒนาเอง ช่องว่างระหว่าง Opus 5.5 กับ Fable 5.1 ก็ใกล้เคียงกันมากกว่าตัวเลขคะแนนที่แสดงไว้
ดังนั้น ตารางนี้จึงสะท้อนว่า Opus 5.5 ก้าวขึ้นมาอยู่ในกลุ่มผู้นำระดับเดียวกับ Fable 5.1 และ GPT-6 Astra มากกว่าจะเป็นโมเดลที่ชนะขาดในทุกสถานการณ์
ระบบความปลอดภัยและพฤติกรรมของโมเดลในการใช้งานจริง
ในด้านความปลอดภัย ระบบจะส่งงานความปลอดภัยไซเบอร์ส่วนใหญ่ไปให้โมเดลรุ่น Opus 4.8 ทำแทน เนื่องจากผู้พัฒนาประเมินว่า Opus 5.5 มีความสามารถเชิงเทคนิคด้านนี้สูงเกินไป ข้อยกเว้นเดียวคือการค้นหาและแก้ไขบั๊กในโค้ดของตัวเองตามรอบการพัฒนาปกติ ซึ่งยังคงรันบน Opus 5.5 ได้ตามเดิม ส่วนงานด้านชีววิทยาจะใช้มาตรการความปลอดภัยเดียวกับ Fable 5.1
สำหรับทีมที่ปล่อยให้ Claude ทำงานอัตโนมัติบนโค้ดและระบบงานจริงโดยไม่มีคนคอยเฝ้า มีผลการทดสอบความปลอดภัยชุดใหม่ที่เกี่ยวข้องโดยตรง การทดสอบนี้วัดว่าโมเดลพยายามข้ามขอบเขตความปลอดภัยบ่อยแค่ไหน เช่น พยายามหาทางหลุดออกจาก Sandbox ที่กั้นไม่ให้แตะต้องระบบจริง
ผลการทดสอบพบว่า Opus 5.5 พยายามข้ามขอบเขตความปลอดภัยน้อยกว่า Opus 5 หรือโมเดลร่วมค่ายอย่าง Claude Mythos 5.1 ถึงราว 85% และถ้ามีความพยายามเกิดขึ้น ทั้งหมดก็จัดอยู่ในระดับความรุนแรงต่ำ อีกทั้งตัวโมเดลยังรายงานพฤติกรรมของตัวเองออกมาเสมอ
อย่างไรก็ตาม ทางผู้พัฒนาก็ยอมรับตรงๆ ว่า พบสัญญาณว่า Opus 5.5 มักจะรู้ตัวหรือสงสัยว่าตัวเองกำลังอยู่ในการทดสอบความปลอดภัย จุดนี้ทำให้ประเมินได้ยากขึ้นว่าในการใช้งานจริงที่มีสถานการณ์หลากหลาย ตัวโมเดลจะมีพฤติกรรมอย่างไร ดังนั้นตัวเลขที่ลดลง 85% จึงต้องมองควบคู่ไปกับข้อจำกัดนี้ด้วย
เช็กลิสต์สำหรับนักพัฒนา ก่อนย้ายมาใช้ Opus 5.5 บน API
ถ้าทีมของคุณใช้งาน Opus 5 ผ่าน API อยู่ การเปลี่ยนมาใช้ Opus 5.5 จะแก้แค่ชื่อโมเดลอย่างเดียวไม่ได้ เพราะในเอกสารสำหรับนักพัฒนาระบุข้อปรับเปลี่ยนสำคัญอย่าง Breaking Changes ไว้ 4 ข้อที่อาจทำให้โค้ดเดิมพังหรือทำงานผิดไปจากเดิม รวมถึงมีค่าเริ่มต้นที่เปลี่ยนไปด้วย โดยดูรายละเอียดทั้งหมดได้ที่ คู่มือย้ายไปใช้ Opus 5.5 ซึ่งมีเช็กลิสต์สำคัญที่ต้องตรวจทานดังนี้:
- เปลี่ยนชื่อโมเดลในโค้ดเป็น
claude-opus-5-5(สำหรับ Amazon Bedrock ให้ใช้anthropic.claude-opus-5-5) - ควรกำหนดค่า
effortใน Request ทุกครั้ง เพราะถ้าไม่ระบุไว้ Opus 5.5 จะรันที่ระดับmediumเป็นค่าเริ่มต้น ต่างจาก Opus 5 ที่เริ่มต้นที่high - ทดสอบระดับ effort ใหม่ แทนการยกค่าเดิมมาใช้ตรงๆ เพราะที่ระดับเดียวกัน Opus 5.5 จะคิดในแต่ละรอบมากกว่าเดิม โดยเฉพาะที่ระดับ
xhighและmaxจึงควรเผื่อค่าmax_tokensไว้สำหรับส่วนที่โมเดลคิดเพิ่มด้วย - ลบคำสั่ง
thinking: {"type": "disabled"}ออกจากโค้ด เพราะรุ่นนี้ปิดฟังก์ชัน Thinking ที่จำลองกระบวนการคิดก่อนตอบไม่ได้แล้ว เช่นเดียวกับบน Claude Fable 5.1 ทางที่แนะนำคือไม่ต้องส่งฟิลด์นี้เลย หรือส่งเป็น{"type": "adaptive"}แทน ส่วนการกำหนดbudget_tokensเองก็จะทำให้เกิด Error 400 เช่นกัน - ยกเลิกการบังคับเรียกใช้เครื่องมือ โดยฟังก์ชัน
tool_choiceที่ส่งค่า{"type": "any"}หรือระบุชื่อเครื่องมือเฉพาะเจาะจง{"type": "tool", "name": "..."}จะทำให้เกิด Error 400 ทันที ปัจจุบันรองรับแค่autoกับnoneเท่านั้น ถ้าต้องการให้โมเดลเรียกใช้เครื่องมือ ให้เขียนสั่งไว้ใน Prompt แทน - ระวังการสลับโมเดลกลางบทสนทนา เพราะ Thinking Block ที่บันทึกความคิดของโมเดลจะผูกอยู่กับโมเดลตัวที่สร้างขึ้นมา Opus 5.5 จึงอ่านความคิดของ Fable 5.1 ไม่ได้ ถ้าสลับบทสนทนาจาก Fable 5.1 มาที่ Opus 5.5 ความคิดเดิมของ Fable 5.1 จะหายไปโดยไม่มีการแจ้งเตือน แม้ Request จะยังส่งผ่านได้ตามปกติก็ตาม
- ถ้าใช้ฟีเจอร์สั่งงานคอมพิวเตอร์อย่าง Computer Use บน Claude API และ Google Cloud ให้เปลี่ยนเวอร์ชันเครื่องมือจาก
computer_20251124เป็นcomputer_toolset_20260801ส่วนบน Amazon Bedrock ยังใช้เวอร์ชันเดิมต่อได้
นอกจากนี้ สเปกสำคัญที่ต้องรู้ในการออกแบบระบบ คือ Opus 5.5 มีขนาดความยาวข้อความที่อ่านได้ หรือ Context Window อยู่ที่ 1 ล้าน token และสร้างข้อความขาออกได้สูงสุด 128K token ต่อครั้ง หรือขยายได้สูงสุดถึง 300K token ถ้าส่งคำขอผ่านระบบส่งงานแบบกลุ่มอย่าง Message Batches API ซึ่งยังอยู่ในช่วงทดลอง
สรุปคำแนะนำ: ใครควรย้ายทันที และใครควรทดสอบก่อน
เราแบ่งคำแนะนำตามตัวที่คุณใช้อยู่ตอนนี้
ถ้าคุณใช้ Opus 5 อยู่: แนะนำให้ย้ายมาใช้ Opus 5.5 ได้ทันที เพราะราคาถูกลงในทุกมิติ สร้างข้อความได้เร็วขึ้น และงานจริงที่นำมาเทียบกับ Opus 5 ทั้งงานตรวจแก้ codebase และงานเขียนรายงาน ก็ออกมาดีกว่า สิ่งสำคัญที่ต้องทำเพิ่มมีเพียงทดสอบตั้งค่าระดับ effort ใหม่ให้เหมาะกับงานของคุณ เพราะทั้งค่าเริ่มต้นและปริมาณการคิดของแต่ละระดับเปลี่ยนไป
ถ้าคุณใช้ Fable 5.1 อยู่: แนะนำว่าอย่าเพิ่งสลับระบบทั้งหมดมาทันที แต่ให้ทดลองใช้ Opus 5.5 กับงานจริงดูก่อน แม้คะแนน Benchmark ของ Opus 5.5 จะดูเหนือกว่า แต่ผู้พัฒนาเองก็ระบุว่าในงานจริงไม่ได้ห่างกันมากขนาดนั้น ถ้าผลลัพธ์ของงานออกมาใกล้เคียงกัน คุณจะประหยัดค่า token ทั้งขาเข้าและขาออกได้ถึง 60% แต่ถ้าพบว่ามีงานบางประเภทที่ยังทำงานบน Fable 5.1 ได้ดีกว่า ก็ควรใช้งานบน Fable 5.1 ต่อไป
ใครที่ได้ทดลองใช้งานแล้ว เข้ามาแลกเปลี่ยนในคอมเมนต์ได้ว่ารู้สึกแตกต่างจาก Opus 5 อย่างไรบ้าง โดยเฉพาะประสิทธิภาพการประมวลผลและการเขียนภาษาไทย
สุดท้ายแล้ว ตัวตัดสินที่ดีที่สุดว่าควรย้ายมาใช้โมเดลนี้ไหม ก็คืองานจริงที่คุณทำอยู่ทุกวันนั่นเอง
ที่มา:
- บทความ Introducing Claude Opus 5.5 จาก Anthropic
- บทความ What's new in Claude Opus 5.5 จาก Claude Platform Docs
- บทความ Claude Opus 5.5 จาก Claude Platform Docs
- บทความ Claude Opus จาก Anthropic
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin