Jev ของ TypeSafe AI: System One Model ที่ไม่เขียนข้อความ แต่ตอบทุกคำถามพร้อมกันในรอบเดียว
Jev คือ System One Model จาก TypeSafe AI ที่ไม่เขียนข้อความ แต่ให้ผลการตัดสินใจพร้อมค่าความน่าจะเป็น พาดูตั้งแต่รูปแบบการเรียกใช้ ไปจนถึงข้อจำกัดที่ต้องรู้
Jev เป็นโมเดล AI ตัวใหม่จาก TypeSafe AI ที่ไม่เขียนข้อความตอบกลับเลยแม้แต่ตัวเดียว
สิ่งที่ Jev ทำคือรับบริบทของงานที่เรียกว่า state เข้าไป เช่น ข้อความที่ลูกค้าเพิ่งส่งเข้ามา พร้อมกับชุดคำถามที่เราต้องการรู้ จากนั้นโมเดลจะคืนคำตอบกลับมาเป็นค่าข้อมูลที่ระบุประเภทชัดเจน พร้อมแนบค่าความน่าจะเป็นกำกับไว้ให้ทุกคำตอบ โดยไม่มีประโยคบรรยาย ไม่มีย่อหน้ายาวๆ และไม่ต้องให้โค้ดมาคอยตัดคำหรือแกะโครงสร้างข้อความซ้ำอีก ทาง TypeSafe เรียกโมเดลกลุ่มนี้ว่า "System One Model" เป็นชื่อที่ทีมงานตั้งขึ้นเพื่อสื่อถึงโมเดลที่เน้นการตัดสินใจอย่างรวดเร็ว ให้ซอฟต์แวร์นำผลลัพธ์ไปประมวลผลต่อได้ทันที ส่วนผู้ก่อตั้ง TypeSafe AI คือ Diogo Almeida อดีตทีมวิจัยของ OpenAI ที่เคยร่วมพัฒนาผลงานที่ต่อยอดมาเป็น ChatGPT
ถ้าดูการทำงานของระบบ AI อัตโนมัติอย่าง AI Agent ในปัจจุบัน ระหว่างทางมักเต็มไปด้วยการตัดสินใจย่อยๆ ที่ไม่จำเป็นต้องใช้ทักษะการเขียนข้อความเลย เช่น ข้อความนี้เร่งด่วนหรือไม่ คำขอนี้ควรส่งให้โมเดลราคาประหยัดหรือโมเดลตัวเก่ง หรือคำสั่งที่ Agent กำลังจะรันนั้นอันตรายพอที่จะต้องสั่งบล็อกไว้ก่อนไหม แต่ทุกวันนี้ เรากลับต้องเสียเงินและเสียเวลาเรียกโมเดลภาษาตัวเต็มทุกครั้งเพื่อตอบคำถามเหล่านี้ TypeSafe จึงสร้าง Jev ขึ้นมารองรับงานตัดสินใจย่อยๆ เหล่านี้โดยเฉพาะ และปัจจุบันยังเปิดให้ทดลองใช้งานล่วงหน้าสำหรับผู้ใช้บางกลุ่มเท่านั้น
โครงสร้างและการเรียกใช้งาน Jev
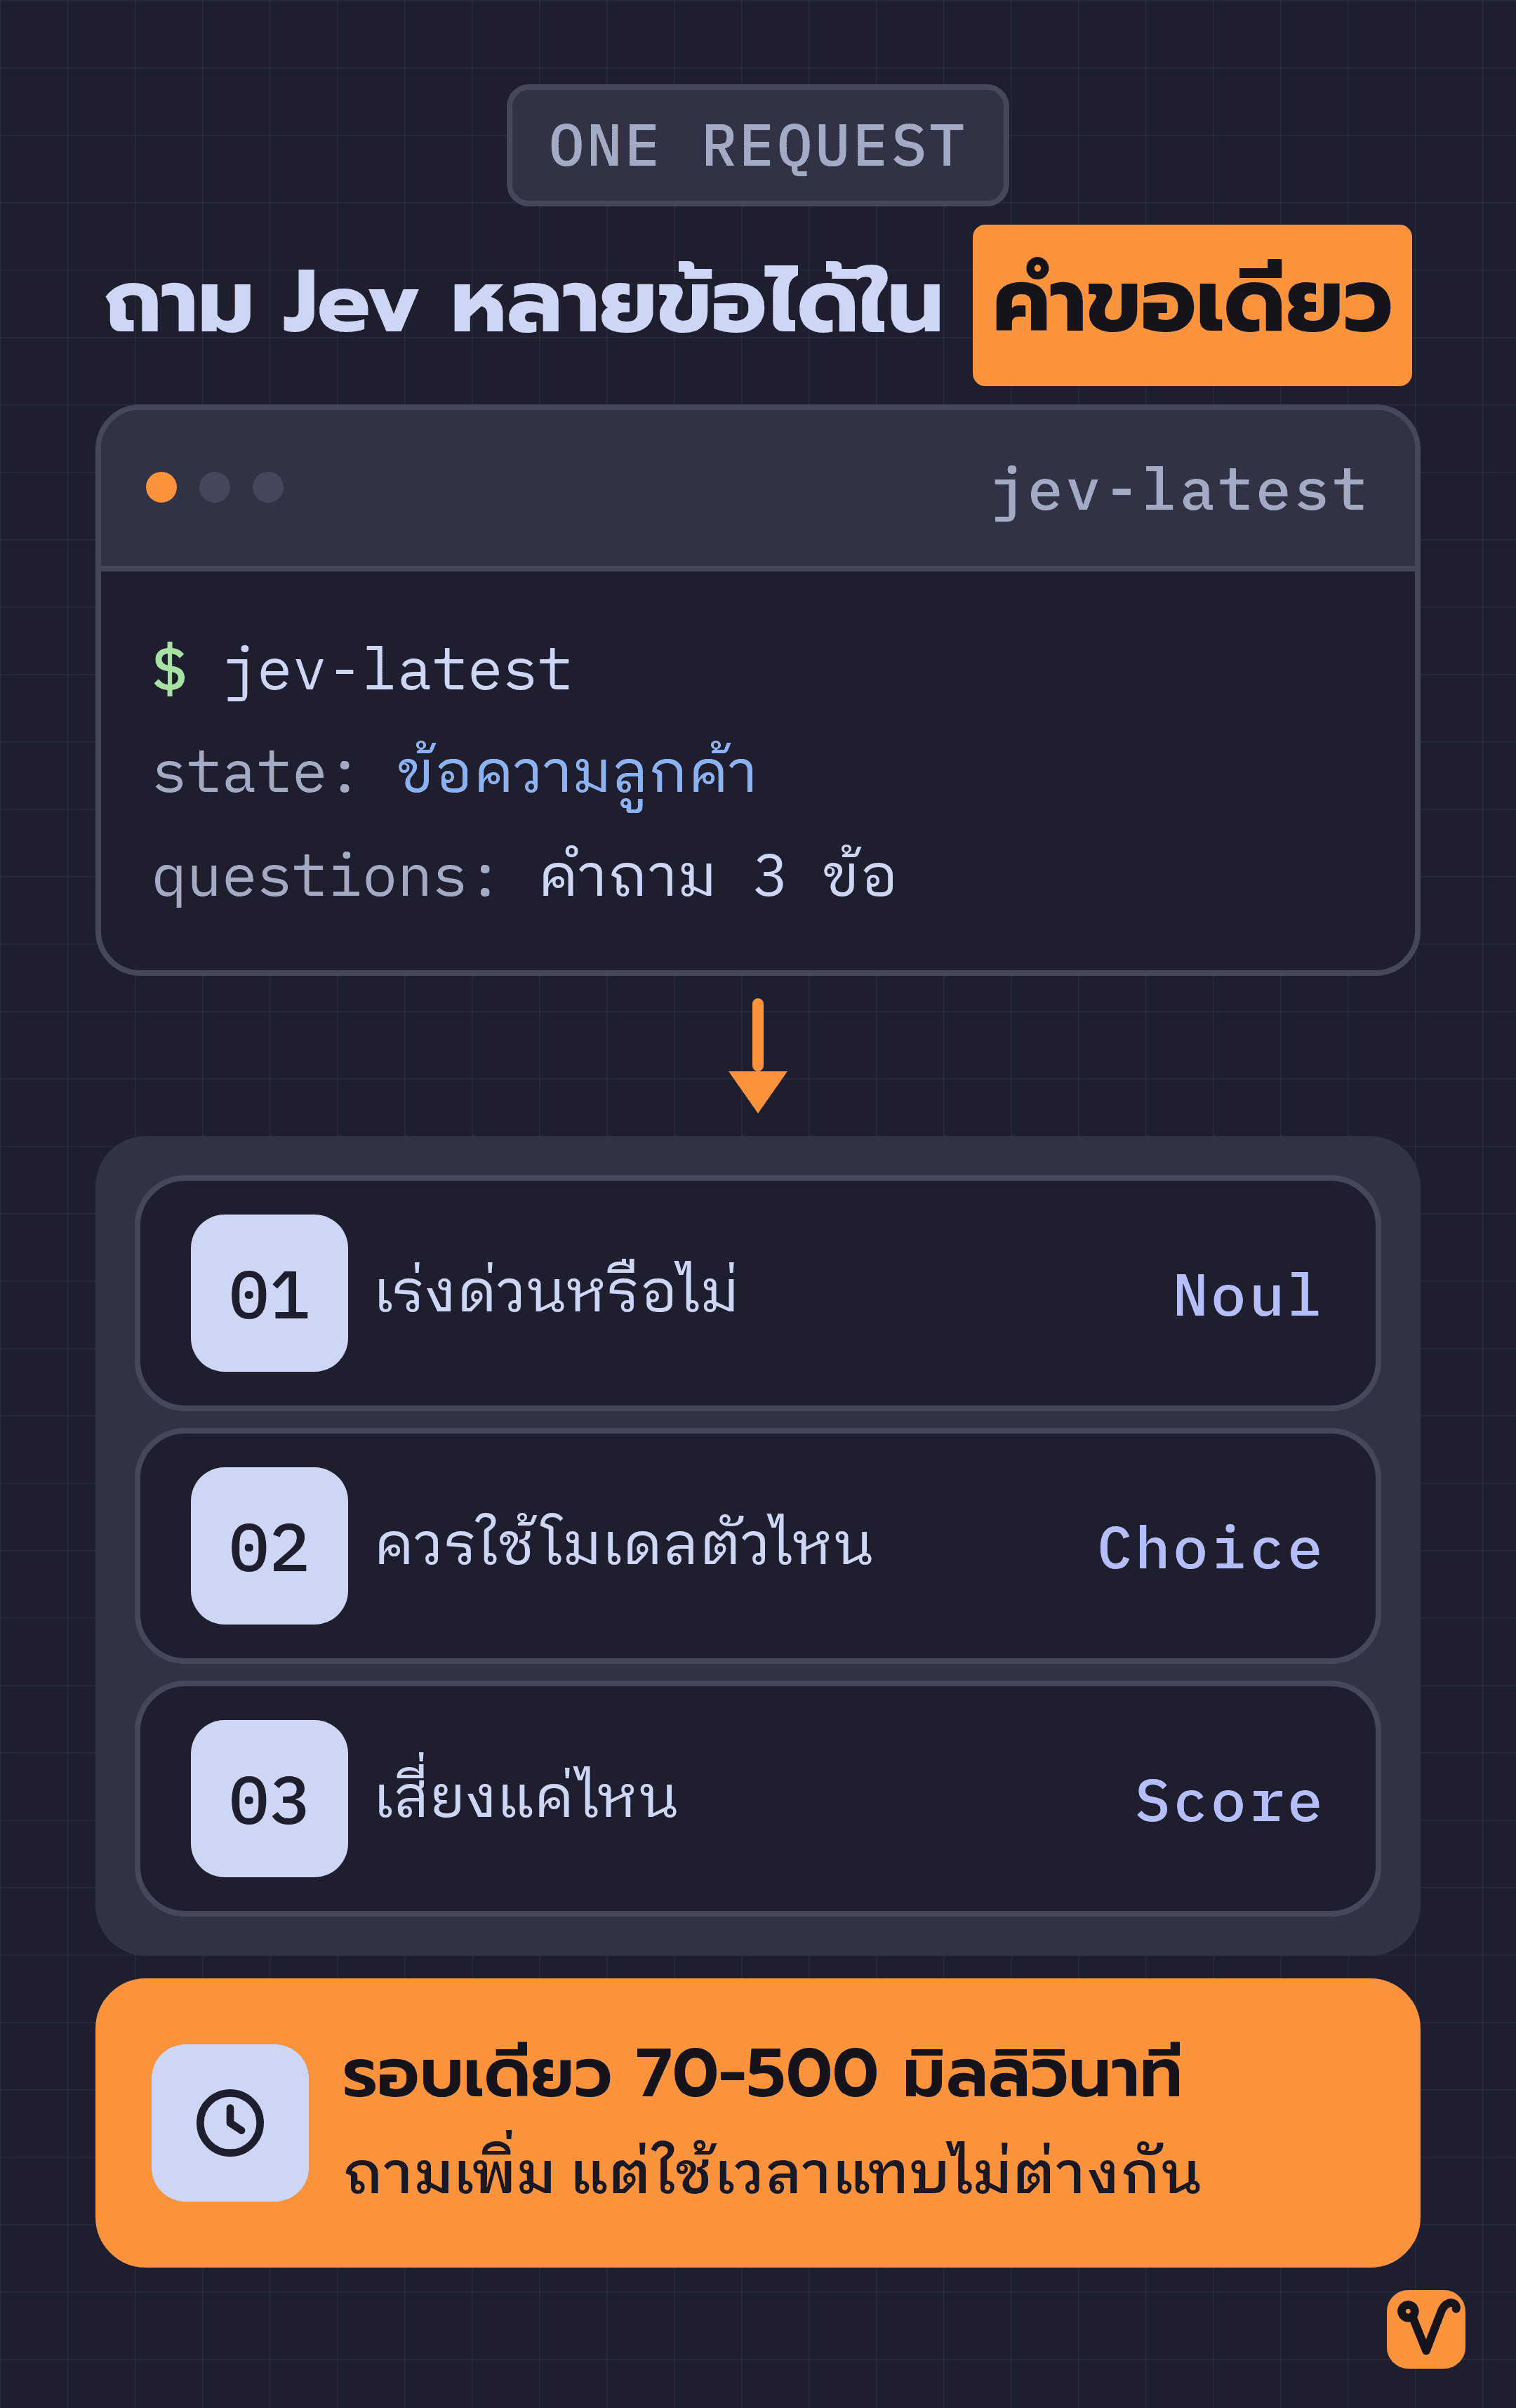
การส่งคำขอไปยัง Jev มีองค์ประกอบหลัก 3 ส่วน คือ model สำหรับระบุโมเดลที่จะใช้ state สำหรับใส่บริบทของงาน และ questions สำหรับใส่ชุดคำถามที่ต้องการคำตอบ ตัวอย่างจาก เอกสาร Quickstart ของ TypeSafe เป็นการส่งข้อความร้องเรียนของลูกค้าเข้าไป แล้วถามคำถามเดียวว่าข้อความนี้เร่งด่วนหรือไม่:
{
  "model": "jev-latest",
  "state": "Hi, I've been trying to connect my Stripe account for 3 days and it keeps failing. I'm losing sales. Please help ASAP.",
  "questions": {
    "is_urgent": {
      "type": "noul",
      "instructions": "The message conveys urgency or time-sensitivity"
    }
  }
}จากตัวอย่างด้านบน:
is_urgentคือชื่อที่เราตั้งขึ้นเอง เพื่อใช้ระบุและอ้างอิงคำตอบที่จะได้รับกลับมาtypeระบุชนิดของคำถาม (ในที่นี้คือnoul)instructionsคือคำอธิบายเกณฑ์ที่ต้องการให้โมเดลใช้พิจารณา
รูปแบบของผลลัพธ์มาจากชนิดของคำถามที่เราเลือกไว้ล่วงหน้า โดยไม่ต้องเขียน Prompt กำกับโครงสร้างข้อความเพิ่มเติม
ผลลัพธ์ที่ตอบกลับมาจะมีหน้าตาดังนี้:
{
  "is_urgent": {
    "type": "noul",
    "noul": 0.999
  }
}ค่า noul: 0.999 หมายความว่า Jev ประเมินความน่าจะเป็นที่ข้อความนี้เร่งด่วนไว้สูงถึง 99.9% ตัวเลขนี้คือข้อมูลที่โค้ดนำไปใช้ต่อได้ทันที เช่น ใส่ในเงื่อนไข if เพื่อดันเคสนี้ขึ้นมาจัดการเป็นคิวแรก โดยไม่ต้องมีขั้นตอนแกะข้อความคั่นกลางอีก
TypeSafe อธิบายแนวคิดว่า ให้มอง Jev เสมือนฟังก์ชันตัวหนึ่งที่รับบริบทดิบเข้าไป แล้วส่งผลการตัดสินใจที่ระบุประเภทข้อมูลชัดเจนออกมาให้ใช้งานทันที
Choice, Score และ Noul: คำถาม 3 รูปแบบที่ Jev รองรับ
คำถามที่ส่งให้ Jev ประเมินได้มีทั้งหมด 3 รูปแบบ ซึ่งจะให้ผลลัพธ์ต่างกันตามลักษณะการใช้งาน:
- Choice: เหมาะสำหรับคำตอบที่ต้องเลือกเพียงหนึ่งตัวเลือกจากชุดตัวเลือกที่กำหนดไว้ล่วงหน้า เช่น การจัดหมวดหมู่ของเคส โดยโมเดลจะคืนค่าความน่าจะเป็นของทุกตัวเลือก พร้อมระดับความมั่นใจรวม
- Score: เหมาะสำหรับคำตอบที่เป็นระดับขั้นและสามารถเรียงลำดับได้ เช่น ระดับต่ำ, กลาง, หรือสูง โดยโมเดลจะคืนค่าคะแนนแบบต่อเนื่อง พร้อมการกระจายตัวของค่าคะแนน และระดับความมั่นใจ
- Noul: เหมาะสำหรับคำถามที่ต้องการคำตอบว่า ใช่ หรือ ไม่ใช่ โดยโมเดลจะคืนค่าความน่าจะเป็นที่เงื่อนไขซึ่งเรากำหนดไว้จะเป็นจริง เหมือนตัวอย่าง
is_urgentข้างต้น
จุดที่ควรระวังคือความแตกต่างระหว่าง Choice กับ Score เพราะภายนอกดูเหมือนเป็นการเลือกจากชุดตัวเลือกเหมือนกัน แต่ความจริงคือ Score จะรับรู้ว่าตัวเลือกเรียงลำดับจากน้อยไปมาก ขณะที่ Choice มองแต่ละตัวเลือกแยกกันโดยไม่มีลำดับ ถ้าคำตอบที่ต้องการมีระดับขั้นอยู่ในตัว เช่น ระดับความเสี่ยง หรือระดับความพึงพอใจ การเลือกใช้ Choice จะทำให้สูญเสียข้อมูลเชิงลำดับไปโดยเปล่าประโยชน์
ถามคำถามเดียวหรือสิบคำถาม ก็ใช้เวลาแทบไม่ต่างกัน
Jev ตอบได้เร็วเพราะกระบวนการสร้างคำตอบ
โมเดลภาษาทั่วไปอย่าง LLM จะสร้างคำตอบทีละชิ้นคำที่เรียกว่า token ตามลำดับ โดยแต่ละ token ต้องรอผลประมวลผลจาก token ก่อนหน้าเสมอ แต่ TypeSafe ออกแบบวิธีประมวลผลของ Jev ขึ้นมาใหม่ทั้งหมด เพื่อให้ประเมินและเติมคำตอบลงในทุกช่องคำถามพร้อมกันได้ในรอบเดียว
การออกแบบนี้ส่งผลต่อการใช้งานจริงอย่างมาก เพราะในหนึ่งคำขอ เราสามารถส่งคำถามหลายข้อเกี่ยวกับ state ก้อนเดียวกันได้เลย โดยเวลาตอบสนองแทบไม่เปลี่ยนแปลง และเสียค่าใช้จ่ายเพิ่มขึ้นแค่ token ของคำถามที่เพิ่มเข้าไปเท่านั้น นั่นแปลว่า ถ้างานของเราจำเป็นต้องรู้ข้อมูล 7 เรื่องเกี่ยวกับเคสหนึ่งเคส การถามรวมกัน 7 ข้อในคำขอเดียวจะคุ้มค่ากว่าการแยกส่ง 7 คำขออย่างเห็นได้ชัด
ตามตัวเลขประสิทธิภาพที่ TypeSafe ประกาศไว้ เวลาตอบสนองตั้งแต่ต้นจนจบอยู่ที่ประมาณ 70 ถึง 500 มิลลิวินาที ค่าบริการฝั่งข้อมูลขาเข้าอยู่ที่ $0.042 ต่อ 1 ล้าน token และไม่คิดค่าบริการฝั่งข้อมูลส่งออกเลย ขณะที่ LLM ทั่วไปที่ทีมงานนำมาเปรียบเทียบ คิดค่าข้อมูลขาเข้าระหว่าง $0.20 ถึง $10 ต่อ 1 ล้าน token และคิดค่าข้อมูลส่งออกสูงกว่าข้อมูลขาเข้าประมาณ 5 เท่า โดยในเดโมที่ทีมงานสร้างบอทเล่นเกม Doom ที่ส่งคำขอประเมินสถานะประมาณ 10 ครั้งต่อวินาที มีค่าใช้จ่ายอยู่ที่ประมาณ $7 ต่อชั่วโมงเท่านั้น
สำหรับชื่อ "System One" นั้นมีที่มาจากหนังสือ Thinking, Fast and Slow ของ Daniel Kahneman ที่แบ่งระบบความคิดของมนุษย์ออกเป็น 2 ระบบ คือ ระบบแรกที่คิดเร็วและใช้สัญชาตญาณ กับระบบที่สองที่คิดช้าและต้องไตร่ตรองอย่างละเอียด TypeSafe จึงนำแนวคิดนี้มาใช้เรียกโมเดลที่ทำหน้าที่ตัดสินใจอย่างรวดเร็วในระบบแรก
ตัวเลข 200 เท่าและ 400 เท่า มาจากการวัดผลของ TypeSafe เอง
ตัวเลขประสิทธิภาพที่ปรากฏบนหน้าเว็บไซต์นั้นมาจากการวัดผลคนละชุด ซึ่งเราควรแยกแยะให้ชัดเจนก่อน:
- ในตารางเปรียบเทียบ TypeSafe ระบุว่า Jev ทำงานได้เร็วกว่า 40 ถึง 200 เท่า สำหรับกลุ่มคำถามที่เข้าทาง System One
- ส่วนตัวเลขเร็วกว่า 193.6 เท่า และประหยัดกว่า 444.6 เท่า ที่แสดงบนหน้าแรกของเว็บไซต์ มาจากชุดทดสอบการทำงานจริงอย่าง Workflow Eval
การทดสอบนี้เป็นการนำโมเดลแต่ละตัวไปรันในโค้ดชุดเดียวกัน เพื่อวัดว่าโมเดลใดให้คำตอบได้ใกล้เคียงกับคำตอบอ้างอิงมากที่สุด สามารถดูรายละเอียดทั้งหมดได้ที่ เว็บไซต์ Workflow Evals
สิ่งที่น่าชื่นชมคือ TypeSafe ชี้แจงเงื่อนไขการทดสอบของตนเองไว้อย่างโปร่งใส ทีมงานระบุเองว่าตัวเลขจาก Workflow Eval น่าจะอยู่ในช่วงบนของสิ่งที่เจอในงานจริง และคำตอบอ้างอิงในการทดสอบชุดนี้อิงจากค่าเฉลี่ยของ GPT-6 Astra ร่วมกับ Fable 5.1 ซึ่งย่อมโน้มเอียงตามลักษณะของทั้งสองโมเดลอยู่แล้ว ส่วนเดโมเปรียบเทียบแบบเทียบกันสองฝั่งบนเว็บไซต์ก็เป็นอีกชุดหนึ่ง ทีมงานยอมรับว่าเดโมนั้นใช้ข้อมูลขาเข้าที่สั้นกว่าปกติ ที่เข้าทางโมเดลของตนเองเป็นพิเศษ
เมื่อจะนำตัวเลขเหล่านี้ไปใช้วางแผนระบบ จึงควรจำไว้ว่านี่คือผลการวัดจากผู้พัฒนาบนโจทย์ที่โมเดลของตนเองถนัดที่สุด ตัวเลขที่ปลอดภัยสำหรับนำไปอ้างอิงคือ Jev ทำงานได้เร็วกว่าเดิมถึงราว 200 เท่า และประหยัดต้นทุนลงได้ราว 400 ถึง 450 เท่า สำหรับงานตัดสินใจแบบมีโครงสร้างเท่านั้น ไม่ใช่กับงานทุกประเภทที่เราส่งให้ AI ทำ
Type Error 0% ไม่ได้แปลว่า Jev ตอบถูกเสมอ
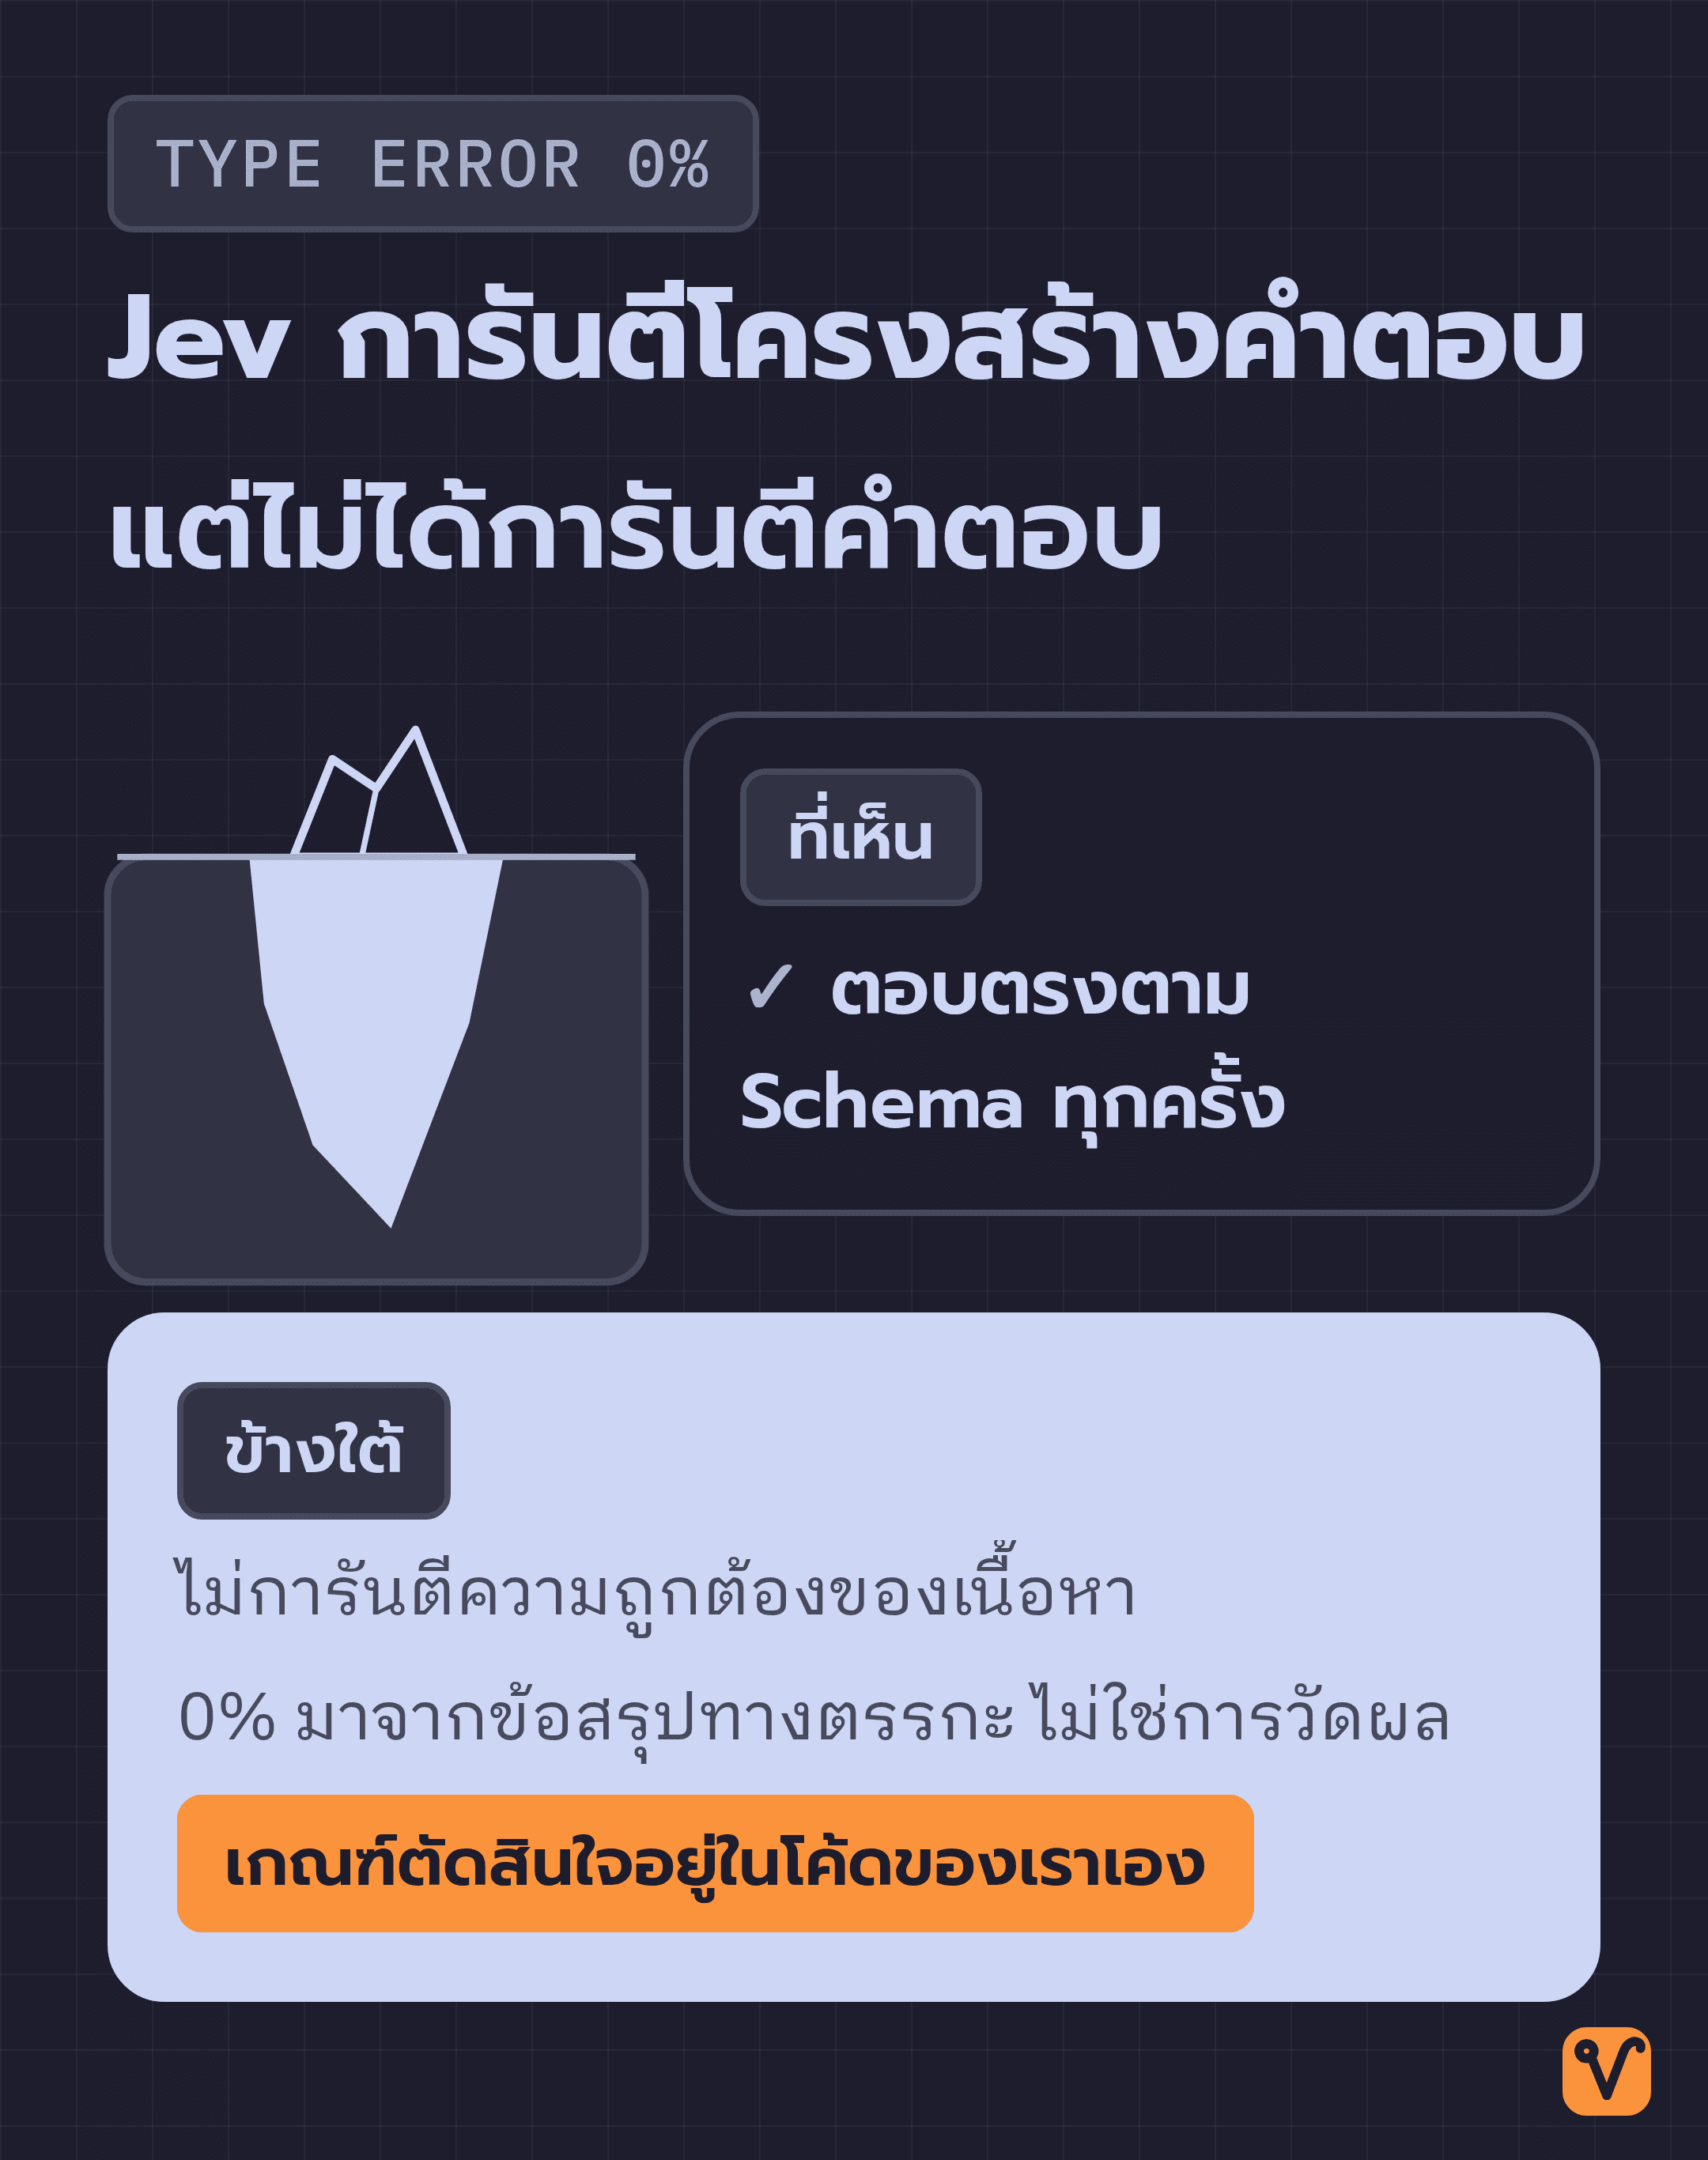
TypeSafe ระบุว่า Jev ไม่มีโอกาสเกิด Type Error หรือข้อผิดพลาดด้านชนิดข้อมูลขึ้นได้เลยในเชิงตรรกะ เพราะโครงสร้างคำตอบต้องตรงตามแบบแผน Schema ที่กำหนดไว้ล่วงหน้าเสมอ ทั้งนี้ ทีมงานชี้แจงว่าตัวเลข 0% ในกราฟไม่ได้เกิดจากการทดลองสุ่มวัดผล แต่เป็นข้อสรุปทางตรรกะ ซึ่งถ้ามีใครพบเคสที่หลุดจากโครงสร้างได้แม้แต่เคสเดียว ข้อสรุปนี้ก็เป็นอันตกไปทันที
นี่คือจุดสำคัญที่หลายคนอาจเข้าใจผิด เพราะสิ่งที่โมเดลรับประกันคือ "โครงสร้างของคำตอบ" ไม่ใช่ "ความถูกต้องของเนื้อหา" Jev ไม่สามารถการันตีได้ว่าสิ่งที่ตอบมานั้นถูกต้อง สิ่งที่มันบอกได้มีเพียงระดับความมั่นใจเท่านั้น
และระดับความมั่นใจนี้เองคือสิ่งที่ TypeSafe ให้ความสำคัญมากที่สุด ทีมงานฝึกฝนโมเดลด้วยเทคนิคการเรียนรู้เพื่อปรับระดับความมั่นใจอย่าง RLCD ซึ่งแตกต่างจาก LLM ทั่วไปที่มักฝึกด้วยวิธี RLHF ที่ใช้ความชอบของมนุษย์เป็นเกณฑ์ หรือวิธี RLVR ที่ใช้โปรแกรมตรวจคำตอบตายตัว เป้าหมายของ RLCD คือทำให้ตัวเลขความมั่นใจสะท้อนความเป็นจริงมากที่สุด นั่นคือเมื่อโมเดลบอกว่ามั่นใจสูง คำตอบต้องถูกต้องบ่อยกว่าตอนที่โมเดลบอกว่ามั่นใจต่ำ
ด้วยเหตุนี้ การตัดสินใจขั้นสำคัญที่สุดจึงไม่ได้ขึ้นอยู่กับตัวโมเดล แต่อยู่ที่โค้ดของระบบเราเอง Jev ส่งคำตอบที่ระบุชนิดข้อมูลชัดเจนกลับมาพร้อมค่าความน่าจะเป็นและค่าความมั่นใจกำกับ แต่ไม่ได้ชี้ขาดแทนเราว่าระบบควรลงมือทำหรือไม่ เราจึงต้องเป็นผู้กำหนดเกณฑ์เองว่า ถ้าค่าความน่าจะเป็นเกินเท่าใดจึงจะให้ระบบทำงานต่อโดยอัตโนมัติ และระดับใดที่ต้องส่งต่อให้ทีมงานช่วยตรวจสอบ ถ้าเรารีบแปลงค่าความน่าจะเป็นให้เหลือเพียง ใช่ หรือ ไม่ใช่ ทันที ก็เท่ากับเราทิ้งจุดเด่นสำคัญที่ทำให้ Jev แตกต่างจากการสั่งให้ LLM ตอบเป็นโครงสร้างตายตัวไปอย่างน่าเสียดาย เพราะในระบบจริง เคสที่ก้ำกึ่งอาจหลุดรอดการตรวจสอบไปได้โดยไม่มีใครสังเกตเห็น
บทบาทของ Jev: ทำงานเคียงข้าง LLM ไม่ใช่เข้ามาแทนที่
Jev สร้างข้อความไม่ได้ จึงไม่สามารถนำไปใช้แทนโมเดลภาษาหลักได้โดยตรง รูปแบบการใช้งานจริงคือปล่อยให้ LLM ทำหน้าที่เขียนข้อความและคิดวิเคราะห์ในงานที่ต้องใช้เหตุผลตามปกติ แล้วนำ Jev เข้ามาเสริมในลูปการทำงานเดียวกัน เพื่อช่วยตัดสินใจงานย่อยๆ ระหว่างทางได้อย่างรวดเร็ว
ตัวอย่างการนำไปใช้จริงที่เห็นภาพชัดมี 2 รูปแบบ:
- Model Routing หรือการเลือกส่งงานให้เหมาะกับโมเดล: ก่อนส่งคำขอของผู้ใช้เข้าไปในระบบหลัก เราสามารถให้ Jev ช่วยประเมินก่อนว่าคำขอนี้เป็นงานทั่วไปที่ใช้โมเดลราคาประหยัดก็เพียงพอ หรือเป็นงานซับซ้อนที่จำเป็นต้องใช้โมเดลตัวเก่ง แนวคิดนี้เป็นแนวทางเดียวกับเทคนิคใน OpenSquilla สลับโมเดลตามความยากของงาน แต่ Jev ต่างออกไปตรงที่มีค่าใช้จ่ายต่ำและทำงานเร็วมาก จนแทบไม่รู้สึกว่าระบบมีขั้นตอนนี้เพิ่มเข้ามา
- ระบบป้องกันคำสั่งอันตรายอย่าง Guardrail: ก่อนที่ Agent จะเรียกใช้เครื่องมือที่มีผลกระทบต่อเครื่องจริง เช่น สั่งรันคำสั่ง
bashเราสามารถให้ Jev ช่วยประเมินความเสี่ยงล่วงหน้าเพื่อสั่งบล็อกคำสั่งได้ทันที แทนที่จะต้องตามไปแก้ไขหลังจากคำสั่งทำงานไปแล้ว ในอดีต กระบวนการนี้มีค่าใช้จ่ายสูงเกินไปสำหรับตรวจสอบทุกขั้นตอน เพราะต้องเรียก LLM ตัวเต็มทุกครั้ง แต่เมื่อต้นทุนการตัดสินใจลดลงเป็นหลักร้อยเท่า การตรวจเช็กความปลอดภัยตลอดเวลาจึงคุ้มค่าขึ้นมาทันที
หน้าที่สำคัญของนักพัฒนาคือการกำหนดระดับความเข้มงวดในการป้องกัน ถ้ากำหนดเกณฑ์ตึงเกินไป Agent ก็จะติดขัดแม้กับคำสั่งทั่วไปที่ปลอดภัย แต่ถ้ากำหนดหย่อนเกินไป ระบบป้องกันก็จะไม่เกิดผล ซึ่งเส้นแบ่งนี้ควรตั้งขึ้นจากตัวเลขความน่าจะเป็นที่ Jev ส่งกลับมา ไม่ใช่การคาดเดาจากความรู้สึก
ข้อจำกัดที่ควรรู้ก่อนวางแผนใช้งาน Jev
ก่อนตัดสินใจนำ Jev ไปปรับใช้ในระบบ มีข้อจำกัดสำคัญ 3 ประการที่ควรพิจารณา:
- ข้อจำกัดเรื่องจำนวนตัวเลือก: คำถามประเภท Choice สามารถรองรับได้สูงสุด 255 ตัวเลือก แต่เมื่อตัวเลือกมีจำนวนมากถึงระดับหนึ่ง Jev จะเปลี่ยนไปประมวลผลเป็นสองขั้นตอน โดยให้คะแนนแต่ละตัวเลือกแยกกันก่อน แล้วจึงเลือกคำตอบภายหลัง ทำให้บางกรณีประมวลผลช้าลง ดังที่เห็นได้จากเดโมเกมท่องเว็บ Wikiracing ที่ผู้เล่นต้องเดินทางจากหน้าบทความ Wikipedia หนึ่งไปยังอีกหน้าผ่านการคลิกลิงก์ และในแต่ละขั้นตอนจำเป็นต้องเลือกจากลิงก์จำนวนมาก
- ไม่รองรับการสร้างเนื้อหา: Jev ไม่สามารถสรุปบทความ ร่างอีเมล หรือเขียนโค้ดได้ งานใดก็ตามที่ผลลัพธ์สุดท้ายต้องออกมาเป็นข้อความบรรยาย ยังคงต้องพึ่งพา LLM ทั่วไปเช่นเดิม
- สถานะยังเป็น Early Access: ปัจจุบัน Jev ยังเปิดให้ทดลองใช้งานเฉพาะกลุ่ม หากต้องการวางแผนระบบในระยะยาว ควรออกแบบโครงสร้างโค้ดให้สามารถสลับเปลี่ยนโมเดลตัดสินใจนี้ได้ง่าย เพื่อไม่ให้ระบบขึ้นอยู่กับผู้ให้บริการรายเดียว ส่วนเรื่องราคา TypeSafe ยอมรับตรงๆ ว่ายังยืนยันไม่ได้ว่าราคานี้ไม่ได้อาศัยเงินทุนมาช่วยอุดหนุน และยังต้องรอดูว่าราคาจะคงระดับนี้ได้จริงในระยะยาวหรือไม่
เมื่อต้นทุนการตัดสินใจลดลงเป็นร้อยเท่า
ชื่อ Jev ได้แรงบันดาลใจมาจาก William Stanley Jevons นักเศรษฐศาสตร์ผู้ตั้งข้อสังเกตว่า เมื่อเครื่องจักรไอน้ำพัฒนาจนใช้ถ่านหินได้อย่างมีประสิทธิภาพมากขึ้น ปริมาณการใช้ถ่านหินในภาพรวมกลับเพิ่มสูงขึ้นอย่างมาก ไม่ได้ลดลงตามที่คาดการณ์ไว้
TypeSafe นำแนวคิดดังกล่าวมาเทียบกับต้นทุนการตัดสินใจของ AI คำถามสำคัญสำหรับเราจึงไม่ใช่ว่าจะนำ Jev ไปแทนโมเดลตัวไหน แต่คือ "มีคำถามหรือการตัดสินใจเรื่องใดบ้าง ที่เราไม่เคยคิดจะส่งให้โมเดล AI ช่วยตอบเลย เพราะรู้สึกมาตลอดว่าไม่คุ้มค่าทั้งเรื่องเวลาและค่าใช้จ่าย"
ที่มา: เอกสารทางการของ Jev
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ