Gemini 3.8 Flash TTS โมเดลเสียง AI ใหม่จาก Google โคลนเสียงตัวเองได้ กำกับอารมณ์ได้ทีละบรรทัด และเป็นรุ่นเดียวในสองรุ่นที่รองรับภาษาไทย
Gemini 3.8 Flash TTS โมเดลแปลงข้อความเป็นเสียงตัวใหม่ของ Google โคลนเสียงตัวเองและกำกับอารมณ์ได้ทีละบรรทัด ส่วนคนไทยต้องรู้ว่า Flash-Lite ไม่รองรับภาษาไทย
Gemini 3.8 Flash TTS คือโมเดลแปลงข้อความเป็นเสียงรุ่นใหม่ล่าสุดจาก Google ที่เปิดให้เรากำกับการพูดได้อย่างละเอียด ทั้งการหัวเราะ ถอนหายใจ หรือเว้นจังหวะสั้นยาวตามต้องการ
สำหรับพ่อค้าแม่ค้าออนไลน์ที่ต้องทำคลิปขายของทุกสัปดาห์ หรือครีเอเตอร์ที่ทำคลิปสอนใช้งาน การอัดเสียงพากย์เองทุกคลิปอาจเหนื่อยและใช้เวลาเยอะ แต่ถ้าเคยใช้เสียง AI ทั่วไปอ่านแทน ก็มักจะเจอกับเสียงที่อ่านครบทุกคำแต่ฟังดูแบนเหมือนหุ่นยนต์ ไม่มีจังหวะและไร้อารมณ์
สิ่งที่ Google ประกาศเมื่อวันที่ 23 กันยายน 2026 ฉีกไปคนละทางกับเสียงแบบนั้น โดยออกแบบให้เราสั่งงานเสียง AI ได้เหมือนผู้กำกับที่กำลังสั่งนักพากย์ เพียงแค่ส่งบทให้ แล้วกำหนดได้เลยว่าแต่ละท่อนต้องการให้ออกอารมณ์แบบไหน
โมเดลที่เปิดตัวในรอบนี้มี 2 รุ่น ได้แก่ Flash TTS และ Gemini 3.8 Flash-Lite TTS นอกจากนี้ยังมาพร้อมความสามารถเด่นอีก 2 อย่าง คือ Voice Design ที่สร้างเสียงใหม่จากคำอธิบายลักษณะเสียง และ Voice Replication ที่ให้เราโคลนเสียงตัวเองจากคลิปเสียงสั้นๆ
ในตระกูลโมเดลเสียง Gemini Audio ของ Google มี Gemini 3.5 Transcribe สำหรับงานถอดเสียงพูดเป็นข้อความอยู่แล้ว สองรุ่นนี้เข้ามาเติมฝั่งแปลงข้อความเป็นเสียงพูดในตระกูลเดียวกัน และทั้ง 2 รุ่นเปิดให้ลองใช้ฟรีแล้วบน Google AI Studio หน้าเว็บทดลองของ Google
เลือกระหว่าง Flash กับ Flash-Lite: เช็กเรื่องภาษาก่อนดูราคา
Google ออกแบบทั้ง 2 รุ่นนี้มาให้ใช้กับงานต่างกันชัดเจน:
- Gemini 3.8 Flash TTS เหมาะกับงานที่เน้นคุณภาพเสียงเป็นหลัก ต้องถ่ายทอดอารมณ์ละเอียด สำเนียงเป็นธรรมชาติ และรองรับภาษาถิ่น โดยเอกสารแนะนำให้ใช้กับงานพอดแคสต์ หนังสือเสียง หรือบทสนทนาที่มีคนคุยกัน 2 คน
- Gemini 3.8 Flash-Lite TTS เหมาะกับงานปริมาณมากที่ต้องการความเร็วและความประหยัด เช่น งานพากย์คลิปจำนวนมาก หรือ Voice Agent ที่เป็นระบบบอทเสียงคุยโต้ตอบกับผู้ใช้งาน
ถ้าดูแค่นี้ คนที่ต้องทำคลิปจำนวนมากคงอยากเลือก Flash-Lite เพราะประหยัดกว่า แต่พอเช็กตารางภาษาในเอกสารทางการ คำตอบกลับเปลี่ยนทันที
เพราะ Flash TTS รองรับ 130 ภาษา และมีภาษาไทย ส่วน Flash-Lite TTS รองรับ 101 ภาษา แต่ไม่มีภาษาไทย
ตรงนี้พลาดง่าย เพราะในประกาศเปิดตัวระบุแบบกว้างๆ ว่ารองรับมากกว่า 100 ภาษา ซึ่งก็จริงสำหรับทั้ง 2 รุ่น แต่ไม่ได้บอกให้ชัดว่าภาษาไทยมีให้ใช้เฉพาะในรุ่น Flash TTS เท่านั้น
ถ้าต้องการสร้างเสียงภาษาไทย ในสองรุ่นนี้จึงเหลือทางเลือกเดียวคือรุ่น Flash TTS ไม่ว่างานของคุณจะเป็นพอดแคสต์หรือคลิปขายของก็ตาม
สำหรับฝั่งนักพัฒนา ทั้ง 2 รุ่นนี้เรียกใช้งานผ่าน API Request รูปแบบเดียวกันทั้งหมด การสลับรุ่นจึงแก้แค่ชื่อโมเดลเป็น gemini-3.8-flash-tts หรือ gemini-3.8-flash-lite-tts เท่านั้น ส่วนเรื่องภาษาไม่ต้องตั้งค่าเพิ่ม เพราะตัวโมเดลจะตรวจจับภาษาจากข้อความที่ส่งเข้าไปให้โดยอัตโนมัติ
4 วิธีเลือกและสร้างเสียง ตั้งแต่เสียงสำเร็จรูปไปจนถึงโคลนเสียงตัวเอง
หลังจากเลือกรุ่นโมเดลได้แล้ว ขั้นตอนถัดไปคือการเลือกเสียง ซึ่งระบบมีตัวเลือกให้ทั้งหมด 4 รูปแบบ:
- เสียงสำเร็จรูป Preset Voices 30 เสียง แต่ละเสียงจะมีชื่อเฉพาะตัว เช่น Kore, Puck และ Charon กดเลือกแล้วใช้ได้ทันที เหมาะมากสำหรับการลองใช้ครั้งแรก
- คลังเสียงเพิ่มเติมอย่าง Extended Voice Library ทาง Google ระบุว่ามีให้เลือกมากกว่า 2,000 เสียง ครอบคลุมหลากหลายภาษาและสำเนียง โดยเข้าไปเลือกฟังตัวอย่างเสียงได้ใน AI Studio
- ออกแบบเสียงใหม่ด้วยข้อความผ่าน Voice Design เราพิมพ์บอกลักษณะเสียงที่ต้องการเป็นภาษาพูดทั่วไปได้เลย เช่น กำหนดบทบาท สำเนียง หรือโทนเสียง แล้วระบบจะสร้างเสียงใหม่พร้อมตัวอย่างให้ลองฟัง
- โคลนเสียงจริงด้วย Voice Replication เป็นการโคลนเสียงของบุคคลจริงจากคลิปเสียงสั้นๆ โดยระบบบังคับว่าเจ้าของเสียงต้องอัดเสียงยินยอมด้วยเสมอ
ฟีเจอร์ Voice Design เหมาะมากสำหรับคนที่ต้องการสร้างเสียงเอกลักษณ์ประจำแบรนด์ หรือเสียงตัวละครที่ไม่ซ้ำใคร ตัวอย่างในประกาศของ Google มีตั้งแต่เสียงมังกรพ่นไฟที่ดุดัน ไปจนถึงเสียงผู้บรรยายที่มีสำเนียงท้องถิ่นเฉพาะตัว เสียงที่สร้างขึ้นใหม่จะได้รหัส ID ที่ขึ้นต้นด้วย voice_ ซึ่งเราสามารถบันทึกไว้เรียกใช้ซ้ำได้ตลอด ทำให้ทุกคลิปของแบรนด์ใช้เสียงเดียวกันได้อย่างต่อเนื่อง
นอกจากนี้ Google ยังระบุว่าจะมีฟีเจอร์ Voice Remixing ตามมาเร็วๆ นี้ ซึ่งจะช่วยให้เราหยิบเสียงที่มีอยู่ในคลังมาปรับแต่งเพิ่มเติมได้ เช่น ปรับเนื้อเสียง ความสูงต่ำของเสียง ความเร็ว และสำเนียง ผ่านคำสั่งง่ายๆ อย่าง "ช่วยปรับให้น้ำเสียงนุ่มนวลขึ้น"
โคลนเสียงตัวเองด้วย Voice Replication ผ่านไฟล์เสียง 2 ชุด
ก่อนจะเริ่มอัดเสียงตัวเองส่งเข้าระบบ มีเรื่องสำคัญเรื่องหนึ่งที่ต้องพิจารณาให้ดี คือหน้าราคาของ Google ที่แบ่งการใช้งานออกเป็น 2 รูปแบบ ได้แก่ Free tier สำหรับใช้งานฟรี และ Paid tier สำหรับแบบชำระเงิน
ใน Free tier ระบุไว้ว่า Google นำเนื้อหาที่ใช้งานไปปรับปรุงผลิตภัณฑ์ของตนเอง ขณะที่ Paid tier ระบุว่าไม่นำไปใช้ ไฟล์เสียงที่เราอัดส่งเข้าไปก็เป็นเนื้อหาชนิดหนึ่ง จึงควรเลือกระดับการใช้งานให้รอบคอบก่อนเริ่มต้นอัดเสียง
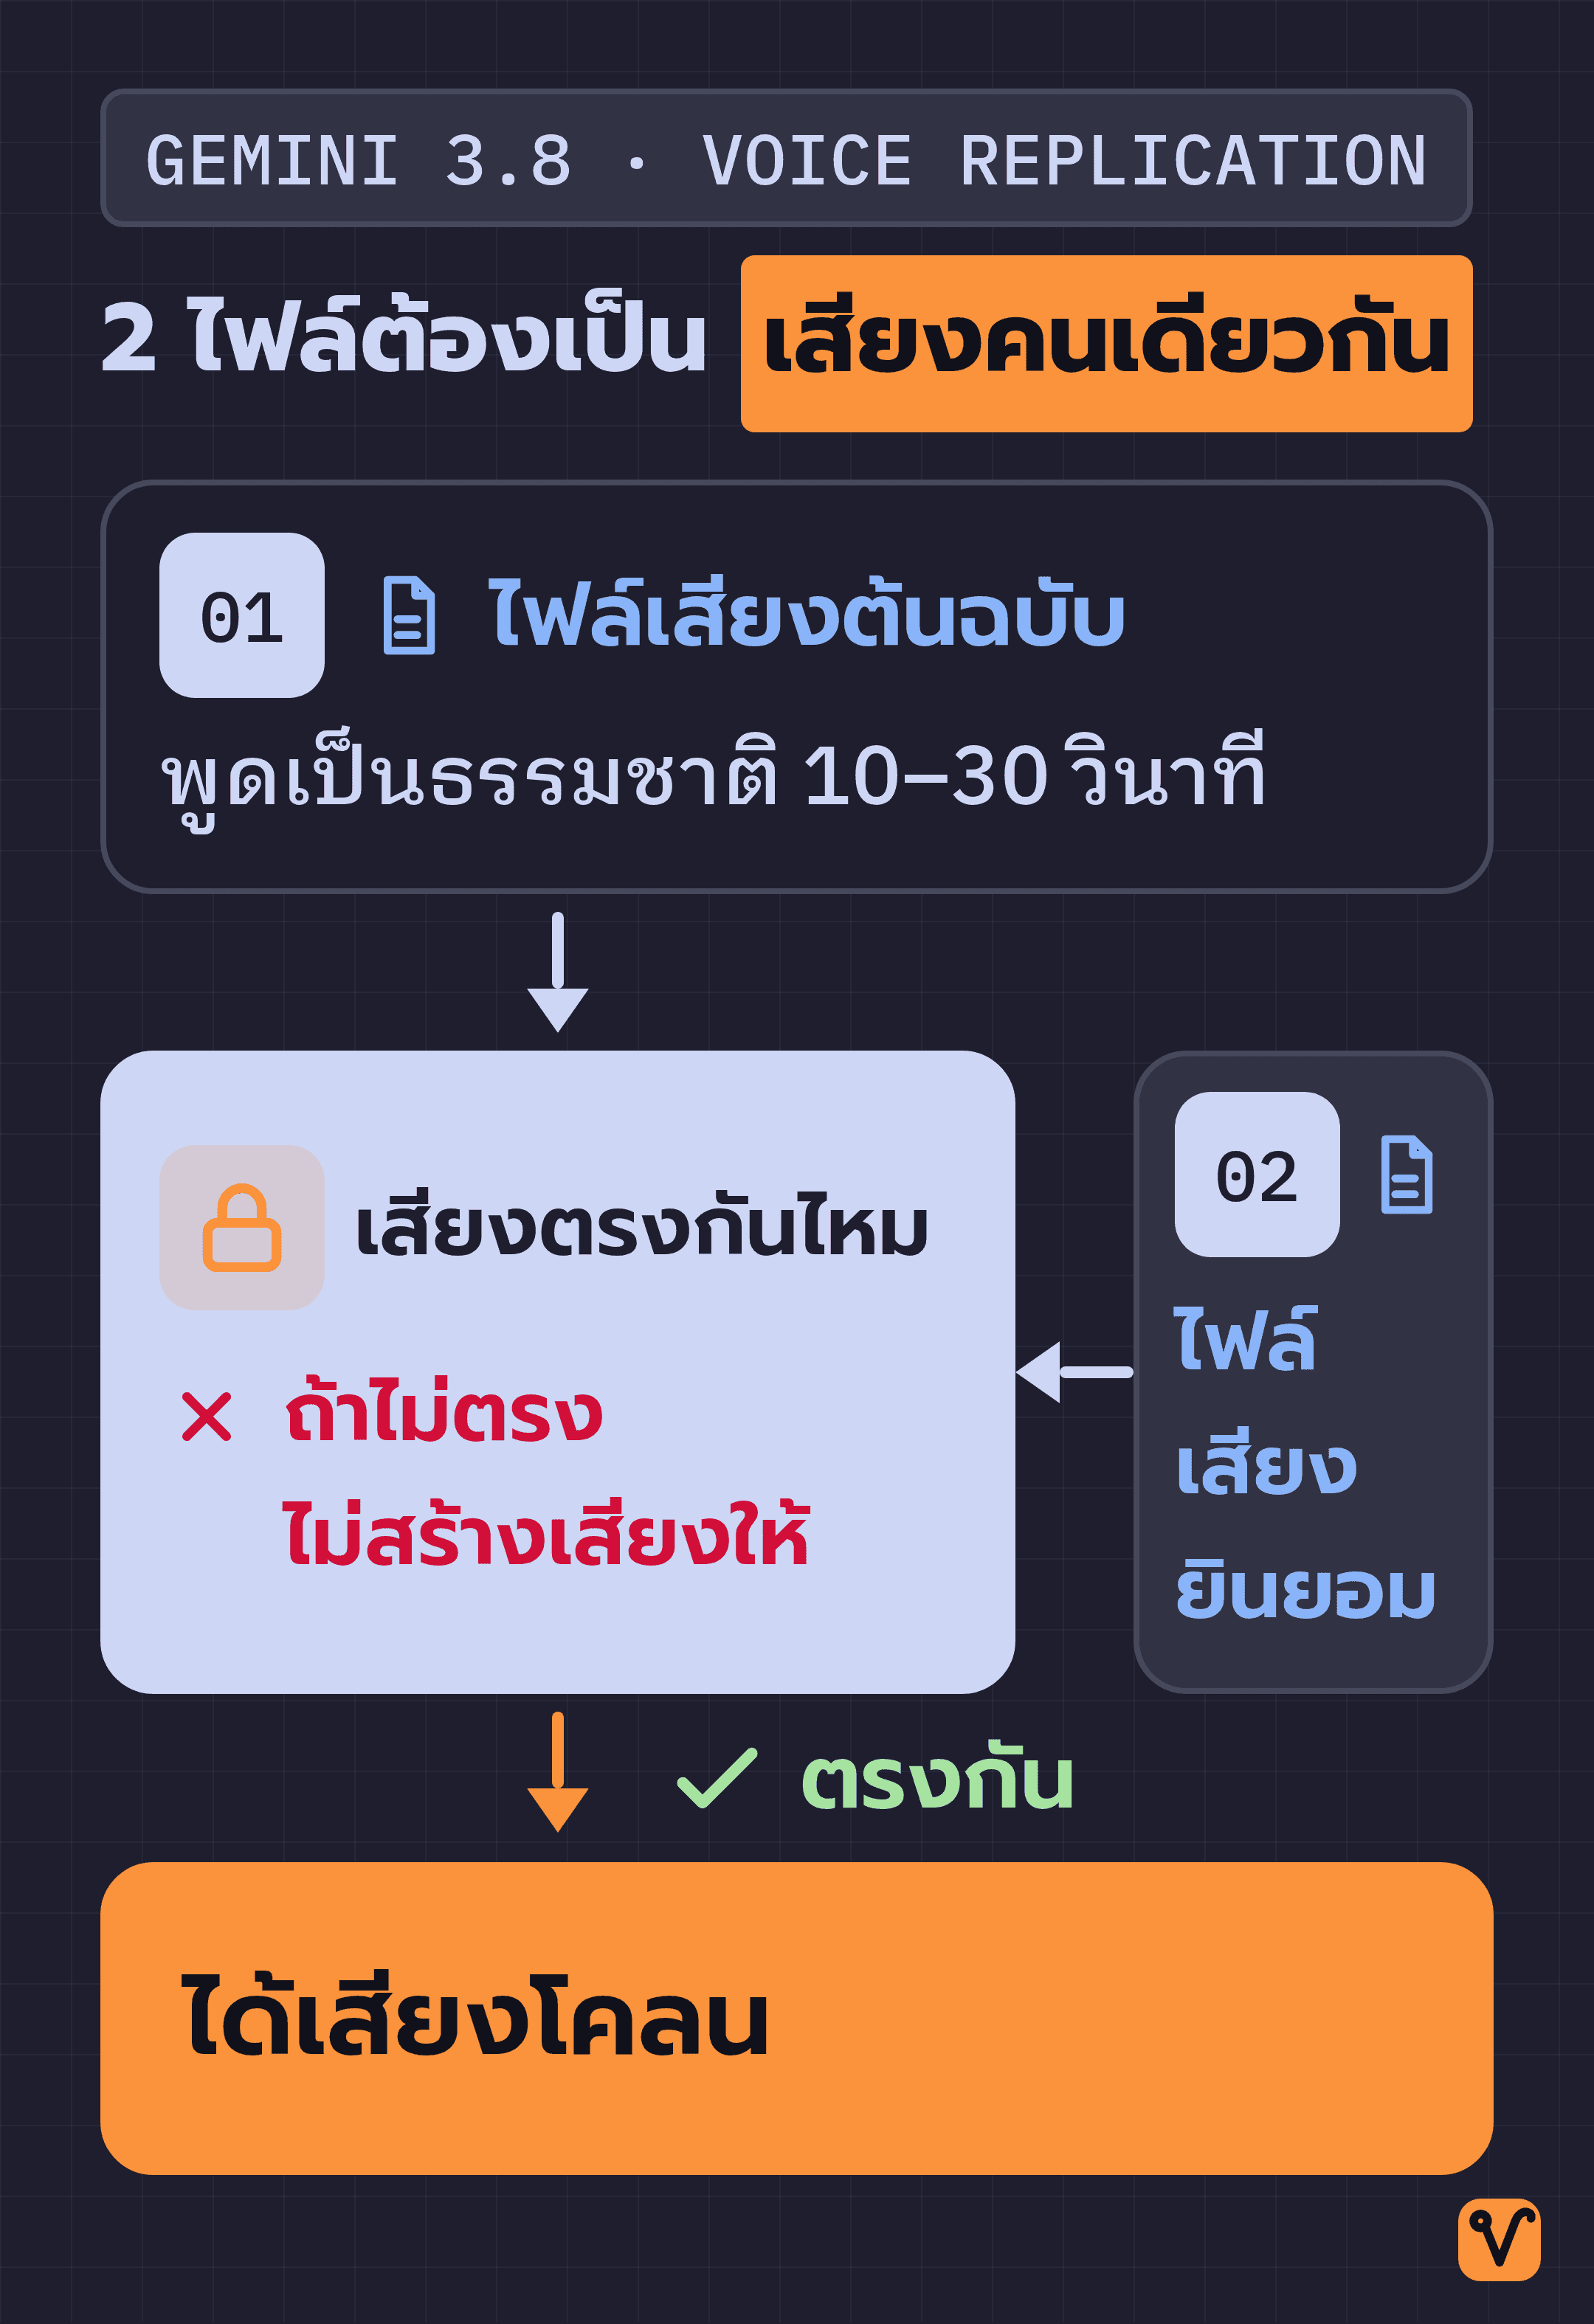
สำหรับการโคลนเสียง ระบบจะกำหนดให้ใช้ไฟล์เสียงจริงของผู้ใหญ่คนเดียวกันจำนวน 2 ไฟล์ ซึ่งทำหน้าที่ต่างกัน:
- ไฟล์เสียงต้นฉบับ: เป็นคลิปเสียงพูดแบบธรรมชาติ ความยาวประมาณ 10 ถึง 30 วินาที และต้องมีเสียงรบกวนน้อยที่สุด ชิ้นนี้คือเสียงที่ระบบจะนำไปเป็นต้นแบบในการสร้างเสียงโคลน
- ไฟล์เสียงยินยอม: ให้เจ้าของเสียงคนเดิมอ่านข้อความยินยอมตามที่ Google กำหนดไว้อย่างชัดเจน ซึ่งมีฉบับภาษาไทยให้ด้วย
ข้อความภาษาไทยที่ต้องอ่านตามเอกสารแบบคำต่อคำ คือ:
ฉันเป็นเจ้าของเสียงนี้ และฉันยินยอมให้ Google ใช้เสียงนี้เพื่อสร้างแบบจำลองเสียงสังเคราะห์จุดที่ชวนสับสนคือ ไฟล์เสียงชิ้นที่สองนี้ไม่ใช่ตัวอย่างเสียงเพิ่มเติม แต่มีไว้เป็นหลักฐานว่าเจ้าของเสียงยินยอม เพราะก่อนจะเริ่มสร้างเสียงโคลน ระบบจะตรวจสอบและเปรียบเทียบว่าคนที่อ่านข้อความยินยอมเป็นคนเดียวกับเจ้าของเสียงในคลิปต้นฉบับหรือไม่ ถ้าเสียงไม่ตรงกัน ระบบจะไม่สร้างเสียงให้ หมายความว่าเราจะนำคลิปเสียงของคนอื่นมาโคลนผ่านขั้นตอนนี้ไม่ได้ ถ้าเจ้าของเสียงตัวจริงไม่ได้มาอ่านข้อความยินยอมนี้ด้วยตัวเอง
ด้วยเหตุนี้ คำแนะนำเรื่องการอัดเสียงในเอกสารจึงสำคัญมาก:
- ควรอัดเสียงในห้องที่เงียบสนิท ไม่มีเสียงก้อง ไม่มีเสียงเพลง หรือเสียงคนอื่นแทรกเข้ามา
- ควรใช้ไมโครโฟนตัวเดิมและอัดในห้องเดิมทั้ง 2 ไฟล์ เพื่อให้ผ่านขั้นตอนตรวจสอบว่าเป็นคนเดียวกันได้อย่างราบรื่น
หากต้องการอัปโหลดเป็นไฟล์เสียง รูปแบบที่เอกสารแนะนำคือไฟล์ WAV ความละเอียด 24kHz ระบบเสียงโมโนแบบ 16-bit
บน Google AI Studio เราเลือกได้ว่าจะอัดเสียงสดผ่านเว็บเบราว์เซอร์หรืออัปโหลดไฟล์เข้าไป พอระบบสร้างเสร็จ ก็ลองฟังตัวอย่างเสียง แล้วคัดลอกรหัส ID ที่ขึ้นต้นด้วย voice_ ไปใส่ในโค้ดเพื่อเรียกใช้งานได้ทันที เสียงที่บันทึกไว้ในระบบมีอายุการใช้งาน 1 ปี และ 1 โปรเจกต์เก็บเสียงได้สูงสุด 200 เสียง (นับรวมทั้งเสียงที่โคลนและเสียงที่สร้างจาก Voice Design)
นอกจากนี้ ในหมายเหตุท้ายประกาศของ Google ยังระบุไว้ว่า ฟีเจอร์โคลนเสียงผ่าน AI Studio ไม่เปิดให้บริการในพื้นที่เหล่านี้ ได้แก่ รัฐอิลลินอยส์และเท็กซัสในสหรัฐอเมริกา, กลุ่มประเทศเขตเศรษฐกิจยุโรป (EEA), สหราชอาณาจักร, สวิตเซอร์แลนด์ และอินเดีย
วิธีใส่บทและกำกับอารมณ์: แยกข้อความพูดกับคำสั่งอารมณ์ออกจากกัน
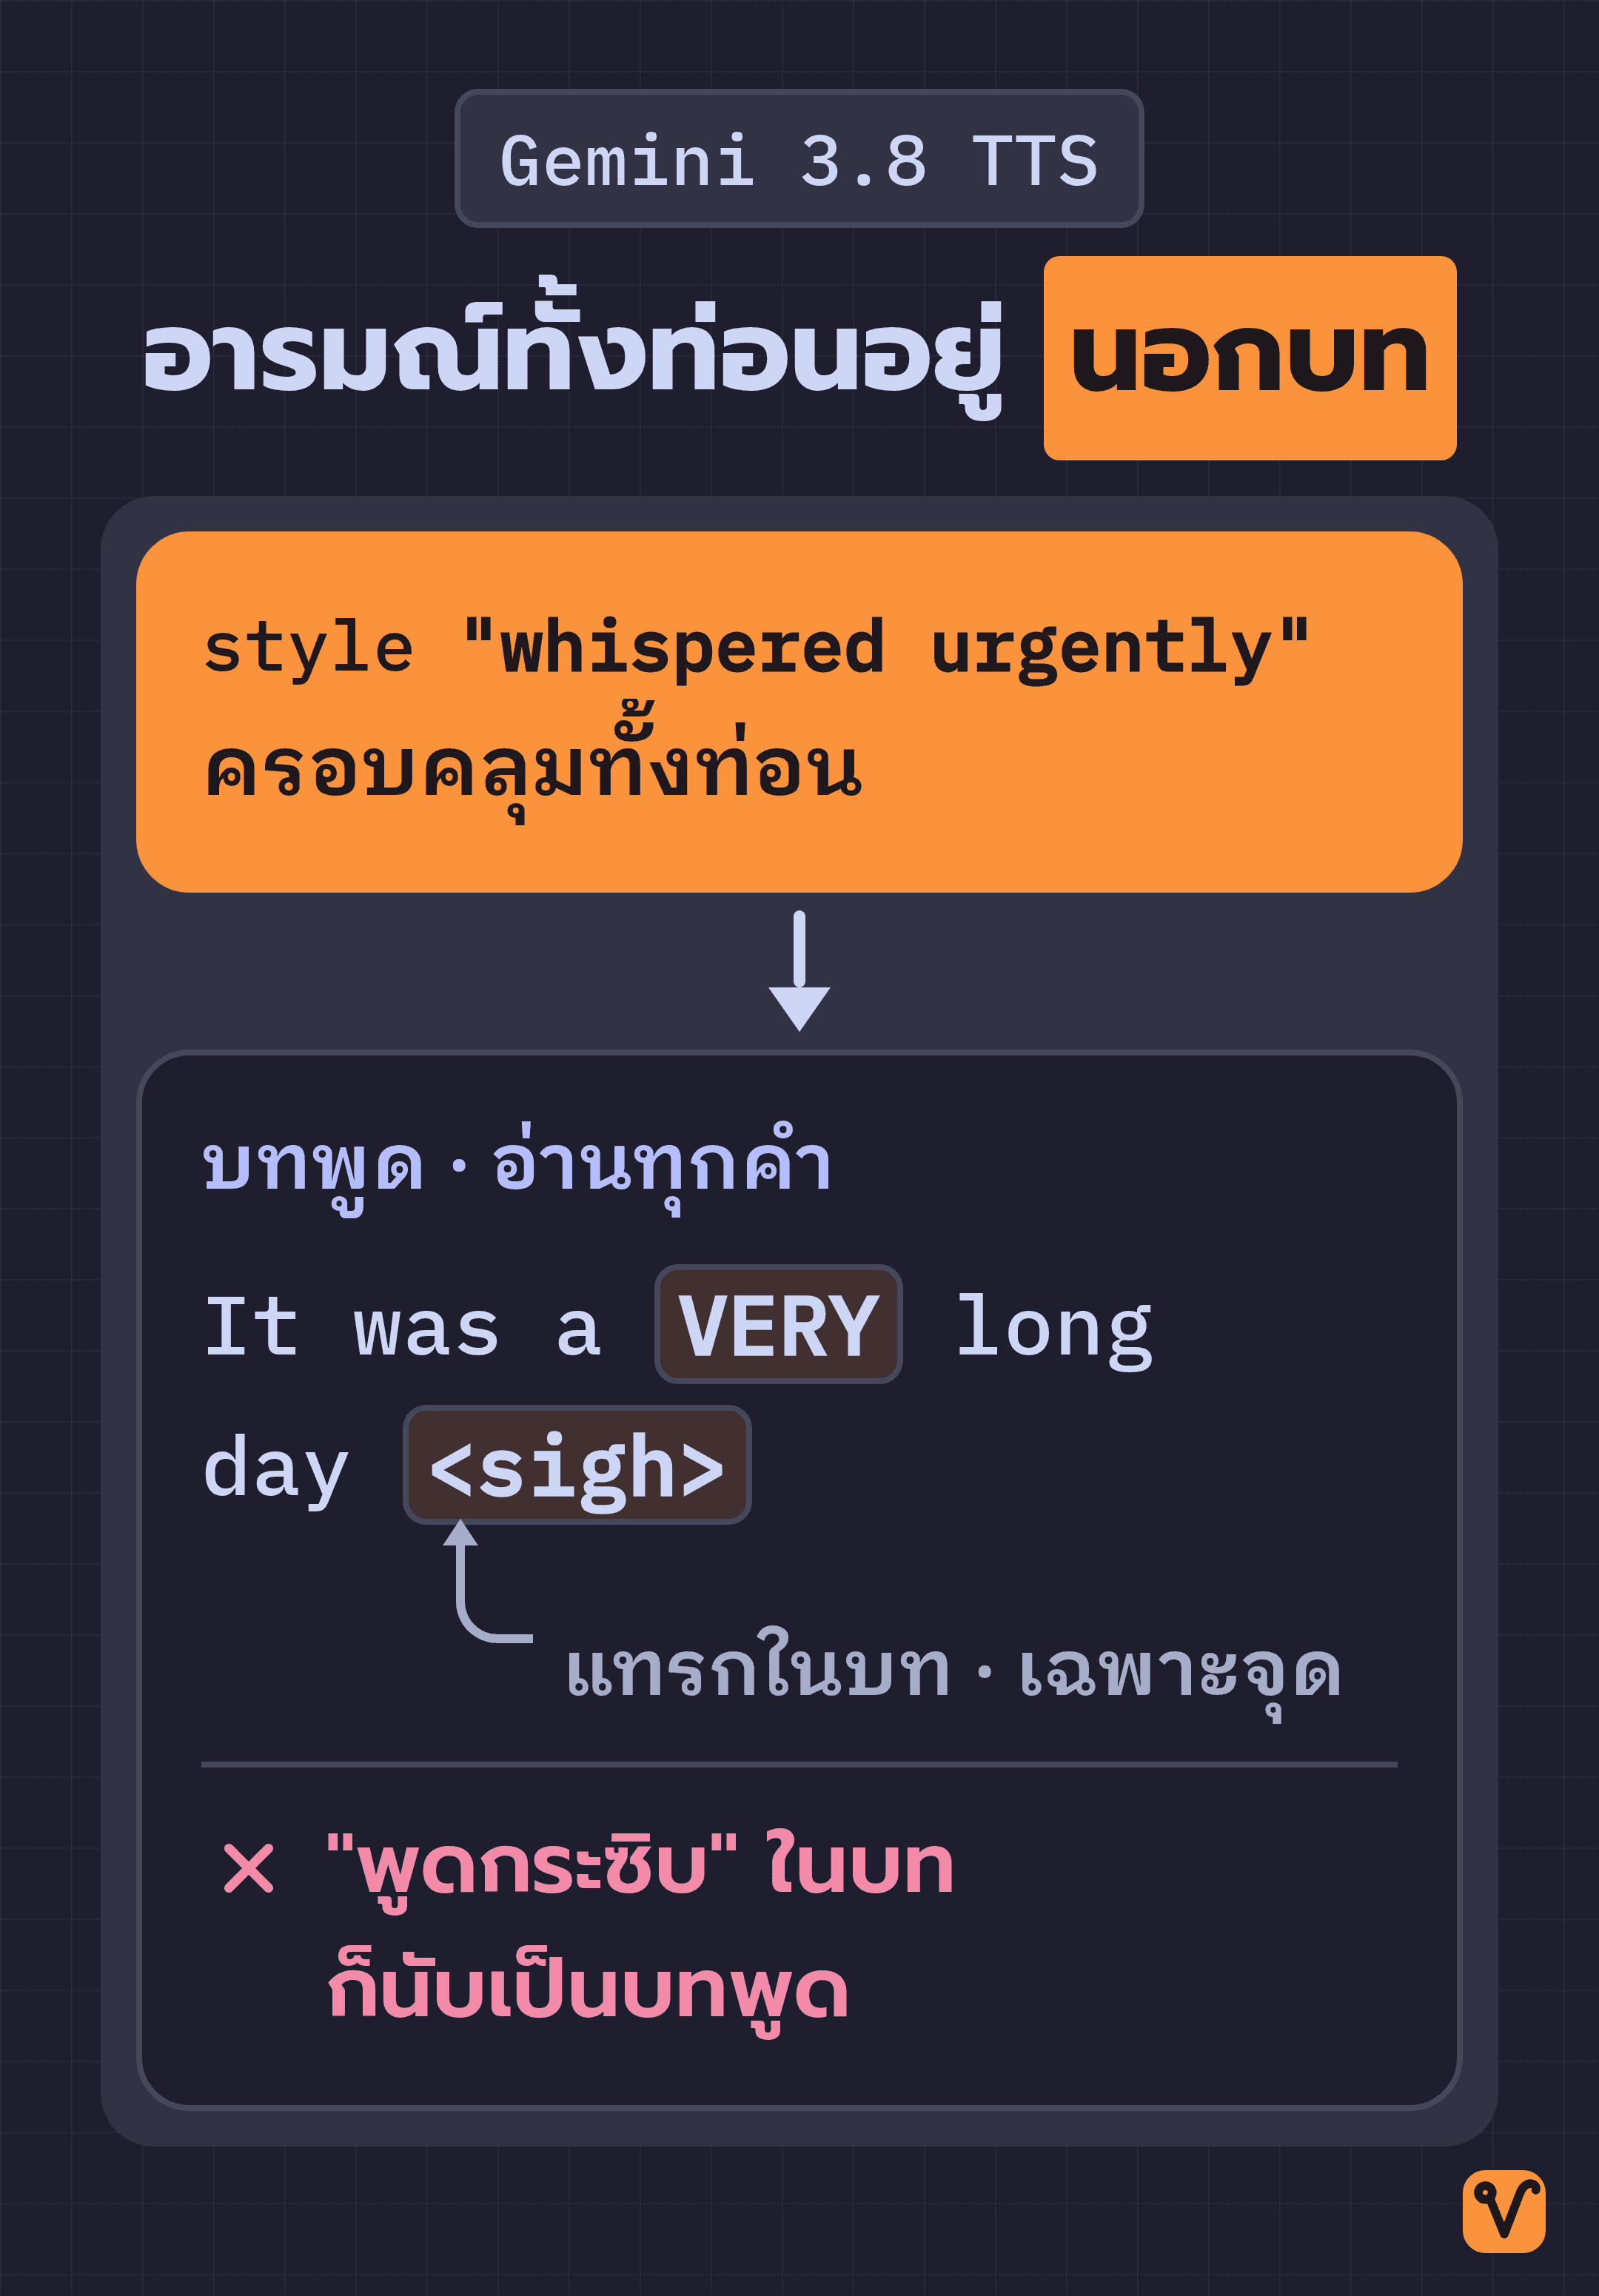
ถ้าเปรียบเสียง AI เป็นนักพากย์ ข้อความที่เราป้อนเข้าไปก็คือบทพูด ซึ่ง Gemini 3.8 TTS จะอ่านข้อความนั้นตรงตามตัวอักษรทุกคำ
สิ่งที่ต้องระวังคือ อย่าใส่คำสั่งอารมณ์ปนเข้าไปในเนื้อหาบทพูดเด็ดขาด เช่น หากเราพิมพ์คำกำกับอย่าง "พูดกระซิบ" ลงไปในช่องข้อความ คำนั้นก็นับเป็นบทพูดด้วย
ดังนั้น เครื่องมือกำกับการแสดงจึงแยกออกเป็น 4 รูปแบบ โดยแบ่งเป็นคำสั่งที่อยู่นอกบท 1 รูปแบบ และคำสั่งที่แทรกไว้ในเนื้อบท 3 รูปแบบ:
- ช่อง Style (
speech_metadata.style): ใช้กำหนดอารมณ์ จังหวะ และระดับความดังที่ครอบคลุมเนื้อหาทั้งท่อน เช่น"style": "warm and enthusiastic"หรือ"style": "whispered urgently" - แท็กในวงเล็บสามเหลี่ยม
< >: ใช้สำหรับแทรกอารมณ์หรือกิริยาเฉพาะจุด เช่น<laugh>(หัวเราะ),<sigh>(ถอนหายใจ),<gasp>(ตกใจ/อ้าปากค้าง),<short pause>(หยุดพักช่วงสั้น) และ<long pause>(หยุดพักช่วงยาว) - ตัวพิมพ์ใหญ่: ใช้สำหรับเน้นเสียงหนักที่คำใดคำหนึ่ง ถ้าพิมพ์คำไหนเป็นตัวพิมพ์ใหญ่ AI จะลงน้ำหนักเสียงที่คำนั้นมากขึ้น
- เครื่องหมายขีดแนวตั้ง
|: ใช้สำหรับบทสนทนา 2 คน เพื่อใส่เสียงตอบรับสั้นๆ ของผู้ฟังแทรกไว้กลางประโยคของผู้พูดหลัก โดยไม่ต้องแยกบทพูดขึ้นบรรทัดใหม่
ตัวอย่างจากเอกสารของ Google ที่ใช้ครบทั้งแท็ก ตัวพิมพ์ใหญ่ และเครื่องหมาย |:
Wait... <short pause> did you hear that? <sigh>
It was a VERY long day <sigh> ... nobody listens anymore.
So the launch is Thursday |oh hmm| Are we actually ready?เมื่อดูทีละบรรทัด: บรรทัดแรกจะเว้นจังหวะสั้นๆ กลางประโยค แล้วปิดท้ายด้วยเสียงถอนหายใจ บรรทัดที่สองจะเน้นน้ำหนักเสียงที่คำว่า VERY ก่อนถอนหายใจ ส่วนบรรทัดที่สาม ระหว่างที่คนหนึ่งกำลังพูด อีกคนก็แทรกเสียงตอบรับ oh hmm เข้ามากลางประโยคได้ทันทีโดยไม่ต้องขึ้นบทใหม่
ถ้าจะใช้เครื่องมือเหล่านี้กับบทภาษาไทย เราแนะนำให้เริ่มจากสคริปต์สั้นๆ สักย่อหน้า แล้วฟังเองว่าเสียงที่ได้ออกมาตามที่ตั้งใจหรือไม่
ข้อจำกัดสำคัญสำหรับคนทำพอดแคสต์คือ การสร้างบทสนทนาหลายคนใน API Request เดียวกัน รองรับได้สูงสุดเพียง 2 คน และต้องใช้เสียงสำเร็จรูป Preset Voices เท่านั้น หากต้องการนำเสียงที่โคลนมาหรือเสียงที่ออกแบบเองมาคุยกัน จะต้องสร้างไฟล์เสียงของแต่ละคนทีละท่อน แล้วนำไฟล์มาตัดต่อเข้าด้วยกันเองในภายหลัง
ทำให้เรามีทางเลือก 2 ทาง: เลือกใช้เสียงสำเร็จรูป 2 เสียงเพื่อรับไฟล์เสียงบทสนทนาจบใน API Request เดียว หรือเลือกใช้เสียงตัวเองแต่ต้องยอมเสียเวลาตัดต่อไฟล์เพิ่มขึ้น
ผลการทดสอบประสิทธิภาพที่ Google อ้างอิง
ในประกาศเปิดตัว Google ยกคะแนนทดสอบมาหลายชุด โดยระบุว่า Flash TTS ได้อันดับ 1 บน Voice Design Benchmark ของบริษัทวิจัย AI อย่าง Hume AI ด้วยคะแนน 71.4 และได้อันดับ 1 ด้านการเลียนแบบสำเนียงด้วยคะแนน 60.8 ส่วนในตาราง Overall Quality Index ของ Hume AI ตัว Flash TTS ก็ได้อันดับ 1 ส่วน Flash-Lite TTS ได้อันดับ 2
อีกชุดคือการทดสอบแบบไม่เปิดเผยชื่อโมเดลบนเว็บจัดอันดับเสียง AI อย่าง Voice Arena ซึ่งให้คนฟังเลือกเสียงที่ชอบกว่าโดยไม่รู้ว่าเป็นเสียงจากโมเดลใด ประกาศบอกว่าทั้ง 2 รุ่นติดกลุ่มอันดับต้นในภาษาหลักหลายภาษา โดยยกตัวอย่างภาษาญี่ปุ่น โปรตุเกสแบบบราซิล เวียดนาม อาหรับมาตรฐาน สเปนแบบเม็กซิโก และฮินดี
ทดลองใช้ฟรีได้แล้ววันนี้ และโครงสร้างราคาที่จะปรับขึ้นในปี 2027
นอกจากจะเปิดให้ทดลองใน AI Studio แล้ว ฝั่งนักพัฒนายังเรียกใช้งานทั้ง 2 รุ่นผ่าน Gemini API ได้ตั้งแต่วันเปิดตัว ผู้ใช้ทั่วไปจะได้ใช้ Flash TTS ใน Gemini Notebook และ Flash-Lite TTS ใน Google Vids ส่วนลูกค้าองค์กรนั้น Google ระบุว่าจะเปิดให้ใช้งานใน Gemini Enterprise เร็วๆ นี้
เรื่องค่าบริการ:
- Free tier: ใช้งานได้ฟรีโดยไม่มีค่าใช้จ่าย
- Paid tier: คิดค่าบริการตาม Token ซึ่งเป็นหน่วยวัดปริมาณข้อความและข้อมูลเสียง โดยราคามาตรฐานมีผลจนถึงวันที่ 31 ธันวาคม 2026 ดังนี้:
| รุ่นโมเดล | ข้อความที่ส่งเข้า (ต่อ 1 ล้าน Token) | เสียงที่สร้างออกมา (ต่อ 1 ล้าน Token) |
|---|---|---|
| Gemini 3.8 Flash TTS | $0.50 | $9.00 |
| Gemini 3.8 Flash-Lite TTS | $0.50 | $6.00 |
ตั้งแต่วันที่ 1 มกราคม 2027 เป็นต้นไป อัตราค่าบริการทั้งหมดในตารางนี้จะปรับเพิ่มขึ้นเป็น 2 เท่า ค่าสร้างเสียงของรุ่น Flash จึงจะอยู่ที่ $18 ต่อ 1 ล้าน Token และรุ่น Flash-Lite อยู่ที่ $12 ต่อ 1 ล้าน Token
ลองเทียบให้เห็นภาพว่า 1 ล้าน Token ยาวแค่ไหน เสียง 1 วินาทีคิดเป็น 25 Token ค่าสร้างเสียง $9 ของรุ่น Flash จึงเทียบเท่ากับเสียงยาวประมาณ 11 ชั่วโมง
สำหรับผู้ที่พัฒนา Voice Agent ภาษาไทย ส่วนต่างระหว่าง $9 กับ $6 ต่อล้าน Token คือต้นทุนที่ต้องจ่ายเพิ่มเพื่อให้รองรับภาษาไทย เพราะรุ่น Flash-Lite ที่ราคาถูกกว่าและออกแบบมาสำหรับ Voice Agent โดยตรงไม่รองรับภาษาไทย ระบบตอบลูกค้าภาษาไทยที่ใช้โมเดลชุดนี้จึงจำเป็นต้องใช้รุ่น Flash TTS และจ่ายค่าเสียงในอัตราที่สูงกว่า
อีกหนึ่งจุดสำคัญคือ ทุกไฟล์เสียงที่สร้างจากโมเดลชุดนี้ จะฝังลายน้ำดิจิทัล SynthID ลงในเนื้อเสียงโดยอัตโนมัติ แม้เราจะฟังด้วยหูไม่ออก แต่ช่วยให้ตรวจได้ว่าเป็นเสียงที่สร้างขึ้นด้วย AI
ลองกับสคริปต์คลิปจริงของคุณใน 10 นาที
ถ้าคุณมีสคริปต์คลิปที่เตรียมไว้ทำคอนเทนต์อยู่แล้ว แนะนำให้ลองตามขั้นตอนง่ายๆ ต่อไปนี้ก่อนตัดสินใจใช้งานจริง:
- เปิดหน้าสร้างเสียงใน Google AI Studio
- เลือกรุ่นโมเดลเป็น Gemini 3.8 Flash TTS (ไม่ใช่ Flash-Lite)
- วางสคริปต์ภาษาไทยสั้นๆ ลงไปสักหนึ่งย่อหน้า
- ลองฟังเสียงสำเร็จรูปสัก 2–3 เสียง เพื่อหาโทนเสียงที่ชอบ
- ใส่แท็ก
<short pause>ในจุดที่ต้องการให้เว้นจังหวะ - ลองฟังว่าสำเนียงภาษาไทยเป็นธรรมชาติและพร้อมใช้งานจริงหรือยัง
ฟังจบแล้วคิดว่าเสียงไหนพูดไทยได้เป็นธรรมชาติที่สุด แวะมาเล่าสู่กันฟังในคอมเมนต์ได้เลยนะ
พอกำกับเสียงได้ งานของคนทำคลิปก็ย้ายจากหน้าไมค์มาอยู่ในบท
ที่มา:
- บทความ Gemini 3.8 text-to-speech says hello จาก Google
- บทความ Text-to-speech generation (TTS) จาก Google AI for Developers
- บทความ Voice replication จาก Google AI for Developers
- บทความ Gemini Developer API pricing จาก Google AI for Developers
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin