คนเอา Jev ไปสร้างอะไรบน GitHub: สรุปจาก awesome-jev 418 รายการ ตั้งแต่ปลั๊กอิน Claude Code ถึงแอปช่วยตอบแชต
รีโป awesome-jev รวมโปรเจกต์และการใช้งาน Jev ของ TypeSafe AI ไว้ 418 รายการ ดูว่าคนแบ่งงานระหว่างตัวตัดสินใจกับ LLM ยังไง และต้องเช็กอะไรก่อนหยิบมาใช้
ช่วงนี้ถ้าเปิดดูบนแพลตฟอร์มรวมโค้ดอย่าง GitHub จะเริ่มเห็นชื่อของ Jev โผล่ขึ้นมาเต็มไปหมด ทั้งที่เป็นโมเดล AI จากค่าย TypeSafe AI ที่ตอบข้อความออกมาเป็นประโยคไม่ได้เลยแม้แต่คำเดียว
โปรเจกต์ที่หยิบ Jev ไปใช้มีหลากหลายมาก ตั้งแต่ปลั๊กอินสำหรับ coding agent หรือโปรแกรม AI ช่วยเขียนและแก้โค้ดอย่าง Claude Code และ Codex, แอปช่วยตอบแชตบนมือถือ ไปจนถึงคลังรวบรวมผลงานอย่างลิสต์ awesome ที่มีคนจัดทำไว้อีกหลายแห่ง
ทำไม AI ที่แต่งประโยคเองไม่ได้เลย ถึงมีคนนำไปต่อเข้ากับระบบต่างๆ แทบทุกที่?
คำตอบอยู่ที่วิธีทำงานของ Jev ที่ออกแบบมาให้รับข้อมูลพร้อมกับคำถามที่มีตัวเลือกคำตอบกำหนดไว้อยู่แล้ว จากนั้นจะตอบกลับมาทันทีเป็นคะแนน ใช่/ไม่ใช่ หรือเลือกตัวเลือกข้อใดข้อหนึ่ง ซึ่งทำงานได้เร็วมากและราคาถูกมาก ส่วนเบื้องหลังการทำงานเชิงลึก เราเคยสรุปไว้แล้วในบทความอธิบาย Jev ตั้งแต่ต้น
เพราะในความเป็นจริง งานจำนวนมากในระบบต้องการแค่การตัดสินใจแบบนี้ ไม่ได้ต้องการให้ AI เขียนบรรยายเป็นข้อความยาวๆ
ส่องคลัง awesome-jev: คนนำ Jev ไปใช้ทำอะไรกันบ้าง
awesome-jev เป็นคลังรวมโปรเจกต์ที่ yibie ดูแลอยู่ ปัจจุบันรวบรวมไว้ทั้งหมด 418 รายการ แบ่งออกเป็น 15 หมวดหมู่ โดยมีโปรเจกต์อยู่จริง 14 หมวด ส่วนอีกหนึ่งหมวดยังคงว่างอยู่
ในจำนวนนี้ มี 79 รายการที่อยู่ในหมวดรวบรวมลิงก์บทความและการพูดคุยในชุมชน ไม่ใช่ตัวโปรเจกต์โค้ดโดยตรง ส่วนหมวดหลักที่เหลือช่วยให้เห็นชัดเจนว่าคนนิยมนำ Jev ไปวางไว้ตรงไหนของระบบ:
- Infra / SDKs / Integrations (76 รายการ): ชุดเครื่องมือและตัวเชื่อมต่อ Jev เข้ากับระบบอื่น
- Agent Decisions (49 รายการ): จุดตัดสินใจของ AI agent ว่าควรทำอะไรต่อไป
- Classification & Routing (40 รายการ): งานจัดหมวดหมู่ข้อมูลและส่งต่อไปยังระบบที่ถูกต้อง
- Verification & Guardrails (33 รายการ): งานตรวจสอบผลลัพธ์และดักจับข้อผิดพลาดก่อนส่งออกไป
- Scoring & Ranking (32 รายการ): งานให้คะแนนและจัดอันดับข้อมูล
สำหรับคนที่ใช้ AI ช่วยเขียนโค้ดอยู่แล้ว awesome-jev ยังแยกดัชนีตาม coding agent ที่แต่ละรายการทำมาให้ใช้ไว้ด้วย แบ่งเป็น Claude Code 7 รายการ, Codex 6 รายการ, Pi 12 รายการ, Cline 1 รายการ และแบบที่ใช้ได้หลายตัวอีก 14 รายการ
ตัวอย่างที่ช่วยให้ผู้ใช้งาน Claude Code เห็นภาพชัดเจนที่สุดคือ fast-jev-compaction ปลั๊กอินตัวนี้เข้ามาทำหน้าที่แทนขั้นตอนการย่อประวัติบทสนทนา (compaction) ของ Claude Code เดิมทีขั้นตอนนี้ต้องใช้ LLM หรือโมเดลภาษาขนาดใหญ่ที่เขียนข้อความได้อย่าง ChatGPT มาสรุปบทสนทนาทั้งหมดในแต่ละรอบออกมาเป็นข้อความก้อนเดียว
ตามคำอธิบายในลิสต์ ปลั๊กอินนี้เปลี่ยนมาให้ Jev ไล่ตรวจและให้คะแนนคำสั่งเรียกใช้เครื่องมืออย่าง tool call แต่ละรายการ ทั้งตอนที่ agent สั่งรันคำสั่งหรือเปิดไฟล์พร้อมผลลัพธ์ เพื่อตัดสินว่ายังจำเป็นต้องเก็บไว้ในหน่วยความจำของ AI หรือไม่ จากงานเดิมที่ต้องให้ LLM เขียนสรุปใหม่ทั้งก้อน จึงกลายเป็นการตอบคำถามสั้นๆ ทีละข้อแทน
รูปแบบนี้คือหัวใจสำคัญที่ทุกโปรเจกต์ในลิสต์มีร่วมกัน เกณฑ์รับเข้าคลัง awesome-jev ข้อหนึ่งระบุไว้ว่า ต้องใช้ Jev กับงานตัดสินใจที่กำหนดขอบเขตคำตอบไว้ชัดเจนเท่านั้น คือส่งคำถามที่กำหนดประเภทคำตอบไว้ แล้วรับผลลัพธ์กลับมาตามนั้น ทุกโปรเจกต์จึงไปในทางเดียวกัน คือยกงานตัดสินใจเล็กๆ ที่มีตัวเลือกแน่นอนให้ Jev ทำ ส่วนงานที่ต้องเรียบเรียงหรือเขียนข้อความยาวๆ ถ้ามี ก็ยังคงเป็นหน้าที่ของ LLM ตามเดิม
jev-chat-jarvis: ตัดสินใจก่อน แล้วค่อยให้เขียน
ตัวอย่างที่สะท้อนรูปแบบนี้ได้ชัดเจนที่สุดคือ jev-chat-jarvis แอป Android ที่ช่วยอ่านข้อความแชตบนหน้าจอแล้วร่างคำตอบให้ ตัวแอปทำงานผ่าน Accessibility Service ที่เป็นบริการช่วยการเข้าถึงของ Android แบบเดียวกับที่โปรแกรมอ่านหน้าจอใช้ จึงไม่จำเป็นต้องดัดแปลงแอปแชต และไม่ต้องเรียกใช้ช่องทางเชื่อมต่อระบบอย่าง API หรือระบบบัญชีของแอปแชตนั้น
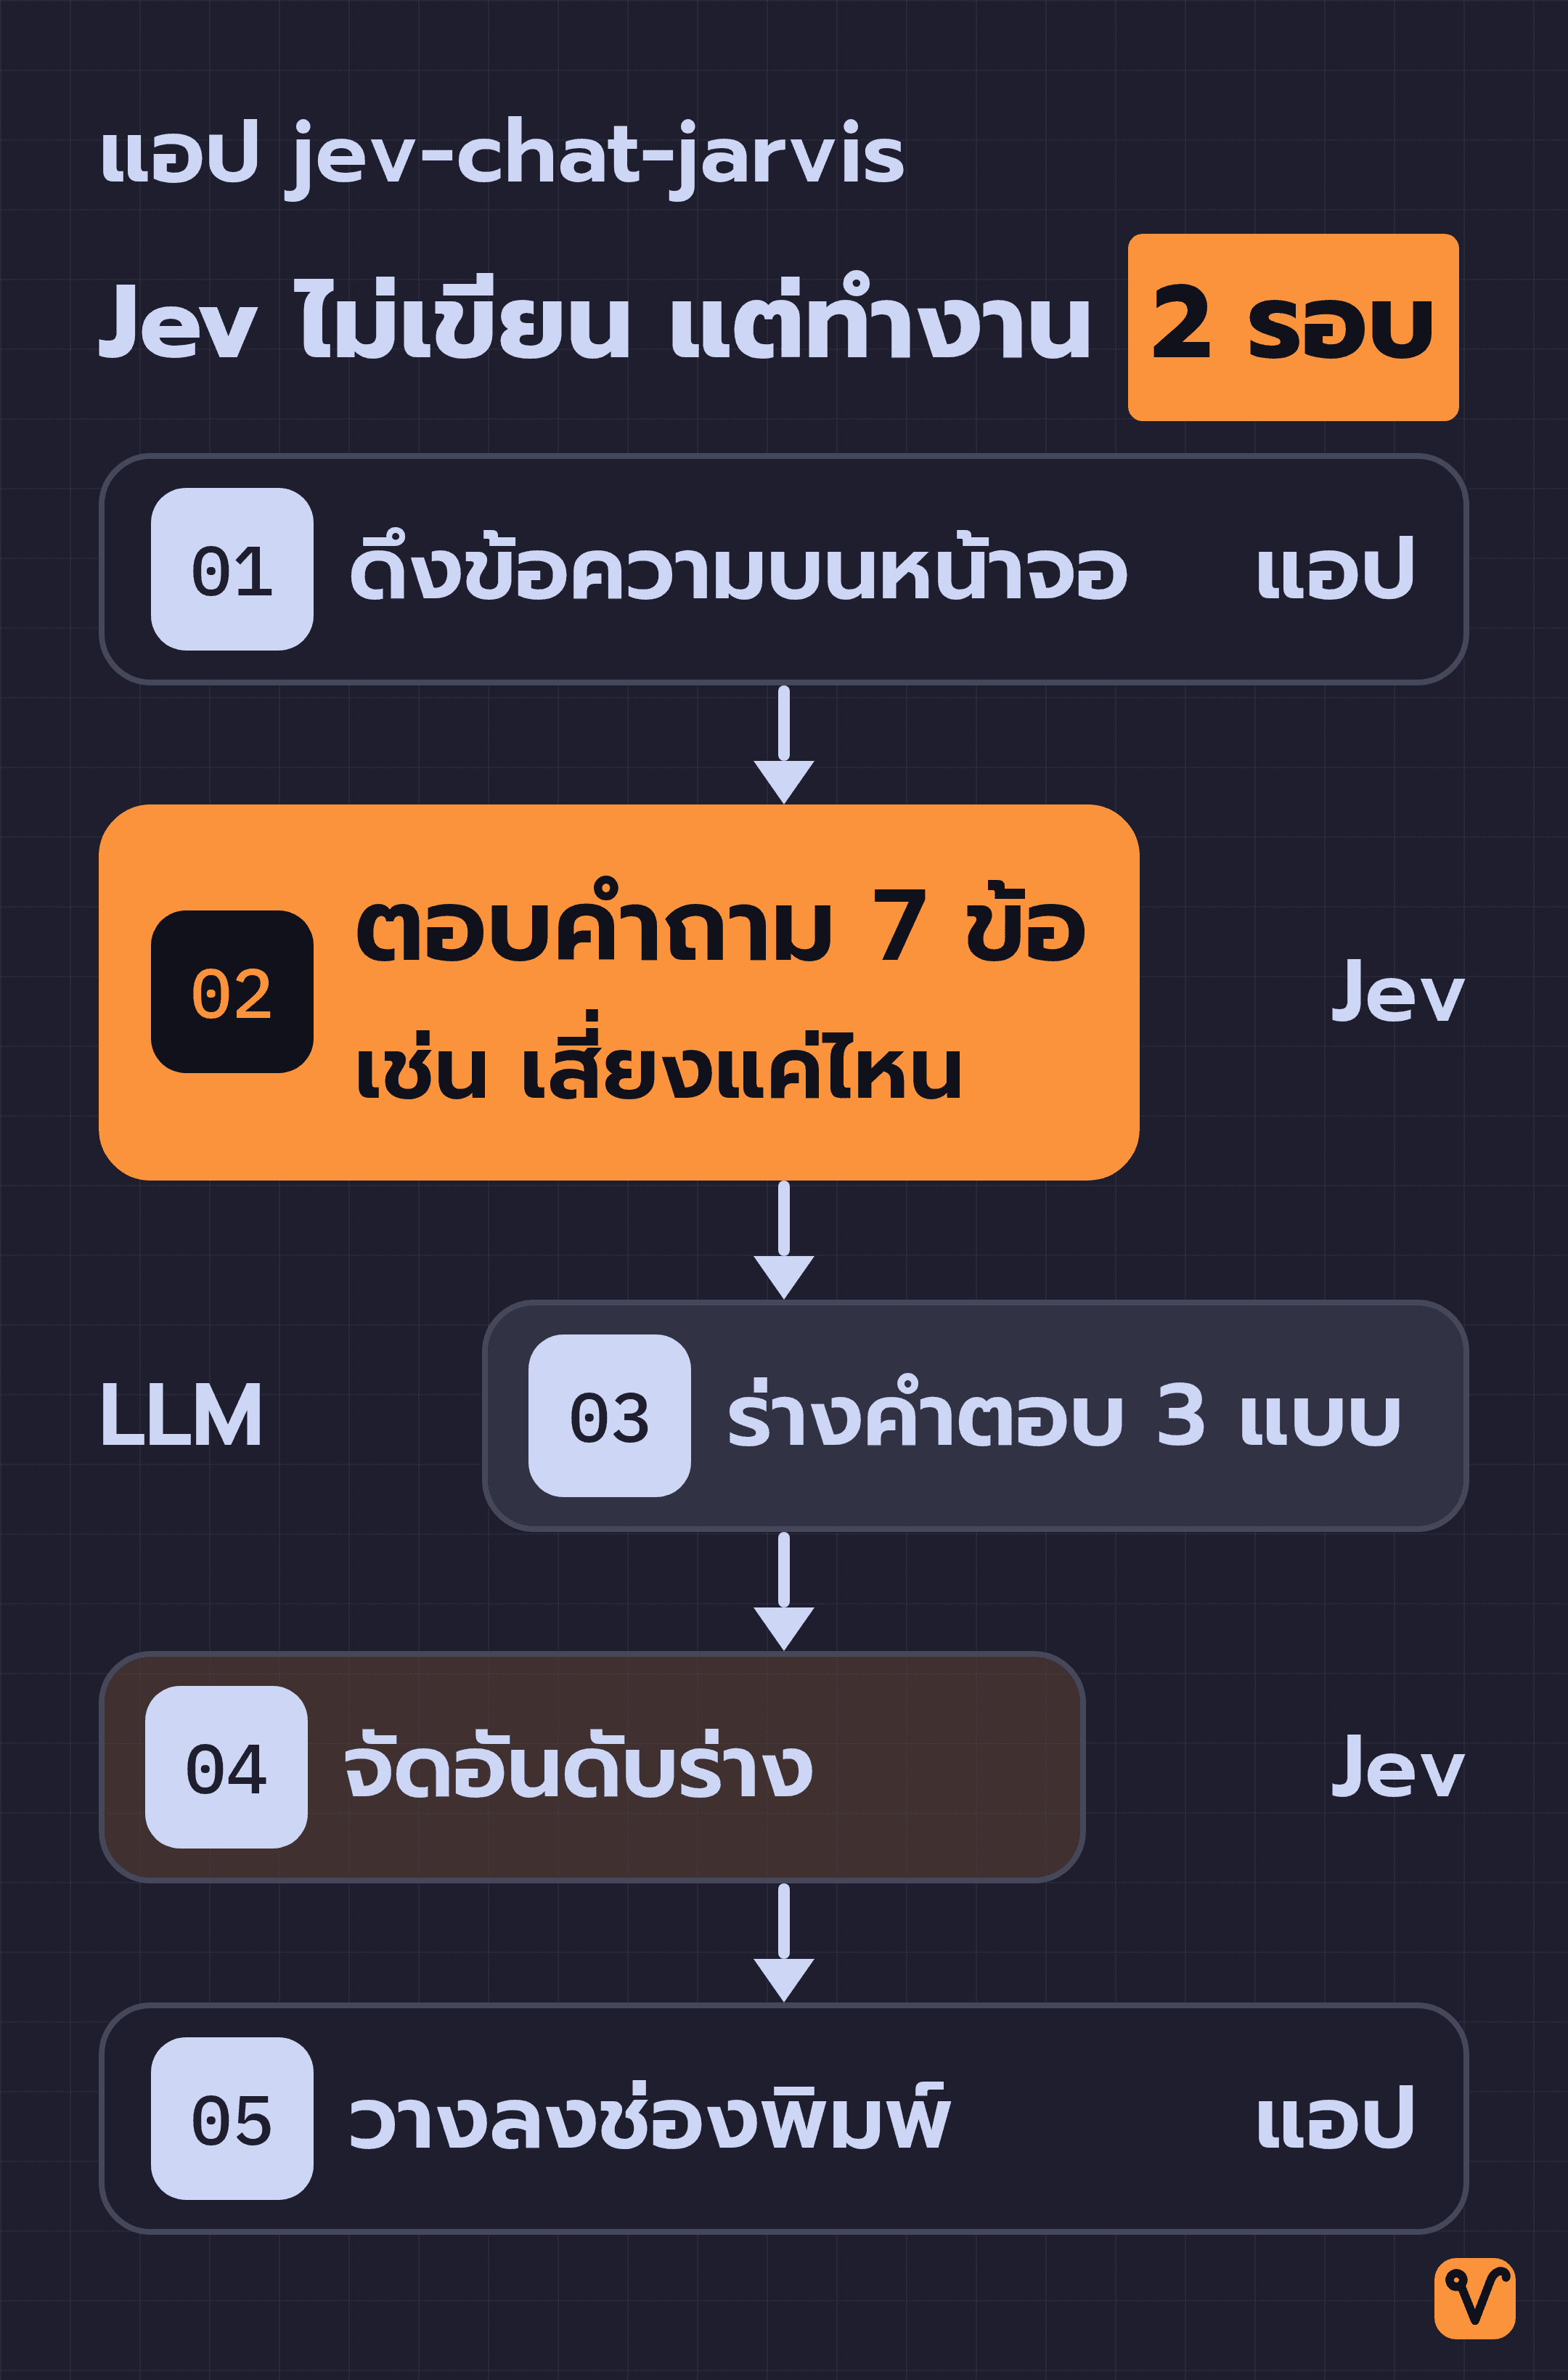
ขั้นตอนการทำงานตามที่ระบุใน README หรือหน้าเอกสารแนะนำโปรเจกต์ล่าสุด แบ่งออกเป็น 5 ขั้นตอน:
- แอปจะดึงข้อความล่าสุดที่กำลังแสดงอยู่บนหน้าจอ
- ส่งให้ Jev ตอบคำถาม 7 ข้อพร้อมกันในคำขอเดียว ใช้เวลาเพียงประมาณ 1 วินาที และทุกคำตอบจะมีค่าความมั่นใจกำกับมาด้วย ตัวอย่างคำถามเช่น คู่สนทนาต้องการอะไรกันแน่ เรื่องนี้เสี่ยงหรืออันตรายแค่ไหนในระดับ 1 ถึง 9 และควรตอบกลับทันทีหรือไม่
- LLM จะนำผลการตัดสินใจจากข้อ 2 ไปร่างข้อความตอบกลับออกมา 3 รูปแบบ
- Jev จะเข้ามาช่วยจัดอันดับร่างข้อความทั้งสามว่าแบบไหนเหมาะสมที่สุด
- เมื่อผู้ใช้แตะเลือกข้อความ แอปจะวางข้อความลงในช่องพิมพ์ให้อัตโนมัติ แต่จะไม่กดส่งเอง และไม่ยุ่งกับการโอนเงิน อั่งเปา หรือการรับเงินเลย
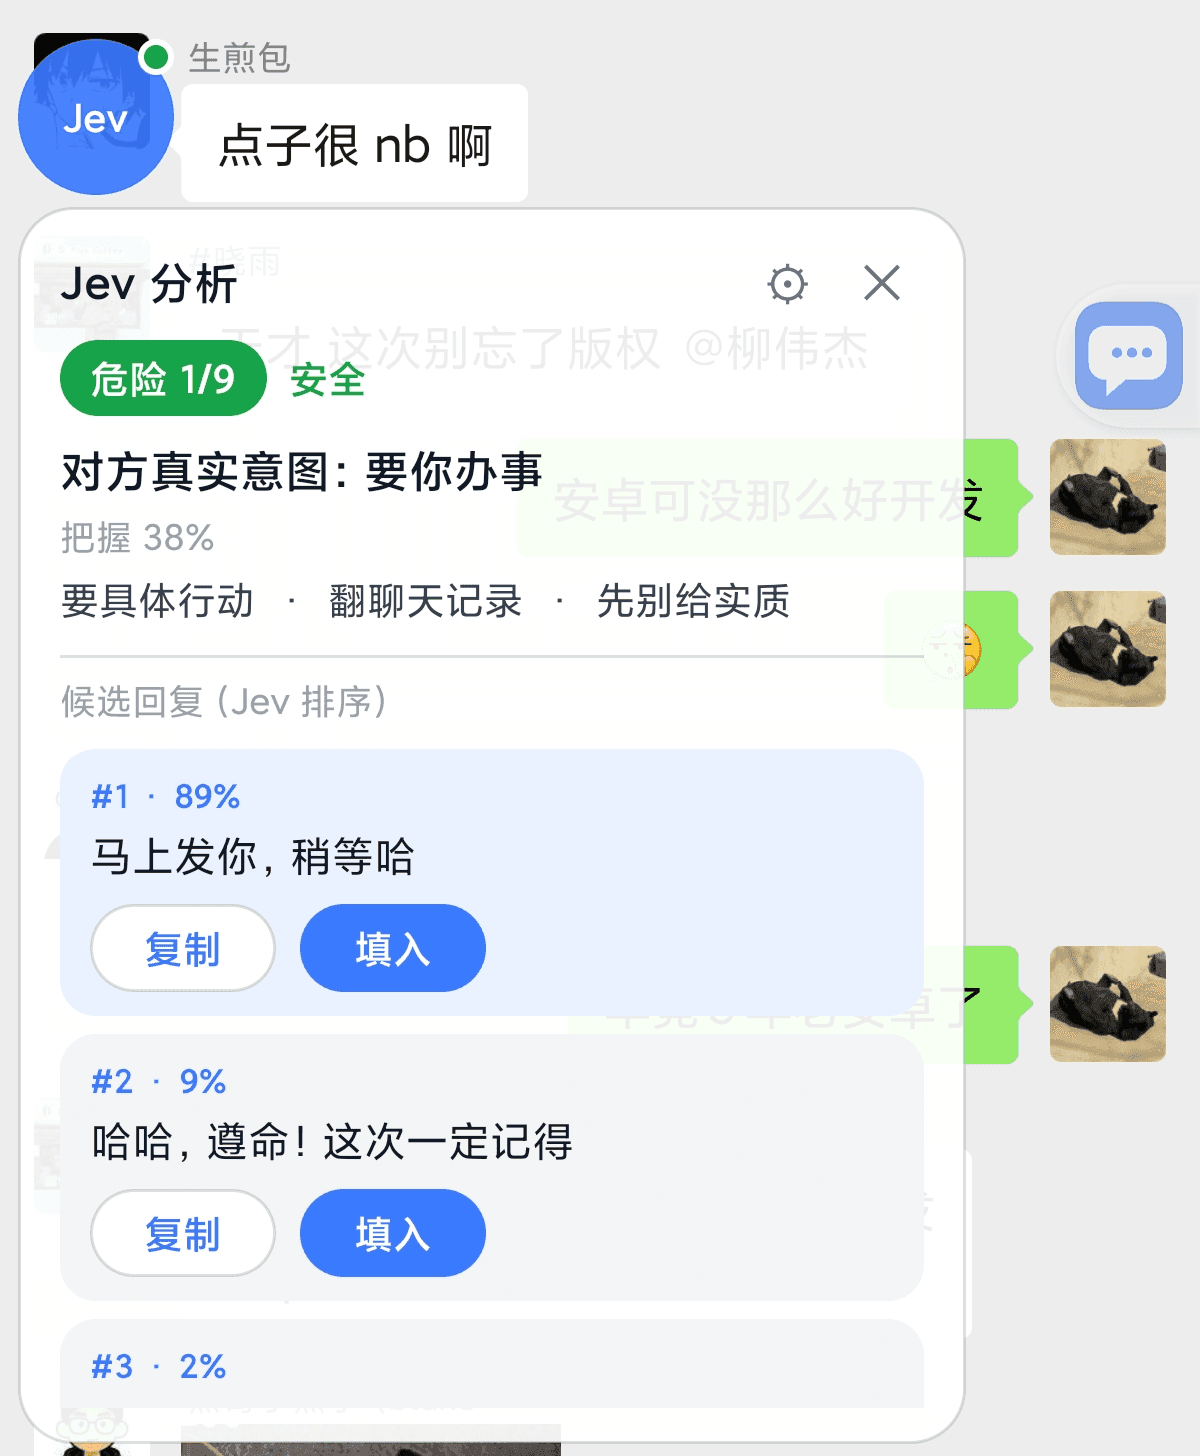
README ของโปรเจกต์ระบุไว้ชัดเจนว่า แอปนี้ใช้แนวคิด "ตัดสินใจก่อน แล้วค่อยให้เขียน" ซึ่งต่างจากเครื่องมือ AI ทั่วไปที่มักสั่งให้โมเดลแต่งข้อความตอบกลับทันที
จุดที่ชวนสับสนคือ Jev ในแอปนี้ไม่ได้มีหน้าที่เขียนข้อความเลยแม้แต่คำเดียว ตัวที่เขียนคือ LLM โดย Jev จะเข้ามาทำงาน 2 รอบด้วยกัน รอบแรกคือบอก LLM ว่าคู่สนทนาอีกฝั่งต้องการอะไรและเสี่ยงแค่ไหน ส่วนรอบที่สองคือจัดอันดับร่างที่ LLM เขียนออกมาก่อนจะส่งถึงมือผู้ใช้
เรื่องค่าใช้จ่าย ตัวแอปเปิดให้ใช้งานฟรีและเป็นโอเพนซอร์ส ผู้ใช้จ่ายเพียงค่า API ของโมเดลตามการใช้งานจริง ผ่านรหัสเข้าใช้งานอย่าง API key ของตัวเอง
README ยกตัวอย่างค่าใช้จ่ายฝั่งโมเดลตัดสินใจไว้หนึ่งกรณี คือการตั้งค่าสำเร็จรูปชื่อ OpenCode Zen ที่ใช้โมเดล jev-1.13 โดยค่า output ฟรี ส่วนค่า input คิดอยู่ที่ $0.042 ต่อ 1 ล้านโทเคน (โทเคนคือหน่วยนับปริมาณข้อความที่ผู้ให้บริการใช้คิดเงิน) การตัดสินใจหนึ่งครั้งใช้ input ประมาณ 1,000 โทเคน เท่ากับว่าตัดสินใจได้ราว 1,000 ครั้งก่อนจะใช้ input ครบ 1 ล้านโทเคน ขณะที่โมเดล LLM ที่ใช้ร่างข้อความจะคิดค่าบริการแยกต่างหากตามผู้ให้บริการที่เลือกใช้
สำหรับเรื่องความเป็นส่วนตัว README ชี้แจงว่า แอปจะส่งข้อความแชตไปยัง API ที่ผู้ใช้ตั้งค่าไว้เฉพาะตอนที่กดสั่งวิเคราะห์เท่านั้น โดยไม่มีการบันทึกลงเครื่อง ไม่มีการเก็บประวัติการใช้งาน และโปรเจกต์นี้ไม่มีเซิร์ฟเวอร์ของตัวเอง ถึงอย่างนั้น ข้อความก็ยังส่งออกจากเครื่องไปยังผู้ให้บริการโมเดลอยู่ดี ผู้ใช้จึงต้องตัดสินใจเองว่าแชตประเภทไหนที่ยอมให้ส่งออกไปได้
ส่วนคำถามว่าจะโดนแบนบัญชีแชตหรือไม่ README อธิบายวิธีทำงานของแอปว่า ตัวแอปไม่ได้เข้าไปดัดแปลงแอปแชต และใช้วิธีอ่านหน้าจอแบบเดียวกับโปรแกรมอ่านหน้าจอสำหรับผู้พิการ แต่นี่เป็นเพียงคำอธิบายการทำงานเชิงเทคนิค ไม่ใช่การรับประกันว่าจะไม่โดนแบน
jev-chat-jarvis ยังไม่เหมาะกับการใช้งานจริงของคนไทย
ตารางใน README ล่าสุดระบุว่า แอปที่รองรับการใช้งานได้อย่างสมบูรณ์มีเพียง 2 แอป คือแอปแชตของจีนอย่าง QQ และข้อความส่วนตัวหรือ DM บน X แต่ฝั่ง X นั้นทดสอบเฉพาะบนหน้าจอภาษาจีนเท่านั้น และยังไม่ได้ทดสอบกับหน้าจอภาษาอังกฤษ
ส่วนแอปแชตสำหรับการทำงานอย่าง Feishu จะใช้งานได้ผ่านวิธีสำรองเท่านั้น เพราะข้อความใน Feishu ไม่รองรับระบบ Accessibility ของ Android ตัวแอปจึงต้องเปลี่ยนมาใช้ระบบ OCR เพื่ออ่านตัวอักษรจากภาพหน้าจอแทน
สำหรับ WeChat ตัวแอปยกเลิกการรองรับไปตั้งแต่เวอร์ชัน 1.4 เนื่องจาก WeChat เวอร์ชัน 8.0.52 ขึ้นไปเริ่มซ่อนข้อความจากระบบ Accessibility และบางบัญชีหรือบางเครื่องยังเปิดระบบป้องกันการแคปหน้าจอไว้อีกด้วย แม้ในคลัง awesome-jev จะยังเขียนว่ารองรับ WeChat อยู่ แต่ควรยึดข้อมูลจาก README ของตัวแอปเป็นหลัก เพราะเจ้าของโปรเจกต์เป็นผู้อัปเดตข้อมูลโดยตรง
ส่วนแอปแชตอื่นๆ ใช้ได้แค่โหมดกดเองเท่านั้น คือผู้ใช้ต้องกดจากเมนูหน้าต่างลอยเพื่อให้แคปหน้าจอแล้วรัน OCR ทีละครั้ง โดยใช้โมเดล OCR ภาษาจีนที่ประมวลผลในเครื่อง วิธีนี้จึงไม่ทำงานอัตโนมัติ และแยกไม่ได้ว่าข้อความไหนเป็นของใคร ที่สำคัญคือ แอปยอดนิยมในไทยอย่าง LINE หรือ Messenger ยังไม่รองรับเลย
นอกจากนี้ ตัวแอปยังต้องลงผ่านไฟล์ APK เอง และรองรับเฉพาะระบบปฏิบัติการ Android 11 ขึ้นไปเท่านั้น อีกทั้ง README ยังระบุว่า Jev เทรนมาด้วยภาษาอังกฤษเป็นหลัก ตัวแอปจึงเขียนคำถามเป็นภาษาอังกฤษ แม้ว่าข้อความแชตจะเป็นภาษาจีนก็ตาม
สรุปแล้ว jev-chat-jarvis เป็นตัวอย่างที่ช่วยให้เห็นแนวคิด "ตัดสินใจก่อน แล้วค่อยเขียน" ได้ชัดเจนที่สุด แต่ยังไม่ใช่แอปที่คนไทยจะโหลดมาใช้งานกับ LINE ได้ในเวลานี้
ไม่อยากพึ่งพา API ของ TypeSafe? ทางเลือกคือ AnyJev และการเทรนเอง
ถ้าคุณต้องการโมเดลสำหรับตัดสินใจในลักษณะนี้ แต่ไม่อยากผูกระบบไว้กับ API ของ TypeSafe ตอนนี้มีทางเลือกที่ไปต่อได้อย่างน้อย 2 ทาง:
ทางแรกคือ AnyJev จากทีมวิจัย Nokia Applied Research ตัวนี้ทำให้เรานำ LLM แบบ open-weight หรือโมเดลเปิดที่ดาวน์โหลดมารันเองได้ มาตอบคำถามแบบกำหนดตัวเลือก พร้อมส่งค่าความน่าจะเป็นกลับมาได้ทันทีโดยไม่ต้องเทรนโมเดลใหม่ วิธีทำงานคือเข้าไปดูค่าน้ำหนักที่โมเดลให้กับแต่ละตัวเลือกทันทีที่ประมวลผลคำถามเสร็จ โดยไม่ต้องรอให้โมเดลเริ่มเขียนคำตอบออกมา คุณสามารถเริ่มใช้งานได้ทันทีด้วยคำสั่ง pip install "anyjev[hf]" แล้วส่งคำถามได้เลยโดยไม่ต้องมีตัวอย่างคำตอบล่วงหน้า จากนั้นค่อยใส่ตัวอย่างเพิ่มเข้าไปทีหลังถ้าต้องการปรับแต่งให้แม่นยำยิ่งขึ้น ข้อจำกัดในตอนนี้คือรองรับเฉพาะการรันผ่านไลบรารี transformers เท่านั้น ส่วนระบบช่วยรันโมเดลอย่าง vLLM และ SGLang ยังอยู่ในแผนพัฒนา และ README ก็ระบุไว้อย่างชัดเจนว่าโปรเจกต์นี้ไม่ได้เกี่ยวข้องใดๆ กับ TypeSafe AI อ่านรายละเอียดเพิ่มเติมได้ในบทความเจาะลึก AnyJev
ทางที่สองคือการเทรนโมเดลขึ้นมาใช้งานเอง ตามแนวทางในบทความของ Together AI ผู้ให้บริการแพลตฟอร์มคลาวด์สำหรับเทรนและรันโมเดล AI โดยบทความนี้สอนวิธีเทรนตัวตัดสินใจสไตล์เดียวกับ Jev ด้วยงบประมาณราว 17 ดอลลาร์
สูตรในบทความใช้โมเดล Qwen3.5 4B เป็นโมเดลตั้งต้น แล้วนำมาปรับแต่งเฉพาะทางหรือ fine-tune ต่อด้วยชุดข้อมูลโจทย์ตัดสินใจจำนวน 37,840 ตัวอย่างจาก 8 แหล่งตามตารางในบทความ ชุดข้อมูลนี้มีโจทย์ตั้งแต่การจำแนกเจตนาของลูกค้าธนาคาร การตอบคำถามแบบใช่/ไม่ใช่จากข้อความที่ให้อ่าน ไปจนถึงการตัดสินใจตามเงื่อนไขหรือกฎเกณฑ์ที่กำหนดไว้
ขั้นตอนทั้งหมดแบ่งออกเป็น 5 ขั้น:
- คัดลอกคลังโค้ดหรือรีโป tev1 มาไว้ในเครื่อง, ติดตั้งแพ็กเกจที่จำเป็น แล้วใส่
TOGETHER_API_KEYลงในไฟล์.env - ดาวน์โหลดชุดข้อมูลและจัดรูปแบบให้อยู่ในโครงสร้างเดียวกัน โดยใช้สคริปต์ที่เตรียมมาให้ในรีโป
- สั่งเทรนผ่านบริการ fine-tuning ของ Together AI ใช้เวลาประมาณ 25 นาที คิดค่าใช้จ่ายในการเทรนราว 17 ดอลลาร์
- นำโมเดลที่ได้ไปเปิดใช้งานเป็น dedicated endpoint หรือเซิร์ฟเวอร์สำหรับรันโมเดลเฉพาะของเรา บนชิป GPU H100 จำนวน 1 ตัว
- นำชื่อ endpoint ไปใส่ในไฟล์
.envในช่องJEV_MODELแล้วทดสอบส่งคำถามผ่านสคริปต์decide.py
ตัวอย่างในบทความลองส่งข้อความของลูกค้าที่แจ้งว่าถูกหักค่าสมาชิกซ้ำ 2 ครั้งในเดือนเดียวกัน พร้อมตัวเลือกเจตนา 4 ข้อ แล้วได้ผลลัพธ์กลับมาเป็น {"label": "A", "key": "duplicate_charge"}
ถ้าไม่อยากเสียเวลาเทรนเอง ก็เรียกใช้โมเดล Tev1-4B-experimental ที่เปิดให้บริการแบบ serverless ผ่าน API ได้ทันที โดยไม่ต้องเปิดเซิร์ฟเวอร์ทิ้งไว้
จะเลือกทางไหนขึ้นอยู่กับความต้องการและต้นทุนที่คุณพร้อมจ่าย AnyJev ช่วยให้ไม่ต้องเทรนโมเดลและมีค่าความน่าจะเป็นให้ใช้งาน แต่คุณต้องรันโมเดล open-weight ผ่าน transformers ด้วยตัวเอง
ส่วนการเทรนเองจะเหมาะกับทีมที่มีงานคัดแยกข้อมูลซ้ำๆ ในปริมาณมาก เช่น การจัดหมวดหมู่ข้อความลูกค้า และพร้อมจ่ายค่าเปิด endpoint อย่างต่อเนื่อง เพื่อแลกกับการได้โมเดลขนาดเล็กที่เป็นของตัวเอง
5 ข้อที่ต้องเช็กก่อนหยิบโปรเจกต์ Jev ไปใช้งาน
ในคลัง awesome-jev มีคำเตือนไว้อย่างชัดเจนในหัวข้อ "Curation is not endorsement" ว่า การมีชื่ออยู่ในลิสต์ไม่ได้แปลว่าผู้ดูแลรับรองโปรเจกต์นั้น เพราะเกณฑ์ในการรับเข้าพิจารณาเพียงแค่เป็นโปรเจกต์สาธารณะ มีแหล่งอ้างอิงชัดเจน นำ Jev ไปใช้ตัดสินใจในงานจริง และอธิบายสรุปได้ในประโยคเดียวเท่านั้น โดยไม่ได้ตรวจสอบคุณภาพของโค้ด ความปลอดภัย ความพร้อมใช้งาน หรือแม้กระทั่งทดสอบว่ารันได้จริงหรือไม่
สิ่งที่ลิสต์เตือนเป็นพิเศษคือโปรเจกต์ที่ปล่อยออกมาเป็นชุด เช่น นักพัฒนาคนเดียวปล่อยหลายรีโปรวดในวันเดียว โปรเจกต์กลุ่มนี้มักใช้โครงสร้างไฟล์ชุดเดียวกัน เช่น มีไฟล์ AGENTS.md, CLAUDE.md, STATE.md และ CHANGELOG.md แต่มี commit หรือการบันทึกแก้ไขโค้ดเพียง 1-2 ครั้งเท่านั้น และอาจมีเอกสารมากกว่าโค้ด ทางผู้ดูแลจึงแนะนำให้มองโปรเจกต์เหล่านี้เป็นเพียงไอเดียตั้งต้นไว้ศึกษาต่อ ยังไม่ใช่เครื่องมือที่พิสูจน์แล้วว่าใช้ได้จริง
ในหัวข้อเดียวกัน จึงมีเช็กลิสต์ 5 ข้อให้ตรวจสอบด้วยตัวเองก่อนนำโปรเจกต์ไปใช้งาน:
- โค้ดเรียกใช้ API ของ Jev จริงหรือไม่: README อาจเขียนบรรยายไว้อย่างน่าสนใจโดยไม่มีโค้ดจริงเลยสักบรรทัด จึงควรตรวจดูในโค้ดว่ามีจุดที่ส่งคำถามพร้อมระบุประเภทคำตอบ และมีจุดที่นำคำตอบกลับมาประมวลผลจริงหรือไม่
- มีส่วนที่รันเพื่อทดสอบได้จริงไหม: ทั้งชุดทดสอบ ตัวอย่างโค้ดที่แสดงผลลัพธ์ที่ควรได้ หรือเดโมให้ทดลองใช้งาน ถ้าไม่มีสิ่งเหล่านี้เลย ก็ไม่มีหลักฐานยืนยันว่าโปรเจกต์ทำงานได้จริง
- ตัวเลขอ้างอิงมีแหล่งที่มาชัดเจนหรือไม่: ตัวเลขด้านความแม่นยำ ความเร็ว ต้นทุน หรือปริมาณงาน ควรมีหน้าเอกสารหรือวิธีวัดผลรองรับ แม้ผู้ดูแลลิสต์จะตัดตัวเลขที่ตรวจสอบไม่ได้ออกจากคำอธิบายแล้ว แต่หน้าโปรเจกต์ต้นทางอาจยังเขียนไว้อยู่
- ในรีโปมีสัดส่วนของโค้ดมากน้อยแค่ไหน: บางโปรเจกต์แทบจะมีแต่เอกสารและ prompt ซึ่งไม่ใช่เรื่องผิด เพียงแต่เราต้องรู้ให้ชัดว่ากำลังนำอะไรมาใช้
- มีสัญญาอนุญาตการใช้งานหรือ License ระบุไว้หรือไม่: บางโปรเจกต์ไม่ได้ระบุ License ไว้ ซึ่งอาจเป็นข้อจำกัดเวลานำไปพัฒนาต่อหรือแจกจ่าย
เช็กลิสต์ทั้ง 5 ข้อนี้ นำไปใช้ตรวจสอบโปรเจกต์ข้างต้นอย่าง fast-jev-compaction และ jev-chat-jarvis ได้เช่นกัน
บทเรียนที่สำคัญกว่าตัวโมเดล
ในมุมมองของเรา บทเรียนสำคัญจากกระแส Jev ไม่ได้อยู่ที่ความสามารถของตัวโมเดลเพียงอย่างเดียว แต่อยู่ที่ "วิธีแบ่งงาน" กล่าวคืองานไหนที่ตอบได้ด้วยตัวเลือก หรือตอบแค่ใช่/ไม่ใช่ ให้ส่งต่อไปให้โมเดลตัดสินใจจัดการไปเลย ทั้งรวดเร็วและราคาถูก แล้วเก็บ LLM ไว้สำหรับงานที่จำเป็นต้องเรียบเรียงและเขียนข้อความจริงๆ
ก่อนจะถามว่างานชิ้นต่อไปจะใช้โมเดลตัวไหน ลองถามตัวเองก่อนว่า งานตรงหน้า "ต้องเขียนข้อความ" หรือ "ต้องการแค่การเลือกคำตอบ" กันแน่
ถ้าคุณมีโมเดลตัดสินใจที่ทั้งเร็วและประหยัดแบบนี้อยู่ในมือ อยากนำไปช่วยตัดสินใจในขั้นตอนไหนของงานบ้าง? มาร่วมแชร์ไอเดียกันในช่องคอมเมนต์ได้เลย
ที่มา:
- โปรเจกต์ awesome-jev บน GitHub จาก yibie
- โปรเจกต์ jev-chat-jarvis บน GitHub จาก jev-chat
- บทความ How to train your own Jev for $17 จาก Together AI
- โปรเจกต์ AnyJev บน GitHub จาก Nokia Applied Research
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ