AnyJev จาก Nokia เปลี่ยน Open LLM ให้ตัดสินใจแบบ Jev ได้ ตอบตามชนิดที่กำหนด พร้อมค่าความน่าจะเป็นที่เชื่อถือได้ โดยไม่ต้องเทรน
AnyJev จาก Nokia ให้ Open LLM ตัดสินใจตามชนิดที่กำหนด พร้อมค่าความน่าจะเป็นที่เชื่อถือได้ โดยไม่ต้องเทรน ตัวเลขนี้เองที่บอกว่าเคสไหนปล่อยให้ระบบทำเองได้
AnyJev เป็นเครื่องมือภาษา Python จากทีม Nokia Applied Research ที่ทำให้คำว่า "มั่นใจ 0.9" ของโมเดลภาษาขนาดใหญ่หรือ LLM กลายเป็นตัวเลขที่นำไปตั้งเกณฑ์ตัดสินใจได้จริง
ฟังดูเหมือนเป็นเรื่องเล็ก แต่ถ้าตัวเลขความมั่นใจนี้เชื่อถือไม่ได้ ระบบที่ใช้ LLM คัดแยกเรื่องหรือคัดกรองคำสั่งที่เสี่ยง ก็ปล่อยให้โมเดลตัดสินใจเองไม่ได้ สุดท้ายทุกเคสก็ต้องวนกลับมารอให้คนช่วยตรวจอยู่ดี
AnyJev ออกแบบมาสำหรับใช้กับ Open LLM หรือโมเดลแบบเปิดที่ดาวน์โหลดมารันเองได้ ช่วยให้โมเดลตอบคำถามที่กำหนดชนิดคำตอบไว้ล่วงหน้า เช่น เลือกข้อใดข้อหนึ่งจากรายการ ตอบว่าใช่หรือไม่ใช่ หรือให้คะแนนเป็นระดับ คำตอบที่ได้จะมาพร้อมกับค่าความน่าจะเป็นของทุกตัวเลือก โดยไม่ต้องเทรนโมเดลใหม่ และไม่ต้องแก้ค่าน้ำหนักที่โมเดลเรียนรู้มาเลยแม้แต่ค่าเดียว งานวิจัยชิ้นนี้มีนักวิจัยจาก Tencent Hunyuan ร่วมพัฒนาด้วย
ชื่อ AnyJev สื่อถึงเป้าหมายอย่างตรงไปตรงมา คือทำให้ LLM ทั่วไปตัดสินใจได้เหมือนกับ Jev โมเดลที่สร้างขึ้นมาเพื่อตอบเป็นคำตัดสินใจพร้อมค่าความน่าจะเป็นโดยเฉพาะ สำหรับใครที่เคยอ่านบทความ langchain-typesafe แล้วสงสัยว่า ถ้าอยากได้คำตอบแบบนี้จาก Open LLM ที่เราเปิดรันเองจะทำได้ไหม AnyJev นี่แหละคือคำตอบ
อย่างไรก็ดี แม้จะมีคำว่า Jev อยู่ในชื่อ แต่ทีมผู้สร้างก็ระบุไว้อย่างชัดเจนว่า AnyJev ไม่ได้มีส่วนเกี่ยวข้องใดๆ กับโปรเจกต์ TypeSafe AI หรือ Jev
AnyJev อ่านคำตอบก่อนที่ LLM จะพิมพ์
โดยปกติ ก่อนที่ LLM จะเริ่มพิมพ์คำแรกออกมา ตัวโมเดลจะคำนวณคะแนนไว้อยู่แล้วว่าคำถัดไปควรเป็นคำไหน และทุกคำที่เป็นไปได้ต่างก็มีค่าความน่าจะเป็นของตัวเอง
AnyJev จึงอาศัยจังหวะนี้ โดยนำตัวอักษร A, B, C ไปกำกับไว้หน้าตัวเลือกแต่ละข้อ แล้วให้โมเดลอ่านข้อความคำสั่งหรือ Prompt เพียงรอบเดียว จากนั้นก็ดึงคะแนนของตัวอักษรเหล่านั้นออกมาตรงๆ
ผลลัพธ์คือเราไม่ต้องรอให้โมเดลพิมพ์ข้อความยาวๆ ไม่ต้องเขียนโค้ดมาคอยแกะประโยคคำตอบ และยังได้ค่าความน่าจะเป็นของทุกตัวเลือกกลับมาพร้อมกันทันที
คำถามที่ตอบด้วยวิธีนี้เรียกว่า Typed Question คือคำถามที่กำหนดชนิดของคำตอบไว้ล่วงหน้า โดย AnyJev มีให้เลือกใช้ 3 รูปแบบ:
choiceสำหรับเลือกหนึ่งข้อจากรายการ เช่น เรื่องนี้ควรส่งให้ทีมไหนnoulสำหรับคำถามที่ตอบว่าใช่หรือไม่ใช่ เช่น คำสั่งนี้สร้างความเสียหายที่ย้อนกลับไม่ได้หรือเปล่าscoreสำหรับการให้คะแนนเป็นระดับ เช่น งานคืบหน้าไปแค่ไหนแล้ว
ติดตั้งได้ง่ายๆ ด้วยคำสั่งบรรทัดเดียว:
pip install "anyjev[hf]"จากนั้นลองถามคำถามทั้งสามรูปแบบกับ Qwen3-8B โมเดลแบบเปิดขนาด 8B ที่ทีมผู้สร้างใช้ทดสอบเป็นหลัก:
from anyjev import Decider, Question
from anyjev.backends.hf import HFBackend

d = Decider(HFBackend("Qwen/Qwen3-8B"))

route = Question.choice("Which team should handle this?", ["billing", "technical", "sales", "other"], name="route")
risky = Question.noul("Is this tool call destructive or irreversible?", name="risky")
done = Question.score("How complete is the task?", bins=5, name="done")

r = d.decide({"conversation": [...], "tool_call": {...}}, [route, risky, done])
r["route"].distribution  # {"billing": 0.81, "technical": 0.07, ...}
r["risky"].p_true        # 0.12
r["done"].value          # 0.35
r.level # "L0"บรรทัด Decider(HFBackend("Qwen/Qwen3-8B")) คือจุดที่เชื่อม AnyJev เข้ากับโมเดล โดย HFBackend จะรันโมเดลผ่าน Transformers ชุดเครื่องมือสำหรับรันโมเดลแบบเปิด ถ้าใช้โมเดลแบบเปิดตัวอื่นอยู่ ก็แค่เปลี่ยนชื่อโมเดลไปชี้ที่ตัวนั้นแทน
d.decide รับสถานะปัจจุบันของงานและคำถามทั้งสามข้อได้พร้อมกันในการเรียกครั้งเดียว ในตัวอย่างนี้ สถานะของงานคือประวัติบทสนทนากับคำขอเรียกใช้เครื่องมือหรือ Tool Call ที่กำลังจะรัน
คำตอบของ route เป็นการกระจายความน่าจะเป็นของทุกทีม โดย billing ได้ค่าสูงสุดที่ 0.81 ส่วน risky ได้ความน่าจะเป็นที่คำตอบคือใช่ 0.12 และ done ได้คะแนน 0.35 จากสเกลที่ bins=5 แบ่งไว้ 5 ระดับ
บรรทัดสุดท้าย r.level จะบอกระดับของคำตอบ ซึ่ง AnyJev ออกแบบระบบไว้ 3 ระดับต่อเนื่องกัน ระดับ L0 ไม่ต้องใช้ข้อมูลตัวอย่างเลย และพร้อมใช้งานได้ทันทีตั้งแต่แรก ส่วนระดับ L1 และ L2 ต้องใช้ข้อมูลตัวอย่างที่มีเฉลยอย่าง Label หลักร้อยตัวอย่างต่อหนึ่งคำถาม คำตอบในตัวอย่างนี้จึงแสดงเป็นระดับ L0
สลับลำดับตัวเลือก คำตอบก็พลิก
จุดอ่อนข้อแรกของการอ่านคะแนนตัวอักษรตรงๆ คือปัญหา Position Bias หรืออาการที่โมเดลมักชอบบางตำแหน่งมากกว่าตำแหน่งอื่น ทำให้ตัวเลือกข้อเดียวกันได้คะแนนไม่เท่ากันเมื่อย้ายไปอยู่คนละตำแหน่ง
ทีมผู้สร้างทดสอบเรื่องนี้กับ Qwen3-8B บนชุดทดสอบ BANKING77 งานคัดแยกข้อความของลูกค้าธนาคารออกเป็น 20 หมวดหมู่ จำนวน 300 ข้อ ปรากฏว่าเมื่อลองสลับลำดับตัวเลือกจากหลังมาหน้า คำตอบที่อ่านออกมาตรงๆ พลิกไปถึง 23% ของข้อทั้งหมด
นั่นหมายความว่า บนชุดทดสอบนี้ เกือบหนึ่งในสี่ของคำตอบเปลี่ยนไปได้เพียงเพราะเราเรียงตัวเลือกกลับด้าน ทั้งที่ในการใช้งานจริง ลำดับตัวเลือกเป็นแค่สิ่งที่คนเขียนโค้ดตั้งขึ้นเอง ไม่ได้เกี่ยวอะไรกับเนื้อหาของข้อความเลย
ระดับ L0 แก้ปัญหานี้ได้โดยไม่ต้องใช้ข้อมูลตัวอย่างเลยแม้แต่ตัวเดียว ผ่าน 2 ขั้นตอน:
อย่างแรก คือถามซ้ำ K รอบตามจำนวนตัวเลือก แต่ละรอบจะเลื่อนลำดับตัวเลือกไปหนึ่งช่อง จนตัวเลือกทุกข้อวนไปอยู่ครบทุกตำแหน่ง แล้วจึงรวมคะแนนของทุกรอบเข้าด้วยกัน เพื่อให้ความเอียงเรื่องตำแหน่งหักล้างกันไปเอง
อย่างที่สอง คือหารความเอียงที่โมเดลมีต่อบางคำตอบออกไป ความเอียงนี้เรียกว่า Label Prior หรือแนวโน้มตามธรรมชาติที่โมเดลมักให้คะแนนบางคำตอบสูงกว่าคำตอบอื่นอยู่แล้ว
บนชุดทดสอบเดิม คำตอบที่พลิกไปมาลดลงเหลือเพียง 7.3% และความแม่นยำเพิ่มขึ้นจาก 0.747 เป็น 0.803
สิ่งที่ต้องแลกมาในระดับ L0 คือเวลาประมวลผล เพราะถ้ามีตัวเลือก 20 ข้อ โมเดลก็ต้องอ่าน Prompt ถึง 20 รอบ โดยการทดสอบที่ประมวลผลพร้อมกันทีละ 32 เคสบนการ์ด GPU รุ่น H100 หนึ่งใบ ใช้เวลาประมาณ 0.25 วินาทีต่อการตัดสินใจหนึ่งครั้ง
นอกจากนี้ L0 ก็ไม่ได้ช่วยทุกงาน โดยทีมผู้สร้างเตือนว่า ถ้าชุดข้อมูลมีคำตอบใดคำตอบหนึ่งครองเคสส่วนใหญ่แบบท่วมท้น การหารความเอียงออกกลับทำให้ความแม่นยำลดลงแทน
ความมั่นใจ 0.9 ต้องแปลว่าถูกเก้าในสิบ
จุดอ่อนข้อที่สองอยู่ที่ตัวเลขความมั่นใจ ตามหลักการแล้ว ถ้าโมเดลตอบคำถาม 100 ข้อด้วยความมั่นใจ 0.9 ข้อที่ตอบถูกก็ควรจะมีประมาณ 90 ข้อ ความมั่นใจที่ตรงกับอัตราตอบถูกจริงแบบนี้เรียกว่า Calibration
ความมั่นใจคลาดเคลื่อนจากอัตราตอบถูกจริงแค่ไหน วัดได้ด้วยค่า ECE หรือชื่อเต็มว่า Expected Calibration Error ยิ่งค่านี้ต่ำ ตัวเลขความมั่นใจก็ยิ่งน่าเชื่อถือ บนชุดทดสอบเดิมของ Qwen3-8B คะแนนที่อ่านตรงๆ มีค่า ECE สูงถึง 0.240 พอผ่านระดับ L0 ก็ลดลงเหลือ 0.184 ซึ่งยังลดไม่มากนัก เพราะ L0 ไม่ได้ออกแบบมาแก้ปัญหานี้โดยตรง
ระดับ L1 เข้ามาแก้จุดนี้ด้วยการเพิ่มตัวเลขปรับสเกลเพียงตัวเดียวที่เรียกว่า Temperature ตัวเลขนี้จะยืดหรือบีบค่าความมั่นใจของทุกคำตอบให้เข้าใกล้อัตราตอบถูกจริง โดยไม่ทำให้ลำดับตัวเลือกที่ได้คะแนนสูงสุดเปลี่ยนไป ผลคือค่า ECE ลดลงเหลือเพียง 0.095
การหาค่า Temperature ต้องใช้ข้อมูลที่มีเฉลยประมาณ 100–500 ตัวอย่างต่อคำถาม ส่วนในโค้ดก็เรียกใช้เพียงบรรทัดเดียวคือ d.calibrate(risky, states, labels)
ตรงนี้เป็นจุดที่อาจเข้าใจผิดได้ง่าย คำว่า "ไม่ต้องเทรน" ไม่ได้แปลว่าไม่ต้องมีข้อมูล เพราะระดับ L1 ยังต้องใช้ข้อมูลที่มีเฉลยจริงอยู่ เพียงแต่ทั้งหมดเป็นการคำนวณทางสถิติ ไม่มีรอบการเทรน และไม่ได้ปรับค่าน้ำหนักใดๆ ของโมเดลเลย
แม่นขึ้นแค่ 6 คะแนน แต่ปล่อยให้ระบบตัดสินเองได้ครึ่งหนึ่ง
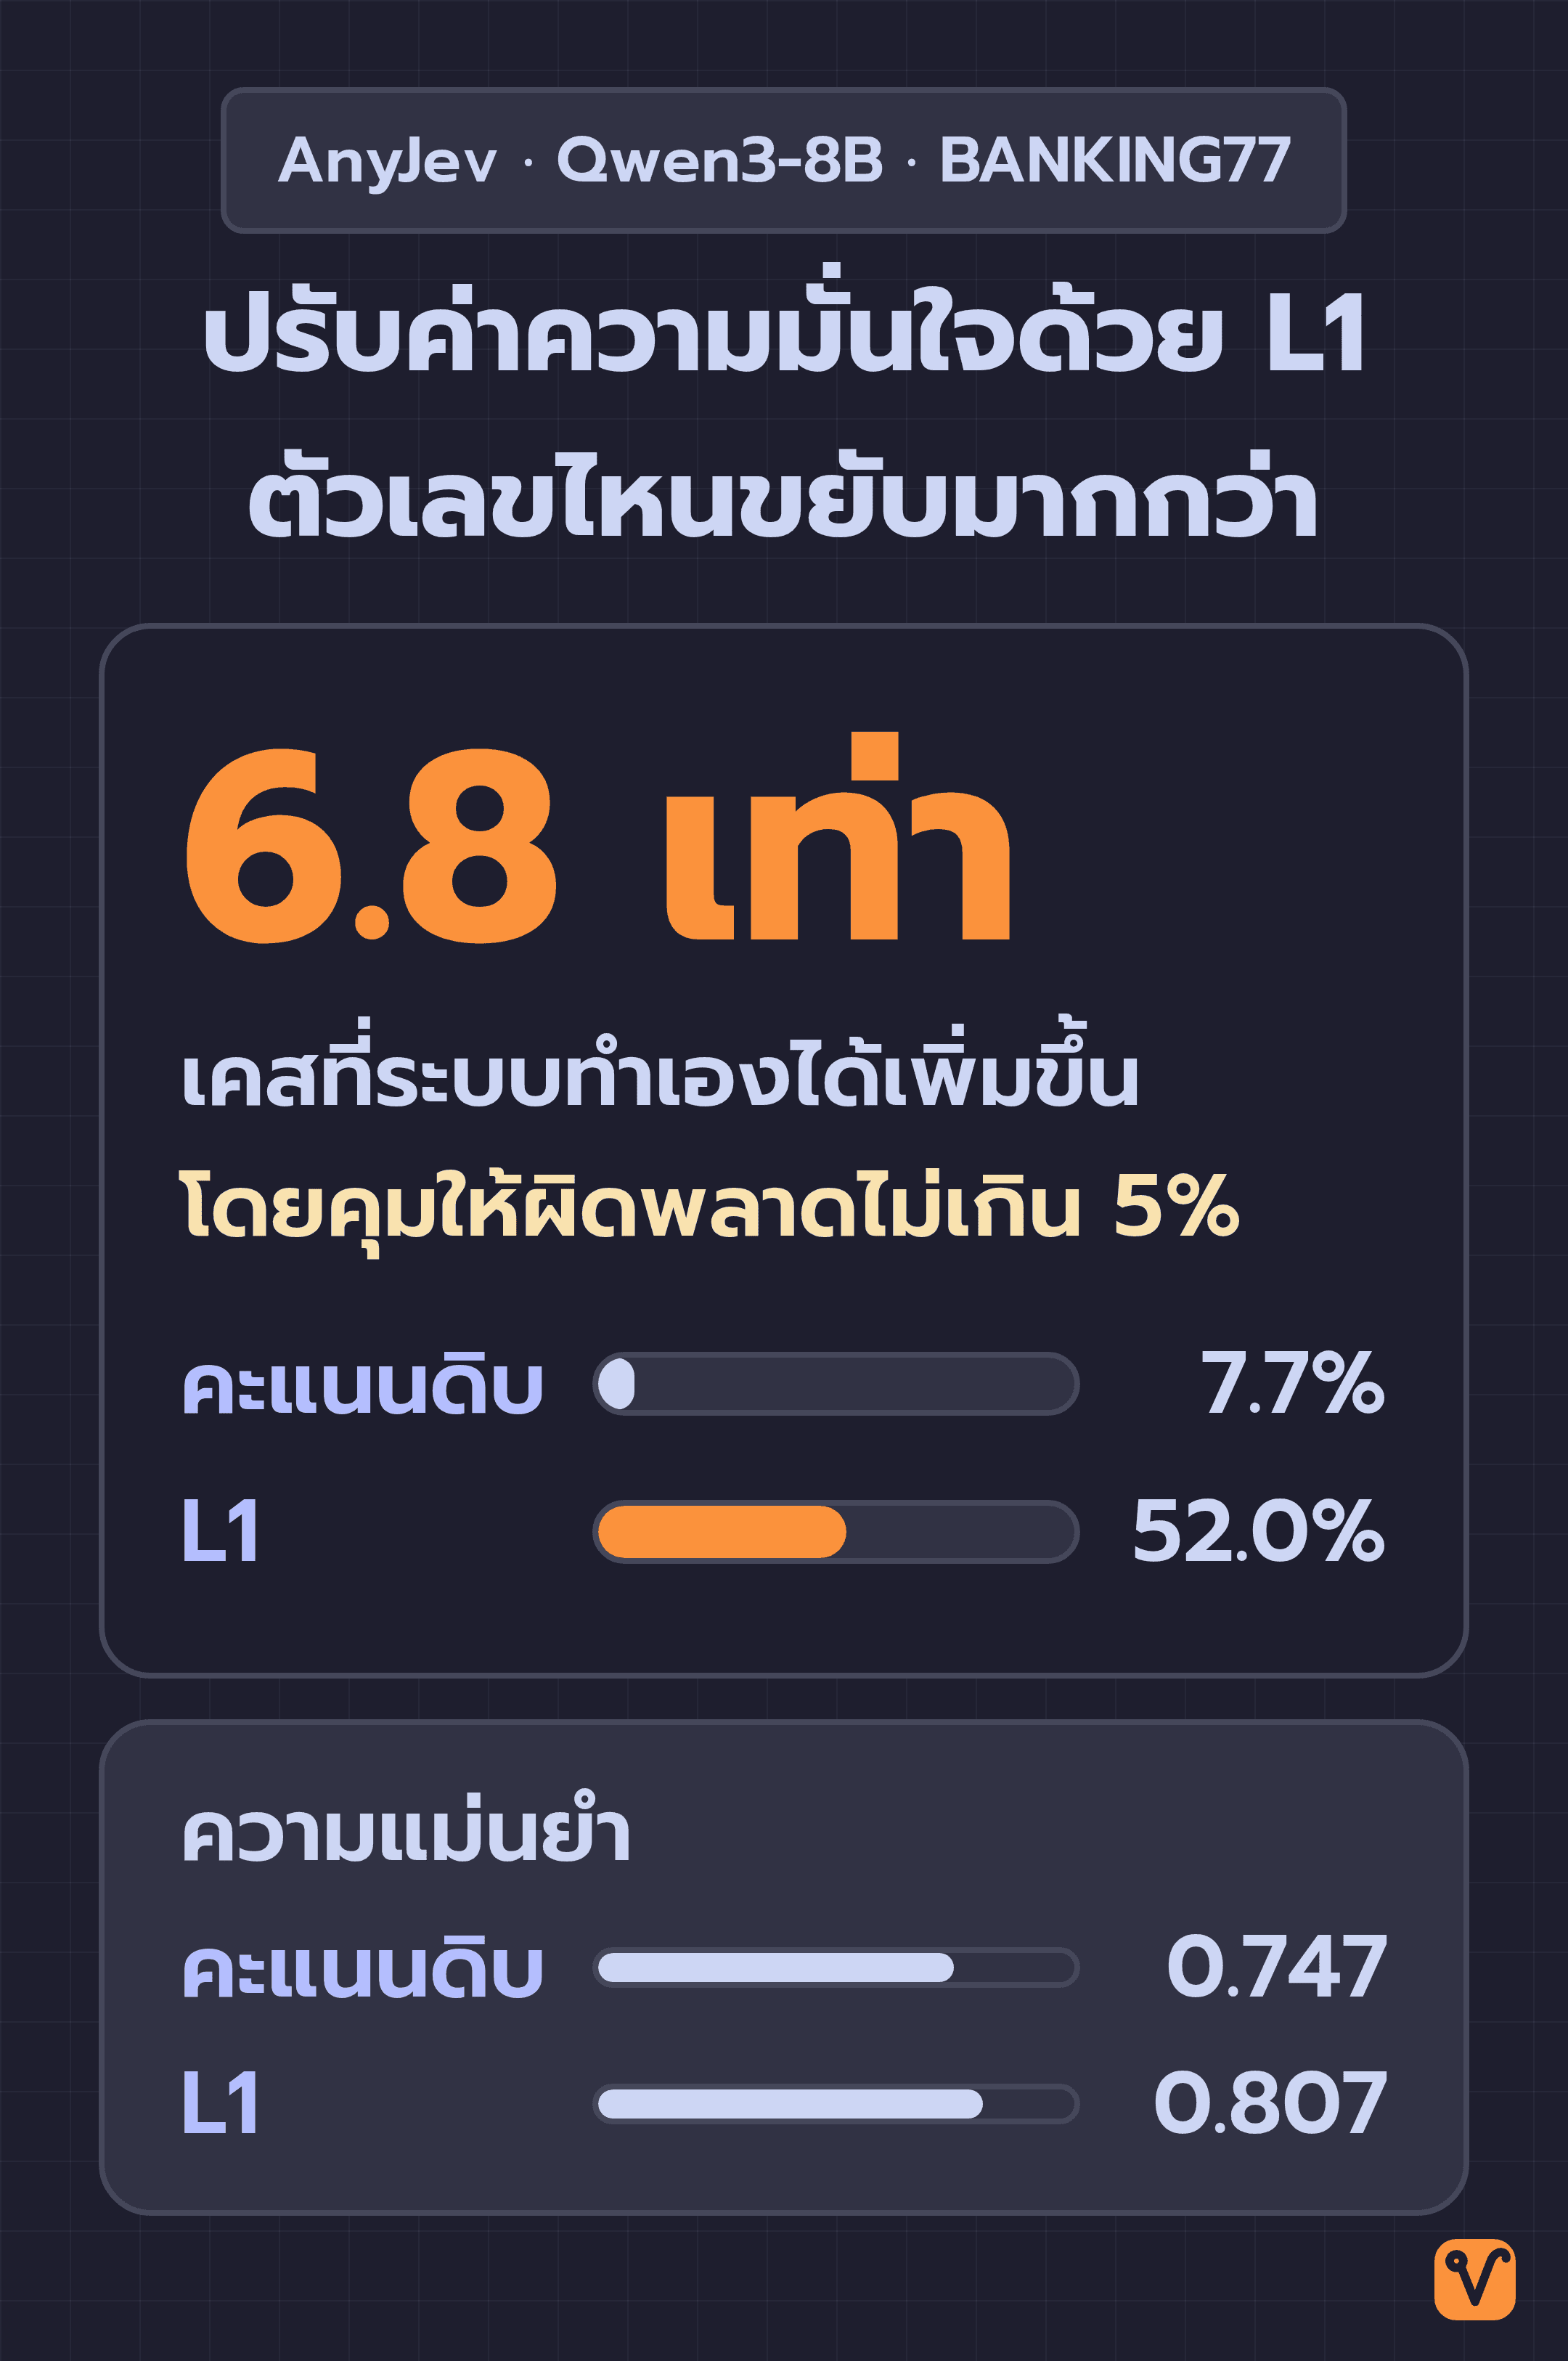
จริงอยู่ที่ความแม่นยำของ Qwen3-8B บนชุดทดสอบ BANKING77 ขยับจาก 0.747 เป็น 0.807 หลังผ่าน L1 หรือเพิ่มขึ้น 6 คะแนน
แต่ตัวเลขที่ขยับแรงกว่ามากคือสัดส่วนของเคสที่ปล่อยให้ระบบตัดสินใจเองได้ โดยคุมอัตราความผิดพลาดของเคสที่ระบบทำเองไว้ไม่เกิน 5%
สัดส่วนเคสที่ระบบจัดการเองได้นี้ พุ่งจากเดิมเพียง 7.7% เมื่อใช้คะแนนดิบ ขึ้นมาเป็น 46.3% ในระดับ L0 และแตะ 52.0% ในระดับ L1 ซึ่งคิดเป็นงานที่ปล่อยให้ระบบทำเองได้เพิ่มขึ้นถึง 6.8 เท่าในการทดสอบนี้
เหตุผลอยู่ที่วิธีตั้งเกณฑ์ตัดสินใจ ระบบจะปล่อยให้โมเดลตัดสินใจเองเฉพาะเคสที่ค่าความมั่นใจสูงกว่าเกณฑ์ที่กำหนดไว้ ส่วนเคสที่เหลือจะส่งให้คนดูแลต่อ หากตัวเลขความมั่นใจเชื่อถือไม่ได้ ไม่ว่าจะตั้งเกณฑ์ไว้ระดับไหนก็คุมความผิดพลาดไม่อยู่ เคสเกือบทั้งหมดจึงต้องตกไปอยู่กับคน แต่พอตัวเลขความมั่นใจสะท้อนความเป็นจริง เกณฑ์ที่ตั้งไว้ก็เริ่มคัดแยกเคสได้อย่างมีประสิทธิภาพ
ทีมผู้สร้างตั้งข้อสังเกตว่า ตัวเลขนี้คำนวณจากกลุ่มตัวอย่าง 300 ข้อความ ทำให้ช่วงความคลาดเคลื่อนทางสถิติยังค่อนข้างกว้าง ตัวเลข 52% จึงควรมองเป็นแนวโน้มมากกว่าค่าที่แน่นอนตายตัว ใครอยากดูการทดลองย่อยทั้งหมด เข้าไปดูได้ที่ ตารางผลทดสอบฉบับเต็ม
L2 หยุดโมเดลไว้ที่สองในสามแล้วตอบ
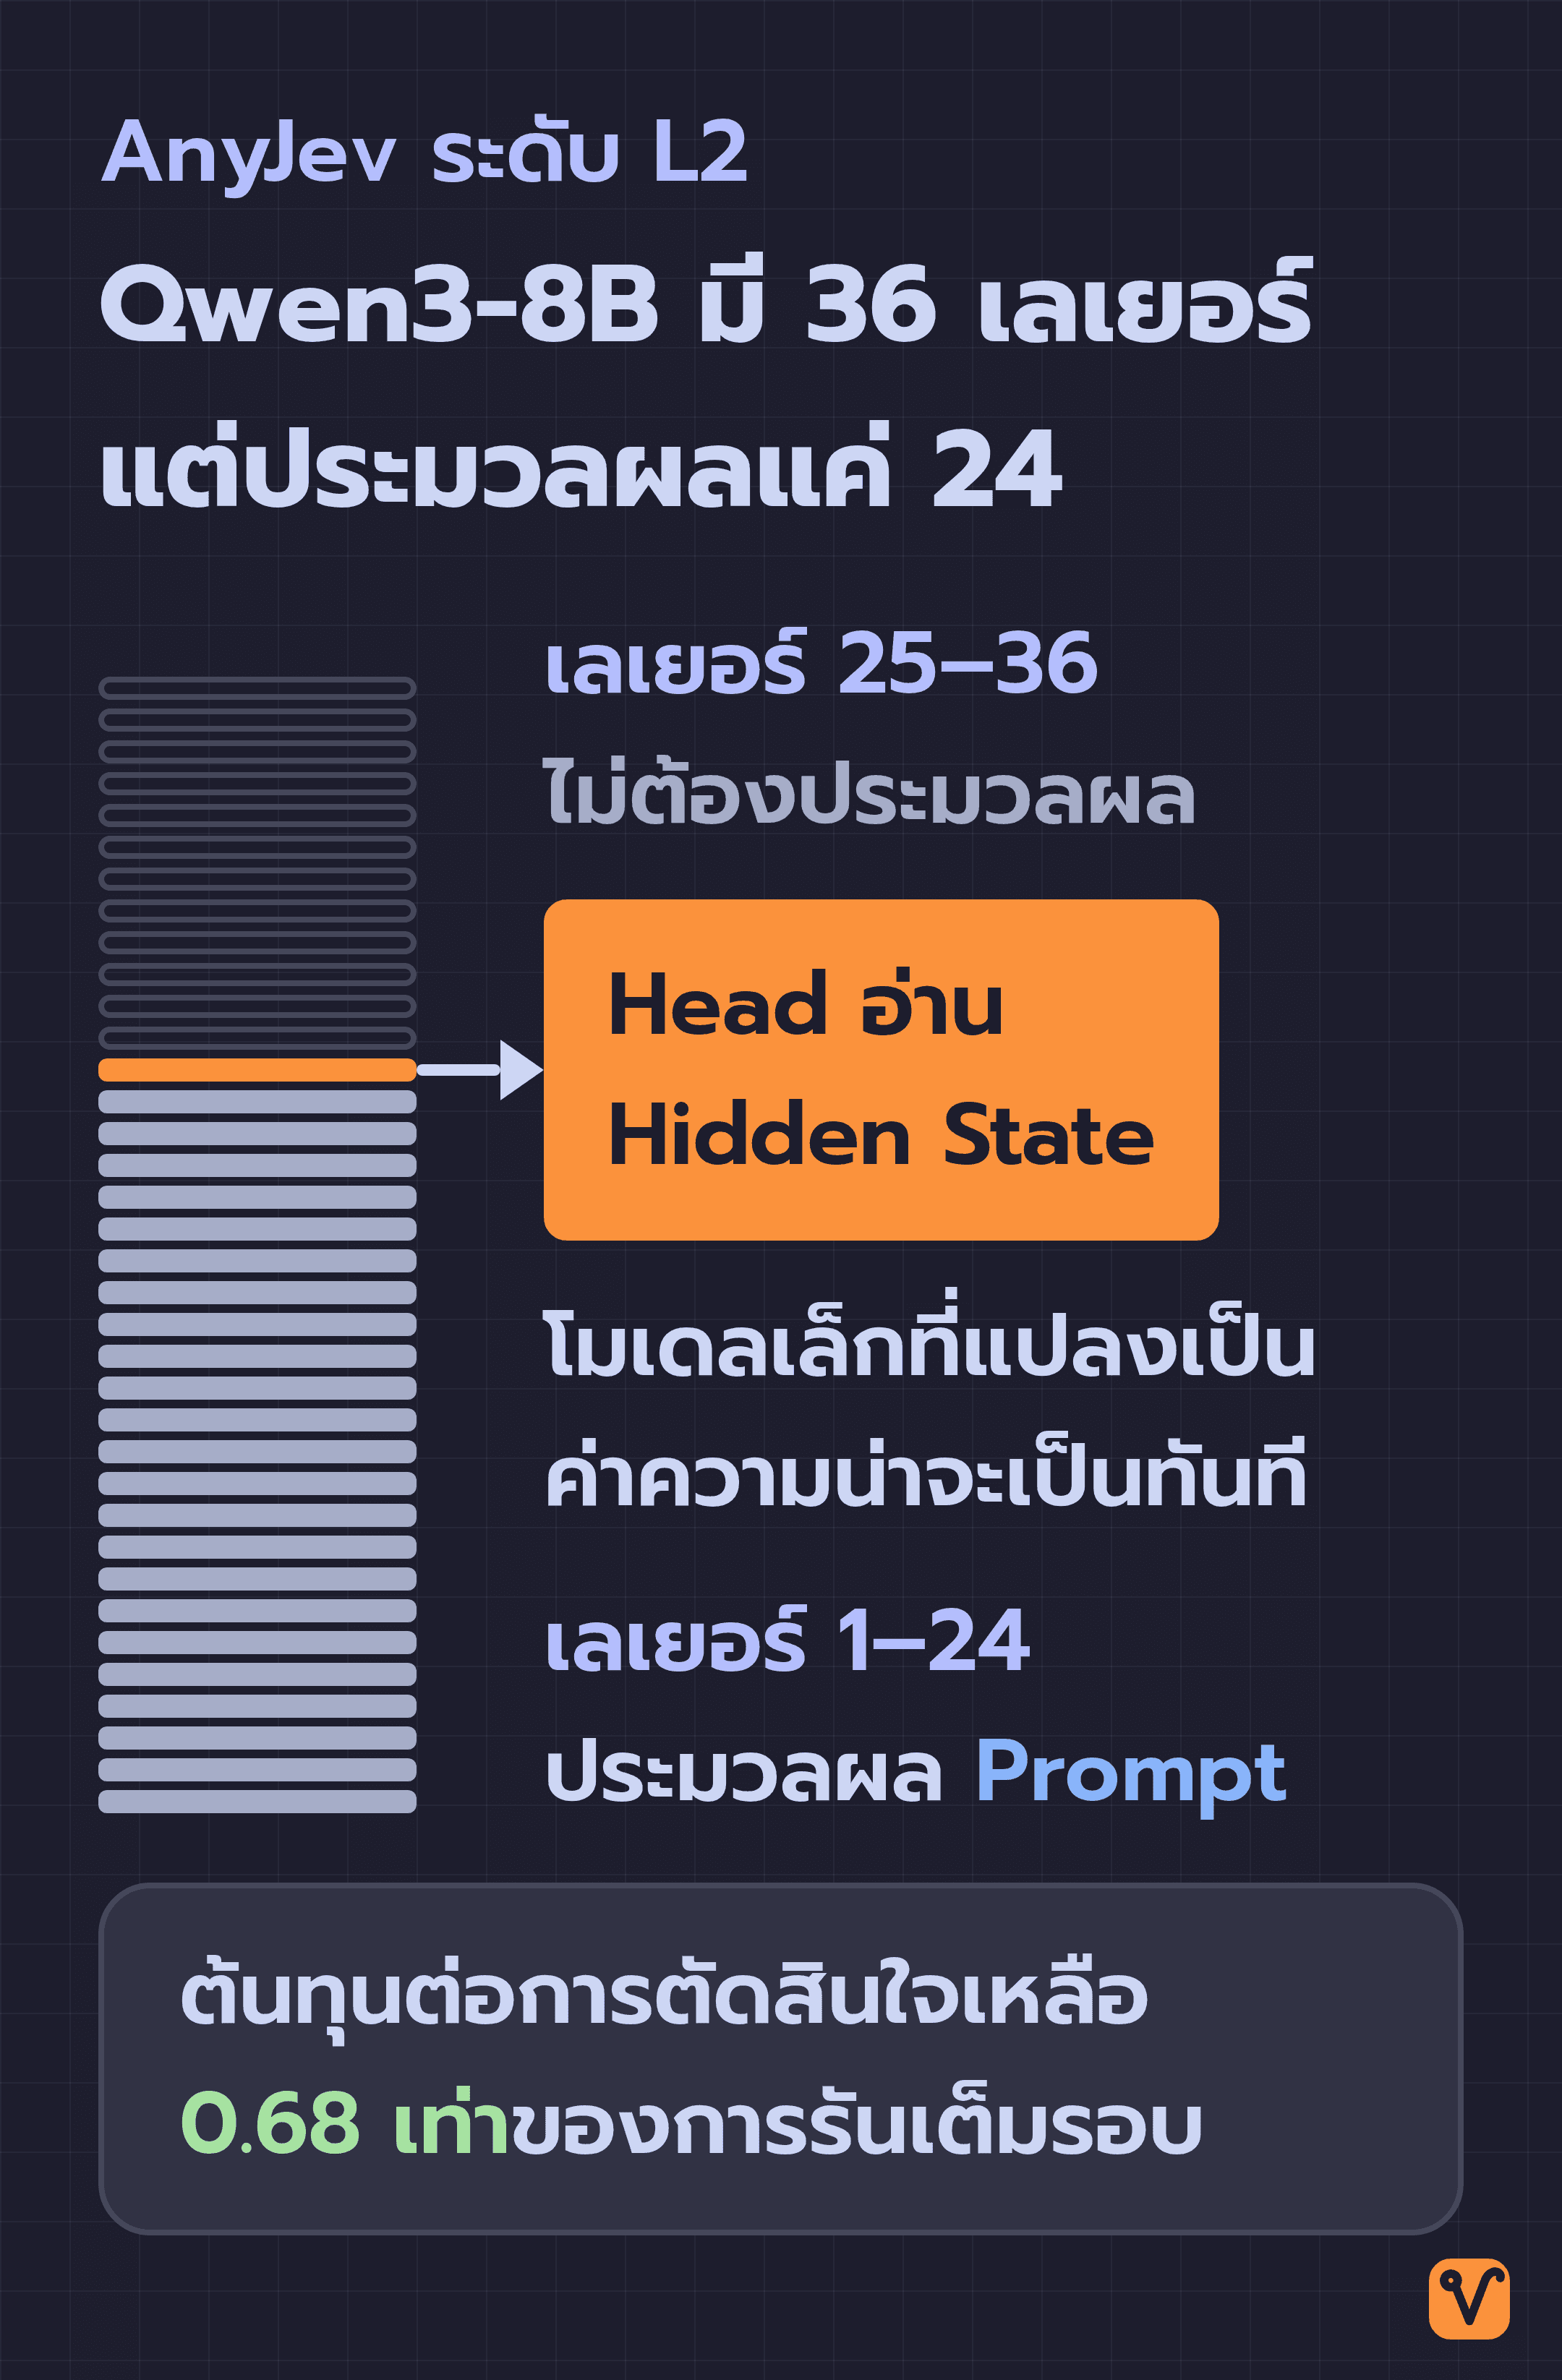
ระดับ L0 และ L1 ยังเป็นการอ่านคำตอบจากปลายทางของโมเดล แต่ระดับ L2 จะเข้าไปดึงข้อมูลจากข้างในโมเดลโดยตรง
ปกติแล้ว LLM จะประมวลผล Prompt ผ่านเลเยอร์ต่างๆ ที่เรียงต่อกันเป็นลำดับ ใน Qwen3-8B มีทั้งหมด 36 เลเยอร์ ค่าที่ส่งออกมาจากแต่ละเลเยอร์เรียกว่า Hidden State คือชุดตัวเลขที่บันทึกสิ่งที่โมเดลเข้าใจจากข้อความจนถึงเลเยอร์นั้น
ระดับ L2 จะสร้างโมเดลขนาดเล็กที่เรียกว่า 'Head' ขึ้นมาสำหรับแต่ละคำถาม Head คือสูตรคำนวณที่อ่าน Hidden State ตรงจุดราวๆ สองในสามของความลึกโมเดล แล้วแปลงเป็นค่าความน่าจะเป็นของแต่ละตัวเลือกทันที
การสร้าง Head ใช้ข้อมูลที่มีเฉลยเพียง 100–300 ตัวอย่างต่อคำถาม และคำนวณหาสูตรได้ในรอบเดียว โดยไม่ต้องวนลูปเทรนหลายรอบเหมือนการ Fine-tune ทั่วไป การประมวลผลบน CPU ใช้เวลาเพียงไม่กี่วินาที และไฟล์ Head แต่ละตัวก็มีขนาดเล็กมาก แค่ราวๆ 100 KB
ในการใช้งานจริง Qwen3-8B จะประมวลผลถึงแค่เลเยอร์ที่ 24 แล้วหยุดทันที ไม่ต้องส่งต่อไปจนสุดเลเยอร์ที่ 36 ทำให้ต้นทุนเวลาและทรัพยากรต่อการตัดสินใจหนึ่งครั้งเหลือเพียง 0.68 เท่าของการรันโมเดลเต็มรอบ ซึ่งเร็วกว่ากันชัดเจนเมื่อเทียบกับ L0 ที่ต้องอ่าน Prompt ซ้ำถึง K รอบ
ทีมผู้สร้างทดสอบ L2 บนชุดทดสอบ typed-decisions ที่มี 20 คำถาม โดยแต่ละคำถามใช้ข้อมูลที่มีเฉลย 300 ตัวอย่างสร้าง Head แล้วนำไปวัดผลกับข้อมูลทดสอบอีก 2,000 เคสที่แยกเก็บไว้ ผลปรากฏว่า ความแม่นยำของ Qwen3-8B เพิ่มขึ้นจาก 0.647 ในระดับ L0 เป็น 0.771 ในระดับ L2
เมื่อเทียบกับโมเดลอื่นบนชุดทดสอบเดียวกัน โมเดล Jev มีตัวเลขที่ประกาศไว้ที่ 0.727 ส่วน Laya โมเดลขนาด 421M ที่ผ่านการเทรนเพิ่มมาโดยเฉพาะ ทำคะแนนได้ 0.768
ทีมผู้สร้างจึงสรุปว่า แม้แต่ Qwen3-1.7B ที่หยุดทำงานไว้ที่ 64% ของความลึก ก็ทำคะแนนเทียบเท่า Jev ได้แล้ว และ Qwen3-4B ก็ขยับขึ้นมาอยู่ในระดับเดียวกับ Laya ทั้งนี้ ตัวเลขของ Jev และ Laya เป็นค่าที่เจ้าของโมเดลประกาศไว้เอง ทีม AnyJev ไม่ได้รันซ้ำ
อีกจุดหนึ่งที่ควรเข้าใจให้ตรงกันคือ คำว่า "ความแม่นยำ" ในชุดทดสอบนี้ไม่ได้เทียบกับเฉลยที่คนตรวจ แต่เทียบกับคำตอบของ LLM อีกตัวที่นำมาใช้เป็น "ครู" โดยเฉลยแต่ละข้อได้จากการถามครูตัวนั้น 3 ครั้งแล้วหาค่าเฉลี่ย ถ้าเรานำคำถามเดิมไปถามครูตัวเดิมซ้ำอีกครั้ง คำตอบใหม่จะตรงกับเฉลยเฉลี่ยของตัวมันเองเพียง 0.735 เท่านั้น ตัวเลขระดับ 0.77 ของ L2 จึงควรอ่านเทียบกับเกณฑ์ 0.735 นี้ ไม่ใช่เทียบกับความแม่นยำเต็ม 1.0
ส่วนจะเก็บ Label มากน้อยแค่ไหนก็ขึ้นอยู่กับการตัดสินใจของเรา จากการทดสอบ Head ของ Qwen3-8B พบว่า:
- ใช้ 20 ตัวอย่าง ได้ความแม่นยำ 0.654
- ใช้ 100 ตัวอย่าง ได้ความแม่นยำ 0.740
- ใช้ 300 ตัวอย่าง ได้ความแม่นยำ 0.772
จะเห็นว่า 100 ตัวอย่างแรกคุ้มค่าและเห็นผลชัดเจนที่สุด หลังจากนั้นข้อมูลที่เพิ่มเข้ามาแต่ละตัวจะช่วยให้ดีขึ้นทีละน้อย การเก็บข้อมูลน้อยจึงช่วยให้เปิดใช้ L2 ได้เร็ว ส่วนการเก็บข้อมูลมากจะช่วยให้แม่นยำขึ้น แต่ต้องแลกกับการรอสะสมข้อมูลนานขึ้น
นอกจากนี้ Head ยังปรับตัวตามสำนวนคำถามที่เปลี่ยนไปได้ดี ถ้าเขียนคำถามเดิมด้วยสำนวนอื่น ความแม่นยำของ Head เดิมอาจลดลงจาก 0.77 เหลือ 0.65–0.70 แต่พอให้โมเดลได้เห็นตัวอย่างข้อความที่ใช้สำนวนใหม่เพียง 30 ข้อความ โดยไม่ต้องมีเฉลยเลยแม้แต่ข้อเดียว ความแม่นยำก็ดีดกลับมาที่ 0.74–0.75 ซึ่งใกล้เคียงกับระดับ 0.77 ที่ต้องเสียเวลาเก็บเฉลยใหม่ทั้งหมด
ในแง่การเขียนโค้ด ขั้นตอนการยกระดับขึ้นเป็น L1 และ L2 มีหน้าตาแบบนี้:
d.calibrate(risky, states, labels) # 100–500 labels → L1 (a temperature)
d.fit_head(route, states, labels) # 100–300 labels → L2, one forward + a closed-form solve, seconds
d.save_artifacts("qwen3-8b.json") # d.load_artifacts(...) next time; ~100 KB per head
r = d.decide(state, [route], level="auto") # L2 where a head routes, else L1, else L0
r["route"].level # "L2"คำสั่ง fit_head ใช้สร้าง Head ให้กับคำถาม route ส่วน save_artifacts จะบันทึก Head เก็บเป็นไฟล์ JSON เพื่อโหลดกลับมาใช้ใหม่ได้ทันที และเมื่อตั้งค่า level="auto" ระบบจะเลือกใช้ระดับ L2 ให้อัตโนมัติถ้าคำถามนั้นมี Head อยู่แล้ว แต่ถ้าไม่มีก็จะถอยลงมาใช้ L1 หรือ L0 ตามลำดับ
วันแรกเริ่มที่ L0 แล้วค่อยสะสม label ระหว่างทาง
ทีมผู้สร้างวางลำดับการนำไปใช้งานจริงไว้ชัดเจน วันแรกเราแค่กำหนดคำถามแล้วเปิดระบบด้วย level="auto" ทุกคำตอบจะอยู่ที่ระดับ L0 เพราะเรายังไม่มีข้อมูลที่มีเฉลยเลย
จากนั้น เราค่อยสะสม Label จากหน้างานจริง เช่น จากคิวที่คนช่วยตรวจทาน จากผลลัพธ์ที่เกิดขึ้นจริง หรือจากคำตอบของ LLM ตัวเดิมที่ AnyJev จะเข้าไปทำหน้าที่แทน แล้วส่ง Label แต่ละตัวเข้าระบบด้วยคำสั่งเดียว
d.observe(route, state, label) # stores labels as they arrive; solves the head at 30, re-solves at 60, 120, …d.observe เก็บ Label ทุกตัวที่เข้ามา เมื่อสะสมครบ 30 ตัวก็สร้าง Head ของคำถาม route ให้อัตโนมัติ และสร้างใหม่อีกครั้งเมื่อครบ 60 ตัว 120 ตัว ต่อเนื่องไปเรื่อยๆ
คำตอบทุกครั้งจะบอกระดับมาด้วยเสมอ โค้ดที่รับคำตอบไปใช้ต่อจึงตั้งระดับขั้นต่ำไว้ แล้วปฏิเสธคำตอบที่ระดับยังไม่ถึงได้
ตรงนี้เปิดโอกาสให้เราตัดสินใจตามระดับความสำคัญของงาน:
- งานที่ผิดพลาดแล้วแก้ไขได้ง่าย เช่น การส่งเรื่องผิดทีม เราอาจรับคำตอบระดับ L0 เพื่อเริ่มใช้งานระบบอัตโนมัติได้ตั้งแต่วันแรก
- ส่วนงานที่ส่งผลกระทบรุนแรงและย้อนกลับไม่ได้ เช่น คำสั่งลบข้อมูล เราอาจตั้งกฎว่าต้องรอให้มี Head (L2) ก่อนเท่านั้น แม้จะต้องแลกกับการให้คนตรวจทุกเคสในช่วงแรกก็ตาม
เมื่อเปิดใช้งานในระยะยาว การเปลี่ยนแปลงแต่ละแบบต้องการวิธีรับมือต่างกัน:
| สิ่งที่เปลี่ยน | สิ่งที่ต้องทำ |
|---|---|
| สำนวนของคำถาม หรือลำดับของตัวเลือก | ไม่ต้องทำอะไร ระบบจะปรับตัวให้อัตโนมัติ |
| เพิ่มคำถามใหม่ หรือเปลี่ยนชุดตัวเลือกใหม่ | ต้องเก็บ Label ใหม่ |
| เปลี่ยนโมเดลหลักที่ใช้งาน | สร้าง Head ใหม่ทุกตัวจาก Label เดิมที่เก็บไว้ |
อย่างไรก็ดี ยังมีการเปลี่ยนแปลงอีกรูปแบบหนึ่งที่ระบบตรวจจับเองไม่ได้ นั่นคือลักษณะของเคสที่ส่งเข้ามาใช้งานจริงเปลี่ยนไปตามเวลา ทั้งที่คำถามยังคงเดิม ทีมผู้สร้างจึงแนะนำให้สุ่มตรวจทานกับชุดข้อมูลที่มีเฉลยอยู่เป็นระยะ เพราะถ้าข้ามขั้นตอนนี้ไป จะไม่มีสัญญาณเตือนใดๆ เลย
ถ้าอยากทดลองดูภาพรวมการทำงานทั้งหมดก่อนดาวน์โหลดโมเดลจริง ในโปรเจกต์มีสคริปต์เดโมที่รันบนโมเดลจำลองได้ในเวลาไม่ถึงหนึ่งวินาที โดยไม่ต้องดาวน์โหลดอะไรเลย:
python -m demo.jev_mode --backend fake
python -m demo.jev_mode --backend fake --lifecycleบรรทัดที่สองเติม --lifecycle เพื่อจำลองขั้นตอนการใช้งานตั้งแต่วันแรกให้ดู พอพร้อมทดลองกับโมเดลจริง แค่ตัด --backend fake ออก สคริปต์จะสลับไปรันบนโมเดล Qwen3 จริงพร้อมโหลด Head ตัวอย่างที่มีมาให้ทันที
ข้อจำกัดที่ต้องรู้ก่อนนำไปใช้กับระบบจริง
- ปัจจุบันรองรับเฉพาะ Transformers เท่านั้น: การนำไปรันให้บริการผ่านเครื่องมือช่วยประมวลผล (Inference Engine) อย่าง vLLM หรือ SGLang ยังอยู่ในแผนงานการพัฒนา และยังไม่พร้อมใช้งานในเวอร์ชันนี้
- ระดับ L2 จำเป็นต้องรันโมเดลเอง: เพราะระบบต้องเข้าไปอ่านค่า Hidden State จากโครงสร้างภายในของโมเดล จึงใช้กับโมเดลภายนอกที่เรียกผ่าน API ไม่ได้
- Head สำเร็จรูปมีเฉพาะตระกูล Qwen3 เท่านั้น: มีให้เลือก 5 ขนาด ได้แก่ 1.7B, 4B, 8B, 30B-A3B และ 32B ขนาดละ 23 Head ซึ่งสร้างขึ้นจากชุดคำถามในการทดลองเท่านั้น สำหรับคำถามใช้งานจริง เราต้องเก็บ Label เพื่อสร้าง Head ของตัวเอง เพราะ Head ใช้ข้ามคำถามหรือข้ามโมเดลไม่ได้ ส่วนตัวเลขผลการทดสอบหลักทั้งหมดก็มาจากโมเดลตระกูล Qwen เป็นหลัก
- ตัวเลือกรองรับได้ไม่เกิน 26 ข้อ: ตามจำนวนตัวอักษรภาษาอังกฤษ (A–Z) ที่ใช้กำกับหน้าตัวเลือก
- ยังไม่ได้วัดผลในงานของระบบอัตโนมัติอย่าง AI Agent จริง: ผลทดสอบทั้งหมดเป็นการประเมินการตัดสินใจทีละครั้งแบบเดี่ยวๆ ยังไม่ได้ทดสอบกับงานหลายขั้นตอนที่ต่อเนื่องกันในลูปของ Agent จริง
- ช่วยไม่ได้ในงานที่โมเดลทำไม่เป็นตั้งแต่แรก: เช่น งานทดสอบหาเส้นทางในเขาวงกตและเกม Minesweeper ไม่มีวิธีอ่านคำตอบแบบไหนทำได้ดีกว่าการเดาแบบพื้นฐานที่สุดเลย
ในความเป็นจริง ระบบอัตโนมัติอาจไม่ได้ต้องการ LLM ที่สมบูรณ์แบบจนไม่เคยตอบผิด แต่ต้องการ LLM ที่บอกได้อย่างตรงไปตรงมาว่า ข้อไหนที่มั่นใจได้ และข้อไหนที่เสี่ยงผิดพลาด เพื่อให้คนเข้ามาช่วยดูแลได้ถูกจังหวะ
ที่มา: โปรเจกต์ AnyJev บน GitHub
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
สร้าง Claude Skill แบบไม่ต้องรู้โค้ด คู่มือสร้าง Claude Skill ของคุณเองด้วยการคุยกับ Claude Code เป็นภาษาไทย
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ