$ loading
$ cd ~/local-llm
Local LLM รัน AI บนเครื่อง และควบคุมระบบได้ด้วยตัวเอง
เลือกโมเดลและ quantization ให้พอดีกับฮาร์ดแวร์ พร้อมชั่งเรื่องคุณภาพ ความเร็ว ความเป็นส่วนตัว และภาระดูแลก่อนเริ่ม
$ cat local-llm/answer.md
Local LLM คืออะไร และมีข้อแลกเปลี่ยนอย่างไร
Local LLM คือการดาวน์โหลดน้ำหนักโมเดลมาประมวลผลบนคอมพิวเตอร์หรือเซิร์ฟเวอร์ที่เราควบคุม แทนการส่งทุกคำขอไปยัง API ภายนอก ข้อดีคือกำหนดที่เก็บข้อมูล การเชื่อมต่อ และเวอร์ชันของโมเดลได้เอง ใช้งานแบบออฟไลน์ได้ในบางระบบ และไม่มีค่าบริการต่อโทเคนจากผู้ให้บริการ แต่ยังมีต้นทุนฮาร์ดแวร์ ไฟฟ้า เวลาในการตั้งค่า และการดูแลความปลอดภัย ขนาดโมเดล รูปแบบ quantization และความยาว context มีผลต่อ RAM หรือ VRAM ความเร็ว และคุณภาพ จึงควรเริ่มจากโมเดลที่เล็กพอกับเครื่อง แล้วทดสอบด้วยงานจริงก่อนขยับขึ้น ความเป็นส่วนตัวจะเกิดขึ้นได้ก็ต่อเมื่อทั้งโมเดล แอป ส่วนเสริม และเครื่องมือที่เชื่อมต่อทำงานอยู่ในขอบเขตที่เราควบคุมจริง
$ ls ~/local-llm
เริ่มรัน Local LLM จากตรงไหน
เลือกอ่านตามเป้าหมายของคุณ แต่ละเส้นทางพาไปยังบทความในหมวดนั้นโดยตรง
$ tail -f local-llm.log
บทความล่าสุดเรื่อง Local LLM จากการรันจริง
$ grep -ri "local-llm" ~/journal
เลือกอ่านตามหมวด
โมเดล AI · 18 เรื่อง
010203
AuK โมเดลเสียงโอเพนซอร์สจาก Tencent Hunyuan แก้คำในไฟล์เสียงที่อัดไว้แล้วได้ตามข้อความที่พิมพ์ ไม่ต้องอัดใหม่ทั้งท่อน
13 ก.ย. 2569 · 12 นาที · อ่าน 24 ครั้งYuE2 เป็นโมเดลเพลง AI โอเพนซอร์สที่ทำคะแนน WildSongBench ไล่ทัน Suno แล้ว พร้อมให้แก้โน้ตและคอร์ดเองได้
12 ก.ย. 2569 · 14 นาที · อ่าน 134 ครั้งQwen3.8-27B คือโมเดลเปิดที่มองหน้าจอแล้วสั่งงานได้เอง โดยทำคะแนน OSWorld ได้ 84.3 เทียบกับรุ่นก่อนที่ 63.9
1 ก.ย. 2569 · 10 นาที · อ่าน 44 ครั้งฟีเจอร์ & อัปเดต · 3 เรื่อง
010203
Claude Desktop เชื่อมต่อกับ Ollama ได้แล้ว สลับไปใช้โมเดลในเครื่องของตัวเองด้วยสวิตช์เดียว
26 ส.ค. 2569 · 5 นาที · อ่าน 68 ครั้งllama.cpp รองรับ MCP แบบ stdio แล้ว · โมเดลที่รันในเครื่องสั่งงานเครื่องมือภายนอกได้เอง
26 ก.ค. 2569 · 11 นาที · อ่าน 41 ครั้งอัปเดต Ollama เป็น 0.31 แล้ว Gemma 4 บน Mac ตอบเร็วขึ้นเกือบ 90% โดยไม่ต้องเปลี่ยนเครื่อง
1 ก.ค. 2569 · 7 นาที · อ่าน 66 ครั้งสอนใช้งาน · 6 เรื่อง
010203
MiniMax Music 3 เปิดน้ำหนักโมเดล: เริ่มทำเพลงใน ComfyUI แบบแยก Lyrics กับ Caption
16 ส.ค. 2569 · 12 นาที · อ่าน 17 ครั้งการตั้งค่าสามอย่างใน ComfyUI ที่ผู้ใช้ RTX 4070 รายงานว่าลดเวลาเรนเดอร์ MiniMax H3 เหลือราวหนึ่งในสาม
11 ส.ค. 2569 · 12 นาที · อ่าน 86 ครั้งMiniMax H3 บน ComfyUI ปั้นคลิปพร้อมเสียงในรอบเดียว โหลดมารันเองได้ แลกกับพื้นที่ดิสก์ 42 GB
4 ส.ค. 2569 · 12 นาที · อ่าน 160 ครั้งเครื่องมือ & สกิล · 15 เรื่อง
010203
AnyJev จาก Nokia เปลี่ยน Open LLM ให้ตัดสินใจแบบ Jev ได้ ตอบตามชนิดที่กำหนด พร้อมค่าความน่าจะเป็นที่เชื่อถือได้ โดยไม่ต้องเทรน
24 ก.ย. 2569 · 18 นาที · อ่าน 10 ครั้งWARP 0.8.0 รัน DeepSeek-V4.1-Flash 552B ทั้งก้อนบนโน้ตบุ๊กได้ โดย README ระบุว่า RAM 16GB พอ แต่ SSD ภายในต้องเหลือพื้นที่ว่าง 299 GiB
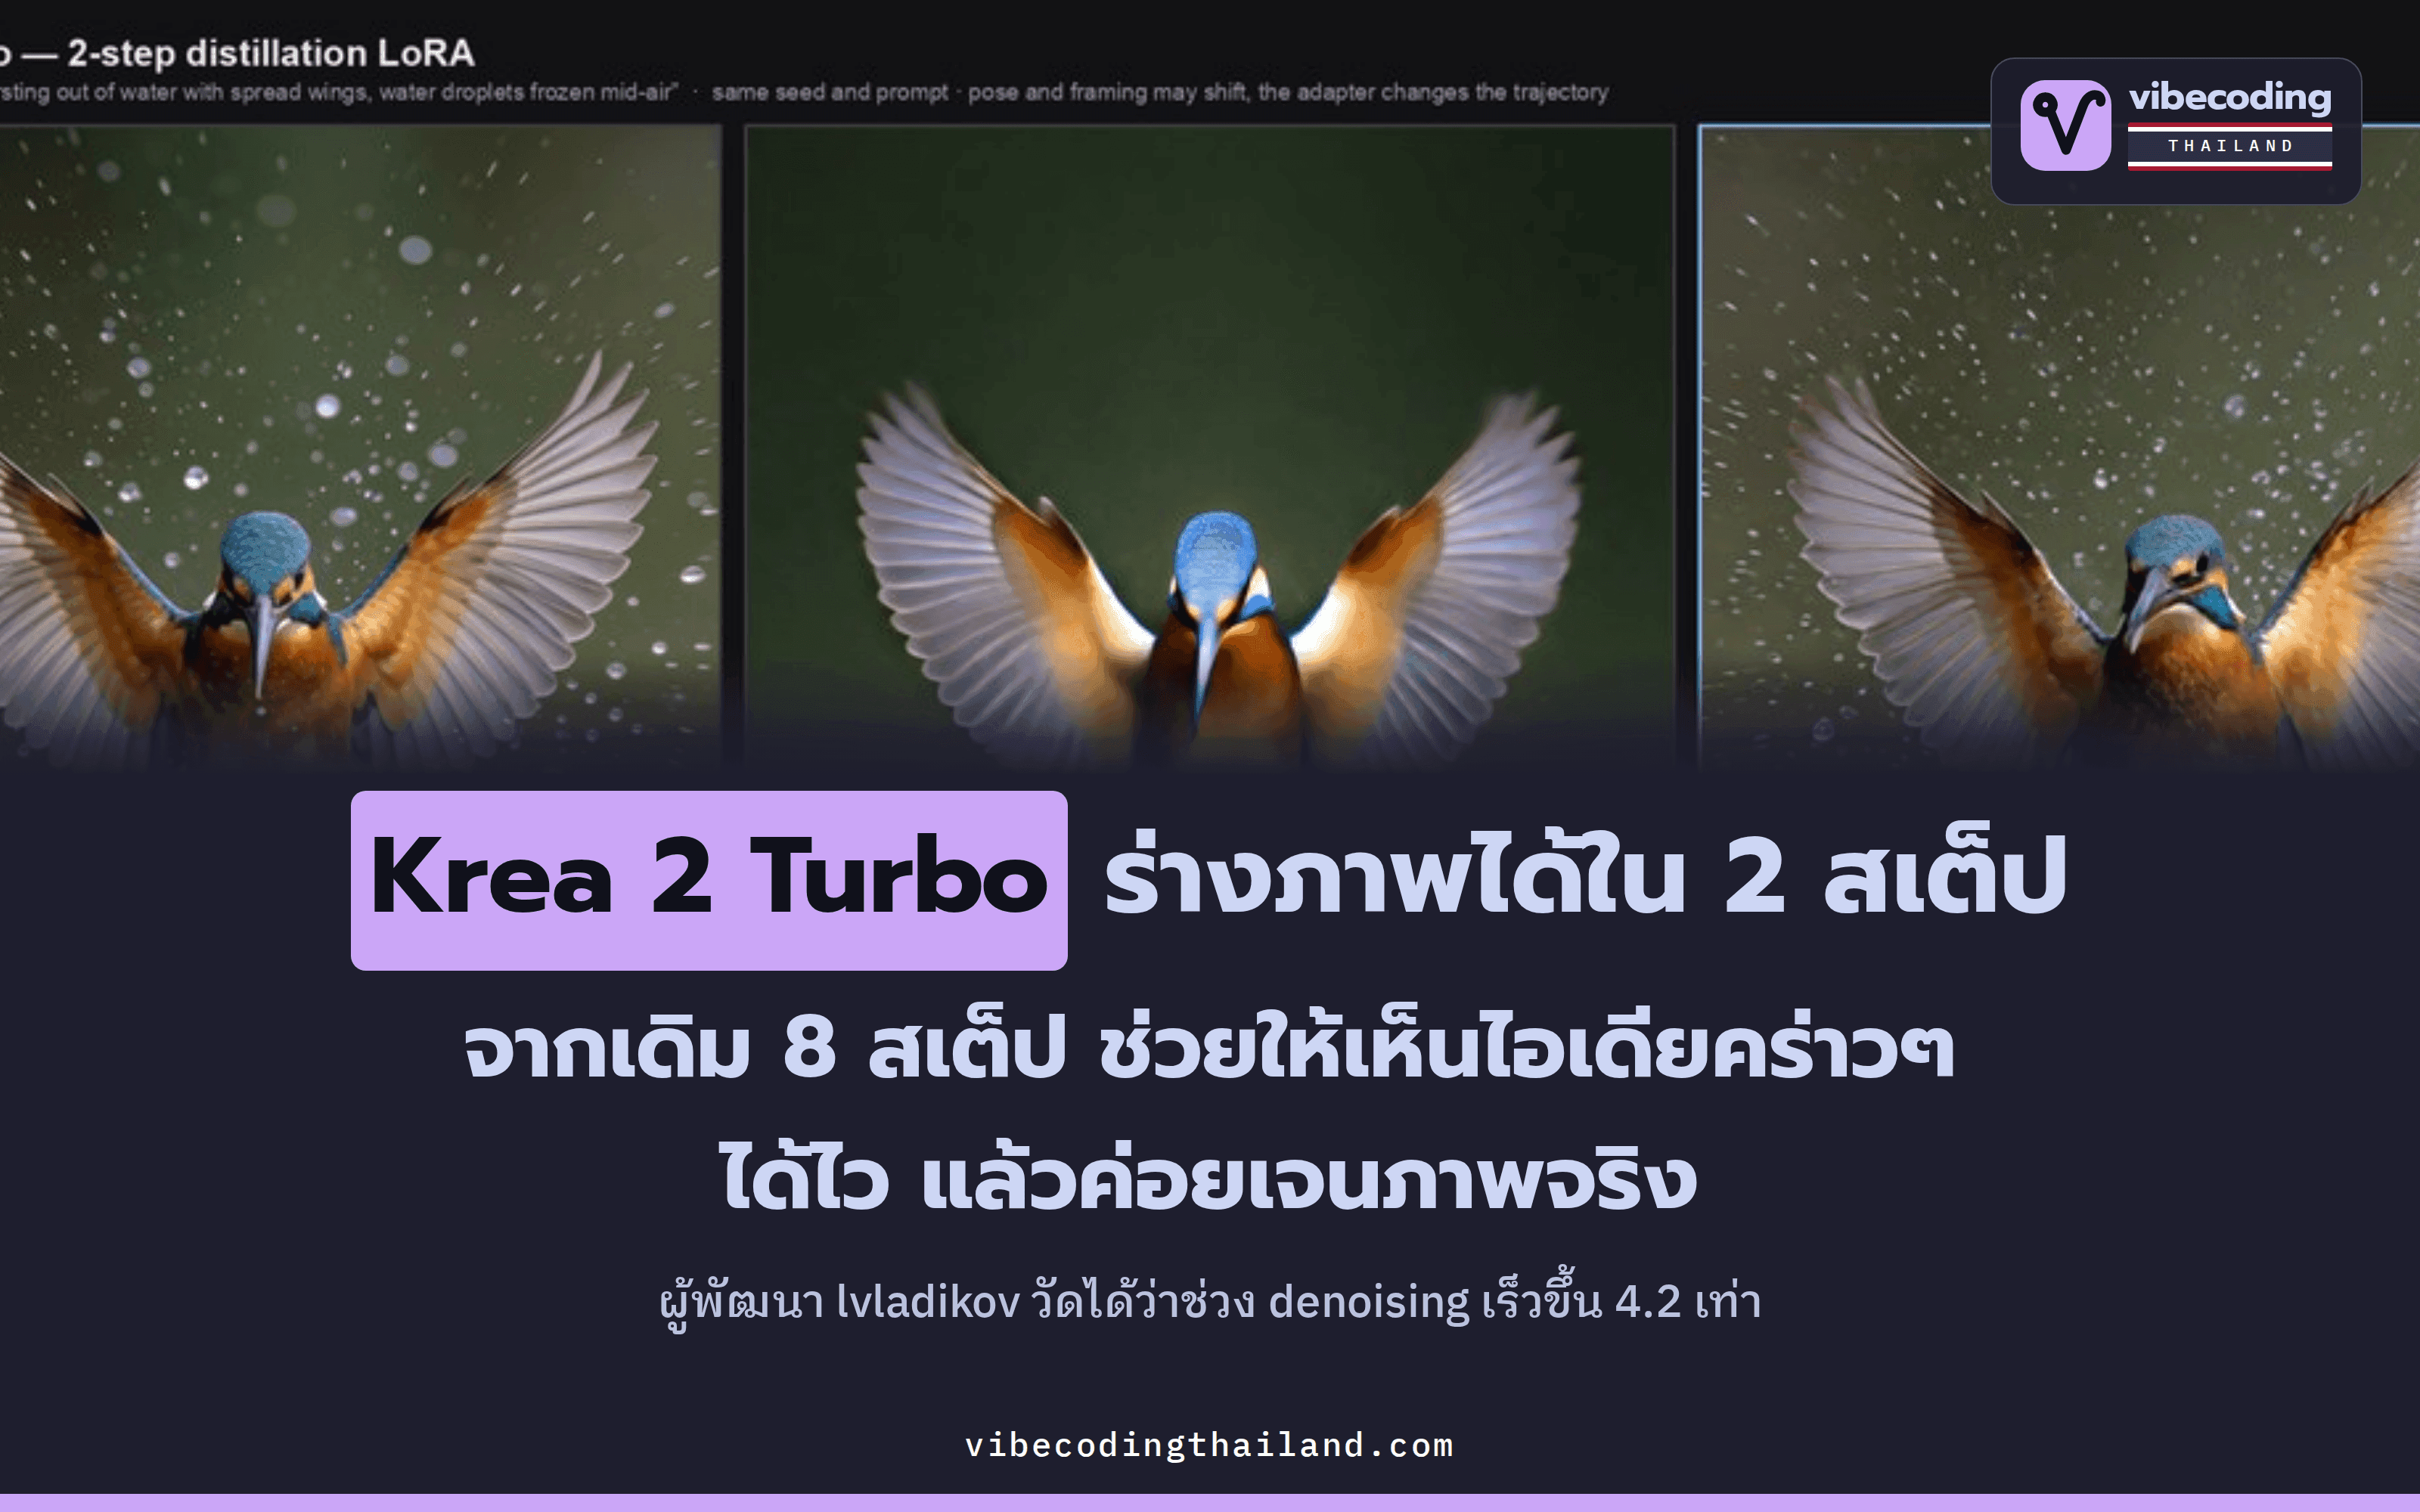
18 ก.ย. 2569 · 17 นาที · อ่าน 134 ครั้งKrea 2 Turbo เจนภาพได้ใน 2 สเต็ปด้วย LoRA และทำช่วง denoising ได้เร็วขึ้น 4.2 เท่าตามผลทดสอบของ lvladikov
16 ก.ย. 2569 · 15 นาที · อ่าน 19 ครั้งพื้นฐาน & อธิบาย · 6 เรื่อง
010203
DeepSeek-V4-Flash-0731 ย่อเหลือ 56.8 GB รันบนแมคเครื่องเดียวได้ด้วย MoEspresso
19 ส.ค. 2569 · 11 นาที · อ่าน 31 ครั้งkimi-k3-in-c รัน Kimi K3 พารามิเตอร์ 2.78 ล้านล้านตัวบนซีพียูตัวเดียวด้วยแรม 8.24 กิกะไบต์
5 ส.ค. 2569 · 9 นาที · อ่าน 21 ครั้งรัน RAG ในเครื่องด้วย Ollama, ChromaDB และ LangChain ให้ AI ตอบคำถามจากคู่มือ 2,111 หน้า โดยไม่ส่งข้อมูลออกนอกเครื่อง
26 ก.ค. 2569 · 12 นาที · อ่าน 384 ครั้ง$ ls ~/tools
เครื่องมือที่เกี่ยวข้อง
ดูรายละเอียดของแต่ละเครื่องมือ วิธีใช้งาน และบทความที่เกี่ยวข้องก่อนเลือกไปทดลอง
$ man local-llm
คำถามที่พบบ่อยเรื่อง Local LLM
รัน Local LLM ต้องใช้เครื่องแรงแค่ไหน?
ขึ้นกับขนาดโมเดล quantization และ context ที่ใช้ RAM หรือ VRAM คือข้อจำกัดหลัก ส่วน GPU ช่วยให้ตอบเร็วขึ้นแต่โมเดลขนาดเล็กบางรุ่นรันบน CPU ได้
Local LLM ทำให้ข้อมูลไม่ออกจากเครื่องแน่นอนหรือไม่?
ไม่เสมอไป ต้องตรวจทั้งแอป การส่งข้อมูลการใช้งานหรือ telemetry ส่วนเสริม การค้นเว็บ และเครื่องมือที่เชื่อมต่อ หากส่วนใดเรียกบริการภายนอก ข้อมูลส่วนนั้นยังออกจากเครื่องได้
Local LLM คุณภาพเท่าโมเดลบนคลาวด์ไหม?
ขึ้นกับงานและโมเดล งานขอบเขตชัดอาจทำได้ดีพอ แต่ควรเทียบกับตัวเลือกบนคลาวด์ด้วยชุดทดสอบเดียวกันก่อนตัดสินใจ
เริ่มรัน Local LLM ด้วยเครื่องมืออะไรดี?
Ollama และ LM Studio เหมาะกับการเริ่มแบบติดตั้งง่าย ส่วน llama.cpp ให้การควบคุมและตัวเลือกเชิงเทคนิคมากขึ้น
ใช้ Local LLM กับ Coding Agent ได้ไหม?
ได้หากเครื่องมือรองรับจุดเชื่อมต่อหรือผู้ให้บริการที่ใช้อยู่ แต่ต้องทดสอบการเรียกเครื่องมือ การทำตามคำสั่ง และความยาวบริบท ไม่ควรดูแค่การตอบแชต
Local LLM ประหยัดกว่าการใช้ API หรือไม่?
ไม่มีค่าต่อโทเคนจากผู้ให้บริการ แต่มีค่าเครื่อง ไฟฟ้า และเวลาดูแล จะคุ้มหรือไม่ขึ้นกับปริมาณงาน อายุฮาร์ดแวร์ และคุณภาพที่ยอมรับได้
รับบทความใหม่เรื่อง Local LLM
เราคัดบทความและคู่มือที่เพิ่งเผยแพร่ แล้วส่งให้ทางอีเมลเมื่อมีเรื่องใหม่ที่น่าอ่าน