WARP 0.8.0 รัน DeepSeek-V4.1-Flash 552B ทั้งก้อนบนโน้ตบุ๊กได้ โดย README ระบุว่า RAM 16GB พอ แต่ SSD ภายในต้องเหลือพื้นที่ว่าง 299 GiB
WARP 0.8.0 รัน DeepSeek-V4.1-Flash 552B ทั้งก้อนบนโน้ตบุ๊กเครื่องเดียว README ระบุว่า RAM 16GB เพียงพอ แต่คอขวดย้ายจาก RAM ไปอยู่ที่พื้นที่ว่างบน SSD
เอนจินสำหรับรันโมเดลภาษาขนาดใหญ่อย่าง LLM ชื่อ WARP สามารถรันโมเดล DeepSeek-V4.1-Flash ขนาด 552 พันล้านพารามิเตอร์หรือ 552B ตัวเต็มบนโน้ตบุ๊กเครื่องเดียวได้ โดยไม่ต้องตัดทอนพารามิเตอร์หรือลดขนาดโมเดลลง ระบบนี้ทำความเร็วได้ 3.77 token ต่อวินาที ซึ่ง token คือหน่วยย่อยของข้อความในการประมวลผลคำตอบ หรือคิดเป็นประมาณ 3.77 คำต่อวินาที ตัวเลขนี้อ้างอิงจากหน้าเอกสารแนะนำโปรเจกต์อย่าง README บน GitHub ซึ่งทดสอบบน MacBook Pro ชิป M5 Pro พร้อม RAM 64GB
จุดที่น่าสนใจสำหรับคนทั่วไปคือ โมเดลนี้กิน RAM ไม่เยอะอย่างที่คิด โดยเอกสารระบุว่า RAM ขั้นต่ำสำหรับโหลดโมเดลนี้ เมื่อตั้งค่า context หรือความยาวข้อความสนทนาไว้ที่ 4,000 token อยู่ที่เพียง 4.86GB และ README ยังระบุชัดเจนว่า "16 GB of RAM is enough"
ทว่าข้อจำกัดที่แท้จริงไม่ได้อยู่ที่ RAM แต่อยู่ที่พื้นที่จัดเก็บข้อมูล เพราะ README ระบุเงื่อนไขไว้ว่า ต้องมีพื้นที่ว่างบน SSD ภายในเครื่องอย่างน้อย 299 GiB สำหรับเก็บไฟล์โมเดลที่แปลงแล้ว และถ้าต้องการดาวน์โหลดไฟล์ต้นฉบับมาแปลงด้วยตัวเอง จะต้องมีพื้นที่ว่างสำหรับพักไฟล์อีก 475 GiB ภาระหลักไม่ได้หายไปไหน แค่ย้ายจาก RAM ไปอยู่ที่พื้นที่ SSD แทน
เอนจินนี้พัฒนาด้วยภาษา C ล้วนโดยไม่ต้องพึ่งซอฟต์แวร์อื่น ใช้สัญญาอนุญาต Apache 2.0 และลิขสิทธิ์เป็นของบริษัท SQLite Cloud, Inc. ส่วนโมเดล DeepSeek-V4.1-Flash พัฒนาโดยบริษัท DeepSeek ซึ่งเป็นคนละทีมกัน
WARP คือโปรเจกต์ WASTE เดิม แต่คำสั่งยังใช้ชื่อ waste
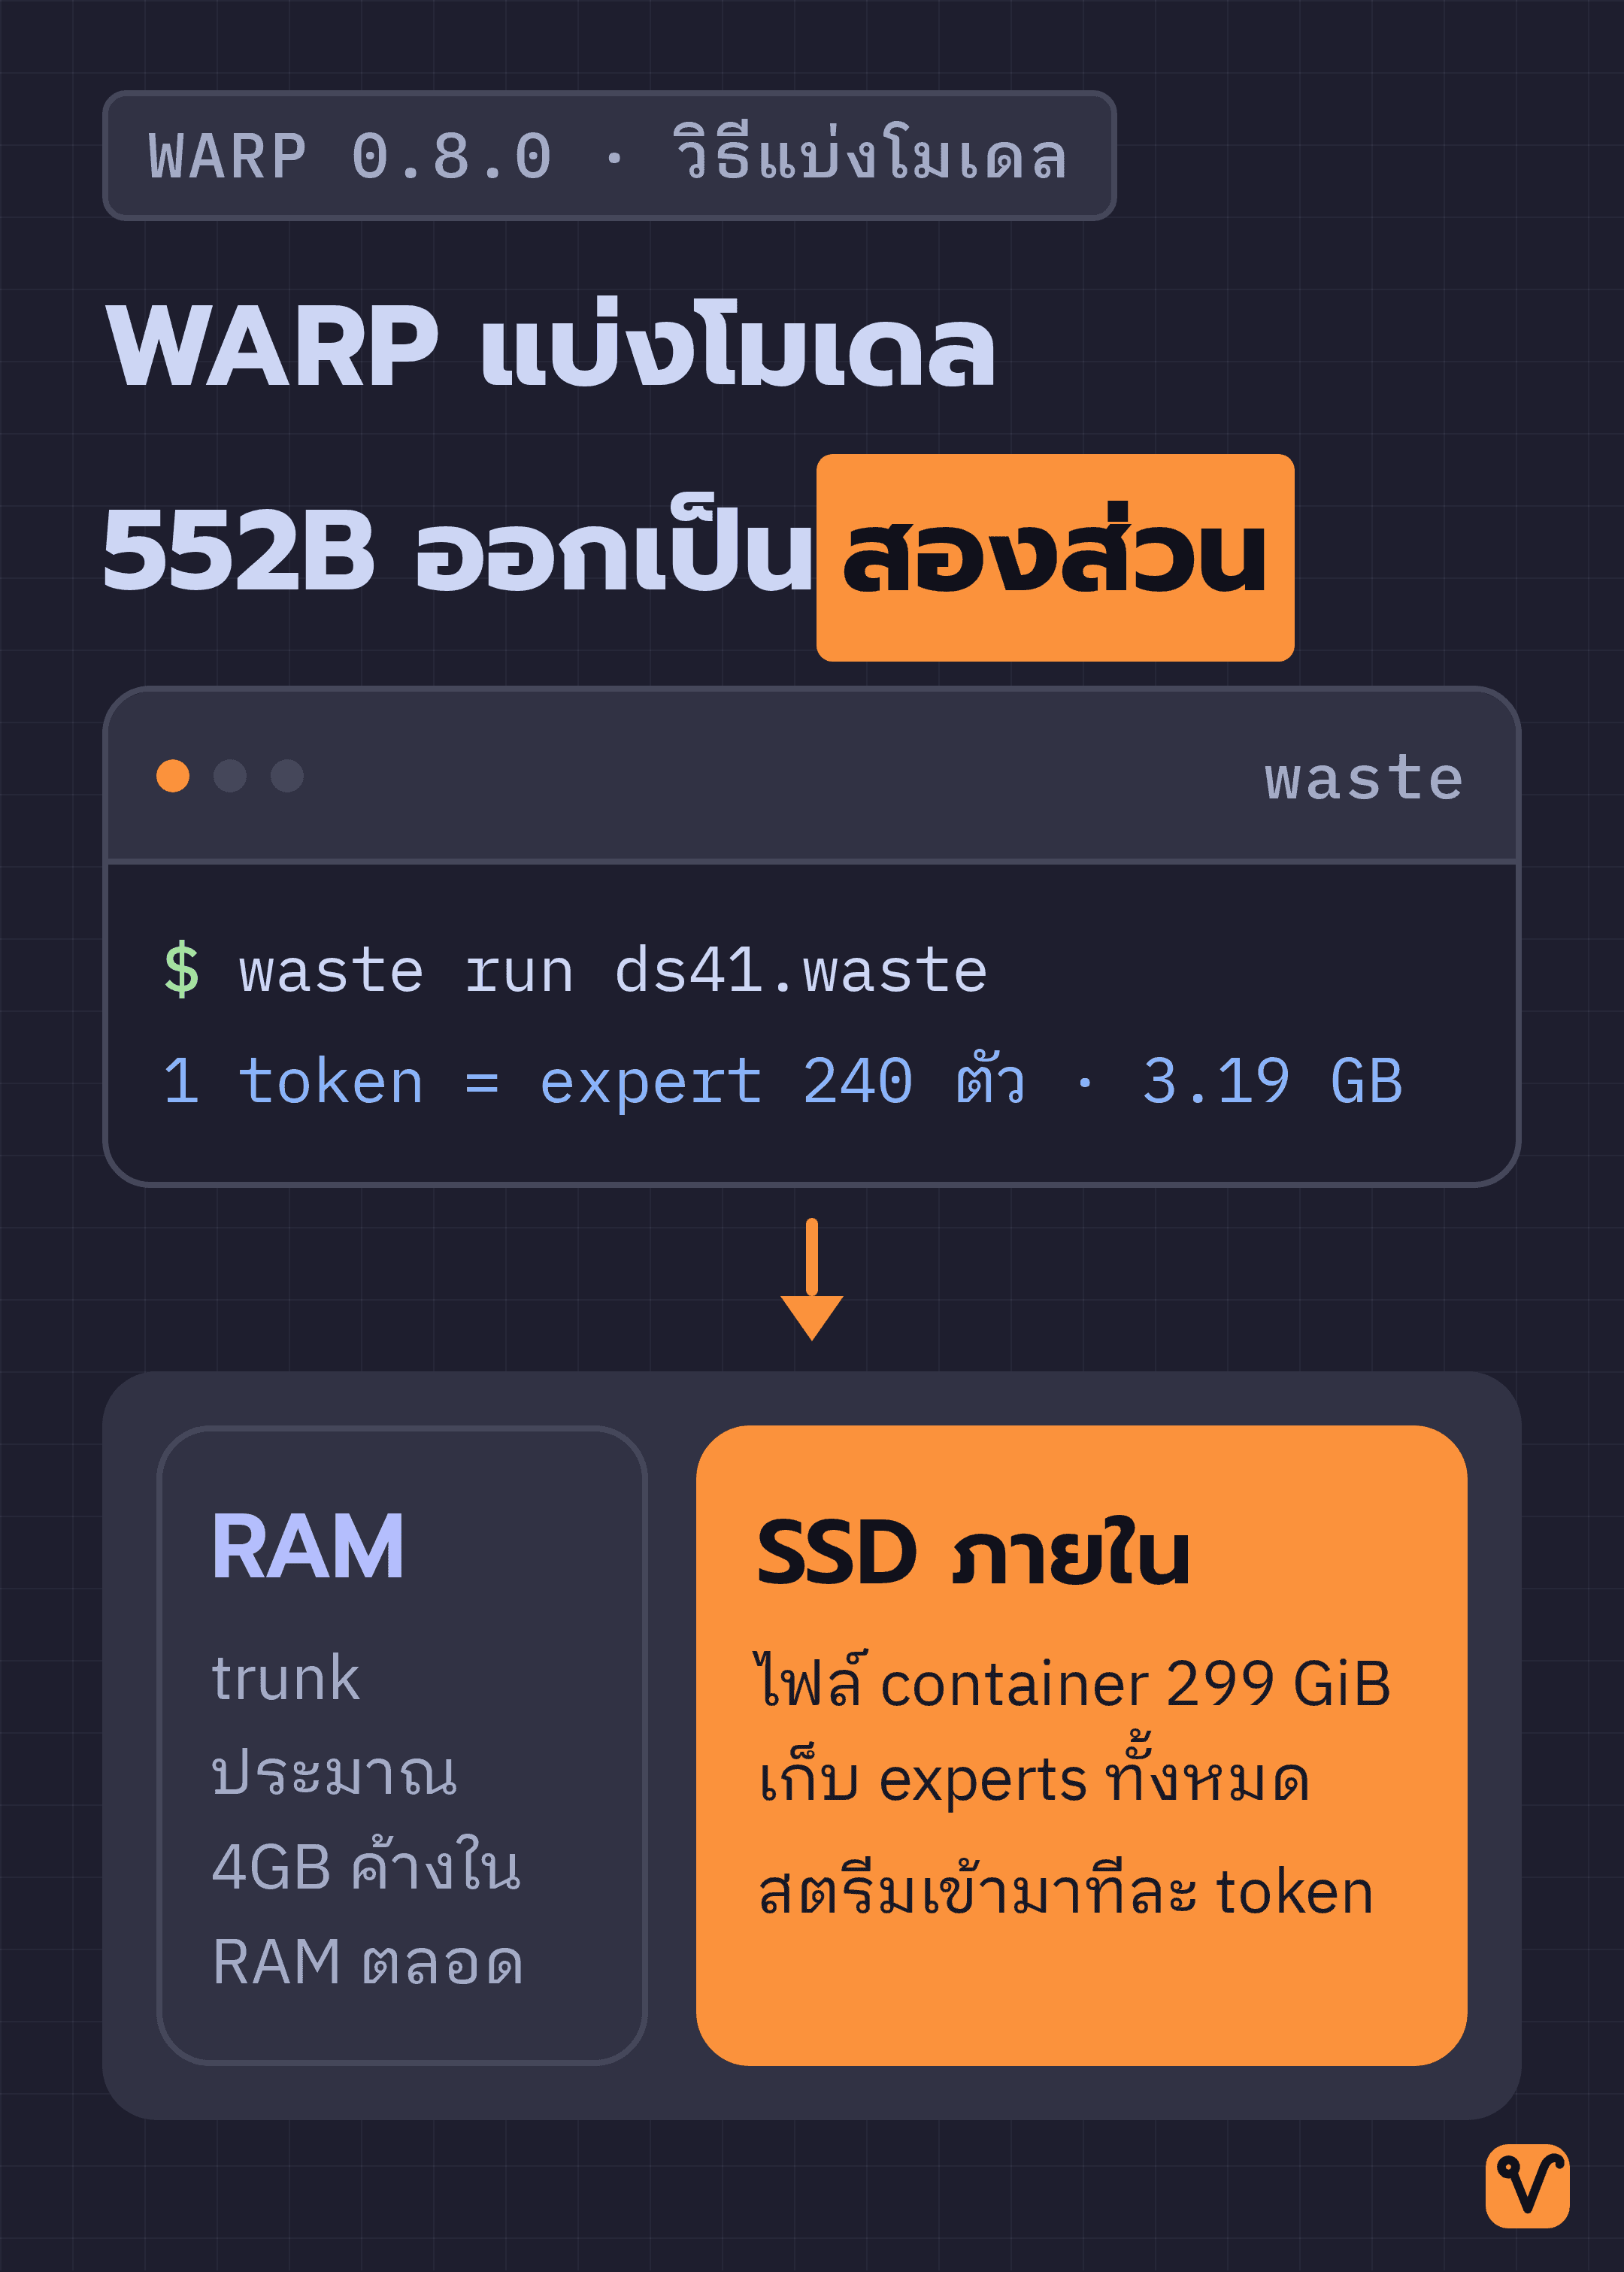
เอนจินตัวนี้เคยรันโมเดลภาษาอย่าง Kimi K3 บนโน้ตบุ๊กเครื่องเดียวมาก่อนในชื่อ WASTE ก่อนจะเปลี่ยนชื่อโปรเจกต์มาเป็น WARP
แม้ว่าชื่อโปรเจกต์จะเปลี่ยนไปแล้ว แต่คำสั่งและตัวโปรแกรมยังใช้ชื่อ waste เหมือนเดิมทั้งหมด เช่น waste run, waste chat, waste plan และ waste bench ดังนั้นถ้าค้นหาเอกสารแล้วพบคำสั่งที่ขึ้นต้นด้วย waste ก็ไม่ต้องแปลกใจ เพราะเป็นโปรเจกต์เดียวกัน
หลักการทำงานของ WARP คือแบ่งโมเดลออกเป็นสองส่วนหลัก ได้แก่ ส่วนแกนหลักของโมเดลที่เรียกว่า trunk ซึ่งต้องใช้ประมวลผลทุก token จะเก็บไว้ใน RAM ตลอดเวลา ส่วน experts ซึ่งเป็นเครือข่ายย่อยที่เรียกใช้เพียงบางตัวในแต่ละ token จะใช้วิธีสตรีมข้อมูลจาก SSD เข้ามาทีละ token โดยตรง จากนั้น RAM ส่วนที่เหลือจะทำหน้าที่เป็นพื้นที่พักข้อมูลชั่วคราวอย่าง cache คอยเก็บ experts ที่เพิ่งอ่านขึ้นมา เผื่อว่า token ถัดไปจะเรียกใช้ซ้ำ จะได้ไม่ต้องอ่านจากดิสก์ใหม่อีกรอบ
DeepSeek-V4.1-Flash เป็นโมเดลตัวที่สี่ของเอนจินนี้
ในบันทึกแจ้งการอัปเดตอย่าง Release Notes เวอร์ชัน 0.8.0 ระบุว่า DeepSeek-V4.1-Flash เป็นโมเดลลำดับที่สี่ที่ WARP รองรับ ต่อจาก Kimi K3, GLM-5.3-Flash และ Kimi-Linear โดยทีมพัฒนาเน้นย้ำว่าเป็น "สถาปัตยกรรมที่สี่ ไม่ใช่แค่รุ่นย่อยของสามตัวเดิม" เพราะต้องเขียนโค้ดรองรับเทคนิคใหม่ทั้งหมด ทั้งกลไก Attention แบบ CSA2, ระบบหน่วยความจำ N-gram ชื่อ Engram, การมิกซ์ Residual แบบ Single-pass mHC, ฟังก์ชัน Router Scoring รูปแบบใหม่ ตลอดจนรูปแบบ Prompt แบบ DSML
สิ่งที่น่าสนใจคือ DeepSeek-V4.1-Flash กลายเป็นโมเดลขนาดใหญ่ที่รันได้เร็วที่สุดบนเอนจินนี้ ทั้งที่โครงหลักใหญ่กว่า GLM-5.3-Flash ราวสองเท่า เพราะความเร็วในการประมวลผลไม่ได้ขึ้นอยู่กับขนาดรวมของโมเดล แต่ขึ้นอยู่กับปริมาณข้อมูลที่ต้องอ่านต่อหนึ่ง token โดย DeepSeek-V4.1-Flash ต้องอ่านข้อมูล expert 240 รายการ รวม 3.19 GB ต่อหนึ่ง token ซึ่งต่างจากปริมาณที่ GLM-5.3-Flash ต้องอ่านไม่ถึง 1%
DeepSeek-V4.1-Flash บน Hugging Face เป็นโมเดลสถาปัตยกรรม Mixture-of-Experts หรือ MoE มีพารามิเตอร์รวม 552B รองรับ context ได้ยาวสูงสุดประมาณ 1 ล้าน token ประมวลผลได้ทั้งรูปภาพและข้อความ โดยหน้าข้อมูลประจำโมเดลอย่าง model card ระบุว่าใช้พารามิเตอร์จริงราว 8B ต่อ token ในช่วงอ่าน prompt และราว 16B ในช่วงสร้างคำตอบ และปล่อยค่าน้ำหนักของโมเดลหรือ weights ภายใต้สัญญาอนุญาตแบบ MIT
อย่างไรก็ตาม คะแนนทดสอบของโมเดลต้นฉบับอาจนำมาเทียบกับการรันบน WARP ตรงๆ ไม่ได้ เนื่องจากไฟล์ที่รันบน WARP ผ่านการควอนไทซ์เพื่อบีบอัดส่วน experts ลงมาเหลือ 3 บิต จึงไม่ใช่ไฟล์ weights ตัวเดียวกับที่ทาง DeepSeek นำไปใช้วัดคะแนนอย่างเป็นทางการ
เงื่อนไขสำคัญเบื้องหลังตัวเลขประสิทธิภาพ
ตารางเปรียบเทียบใน README สรุปข้อมูลของทั้ง 4 โมเดลไว้ดังนี้ โดย container หมายถึงไฟล์โมเดลที่แปลงเป็นรูปแบบเฉพาะสำหรับรันบนเอนจิน WARP:
| โมเดล | ขนาด container | RAM ขั้นต่ำ | ความเร็วที่ 64 token |
|---|---|---|---|
| Kimi K3 (2.78T) | 982 GB | 29.19 GB | 0.45-0.62 คำ/วิ |
| DeepSeek-V4.1-Flash (552B) | 299 GiB | 4.86 GB | 3.77 คำ/วิ |
| GLM-5.3-Flash (313B) | 112 GB | 5.14 GB | 3.32 คำ/วิ |
| Kimi-Linear (48B) | 19 GB | 1.32 GB | 14.29 คำ/วิ |
ขนาดไฟล์ในช่อง container บอกว่าพื้นที่ในเครื่องของเราจะรองรับโมเดลไหนได้บ้าง โดยโมเดลขนาดเล็กลงมาอย่าง GLM-5.3-Flash และ Kimi-Linear ใช้งานบนโน้ตบุ๊กทั่วไปได้สบาย ส่วน DeepSeek-V4.1-Flash จำเป็นต้องเคลียร์พื้นที่ในเครื่องพอสมควร ขณะที่ Kimi K3 ขนาด 982 GB นั้นใหญ่เกินความจุของโน้ตบุ๊กส่วนใหญ่
นอกจากตัวเลขในตารางแล้ว ยังมีเงื่อนไขสำคัญที่ต้องพิจารณาควบคู่กัน:
- ทดสอบบนเครื่องเดียว: ตัวเลขทั้งหมดวัดบน MacBook Pro ชิป M5 Pro แรม 64GB และวางไฟล์ container ไว้บน SSD ภายในเครื่อง จึงไม่ได้หมายความว่าทุกเครื่องจะได้ความเร็ว 3.77 คำต่อวินาทีเท่ากัน
- ต้องใช้ SSD ความเร็วสูงแบบ NVMe ภายในเครื่อง: ไฟล์ container ต้องอยู่บน SSD ที่ติดมากับเครื่อง ไม่ควรเก็บไว้ใน External SSD ที่ต่อผ่านพอร์ต USB เพราะในการทดสอบ SSD ภายในอ่านข้อมูลได้ถึง 12.78 GB/s ขณะที่กล่องไดรฟ์ที่ต่อผ่าน USB ทำได้เพียง 0.94 GB/s เอนจินต้องอ่านดิสก์ตลอดเวลาในการสร้างคำแต่ละคำ ความเร็วของดิสก์จึงส่งผลต่อประสิทธิภาพโดยตรง
- พื้นที่พักไฟล์ต้นฉบับ 475 GiB: พื้นที่ส่วนนี้ใช้เฉพาะตอนดาวน์โหลดและแปลงไฟล์เท่านั้น ไม่เกี่ยวข้องกับพื้นที่ 299 GiB ที่ใช้เก็บ container ไฟล์ต้นฉบับเก็บไว้ใน External SSD ได้ และทยอยลบระหว่างการแปลงเพื่อคืนพื้นที่ได้
- รองรับเฉพาะข้อความ: แม้ตัวโมเดล DeepSeek-V4.1-Flash จะรองรับภาพได้ แต่ไฟล์ที่แปลงแล้วสำหรับ WARP ยังไม่ได้รวมส่วนประมวลผลรูปภาพเข้ามา จึงยังไม่สามารถส่งรูปภาพเพื่อสั่งงานได้
- ประมวลผลผ่าน CPU ล้วน: เอนจินทำงานบน CPU ทั้งหมดโดยไม่พึ่งพา GPU ไม่ใช้ระบบประมวลผลกราฟิกอย่าง CUDA และไม่ต้องใช้ชุดคำสั่งคำนวณอย่างไลบรารี BLAS เอนจินคอมไพล์ใช้งานได้ทั้งบน macOS, Linux และ Windows ผ่านชุดเครื่องมือ MinGW-w64 แต่ตัวเลขผลการทดสอบทั้งหมดในปัจจุบันมาจากเครื่อง Mac เพียงเครื่องเดียว
สรุปแล้วต้องใช้ RAM เท่าไหร่ถึงจะพอ
ในเอกสาร docs/DS41.md ทีมพัฒนาได้บันทึกรายละเอียดเชิงลึกเกี่ยวกับการใช้หน่วยความจำไว้ โดยทดลองปรับขนาดของ expert cache เพียงค่าเดียว เพื่อดูผลกระทบต่อความเร็วและปริมาณการอ่านข้อมูลจากดิสก์
ข้อควรทราบก่อนดูตารางคือ ตัวเลขในคอลัมน์แรกคือขนาดของ expert cache เท่านั้น ไม่ใช่ปริมาณ RAM ทั้งหมดของเครื่อง การใช้งาน RAM จริงจะต้องรวมส่วนของ trunk (ประมาณ 4GB), ขนาดของ cache และ RAM ที่ระบบปฏิบัติการใช้งานตามปกติเข้าไปด้วย
| expert cache | ความเร็ว | อ่านจากดิสก์รวม 60 token |
|---|---|---|
| 152 MB (ต่ำสุดที่เปิดได้) | 2.00 คำ/วิ | 234.70 GB |
| 512 MB | 2.70 คำ/วิ | 307.77 GB |
| 3.2 GB | 3.03 คำ/วิ | 255.66 GB |
| 9.6 GB | 3.57 คำ/วิ | 170.42 GB |
| 17 GB | 3.57 คำ/วิ | 130.45 GB |
| 30 GB | 3.45 คำ/วิ | 96.62 GB |
| 41.74 GB (ค่าที่เอนจินเลือกเองบนเครื่อง 64GB) | 3.33 คำ/วิ | 81.13 GB |
จากผลการทดลอง ความเร็วจะเพิ่มขึ้นอย่างเห็นได้ชัดเมื่อขยาย cache จาก 152 MB ไปจนถึง 9.6 GB แต่ตั้งแต่ 9.6 GB หรือ 17 GB ขึ้นไป ความเร็วแทบไม่เพิ่มขึ้นอีก แม้จะเพิ่มขนาด cache มากแค่ไหนก็ตาม
สำหรับคนที่กำลังเช็กสเปกเครื่องตัวเอง สรุปได้ดังนี้:
- RAM ประมาณ 5GB: เป็นระดับขั้นต่ำที่พอเปิดโมเดลได้ แต่ดิสก์ต้องรับภาระหนักมาก เพราะเมื่อใช้ cache ขนาด 152 MB ระบบต้องอ่านข้อมูลจากดิสก์สูงถึง 234.70 GB สำหรับการสร้างข้อความเพียง 60 token
- RAM 16GB: เป็นขนาดที่ README ระบุไว้ว่าเพียงพอต่อการใช้งาน
- เครื่องทดสอบ RAM 64GB: เอนจินเลือก cache ให้เองที่ 41.74 GB แล้ววัดได้ 3.33 คำต่อวินาที ซึ่งไม่ได้สูงกว่าช่วง 9.6 GB ถึง 17 GB ที่วัดได้ 3.57 คำต่อวินาที
ความเร็ว 3.77 คำต่อวินาที นำไปใช้งานอะไรได้จริงบ้าง
ในกระทู้ Show HN ของโปรเจกต์ มีผู้อ่านตั้งคำถามไว้ 2 ข้อ ซึ่งตอบได้จากข้อมูลในโปรเจกต์โดยตรง:
คำถามแรก: ความเร็ว 3.77 คำต่อวินาที ช้าเกินไปไหม และการเรียกใช้งานผ่านระบบคลาวด์หรือ Cloud API จะดีกว่าหรือไม่? ในกระทู้มีผู้ใช้อีกรายมาตอบไว้ว่า งานที่มีโจทย์ชัดเจนแน่นอนอยู่แล้วน่าจะได้ประโยชน์จากการรันแบบนี้ ส่วนจะเจองานแบบนั้นบ่อยแค่ไหนก็อีกเรื่องหนึ่ง อีกด้านหนึ่ง สิ่งที่ README ยกขึ้นมาเป็นเหตุผลของโปรเจกต์ตั้งแต่ต้นคือ ทุกคำตอบที่ได้จากระบบคลาวด์ต้องจ่ายสองต่อ ทั้งค่าบริการและค่าไฟของศูนย์ข้อมูลที่รันโมเดล ซึ่งจริงๆ แล้วพอจะเปิดรันบนเครื่องคอมพิวเตอร์ตั้งโต๊ะได้
สิ่งที่ไม่เหมาะจะนำไปใช้คืองานประเภทแชตที่ต้องการการโต้ตอบรวดเร็ว หรืองานโปรแกรมผู้ช่วยเขียนโค้ดอย่าง Coding Agent ที่ต้องส่ง context ยาวๆ เข้าไปในระบบ เพราะ README ระบุว่า ช่วงการอ่านและประมวลผล prompt ก่อนเริ่มตอบหรือ prefill phase ทำงานด้วยความเร็วระดับเดียวกับช่วงสร้างคำตอบ ถ้าส่ง prompt ยาว 2,000 token ก็อาจต้องรอนานหลายนาทีกว่าจะเริ่มเห็นคำแรก
คำถามที่สอง: การ์ดจอที่มีหน่วยความจำ VRAM ขนาด 8GB สามารถรันได้หรือไม่? คำตอบจาก README คือ ตัวเอนจินไม่ได้ใช้ GPU เลยแม้แต่น้อย ดังนั้นขนาดของ VRAM บนการ์ดจอจึงไม่มีผลต่อการทำงาน สิ่งที่ต้องดูแทนคือ RAM ในเครื่อง กับพื้นที่ว่างบน SSD ภายในตัวเครื่อง
ขั้นตอนการติดตั้งและรันตาม README
เริ่มต้นด้วยการโคลนและคอมไพล์โค้ด:
git clone https://github.com/sqliteai/warp
cd waste
makeข้อสังเกตคือใน README ระบุคำสั่ง cd waste แต่โฟลเดอร์ที่ได้จาก git clone จะชื่อ warp ซึ่งชื่อไม่ตรงกันตั้งแต่ในเอกสารต้นฉบับ ส่วนคำสั่ง make จะคอมไพล์และสร้างไฟล์โปรแกรม waste รวมถึงไลบรารี libwaste.a ออกมา
หลังจากคอมไพล์เสร็จ สามารถสั่ง make check เพื่อรันชุดทดสอบด้วย container จำลองได้ทันที โดยขั้นตอนนี้ยังไม่ต้องดาวน์โหลดไฟล์ weights ลงเครื่องแม้แต่ไฟล์เดียว
เมื่อถึงขั้นตอนการดาวน์โหลด weights แนะนำให้ใช้คำสั่ง dry-run ทดสอบก่อน:
tools/fetch_weights.sh --repo deepseek-ai/DeepSeek-V4.1-Flash --dest <staging> --dry-runออปชัน --dry-run ใช้ตรวจสอบและรายงานจำนวนไฟล์ย่อยของโมเดลหรือ shard ขนาดไฟล์รวม และพื้นที่ว่างที่เหลือบนดิสก์โดยยังไม่ดาวน์โหลดจริง เมื่อตรวจแล้วว่าพื้นที่เพียงพอ ให้ตัด --dry-run ออกแล้วรันคำสั่งเดิมอีกครั้ง เพื่อดาวน์โหลดไฟล์จริงจำนวน 48 shard รวม 475 GiB กระบวนการนี้หยุดกลางคันแล้วสั่งดาวน์โหลดต่อได้ ระบบจะไม่ดาวน์โหลดไฟล์ที่โหลดเสร็จแล้วซ้ำ
ขั้นตอนถัดมาคือการแปลงไฟล์โมเดล:
uv run --with torch python tools/convert.py --src <staging> --out ~/models/ds41.waste --jobs 3พาธหลังออปชัน --out ควรชี้ไปยัง SSD ภายในเครื่อง เพราะเป็นตำแหน่งที่เอนจินจะอ่านไฟล์ container ระหว่างรันจริง ตัวสคริปต์แปลงไฟล์รู้จักสถาปัตยกรรมของโมเดลนี้อยู่แล้ว จึงไม่ต้องใส่ flag เพิ่มเติม โดยจะไล่แปลง expert ทั้ง 40 เลเยอร์ ตามด้วย trunk และตาราง Engram อีก 2 ชุด ซึ่งเฉพาะตาราง Engram อย่างเดียวก็กินพื้นที่ไปถึง 40% ของไฟล์ที่ต้องดาวน์โหลดมาทั้งหมด
เมื่อแปลงไฟล์เรียบร้อย เรียกใช้งานได้ 2 รูปแบบ:
./waste run ~/models/ds41.waste "<prompt>"
./waste chat ~/models/ds41.wasteถ้าต้องการความสะดวกโดยไม่ต้องสั่งทีละขั้นตอน ทางโปรเจกต์มีสคริปต์อัตโนมัติเตรียมไว้ให้:
MODEL=ds41 SRC=<staging> OUT=~/models/ds41.waste tools/pipeline.shสคริปต์นี้จะจัดการตั้งแต่ขั้นตอนการดาวน์โหลด แปลงไฟล์ ไปจนถึงการรันให้เสร็จสรรพในคำสั่งเดียว แต่ละขั้นตอนสามารถหยุดและกลับมารันต่อได้ ถ้าขั้นตอนก่อนหน้ามีข้อผิดพลาด ระบบจะไม่เริ่มขั้นตอนถัดไป พร้อมทั้งมี log ให้ตรวจสอบและสรุปผลเป็นไฟล์ REPORT.md วางไว้ข้างไฟล์ container
งบประมาณหน่วยความจำหรือ memory budget ไม่จำเป็นต้องตั้งค่าเอง เพราะเอนจินจะคำนวณและรายงานค่าที่เลือกใช้ออกมาให้เห็น เช่น waste: no --budget, using 46.45 GB of 64.00 GB (expert cache 41.74 GB) และ README แนะนำว่าไม่ควรตั้งค่า --budget เองเว้นแต่จะมีเหตุผลเฉพาะ
ส่วนเรื่องระยะเวลาทำงาน เอกสารระบุตัวเลขอ้างอิงจากโมเดล GLM-5.3-Flash (ยังไม่มีตัวเลขของ DeepSeek-V4.1-Flash) ว่าใช้เวลาดาวน์โหลดประมาณ 2 ชั่วโมง และใช้เวลาแปลงไฟล์ประมาณ 45 นาที เมื่อประมวลผลพร้อมกัน 3 ชุดงานหรือ 3 worker
ทีมพัฒนาบันทึกบั๊กของตัวเองอย่างตรงไปตรงมาใน Release Notes
ใน Release Notes ของเวอร์ชัน 0.8.0 ทีมพัฒนา sqliteai บันทึกบั๊กในระบบไว้อย่างตรงไปตรงมา โดยสองเรื่องที่เห็นภาพชัดที่สุดคือ:
- ตัวอ่านไฟล์ JSON: มีปัญหาถอดรหัสอักขระพิเศษอย่าง Escape Sequence แบบ
\uXXXXไม่ได้มาตั้งแต่เวอร์ชัน 0.6.0 แต่ที่ผ่านมาไม่มีใครตรวจพบเพราะโทเค็นควบคุมพิเศษอย่าง Control Token ของโมเดลรุ่นก่อนๆ ล้วนเป็นรหัสตัวอักษรพื้นฐานแบบ ASCII ทั้งหมด ทีมพัฒนาจึงเพิ่งพบปัญหานี้เมื่อนำมารันกับ DeepSeek-V4.1-Flash ที่มี Control Token นอกเหนือจาก ASCII - ตัวตัดคำ Tokenizer: พบการเข้ารหัสผิดพลาดประมาณ 4.5% บนโมเดลตัวอื่นในเอนจินเดียวกัน ซึ่งตัวเอนจินผ่านชุดทดสอบเดิมที่มีข้อความทดสอบ 21 ชุดได้ทั้งหมดทั้งก่อนและหลังแก้ ทำให้ตรวจไม่พบ จนกระทั่งทีมงานนำชุดข้อความทดสอบขนาดใหญ่ 24,021 ชุดมาทดสอบ จึงตรวจพบบั๊กและแก้ไขได้สำเร็จ
อีกประเด็นคือฟีเจอร์ DSpark ซึ่งเป็นเทคนิคช่วยเร่งความเร็วของ DeepSeek-V4.1-Flash โดยทีมพัฒนาชี้แจงเหตุผลที่ยังไม่นำมาใช้ว่า เพราะเอนจินต้องอ่านข้อมูลจาก SSD เป็นหลัก การคาดเดา token ล่วงหน้าพร้อมกัน 5 token ตามแนวทางของ DSpark จะทำให้ระบบต้องอ่านข้อมูล expert จากดิสก์เพิ่มขึ้นถึง 3.45 เท่า เมื่อเทียบกับการประมวลผลทีละ token ระบบจึงต้องคาดเดา token ให้ถูกอย่างน้อย 3.45 จาก 5 token ถึงจะเริ่มคุ้มกับปริมาณข้อมูลที่ต้องอ่านจากดิสก์
ตัวเลขที่วัดได้คือผลจากการทดลองจริง ไม่ใช่ตัวเลขเพื่อการตลาด แม้จะพบในภายหลังว่าผลลัพธ์ผิดพลาด ก็ยังคงบันทึกไว้อย่างตรงไปตรงมา
นั่นคือท่าทีที่ README ระบุไว้อย่างชัดเจน พร้อมกับแจ้งเตือนผู้ใช้งานด้วยว่า ซอฟต์แวร์ยังอยู่ระหว่างพัฒนาและเปลี่ยนแปลงบ่อยครั้ง จึงอาจพบความไม่เสถียรในการใช้งานได้
เช็ก 3 สิ่งสำคัญก่อนตัดสินใจดาวน์โหลดไฟล์ 475 GiB
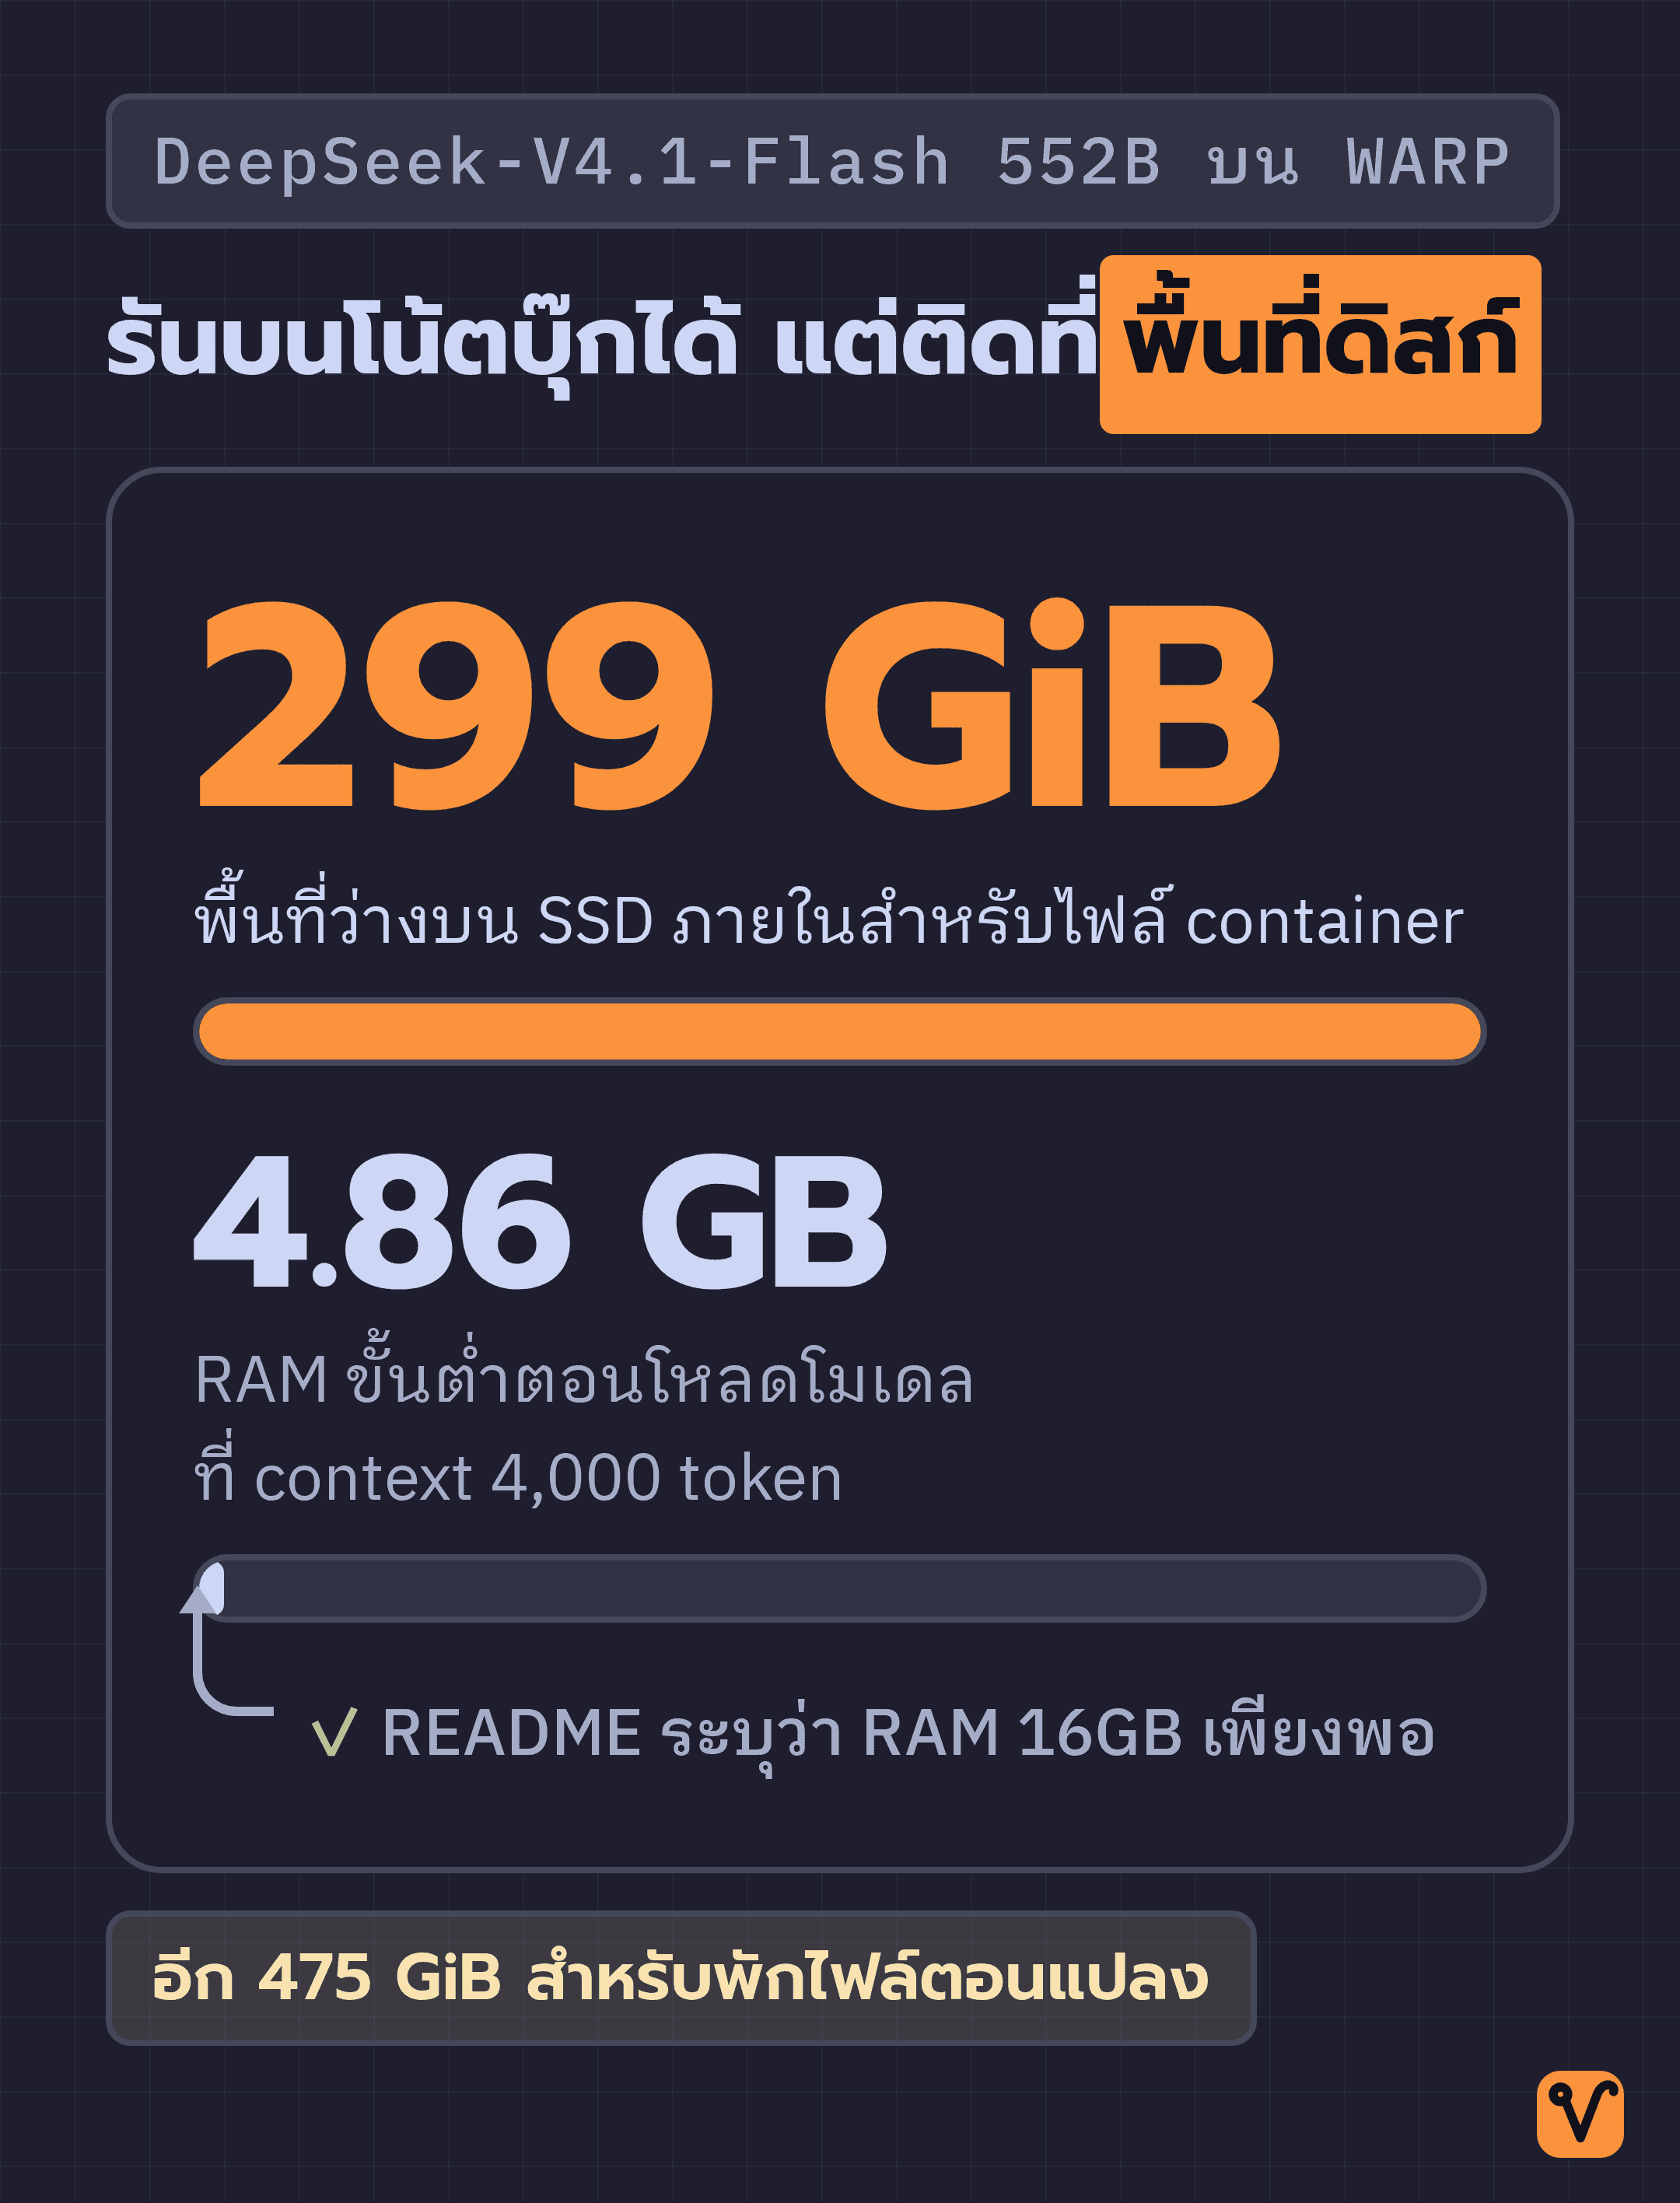
ก่อนจะเสียเวลาและแบนด์วิดท์อินเทอร์เน็ตเพื่อดาวน์โหลดไฟล์ขนาดใหญ่ มี 3 ข้อที่เช็กกับเครื่องตัวเองได้ทันที:
- RAM ของเครื่องมีถึง 16GB หรือไม่: ถ้ามี 16GB ก็ผ่านเกณฑ์ตามที่ README แนะนำว่าเพียงพอ
- พื้นที่จัดเก็บข้อมูลเพียงพอหรือไม่: ต้องมีพื้นที่ว่างบน SSD ภายในเครื่องอย่างน้อยประมาณ 300 GiB สำหรับเก็บไฟล์ container และมีพื้นที่ว่างอีก 475 GiB สำหรับพักไฟล์ดาวน์โหลด (ส่วน 475 GiB นี้สามารถใช้ External SSD ได้)
- ระบบปฏิบัติการและเครื่องมือคอมไพล์พร้อมหรือไม่: เครื่องต้องใช้ macOS, Linux หรือ Windows และติดตั้งโปรแกรมคอมไพล์ภาษา C เรียบร้อยแล้ว
ถ้าตรวจสอบแล้วครบทั้ง 3 ข้อ แนะนำให้เริ่มต้นด้วยการ git clone โค้ดลงมา แล้วสั่ง make ตามด้วย make check ให้ผ่านก่อน เพราะชุดทดสอบนี้ใช้ container จำลอง จึงได้ลองคอมไพล์และรันเอนจินจริงโดยยังไม่ต้องดาวน์โหลดไฟล์ขนาด 475 GiB มาแม้แต่ไบต์เดียว
แต่ถ้าพื้นที่ดิสก์ไม่เอื้ออำนวยจริงๆ ทางเลือกที่น่าสนใจในเอนจินเดียวกันคือ Kimi-Linear ซึ่งไฟล์ container มีขนาดเพียง 19 GB ต้องการ RAM ขั้นต่ำแค่ 1.32 GB และทำความเร็วได้ถึง 14.29 คำต่อวินาที
สรุปแล้ว ข้อจำกัดในการรันโมเดลระดับ 552B บนเครื่องส่วนตัวในปัจจุบันไม่ได้ติดที่ขนาดของ RAM อีกต่อไป แต่ย้ายไปอยู่ที่พื้นที่ว่างบน SSD ความเร็วสูง และความอดทนรอคำตอบที่ไหลออกมาด้วยความเร็วประมาณสามคำกว่าต่อวินาที
ที่มา:
- sqliteai/warp บน GitHub จาก sqliteai
- Release 0.8.0 DeepSeek-V4.1-Flash จาก sqliteai
- docs/DS41.md จาก sqliteai
- DeepSeek-V4.1-Flash จาก deepseek-ai บน Hugging Face
- Show HN: Warp – Run DeepSeek v4.1 Flash with 5 GB of RAM at 3.77 tok/s จาก Hacker News
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
สร้าง Claude Skill แบบไม่ต้องรู้โค้ด คู่มือสร้าง Claude Skill ของคุณเองด้วยการคุยกับ Claude Code เป็นภาษาไทย
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin