GPT-6.1 Sol ค่า token แค่ 1 ใน 5 ของ GPT-6 Astra แต่ OpenAI บอกว่าเก่งเกือบเท่ากัน
GPT-6.1 Sol โมเดลใหม่จาก OpenAI คิดค่า API ขาเข้า $2 และขาออก $10 ต่อล้าน token แต่ต้นทุนจริงต่องานจะลดลงแค่ไหน ขึ้นกับงานและโมเดลที่นำมาเทียบ
OpenAI เปิดตัว GPT-6.1 Sol โมเดล AI รุ่นอัปเกรดของ GPT-6 Sol พร้อมจุดขายสำคัญคือความสามารถที่ใกล้เคียงกับรุ่นท็อปอย่าง GPT-6 Astra แต่มีราคาเพียง 1 ใน 5 เท่านั้น
ความเก่งที่ OpenAI อ้างถึงนั้น วัดจากงานหลัก 3 ด้าน ได้แก่ การเขียนโค้ดอัตโนมัติ การสั่งงานคอมพิวเตอร์แทนมนุษย์ และงานสายวิชาชีพหรืองานธุรกิจที่มีหลายขั้นตอน สำหรับคนที่ใช้ AI ทำงานเหล่านี้เป็นประจำ โมเดลนี้อาจช่วยลดค่าใช้จ่ายลงได้หลายเท่าตัว
อย่างไรก็ตาม คำว่า "จ่ายแค่หนึ่งในห้าและเก่งเกือบเท่ากัน" มีรายละเอียดที่ต้องทำความเข้าใจเพิ่ม เพราะคำว่าหนึ่งในห้านี้ บางจุดหมายถึงราคาต่อหน่วยนับข้อความอย่าง token แต่บางจุดหมายถึงต้นทุนจริงที่จ่ายต่องานหนึ่งชิ้น พอเปลี่ยนประเภทงานหรือเปลี่ยนโมเดลคู่เทียบ ตัวเลขต้นทุนจริงก็อาจกลายเป็นหนึ่งในสามหรือหนึ่งในเจ็ดได้เช่นกัน
ราคา API ของ GPT-6.1 Sol และส่วนลด 95% สำหรับข้อความซ้ำ
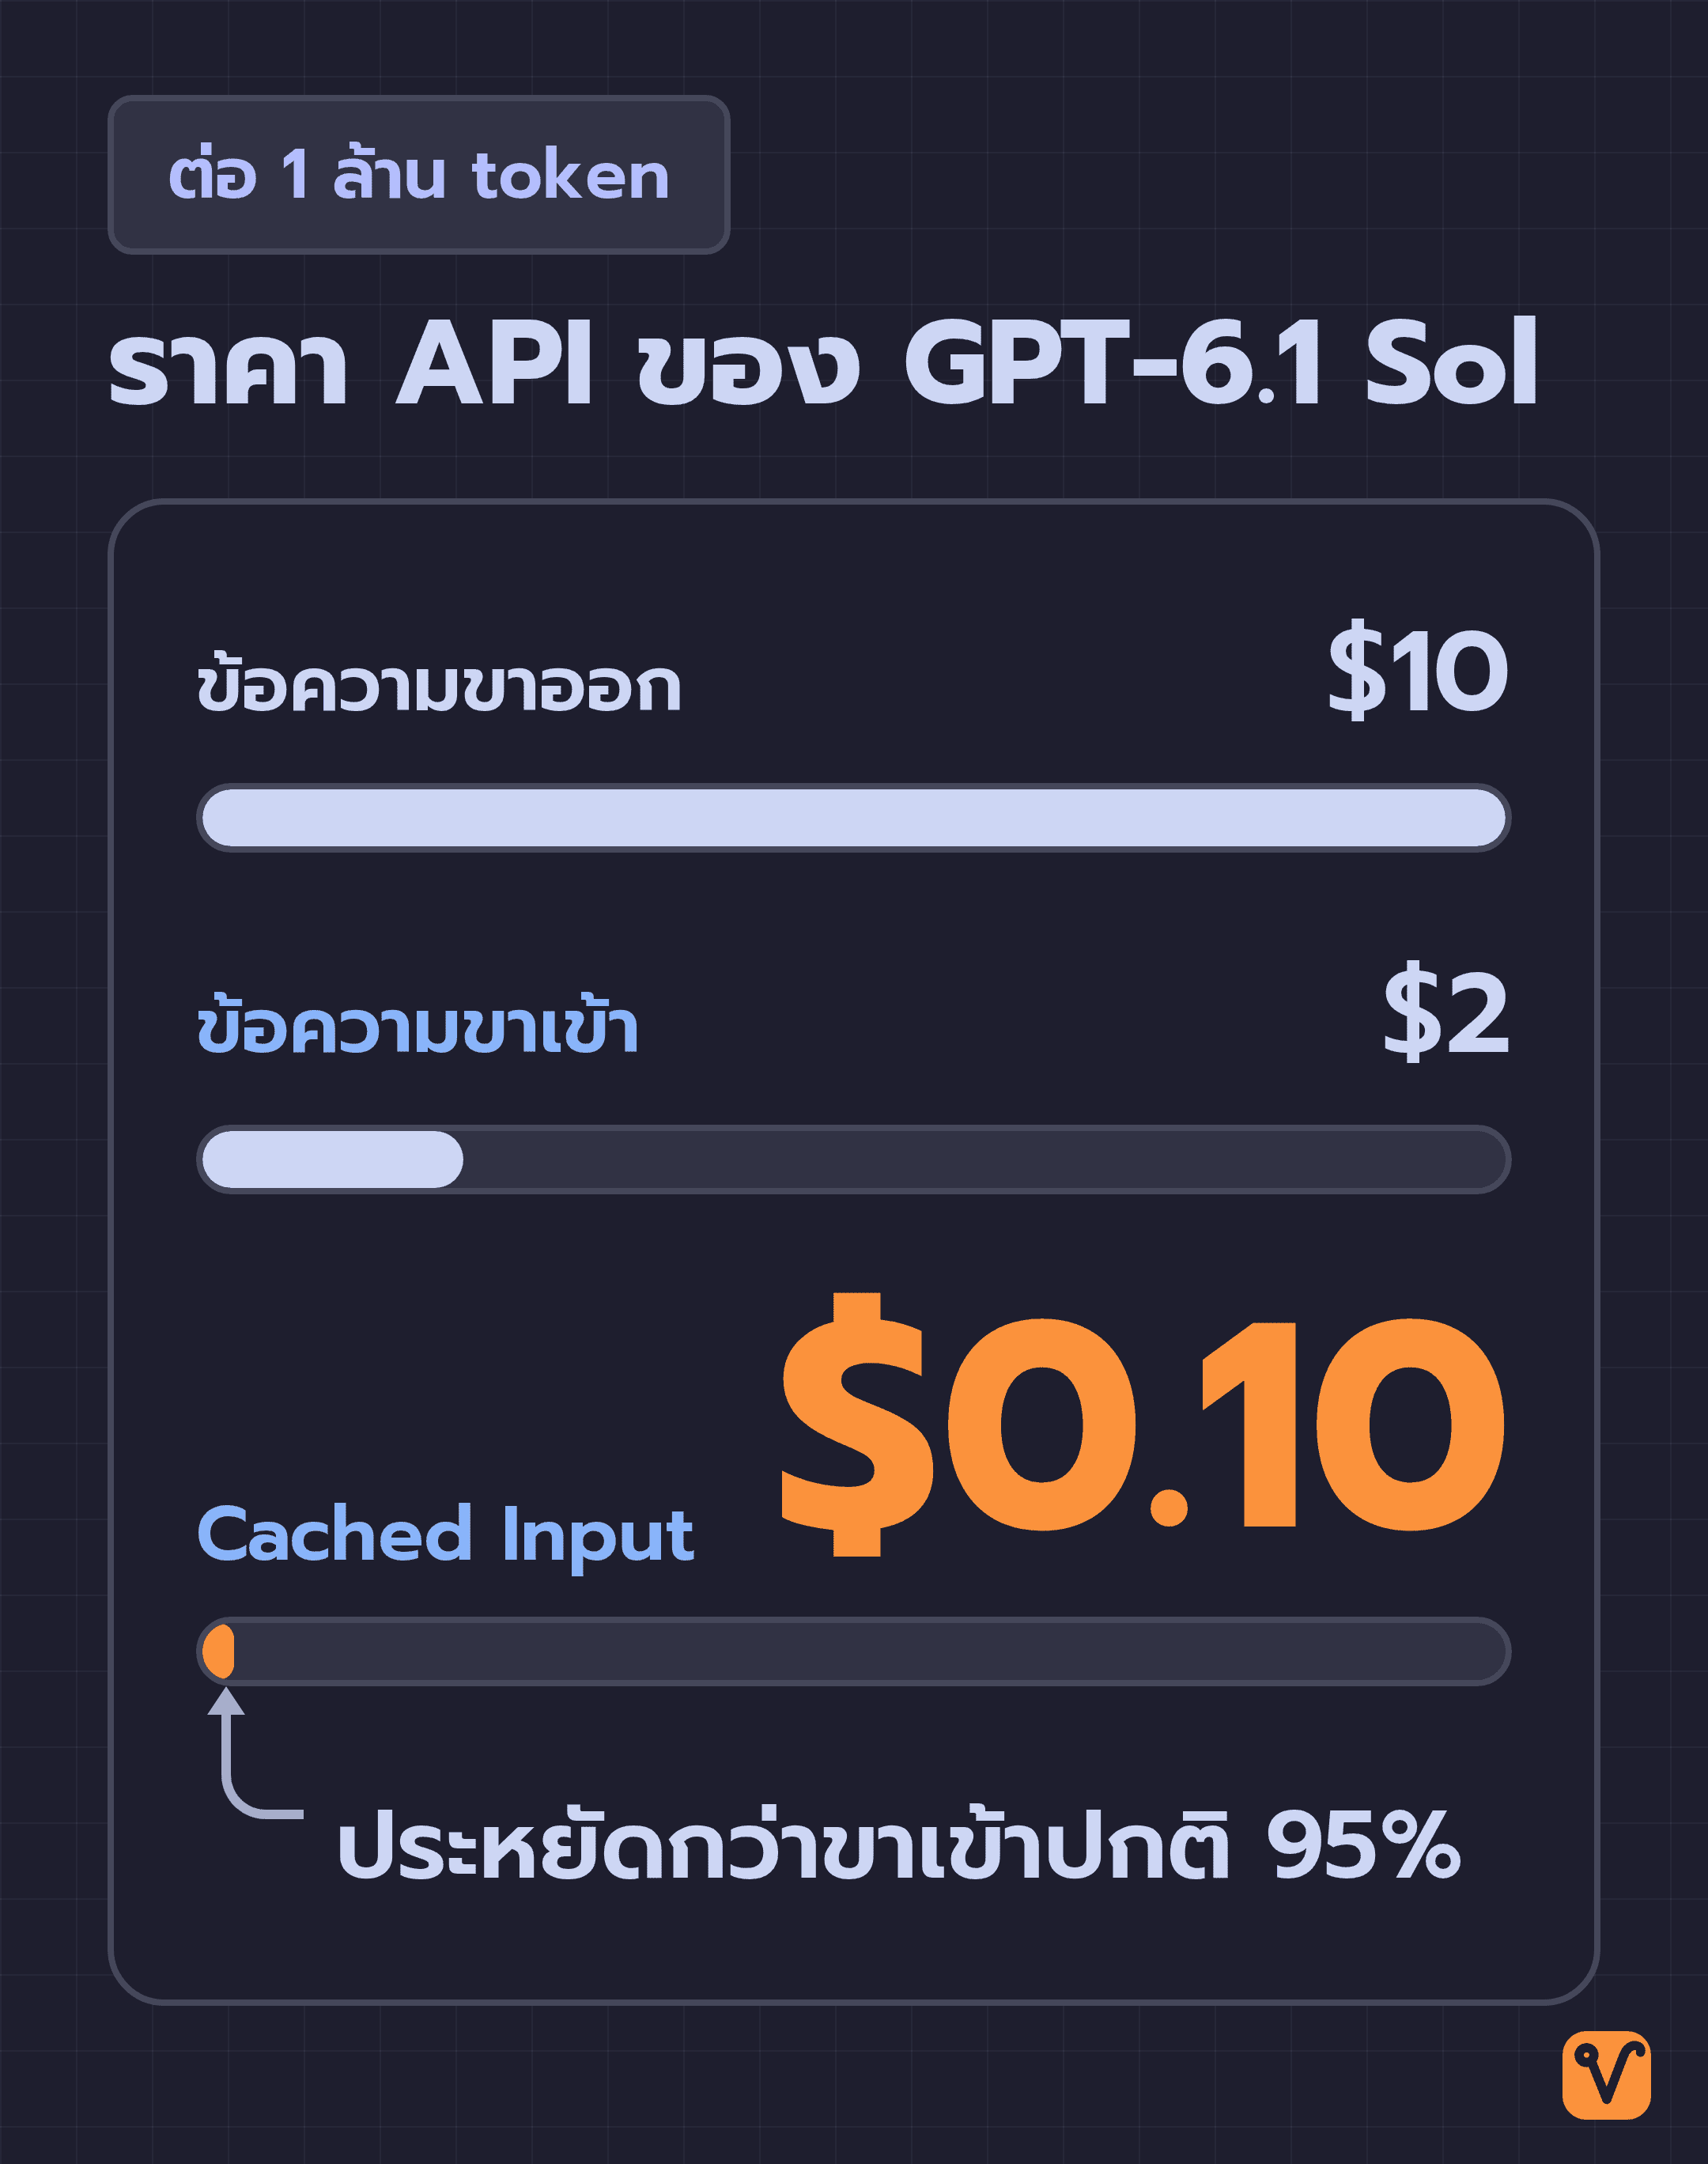
ราคาที่ประกาศนี้เป็นราคาสำหรับใช้งานผ่าน API ที่เป็นระบบเชื่อมต่อสำหรับนักพัฒนา โดยคิดต่อ 1 ล้าน token และแบ่งออกเป็น 3 รูปแบบ:
- ข้อความขาเข้า: สำหรับข้อมูลที่ส่งให้โมเดลอ่าน ราคา $2
- ข้อความขาเข้าที่ส่งซ้ำ หรือ Cached Input: สำหรับข้อมูลที่ซ้ำกับคำขอก่อนหน้า ราคา $0.10
- ข้อความขาออก: สำหรับคำตอบที่โมเดลเขียนออกมา ราคา $10
จะเห็นว่าราคาขาออกแพงกว่าขาเข้าถึง 5 เท่า ดังนั้นหากใช้จำนวน token เท่ากัน งานที่ต้องการให้โมเดลเขียนคำตอบยาวๆ จะมีค่าใช้จ่ายสูงกว่างานที่ส่งข้อมูลยาวๆ ให้โมเดลอ่าน
ส่วนที่ราคาถูกที่สุดคือ Cached Input โดย OpenAI ระบุว่าราคา $0.10 ต่อล้าน token นี้ จะช่วยให้นักพัฒนาสร้างระบบทำงานอัตโนมัติต่อเนื่องหลายขั้นตอนอย่าง AI Agent ได้คุ้มค่ายิ่งขึ้น ลองนึกภาพ AI Agent ที่ต้องแนบคู่มือหรือบริบทเดิมซ้ำๆ ไปในทุกคำขอ ข้อมูลส่วนที่ส่งซ้ำเหล่านี้คือ Cached Input
ราคานี้ประหยัดกว่าข้อความขาเข้าปกติถึง 95% และถูกลงครึ่งหนึ่งเมื่อเทียบกับ Cached Input ของ GPT-6 Sol รุ่นเดิม
ต้นทุนต่องานลดลงไม่เท่ากันในแต่ละโจทย์
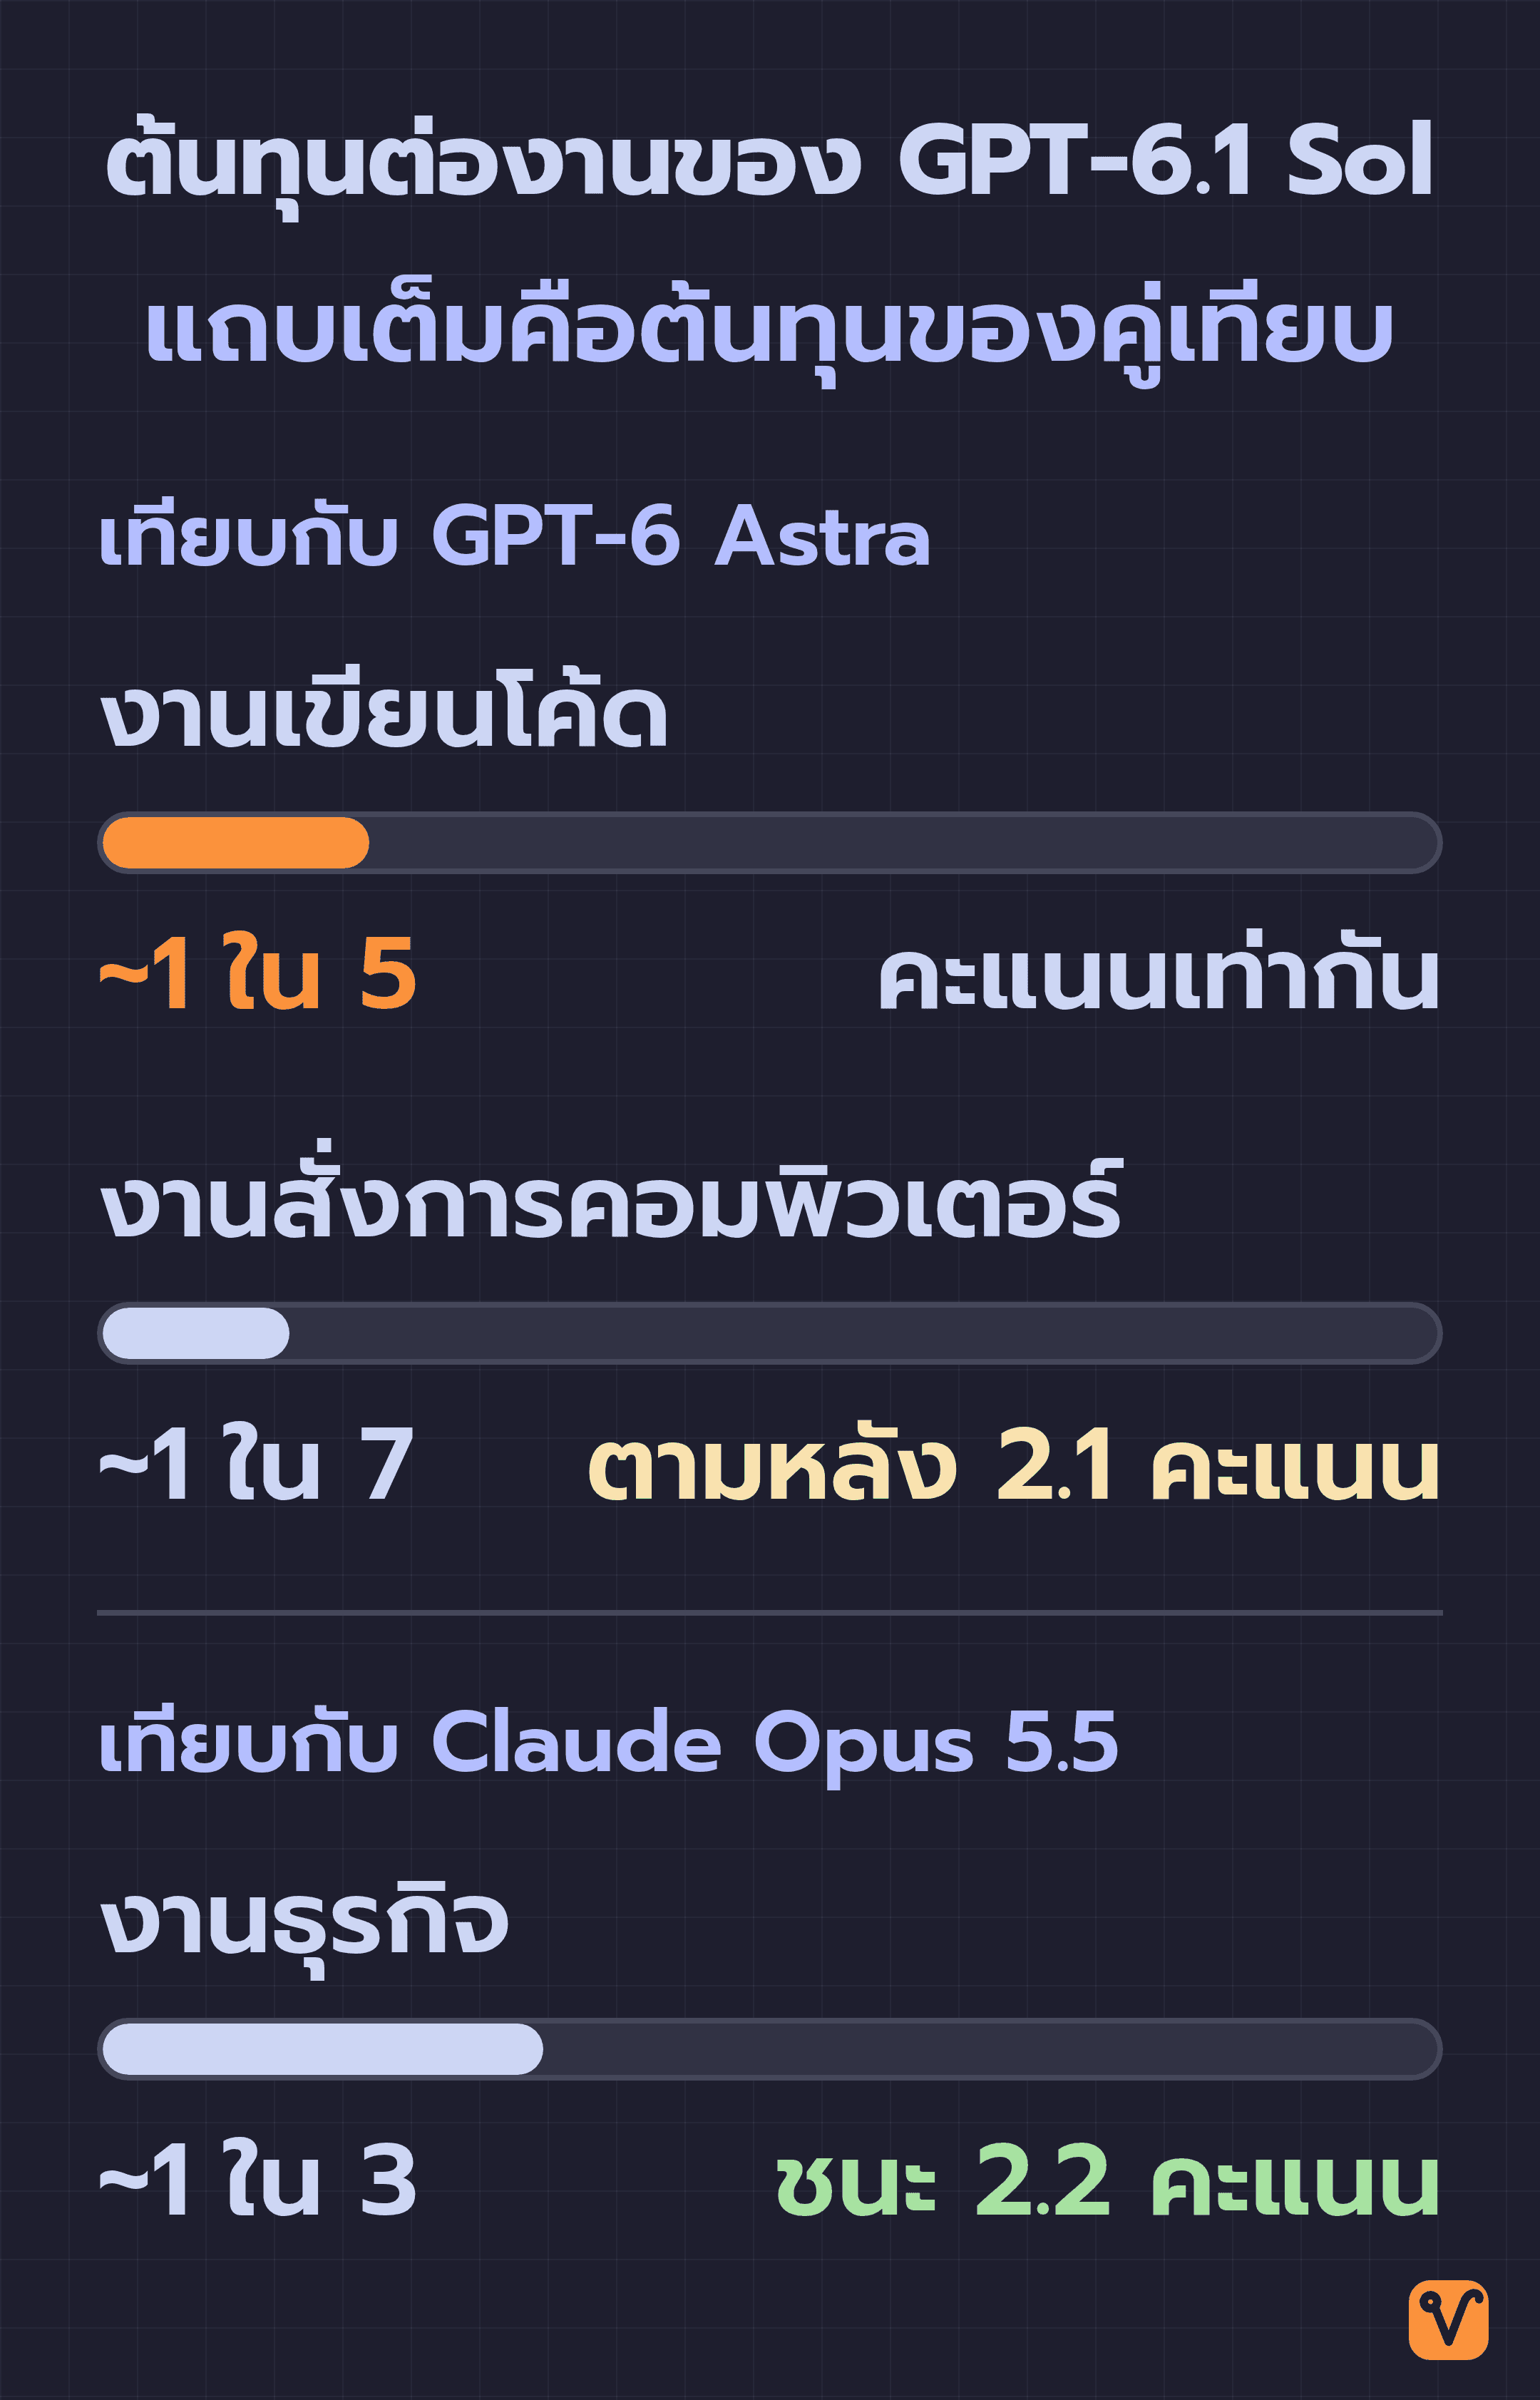
ราคาข้างต้นคือราคาต่อ token แต่เมื่อดูการใช้งานจริง OpenAI วัดผลผ่านชุดทดสอบมาตรฐานและคิดออกมาเป็น "ต้นทุนต่องาน"
ต้นทุนต่องานคือเงินที่จ่ายจริงเพื่อให้โมเดลแก้โจทย์แต่ละข้อจนสำเร็จ ค่าใช้จ่ายส่วนนี้จึงขึ้นอยู่กับจำนวน token ที่โมเดลใช้คิดและตอบด้วย ไม่ได้ขึ้นอยู่กับราคาต่อ token เพียงอย่างเดียว
นอกจากนี้ยังต้องดูค่า Reasoning Effort หรือระดับการคิดวิเคราะห์ก่อนตอบประกอบด้วย เพราะการทดสอบแต่ละชุดใช้ระดับการคิดไม่เท่ากัน
งานเขียนโค้ดใน DeepSWE ได้คะแนนเท่ากับ Astra
การทดสอบแรกเป็นงานวิศวกรรมซอฟต์แวร์ที่ซับซ้อนในโปรเจกต์จริง โดยใช้ชุดทดสอบ DeepSWE v1.1
ในงานนี้ GPT-6.1 Sol ทำคะแนนได้เทียบเท่ากับ Astra โดยมีต้นทุนต่องานเพียงประมาณ 1 ใน 5 ใกล้เคียงกับสัดส่วนราคาต่อ token และเมื่อเทียบกับ GPT-6 Sol รุ่นเดิม โมเดลใหม่นี้ทำคะแนนสูงกว่าคะแนนที่ดีที่สุดของรุ่นเดิมถึง 6.4 คะแนน ทั้งที่ตั้งค่า Reasoning Effort ต่ำกว่า และจ่ายเงินน้อยกว่า
งานธุรกิจใน AutomationBench ชนะ Opus 5.5
การทดสอบที่สองใช้ AutomationBench วัดว่า AI Agent สามารถจัดการงานธุรกิจหลายขั้นตอนได้ถูกต้องจนจบกระบวนการหรือไม่ โดยโจทย์ในชุดนี้ต้องทำงานร่วมกับเครื่องมือ 47 ตัว ครอบคลุมทั้งงานขาย การตลาด ปฏิบัติการ บริการลูกค้า การเงิน และงานบุคคล
คู่เทียบในการทดสอบนี้คือโมเดลคู่แข่งอย่าง Claude Opus 5.5 ของค่าย Anthropic ซึ่งเมื่อตั้งค่า Reasoning Effort ไว้ที่ระดับกลาง GPT-6.1 Sol ทำคะแนนชนะ Opus 5.5 ได้ 2.2 คะแนน ด้วยต้นทุนเพียงประมาณ 1 ใน 3 ของ Opus 5.5 เท่านั้น และคะแนนนี้ยังสูงกว่า GPT-6 Sol รุ่นเดิมที่ตั้งค่าเดียวกันอยู่ 4.8 คะแนน
ข้อสังเกตคือ ต้นทุน 1 ใน 3 ตรงนี้เป็นการเทียบกับ Claude Opus 5.5 ไม่ใช่การเทียบกับ Astra จึงไม่ควรนำตัวเลขนี้ไปเทียบกับสัดส่วน 1 ใน 5 ของงานเขียนโค้ดตรงๆ
งานวิทยาศาสตร์ใน Terminal-Bench Science จ่ายเพียง $5.47 ต่องาน
การทดสอบที่สามเป็นงานสายวิทยาศาสตร์ ทั้งการวิเคราะห์ข้อมูล การรันแบบจำลอง และการพิสูจน์ทฤษฎีบท ซึ่งวัดด้วย Terminal-Bench Science 0.1 ชุดทดสอบงานวิจัย ในชุดนี้ OpenAI เปิดเผยต้นทุนเฉลี่ยเป็นตัวเงินจริง เมื่อตั้งค่า Reasoning Effort ไว้ระดับสูงสุด:
| โมเดล | ค่าใช้จ่ายเฉลี่ยต่องาน |
|---|---|
| GPT-6.1 Sol | $5.47 |
| Claude Opus 5.5 | $23.21 |
| GPT-6 Astra | $23.80 |
จากตัวเลขนี้ GPT-6.1 Sol มีต้นทุนต่องานถูกกว่าอีกสองโมเดลเกิน 75% และเมื่อเทียบกับ GPT-6 Sol รุ่นเดิมที่ตั้งค่าระดับการคิดสูงสุดเหมือนกัน รุ่นใหม่นี้ทำคะแนนได้มากกว่า 2 เท่า โดยมีค่าใช้จ่ายต่องานไม่ถึงครึ่งหนึ่งของรุ่นเดิม
งานที่ยังคุ้มค่าที่จะจ่ายให้ Astra
แม้ภาพรวมของ GPT-6.1 Sol จะทำได้ดีมาก แต่คะแนนสูงสุดในงานวิทยาศาสตร์ชุดเดียวกันนี้ยังคงเป็นของ Astra ที่ 68.1% โดย OpenAI เองก็ระบุไว้ชัดเจนในประกาศว่า สำหรับงานวิจัยทางวิทยาศาสตร์ที่ยากและซับซ้อนที่สุด ยังคงแนะนำให้ใช้ Astra
ส่วนงานสั่งการคอมพิวเตอร์แทนมนุษย์ก็ยังเห็นความต่างอยู่ โดยในชุดทดสอบ OSWorld 2.0 ที่ตั้งค่า Reasoning Effort สูงสุด GPT-6.1 Sol ยังตามหลัง Astra อยู่ 2.1 คะแนน แต่มีต้นทุนต่องานเพียงประมาณ 1 ใน 7 เท่านั้น
การเลือกว่าจะใช้โมเดลไหนจึงขึ้นอยู่กับความต้องการของแต่ละงาน หากเป็นงานสำคัญที่ผิดพลาดไม่ได้เลย คะแนนที่ Astra ยังนำอยู่อาจคุ้มกับค่า token ที่แพงกว่า 5 เท่า แต่หากเป็นงานที่ต้องประมวลผลซ้ำบ่อยๆ และตรวจสอบความถูกต้องได้ง่าย เงินที่ประหยัดได้จาก GPT-6.1 Sol ในทุกรอบน่าจะคุ้มกว่า
GPT-6.1 Sol ยังไม่มีให้ใช้ในหน้าแชตของ ChatGPT
สิ่งที่ควรรู้ก่อนคือ GPT-6.1 Sol ยังไม่มีให้เลือกใช้ในหน้าแชตปกติของ ChatGPT
ปัจจุบันเปิดให้ใช้งานได้ผ่าน 3 ช่องทาง:
- ChatGPT Work หน้าทำงานที่แยกจากแชตปกติ สำหรับผู้ใช้แพ็กเกจ Plus, Pro, Business, Enterprise และ Edu
- Codex เครื่องมือช่วยเขียนโค้ดของ OpenAI สำหรับผู้ใช้แพ็กเกจกลุ่มเดียวกัน
- API สำหรับนักพัฒนา โดยเรียกใช้งานผ่านชื่อโมเดล
gpt-6.1-sol
ทั้งสามช่องทางเปิดให้ใช้งานได้ตั้งแต่วันประกาศ ถ้าใช้แพ็กเกจที่ระบุไว้แต่ไม่พบชื่อโมเดลในหน้าแชตปกติ ไม่ต้องแปลกใจ เพราะต้องเข้าไปใช้งานผ่าน ChatGPT Work หรือ Codex แทน
ยิ่งโมเดลรุ่นประหยัดทำผลงานได้ใกล้เคียงกับรุ่นท็อปมากเท่าไร หากจะยอมจ่ายแพงกว่าเพื่อใช้รุ่นท็อป ก็ยิ่งต้องตอบให้ชัดเจนว่าความสามารถส่วนต่างนั้นจำเป็นกับงานของเราจริงหรือไม่
ที่มา: เอกสารทางการของ GPT-6.1 Sol
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin