DeepSeek เปิดโค้ด dsh-superagent ต้นแบบ AI agent ที่สั่งงานได้ด้วยการแท็กใน GitHub issue แล้วรับไปทำจนส่ง Pull Request กลับ ออกแบบจากข้อสังเกตว่าคนคอยตามงาน agent ได้พร้อมกันแค่ 3-5 session
dsh-superagent ต้นแบบ AI agent ของ DeepSeek รับงานจาก GitHub issue ไปทำเองแล้วตอบกลับด้วย Pull Request กฎการทำงานทุกข้อออกแบบมาให้รบกวนคนน้อยที่สุด
DeepSeek เปิดโค้ด dsh-superagent ต้นแบบ AI agent ที่สามารถรับงานจากแพลตฟอร์มฝากโค้ดอย่าง GitHub ไปแก้โค้ดเองจนเสร็จ แล้วส่ง Pull Request หรือคำขอรวมโค้ดกลับมาให้คนตรวจ
เวลาเราเปิด coding agent อย่าง Claude Code ไว้ 3 หน้าต่าง คู่กับ Codex อีก 1 หน้าต่าง ซึ่งแต่ละหน้าต่างก็คือหนึ่ง session หรือรอบการทำงานที่แยกกันคนละเรื่อง พอสลับแท็บไปมาบ่อยๆ เรามักจะเริ่มจำไม่ได้ว่าหน้าต่างไหนกำลังรอเราตอบ หรือหน้าต่างไหนกำลังแก้อะไรค้างไว้
บัญชี DeepSeek Harness โพสต์บทความ Exploring Super-agent Design บน X เมื่อวันที่ 1 พ.ย. โดยหยิบปัญหานี้มาเปิดเรื่อง ทีม DeepSeek เล่าว่าจากประสบการณ์ใช้งานจริง คนคนหนึ่งมักตามงาน agent ที่กำลังรันอยู่พร้อมกันได้แค่ 3 ถึง 5 session เท่านั้น พวกเขาจึงสรุปว่า ถ้าเป็นงานชิ้นเดียว ขีดจำกัดจะอยู่ที่ความเก่งของโมเดล แต่ถ้าเป็นการรันหลายงานพร้อมกัน คอขวดจะกลายเป็นสมาธิและความสนใจของมนุษย์แทน
dsh-superagent คือโค้ดต้นแบบที่สร้างขึ้นมาเพื่อแก้ปัญหานี้โดยเฉพาะ หน้าที่ของมันคือคอยเฝ้ารีโปของโปรเจกต์บน GitHub แล้วรับงานจากคนที่มีสิทธิ์เท่านั้น จากนั้นจะแยกไปทำงานใน session และโฟลเดอร์ของตัวเอง ก่อนจะตอบกลับมาในเธรดเดิม ระบบทั้งหมดออกแบบตามหลักการสำคัญเพียงข้อเดียว คือใช้ความสนใจของคนให้น้อยที่สุด แต่ให้คุณค่ากลับมามากที่สุด
โค้ดทั้งหมดเปิดให้ดูบน GitHub ในรีโปของ deepseek-ai ซึ่งมียอดดาว 7.1k (ข้อมูล ณ วันที่ 2 พ.ย.) แต่ไฟล์ README หรือเอกสารแนะนำโปรเจกต์ก็เตือนไว้ตั้งแต่บรรทัดแรกว่า นี่เป็นเพียงโค้ดต้นแบบเพื่อการวิจัยและใช้อ้างอิงเท่านั้น ไม่ใช่ผลิตภัณฑ์ทางการของ DeepSeek
แท็ก dsh-superagent ใน GitHub Issue แล้วรอรับ Pull Request
การสั่งงานจะเริ่มที่ Issue บน GitHub ช่องทางเดิมที่ใช้แจ้งปัญหาหรือขอฟีเจอร์อยู่แล้ว โดยงานแต่ละชิ้นจะผ่านขั้นตอนดังนี้:
- คนที่มีสิทธิ์ (อยู่ในรายชื่อที่อนุญาต) พิมพ์คอมเมนต์ใน Issue ว่า
@<agent login> <request>โดยแท็กชื่อบัญชีของ agent แล้วตามด้วยรายละเอียดงานที่ต้องการให้ทำ - ภายในเวลาประมาณ 1 นาที งานชิ้นนั้นจะขึ้นเป็นรายการงานหรือ Ticket บนหน้าควบคุม Panel ของระบบ
- agent จะเริ่มทำงานใน session และโฟลเดอร์ของตัวเอง โดยแยกขาดจากงานชิ้นอื่น
- เมื่อได้ผลแล้ว agent จะตอบกลับมาในเธรดเดิม เช่นส่ง Pull Request ให้คนตรวจก่อนกดรวมโค้ด
หน้า Panel จะแสดงเฉพาะสิ่งที่คนจำเป็นต้องดู โดยจะดันงานที่รอคนตัดสินใจขึ้นมาแสดงเป็นอันดับแรก ส่วนงานที่รันได้ปกติดีก็จะไม่ขึ้นมากวนสายตาบนหน้าจอ
ตัว dsh-superagent เป็นชุดเสริม (bundle) ที่ต้องติดตั้งลงบน DeepSeek Harness อีกทอดหนึ่ง
README ยังเล่าที่มาของโค้ดด้วยว่า พัฒนาขึ้นจากงานจริงในแต่ละวันของทีม และงานวิศวกรรมหลายส่วนก็เขียนโดย coding agent แต่มีจุดที่ต้องระวังคือ ทีมใช้คำว่าโค้ด "จำนวนมาก" เป็นฝีมือ agent ซึ่งไม่ได้หมายความว่า agent สร้างระบบทั้งหมดขึ้นมาเอง
Agent ที่ทักคนเฉพาะตอนที่ต้องให้คนตัดสินใจ
หลักการ "ใช้ความสนใจของคนให้น้อยที่สุด" อาจฟังดูเหมือนคำขวัญลอยๆ แต่ในเอกสาร docs/000-philosophy.md ได้แปลงเรื่องนี้ให้กลายเป็นเกณฑ์ที่วัดผลได้จริง ทุกองค์ประกอบในโปรเจกต์ต้องคุ้มกับความสนใจที่คนต้องเสียให้มัน ทั้งข้อความแจ้งเตือน คำถาม การตั้งค่า ชิ้นส่วนบนหน้า Panel หรือแม้แต่ข้อความหนึ่งย่อหน้าในเอกสาร ถ้าสิ่งไหนสร้างคุณค่าได้ไม่คุ้มกับความสนใจที่เสียไป ก็ต้องตัดทิ้ง
เกณฑ์นี้นำมากำหนดเป็นกฎการทำงานของ agent ดังนี้:
- ลงมือทำเมื่อมีคนสั่ง หรือมีกฎที่ทีมกำหนดไว้เท่านั้น: คำสั่งจะต้องเป็นการเรียก agent โดยตรง และต้องมาจากคนที่มีสิทธิ์สั่งงาน
- งานที่ไม่มีคนสั่ง ให้เริ่มจากแค่จดบันทึก: ต้องมีกฎของทีมรองรับ และต้องเริ่มในโหมดที่ agent แค่จดบันทึกว่าจะทำอะไร โดยยังไม่ลงมือทำจริง
- ตอบรับงานครั้งเดียวแล้วเงียบ: agent จะตอบยืนยันว่ารับงานแล้ว พร้อมบอกว่าจะทำอะไร จากนั้นจะไม่ส่งข้อความมารบกวนระหว่างทำงานอีก
- ทักอีกครั้งเมื่อมีเหตุจำเป็น: จะส่งข้อความอีกครั้งก็ต่อเมื่อทำงานเสร็จ มีเรื่องที่ต้องให้คนตัดสินใจ หรือเจอปัญหาจนทำไม่เสร็จ โดยส่งเป็นข้อความสั้นๆ เฉพาะในเธรดที่สั่งงาน
- ถามทีละคำถาม: แต่ละคำถามต้องชัดเจนและอยู่ในรูปแบบที่ตอบง่าย เพื่อให้คนเห็นคำถามและตอบได้ทันที ไม่จมหายไปในรายงานยาวๆ
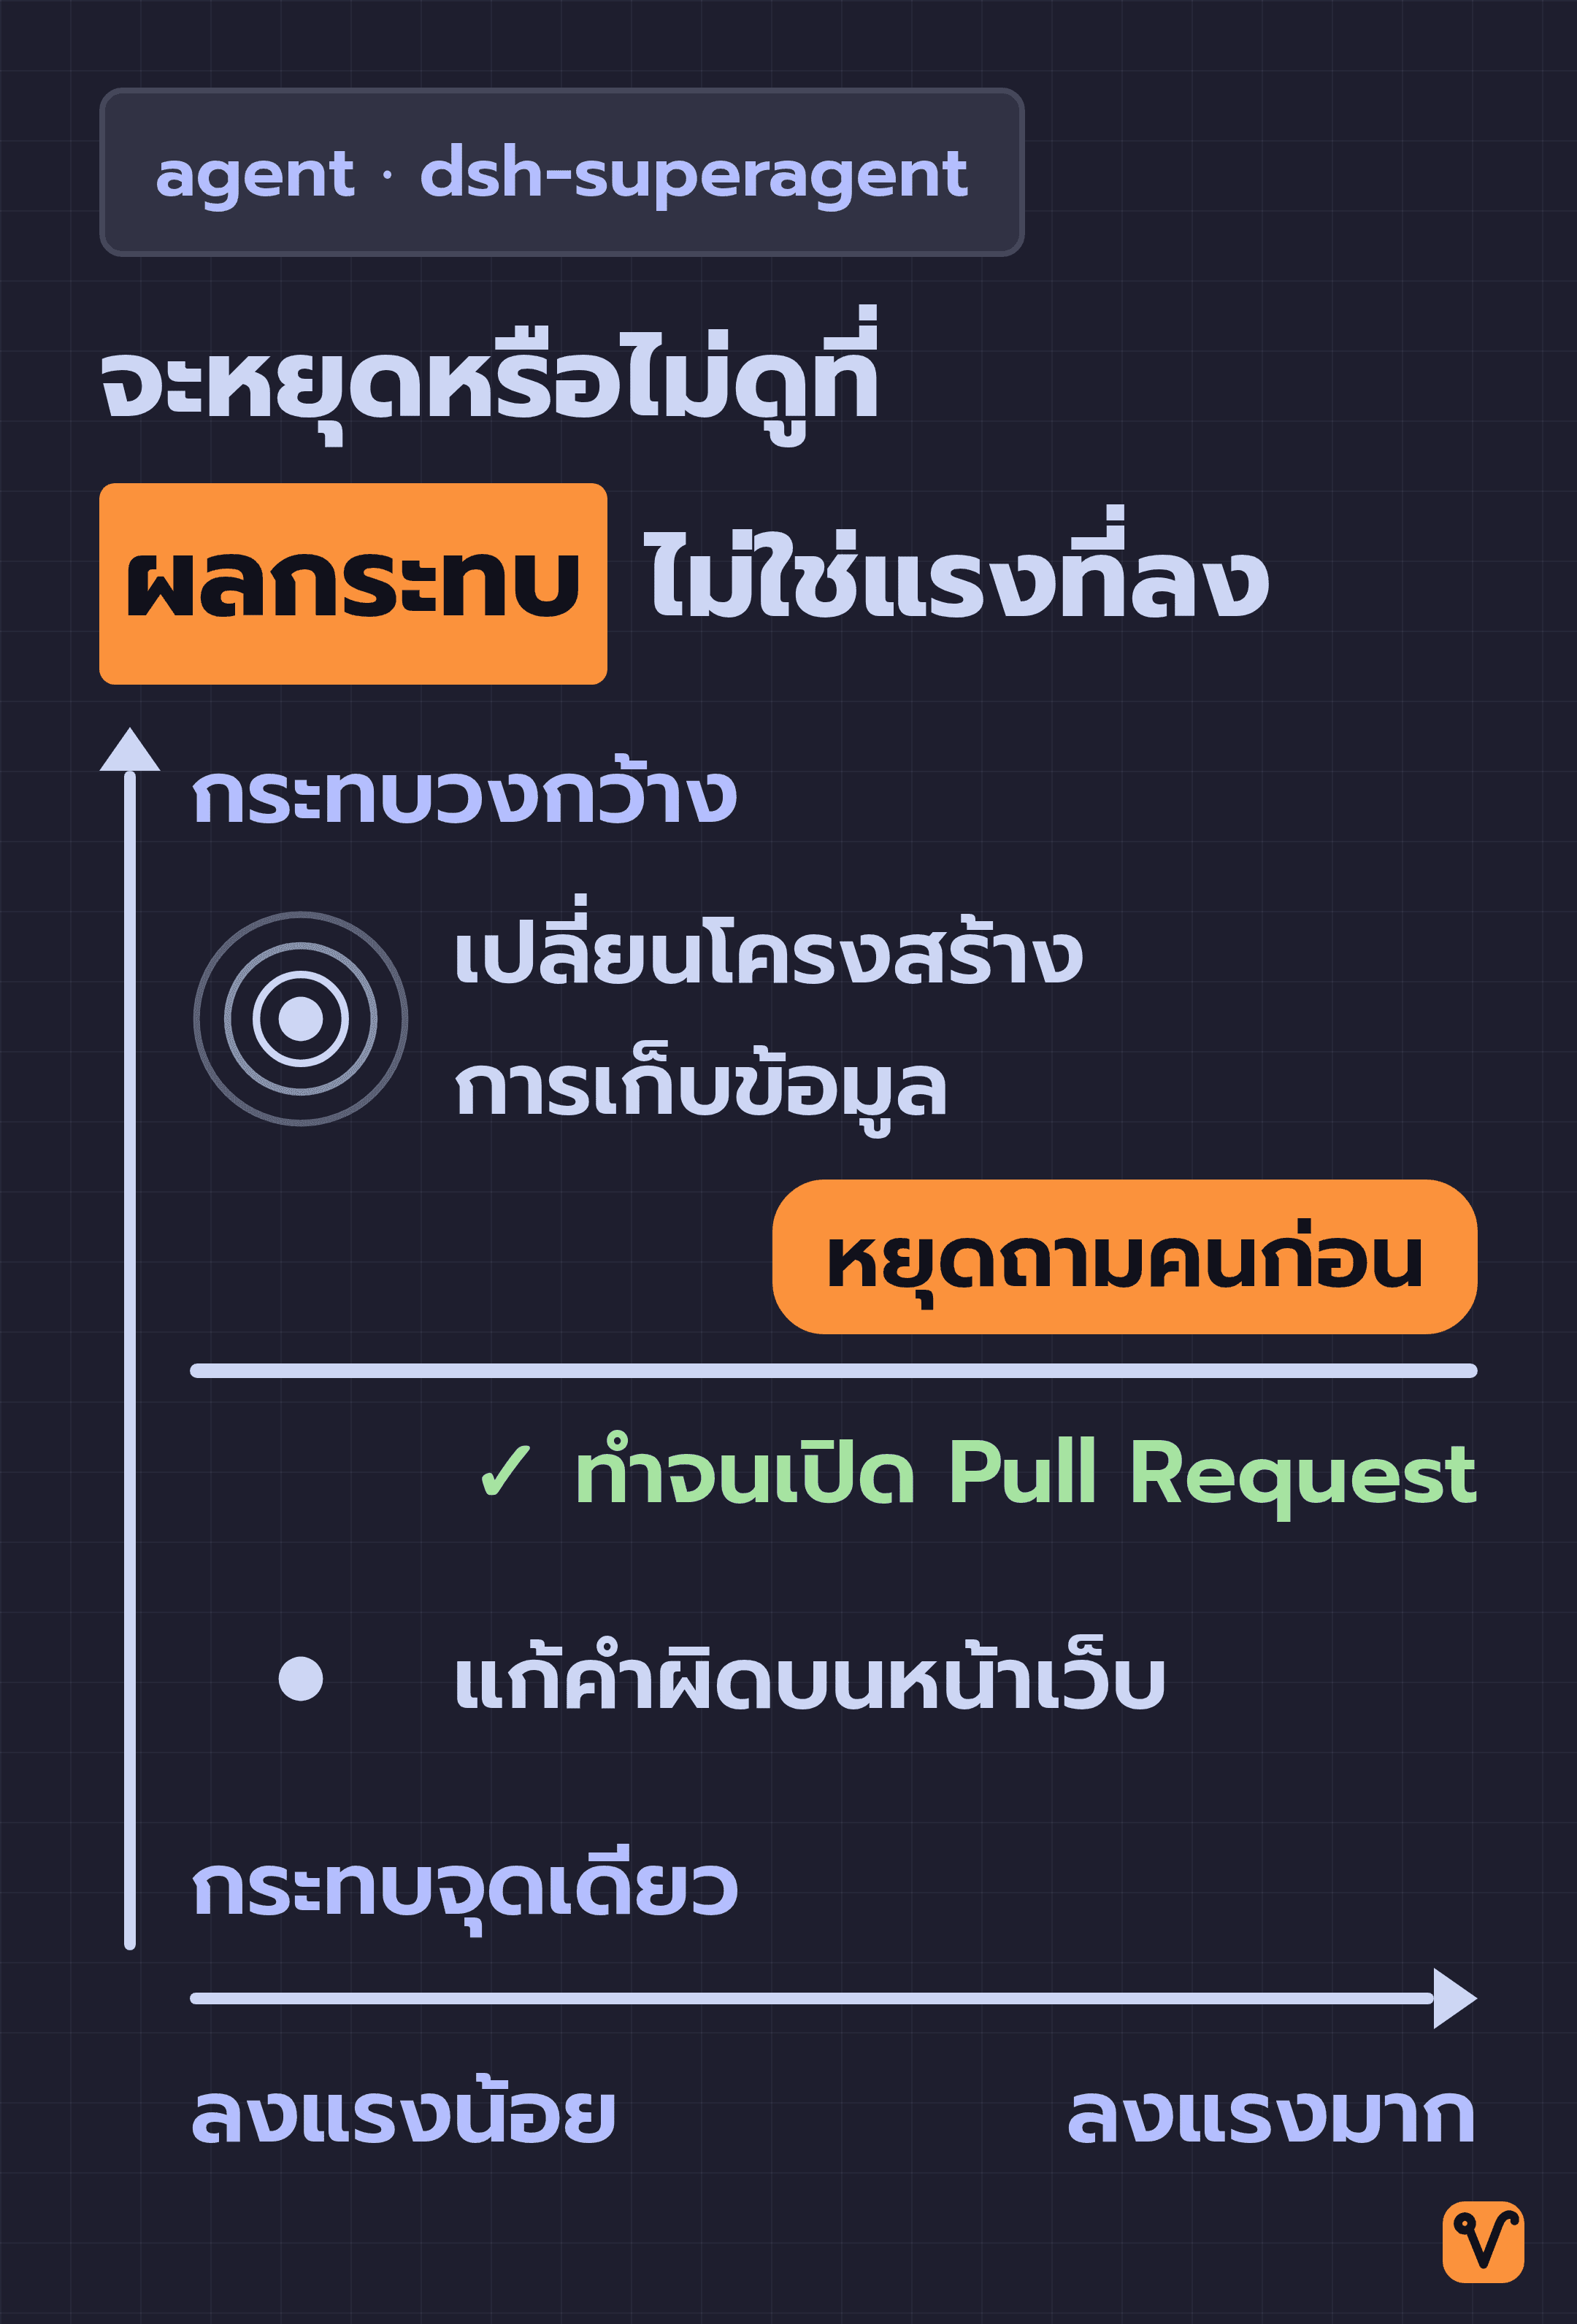
- หยุดตามผลกระทบ ไม่ใช่ตามความพยายาม: งานแก้โค้ดเฉพาะจุด agent สามารถทำต่อเนื่องไปจนถึงขั้นส่ง Pull Request ให้ตรวจได้เลย แต่งานที่มีผลต่อการออกแบบเชิงโครงสร้าง agent จะหยุดทำแล้วถามคนก่อนเสมอ
- รายงานตามความจริง: ถ้างานยังไม่เสร็จก็บอกว่าไม่เสร็จ ถ้าทำไม่สำเร็จก็บอกตรงๆ และไม่แอบเลี่ยงข้อจำกัดเพียงเพื่อจะได้ไม่ต้องถามคน
ในบรรดากฎทั้งหมด ข้อที่ว่า "หยุดตามผลกระทบ" อาจฟังดูเข้าใจยากที่สุดในตอนแรก เพราะเหมือนสั่งให้ AI ทำงานน้อยลง แต่ความจริงแล้ว กฎข้อนี้ตัดสินจากระดับผลกระทบของงาน ไม่ใช่ปริมาณแรงที่ลงไป เช่น ถ้าเป็นการแก้คำผิดบนหน้าเว็บซึ่งกระทบจุดเดียว agent สามารถทำจนจบแล้วเปิด Pull Request ให้ตรวจได้เลย แต่ถ้าเป็นงานที่ต้องเลือกว่าจะเปลี่ยนโครงสร้างการเก็บข้อมูลของทั้งระบบหรือไม่ ต่อให้แก้โค้ดแค่ไม่กี่บรรทัด agent ก็ต้องหยุดถามคนก่อน เพราะผลกระทบของมันกว้างกว่ามาก
agent ที่ทำงานแทนคนได้ทั้งทีม ก็เปลืองความสนใจของคนทั้งทีมได้เหมือนกัน
หลักการชุดนี้ไม่ได้ผูกอยู่กับโค้ดของ DeepSeek เท่านั้น แต่เป็นแนวคิดที่นำไปปรับใช้กับ agent ตัวไหนก็ได้ แม้จะไม่ได้ติดตั้ง dsh-superagent เลยก็ตาม
Router คอยคุยกับคน ส่วน Worker ลงมือทำ
ทำไมต้องออกแบบให้ละเอียดขนาดนี้? บทความของ DeepSeek ตอบคำถามนี้ด้วยแนวคิดการออกแบบระบบที่ใหญ่กว่าตัวต้นแบบ
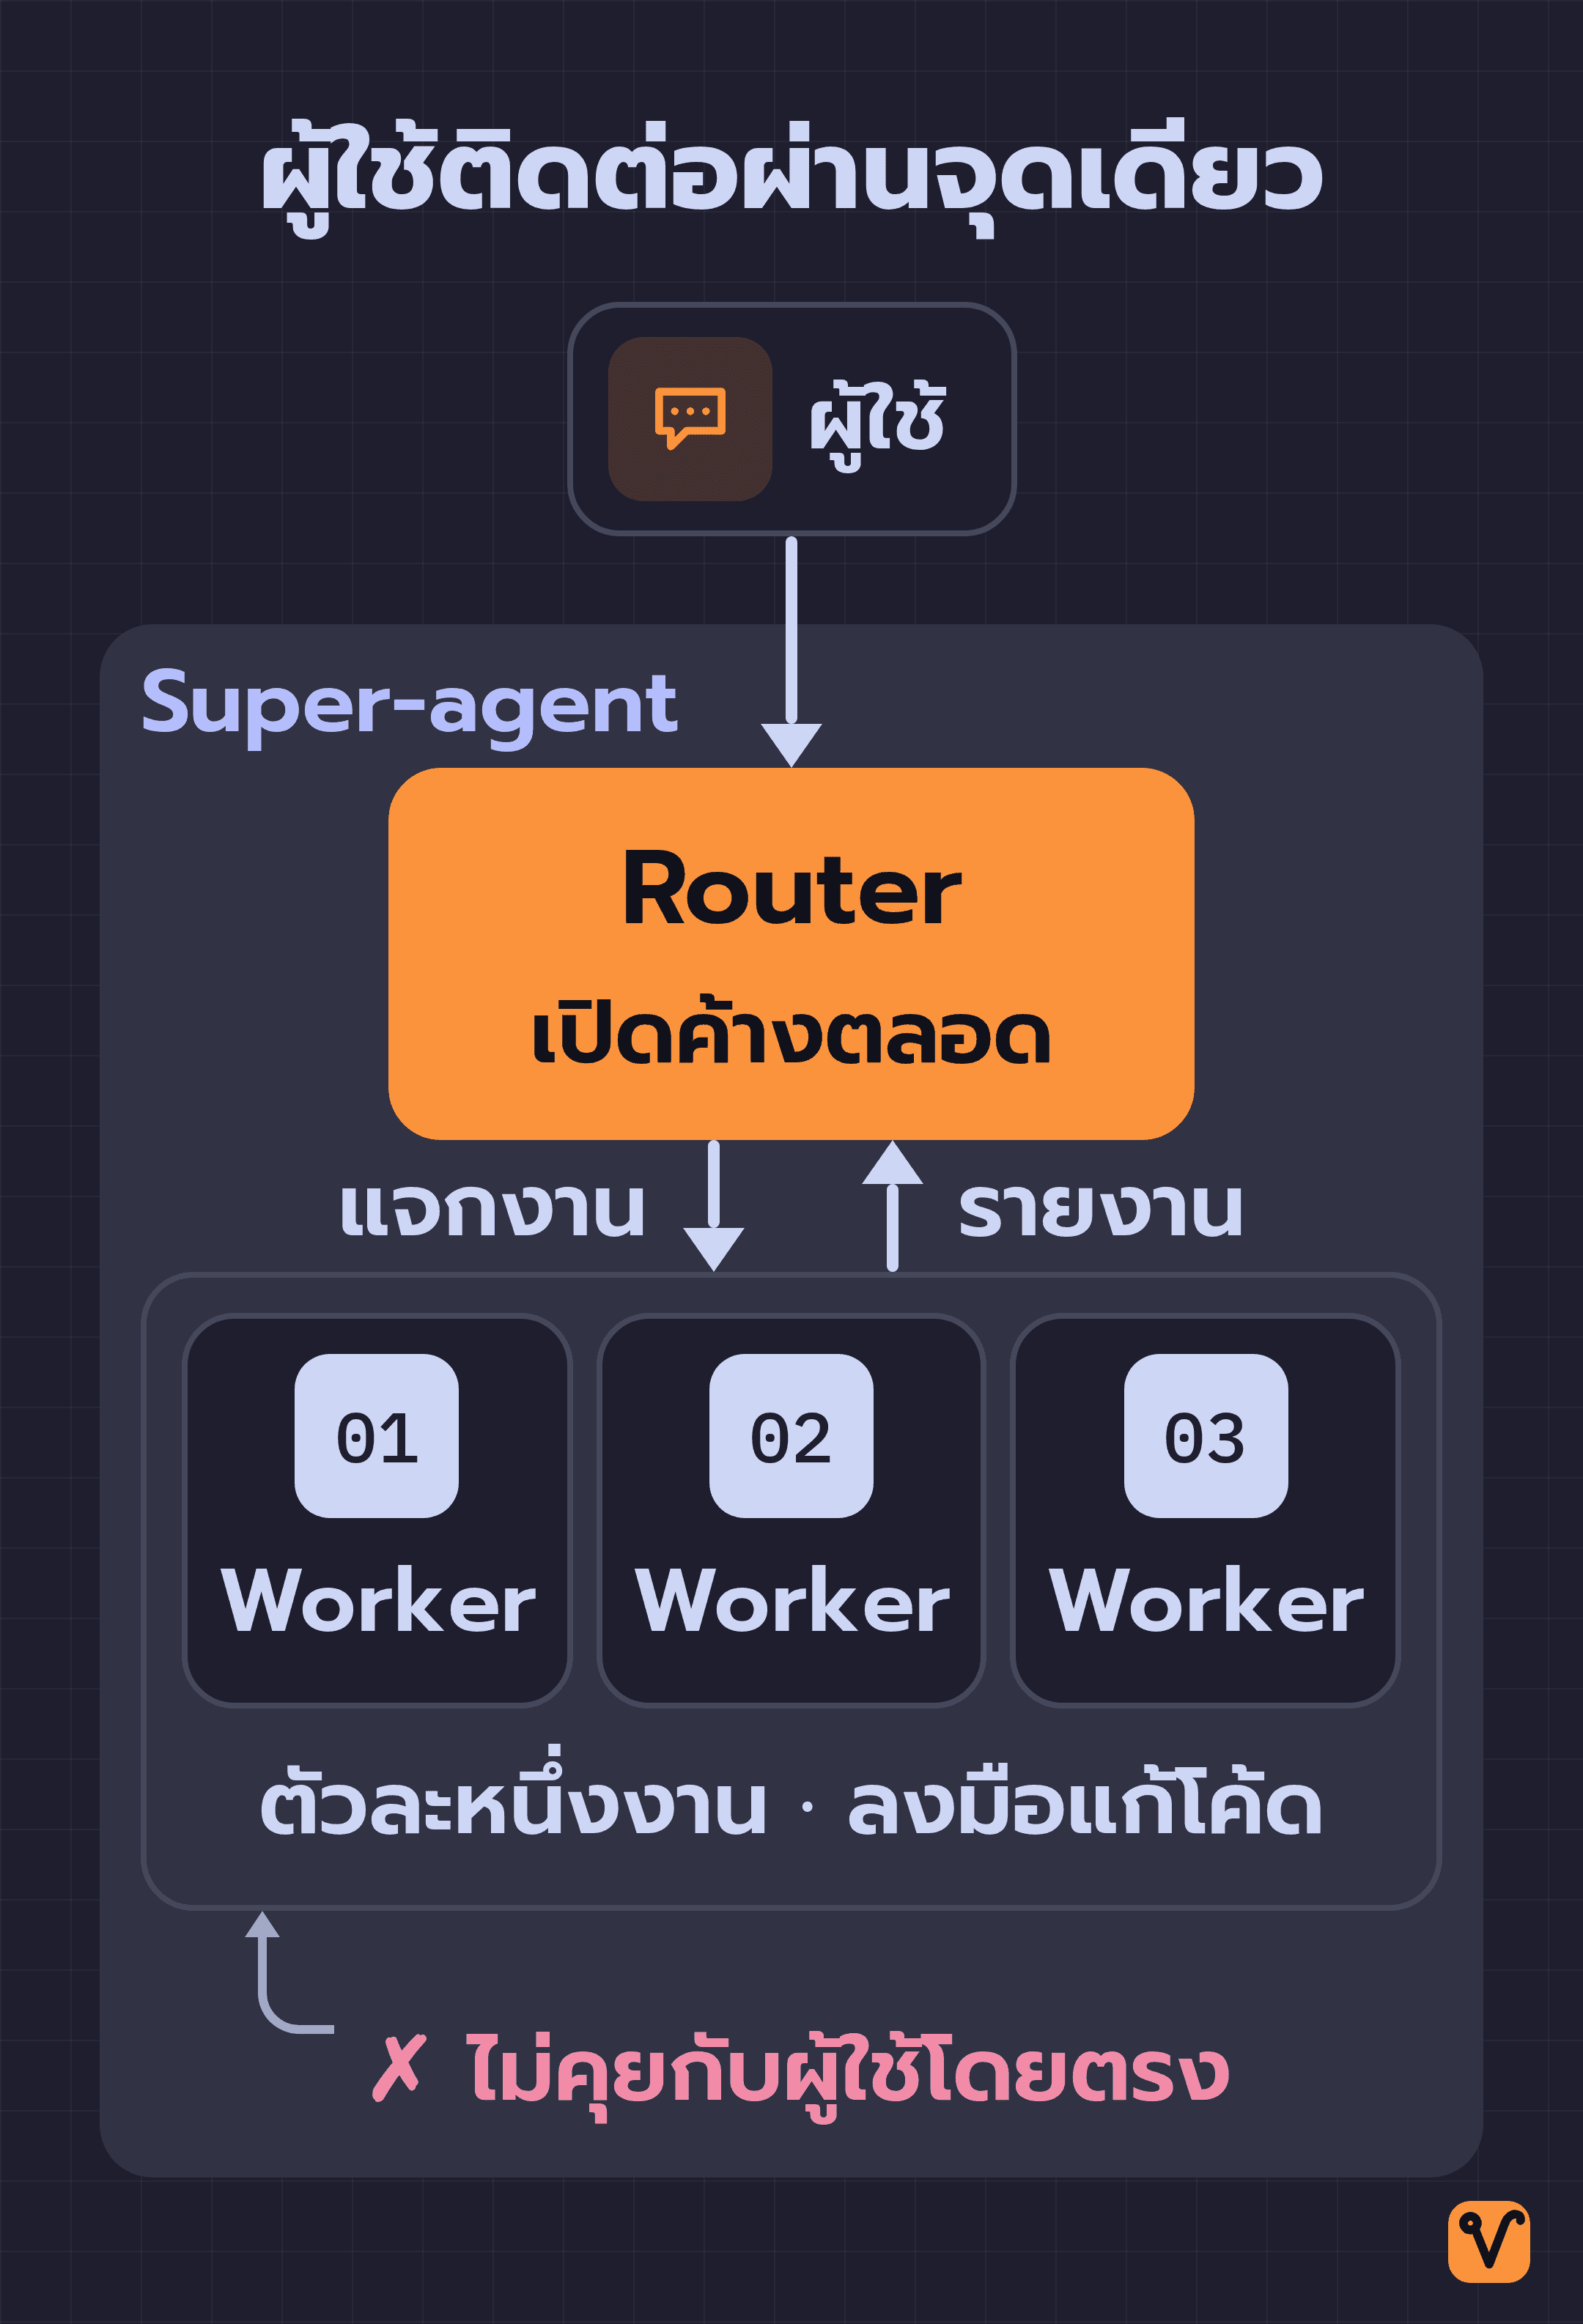
บทความชี้ว่า AI agent ทุกวันนี้ยังใช้หนึ่ง session เป็นหน่วยของงาน และแต่ละ session จะแยกขาดจากกัน ทำให้คนที่ต้องการรันหลายงานพร้อมกัน ต้องคอยสลับหน้าต่าง session ไปมา และต้องจำเอาเองว่าแต่ละอันกำลังทำอะไรอยู่ ทาง DeepSeek จึงเสนอโครงสร้างระบบแบบสองชั้น และเรียกระบบนี้ว่า Super-agent
ชั้นบนคือ Router session หลักที่เปิดค้างไว้ตลอดเวลา คอยรับข้อความจากคนทุกช่องทางแล้วแจกจ่ายงานออกไป Router จะไม่ลงมือทำงานเอง และรันได้โดยไม่ต้องมีเครื่องมือรันคำสั่งระบบอย่าง Bash tool ด้วยซ้ำ
ชั้นล่างคือ Worker ตัวลงมือทำงานที่ได้รับมอบหมาย Worker แต่ละตัวรับผิดชอบงานเพียงชิ้นเดียว และมีบริบทกับเครื่องมือของตัวเองครบครัน Worker เป็นตัวที่ลงมือแก้โค้ดและตัดสินคุณภาพงานจริง จึงมักต้องใช้โมเดลที่ฉลาดที่สุด และถ้างานซับซ้อน Worker ก็ยังสร้าง subagent หรือตัวช่วยย่อยที่แยกไปทำงานเฉพาะส่วนของตัวเองได้อีก
กติกาสำคัญของระบบสองชั้นนี้คือ Worker จะไม่คุยกับคนโดยตรง แต่จะรายงานสถานะให้ Router ทราบ แล้วให้ Router เป็นฝ่ายตอบกลับผู้ใช้เท่านั้น ผู้ใช้จึงเห็นการติดต่อสื่อสารผ่านจุดเดียวเสมอ โดยไม่มีหลาย session แย่งกันตอบในเธรดเดียวกัน
ส่วน agent แบบเดิมที่ใช้ session เดียว ตัวหลักมักต้องลงมือทำงานเอง พอมีข้อความใหม่เข้ามาก็ต้องหยุดชะงักกลางคัน บทความจึงสรุปว่า session ควรเป็นเพียงเรื่องการจัดการภายในของระบบ ไม่ควรกลายมาเป็นภาระที่ผู้ใช้ต้องคอยแบกไว้ในหัว
Trigger ทำให้งานเริ่มได้โดยไม่ต้องรอให้คนพิมพ์สั่ง
ในบทความนี้ Trigger หมายถึงเหตุการณ์ต่างๆ ที่เกิดขึ้นรอบตัว เช่น ข้อความในกลุ่มแชต, อีเมล, การแจ้งเตือนจากปฏิทิน, คอมเมนต์รีวิวโค้ด หรือผลการทดสอบจากระบบตรวจสอบอัตโนมัติอย่าง CI ตัว agent ที่คอยดักฟัง Trigger เหล่านี้จึงเริ่มงานได้เอง โดยไม่ต้องรอให้คนพิมพ์สั่งก่อนทุกครั้งเหมือน agent แบบ session เดียว
แต่เนื่องจากข้อความและเหตุการณ์ส่วนใหญ่ในชีวิตประจำวันไม่ได้ต้องการให้ agent เข้าไปจัดการ ระบบจึงคัดกรองเหตุการณ์ออกเป็น 2 ชั้น โดยชั้นแรกจะใช้โค้ดธรรมดาตรวจสอบว่าเหตุการณ์มาจากไหน กลุ่มใด และอยู่ในรายชื่อที่อนุญาตหรือไม่ ชั้นนี้ทำงานได้รวดเร็วและต้นทุนต่ำ และจะมีเฉพาะเหตุการณ์ที่ผ่านชั้นแรกมาได้เท่านั้นที่จะส่งต่อไปให้โมเดล AI คิดตัดสินใจว่าควรทำอะไรต่อ
Super-agent ทำงานเสร็จเร็วกว่า แต่แลกด้วยการใช้ token มากกว่า
DeepSeek ทดลองเปรียบเทียบ Super-agent กับ agent แบบ session เดียวที่เรียกใช้ subagent ได้ โดยป้อนข้อความจำลองเข้าไปประมาณ 300 ข้อความ ในจำนวนนี้มีคำขอให้ทำงานจริงราว 20 รายการ ส่วนที่เหลือเป็นการพูดคุยทั่วไป คำถามต่อเนื่อง คำขอยกเลิก และข้อความจากระบบ CI แต่ละรูปแบบรันซ้ำทั้งหมด 5 รอบ
ฝั่ง session เดียวทดลองพรอมต์ 2 แบบ คือพรอมต์แบบทั่วไปที่บอกแค่ให้ใช้ subagent เมื่อเหมาะสม กับพรอมต์ที่บอกชัดเจนว่าให้ส่งงานแต่ละชิ้นให้ subagent เป็นหลัก แล้วทำเองเฉพาะงานเล็กๆ
ตัวเลขเวลาในตารางมี 2 ค่า คือค่ากลาง และค่า p95 ซึ่งหมายถึงเวลาที่งาน 95 ใน 100 ชิ้นทำเสร็จภายในนั้น ตัวเลข p95 จึงช่วยบอกว่างานในกลุ่มที่ช้าที่สุดนั้นช้าแค่ไหน ส่วนคอลัมน์สุดท้ายคือจำนวน token หรือหน่วยนับปริมาณข้อมูลที่ AI ประมวลผล โดยนับเฉพาะส่วนที่ระบบอ่านซ้ำจากแคช หรือ cache-read tokens ต่อการรันหนึ่งรอบ
| ดีไซน์ | เวลาที่งานเสร็จ ค่ากลาง / p95 (นาที) | cache-read token ต่อรอบ |
|---|---|---|
| Super-agent | 12.4 / 15.7 | 23.2M |
| session เดียว + subagent (พรอมต์แบบทั่วไป) | 20.4 / 29.5 | 6.1M |
| session เดียว + subagent (พรอมต์สั่งให้แบ่งงาน) | 13.8 / 29.0 | 10.8M |
ผลการทดลองพบว่า Super-agent ทำงานเสร็จเร็วกว่าและคุมเวลาได้นิ่งกว่าอย่างเห็นได้ชัด โดยค่า p95 อยู่ที่ 15.7 นาที ขณะที่อีกสองแบบลากยาวไปถึงเกือบ 30 นาที
สาเหตุหลักอยู่ที่ว่าโมเดลเลือกแบ่งงานหรือไม่ กับพรอมต์แบบทั่วไป โมเดลไม่เรียก subagent เลยสักครั้งตลอดการรัน 5 รอบ งานทั้งหมดจึงไปรันใน session หลักและโดนข้อความใหม่ๆ แทรกเข้ามาขัดจังหวะตลอดเวลา ส่วนพรอมต์ที่สั่งให้แบ่งงาน โมเดลแบ่งงานจริง 4 ใน 5 รอบ ค่ากลางจึงลดลงมาใกล้เคียงกับ Super-agent แต่อีกหนึ่งรอบที่เหลือ โมเดลตัดสินว่างานนั้นเป็นงาน "เล็ก" จึงทำเอง ทำให้ค่า p95 ยังคงสูงอยู่
สิ่งที่ต้องแลกคือปริมาณ token เพราะ Super-agent ใช้ cache-read tokens สูงถึง 23.2 ล้านต่อรอบ เทียบกับ 6.1 ล้าน และ 10.8 ล้านในอีกสองแบบ เนื่องจากต้องคอยจัดการหลาย session แยกจากกัน ทางทีม DeepSeek จึงระบุตรงๆ ว่า นี่คือการนำ token มาแลกกับเวลาการทำงานที่สั้นลงและคาดเดาได้แน่นอนกว่า
จุดนี้ขึ้นอยู่กับการตัดสินใจของผู้ใช้ หากงานไม่ได้เร่งด่วนและมีงบ token จำกัด แบบ session เดียวก็ประหยัดกว่า แต่ถ้าคนในทีมกำลังรองานเพื่อนำไปทำต่อ เวลาที่แน่นอนและเร็วกว่าก็อาจคุ้มค่ากว่า
อย่างไรก็ตาม ก่อนจะนำตัวเลขนี้ไปอ้างอิง ต้องเข้าใจก่อนว่าการทดลองนี้วัดจากอะไร DeepSeek ทดสอบบนชุดงานจำลอง โดยงานเขียนโค้ดในการทดลองจำลองขึ้นด้วยเครื่องมือที่ตั้งหน่วงเวลาไว้เฉยๆ ผลลัพธ์นี้จึงสะท้อนเพียงความสามารถในการจัดคิวและประสานงานของระบบ ไม่ได้วัดว่าโมเดลเขียนโค้ดเก่งแค่ไหน และทาง DeepSeek เองก็กำกับไว้ชัดเจนว่า ผลการทดลองนี้มีไว้เพื่อดูแนวโน้มเท่านั้น
ให้ coding agent พาติดตั้ง dsh-superagent ทีละขั้นตอน
README บอกไว้ตรงๆ ว่าการติดตั้งมีหลายขั้นตอน จึงแนะนำให้ใช้ coding agent ช่วยทำไปพร้อมกับเรา โดยก่อนเริ่ม เครื่องของเราต้องมีโปรแกรมตามที่ SETUP.md กำหนดไว้ให้พร้อม:
- Node.js เวอร์ชัน 22.19 ขึ้นไป หรือ 24 ขึ้นไป
- pnpm
- git เวอร์ชัน 2.32 ขึ้นไป
- tmux
- Python เวอร์ชัน 3.8 ขึ้นไป
- GitHub CLI เวอร์ชัน 2.48 ขึ้นไป
- DeepSeek Harness ในช่วงเวอร์ชันที่
package.jsonกำหนด พร้อมผู้ให้บริการโมเดล
ถ้าเครื่องเราขาดโปรแกรมตัวไหน agent จะเพิ่มขั้นตอนติดตั้งเข้าไปในแผนให้ ส่วนใครที่ยังไม่เคยรัน DeepSeek Harness คู่กับโมเดลใดๆ มาก่อน จะต้องตั้งค่าโมเดลด้วยตัวเอง
เริ่มต้นด้วยการโคลนรีโปลงเครื่อง แล้วเปิด coding agent ขึ้นมาในโฟลเดอร์นั้น:
git clone https://github.com/deepseek-ai/dsh-superagent-prototype
cd dsh-superagent-prototype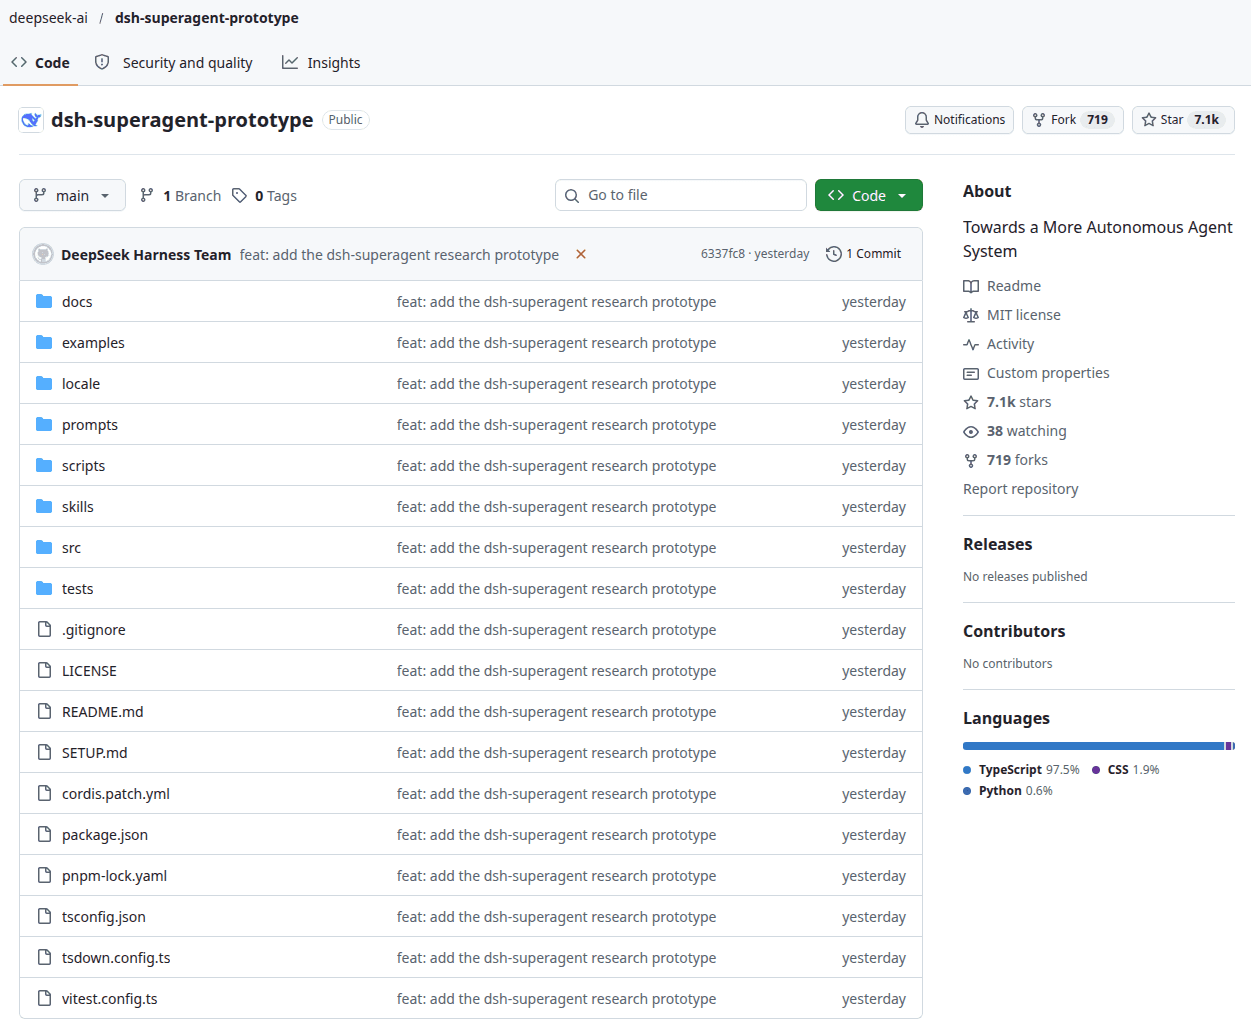
จากนั้นพิมพ์ข้อความนี้ส่งให้ agent ตามที่ README แนะนำ:
Read SETUP.md in this repository and set up dsh-superagent with me.คำสั่งนี้จะให้ agent อ่านไฟล์ SETUP.md แล้วพาเราตั้งค่า dsh-superagent ไปทีละขั้นตอน โดยมันจะถามทีละคำถาม แต่ละข้อจะมีคำตอบที่แนะนำพร้อมเหตุผลสั้นๆ กำกับไว้ ระหว่างที่ถาม agent จะยังไม่ลงมือทำอะไร จนกระทั่งได้คำตอบครบทั้งหมด มันจะสรุปแผนงานฉบับเต็มมาให้เราตรวจดูรอบเดียวก่อน เมื่อเรายืนยันแล้ว agent จึงจะเริ่มลงมือติดตั้งจริง
คำตอบที่ SETUP.md แนะนำมีจุดสำคัญที่ควรรู้ ดังนี้:
- บัญชี GitHub ของ agent: แนะนำให้ใช้บัญชีแยกต่างหาก ไม่ควรใช้บัญชีส่วนตัวของเรา เพราะทุกอย่างที่ agent เขียนจะขึ้นในชื่อบัญชีนี้ (ขั้นตอนนี้เราต้องเป็นคนสมัครบัญชีใหม่เอง)
- ใครสั่งงานได้บ้าง: ในช่วงแรกควรเปิดให้สั่งงานได้เฉพาะบัญชีของเราคนเดียวก่อน
- ระบบรวมโค้ดอัตโนมัติ หรือ auto-merge: แนะนำให้ปิดไว้ก่อน เพื่อให้คนตรวจและกดรวมโค้ดเอง จนกว่า Pull Request ของ agent จะออกมาถูกต้องสม่ำเสมอ
- แหล่งรับงาน: ให้เลือกเฉพาะ GitHub ก่อน เว้นแต่ทีมจะทำงานบนแอปแชตสำหรับองค์กรอย่าง Feishu
การเลือกใช้บัญชีแยกเป็นจุดที่ต้องคิดก่อนตอบ หากใช้บัญชีของตัวเองก็ไม่ต้องเสียเวลาสมัครใหม่ แต่ทุกคอมเมนต์และ Pull Request จะขึ้นเป็นชื่อเราทั้งหมด ส่วนการใช้บัญชีแยก แม้จะเสียเวลาสร้างเพิ่ม แต่จะช่วยให้คนในทีมมองเห็นได้ชัดเจนทันทีว่า งานไหนเป็นของ agent
ส่วนค่าคอนฟิกอื่นๆ ที่มีค่าเริ่มต้นเหมาะสมอยู่แล้ว agent จะไม่ถามให้เสียเวลา แต่จะสรุปไว้ในแผนงานให้เห็น โดยค่าสำคัญที่สุดคือโหมดรับงานเริ่มต้นจะเป็น observe ซึ่งจะทำหน้าที่เพียงจดบันทึกงานเชิงรุกที่ agent คิดจะทำเองโดยไม่มีใครสั่งไว้เท่านั้น โดยไม่ลงมือแก้จริง และอีกค่าคือชื่อ branch ของ agent จะขึ้นต้นด้วย agent/ เสมอ
ด้านความปลอดภัย เราไม่ต้องพิมพ์รหัสลับใดๆ ลงในแชตเลย เพราะ SETUP.md มีกฎห้าม agent ขอรหัสลับในแชตเด็ดขาด ขั้นตอนไหนที่ต้องทำเอง เช่น การสร้างบัญชีหรือล็อกอินผ่านเครื่องมือ CLI ตัว agent จะสรุปคำสั่งมาให้เรานำไปรันในหน้าต่างคำสั่งหรือ terminal ของเครื่องตัวเอง
เมื่อติดตั้งเสร็จ agent จะส่ง URL ของหน้าเว็บ Panel มาให้ จากนั้นเปิดเข้าไปดูที่เมนู Superagent ในแถบด้านข้าง แล้วใช้บัญชี GitHub ที่มีสิทธิ์ คอมเมนต์ @<agent login> <request> ใน Issue ของรีโปนั้น แล้วรอดู Ticket งานชิ้นแรกขึ้นมาในหน้าภาพรวมได้เลย
สิ่งที่ต้องรู้ก่อนเปิดให้ทั้งทีมเริ่มแท็กสั่งงาน
ก่อนจะขยายวงเปิดให้ทั้งทีมเข้ามาแท็กสั่งงาน มีข้อจำกัดสำคัญของโปรเจกต์ต้นแบบนี้ที่ควรรู้ไว้ก่อน:
- ยังเป็นโค้ดเพื่อการวิจัย ไม่พร้อมใช้งานจริงเต็มรูปแบบระดับ Production: README ระบุไว้ชัดเจนว่าโค้ดอาจยังมีบั๊ก สไตล์การเขียนโค้ดยังไม่สม่ำเสมอ และควรนำไปรีวิวปรับแต่งก่อนใช้งานจริง โค้ดชุดนี้ดัดแปลงมาเพื่อเผยแพร่ จึงไม่เหมือนกับเวอร์ชันที่ DeepSeek ใช้งานอยู่ภายในบริษัท
- เนื้อหาในบทความไปไกลกว่าตัวต้นแบบจริง: บทความเล่าว่า agent สามารถเฝ้าดูแชตสาธารณะ สืบหาต้นตอของปัญหา แล้วเปิด Pull Request แก้ไขเองได้แม้ไม่มีใครแท็กสั่ง แต่ระบบนั้นเป็นระบบภายในของ DeepSeek และ README ก็ระบุว่าดีไซน์บางอย่างเป็นเพียงทิศทางในอนาคตที่ต้นแบบนี้ยังไม่ได้ทำ ในโค้ดต้นแบบ งานที่ไม่มีคนสั่งจะตั้งไว้ในโหมด
observeซึ่งทำได้แค่จดบันทึก และถ้าเชื่อมต่อกับ Feishu ตัวบอตก็จะอ่านเฉพาะข้อความที่แท็กถึงมันเท่านั้น - รับงานในตัวได้จาก GitHub และ Feishu เท่านั้น: ไม่มี Slack, LINE หรือ Discord มาให้ หากทีมใช้ช่องทางอื่น เอกสารบท 008 Cookbook ว่าด้วยการเพิ่มช่องทางรับงานหรือ Source เอง
- ทุกข้อความขึ้นในชื่อบัญชีที่ทีมเห็นทุกวัน: ทั้งการคอมเมนต์ การเปิด Pull Request และการส่งข้อความหาเพื่อนร่วมทีม ล้วนใช้เวลาและความสนใจของคนอื่นทั้งสิ้น คนที่ตั้งค่าและดูแล agent จึงต้องพร้อมรับผิดชอบต่อสิ่งที่มันทำเสมอ
ด้วยเหตุนี้ เอกสาร docs/000-philosophy.md จึงกำหนดกฎ 3 ข้อสำหรับผู้ดูแล agent ไว้ดังนี้:
- เริ่มจากวงแคบก่อน: เริ่มจากรายชื่อคนสั่งงานเพียงไม่กี่คน และปล่อยให้งานเชิงรุกอยู่ในโหมดจดบันทึกไปก่อน เมื่อเห็นว่าสิ่งที่มันตั้งใจจะทำนั้นถูกต้อง จึงค่อยขยายขอบเขตการทำงาน
- ปรับแต่งเพื่อลดการรบกวน: หากพบว่า agent ส่งข้อความบ่อยเกินไป ให้ปรับพรอมต์ให้สั้นและเข้มงวดขึ้น หรือสั่งหยุดการทำงานไว้ชั่วคราว อย่าแก้ปัญหาด้วยการเพิ่มข้อความมาอธิบายว่าทำไมมันถึงส่งข้อความเยอะ
- รับผิดชอบทุกสิ่งที่ agent สื่อสาร: ควรอ่านทุกข้อความที่ agent โพสต์ในนามของเราอย่างสม่ำเสมอ หากมีสิ่งใดผิดพลาด ให้เข้าไปแก้ไขที่ตัวพรอมต์ทันที
นอกจากนี้ เอกสารยังห้ามใช้ agent ปั๊มปริมาณงาน เช่น สั่งเปิด Pull Request จำนวนมากๆ พร้อมกัน หรือส่งข้อความกระจายไปหาคนทั้งทีม เพราะผลเสียที่ทีมต้องแบกรับจะมากกว่าประโยชน์ที่ได้
ใครที่ควรติดตั้งใช้งานวันนี้ และใครที่ควรยืมแค่หลักคิดไปใช้ก่อน
หากคุณหรือทีมทำงานบน GitHub เป็นประจำอยู่แล้ว และอยากลองให้ AI agent เข้ามารับงานจาก Issue ไปทำเองจนเสร็จ dsh-superagent ก็เป็นโปรเจกต์ที่น่าลอง โดยแนะนำให้เริ่มทดลองกับรีโปเล็กๆ ที่ต่อให้มีข้อผิดพลาดขึ้นมาก็ไม่เสียหายร้ายแรง และควรตั้งค่าตามที่ SETUP.md แนะนำทุกข้อ
แต่ถ้ายังเป็นมือใหม่ ก็ยังไม่จำเป็นต้องรีบติดตั้ง สิ่งที่สามารถหยิบไปใช้กับงานได้ทันทีก็คือ หลักการใช้ความสนใจของคนให้น้อยที่สุด โดยลองนำข้อความชุดนี้ไปเพิ่มลงในพรอมต์ของ AI agent ที่คุณใช้อยู่เป็นประจำ:
ถามฉันทีละคำถาม ยืนยันรับงานครั้งเดียวแล้วทำไปเงียบๆ
รายงานกลับเฉพาะตอนงานเสร็จ ตอนต้องให้ฉันตัดสินใจ หรือตอนทำต่อไม่ได้สิ่งที่ DeepSeek เปิดออกมาในครั้งนี้ จึงไม่ได้มีเพียงแค่ชุดโค้ดต้นแบบเท่านั้น แต่ยังมีคำถามสำคัญที่เราควรถาม AI agent ทุกตัวก่อนเริ่มใช้งานว่า "มันรู้ตัวไหมว่าเวลาไหนควรเงียบ"
ที่มา:
- โปรเจกต์ dsh-superagent-prototype บน GitHub
- เอกสารทางการของ dsh-superagent · SETUP.md
- เอกสารทางการของ dsh-superagent · docs/000-philosophy.md
- บทความ Exploring Super-agent Design: Towards a More Autonomous Agent System จาก DeepSeek Harness
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
สร้าง Claude Skill แบบไม่ต้องรู้โค้ด คู่มือสร้าง Claude Skill ของคุณเองด้วยการคุยกับ Claude Code เป็นภาษาไทย
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ