Grok TTS ขึ้นนำบน Humanness Index ของ Vapi · เสียง AI ที่ได้ 96 เมื่อเสียงคนจริงอยู่ที่ 100
Grok TTS คือโมเดลเสียงพูดตัวใหม่ของ xAI ที่ขึ้นนำโมเดล AI ทั้งหมดบน Humanness Index ของ Vapi ด้วยคะแนน 96 จุดที่น่าสนใจไม่ใช่ตัวเลข แต่เป็นวิธีวัด · ใช้การเทียบเสียงแบบปิดป้าย โดยมีเสียงคนจริงเป็นจุดอ้างอิง แล้วให้คนฟังเลือกว่าเสียงไหนเหมือนคนมากกว่า

Grok TTS คือโมเดลแปลงข้อความเป็นเสียงพูด (text-to-speech) ตัวใหม่ของ xAI บริษัท AI ของ Elon Musk ผู้พัฒนาแชตบอต Grok โดยล่าสุดสามารถทำคะแนนขึ้นนำโมเดลเสียง AI ทุกตัวบนกระดาน Humanness Index ด้วยคะแนน 96 จากคะแนนเต็ม 100 ของเสียงมนุษย์จริง ซึ่งห่างกันเพียง 4 คะแนนเท่านั้น
Humanness Index เป็นการทดสอบโดย Vapi แพลตฟอร์มสำหรับสร้าง voice agent และผู้ช่วยเสียงอัตโนมัติ โดยมีเป้าหมายเพื่อวัดว่าเสียง AI ตัวไหน "ฟังดูเป็นธรรมชาติเหมือนมนุษย์จริง" มากที่สุด ไม่ใช่แค่วัดความชัดเจนของคำ จุดที่น่าสนใจจึงไม่ใช่แค่ตัวเลข 96 แต่เป็นกระบวนการทดสอบเบื้องหลัง เพราะผลคะแนนนี้ไม่ได้มาจากเดโมที่คัดสรรมาอย่างดี แต่เกิดจากผู้ฟังจริงจำนวนมากที่ร่วมโหวตแบบไม่รู้ล่วงหน้าว่ากำลังฟังเสียงของค่ายใด
ฟังสองเสียง แล้วเลือกว่าอันไหนเหมือนคนมากกว่า
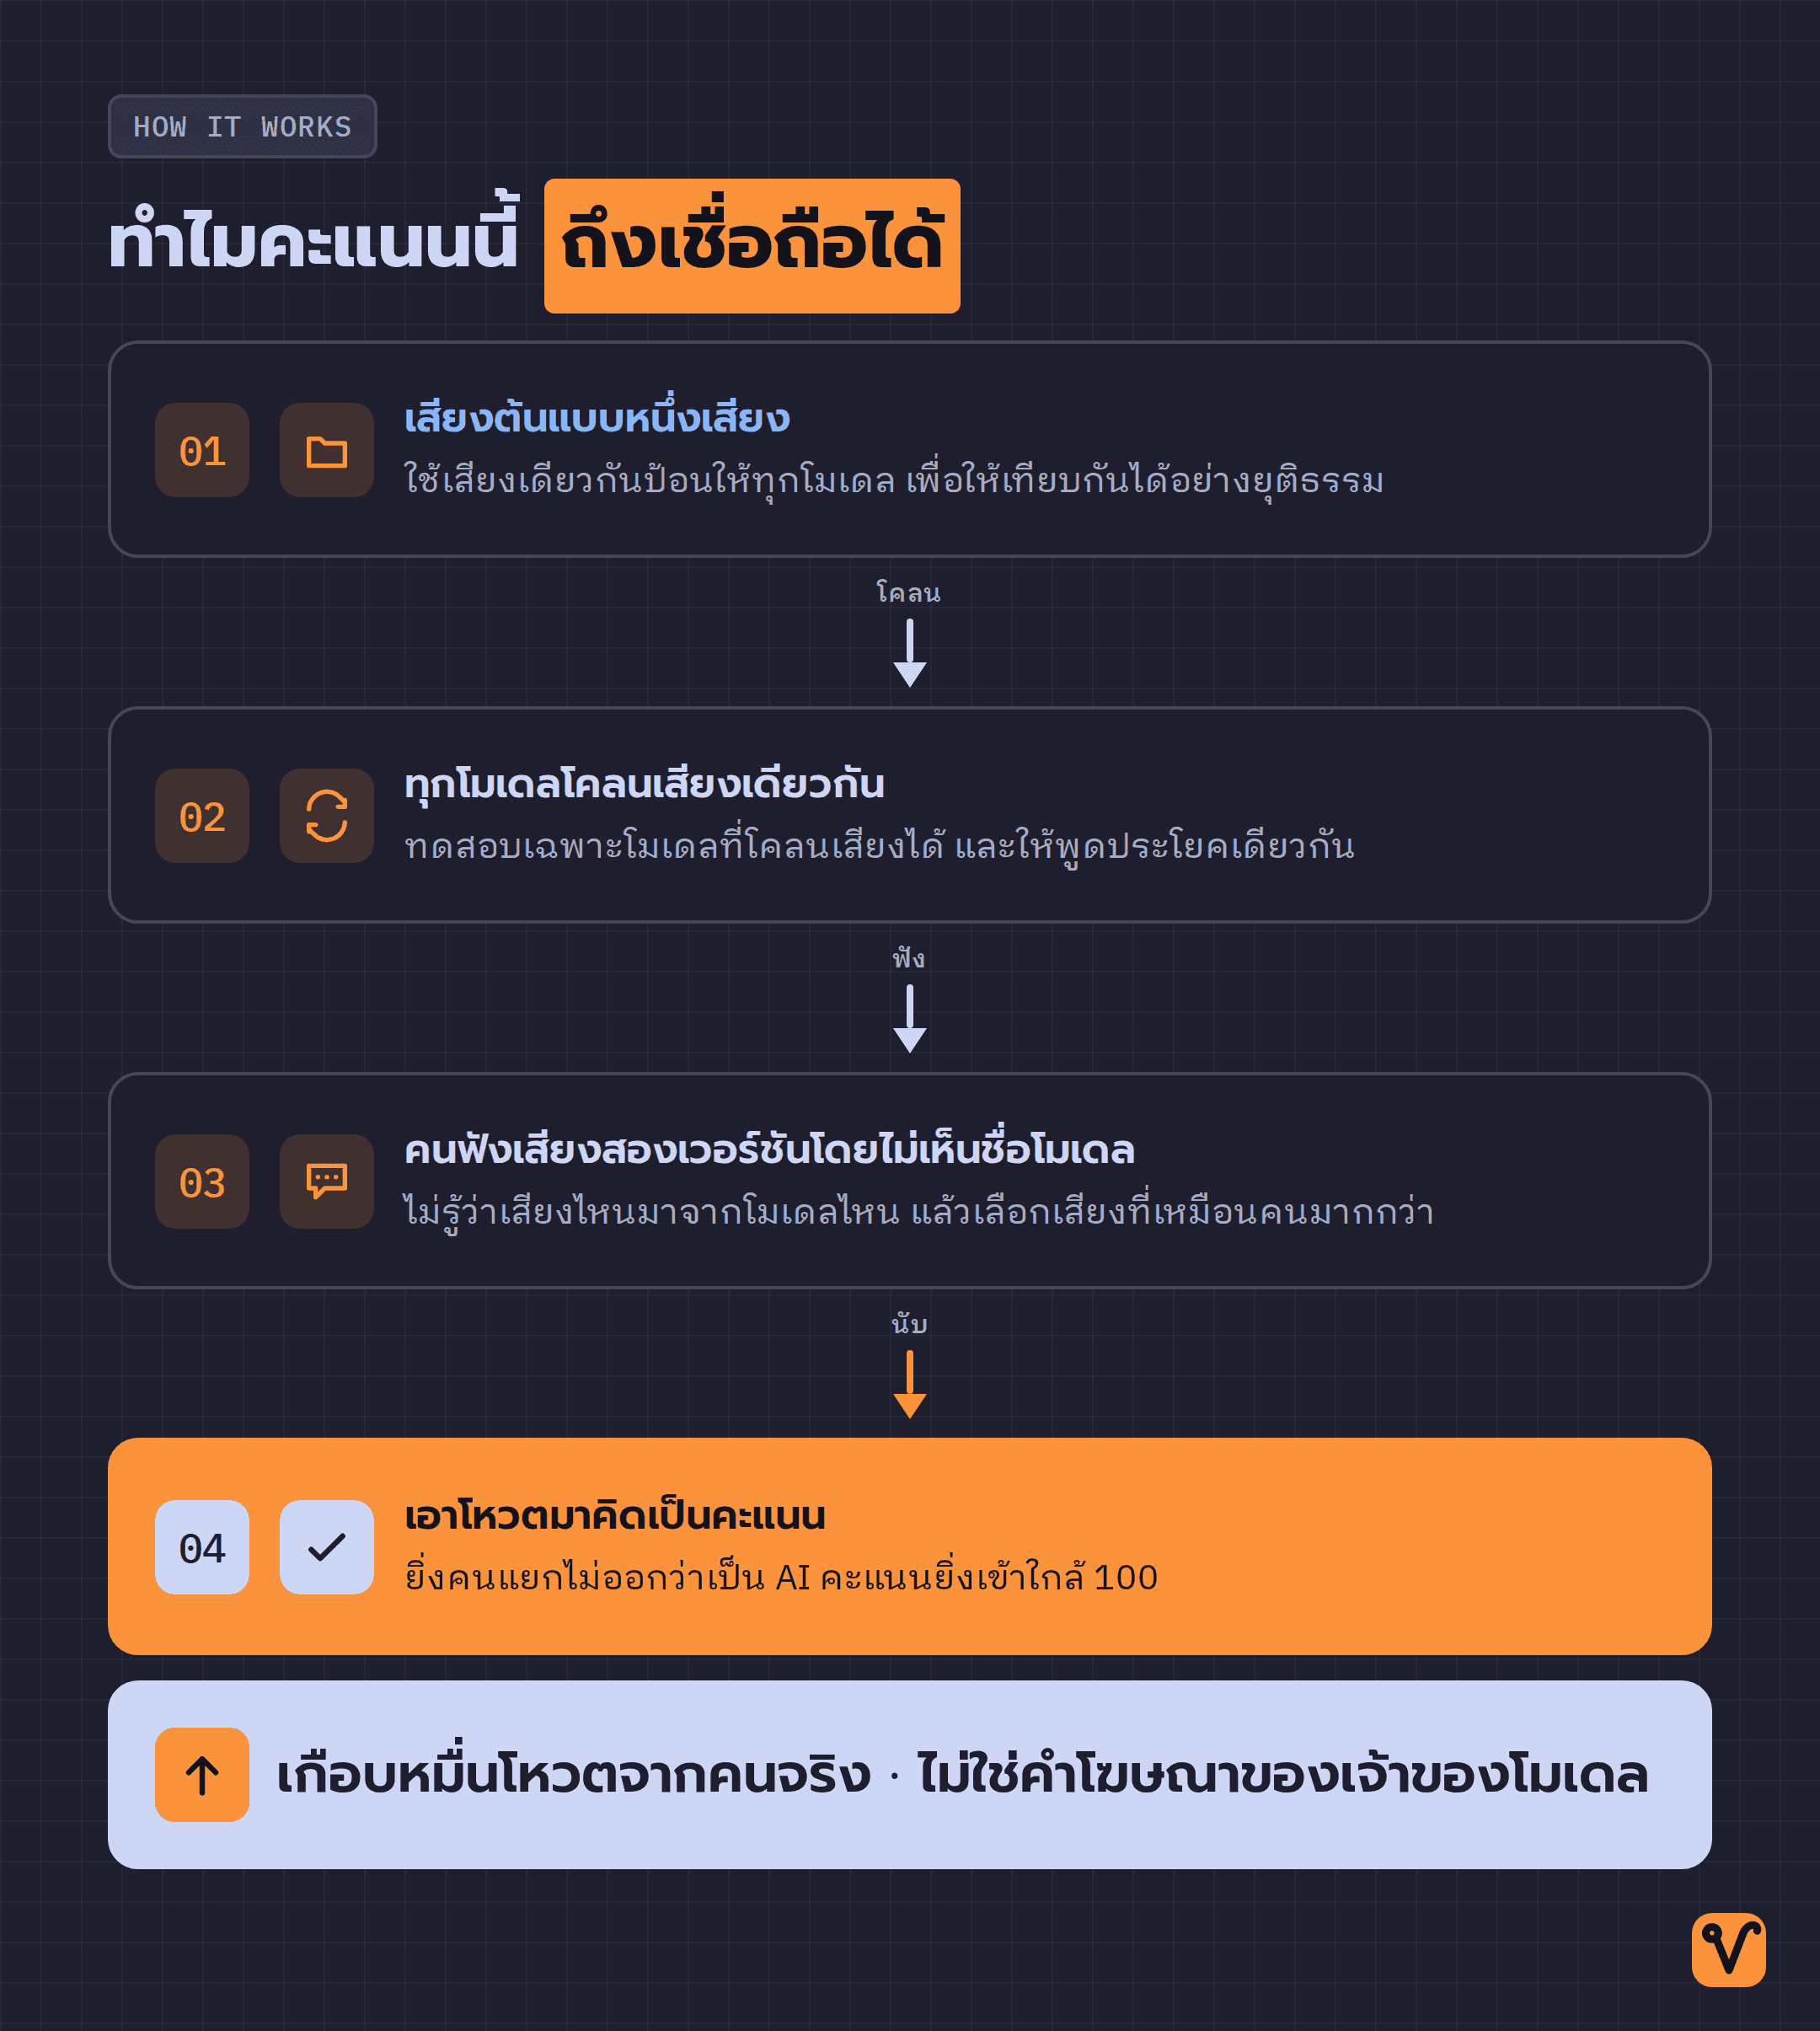
หัวใจของการจัดอันดับบน Humanness Index คือการทดสอบแบบปิดป้ายชื่อ (blind test) ทาง Vapi นำไฟล์เสียงต้นแบบเดียวกันไปโคลนด้วยทุกโมเดลที่เข้าร่วมทดสอบ จากนั้นเปิดให้ผู้ฟังได้ยิน 2 เวอร์ชันที่พูดประโยคเดียวกัน โดยไม่เปิดเผยชื่อโมเดล แล้วให้ผู้ฟังเลือกว่าเสียงใดมีความเป็นธรรมชาติเหมือนมนุษย์มากกว่ากัน
การใช้เสียงต้นแบบเดียวกันทำให้การเปรียบเทียบมีความยุติธรรม ผู้ฟังไม่ได้ตัดสินว่าเสียงไหนไพเราะกว่า แต่ตัดสินว่าโมเดลใดสังเคราะห์เสียงออกมาได้สมจริงกว่า Vapi กำหนดให้เสียงมนุษย์จริงอยู่ที่ระดับ 100 คะแนน ยิ่งโมเดลใดทำคะแนนเข้าใกล้ 100 มากขึ้น ก็หมายความว่าผู้ฟังเริ่มแยกไม่ออกว่ากำลังฟังเสียงของ AI
สิ่งที่การทดสอบนี้ตรวจจับได้ ไม่ใช่เพียงความชัดของถ้อยคำ แต่รวมถึง 3 ปัจจัยสำคัญที่ทำให้เสียงเหมือนมนุษย์จริง ได้แก่ การเน้นจังหวะอารมณ์ของคำ น้ำเสียงสูงต่ำตามธรรมชาติของการพูด และเสียงแทรกเล็กๆ ที่เกิดขึ้นโดยธรรมชาติ เช่น เสียงจังหวะการหายใจ ซึ่งเป็นจุดที่ระบบสังเคราะห์เสียงส่วนใหญ่ยังทำได้ไม่แนบเนียน
ความหมายของคะแนน 96 บนกระดานเปรียบเทียบ
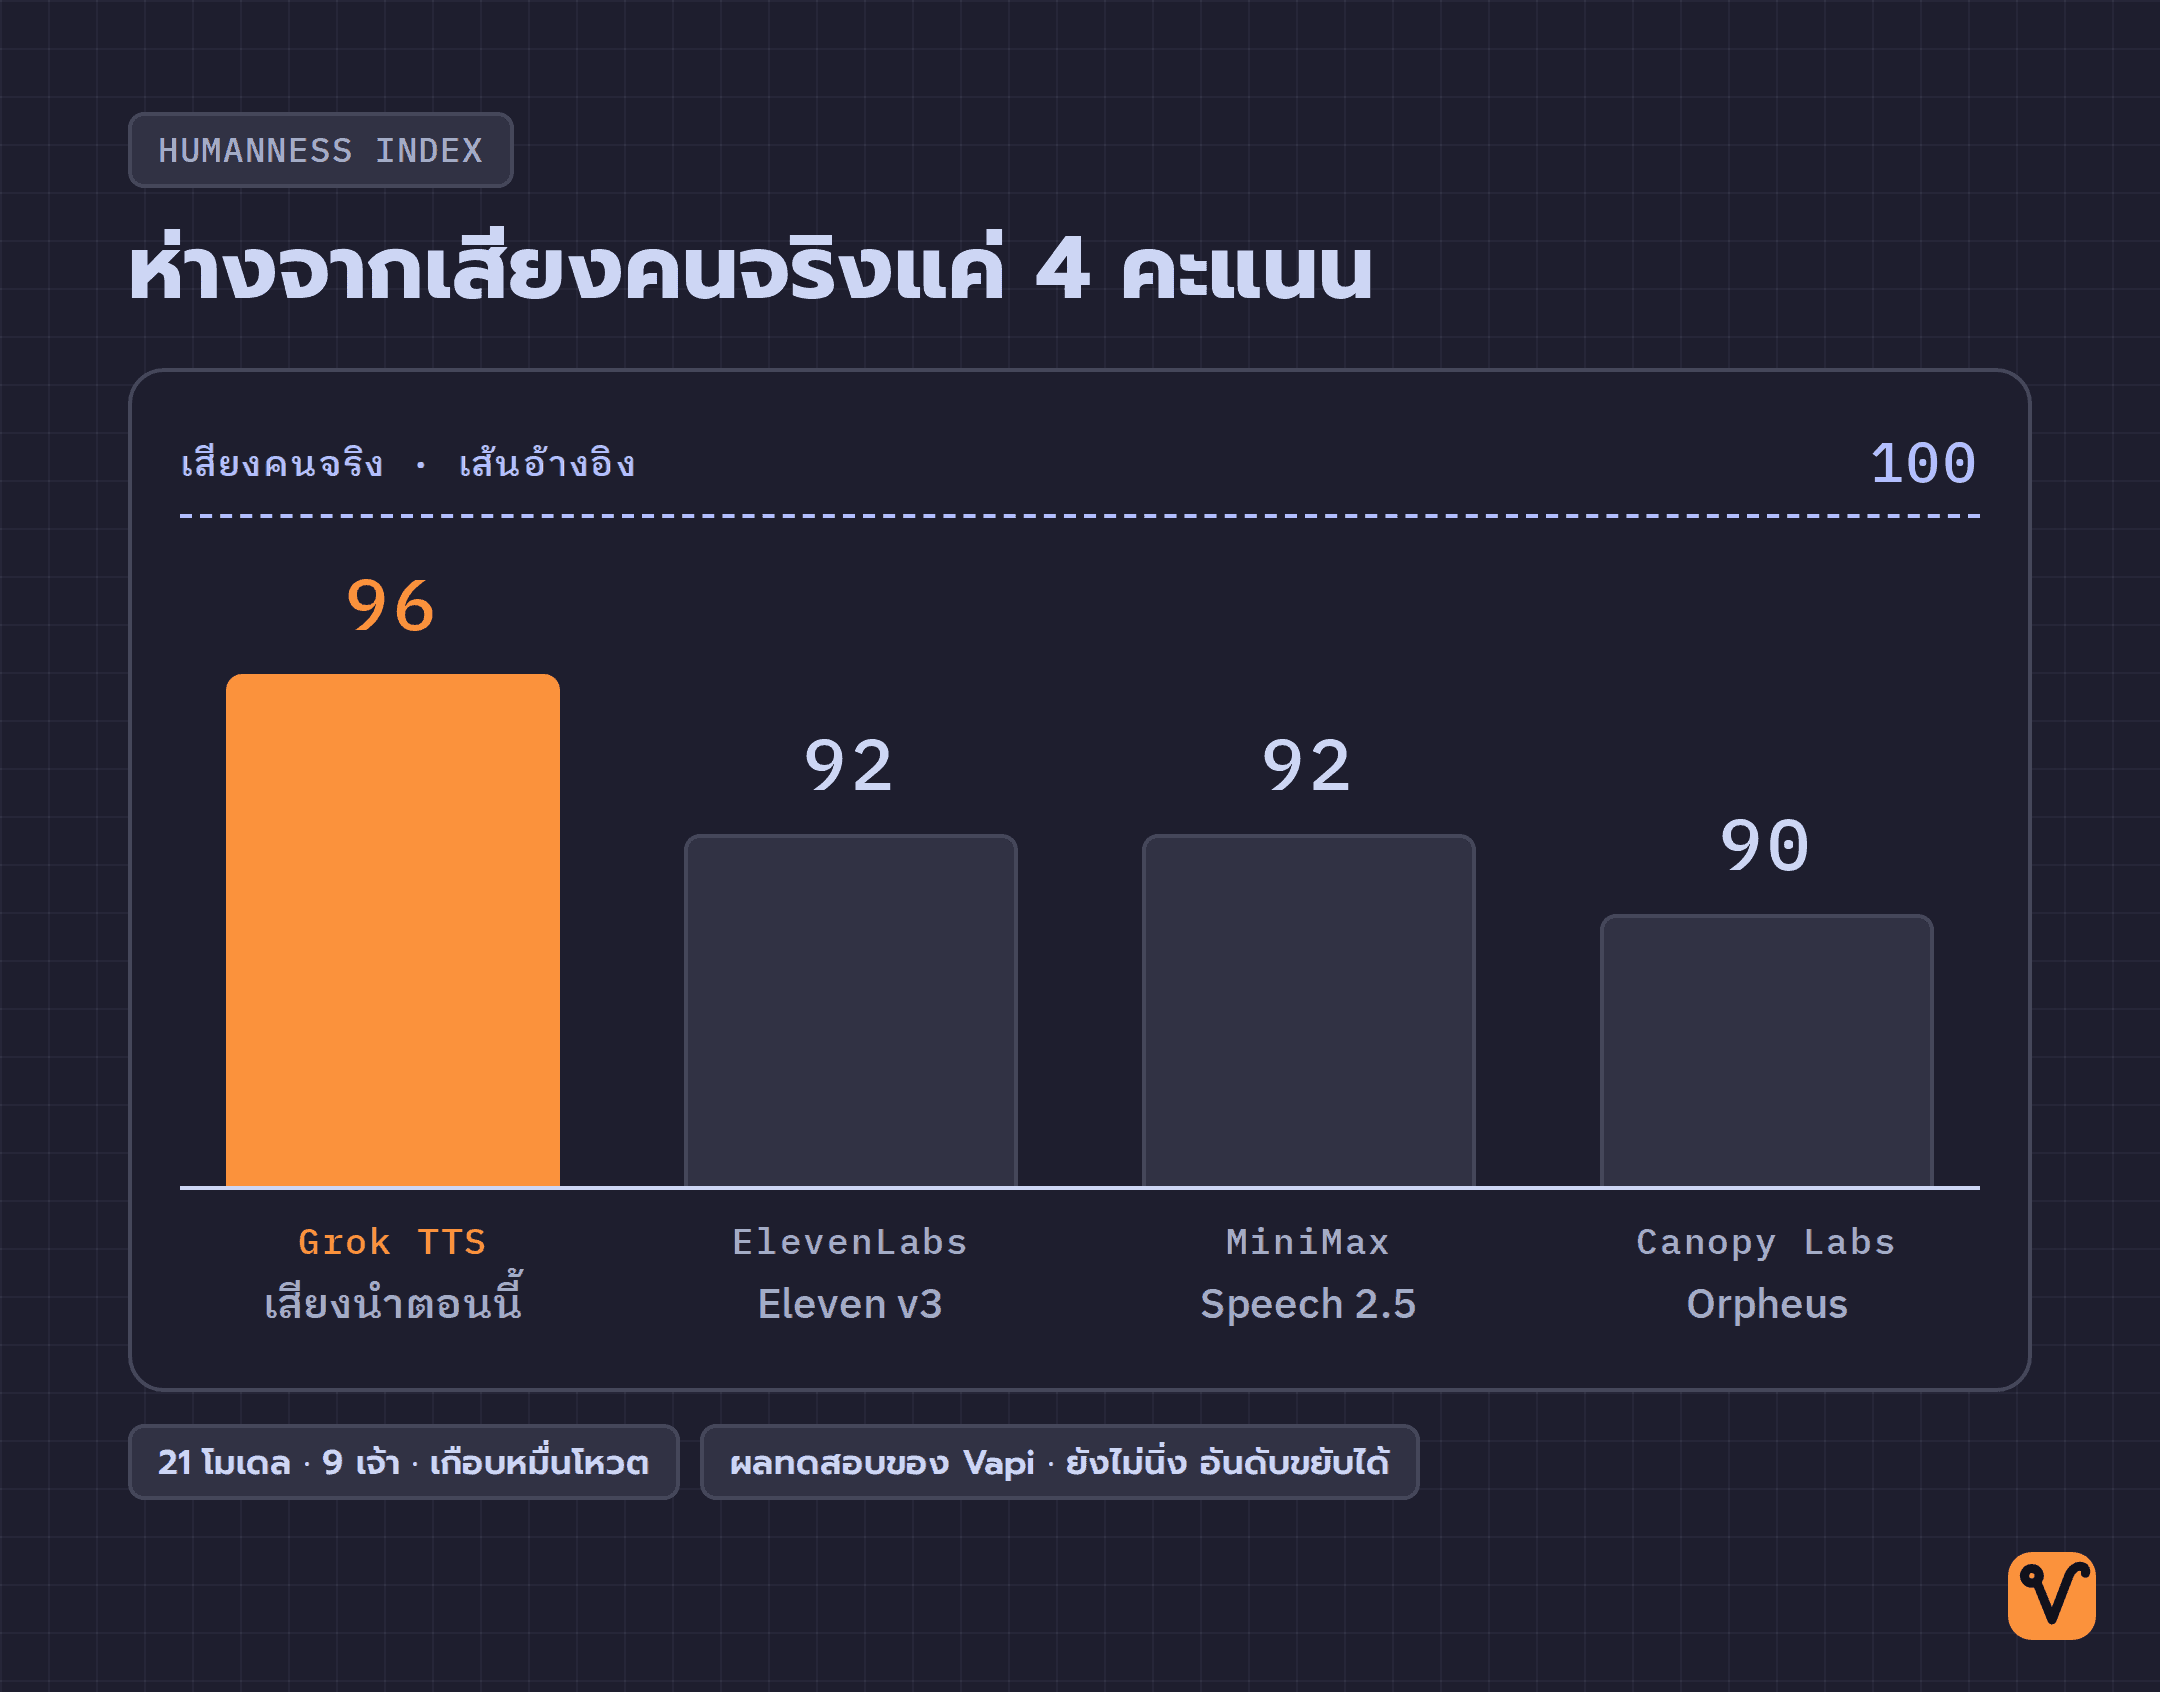
การทดสอบรอบนี้มีโมเดลเข้าร่วมทั้งหมด 21 โมเดล จาก 9 ผู้พัฒนา และรวบรวมผลโหวตจากผู้ฟังไปแล้วกว่า 9,150 ครั้ง โดย Grok TTS ทำคะแนนนำเป็นอันดับหนึ่งที่ 96 คะแนน ตามมาด้วย ElevenLabs Eleven v3 และ MiniMax Speech 2.5 ที่ทำคะแนนเสมอกันที่ 92 คะแนน
ส่วนต่างเพียง 4 คะแนนระหว่าง Grok TTS กับเสียงมนุษย์จริง ถือเป็นตัวเลขที่มีนัยสำคัญ เพราะในการทดสอบแบบ blind test ผู้ฟังส่วนใหญ่โหวตให้ Grok TTS มีความเป็นธรรมชาติใกล้เคียงมนุษย์มากที่สุดในบรรดาโมเดล AI ทั้งหมดบนกระดาน
| โมเดล | คะแนนความเป็นมนุษย์ |
|---|---|
| เสียงคนจริง (เกณฑ์อ้างอิง) | 100 |
| Grok TTS | 96 |
| ElevenLabs Eleven v3 | 92 |
| MiniMax Speech 2.5 | 92 |
| Canopy Labs Orpheus | 90 |
นอกจากนี้ xAI ยังมีอีกหนึ่งโมเดลบนตารางคือ Grok TTS Streaming ซึ่งทำได้ 88 คะแนน เวอร์ชันนี้ถูกออกแบบมาเพื่อการสตรีมเสียงแบบเรียลไทม์ระหว่างการสนทนา จึงเหมาะกับงานที่ต้องการการโต้ตอบที่รวดเร็ว ส่วน Grok TTS ตัวหลักที่ได้ 96 คะแนนจะเน้นคุณภาพความสมจริงของเสียงระดับสูงสุด
การนำไปประยุกต์ใช้งานจริง
สิ่งที่ทำให้ผลการทดสอบนี้น่าจับตามองในทางปฏิบัติ คือการที่ Vapi ได้เลือก Grok ให้เป็นระบบสร้างเสียงหลักสำหรับ 12 เสียงมาตรฐานบนแพลตฟอร์ม ซึ่งรองรับ voice agent กว่า 2.5 ล้านตัวที่รันอยู่บน Vapi ในปัจจุบัน
สำหรับผู้ที่มี agent บน Vapi อยู่แล้ว สามารถสลับมาใช้เสียงของ Grok ได้ทันที โดยเข้าไปที่ Vapi Dashboard แล้วเลือก Grok ในเมนู TTS ใต้แถบการตั้งค่าเสียง ซึ่งปัจจุบันระบบรองรับทั้ง Grok Speech-to-Text และ Text-to-Speech ครบวงจร
ส่วนทีมพัฒนาที่ต้องการเชื่อมต่อเข้ากับระบบของตนเองโดยตรง xAI ได้เปิดให้บริการ Voice API ที่รองรับทั้งเสียงมาตรฐาน การปรับแต่งขั้นสูง และการทำ voice cloning งานที่เหมาะกับการนำไปปรับใช้ ได้แก่ การพากย์เสียงบรรยาย รายการพอดแคสต์ สื่อโฆษณา และเสียงประกอบในแอปพลิเคชัน ซึ่งเดิมทีมักเจอปัญหาเสียงสังเคราะห์ที่ฟังดูแข็งทื่อ
ข้อควรพิจารณาและมุมมองรอบด้าน
แม้คะแนน 96 จะเป็นตัวเลขที่น่าประทับใจ แต่ยังมี 2 ประเด็นสำคัญที่ควรทำความเข้าใจเพิ่มเติม
ประเด็นแรก Humanness Index เป็นการทดสอบที่จัดทำขึ้นโดย Vapi ซึ่งเพิ่งประกาศเลือก Grok เป็นพาร์ทเนอร์หลักด้านเสียง ข้อมูลบริบทนี้จึงเป็นสิ่งที่ควรทราบไว้ ผลการทดสอบนี้ถือเป็นข้อมูลอ้างอิงที่มีประโยชน์จากเวทีของ Vapi แม้จะยังไม่ใช่มาตรฐานกลางที่ได้รับการรับรองจากองค์กรสากลก็ตาม
ประเด็นที่สอง คะแนนในปัจจุบันยังคงมีการอัปเดตอย่างต่อเนื่อง เนื่องจากผลโหวตยังคงทยอยเข้ามาเพิ่มเติม อันดับและตัวเลขจึงสามารถเปลี่ยนแปลงได้ตามจำนวนกลุ่มตัวอย่างที่เพิ่มขึ้น
อย่างไรก็ดี สิ่งสำคัญที่สะท้อนจากผลทดสอบนี้ คือวิธีการประเมินที่เปิดให้ผู้ฟังจำนวนหลายพันคนตัดสินจากคุณภาพเสียงจริงโดยไม่ทราบแบรนด์ผู้พัฒนา ซึ่งเป็นข้อมูลเชิงประจักษ์ที่สะท้อนถึงก้าวกระโดดด้านคุณภาพเสียงสังเคราะห์ในปัจจุบัน
เมื่อช่องว่างระหว่างเสียง AI กับเสียงมนุษย์จริงลดลงเหลือเพียงไม่กี่คะแนน คำถามสำคัญในวันนี้จึงอาจไม่ใช่แค่เสียงสังเคราะห์ฟังดูเหมือนคนหรือไม่ แต่เป็นเรื่องของการนำเสียงเหล่านี้ไปออกแบบประสบการณ์ผู้ใช้งานให้เกิดประโยชน์สูงสุดในชีวิตจริง
ที่มา:
- บทความ Grok Becomes Voice of Vapi จาก xAI
- บทความ Humanness Index™: Which TTS Voice Is Most Human? จาก Vapi
- โพสต์ xAI (@xai) on X จาก xAI
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin