AI มองคำว่า 'หมา' กับ 'แมว' ใกล้กันได้ยังไง
AI ไม่เคยลูบขนหมาและไม่เคยได้ยินเสียงเหมียว แต่รู้ว่า 'หมา' กับ 'แมว' อยู่ละแวกเดียวกันบนแผนที่ภาษา หลักการเดียวที่อายุเกือบ 70 ปีนี้คือกระดูกสันหลังของ Spotify Netflix Google และ ChatGPT พร้อมกัน

AI ไม่เคยได้ยินเสียงเห่าและไม่เคยสัมผัสขนนุ่มของสัตว์เลี้ยง แต่กลับเข้าใจได้อย่างแม่นยำว่าคำว่า "หมา" กับ "แมว" มีความหมายใกล้เคียงกันบนแผนที่ภาษา
กลไกทางคณิตศาสตร์นี้คือเบื้องหลังของระบบที่เราใช้งานในชีวิตประจำวัน ไม่ว่าจะเป็น Spotify ที่แนะนำเพลงแนวเดียวกันได้อย่างตรงใจ Netflix ที่คัดเลือกภาพยนตร์ที่น่าจะถูกใจคุณ หรือ Google ที่สามารถค้นพบบทความที่ตอบโจทย์ได้ แม้ในบทความนั้นจะไม่มีคำค้นที่คุณพิมพ์ลงไปเลยสักคำเดียว
เบื้องหลังความสามารถทั้งหมดนี้ มีรากฐานมาจากหลักการทางภาษาศาสตร์ที่มีอายุเกือบ 70 ปี ซึ่งยังคงเป็นกระดูกสันหลังของระบบ AI ยุคปัจจุบัน
1. ปริศนาเบื้องหลังระบบแนะนำที่เราใช้งานทุกวัน
ลองนึกถึงประสบการณ์คุ้นเคย 3 อย่างในชีวิตประจำวัน
- เมื่อคุณเปิดฟังเพลงหนึ่งเพลงใน Spotify ระบบจะเล่นเพลงถัดไปที่มีบรรยากาศคล้ายกันอย่างต่อเนื่อง ทั้งที่ไม่ใช่ศิลปินคนเดียวกันและชื่อเพลงไม่มีความเกี่ยวข้องกันเลย
- เมื่อดูภาพยนตร์จบใน Netflix หน้าแรกจะแสดงรายการภาพยนตร์แนะนำที่มีโทนเรื่องและอารมณ์คล้ายกัน
- เมื่อค้นหาใน Google ด้วยคำว่า "ปวดท้องช่วงบน" ผลลัพธ์อันดับแรกอาจเป็นบทความเรื่อง "gastritis" (โรคกระเพาะอาหารอักเสบ) ทั้งที่ในบทความไม่มีคำว่าปวดท้องปรากฏอยู่เลย
คอมพิวเตอร์ไม่มีประสาทสัมผัสแบบมนุษย์ แล้วมันสามารถตรวจจับ "ความคล้ายคลึง" ของสิ่งเหล่านี้ได้อย่างไร คำตอบคือระบบทั้งหมดแปลงข้อมูลเหล่านั้นให้กลายเป็นตำแหน่งบน "แผนที่ภาษา" หรือสิ่งที่เราเรียกว่า Embedding
2. ทางตันของวิธีคิดแบบเก่า: เมื่อทุกคำอยู่ห่างกันเท่ากันหมด (One-Hot Encoding)
เพื่อให้เห็นภาพว่าทำไม Embedding ถึงเป็นจุดเปลี่ยนสำคัญ เราต้องย้อนดูวิธีคิดดั้งเดิมของวิทยาการคอมพิวเตอร์ก่อน
ในอดีต หากเรามีพจนานุกรม 100,000 คำ วิธีที่คอมพิวเตอร์ใช้แทนความหมายของคำคือการสร้างตารางหรือล็อกเกอร์ยาว 100,000 ช่อง คำว่า "หมา" อาจได้ช่องหมายเลข 4,512 มีการติดธงเลข 1 ไว้ที่ช่องนั้น ส่วนช่องที่เหลืออีก 99,999 ช่องเป็นเลข 0 ทั้งหมด คำว่า "แมว" ได้ช่องหมายเลข 71,894 คำว่า "รถยนต์" ได้ช่องหมายเลข 23,007 และคำว่า "ตู้เย็น" ได้ช่องหมายเลข 89,003
วิธีนี้เรียกว่า One-Hot Encoding
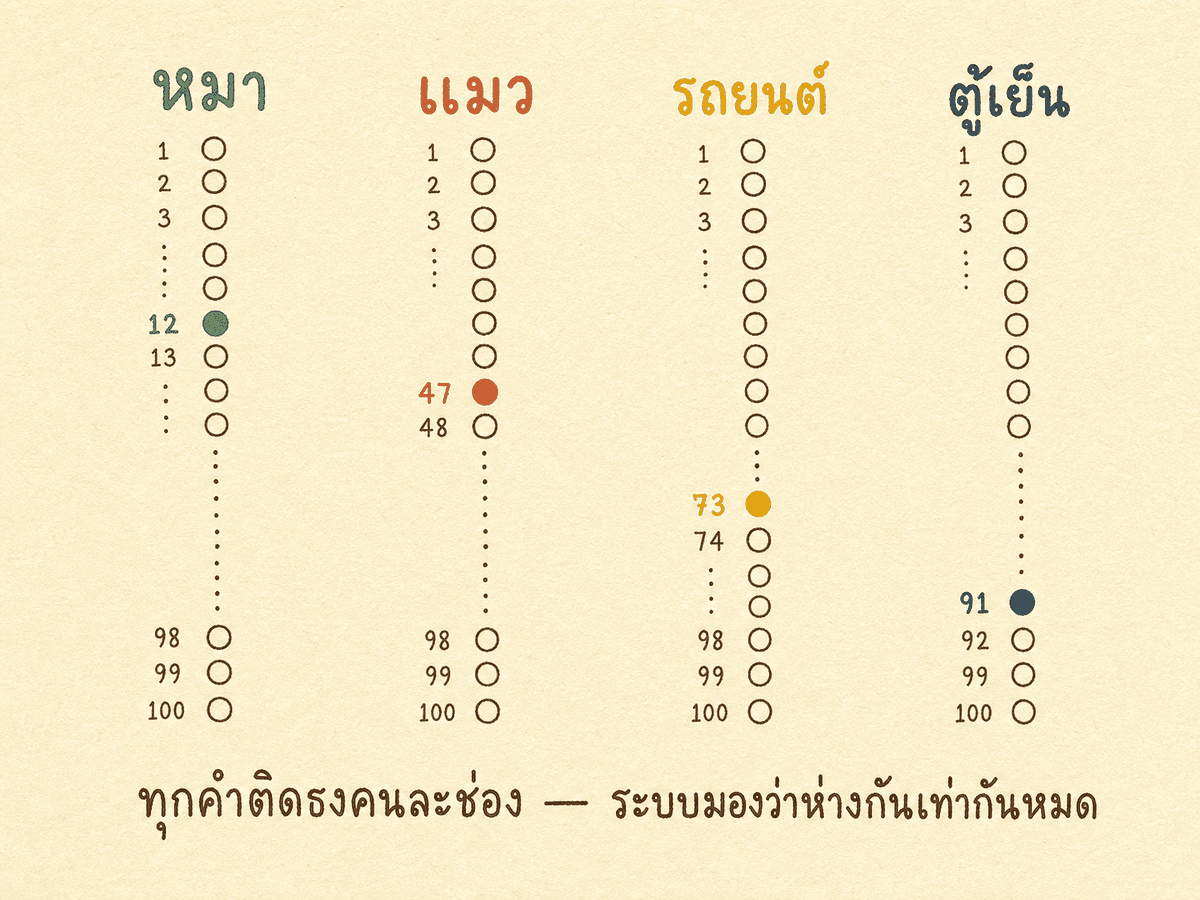
เมื่อคำนวณระยะห่างทางเรขาคณิตระหว่างคำว่า "หมา" กับ "แมว" ผลลัพธ์ที่ได้จะเท่ากับระยะห่างระหว่าง "หมา" กับ "รถยนต์" หรือ "หมา" กับ "ตู้เย็น" เพราะทุกคำต่างเป็นอิสระต่อกันและไม่มีมิติใดเชื่อมโยงกันเลย
นั่นคือเหตุผลที่ระบบค้นหายุคเก่าทำได้เพียงการค้นหาข้อความแบบตรงตัว (Exact Match) หากคุณค้นหาคำว่า "ปวดท้อง" ระบบจะไม่สามารถเจอบทความที่ใช้คำว่า "gastritis" หรือ "อาการเสียดท้อง" ได้เลย เพราะในมุมมองของคอมพิวเตอร์ คำเหล่านี้เป็นคนละคำที่ไม่มีความเกี่ยวข้องกัน นักวิจัยอย่าง Yoshua Bengio และคณะ (2003) เรียกข้อจำกัดนี้ว่าเป็นส่วนหนึ่งของปัญหา Curse of Dimensionality
3. กฎทองที่เปลี่ยนวงการ: ความหมายของคำดูได้จากเพื่อนข้างเคียง
ในปี 1957 นักภาษาศาสตร์ชื่อ J.R. Firth ได้บันทึกประโยคอมตะที่เป็นหัวใจสำคัญของวงการประมวลผลภาษาธรรมชาติ
"You shall know a word by the company it keeps"
ประโยคนี้สรุปหลักการง่ายๆ ว่า "เราจะเข้าใจความหมายของคำหนึ่งคำได้ จากกลุ่มคำที่มักปรากฏอยู่รอบตัวมัน"
Firth ยกตัวอย่างคำว่า "ass" ในภาษาอังกฤษ ซึ่งปกติแปลว่าลา แต่หากปรากฏในประโยคอย่าง "you silly ass" เราจะเข้าใจได้ทันทีว่าหมายถึงคนโง่ ไม่ใช่สัตว์ เพราะมีคำแวดล้อมอย่าง "silly" เป็นตัวกำหนดบริบท
ในภาษาไทยก็เช่นเดียวกัน คำว่า "กิน" มักปรากฏร่วมกับคำว่า "ข้าว" "น้ำ" "ขนม" หรือ "ยา" ส่วนคำว่า "ขับ" มักปรากฏร่วมกับคำว่า "รถ" "มอเตอร์ไซค์" หรือ "เรือ" ต่อให้เป็นผู้ที่ไม่เคยเรียนภาษาไทยมาก่อน หากได้อ่านประโยคภาษาไทยนับล้านประโยค ก็สามารถจัดกลุ่มได้ว่าคำใดมีความหมายในหมวดหมู่เดียวกัน โดยดูจากคำแวดล้อมที่อยู่ใกล้เคียง
หลักการนี้เรียกว่า Distributional Hypothesis ซึ่งริเริ่มโดย Zellig Harris ในปี 1954 และกลายมาเป็นรากฐานของโมเดลภาษาสมัยใหม่ทั้งหมด ตั้งแต่ Word2Vec ในปี 2013 มาจนถึง Large Language Models ในปัจจุบัน
4. แผนที่ภาษา: เมื่อทุกคำมีพิกัดของตัวเอง (Word Embeddings)
เมื่อนำหลักการเพื่อนข้างเคียงมาจัดวางใหม่ เราจะได้แผนที่ความหมายขนาดใหญ่ที่ทุกคำมีพิกัดเฉพาะตัว คำที่มีกลุ่มคำแวดล้อมคล้ายกันจะถูกจัดให้อยู่ในละแวกใกล้เคียงกันโดยอัตโนมัติ โดยที่มนุษย์ไม่ต้องคอยป้อนกฎว่าคำใดเป็นสัตว์เลี้ยงหรือยานพาหนะ
คำว่า "หมา" "แมว" "กระต่าย" จะรวมกลุ่มอยู่ด้วยกัน เพราะมักพบร่วมกับคำว่า "เลี้ยง" "อาหารสัตว์" หรือ "น่ารัก" ขณะที่ "รถยนต์" "มอเตอร์ไซค์" "รถบัส" จะไปรวมอยู่อีกมุมหนึ่งเพราะปรากฏร่วมกับคำว่า "ขับ" "เครื่องยนต์" หรือ "ถนน"
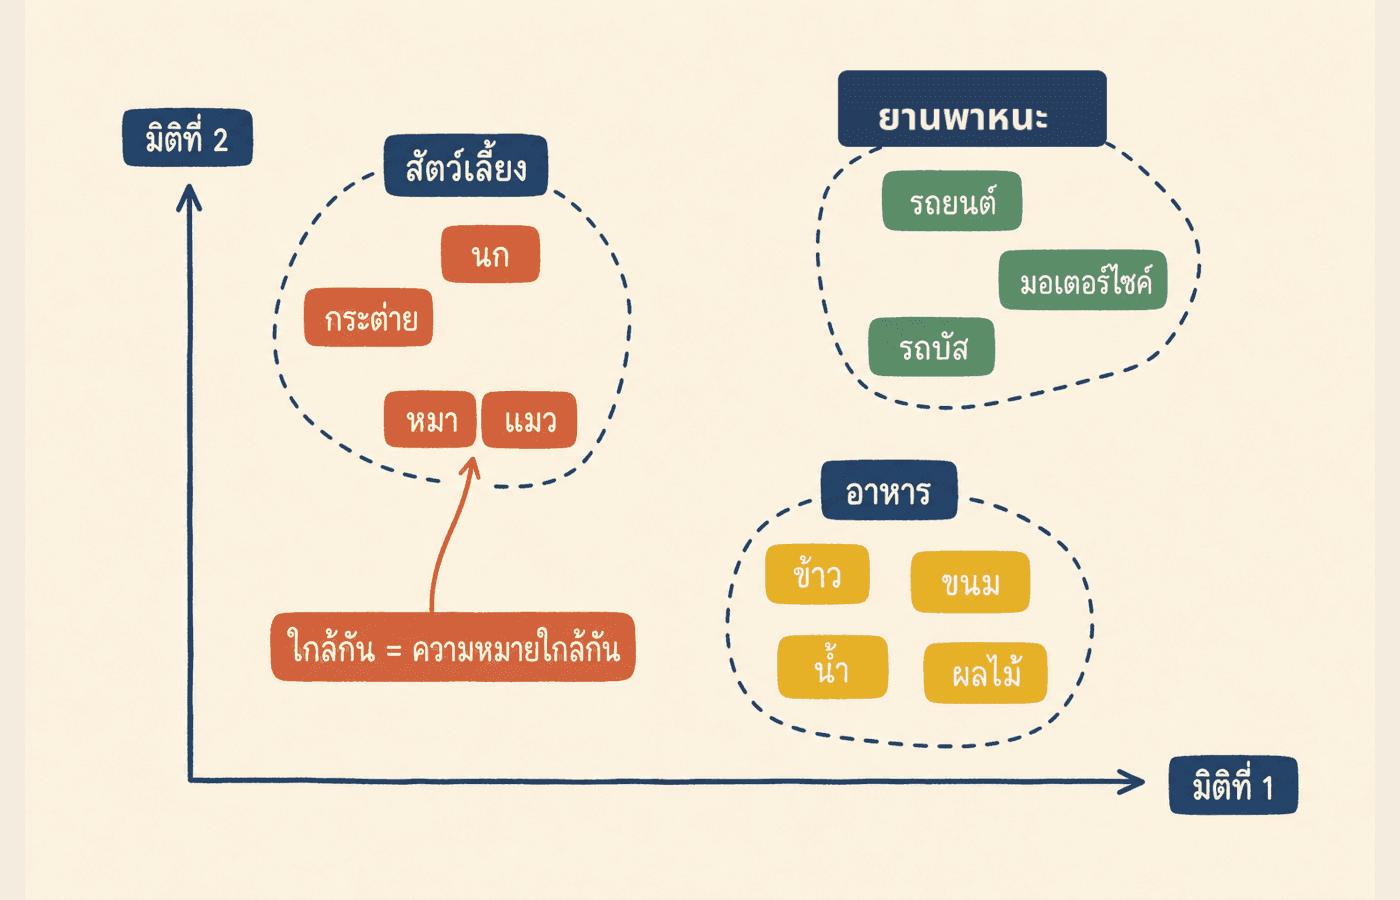
ในความเป็นจริง แผนที่ที่ AI ใช้งานไม่ได้มีเพียง 2 มิติแบบแผนที่ทั่วไป แต่เป็นพื้นที่หลายร้อยถึงหลายพันมิติ โดยแต่ละมิติทำหน้าที่สะท้อนคุณลักษณะเฉพาะบางอย่าง เช่น ความเป็นสิ่งมีชีวิต ขนาด หรือระดับความเป็นทางการ
- Word2Vec (2013): นิยมใช้ประมาณ 300 มิติ
- BERT (2018): ใช้ 768 ถึง 1,024 มิติ
- OpenAI text-embedding-3 (2024): ใช้ 1,536 ถึง 3,072 มิติ (OpenAI Embeddings Guide)
ชุดตัวเลขพิกัดหลายมิติเหล่านี้คือสิ่งที่เรียกว่า Vector Embedding ซึ่งทำหน้าที่เป็นตัวแทนความหมายของคำในมุมมองของ AI
5. คณิตศาสตร์แห่งภาษา: เมื่อเวกเตอร์ของคำสามารถบวกลบกันได้
ความน่าทึ่งของ Vector Space คือการที่เราสามารถนำพิกัดของคำมาคำนวณทางคณิตศาสตร์ได้เหมือนตัวเลขทั่วไป
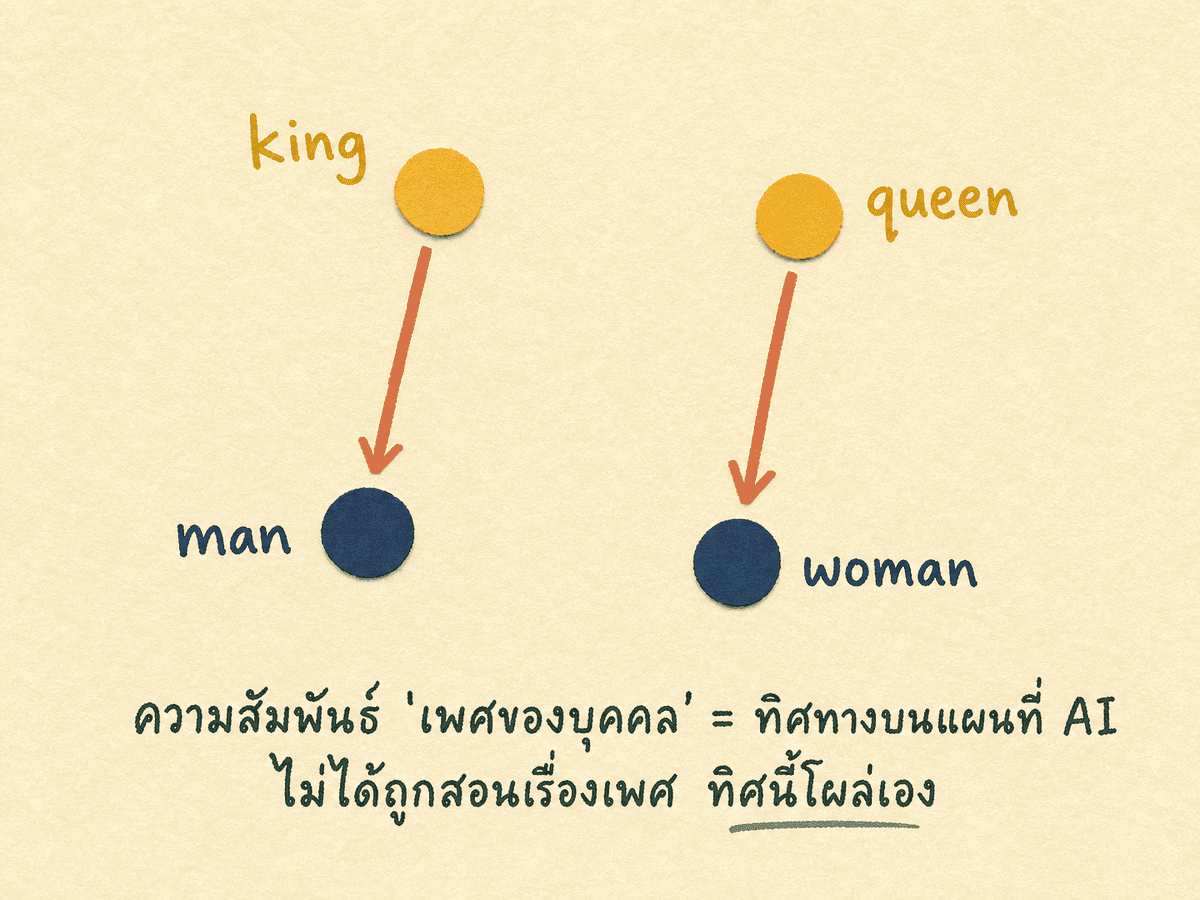
สมการคลาสสิกที่โด่งดังที่สุดในวงการคือ
vec(king) - vec(man) + vec(woman) ≈ vec(queen)เมื่อนำเวกเตอร์ของคำว่า "king" ลบเวกเตอร์ของคำว่า "man" (หักมิติความเป็นเพศชายออก) แล้วบวกเวกเตอร์ของคำว่า "woman" (เพิ่มมิติความเป็นเพศหญิงเข้าไป) พิกัดผลลัพธ์ที่ได้จะอยู่ใกล้เคียงกับเวกเตอร์ของคำว่า "queen" มากที่สุด
Tomas Mikolov และทีมวิจัยจาก Google สาธิตตัวอย่างเพิ่มเติมใน งานวิจัยปี 2013 เช่น
vec(Madrid) - vec(Spain) + vec(France) ≈ vec(Paris)การลบพิกัดประเทศสเปนออกจากเมืองมาดริด จะเหลือเวกเตอร์ที่เป็นตัวแทนของ "แนวคิดเมืองหลวง" เมื่อนำไปบวกกับประเทศฝรั่งเศส ผลลัพธ์จึงชี้ไปยังเมืองปารีสอย่างแม่นยำ ความสัมพันธ์เชิงตรรกะเหล่านี้เกิดขึ้นเองจากโครงสร้างทางสถิติของภาษา โดยไม่มีใครป้อนกฎความสัมพันธ์ไว้ล่วงหน้า (Mikolov et al. 2013)
6. พลังของ Embedding ผู้อยู่เบื้องหลัง Spotify, Netflix, Google และ ChatGPT
หลักการแผนที่ความหมายไม่ได้จำกัดอยู่เฉพาะข้อความ แต่ถูกนำไปประยุกต์ใช้กับระบบดิจิทัลรอบตัวเรา
- Spotify: แปลงบทเพลงและพฤติกรรมการฟังของผู้ใช้ให้เป็นเวกเตอร์บนแผนที่ดนตรี เพลงที่มักถูกฟังต่อเนื่องกันโดยกลุ่มผู้ใช้ที่มีรสนิยมใกล้เคียงกัน จะถูกจัดวางให้อยู่ใกล้กันใน Vector Space
- Netflix & Amazon: แปลงภาพยนตร์และสินค้าให้อยู่ในแผนที่ความชอบ ระบบแนะนำจึงสามารถค้นหาสิ่งที่คล้ายคลึงกันจากระยะห่างของเวกเตอร์ได้อย่างมีประสิทธิภาพ
- Semantic Search ของ Google: เมื่อคุณค้นหาคำว่า "ปวดท้องช่วงบน" ระบบจะแปลงข้อความค้นหาเป็นเวกเตอร์ แล้วนำไปเทียบกับเวกเตอร์ของบทความนับล้านชิ้น บทความเรื่อง gastritis ซึ่งมีพิกัดเวกเตอร์อยู่ในละแวกเดียวกันจึงถูกดึงขึ้นมาเป็นคำตอบแรกได้อย่างแม่นยำ
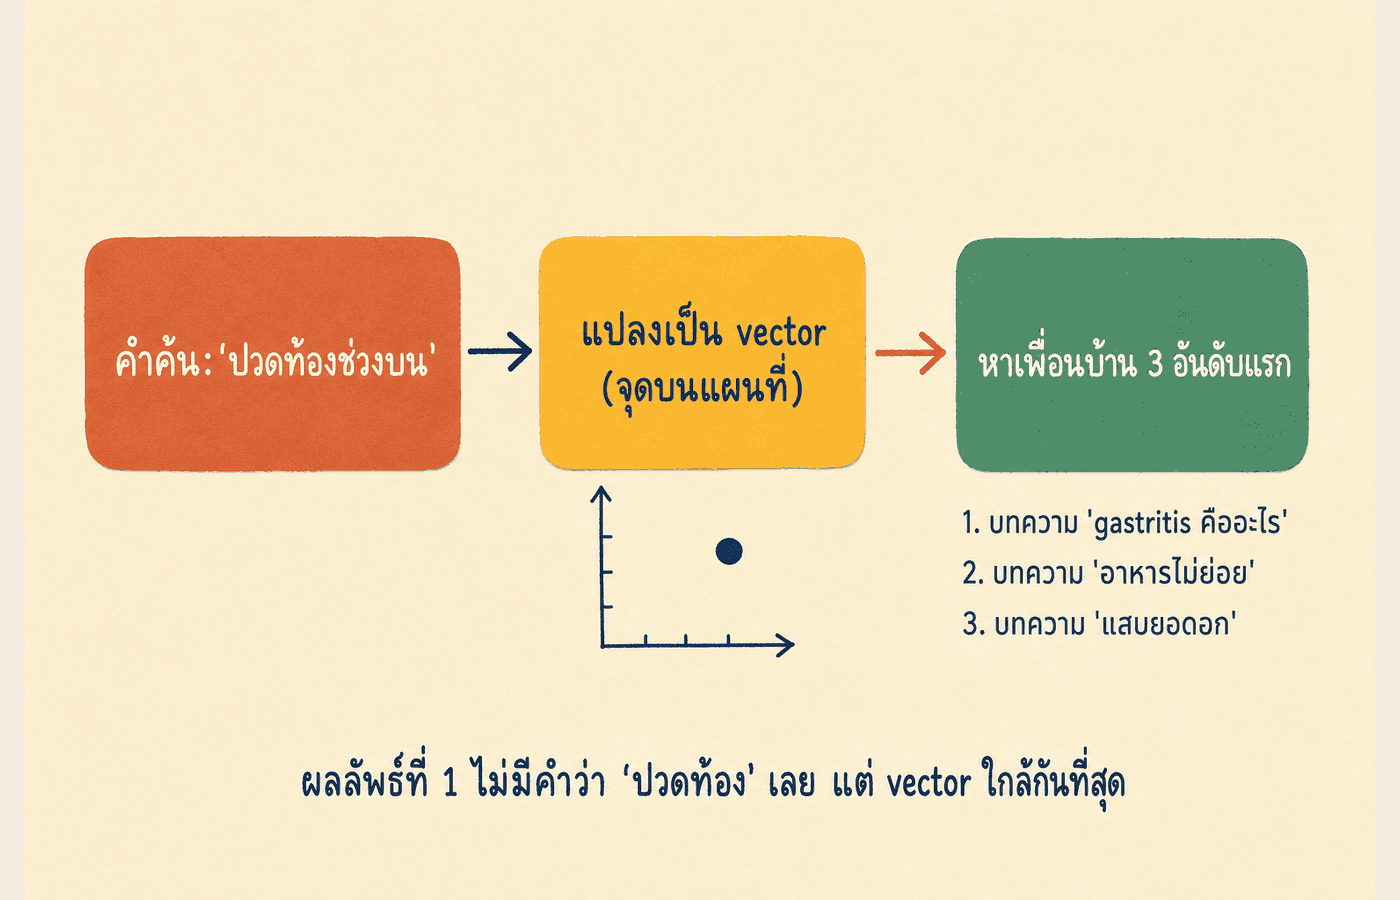
สำหรับโมเดลภาษาขนาดใหญ่ (LLM) อย่าง ChatGPT, Claude หรือ Gemini ขั้นตอนแรกของการประมวลผลคือการแปลงทุกข้อความที่ได้รับให้กลายเป็น Vector Embedding ก่อนจะส่งต่อเข้าไปยังชั้นประมวลผลถัดไปเสมอ
7. ข้อจำกัดและจุดที่ต้องระวังของ Embedding
แม้ Embedding จะทรงพลัง แต่ยังมีข้อจำกัดสำคัญ 3 ประการที่ผู้พัฒนาควรตระหนัก
- ปัญหาคำที่มีหลายความหมาย (Polysemy): ในโมเดลรุ่นเก่าอย่าง Word2Vec คำว่า "ธนาคาร" (ที่หมายถึงสถาบันการเงิน หรือตลิ่งริมน้ำ) จะมีพิกัดเพียงจุดเดียว ทำให้เวกเตอร์อยู่ก้ำกึ่งระหว่างสองความหมาย แต่โมเดลรุ่นใหม่อย่าง BERT และ Transformer ได้รับการปรับปรุงให้สร้างพิกัดตามบริบทของทั้งประโยค (Contextualized Embeddings)
- อคติที่ติดมาจากข้อมูลฝึกสอน (Data Bias): เนื่องจากแผนที่สร้างขึ้นจากพฤติกรรมการใช้ภาษาจริง รูปแบบอคติทางสังคมจึงถูกสะท้อนลงในพิกเตอร์เวกเตอร์ด้วย เช่น งานวิจัยพบว่าเวกเตอร์ของคำว่า programmer อาจมีความโน้มเอียงไปทางเพศชายตามสัดส่วนข้อความในอดีต การนำไปใช้งานจึงต้องมีการตรวจสอบความเหมาะสม
- เวกเตอร์ต่างโมเดลไม่สามารถเปรียบเทียบกันได้โดยตรง: แผนที่ของแต่ละโมเดลถูกสร้างขึ้นอย่างเป็นอิสระ เวกเตอร์จากโมเดลของ OpenAI ไม่สามารถนำไปวัดระยะห่างกับเวกเตอร์ของโมเดล Cohere หรือ Hugging Face ได้โดยตรง เว้นแต่จะผ่านกระบวนการแปลงมิติ
8. บทสรุป: หัวใจสำคัญของภาษาในมุมมอง AI
ความหมายของคำในมุมมองของ AI คือ พิกัดบนแผนที่หลายมิติที่จัดวางตามความสัมพันธ์ของคำแวดล้อมที่ปรากฏร่วมกันในข้อมูลฝึกสอน
จากแนวคิดที่ J.R. Firth เสนอไว้ในปี 1957 ผ่านการพัฒนาสู่ Word2Vec ในปี 2013 และก้าวสู่เทคโนโลยี AI ในปี 2026 หลักการพื้นฐานเรื่องการทำความเข้าใจความหมายผ่านบริบทแวดล้อมยังคงเป็นแกนหลักที่แข็งแกร่ง และจะเป็นรากฐานสำคัญของระบบปัญญาประดิษฐ์ต่อไปในอนาคต
แหล่งอ้างอิง
- Efficient Estimation of Word Representations in Vector Space (Mikolov et al. 2013)
- Distributed Representations of Words and Phrases and their Compositionality (Mikolov et al. 2013)
- GloVe: Global Vectors for Word Representation (Pennington, Socher, Manning 2014)
- Distributional Structure (Harris 1954)
- A Neural Probabilistic Language Model (Bengio et al. 2003)
- Word2vec บน Wikipedia
- Word embedding บน Wikipedia
- OpenAI text-embedding-3 documentation
- Distributional Hypothesis บน ACL Wiki
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin