AI สร้างรูปจากประโยคเดียวได้ยังไง คำตอบที่ทำให้คุณเห็น Midjourney เป็นคนละตัว
AI ไม่ได้วาดรูปจากศูนย์ มันลบความมั่วออกจากผ้าใบจุดมั่วๆ ทีละขั้นจนเหลือภาพ เข้าใจ 5 หลักการนี้ครั้งเดียว ใช้ได้กับ Midjourney DALL-E และทุก tool ที่จะออกในอนาคต

AI ไม่ได้วาดภาพขึ้นมาจากความว่างเปล่า แต่มันค่อยๆ ลบสัญญาณรบกวน (Noise) ออกจากผืนผ้าใบที่เต็มไปด้วยจุดสุ่ม จนกระทั่งปรากฏเป็นภาพที่คมชัด
เวลาที่เราพิมพ์ข้อความสั้นๆ ลงใน Midjourney หรือ DALL-E แล้วได้ภาพที่สวยงามภายในไม่กี่วินาที เบื้องหลังของกระบวนการนั้นเริ่มต้นจากภาพจุดสีที่ดูเหมือนจอทีวีไม่มีสัญญาณ จากนั้นตัวโมเดลจะค่อยๆ ขัดเกลาความไม่ชัดเจนนั้นออกทีละขั้นตอนประมาณ 30 ถึง 50 รอบ จนเหลือเพียงภาพที่เราต้องการ
แนวคิดการสร้างภาพแบบย้อนกลับนี้คือจุดเปลี่ยนสำคัญที่ทำให้วงการ AI สร้างภาพก้าวกระโดดอย่างมหาศาล และ 5 หลักการพื้นฐานในบทความนี้จะช่วยให้คุณมองเห็นกลไกเบื้องหลังของเครื่องมือสร้างภาพ AI ทุกตัวได้อย่างทะลุปรุโปร่ง
ปริศนาเบื้องหลังภาพสวยงามจากประโยคเดียว
สมมติคุณพิมพ์ข้อความว่า "แมวใส่หมวกพ่อมดในป่ายามค่ำคืน" ลงในโปรแกรมสร้างภาพ เพียงครู่เดียวคุณจะได้ผลงานที่มีรายละเอียดประณีตและไม่เคยมีอยู่บนโลกมาก่อน
หลายคนอาจตั้งข้อสันนิษฐานไว้ 2 แบบ
- AI มีคลังภาพขนาดมหึมา แล้วนำภาพแมว ภาพหมวก และภาพป่ามาตัดแปะรวมกัน
- AI มีจินตนาการเหมือนมนุษย์ ที่สามารถจรดพู่กันวาดทุกอย่างขึ้นมาจากผืนผ้าใบที่ว่างเปล่า
ในความเป็นจริง ทั้งสองข้อสันนิษฐานยังไม่ใช่คำตอบที่ถูกต้อง
ระบบไม่ได้เก็บไฟล์ภาพไว้ตัดแปะ และไม่ได้เริ่มวาดจากความว่างเปล่า แต่มันเริ่มต้นจาก "ภาพสุ่มที่มีแต่จุด Noise ล้วนๆ" แล้วใช้แบบจำลองทางคณิตศาสตร์ค่อยๆ คำนวณเพื่อดึงเอาความสับสนวุ่นวายออกไปทีละน้อย จนกระทั่งเค้าโครงของแมว หมวกพ่อมด และผืนป่าค่อยๆ ชัดเจนขึ้นมา
ทำไมการ 'วาดจากศูนย์' จึงเป็นเรื่องยากเกินไปสำหรับคอมพิวเตอร์
หากเราต้องการสร้างภาพขนาด 512x512 พิกเซล หนึ่งภาพจะต้องประกอบด้วยค่าจุดสีถึง 786,432 ค่า (กว้าง 512 x ยาว 512 x ช่องสี RGB 3 ช่อง)
การสั่งให้โครงข่ายประสาทเทียม (Neural Network) ทายค่าตัวเลขเกือบแปดแสนค่าให้ถูกต้องสมบูรณ์แบบในครั้งเดียว เปรียบเหมือนการบังคับให้นักเขียนพิมพ์หนังสือนิยาย 200 หน้าให้เสร็จสมบูรณ์ในพริบตาเดียวโดยห้ามแก้ไข ซึ่งในทางสถิติและความน่าจะเป็นแทบเป็นไปไม่ได้เลย
นักวิจัยจึงเปลี่ยนมุมมองใหม่ โดยการแบ่งโจทย์ใหญ่ที่ยากเกินไปให้กลายเป็นโจทย์ย่อยขนาดเล็กนับร้อยนับพันข้อที่มีรูปแบบเดียวกัน เพื่อให้โครงข่ายประสาทเทียมสามารถเรียนรู้และทำซ้ำได้อย่างแม่นยำ
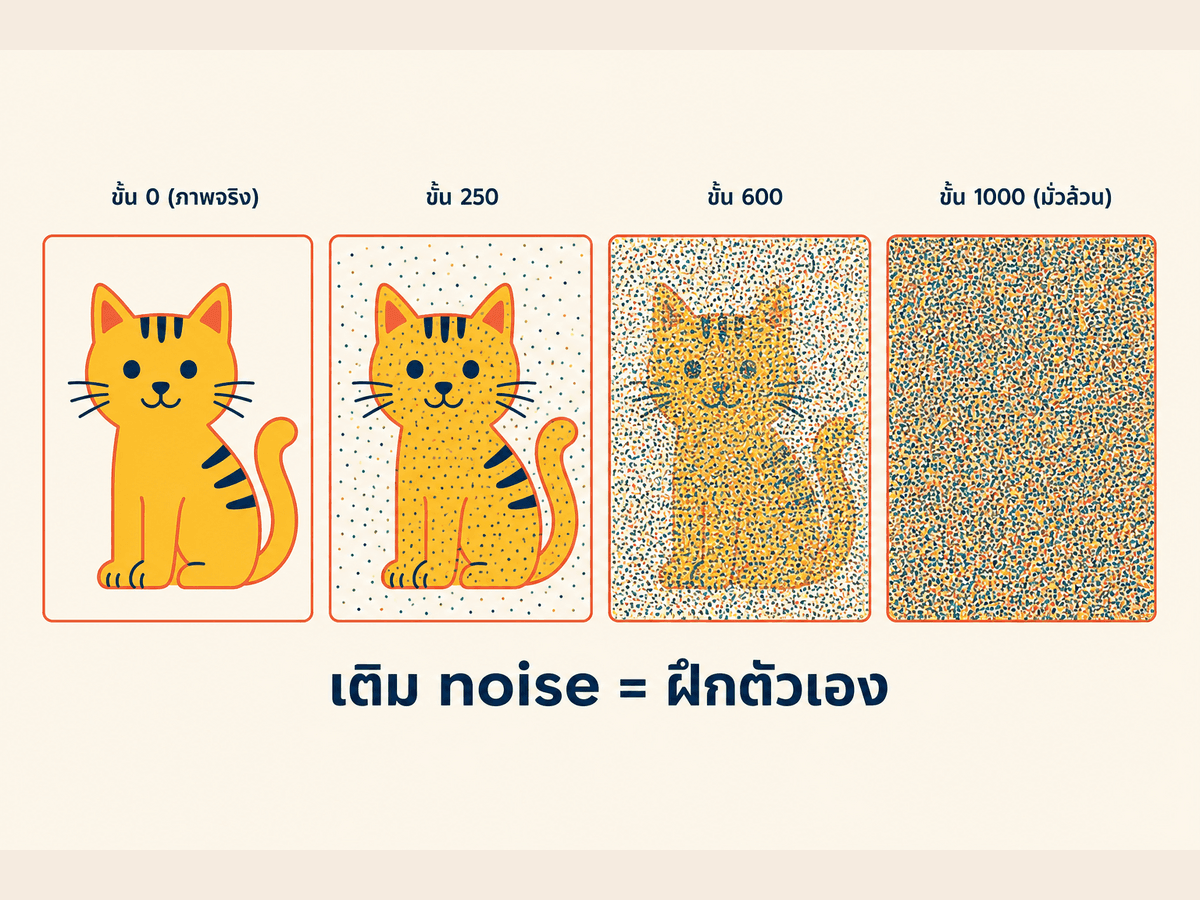
งานวิจัยชิ้นสำคัญ "Denoising Diffusion Probabilistic Models" โดย Ho, Jain และ Abbeel (NeurIPS 2020) (Ho et al. 2020) ได้วางรากฐานของแนวคิดนี้ ด้วยการแบ่งกระบวนการสร้างภาพออกเป็นขั้นตอนย่อยประมาณ 1,000 ขั้นตอน ในแต่ละขั้น โครงข่ายประสาทเทียมมีหน้าที่เพียงอย่างเดียวคือการคาดเดาและลบ Noise ก้อนเล็กๆ ออกจากภาพ เมื่อปัญหาถูกซอยย่อยจนเรียบง่าย ระบบจึงสามารถประมวลผลได้อย่างมีเสถียรภาพสูง
หลักการที่ 1: ค่อยๆ ขัด Noise ทีละขั้นง่ายกว่าการวาดภาพรวดเดียว
แนวคิดนี้คล้ายกับคำกล่าวของประติมากรชื่อดังอย่าง Michelangelo ที่มองว่ารูปปั้นมีตัวตนอยู่ในก้อนหินอ่อนตั้งแต่แรกอยู่แล้ว หน้าที่ของช่างคือการสกัดเอาเศษหินส่วนเกินออกไปเท่านั้น
AI สร้างภาพทำงานด้วยหลักการเดียวกัน ผืนผ้าใบเริ่มต้นคือ Gaussian Noise ซึ่งเป็นจุดพิกเซลสีที่กระจายตัวแบบสุ่มไร้ทิศทาง จากนั้นในแต่ละรอบการทำงาน AI จะค่อยๆ ขัดเอาจุดรบกวนออกไปทีละระดับ ทำซ้ำอย่างต่อเนื่อง 30 ถึง 50 รอบขึ้นอยู่กับการตั้งค่าของแต่ละโปรแกรม
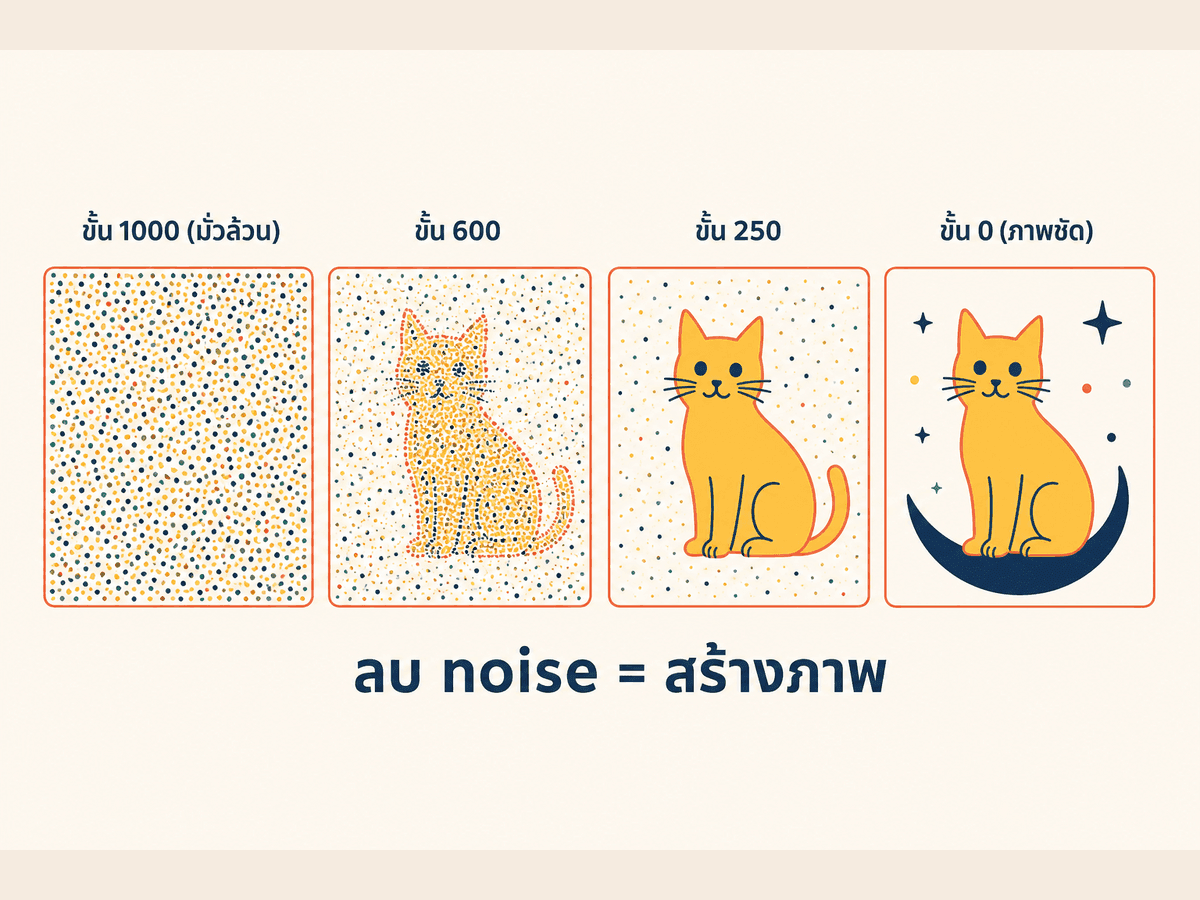
ในแต่ละรอบ โมเดลต้องตอบคำถามเพียงข้อเดียวว่า "สัญญาณรบกวนในภาพนี้น่าจะมีหน้าตาเป็นอย่างไรและควรตัดทิ้งตรงไหน" การมุ่งเน้นภารกิจทีละส่วนช่วยให้ระบบเก็บรายละเอียดที่ประณีตได้ดีกว่าการพยายามสร้างภาพทั้งผืนขึ้นมาในขั้นตอนเดียว
หลักการที่ 2: ฝึกสอนได้ไม่จำกัด เพราะโมเดลสร้างโจทย์เองได้ฟรี
ในการสอนให้ AI มีทักษะการลบ Noise ได้อย่างเชี่ยวชาญ ระบบจำเป็นต้องฝึกฝนกับตัวอย่างภาพนับพันล้านภาพ แต่ใครจะเป็นผู้เตรียมเฉลยที่ถูกต้องทั้งหมด
คำตอบคือ ระบบสามารถสร้างแบบฝึกหัดพร้อมเฉลยได้ด้วยตัวเองโดยอัตโนมัติ
- นำภาพถ่ายจริงที่สมบูรณ์มา 1 ภาพ (เช่น ภาพแมว)
- สุ่มระดับความเข้มข้น แล้วเติม Noise ลงไปในภาพด้วยตัวเอง (เช่น เติม Noise เข้าไป 30%)
- ส่งภาพที่เลอะ Noise ให้โมเดลดู พร้อมตั้งโจทย์ว่า "ลองทายซิว่า Noise ที่เพิ่งเติมเข้าไปมีหน้าตาอย่างไร"
- นำคำตอบที่โมเดลทาย มาเปรียบเทียบกับ Noise จริงที่ระบบเป็นคนใส่เข้าไปเองในตอนแรก
- ปรับจูนค่าน้ำหนักในโมเดลเพื่อให้ทายได้แม่นยำขึ้นในครั้งถัดไป
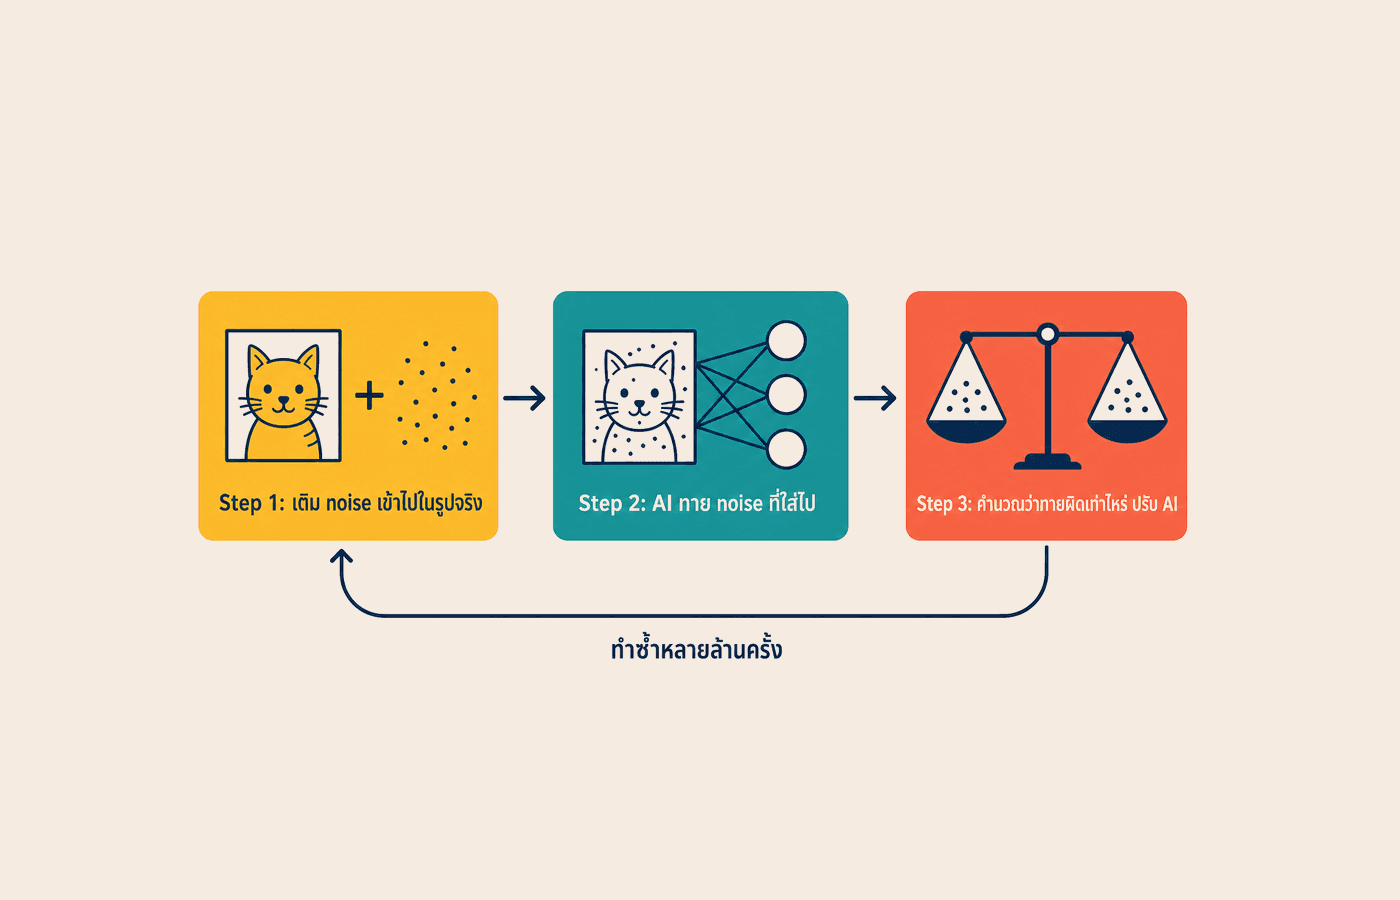
เนื่องจากระบบเป็นผู้เติม Noise ลงไปเอง จึงรู้คำตอบที่ถูกต้องอยู่เสมอโดยไม่ต้องจ้างมนุษย์มานั่งทำเฉลย รูปภาพสาธารณะนับพันล้านภาพบนอินเทอร์เน็ตจึงสามารถนำมาสร้างเป็นแบบฝึกหัดได้นับหมื่นล้านรูปแบบ นี่คือปัจจัยหลักที่ทำให้โมเดลตระกูล Diffusion ได้รับการพัฒนาอย่างก้าวกระโดด
หลักการที่ 3: แต่ละขั้นตอนตอบคำถามเดียวอย่างแม่นยำ
โมเดลสร้างภาพในยุคก่อนหน้า เช่น GAN (Generative Adversarial Networks) พยายามสั่งให้โครงข่ายประสาทเทียมแปลงภาพจุดสุ่มให้กลายเป็นภาพผลลัพธ์สุดท้ายในคราวเดียว ซึ่งมักพบปัญหาภาพบิดเบี้ยวหรือมีรายละเอียดไม่สมจริงในจุดที่ซับซ้อน
ตรงกันข้าม Diffusion Models ในแต่ละสเต็ปจะไม่พยายามคาดเดาภาพผลลัพธ์สุดท้าย แต่จะโฟกัสเฉพาะการคำนวณทิศทางของ Noise ณ ปัจจุบันเท่านั้น การแบ่งภาระงานเป็นส่วนย่อยที่มีเป้าหมายชัดเจน ทำให้โมเดลสามารถสร้างรายละเอียดที่สมจริงระดับสูง เช่น เส้นขน ประกายตา หรือรอยพับของผืนผ้า ได้อย่างเป็นธรรมชาติ
หลักการที่ 4: Prompt คือพวงมาลัยคอยคุมทิศทาง ไม่ใช่พิมพ์เขียวสำเร็จรูป
ความเข้าใจผิดทั่วไปคือคิดว่า Prompt คือพิมพ์เขียวที่บอกให้ AI วาดตามทีละส่วน แต่ในเชิงเทคนิค Prompt ทำหน้าที่เป็น "พวงมาลัยที่คอยปรับทิศทางการขจัด Noise ตลอดทุกขั้นตอน"
เปรียบเหมือนการขับรถ พิมพ์เขียวคือแผนผังที่กำหนดไว้ตายตัว แต่พวงมาลัยคือสิ่งที่คุณบังคับทิศทางตลอดเวลาที่รถกำลังเคลื่อนที่ ในทุกสเต็ปของการลบ Noise ข้อความ Prompt จะถูกนำมาประมวลผลซ้ำเพื่อบอกโมเดลว่า "ในขั้นตอนนี้ ให้ลบ Noise ไปในทิศทางที่สอดคล้องกับภาพแมวใส่หมวกพ่อมดนะ"
งานวิจัยของ Rombach และคณะ (CVPR 2022) (Rombach et al. 2022) ใช้กลไกที่เรียกว่า Cross-Attention เพื่อให้โครงข่ายประสาทเทียมสามารถหันกลับมาตรวจสอบความหมายของคำใน Prompt อยู่ตลอดเวลาในทุกๆ รอบการทำงาน
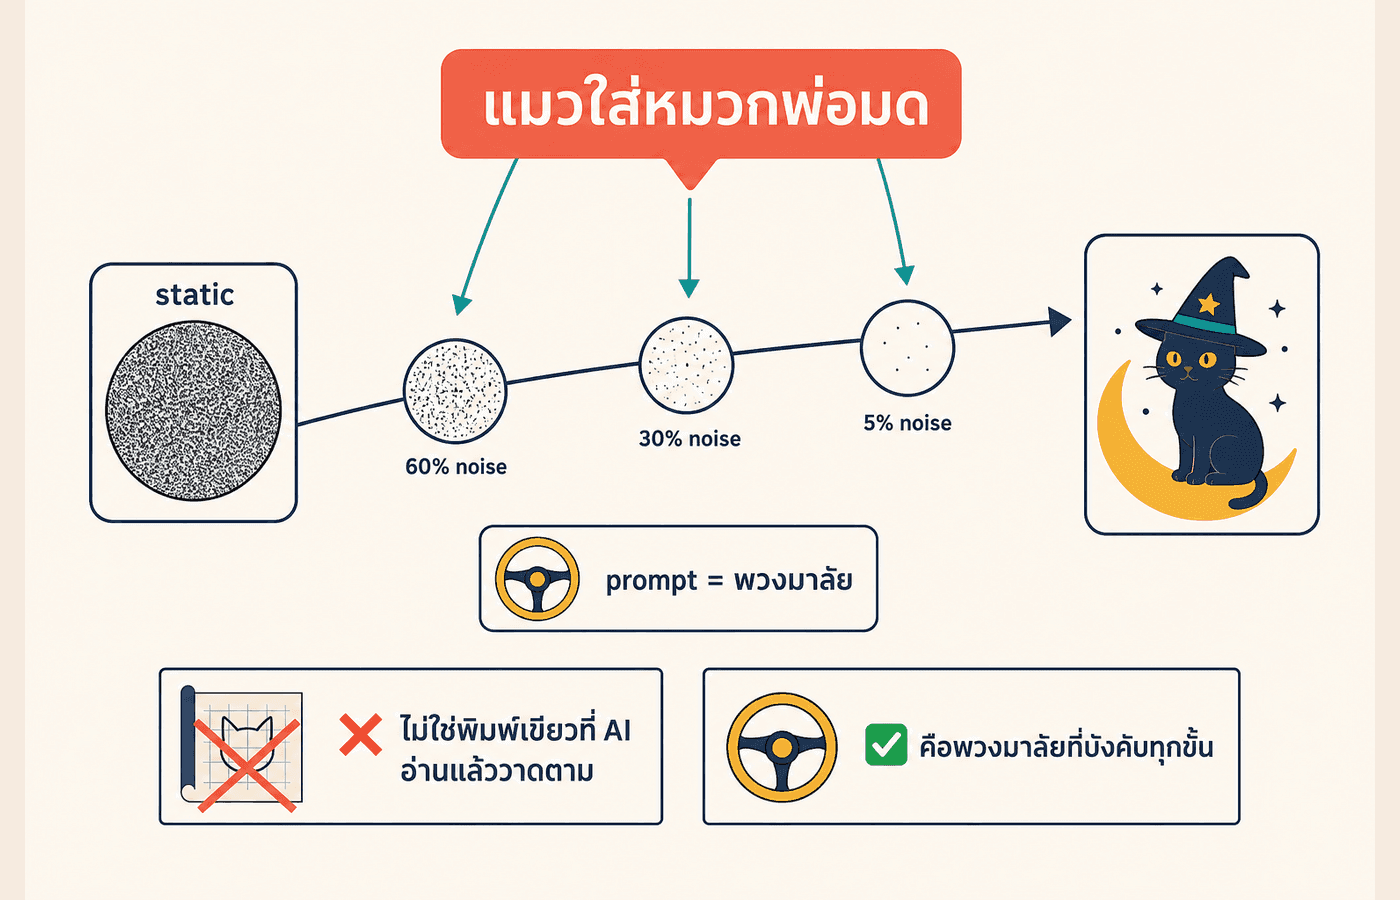
นั่นคือสาเหตุที่การเปลี่ยนคำใน Prompt เพียงคำเดียว (เช่น เปลี่ยนจากหมวกพ่อมด เป็นหมวกคาวบอย) สามารถเปลี่ยนโครงสร้างภาพทั้งหมดได้ เพราะทิศทางการขัดเกลาภาพถูกเบนไปคนละเส้นทางตั้งแต่ก้าวแรก
หลักการที่ 5: สเก็ตช์ภาพร่างก่อนลงสี (Latent Diffusion)
ในอดีต การประมวลผลบนพิกเซลภาพขนาด 512x512 โดยตรงต้องอาศัยซูเปอร์คอมพิวเตอร์และใช้เวลาประมวลผลยาวนาน แต่ทำไมโมเดลอย่าง Stable Diffusion ถึงสามารถรันบนคอมพิวเตอร์ส่วนบุคคลได้ภายในไม่กี่วินาที
กุญแจสำคัญคือเทคโนโลยี Latent Diffusion ของทีม Rombach ซึ่งเปรียบเหมือนการทำงานของศิลปินที่ต้องร่างภาพสเก็ตช์โครงสร้างคร่าวๆ ด้วยดินสอก่อน แล้วจึงลงรายละเอียดและสีสันในภายหลัง
ตัวระบบใช้เครื่องมือที่เรียกว่า Autoencoder ในการบีบอัดภาพขนาด 512x512 พิกเซล ให้กลายเป็นพื้นที่ข้อมูลแฝง (Latent Space) ขนาดเพียง 64x64 ซึ่งมีขนาดเล็กลงถึง 64 เท่า กระบวนการลบ Noise ทั้งหมดจะเกิดขึ้นบนพื้นที่ขนาดเล็กนี้ และเมื่อได้โครงสร้างภาพที่สมบูรณ์แล้ว Autoencoder จะทำการขยายภาพกลับมาเป็นขนาด 512x512 พิกเซลพร้อมเติมรายละเอียดให้ครบถ้วนในขั้นตอนสุดท้าย
นอกจากนี้ งานวิจัยของ Song, Meng และ Ermon (ICLR 2021) (Song et al. 2021) ยังได้คิดค้นวิธีลดจำนวนรอบการประมวลผลจาก 1,000 ขั้นตอน ให้เหลือเพียง 30 ถึง 50 ขั้นตอน ทำให้การสร้างภาพเสร็จสิ้นได้อย่างรวดเร็วในระดับวินาทีบนฮาร์ดแวร์ทั่วไป
บทสรุป: 5 หลักการพื้นฐานของ Diffusion Models
สรุปหัวใจสำคัญของกลไกการสร้างภาพด้วย AI
- ขัด Noise ทีละขั้น: เริ่มต้นจากภาพจุดสุ่ม แล้วค่อยๆ คำนวณลบสัญญาณรบกวนออกทีละรอบ
- สร้างโจทย์ฝึกสอนอัตโนมัติ: ระบบสามารถเติม Noise และสร้างแบบฝึกหัดได้เอง ทำให้ฝึกฝนกับชุดข้อมูลขนาดมหาศาลได้อย่างมีประสิทธิภาพ
- โฟกัสงานเดียวในแต่ละรอบ: มุ่งเน้นการคำนวณ Noise ณ จุดปัจจุบัน ทำให้เก็บรายละเอียดได้ประณีต
- Prompt คือพวงมาลัยนำทาง: ข้อความคำสั่งทำหน้าที่ปรับทิศทางการลดทอน Noise ในทุกสเต็ปของการสร้างภาพ
- ทำงานบนพื้นที่ภาพร่าง (Latent Space): ประมวลผลบนพื้นที่ย่อขนาดก่อน แล้วจึงขยายภาพสู่ความละเอียดสูง ทำให้รันบนคอมพิวเตอร์ทั่วไปได้อย่างรวดเร็ว
เมื่อคุณกดสั่งสร้างภาพในครั้งต่อไป คุณจะมองเห็นภาพกระบวนการทำงานที่อยู่เบื้องหลัง ว่าไม่มีคลังภาพตัดแปะและไม่มีการวาดจากศูนย์ มีเพียงระบบคณิตศาสตร์ที่กำลังขัดเกลาผืนผ้าใบจุดสุ่มให้กลายเป็นผลงานที่ตรงกับทิศทางที่คุณกำหนดไว้อย่างแม่นยำ
แหล่งอ้างอิง
- Denoising Diffusion Probabilistic Models โดย Ho, Jain, Abbeel (NeurIPS 2020)
- High-Resolution Image Synthesis with Latent Diffusion Models โดย Rombach และคณะ (CVPR 2022)
- Denoising Diffusion Implicit Models โดย Song, Meng, Ermon (ICLR 2021)
- Classifier-Free Diffusion Guidance โดย Ho, Salimans (NeurIPS 2021 Workshop)
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin