AI ไม่ได้โกหก แค่ถูกฝึกให้เดา first principles ของ hallucination
AI ไม่ได้โกหก มันแค่ถูกฝึกในระบบที่ให้รางวัลการเดามากกว่ายอมรับว่าไม่รู้ เข้าใจ first principle ของ hallucination แล้วคุณจะรู้ว่าควรเชื่อคำตอบของ AI ตอนไหน

AI ไม่ได้ตั้งใจโกหก มันแค่ถูกฝึกมาในระบบที่ให้รางวัลกับการเดามากกว่าการยอมรับว่าไม่รู้
ลองนึกภาพห้องสอบที่คุ้นเคย นักเรียนคนหนึ่งเปิดข้อสอบมาเจอข้อที่ไม่รู้คำตอบ กฎระบุชัดว่าตอบผิดได้ 0 คะแนน เว้นว่างไว้ก็ได้ 0 คะแนนเช่นกัน ถ้าเป็นคุณ คุณจะเดาไหม คำตอบแทบไม่ต้องคิด
เมื่อแกะกลไกการเดาของ AI ออกมาดูระดับรากฐาน (First Principles) เราจะพบกลไก 3 ชั้นที่ซ้อนทับกันอยู่ และเมื่อเข้าใจระบบนี้ คุณจะอ่านออกทันทีว่าจังหวะไหนควรเชื่อคำตอบของ AI และจังหวะไหนที่มันกำลังเดาอย่างมั่นใจ
1. กฎข้อสอบ Multiple Choice ที่เปลี่ยนพฤติกรรมคน
นึกภาพข้อสอบ 4 ตัวเลือก กฎคือตอบถูกได้ 1 คะแนน ตอบผิดได้ 0 คะแนน เว้นว่างได้ 0 คะแนน ถ้าคุณเป็นนักเรียนแล้วเจอข้อที่ไม่รู้ ทางที่คุ้มที่สุดตามหลักความน่าจะเป็นคือเดา เพราะค่าเฉลี่ยของการสุ่มตอบคือ 0.25 คะแนน (โอกาสถูก 1 ใน 4) ขณะที่การเว้นว่างการันตี 0 คะแนนแน่ๆ การเดาจึงเป็นกลยุทธ์ที่ชนะเสมอ
ทีนี้ลองเปลี่ยนกฎ ข้อสอบมาตรฐานบางชุดในอดีตอย่าง GRE หรือ SAT รุ่นเก่า มีการหักคะแนนเมื่อตอบผิดประมาณ 0.25 คะแนน พฤติกรรมของนักเรียนจะเปลี่ยนทันที ทุกคนจะตอบเฉพาะข้อที่มั่นใจ ส่วนข้อที่ไม่รู้จะเว้นว่างไว้ เพราะการเดามั่วทำให้ค่าเฉลี่ยความคาดหวังติดลบ เมื่อระบบให้คะแนนเปลี่ยน พฤติกรรมก็เปลี่ยนตามทันที
ระบบวัดผลคือตัวกำหนดพฤติกรรม ไม่ใช่เจตนาของนักเรียน เด็กที่เดาในข้อสอบที่ไม่หักคะแนนไม่ได้มีนิสัยขี้โกง และเด็กที่เว้นว่างในข้อสอบที่หักคะแนนก็ไม่ได้ขี้กลัว ทั้งสองฝ่ายแค่เลือกกลยุทธ์ที่ทำคะแนนได้สูงสุดภายใต้กติกาที่กำหนด
จำภาพนี้ไว้ให้ดี เพราะ AI ที่เราคุยด้วยทุกวันนี้ มีพฤติกรรมไม่ต่างจากนักเรียนคนนั้นเลย
2. AI ก็คือนักเรียนคนนั้น กับระบบ Benchmark ที่บีบให้ต้องเดา
ทีมวิจัยที่ทำงานร่วมกับ OpenAI นำโดย Adam Tauman Kalai ตีพิมพ์งานวิจัย Why Language Models Hallucinate (2025) ซึ่งอธิบายต้นตอของอาการ hallucination ไว้อย่างตรงไปตรงมา ปัญหาไม่ได้เกิดจากโมเดลมีความคิดอยากหลอกเรา แต่อยู่ที่ระบบการให้คะแนนตอนฝึกสอน
เวลาประเมินว่า AI เก่งแค่ไหน วงการจะใช้ชุดข้อสอบมาตรฐานที่เรียกว่า Benchmark เช่น GPQA, MMLU-Pro, MATH หรือ SWE-bench ทีมของ Kalai เข้าไปวิเคราะห์ Benchmark หลัก 9 ตัวที่นิยมใช้กัน และพบว่าเกือบทั้งหมดใช้กติกาเดียวกัน ตอบถูกได้ 1 คะแนน ตอบผิดได้ 0 คะแนน และตอบว่าไม่รู้ก็ได้ 0 คะแนนเท่ากับตอบผิด
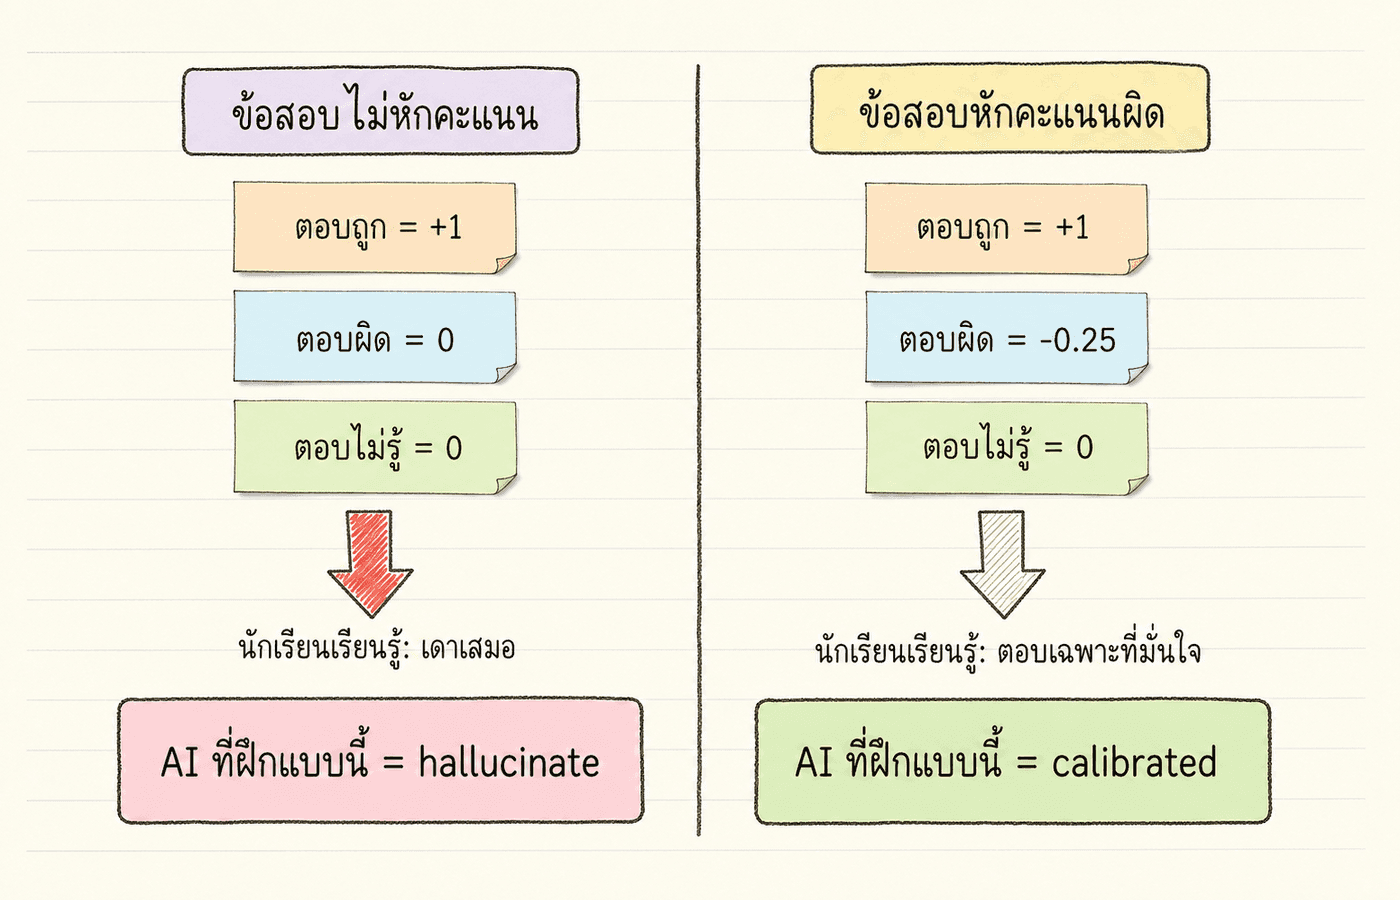
ผลลัพธ์จึงออกมาเหมือนนักเรียนในห้องสอบ โมเดลเรียนรู้ว่าการตอบแบบมั่นใจเต็มร้อยในทุกกรณีคือกลยุทธ์ที่ทำคะแนนรวมได้ดีที่สุด การยอมรับว่า 'ฉันไม่รู้' ไม่เคยได้คะแนนเพิ่ม ซ้ำยังตัดโอกาสลุ้นคะแนนจากการเดาถูก Kalai และทีมสรุปประเด็นนี้ไว้ว่า นักเรียนเดาข้อสอบชอยส์เพื่อเพิ่มคะแนนอย่างไร AI ก็เดาคำตอบในการทดสอบ Benchmark อย่างนั้น (Kalai et al. 2025)
ต้นตอไม่ได้อยู่ที่โมเดลมีข้อบกพร่องทางศีลธรรม และไม่ได้เกิดจากผู้พัฒนาตั้งใจให้มันหลอกผู้ใช้ แต่อยู่ที่ระบบวัดผลทั้งอุตสาหกรรมที่ส่งสัญญาณมาตลอดว่า 'เดาดีกว่ายอมรับว่าไม่รู้' ตราบใดที่ตาราง Leaderboard ยังจัดอันดับด้วยกฎเดิม โมเดลรุ่นใหม่ก็จะยังคงพฤติกรรมเดิมไว้เสมอ นี่คือกฎชั้นแรกของกลไก hallucination
3. ข้อเท็จจริงที่เห็นครั้งเดียว (Singleton Facts) ต่อให้เพิ่มข้อมูลก็ยังจำไม่ได้
ระบบคะแนนเป็นเพียงกลไกชั้นแรก ชั้นที่สองฝังลึกอยู่ในขั้นตอน Pre-training ซึ่งเป็นช่วงที่โมเดลอ่านข้อความมหาศาลจากอินเทอร์เน็ตเพื่อซึมซับความรู้ภาษา
ลองนึกภาพห้องสมุดขนาดยักษ์ที่รวบรวมข้อความเกือบทั้งหมดบนโลก เรื่องราวของ Albert Einstein มีคนเขียนถึงเป็นพันเป็นหมื่นครั้ง ทั้งใน Wikipedia ตำราเรียน ข่าว และบทความ ใครก็ตามที่อ่านห้องสมุดนี้ย่อมจำประวัติ Einstein ได้อย่างแม่นยำ แต่ข้อมูลอย่างวันเกิดของพนักงานบริษัทคนหนึ่ง อาจปรากฏอยู่ในหน้าเว็บสาธารณะเพียงแค่ครั้งเดียวในห้องสมุดทั้งหลัง เมื่อโมเดลเห็นข้อมูลเพียงหนเดียว มันจึงจำได้แค่โครงสร้างประโยคคร่าวๆ ส่วนตัวเลขเป๊ะๆ ต้องอาศัยการเดาจากบริบทรอบข้าง
ทีมวิจัยของ Kalai เรียกข้อมูลประเภทนี้ว่า 'Singleton Fact' หรือข้อเท็จจริงที่ปรากฏเพียงครั้งเดียวในชุดข้อมูลฝึกสอน งานวิจัยพิสูจน์ในเชิงทฤษฎีไว้ว่า อัตราการเกิด hallucination ของโมเดลหลังผ่าน Pre-training จะไม่มีทางลดลงต่ำไปกว่าสัดส่วนของ Singleton Fact ที่มีอยู่ในชุดข้อมูลฝึก (Kalai et al. 2025 Theorem 2)
ยกตัวอย่างให้เห็นภาพ สมมติในชุดข้อมูลฝึกมีวันเกิดของคน 100 คน หาก 20 คนในนั้นถูกพูดถึงเพียงครั้งเดียว ไม่ว่าจะถามโมเดลกี่รอบ มันจะตอบวันเกิดผิดอย่างน้อย 20 ครั้งจาก 100 ครั้ง และตัวเลข 20% นี้จะไม่หายไปเพียงแค่ป้อนข้อมูลเพิ่ม เพราะตราบใดที่ยังมีข้อมูลประเภท 'ปรากฏครั้งเดียว' อยู่ในระบบ สถิติความคลาดเคลื่อนก็จะคงอยู่ตามธรรมชาติ
ทีมของ Kalai ทดสอบด้วยการให้ DeepSeek-V3 ตอบวันเกิดของ Kalai เอง ผลการทดสอบ 3 ครั้งได้คำตอบต่างกันหมดคือ '03-07' '15-06' และ '01-01' ซึ่งผิดทั้งหมด ปัญหานี้ไม่ได้เกิดเฉพาะกับ DeepSeek โมเดลชั้นนำตัวอื่นก็ตอบผิดเช่นกัน เพราะในมุมของข้อมูลฝึก Kalai คือ Singleton ที่ไม่มีหน้าเว็บไหนพูดถึงวันเกิดของเขาบ่อยพอให้โมเดลจำพิกัดได้
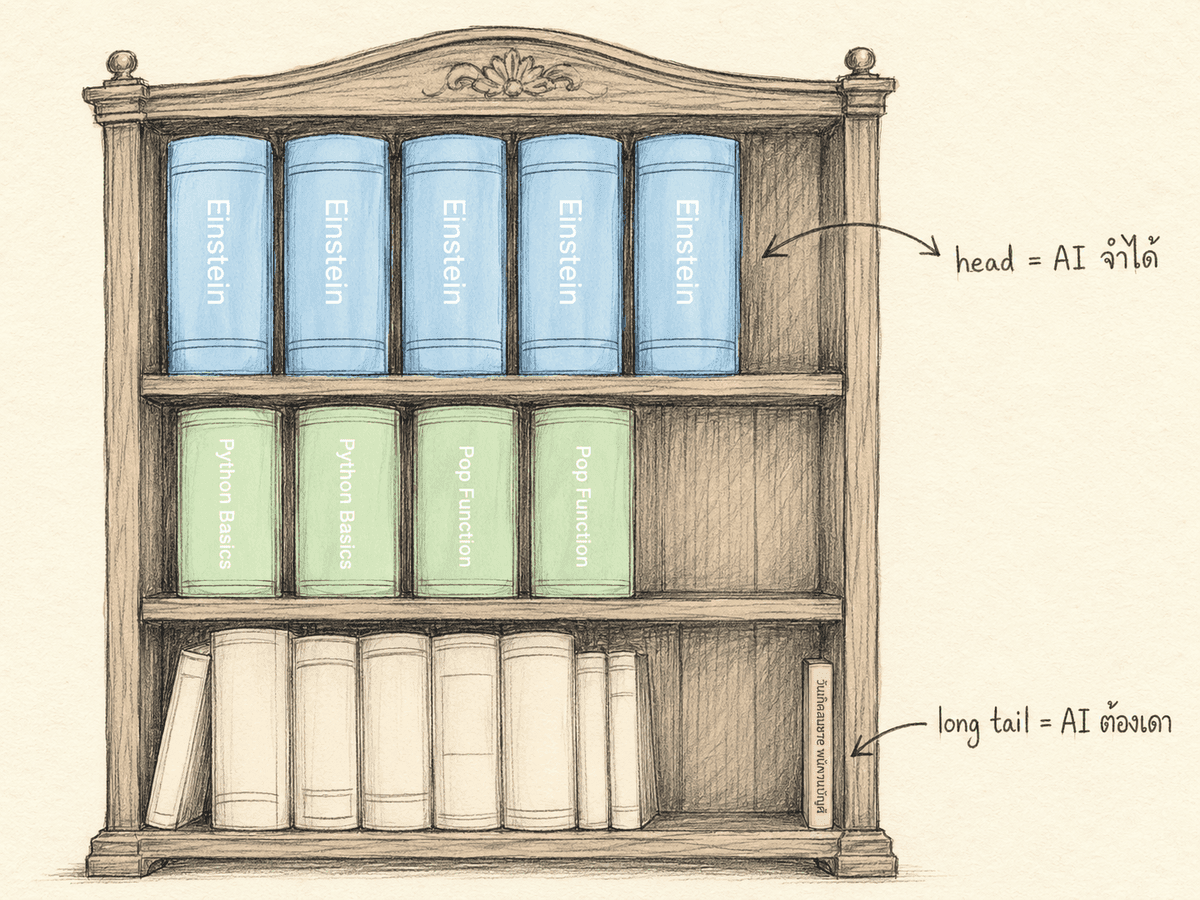
สรุปกลไกชั้นนี้ได้ง่ายๆ เรื่องใดที่ปรากฏซ้ำเป็นวงกว้างบนอินเทอร์เน็ต เช่น ไวยากรณ์ภาษา Python หรือฟังก์ชันมาตรฐาน โมเดลจะตอบได้แม่นยำ ส่วนเรื่องเฉพาะทางที่มีบันทึกน้อย เช่น รายชื่อคนในองค์กร หรือข้อกำหนดเฉพาะของเครื่องมือภายในทีม โมเดลจะมีโอกาสเดาสูงมาก และอาการนี้ไม่หายไปด้วยการอัดข้อมูลเพิ่ม เพราะในโลกความจริงมีข้อมูลใหม่ บริษัทใหม่ และเหตุการณ์ใหม่เกิดขึ้นทุกวัน ข้อมูลใหม่เหล่านี้ก็คือ Singleton รุ่นถัดไปนั่นเอง
4. แยกประเภท Hallucination ให้ขาดก่อนหาทางแก้
ก่อนจะมองหาวิธีรับมือ เราต้องแยกประเภทของ hallucination ให้ชัดเจน เพราะแต่ละแบบต้องใช้วิธีตรวจสอบคนละวิธี งานสำรวจการจัดหมวดหมู่ hallucination โดย Huang และคณะ (2023) แบ่งออกเป็น 2 ตระกูลหลัก
คนทำงานทั่วไปจะพบ Faithfulness Hallucination บ่อยกว่า เพราะรูปแบบงานส่วนใหญ่คือการส่งเอกสารหรือบริบทเข้าไปให้ AI สรุป แปล หรือเรียบเรียง ปัญหาที่เจอมักเป็น 'AI แต่งเติมข้อมูลเกินจากต้นฉบับ' มากกว่าการจำประวัติศาสตร์โลกผิด การตรวจสอบประเภทนี้จึงต้องเทียบกับเอกสารที่เราป้อนเข้าไปเอง ไม่ใช่เทียบกับฐานข้อมูลโลกภายนอก
5. สัญญาณสังเกต AI กำลังเดาหรือรู้จริง
งานวิจัยปี 2025 ของ Tao และคณะ ทดสอบโมเดลกว่า 80 ตัว ครอบคลุมตั้งแต่โมเดลขนาดเล็กสำหรับรันบนเครื่องส่วนตัว ไปจนถึงโมเดลเรือธงขนาดใหญ่ เพื่อเปรียบเทียบ 3 วิธีในการวัดว่าโมเดลมั่นใจในคำตอบจริงแค่ไหน
วิธีแรกคือถามความมั่นใจตรงๆ เช่น ให้ระบุเป็นเปอร์เซ็นต์ วิธีที่สองคือตรวจวัดค่าความน่าจะเป็นภายใน (Internal Probability Signals) ระหว่างสร้างคำตอบ และวิธีที่สามคือวิเคราะห์การใช้คำบอกความไม่แน่ใจ (Hedge Words) ในประโยค เช่น 'อาจจะ' 'น่าจะ' หรือ 'ตามข้อมูลที่มี' ผลการทดลองพบว่า วิธีที่สามให้ความแม่นยำสูงกว่าสองวิธีแรกในเกือบทุกการทดสอบ
ภาษากำกวมหรือคำบอกความไม่แน่ใจที่ AI ใช้ตามธรรมชาติ มีความน่าเชื่อถือกว่าตัวเลขเปอร์เซ็นต์ที่มันพิมพ์ออกมา เหตุผลเพราะตัวเลขเปอร์เซ็นต์ก็คือข้อความอีกชุดที่โมเดลสร้างขึ้นมา มันจึงสามารถเดาตัวเลขความมั่นใจได้เหมือนเดาเนื้อหาคำตอบ ขณะที่การเลือกใช้คำบอกความไม่แน่นอนสะท้อนถึงการกระจายตัวของความน่าจะเป็นในขณะประมวลผลคำตอบจริง
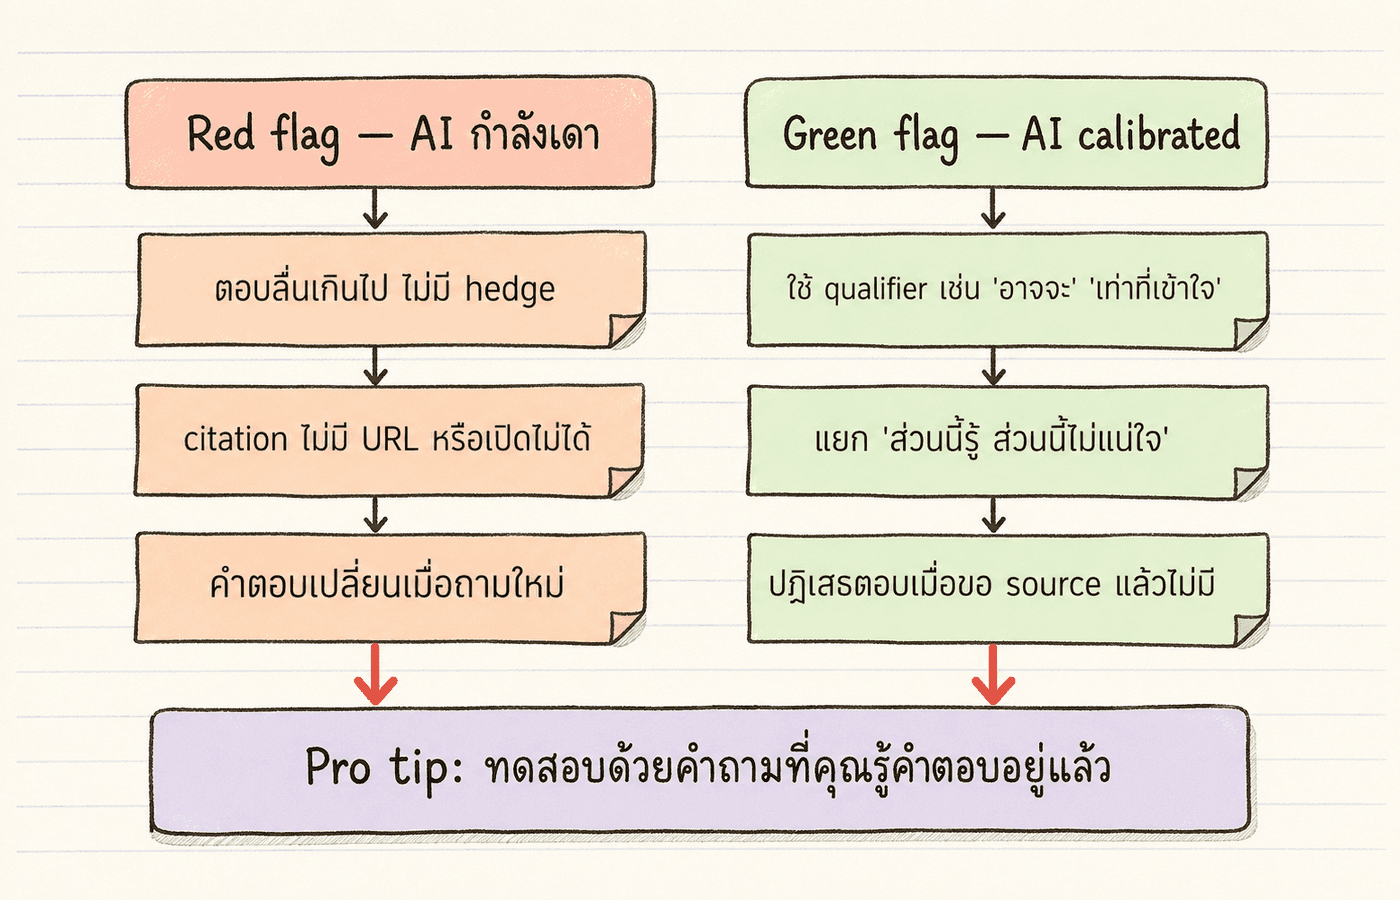
สรุปเป็นเช็กลิสต์สำหรับสังเกตในการใช้งานจริง
สัญญาณเตือน (Red Flags) บ่งบอกว่า AI กำลังเดา
- ภาษาลื่นไหลและมั่นใจเกินเหตุในข้อมูลเฉพาะ เช่น ชื่อคน วันที่ สถิติตัวเลข หรือรหัสเอกสาร
- ให้แหล่งอ้างอิงที่ไม่มีลิงก์จริง หรือลิงก์เปิดไม่ได้ ซึ่งส่วนใหญ่โมเดลแต่ง URL ขึ้นมาเองตามรูปแบบที่คุ้นเคย
- คำตอบเปลี่ยนไปมาเมื่อเปิดห้องแชทใหม่แล้วถามด้วยคำถามเดิม หากข้อมูลจริงคำตอบควรคงที่ การที่เนื้อหาเปลี่ยนบ่อยแสดงว่าเป็นการสุ่มสร้างขึ้นมา
สัญญาณบวก (Green Flags) บ่งบอกว่า AI ตอบตามข้อมูลจริง
- มีการใช้คำบอกขอบเขตความรู้ เช่น 'ตามข้อมูลที่บันทึกไว้ถึง...' หรือ 'เท่าที่ปรากฏในเอกสาร'
- แยกแยะชัดเจนในคำตอบเดียวกันว่าส่วนใดเป็นข้อเท็จจริงที่มั่นใจ และส่วนใดเป็นข้อสันนิษฐาน
- ปฏิเสธการตอบหรือแจ้งตรงๆ ว่าไม่พบแหล่งอ้างอิงเมื่อมีการร้องขอเอกสารยืนยัน
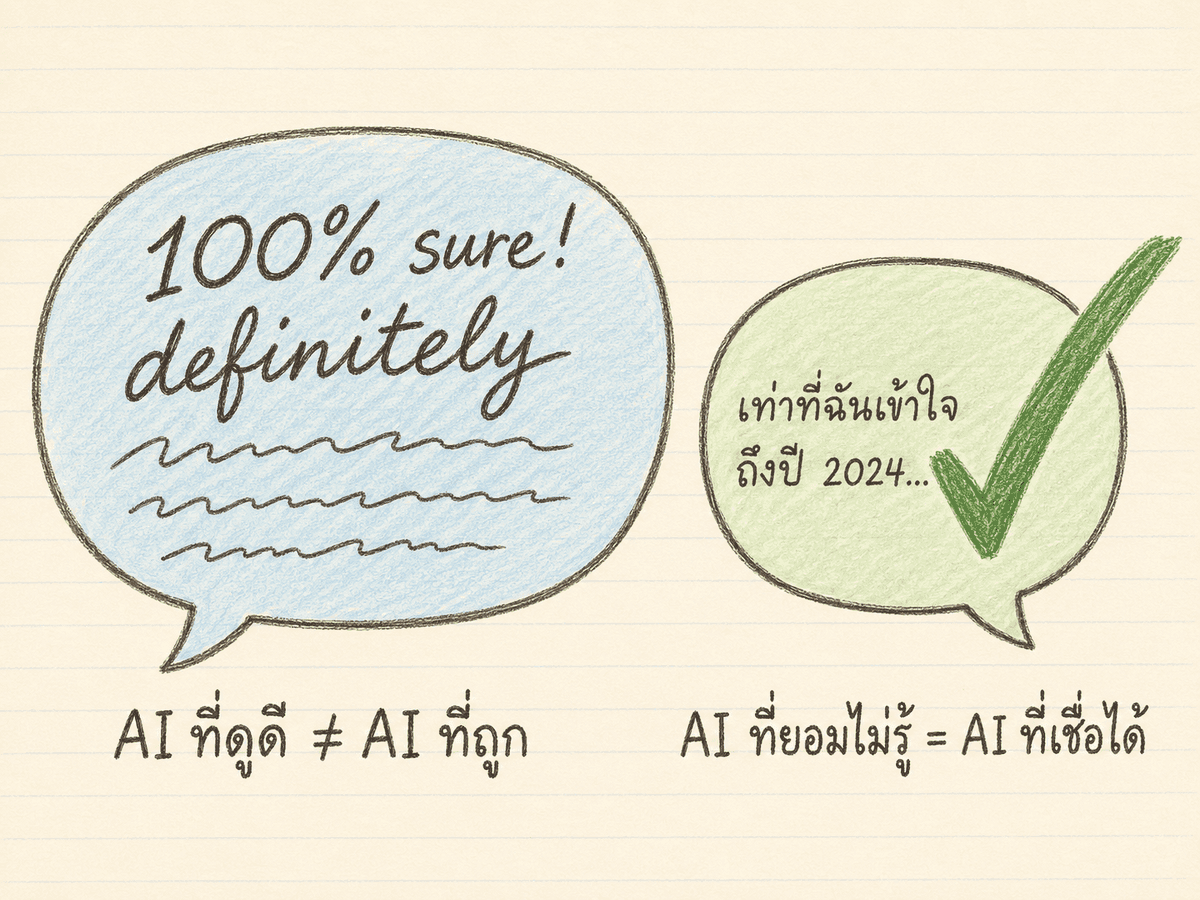
ข้อสำคัญที่ต้องตระหนักคือ น้ำเสียงที่ฟังดูมั่นใจไม่ได้แปลว่าเป็นความจริง บางครั้งโมเดลมั่นใจเพราะรู้จริง แต่หลายครั้งมันมั่นใจเพราะกำลังแต่งเรื่องได้คล่อง เราจึงไม่สามารถตัดสินความถูกต้องจากน้ำเสียงเพียงอย่างเดียว
6. โมเดลขนาดใหญ่กว่าไม่ใช่ทางออก แล้วอะไรคือทางแก้จริง
ความเข้าใจผิดที่พบบ่อยคือคิดว่าเมื่อโมเดลรุ่นใหม่มีขนาดใหญ่ขึ้น อาการ hallucination จะหมดไปเอง การคิดเช่นนี้มองข้ามข้อสรุปสำคัญของ Kalai ตราบใดที่ระบบ Benchmark ยังคงใช้เกณฑ์ให้คะแนนแบบเดิม (ถูกได้ 1 ผิดได้ 0 ไม่ตอบได้ 0) โมเดลทุกรุ่นก็จะยังคงถูกฝึกให้เดาต่อไป ขนาดที่ใหญ่ขึ้นช่วยลดความผิดพลาดเฉพาะในเรื่องที่มีการพูดถึงซ้ำๆ บนอินเทอร์เน็ต แต่ข้อมูลเฉพาะทางหรือ Singleton Facts จะยังคงมีปัญหาอยู่เช่นเดิม
ทางแก้เชิงโครงสร้างที่งานวิจัยเสนอคือการเปลี่ยนระบบแรงจูงใจ (Incentive Structure) ตัวอย่างเช่น การระบุใน Prompt อย่างชัดเจนว่า 'ตอบเฉพาะเมื่อมั่นใจเกิน 75% หากตอบผิดจะถูกหัก 2 คะแนน หากตอบว่าไม่ทราบจะได้ 0 คะแนน และตอบถูกได้ 1 คะแนน' เมื่อการตอบผิดมีต้นทุน โมเดลจะปรับพฤติกรรมเป็นการยอมรับว่าไม่รู้ในเรื่องที่ไม่มั่นใจทันที
สำหรับผู้ใช้งานทั่วไป มีแนวทางจัดการในทางปฏิบัติ 2 แนวทางหลัก
แนวทางแรกคือ RAG (Retrieval-Augmented Generation) ซึ่งเป็นเทคนิคที่ดึงข้อมูลจากแหล่งภายนอกที่เชื่อถือได้ เช่น ฐานข้อมูลเอกสารขององค์กร หรือผลการค้นหาเว็บ มาแนบให้โมเดลอ่านก่อนตอบ วิธีนี้ช่วยลด Factuality Hallucination ได้อย่างมาก เพราะคำตอบจะถูกผูกเข้ากับเอกสารอ้างอิงจริง
แนวทางที่สองคือ การใช้ระบบตรวจคำตอบอัตโนมัติ (Automated Verification) เหมาะกับงานที่มีผลลัพธ์ชัดเจน เช่น การเขียนโค้ดที่สามารถรันเทสต์เพื่อดูผลลัพธ์ได้ทันที หรือการคำนวณทางคณิตศาสตร์ที่มีขั้นตอนพิสูจน์แน่นอน
7. เปลี่ยนคำถามจาก 'AI โกหกไหม' เป็น 'AI กำลังเดาอยู่หรือเปล่า'
อาการ hallucination ไม่ใช่ความพยายามหลอกลวงของ AI ไม่ใช่บั๊กประหลาด และไม่ใช่ความผิดพลาดของผู้พัฒนา แต่มันคือแรงกดดันทางสถิติที่เกิดจากระบบวัดผลที่ฝึกมันขึ้นมา
แทนที่จะตั้งคำถามแบบปลายปิดว่า 'เราเชื่อ AI ได้ไหม' ซึ่งมักได้คำตอบครึ่งๆ กลางๆ ลองเปลี่ยนมาใช้ 3 คำถามนี้ในการพิจารณาคำตอบของ AI
- ข้อมูลนี้เป็นเรื่องทั่วไปหรือเรื่องเฉพาะกลุ่ม หากเป็นเรื่องที่มีการบันทึกซ้ำๆ มากมายบนอินเทอร์เน็ต โมเดลจะตอบได้แม่นยำ แต่หากเป็นข้อมูลเฉพาะองค์กรหรือเรื่องเฉพาะทาง ต้องเพิ่มความระมัดระวังเป็นพิเศษ
- โมเดลใช้คำบอกระดับความมั่นใจหรือไม่ สังเกตคำอย่าง 'อาจจะ' 'ตามที่ระบุ' หรือคำตอบฟังดูราบรื่นและมั่นใจเกินความเป็นจริง
- เรามีกลไกตรวจสอบคำตอบหรือไม่ มีเอกสารอ้างอิงให้เทียบ หรือมีระบบคอมไพล์และรันโค้ดเพื่อตรวจผลลัพธ์หรือไม่
AI ที่มีประโยชน์ไม่ใช่ระบบที่ตอบได้ทุกเรื่องโดยไม่ลังเล แต่คือระบบที่รู้ว่าตนเองไม่รู้อะไร และในฐานะผู้ใช้งาน เมื่อเราเข้าใจว่าระบบถูกฝึกมาให้ตอบอย่างไร เราจะสามารถออกแบบคำสั่งและวางระบบตรวจสอบได้อย่างรัดกุม โดยไม่ต้องกังวลว่าโมเดลรุ่นต่อไปจะเปลี่ยนชื่อหรือเปลี่ยนผู้พัฒนาไปอย่างไร
แหล่งอ้างอิง
- Kalai, A. T., Nachum, O., Vempala, S. S., & Zhang, E. (2025). Why Language Models Hallucinate. arXiv:2509.04664
- Huang, L., Yu, W., Ma, W., et al. (2023). A Survey on Hallucination in Large Language Models: Principles, Taxonomy, Challenges, and Open Questions. arXiv:2311.05232
- Tao, L., Yeh, Y.-F., Dong, M., Huang, T., Torr, P., & Xu, C. (2025). Revisiting Uncertainty Estimation and Calibration of LLMs. arXiv:2505.23854
- OpenAI (2025). Why language models hallucinate (companion blog post)
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin