ทำไม AI นับตัว r ใน strawberry ไม่ถูก เข้าใจกลไกพื้นฐานของ tokenization
AI ตอบเรื่องยากๆ ได้คล่อง แต่นับตัว r ใน strawberry กลับพลาด เพราะมันไม่ได้เห็นข้อความเป็นตัวอักษร แต่เห็นเป็นก้อนที่ประกอบมาเสร็จแล้วก่อนถึงมือ

AI ไม่ได้อ่านข้อความเป็นตัวอักษรทีละตัวแบบที่มนุษย์อ่าน แต่มันมองเห็นข้อความเป็นก้อนสำเร็จรูปที่ผ่านการตัดแบ่งมาล่วงหน้า
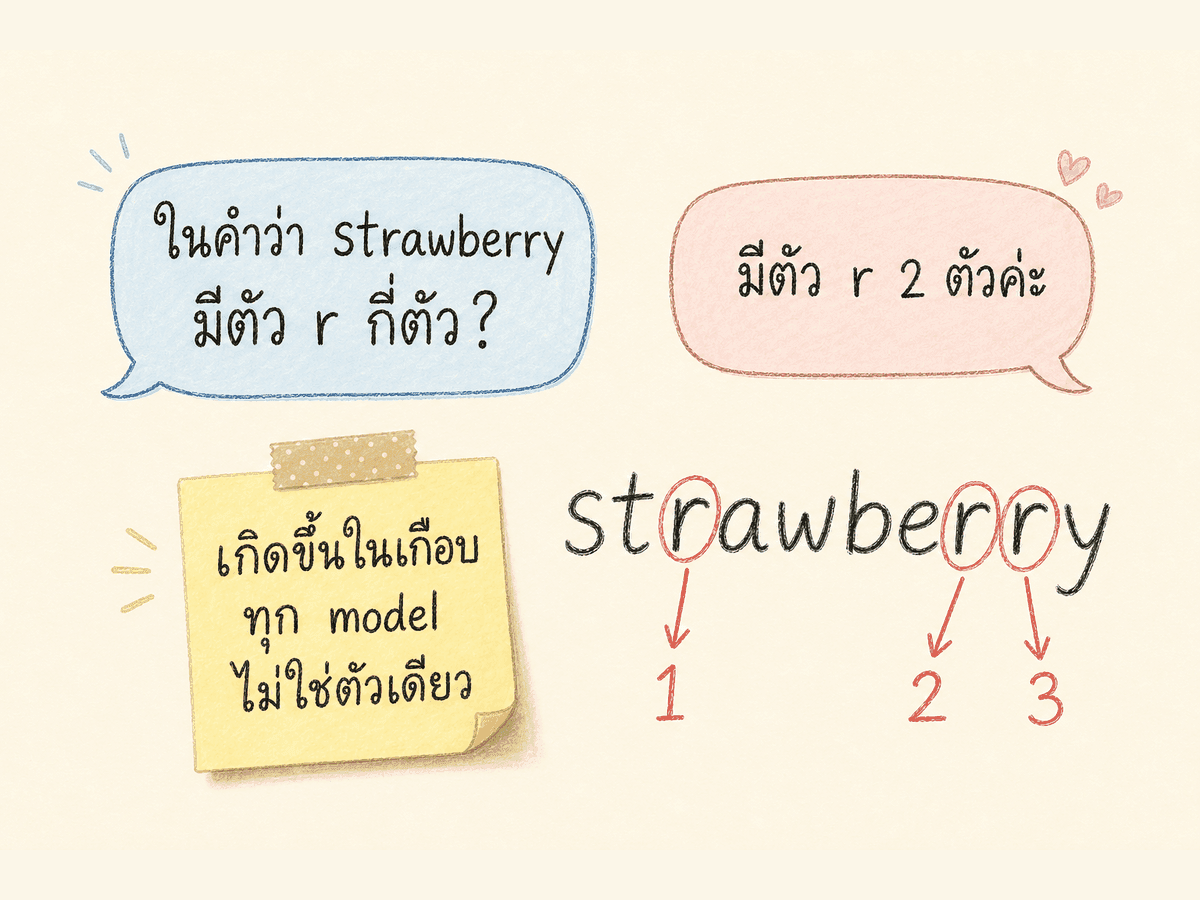
ลองเปิดหน้าต่างแชทแล้วถาม AI ตัวโปรดของคุณว่า "ในคำว่า strawberry มีตัว r กี่ตัว" คำตอบยอดนิยมที่มักจะได้คือ 2 ตัว ทั้งที่ความจริงมี 3 ตัว อาการนี้ไม่ได้เกิดขึ้นกับ AI ตัวใดตัวหนึ่ง แต่เกิดขึ้นกับโมเดลเกือบทุกตัวในวงการ ทั้งที่มันสามารถอธิบายกลไกทางชีวเคมี ถกประเด็นปรัชญา หรือวิเคราะห์ข้อกฎหมายได้อย่างคล่องแคล่ว แล้วทำไมเรื่องการนับตัวอักษรระดับอนุบาลถึงทำให้ AI สะดุดได้ขนาดนี้
ปริศนาตัว r สามตัวที่ AI มักตอบผิด
หากลองพิมพ์ถามในแชทว่า "strawberry มีตัว r กี่ตัว" โมเดลมักจะยืนยันคำตอบว่าเป็น 2 ตัว บางครั้งอาจตอบว่า 1 ตัว ทั้งที่คำสะกดที่ถูกต้องคือ s, t, r, a, w, b, e, r, r, y ซึ่งมีตัว r ทั้งหมด 3 ตัว
เรื่องที่น่าสนใจคือไม่ว่าคุณจะทดสอบด้วย ChatGPT, Claude, Gemini หรือโมเดลโอเพนซอร์สชั้นนำ อาการผิดพลาดนี้ก็ยังปรากฏให้เห็นในรูปแบบที่คล้ายกัน งานวิจัยของ Fu และคณะ (2024) ทดสอบกับโมเดลหลากหลายตระกูลและพบรูปแบบความผิดพลาดที่เกิดขึ้นซ้ำในลักษณะเดียวกัน (Fu et al. 2024) สรุปได้ว่านี่ไม่ใช่ความบังเอิญหรือข้อผิดพลาดชั่วคราว แต่เป็นผลลัพธ์โดยตรงจากสถาปัตยกรรมพื้นฐานของระบบ
ปัญหานี้ไม่ได้เกี่ยวกับความฉลาดของตัว AI แต่อยู่ที่กระบวนการแปลงข้อความก่อนจะส่งเข้าไปให้โมเดลประมวลผล
AI มองเห็นโลกเป็น Token ไม่ใช่ตัวอักษร
ลองจินตนาการถึงตัวต่อเลโก้ชุดสำเร็จรูปที่โรงงานประกอบเป็นโมเดลเด็ก สวมหมวก นั่งในรถ มาให้เรียบร้อยแล้วในกล่อง หากมีใครเดินมาถามว่า "โมเดลเด็กตัวนี้ประกอบจากชิ้นส่วนขนาด 2x2 กี่ชิ้น" เราคงตอบทันทีไม่ได้ เพราะเรามองเห็นเป็นก้อน "เด็ก" สำเร็จรูปทั้งชิ้น ไม่ได้เห็นชิ้นส่วนย่อยข้างใน
AI ประมวลผลข้อความในลักษณะเดียวกัน ก่อนที่ข้อความจะเดินทางไปถึงโมเดล ตัวระบบจะตัดแบ่งข้อความเป็นชิ้นๆ ที่เรียกว่า Token (Token คือหน่วยย่อยของข้อความที่ระบบจัดกลุ่มไว้ล่วงหน้า อาจเป็นคำเต็ม คำบางส่วน หรือพยางค์) จากนั้น Token แต่ละก้อนจะถูกแทนที่ด้วยรหัสตัวเลขประจำตัว (Token ID)
ตัวอย่างเช่น คำว่า "strawberry" ในระบบ Tokenizer ของ GPT-4 ถูกแบ่งออกเป็น 3 ก้อน คือ str + aw + berry และแปลงเป็นรหัสตัวเลข 496, 675, 15717 ตามลำดับ (Cosma et al. 2025) สิ่งที่โมเดลรับรู้และมองเห็นจริงๆ คือลำดับตัวเลข 3 ตัวนี้ ไม่ใช่ตัวอักษร s, t, r, a, w, b, e, r, r, y แบบที่เราเห็นบนหน้าจอ
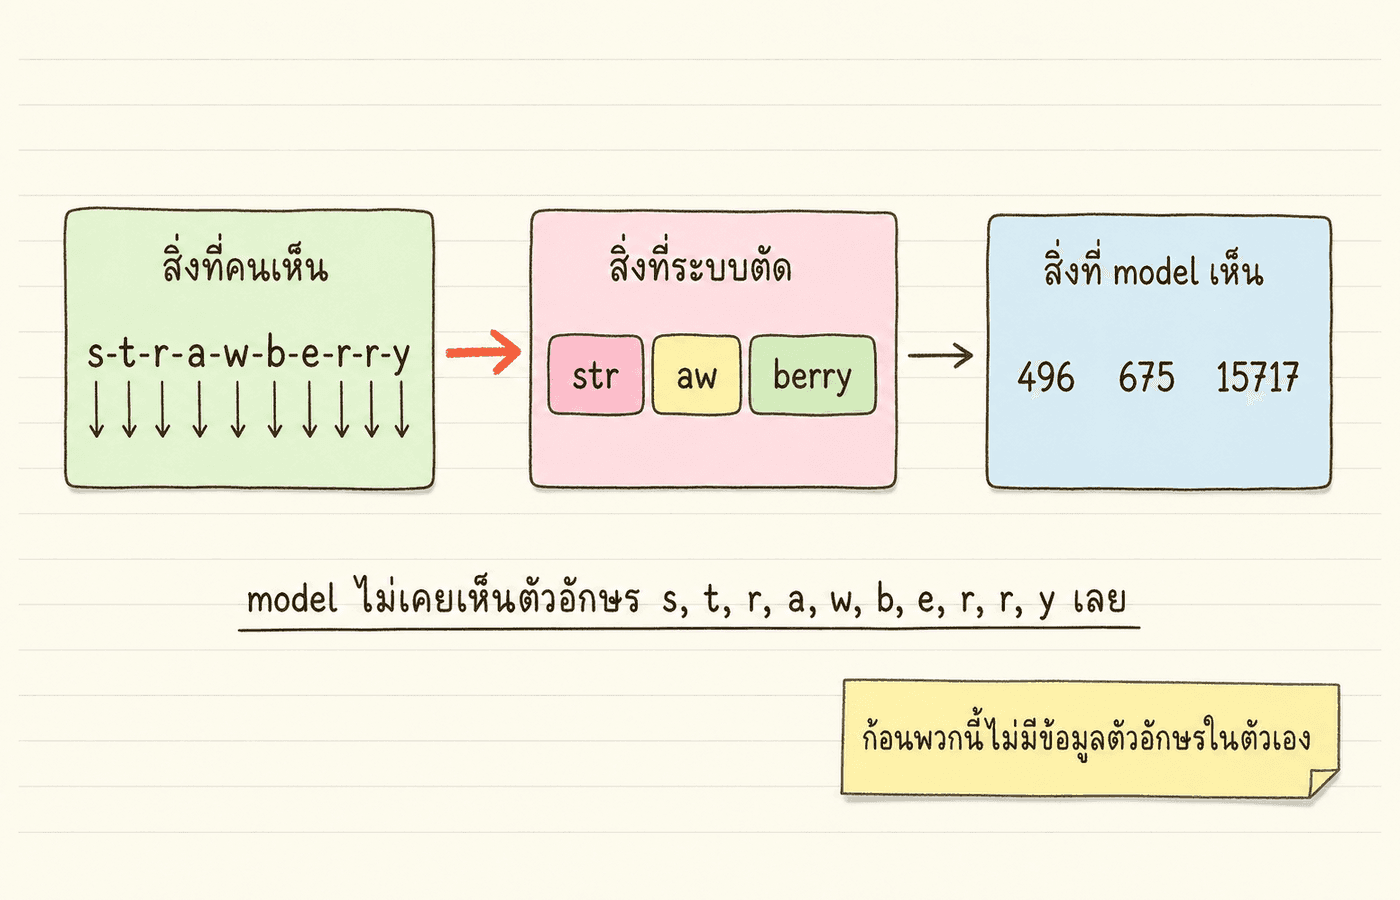
เมื่อเราถามโมเดลว่า "strawberry มีตัว r กี่ตัว" ในมุมมองของโมเดล มันเหมือนการถูกถามว่า "ลำดับรหัส 496, 675, 15717 มีตัวอักษร r กี่ตัว" รหัสตัวเลขเหล่านี้ไม่ได้เก็บข้อมูลตัวอักษรย่อยไว้ในตัว รหัส 496 ไม่ได้บอกว่ามันเกิดจาก s, t, r โมเดลจึงต้องคาดเดาทางอ้อมจากรูปแบบทางสถิติที่เคยเห็นในตอนฝึกสอน ซึ่งบ่อยครั้งการเดานี้ก็คลาดเคลื่อน
ทำไมระบบถึงต้องตัดข้อความเป็นก้อน Token
คำถามตามมาคือทำไมวิศวกรไม่ป้อนตัวอักษรเดี่ยวๆ ทีละตัวให้โมเดลโดยตรง คำตอบสั้นๆ คือเรื่องของ ประสิทธิภาพและความเร็ว
อัลกอริทึมยอดนิยมในการตัดคำชื่อว่า BPE (Byte Pair Encoding) มีหลักการทำงานที่เรียบง่าย ระบบจะกวาดดูข้อมูลข้อความมหาศาล แล้วนับว่าคู่ตัวอักษรไหนปรากฏติดกันบ่อยที่สุด หากพบว่าตัว b กับ e ปรากฏติดกันถี่มาก ระบบจะรวมเป็นก้อนเดียวชื่อ be และเมื่อพบ r กับ r บ่อยๆ ก็รวมเป็น rr ทำกระบวนการนี้ซ้ำไปเรื่อยๆ จนได้คลังคำศัพท์ของ Token ขนาดยักษ์
เปรียบเหมือนโรงงานผลิตชิ้นส่วนสำเร็จรูป หากลูกค้าสั่งคำว่า "berry" บ่อยครั้ง โรงงานจะผลิตชิ้นส่วนสำเร็จรูป "berry" เก็บไว้ในสต็อกทันที เพื่อประหยัดเวลาและพลังงานในการประกอบตัวอักษรทีละตัว
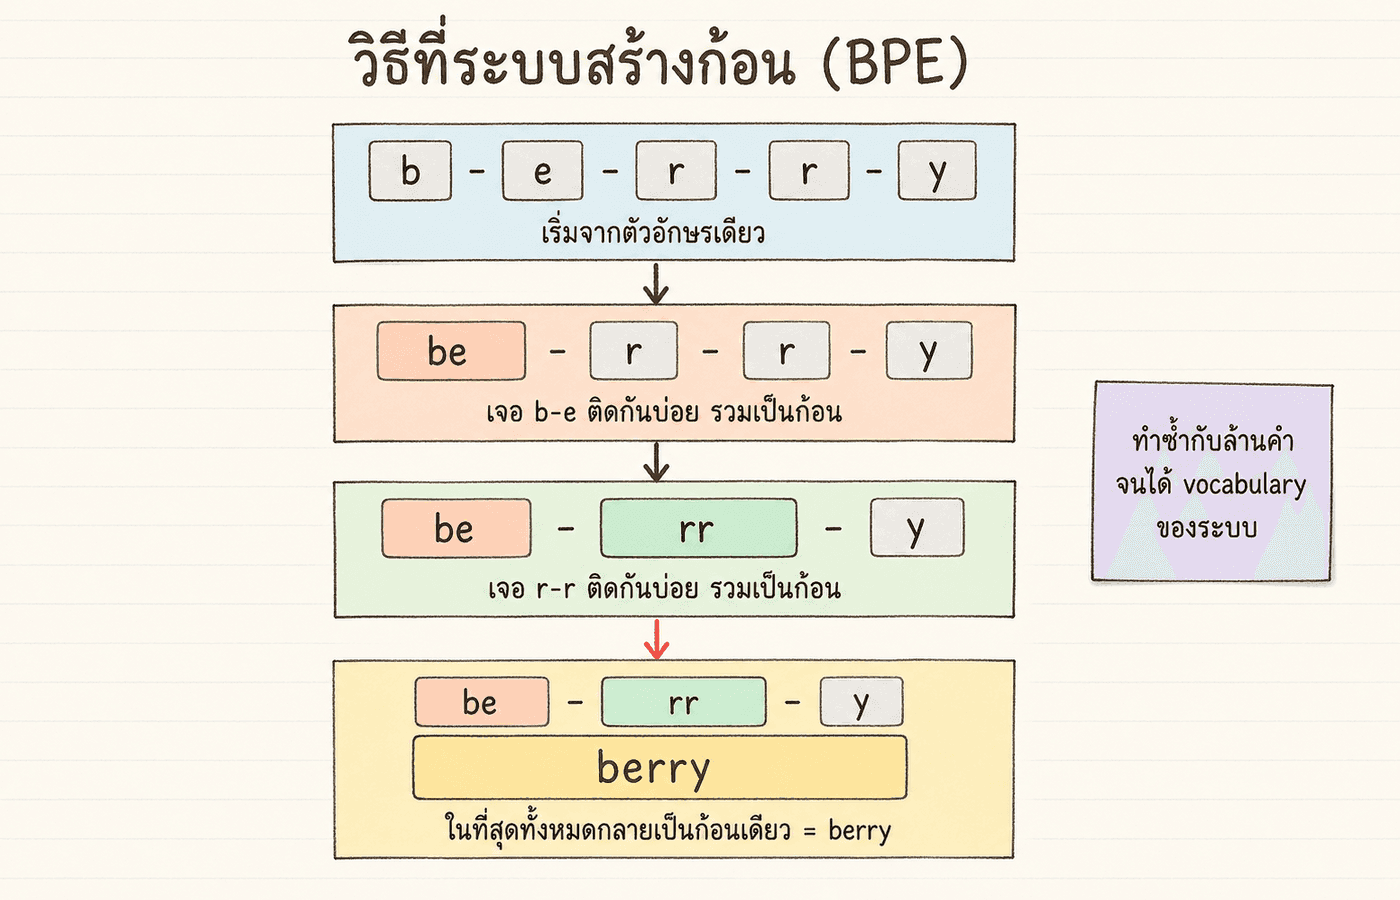
คำที่พบบ่อยในชุดข้อมูลฝึกสอนจะกลายเป็น Token ขนาดใหญ่ชิ้นเดียว ส่วนคำที่พบน้อยจะถูกซอยย่อยออกเป็นหลายชิ้น ซึ่งกลไกนี้นำไปสู่อาการข้างเคียงอื่นๆ ในการทำงานของ AI
ทำไมโมเดลเกือบทุกตัวถึงพลาดเหมือนกัน
งานวิจัยของ Fu และคณะ (2024) (Fu et al. 2024) ค้นพบ 3 ปัจจัยหลักที่กำหนดอัตราความผิดพลาดในการนับตัวอักษร
- ความยาวของคำ คำยิ่งยาว จำนวนก้อน Token ยิ่งเพิ่มขึ้น ทำให้โมเดลต้องอนุมานความสัมพันธ์ระหว่างก้อน Token กับตัวอักษรหลายทอด
- โมเดลจำได้แต่นับไม่ได้ โมเดลมักจะระบุได้ถูกต้องว่าคำนั้นประกอบด้วยตัวอักษรใดบ้าง แต่ไม่สามารถนับจำนวนความถี่ที่ปรากฏได้แม่นยำ
- การปรากฏซ้ำของตัวอักษร ความผิดพลาดจะพุ่งสูงขึ้นทันทีเมื่อตัวอักษรเป้าหมายปรากฏมากกว่า 2 ครั้งขึ้นไปในคำเดียวกัน
คำว่า strawberry เข้าเงื่อนไขความยากครบทุกข้อ เป็นคำยาว 10 ตัวอักษร และมีตัว r ปรากฏซ้ำถึง 3 ครั้ง มันจึงกลายเป็นตัวอย่างคลาสสิกที่ทำให้ระบบ Tokenizer สะดุดอย่างสมบูรณ์แบบ
ผลกระทบอื่นๆ ที่เกิดจากกลไก Tokenization
เมื่อเข้าใจพฤติกรรมของ Token แล้ว เราจะเห็นว่าปัญหาอื่นๆ ในวงการ AI ที่ดูเหมือนคนละเรื่อง ล้วนมีต้นตอมาจากรากฐานเดียวกัน
ภาษาไทยใช้ Token เปลืองกว่าภาษาอังกฤษหลายเท่า
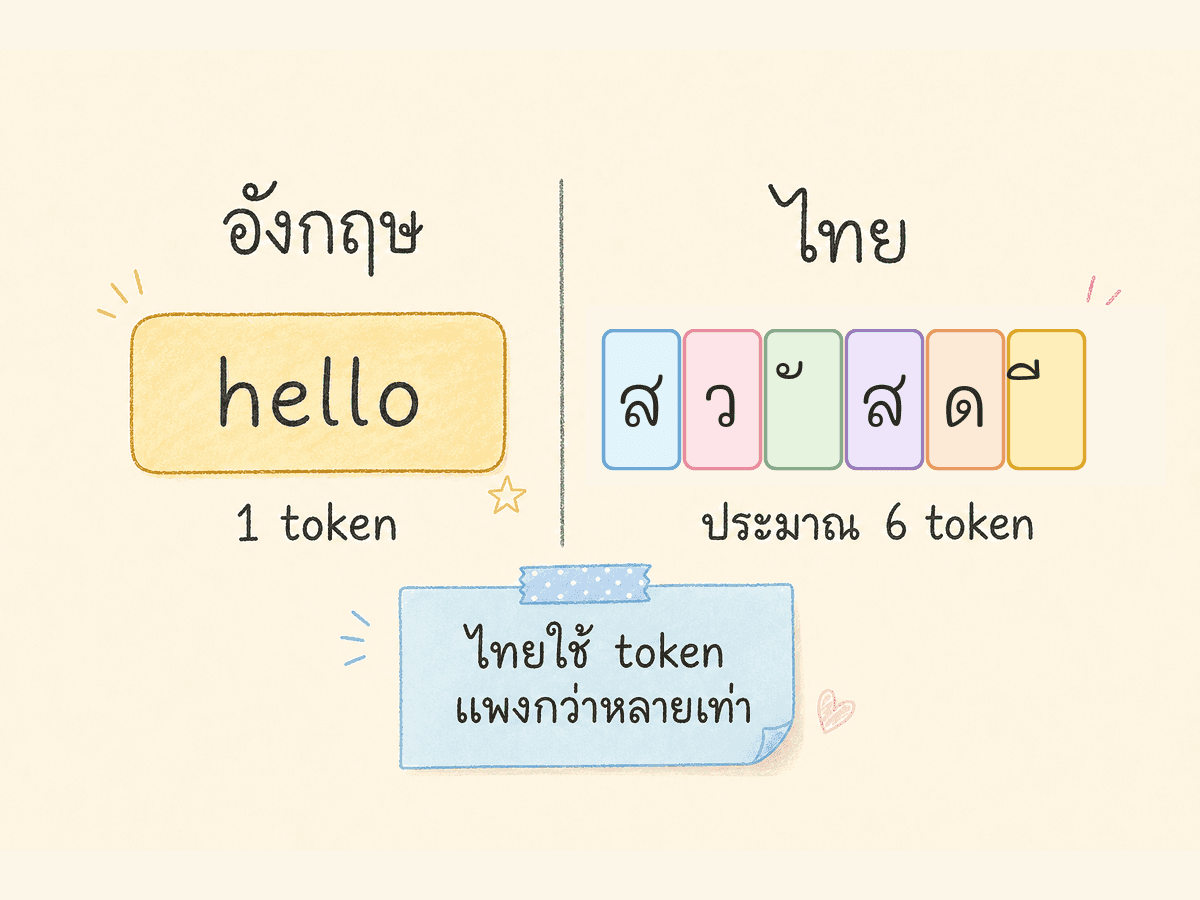
ข้อมูลฝึกสอนของ AI ส่วนใหญ่เป็นภาษาอังกฤษ ระบบ BPE จึงสร้างก้อน Token สำเร็จรูปให้ภาษาอังกฤษไว้อย่างครอบคลุม โดยเฉลี่ยตัวอักษรภาษาอังกฤษ 4 ถึง 5 ตัวจะนับเป็น 1 Token คำอย่าง "hello" จึงนับเป็นเพียง 1 Token
ตรงกันข้าม ภาษาไทยมีสัดส่วนในข้อมูลฝึกสอนน้อยกว่ามาก ระบบจึงต้องหั่นคำภาษาไทยเป็นก้อนย่อยๆ คำว่า "สวัสดี" อาจถูกตัดแบ่งออกถึง 6 Token (สามารถทดสอบได้ผ่านเครื่องมือ tiktoken ของ OpenAI)
ส่งผลให้การเรียกใช้งาน AI ผ่าน API สำหรับภาษาไทยมีค่าใช้จ่ายสูงกว่าภาษาอังกฤษอย่างเห็นได้ชัด ทั้งที่มีจำนวนคำเท่ากัน รวมถึงโมเดลอาจมีความเข้าใจในรูปประโยคภาษาไทยที่ซับซ้อนลดลงเล็กน้อย เพราะหน่วยที่โมเดลประมวลผลไม่สอดคล้องกับพยางค์หรือคำในภาษาไทยจริง
AI คำนวณตัวเลขหลายหลักผิดพลาด
ตัวเลขอย่าง "1234" อาจถูกตัดเป็น "1" + "234" หรือ "1234" ขึ้นอยู่กับการตั้งค่า Tokenizer งานวิจัยของ Singh และ Strouse (2024) (Singh & Strouse 2024) พบว่าโมเดลที่ตัดตัวเลขทีละหลัก (1 หลัก = 1 Token) สามารถคำนวณเลขได้แม่นยำกว่าโมเดลที่รวบตัวเลขหลายหลักเป็น Token เดียวกันอย่างมีนัยสำคัญ
ทั้งการนับตัวอักษร ปัญหา Token ภาษาไทย และการคำนวณเลขผิดพลาด ล้วนมีสาเหตุเดียวกัน คือ หน่วยย่อยที่โมเดลมองเห็น ไม่ตรงกับหน่วยที่งานนั้นจำเป็นต้องใช้
วิธีแก้ปัญหาที่นำไปใช้ได้ทันที
แม้เราจะไม่สามารถเปลี่ยนวิธีที่โมเดลตัด Token ได้โดยตรง แต่เราสามารถปรับเทคนิคการตั้ง Prompt เพื่อบังคับให้โมเดลลดระดับการประมวลผลลงมาที่ระดับตัวอักษรทีละตัวได้
เทคนิคเหล่านี้สามารถประยุกต์ใช้กับงานเอกสารทั่วไปได้เช่นกัน เช่น การนับจำนวนคำเฉพาะในย่อหน้า การนับเซลล์ในตาราง หรือการตรวจสอบรูปแบบตัวเลข
ทำไมการรอโมเดลขนาดใหญ่ขึ้นถึงไม่ใช่คำตอบ
หลายคนอาจคาดหวังว่าเมื่อโมเดลรุ่นถัดไปมีพารามิเตอร์มากขึ้น ปัญหาการนับตัวอักษรจะหมดไป แต่งานวิจัยของ Cosma และคณะ (2025) (Cosma et al. 2025) ชี้ให้เห็นว่าความสามารถระดับตัวอักษร เช่น การนับหรือการสะกดคำย้อนกลับ เกิดขึ้นช้ามากในกระบวนการเทรน ยิ่งคลัง Token มีขนาดใหญ่ ความสามารถนี้ยิ่งพัฒนาได้ยากขึ้น
เหตุผลสำคัญคือบนอินเทอร์เน็ต แทบไม่มีใครเขียนสะกดคำแจกแจงทีละตัวอักษร มนุษย์สื่อสารกันเป็นคำสำเร็จรูป โมเดลจึงได้รับสัญญาณการเรียนรู้ในระดับตัวอักษรน้อยมาก การขยายขนาดโมเดลเพียงอย่างเดียวจึงไม่สามารถแก้ปัญหาเชิงโครงสร้างนี้ได้ทั้งหมด หากต้องการแก้ให้ขาด จำเป็นต้องมีการปรับโครงสร้าง Tokenizer หรือเพิ่มสถาปัตยกรรมที่ช่วยให้ Token เข้าถึงข้อมูลระดับตัวอักษรได้โดยตรง
สรุป
บทเรียนสำคัญคือ AI มองเห็นข้อความเป็นก้อน Token สำเร็จรูป ไม่ใช่ตัวอักษรเดี่ยวๆ
หลักการนี้ช่วยให้เราเข้าใจข้อเท็จจริง 3 ข้อในการใช้งาน AI
- หากงานใดต้องการความละเอียดในระดับที่เล็กกว่าก้อนคำ (เช่น การนับตัวอักษร หรือการตรวจคำสะกด) ต้องสั่งให้ AI แจกแจงองค์ประกอบย่อยออกมาก่อนเสมอ
- ภาษาไทยใช้ Token มากกว่าภาษาอังกฤษ เพราะสัดส่วนข้อมูลในระบบฝึกสอนน้อยกว่า ทำให้ต้นทุน API และการประมวลผลสูงกว่าตามธรรมชาติ
- ความเก่งของ AI ในงานวิเคราะห์ระดับสูง กับความผิดพลาดในงานระดับเด็กอนุบาล ไม่ได้ขัดแย้งกัน ทั้งหมดขึ้นอยู่กับว่างานนั้นสอดคล้องกับขนาดของก้อน Token ที่โมเดลมองเห็นหรือไม่
ครั้งถัดไปที่ AI ให้คำตอบที่ดูผิดพลาดในเรื่องง่ายๆ ลองพิจารณาดูว่าโจทย์นั้นต้องการการมองเห็นในระดับที่เล็กกว่าก้อน Token หรือไม่ แล้วปรับรูปแบบคำสั่งให้ตรงกับธรรมชาติของระบบ
แหล่งอ้างอิง
- Fu, T. et al. (2024). Why Do Large Language Models Struggle to Count Letters?
- Singh, A. K. & Strouse, D. (2024). Tokenization counts: the impact of tokenization on arithmetic in frontier LLMs
- Zhang, X. et al. (2024). Counting Ability of Large Language Models and Impact of Tokenization
- Cosma, A. et al. (2025). The Strawberry Problem: Emergence of Character-level Understanding in Tokenized Language Models
- OpenAI tiktoken (BPE tokenizer)
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin