Karpathy บอกว่าไม่ต้องใช้ RAG: ทำ knowledge base ด้วย folder markdown + Claude Code ใน 5 นาที
Andrej Karpathy โพสต์บน X ว่าเขาทำ personal knowledge base ด้วย folder ของไฟล์ markdown ดิบที่ให้ Claude Code อ่านโดยตรง โดยไม่พึ่ง vector database หรือ embedding ใด ๆ ที่ scale ราว 100 บทความ ครึ่งล้านคำ วิธีนี้ประหยัด token กว่าการคิวรีแบบ naive ถึง 95% และตั้งค่าได้ในห้านาที
Andrej Karpathy จุดกระแสบน X อีกครั้ง เมื่อเขาเปิดเผยว่าตัวเองเลิกใช้ระบบ RAG ที่ซับซ้อนสำหรับ personal knowledge base แล้วเปลี่ยนมาใช้โฟลเดอร์ไฟล์ markdown ดิบๆ ให้ Claude Code อ่านโดยตรง ไม่ต้องพึ่งพา vector database, embedding model หรือ chunking pipeline ใดๆ ในระดับความรู้ประมาณ 100 บทความ (ราว 500,000 คำ) LLM ยุคนี้ดูแล index file สรุปเนื้อหา และวิ่งค้นหาข้อมูลที่เกี่ยวข้องได้แม่นยำเหลือเฟือ
Nate Herk จากช่อง Nate Herk | AI Automation ได้หยิบแนวคิดนี้มาทดลอง setup จริงในเวลาเพียง 5 นาทีด้วย Obsidian ร่วมกับ Claude Code พร้อมยกเคสจริงจากชุมชนนักพัฒนาบน X ที่รายงานว่าวิธีนี้ช่วยลดการใช้ token ลงได้ถึง 95% เมื่อเทียบกับการโยน context ทั้งก้อนแบบเดิม
ทำไมโครงสร้าง Folder ธรรมดาถึงพอ: มุมมองของ Karpathy
Karpathy อธิบายแนวคิดนี้ไว้อย่างน่าสนใจว่า เดิมทีเขาคิดว่าต้องพึ่งพาเทคนิค RAG ที่หรูหราซับซ้อน แต่ปรากฏว่า LLM ปัจจุบันเก่งพอที่จะดูแล index files และสรุปเนื้อหาของทุกเอกสารได้เองแบบอัตโนมัติ ทั้งยังอ่านและดึงข้อมูลสำคัญมาเชื่อมโยงกันในระดับ small scale ได้อย่างสบายๆ
ในสเกลระดับที่ Karpathy ใช้งาน (ประมาณ 100 บทความ รวม 500,000 คำ) Claude Code สามารถสแกนโครงสร้างโฟลเดอร์ อ่านไฟล์ดัชนี และเปิดอ่านเฉพาะไฟล์ที่เกี่ยวข้องได้ในรอบเดียว ต่างจากระบบ RAG ทั่วไปที่ต้องตัดย่อยข้อความเป็นชิ้นเล็กๆ (chunks) แปลงเป็น vector แล้วเก็บลงใน database แถมยังต้องคอย re-embed ใหม่ทุกครั้งที่มีการแก้ไขข้อมูล แต่วิธีของ Karpathy ทุกอย่างคือ markdown ดิบ หากต้องการแก้ไขหรือเพิ่มข้อมูล ก็แค่พิมพ์ลงในไฟล์ได้ทันที
ข้อได้เปรียบสำคัญอีกจุดคือ "Relationship Depth" หรือความลึกของการเชื่อมโยงเนื้อหา เพราะระบบ RAG มักค้นหาจาก similarity score ของแต่ละท่อนข้อความ ซึ่งบางครั้งได้ผลลัพธ์ที่ตัดตอนหรือผิวเผิน ขณะที่ Claude Code สามารถกวาดอ่านทั้งโฟลเดอร์เมื่อจำเป็น ทำให้มองเห็นลิงก์ข้ามบทความ แท็กของแต่ละคอนเซปต์ และความสัมพันธ์เชิงลึกที่ระบบ embedding ทั่วไปมองข้ามไป
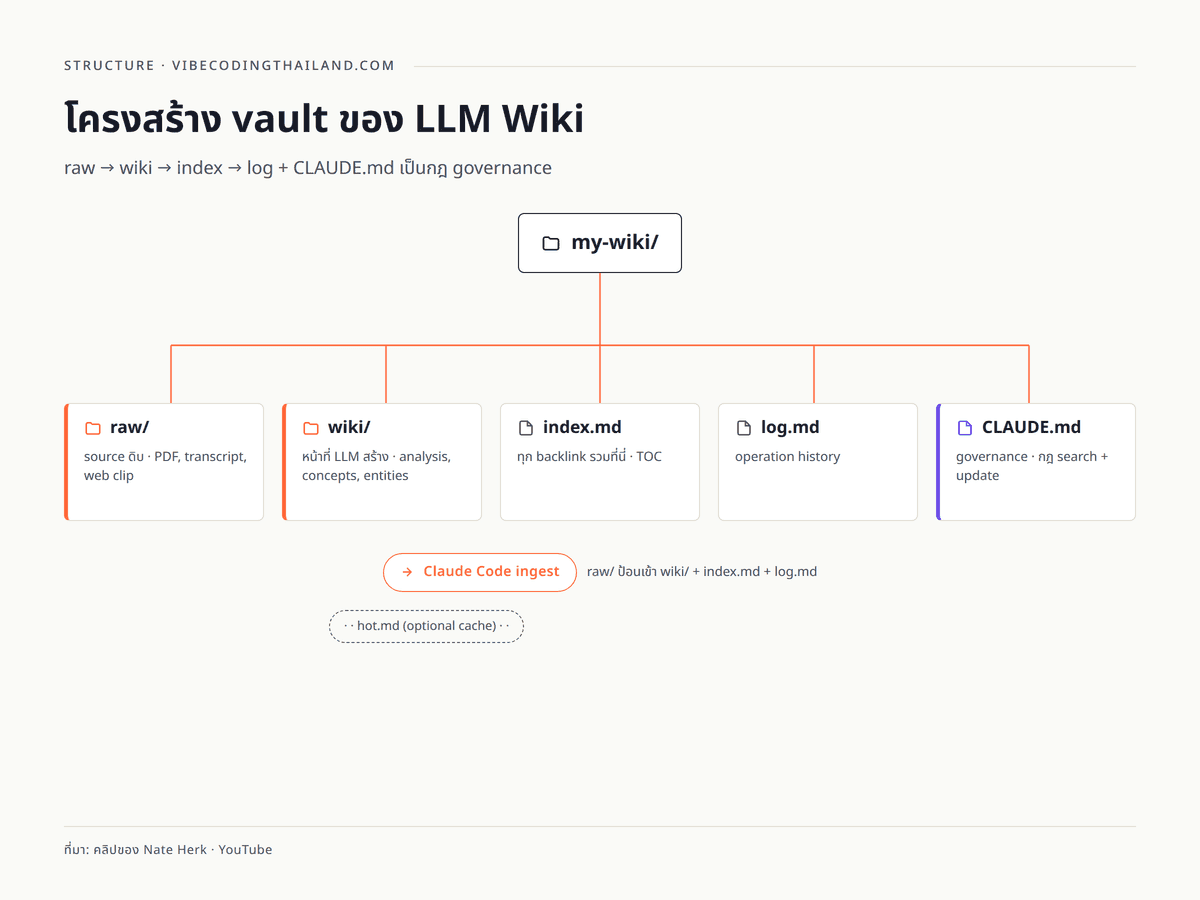
โครงสร้างโฟลเดอร์ของ LLM Wiki: raw, wiki, index, log และ CLAUDE.md
โครงสร้างคลังความรู้แบบนี้เรียบง่ายมาก ทุกอย่างเป็นไฟล์ markdown ล้วนๆ ภายในโฟลเดอร์หลักของโปรเจกต์ประกอบด้วย 5 ส่วนสำคัญ:
raw/แหล่งเก็บข้อมูลดิบทั้งหมด ไม่ว่าจะเป็นบทความที่ตัดมาจากเว็บ, transcript ของ YouTube หรือข้อความจาก PDF โยนเข้ามาเก็บไว้ตรงๆ ได้เลยโดยไม่ต้องจัดรูปแบบwiki/โฟลเดอร์ที่ Claude Code สร้างขึ้นจากการอ่านraw/แล้วย่อยแยกหมวดหมู่อัตโนมัติ โดยค่าเริ่มต้นมักแบ่งเป็น 4 โฟลเดอร์ย่อยคือanalysis,concepts,entities,sourcesหรือจะจัดโครงสร้างแบบ flat ตามสไตล์ที่ Karpathy ชอบก็ได้index/หรือไฟล์index.mdสารบัญหลักที่ LLM ดูแลและอัปเดตเอง รวบรวมหัวข้อสำคัญ เช่น เครื่องมือ, เทคนิค, บุคคล, แนวคิด พร้อมทำ backlink เชื่อมโยงไปยังหน้า wiki ที่เกี่ยวข้องlog/หรือไฟล์log.mdบันทึกประวัติการนำเข้าข้อมูล (ingestion history) ระบุว่าเพิ่มเนื้อหาอะไรเข้ามาเมื่อไหร่ ช่วยให้ตรวจสอบย้อนหลังได้ง่ายCLAUDE.mdไฟล์กำหนดกฎระเบียบ (governance) อธิบายว่าคลังความรู้นี้ทำหน้าที่อะไร มีแนวทางการค้นหาและอัปเดตอย่างไร รวมถึงบอก agent ตัวอื่นว่าจะเข้ามาค้นข้อมูลใน wiki นี้เมื่อใด
นอกจากนี้ Nate Herk ยังยกตัวอย่าง vault ส่วนตัวชื่อ "Herc Brain" ที่เพิ่มไฟล์ hot.md ขนาดประมาณ 500 คำ ไว้เก็บ cache ของบริบทล่าสุดที่คุยกับผู้ช่วยส่วนตัว เพื่อช่วยลดการอ่านไฟล์ทั้ง wiki เมื่อต้องการถามตอบเรื่องที่เพิ่งเกิดขึ้น
สเต็ป Setup ใน 5 นาที: Obsidian + Claude Code + Starter Prompt
การตั้งค่าคลังความรู้ใหม่สามารถทำตามได้ง่ายๆ ใน 3 ขั้นตอน:
- ดาวน์โหลด Obsidian จาก obsidian.md เพื่อใช้เป็นโปรแกรมเปิดดูไฟล์ markdown และดูความเชื่อมโยงของข้อมูลผ่าน Graph View (จริงๆ จะใช้ text editor ตัวไหนก็ได้ แต่ Obsidian ช่วยให้เห็นภาพรวมของความรู้ได้ชัดเจนที่สุด)
- สร้าง vault ใหม่ เปิดโฟลเดอร์นั้นใน Terminal แล้วรันคำสั่ง
claudeเพื่อเปิดใช้งาน Claude Code - วาง prompt เริ่มต้นของ Karpathy ลงไป เพื่อให้ Claude Code เริ่มสร้างระบบให้ทันที:
You are now my LLM Wiki agent. Implement this exact idea file as my
complete second brain. Guide me step-by-step. Create the claude.md
schema, the raw/ folder, the wiki/ folder, the index, and the log.
Ask me what this project is for so the structure fits the use case.
เมื่อ Claude Code อ่านคำสั่งเสร็จ จะถามจุดประสงค์การใช้งาน เช่น ใช้เป็น second brain ส่วนตัว, งานวิจัยเฉพาะด้าน หรือคลังความรู้ของธุรกิจ เพื่อปรับแต่งโครงสร้างโฟลเดอร์ให้เข้ากับโจทย์
หลังจากตั้งค่าเสร็จ เมื่อมีข้อมูลใหม่เข้ามา เพียงแค่นำไฟล์ไปวางใน raw/ แล้วสั่ง Claude Code สั้นๆ ว่า "ingest the new article" ระบบจะอ่านต้นฉบับ ถามระดับความละเอียดที่ต้องการ แล้วแยกเนื้อหาออกเป็นหน้า wiki ย่อยๆ พร้อมเชื่อมโยง backlink ให้อัตโนมัติ เช่น บทความขนาดยาวชิ้นเดียวถูกแตกออกเป็น 23 หน้า wiki พร้อมจัดหมวดหมู่บุคคล องค์กร และแนวคิดต่างๆ ภายในเวลาไม่กี่นาที
เบื้องหลังความประหยัด Token: เคสลดการใช้ 95% และความรู้ที่ต่อยอดได้จริง
จุดเด่นของ pattern นี้ไม่ได้มีแค่ความง่าย แต่รวมถึงความคุ้มค่าของ token ด้วย มีผู้ใช้บน X นำไฟล์กระจัดกระจาย 383 ไฟล์ พร้อม meeting transcripts กว่า 100 รายการ มาแปลงเป็น compact wiki ตามแนวทางนี้ แล้วพบว่า token usage ลดลงถึง 95% เมื่อเทียบกับการโยนไฟล์ดิบทั้งหมดเข้าไปใน context ทุกครั้ง
กลไกที่ช่วยประหยัด token มี 2 ส่วนสำคัญ:
- การมี index file ที่ดี ทำให้ Claude Code เปิดดูสารบัญก่อน แล้วเลือกโหลดเฉพาะหน้าที่จำเป็นต่อคำถามนั้นๆ เข้า context
- หน้าใน
wiki/ผ่านการสรุปและจัดระเบียบเนื้อหามาแล้ว ทำให้สกัดคำตอบได้กระชับกว่าการไล่อ่านจากไฟล์ดิบ
Nate Herk เสริมว่าในไฟล์ CLAUDE.md ของ agent ควรกำหนดคำสั่งชัดเจน เช่น "Don't read from the wiki unless you actually need it" เพื่อป้องกันไม่ให้ agent ดึงข้อมูลโดยไม่จำเป็น
นอกจากนี้ ประโยชน์ระยะยาวคือความรู้จะสะสมแบบ compound คล้ายดอกเบี้ยทบต้น แตกต่างจากการคุยกับ AI แบบทั่วไปที่ความรู้จะหายไปเมื่อจบเซสชัน แต่ LLM Wiki จะเก็บบันทึกและต่อยอดความรู้ไปเรื่อยๆ ทำให้ AI ทำงานเหมือนเพื่อนร่วมทีมที่จำบริบทโปรเจกต์ได้ครบถ้วน
ขอบเขตและ Trade-off: เมื่อไหร่ควรใช้ เมื่อไหร่ควรเลี่ยง
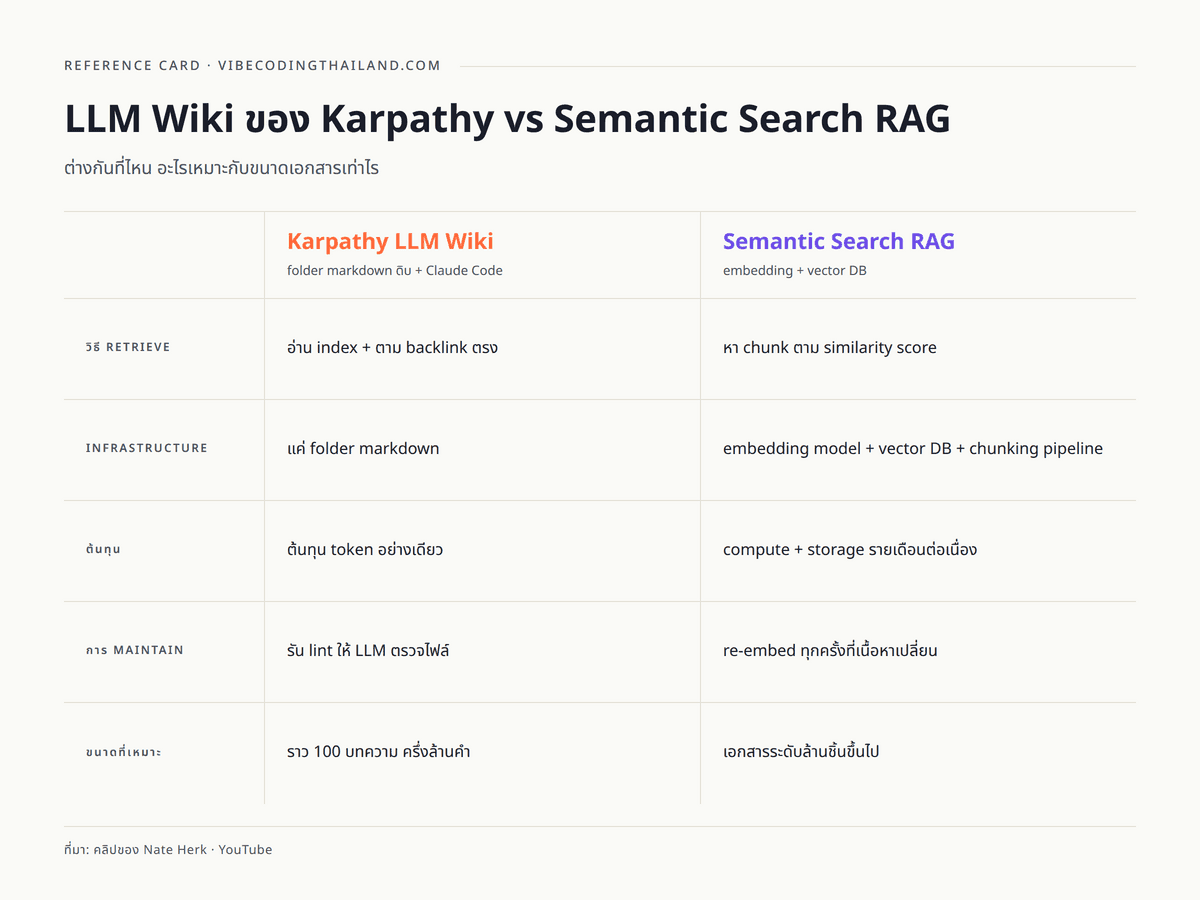
เมื่อเปรียบเทียบระหว่าง Karpathy LLM Wiki กับ Semantic Search RAG ทั่วไป จะเห็นความแตกต่างใน 5 มิติ:
- Retrieval Mechanism: LLM Wiki ใช้การอ่าน index แล้วตาม backlink ไปยังไฟล์ที่เกี่ยวข้อง ทำให้เข้าใจความสัมพันธ์เชิงโครงสร้างได้ลึกซึ้ง ส่วน RAG ค้นหาด้วย similarity score จึงเก่งในการจับท่อนข้อความที่คล้ายกัน แต่อาจขาดบริบทภาพรวม
- Infrastructure: LLM Wiki ใช้เพียงโฟลเดอร์ไฟล์ markdown ในเครื่อง ไม่ต้องตั้ง vector database หรือรัน embedding pipeline ให้ซับซ้อน
- Cost: LLM Wiki มีเพียงค่า token ตอน ingest และ query เท่านั้น ไม่มีค่าเซิร์ฟเวอร์หรือ database รายเดือน
- Maintenance: LLM Wiki ดูแลด้วยการให้ Claude Code ทำ lint ตรวจสอบความสอดคล้อง อัปเดตข้อมูลที่ขาด และเชื่อมโยงเนื้อหาใหม่ๆ เป็นระยะ ส่วน RAG ต้อง re-embed ใหม่เมื่อข้อมูลเปลี่ยน
- Scale: นี่คือข้อจำกัดสำคัญที่สุด LLM Wiki เหมาะกับเอกสารระดับหลักร้อยถึงพันไฟล์ หากระบบใหญ่ขึ้นถึงระดับหลายหมื่นหรือล้านเอกสาร การใช้ RAG หรือ Knowledge Graph ระดับ enterprise ยังเป็นคำตอบที่จำเป็น
สำหรับนักพัฒนาที่ใช้งาน Claude Code อยู่แล้ว แนวทางนี้แทบไม่มีต้นทุนเริ่มต้นในการทดลอง จุดสำคัญไม่ได้อยู่ที่ตัวเครื่องมือ แต่อยู่ที่การเปลี่ยนวิธีคิด ว่าคลังความรู้ส่วนบุคคลไม่จำเป็นต้องพึ่งพาระบบ infrastructure ที่ซับซ้อนเสมอไป เมื่อ LLM รุ่นปัจจุบันฉลาดพอที่จะจัดการโครงสร้างไฟล์และค้นหาข้อมูลให้เราได้แบบตรงไปตรงมา
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Vibe Coding สำหรับคนไม่ใช่โปรแกรมเมอร์ ใช้ Claude Code สร้าง landing page, mini app และ prototype จริงโดยไม่ต้องเขียนโค้ด
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Vibecoding · The Developer's Playbook
ฉบับภาษาไทย 10 บท พา dev สร้าง Personal Finance Tracker (LINE OA + AI จัดหมวดอัตโนมัติ) ตั้งแต่โครงโปรเจกต์บรรทัดแรกจนแอปทำงานจริงบน server