Sean Goedecke ชี้ว่าเมื่อโมเดลเร็วพอ DevEx จะเป็นคอขวด โดย coding agent จะเสียเวลารอเทสต์กับ dev loop ของเราเอง
Sean Goedecke ชี้ว่าเมื่อโมเดลเร็วพอ เทสต์กับ dev loop ของเราเองจะกลายเป็นคอขวดของ coding agent อ่านต่อเพื่อดู 4 จุดที่จับเวลาและแก้ได้ตั้งแต่วันจันทร์
สั่งงาน AI ที่แก้โค้ดทั้งโปรเจกต์อย่าง coding agent เช่น Claude Code หรือ Codex แล้วนั่งรอมันคิด สลับหน้าจอไปตอบแชต แล้วค่อยวนกลับมาดูว่าทำงานเสร็จหรือยัง
ภาพแบบนี้คือจุดเริ่มต้นของบทความสั้นของ Sean Goedecke ซึ่งประเด็นหลักที่เขาชี้ให้เห็นก็คือ จุดที่ทำให้เราเสียเวลารอกำลังจะเปลี่ยนไป
ทุกวันนี้เราเสียเวลานั่งรอโมเดลคิด แต่โมเดล AI กำลังเร็วขึ้นเรื่อยๆ และในวันที่โมเดลเร็วมากพอ คอขวดจะไม่ใช่ตัวโมเดลอีกต่อไป แต่จะย้ายมาอยู่ที่ฝั่งเราแทน ทั้งการรันเทสต์ การคอมไพล์ และรอบ dev loop ที่เราต้องแก้โค้ด รันเทสต์ แล้วดูผลวนซ้ำไปมาทั้งวัน ซึ่งเป็นเรื่องที่เราเริ่มปรับปรุงได้ตั้งแต่วันนี้
บทความของเขาเป็นเพียงความคิดเห็นส่วนตัว ไม่มีผลการทดลองทางสถิติรองรับ แต่มุมมองและตัวเลขที่เขายกขึ้นมาเปรียบเทียบนั้นเห็นภาพชัดเจนมาก จนเรานำวิธีคิดนี้มาลองจับเวลาในโปรเจกต์ของตัวเองได้ทันที
ทุกวันนี้ DevEx วัดกันเป็นวินาที เร็วกว่านั้นก็ยังแทบไม่มีผล
DevEx หรือประสบการณ์การทำงานของนักพัฒนา คือความสะดวกและความเร็วในการทำงานกับเครื่องมือต่างๆ ตั้งแต่การรันเทสต์ การคอมไพล์ ไปจนถึงเซิร์ฟเวอร์ทดสอบอย่าง dev server ที่ช่วยรีโหลดหน้าเว็บให้อัตโนมัติหลังแก้โค้ด
เขาให้เกณฑ์เปรียบเทียบง่ายๆ ว่า ถ้าเทสต์รันจบภายใน 1 วินาทีถือว่าดีมาก แต่ถ้าใช้เวลาถึง 30 วินาทีถือว่าช้าเกินไป แต่การทำให้เทสต์รันเร็วกว่า 1 วินาทีนั้น แทบไม่ได้ช่วยให้เราทำงานเสร็จเร็วขึ้นเลย เพราะเวลาส่วนใหญ่ในแต่ละวันหมดไปกับสองเรื่อง คือนั่งคิดเอง กับนั่งรอให้ agent ทำงานเสร็จ
ดังนั้น การลดเวลารีโหลดหน้าเว็บของ dev server ลงอีกเพียงไม่กี่มิลลิวินาทีในทุกวันนี้จึงแทบไม่เห็นความต่าง เพราะไม่ใช่จุดที่ทำให้เราเสียเวลาจริงๆ
สิ่งสำคัญคือ คำว่า "ไม่มีผล" ในที่นี้ หมายถึงสถานการณ์ทุกวันนี้เท่านั้น ไม่ได้แปลว่าความเร็วของเครื่องมือไม่มีความหมาย เพียงแต่ยังไม่ใช่คอขวดหลัก และสิ่งที่เขาเตือนไว้ก็คือ สิ่งนี้กำลังจะกลายมาเป็นคอขวด
เมื่อโมเดลขนาดเล็กทำงานเร็วขึ้น และโมเดลที่ฉลาดก็มีขนาดเล็กลง คอขวดจะย้ายที่
เหตุผลที่เขาฟันธงแบบนั้น มาจากสองทิศทางของเทคโนโลยี AI ที่กำลังพัฒนามาบรรจบกัน นั่นคือ โมเดลขนาดเล็กกำลังทำงานได้เร็วขึ้นเรื่อยๆ ขณะที่โมเดลที่ฉลาดมากๆ ก็มีขนาดเล็กลงเรื่อยๆ เช่นกัน
เขามองว่า สำหรับงานยากๆ วิศวกรส่วนใหญ่คงยังเลือกใช้โมเดลที่ฉลาดที่สุดอยู่ดี เพราะงานพัฒนาซอฟต์แวร์ซับซ้อนมาก แต่เราจะเริ่มเห็นคนนำโมเดลที่เร็วมากๆ มาใช้เป็น subagent คอยรับงานย่อยที่ agent หลักแบ่งให้ทำ หรือนำมาใช้กับงานที่ไม่ซับซ้อนและเข้าใจขั้นตอนดีอยู่แล้วมากขึ้นเรื่อยๆ
เขายังยอมรับว่า เรื่องนี้ยังเป็นเรื่องใหม่ที่แทบไม่มีใครเคยสัมผัสมาก่อน เพราะทุกวันนี้แทบไม่มีใครนึกภาพออกเลยว่า การทำงานร่วมกับ agent ที่สร้างหน่วยย่อยของข้อความอย่าง token ได้เร็วระดับหลายพันตัวต่อวินาทีนั้น จะให้ความรู้สึกแบบไหน
ความเร็ว 60 กับ 17,000 token ต่อวินาที ให้ความรู้สึกต่างกันแค่ไหน
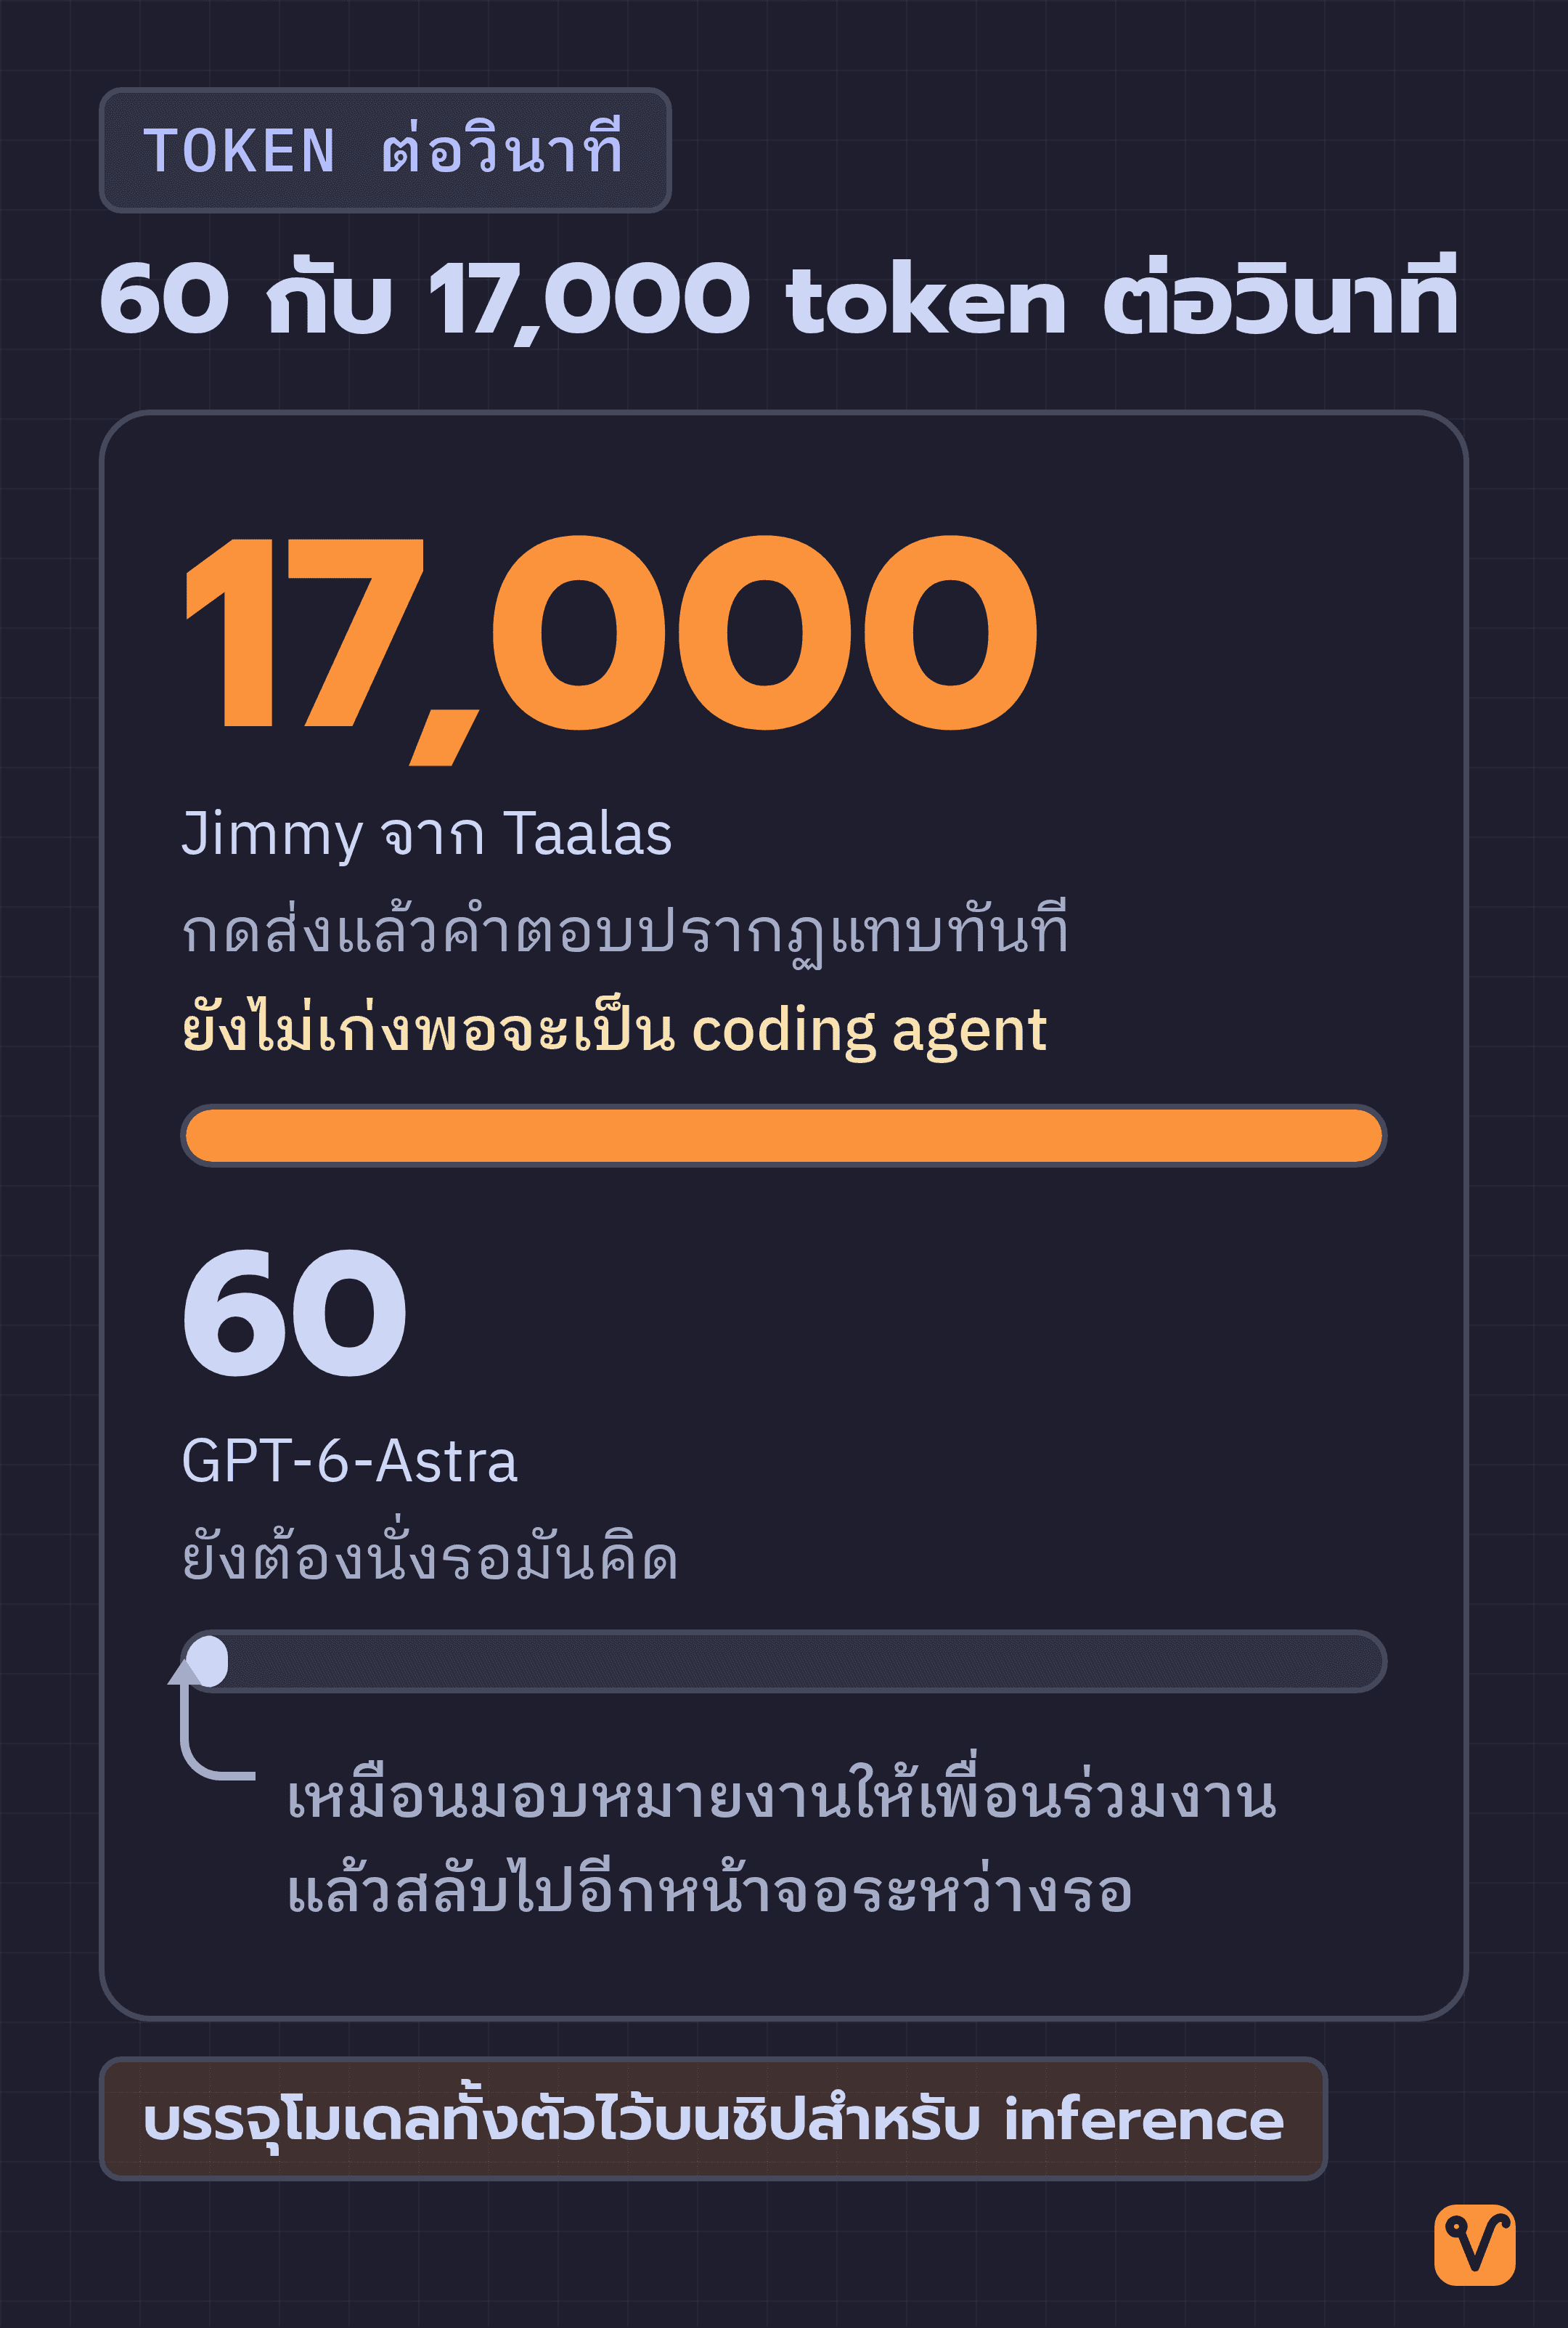
ผู้เขียนยกตัวเลขความเร็วสองระดับมาเปรียบเทียบเพื่อให้เห็นภาพชัดเจนขึ้น
ฝั่งแรกคือโมเดลอย่าง GPT-6-Astra ที่เร็วประมาณ 60 token ต่อวินาที ที่ระดับความเร็วนี้ เรายังต้องใช้เวลารอมันคิดค่อนข้างนาน การทำงานกับมันจึงเหมือนมอบหมายงานให้เพื่อนร่วมงานสักคน แล้วสลับหน้าจอไปทำงานอื่นเพื่อรองานเสร็จ
ส่วนอีกฝั่งคือ Jimmy โมเดล LLaMA-3.1-8B เวอร์ชันที่บริษัท Taalas นำมาให้บริการ โมเดลนี้ทำความเร็วได้สูงถึงประมาณ 17,000 token ต่อวินาที ไม่ว่าคำตอบจะยาวแค่ไหน เพียงแค่กดส่ง คำตอบก็ปรากฏขึ้นมาแทบจะทันที
แม้เขาจะบอกชัดเจนว่าโมเดลตัวนี้ยังไม่เก่งพอจะนำมาใช้เป็น coding agent จริงๆ แต่มันก็ทำให้เราเห็นภาพล่วงหน้าได้ชัดเจนว่า โลกที่ AI ตอบกลับได้ทันทีนั้นเป็นอย่างไร
ความเร็วระดับนี้เกิดจากการนำโมเดลทั้งตัวไปบรรจุลงบนชิปที่ออกแบบมาเพื่อทำ inference โดยเฉพาะ หรือขั้นตอนที่โมเดลรับคำสั่งแล้วประมวลผลคำตอบออกมา ซึ่งกรณีของ Taalas คือการฝังโมเดลลงไปในเนื้อชิปซิลิคอนโดยตรง
ถ้าจะให้คำตอบมาทันที tool call ก็ต้องเร็วด้วย
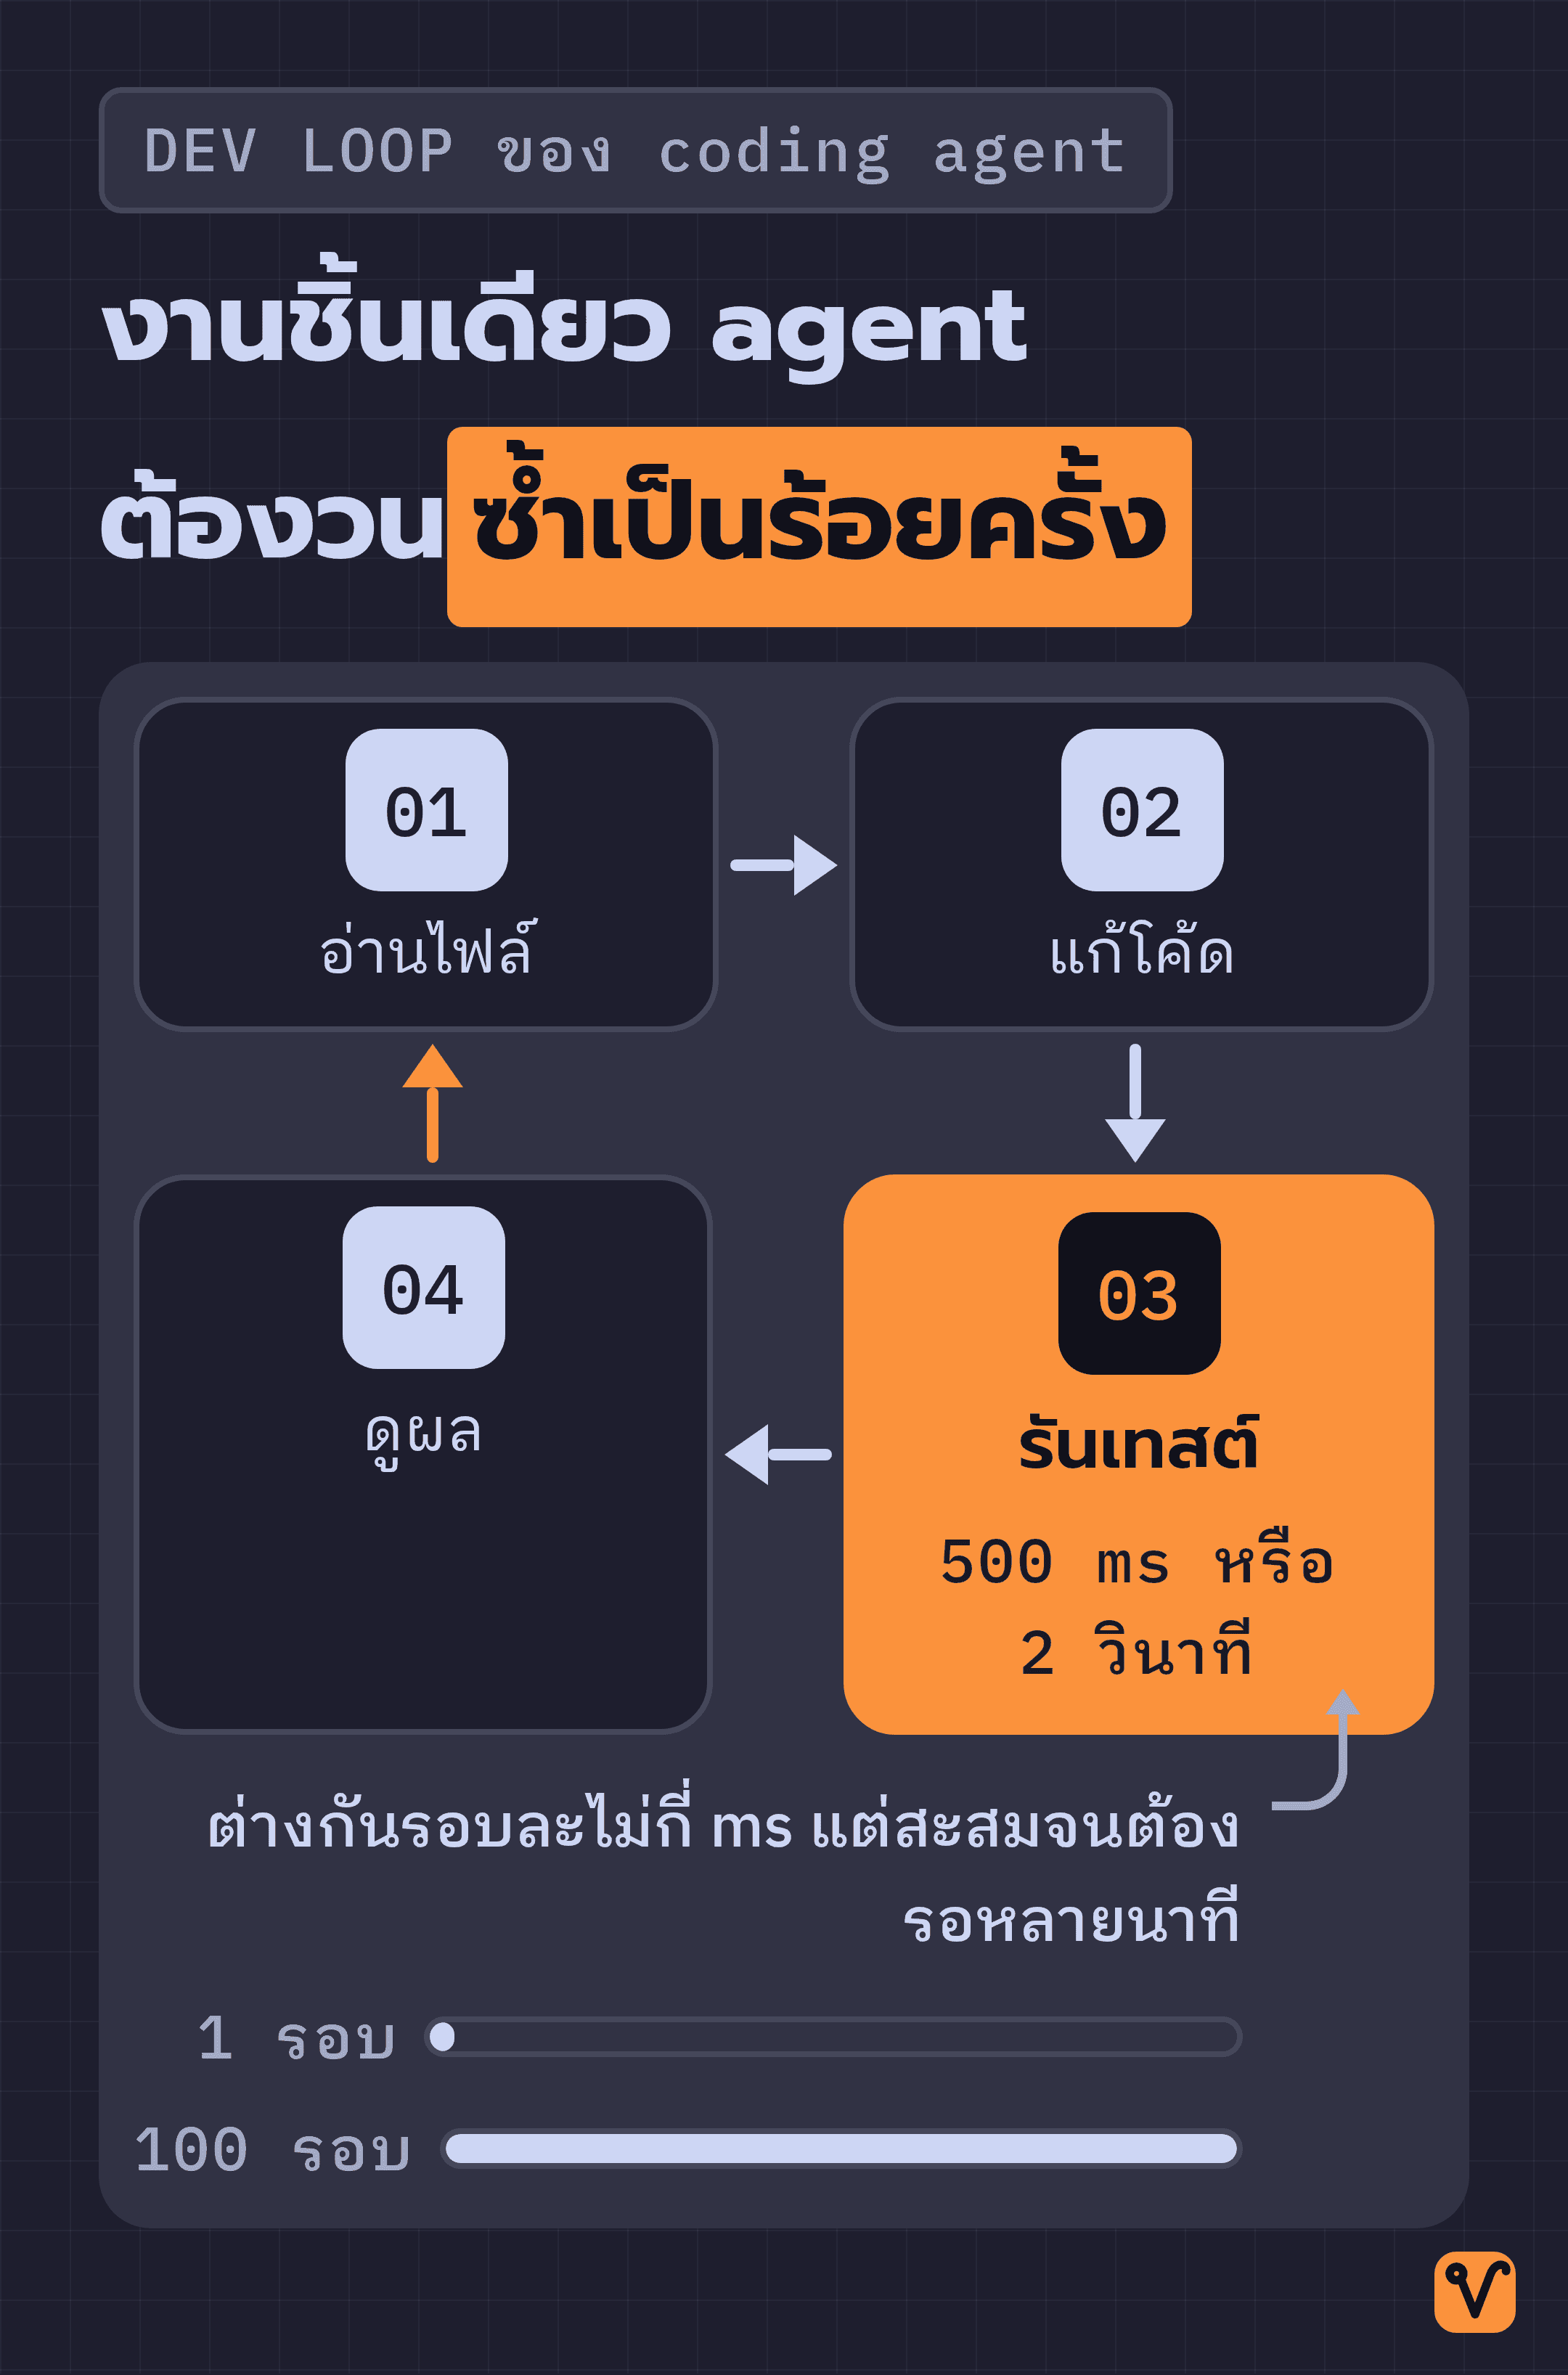
คำตอบจะมาถึงทันทีได้ ก็ต่อเมื่อการเรียกใช้เครื่องมือภายนอกอย่าง tool ของ agent ทำงานได้เร็วด้วยเช่นกัน
tool call คือจังหวะที่ agent หยุดสร้างข้อความชั่วคราวเพื่อไปเรียกคำสั่งหรือเครื่องมือภายนอก เช่น การอ่านไฟล์ การสั่งรันเทสต์ หรือการรันคำสั่งในเทอร์มินัล พอการสร้าง token ไม่ใช่คอขวดอีกต่อไป ความเร็วของ tool call จึงกลายเป็นเรื่องสำคัญขึ้นมาทันที ตัวอย่างเช่น agent อ่านแต่ละไฟล์ใช้เวลา 100 มิลลิวินาทีหรือแค่ 10 มิลลิวินาที และการรันเทสต์ใช้เวลา 500 มิลลิวินาทีเทียบกับ 2 วินาที
ตัวเลขระดับมิลลิวินาทีอาจดูน้อยเมื่อมองทีละครั้ง แต่ในการทำงานจริง agent มักต้องเรียกคำสั่งเหล่านี้ซ้ำๆ เป็นร้อยครั้งต่องานหนึ่งชิ้น ความต่างเพียงเล็กน้อยในแต่ละรอบจึงสะสมจนกลายเป็นความต่างระหว่าง "งานเสร็จแทบจะทันที" กับ "ต้องนั่งรอนานหลายนาที"
เขาจึงคาดว่า ในอนาคตจะมีแรงผลักดันมหาศาลให้การพัฒนาแบบ agentic coding ซึ่งใช้ AI agent รับหน้าที่เขียนโค้ดเป็นหลัก เปลี่ยนมาใช้ภาษาโปรแกรมที่คอมไพล์และรันเทสต์ได้เร็วเป็นพิเศษอย่าง Go รวมถึงปรับ dev loop ของ codebase ที่ตั้งใจให้ agent ทำงานเป็นหลัก ให้กระชับและเร็วที่สุด
จุดนี้ต้องระวังไม่ให้เข้าใจผิด เพราะสิ่งที่เขาพูดถึงคือแนวโน้มในอนาคต ไม่ได้หมายความว่าให้รีบย้ายภาษาโปรเจกต์ในวันนี้ ส่วนการยกตัวอย่างภาษา Go ก็เพื่อแสดงให้เห็นคุณสมบัติเรื่องการคอมไพล์และรันเทสต์ที่เร็ว ไม่ใช่การตัดสินว่าภาษาไหนดีกว่ากัน
สำหรับโปรเจกต์เดิมที่มีอยู่แล้ว การเปลี่ยนไปใช้ภาษาใหม่ย่อมมีต้นทุนสูงมากเพราะแทบต้องรื้อใหม่ทั้งโปรเจกต์ แต่สิ่งที่เราทำได้ทันทีโดยไม่ต้องรื้อระบบเดิม คือทำให้ชุดเทสต์ในภาษาปัจจุบันทำงานเร็วขึ้น เพราะเป้าหมายที่แท้จริงคือความเร็วของ dev loop ไม่ใช่ชื่อภาษาโปรแกรม
ทีม DevEx ที่เคยหายไป อาจกลับมามีบทบาทสำคัญอีกครั้งในยุค AI
ในสายตาของผู้เขียน ทีม DevEx เป็นมรดกตกทอดจากยุค 2010 ซึ่งเป็นยุคที่บริษัทมีแรงจูงใจทำให้วิศวกรมีความสุข แต่ปัจจุบัน บริษัทส่วนใหญ่ลดขนาดทีมนี้ลงจนเหลือน้อยมาก หรือไม่ก็ยุบทีมทิ้งไปแล้ว
ถึงอย่างนั้น เขาคาดว่าเราอาจได้เห็นทีมแบบนี้กลับมาอีกครั้งในช่วงปลายทศวรรษ 2020 แต่จะมาพร้อมบทบาทใหม่ นั่นคือการปรับปรุงประสบการณ์การทำงานและความเร็วให้กับ AI agent แทนมนุษย์
4 สิ่งที่คุณลงมือทำได้ทันทีตั้งแต่วันจันทร์นี้
เนื้อหาส่วนนี้คือข้อเสนอแนะที่เราต่อยอดมาจากบทความ เพื่อให้นำไปปรับใช้จริงกับโปรเจกต์ของตัวเอง โดยมี 4 สิ่งที่เริ่มทำได้ทันที:
หนึ่ง จับเวลา 3 อย่างหลักในโปรเจกต์ก่อน ได้แก่ ชุดเทสต์ที่ agent ต้องรันบ่อยที่สุด เวลาที่ใช้ build หรือคอมไพล์โค้ด และเวลาที่ระบบตรวจชนิดข้อมูลอย่าง type check ในภาษาอย่าง TypeScript ใช้ตรวจก่อนปล่อยโค้ดผ่าน ที่ต้องจับเวลา 3 อย่างนี้ เพราะเป็นสิ่งที่ agent ต้องเรียกใช้ซ้ำๆ ไม่ใช่สิ่งที่คนเรียกใช้วันละครั้ง จากนั้นลองนำเกณฑ์ที่ว่า 1 วินาทีถือว่าดีมาก ส่วน 30 วินาทีถือว่าช้าเกินไป มาใช้วัดผลดู
สอง แยกชุดเทสต์ออกเป็นสองระดับ โดยแยก "ชุดเทสต์ความเร็วสูง" ที่รันจบได้ในระดับวินาทีเอาไว้ให้ agent รันวนรอบตอนแก้โค้ด ส่วน "ชุดเทสต์แบบละเอียดหรือชุดใหญ่" ที่ใช้เวลานาน ให้ย้ายไปรันบนระบบ CI ที่คอยรันเทสต์ให้อัตโนมัติเมื่อส่งโค้ดขึ้นเซิร์ฟเวอร์แทน ถ้าไม่แยกชุดเทสต์ agent ก็ต้องรันเทสต์ชุดช้าซ้ำทุกรอบที่แก้โค้ด และเวลานั้นจะสะสมขึ้นทุกรอบ
สาม ใช้ความเร็วของ dev loop เป็นเกณฑ์เลือกเครื่องมือ สำหรับโปรเจกต์ใหม่ที่ตั้งใจให้ agent เขียนโค้ดเป็นหลัก เวลาเลือกภาษาโปรแกรมหรือเฟรมเวิร์ก ให้ดูด้วยว่าคอมไพล์และรันเทสต์ได้เร็วแค่ไหน ควบคู่ไปกับความคุ้นเคยของทีม เพราะความคุ้นเคยก็ยังสำคัญมาก ทีมที่อ่านโค้ดเข้าใจดี ย่อมตรวจสอบงานของ agent ได้เร็วกว่า
สี่ ตรวจสอบให้ชัดว่าเวลาหายไปตรงไหน ก่อนจ่ายเงินเพิ่ม ก่อนตัดสินใจจ่ายเงินซื้อโมเดลที่แพงขึ้นหรือเร็วกว่าเดิม หรือเปลี่ยนเครื่องมือตามกระแสที่ถกเถียงกันว่า Codex หรือ Claude Code ตัวไหนดีกว่ากัน ให้ลองเทียบดูก่อนว่า ระหว่างเวลาที่ agent ใช้คิด กับเวลาที่ agent ต้องนั่งรอชุดเทสต์ของเรา ฝั่งไหนกินเวลามากกว่ากัน ถ้าเวลาส่วนใหญ่หมดไปกับการรอเทสต์ เงินที่จ่ายเพิ่มให้โมเดลก็แทบไม่ช่วยให้งานเสร็จเร็วขึ้นเลย
ลองถามตัวเองดูว่า เทสต์ชุดหลักของโปรเจกต์คุณใช้เวลารันกี่วินาที และ agent ต้องรันกี่รอบต่อการแก้โค้ดหนึ่งครั้ง ผลคูณของตัวเลขสองตัวนี้คือเวลาที่คุณควบคุมและลดได้ด้วยตัวเอง โดยไม่ต้องรอให้ใครเปิดตัวโมเดลรุ่นใหม่
โมเดล AI จะเก่งขึ้นและเร็วขึ้นเองโดยที่เราไม่ต้องทำอะไร แต่ชุดเทสต์ที่รันนาน 30 วินาที จะไม่มีวันเร็วขึ้นเองถ้าเราไม่ลงมือปรับปรุง
ที่มา: บทความ Slow developer experience will bottleneck fast models จาก Sean Goedecke
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Vibe Coding สำหรับคนไม่ใช่โปรแกรมเมอร์ ใช้ Claude Code สร้าง landing page, mini app และ prototype จริงโดยไม่ต้องเขียนโค้ด
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ