Strata รัน Qwen3.8-Flash-Next โมเดล 125B บนคอมเกมมิ่งที่มี RAM กับการ์ดจอรวมกัน 32GB แล้วต่อ Claude Code ใช้บนเครื่องได้โดยไม่เสียค่า API
Strata รัน Qwen3.8-Flash-Next โมเดล 125B บนคอมเกมมิ่ง ให้ Claude Code ใช้ผ่าน localhost ดูว่าเครื่องไหนไหว เร็วแค่ไหน และเทียบ Opus 5.5 ในงานจริงได้แค่ไหน
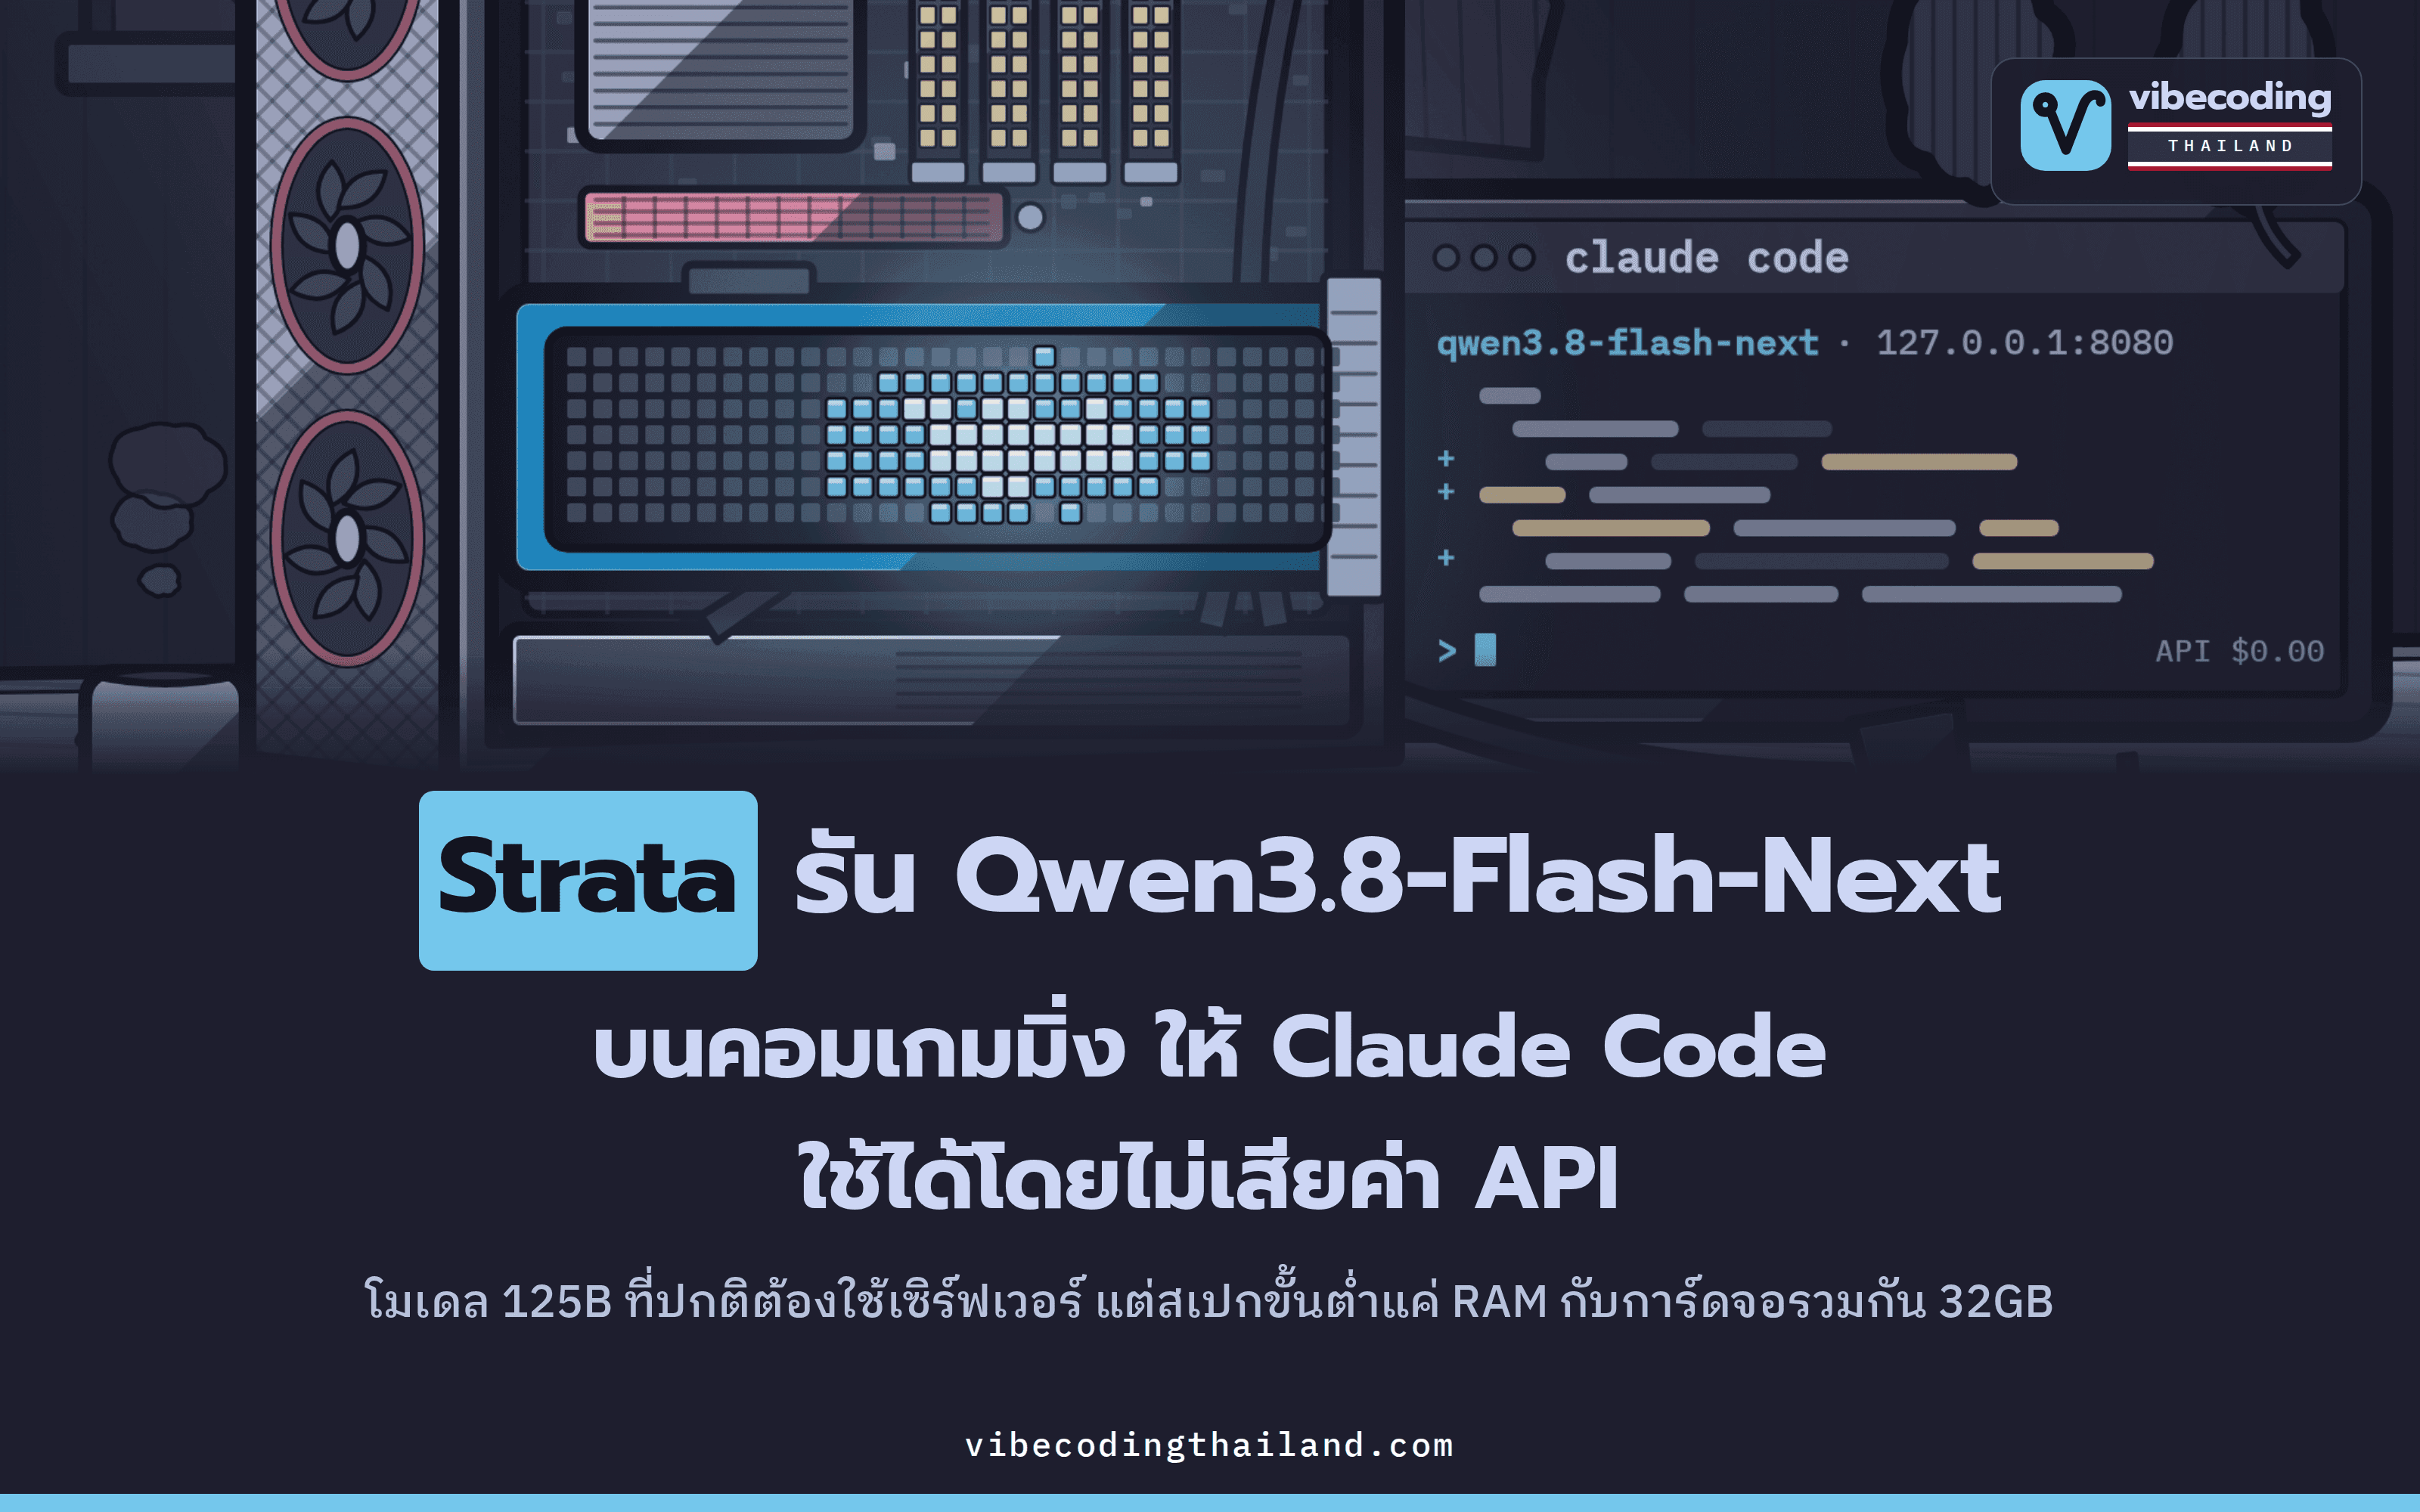
โปรแกรมโอเพนซอร์สอย่าง Strata ช่วยให้คอมเกมมิ่งที่บ้านรันโมเดล AI ระดับเซิร์ฟเวอร์อย่าง Qwen3.8-Flash-Next ของทีม Qwen ได้แล้ว
ลองนึกถึงวันที่ Claude Code ผู้ช่วยเขียนโค้ดของ Anthropic ขึ้นข้อความว่าโควตาหมดกลางงาน ทั้งที่การ์ดจอในเครื่องแทบไม่ได้ใช้งานอะไรเลยในแต่ละวัน
Strata เข้ามาแก้ปัญหานี้ โดยเปิดทางให้ Claude Code สลับมาใช้โมเดลที่รันอยู่บนเครื่องเราแทน ทำให้งานที่ส่งเข้าโมเดลในเครื่องไม่ต้องเสียค่าเรียก API ที่คิดตามปริมาณการใช้งาน
เกณฑ์ขั้นต่ำคือเครื่องต้องมี RAM และหน่วยความจำการ์ดจอ (VRAM) รวมกันอย่างน้อย 32GB
โปรเจกต์นี้พัฒนาโดย Niko1221 บน GitHub ซึ่งตอนนี้ได้รับความสนใจจนมีคนกดดาวให้แล้วมากกว่า 29,000 ดวง
README ของโปรเจกต์สรุปจุดเด่นไว้สั้นๆ ว่า Strata พาโมเดลขนาด 125B มารันบนคอมพิวเตอร์ทั่วไปได้ โมเดลขนาดนี้มีพารามิเตอร์มากถึง 125,000 ล้านตัว และปกติต้องรันบนเซิร์ฟเวอร์
เมื่อรันผ่าน Strata โมเดลนี้ทำได้ทั้งตอบคำถาม เขียนโค้ด และอ่านรูปภาพ โดยประวัติการคุยและไฟล์ทั้งหมดอยู่บนเครื่องเราเอง
สเปก 32GB ของ Strata คิดจาก RAM รวมกับแรมการ์ดจอ
จุดที่ชวนสับสนในเกณฑ์ 32GB คือคำว่า "รวมกัน" ตัวอย่างเช่น เครื่องที่มี RAM 16GB และการ์ดจอ 16GB ก็นับเป็น 32GB ตามเกณฑ์แล้ว
ส่วนฝั่ง Mac หรือคอมพิวเตอร์ที่ใช้ชิปอย่าง Ryzen AI Max ให้ดูที่ Unified Memory หรือหน่วยความจำที่ CPU กับ GPU ใช้ร่วมกันได้เลย
| สิ่งที่เช็ก | ขั้นต่ำ |
|---|---|
| RAM + หน่วยความจำการ์ดจอ | รวมกัน 32GB ขึ้นไป |
| การ์ด NVIDIA | GeForce RTX ซีรีส์ 20, 30, 40 หรือ 50 ที่มี 12GB ขึ้นไป |
| การ์ด AMD | Radeon RX 6800 ขึ้นไป หรือ Radeon AI PRO R9700 ที่มี 12GB ขึ้นไป |
| การ์ด Intel | Intel Arc |
| Mac | Apple Silicon M1 ขึ้นไป บน macOS 15 ขึ้นไป |
| ดิสก์ | ว่างราว 80GB ถ้าเป็น SSD การเปิดครั้งแรกจะเร็วขึ้นมาก |
| ระบบปฏิบัติการ | Windows 10/11, Linux หรือ macOS |
ข้อควรระวัง: หากในเครื่องมีการ์ดจอทั้ง NVIDIA และ AMD ติดตั้งอยู่ด้วยกัน Strata จะไม่สามารถกระจายการประมวลผลของโมเดลข้ามค่ายได้
เมื่อเช็กแล้วว่าสเปกเครื่องผ่านเกณฑ์ขั้นต่ำ ขั้นตอนถัดไปคือการเลือกขนาดโมเดล
Qwen3.8-Flash-Next บน Strata มีให้เลือกหลายขนาด ทุกขนาดคือโมเดลตัวเดียวกันที่บีบอัดมาในระดับต่างกัน รุ่นเล็กจะทำงานได้เร็วกว่า ส่วนรุ่นใหญ่จะฉลาดกว่าเล็กน้อย
README สรุปวิธีเลือกไว้ง่ายๆ ว่า พีซี 32GB ที่มีการ์ดจอ VRAM 12–16GB รันรุ่น Coder ที่เน้นงานเขียนโค้ดโดยเฉพาะได้ แต่ถ้าเครื่องมี RAM ถึง 64GB ขึ้นไป ก็รันได้ครบทุกขนาด
ส่วนคู่มือติดตั้ง AI_SETUP.md ให้ตารางแนะนำขนาดโมเดลตาม RAM ของเครื่องไว้ดังนี้:
| RAM | ขนาดที่แนะนำ | หมายเหตุ |
|---|---|---|
| 32GB | Coder (IQ1_M) | สำหรับงานโค้ด |
| 48GB | IQ2_XS | หรือ Q2_0 ที่เร็วที่สุด |
| 64GB | IQ2_XS | IQ3_XXS กับ IQ3_S ช้ากว่าแต่ดีกว่านิดหน่อย |
| 96GB ขึ้นไป | IQ3_S | หรือ Unsloth UD-IQ4_XS ที่ต้องโหลด 94GB |
จุดที่ต้องระวังคือ ตัวเลขสเปกขั้นต่ำ 32GB นั้นนับ RAM รวมกับแรมการ์ดจอ แต่ตารางแนะนำขนาดโมเดลนี้จะดูจากขนาด RAM ของเครื่องเป็นหลัก
สำหรับคนที่เน้นเขียนโค้ดเป็นหลัก คู่มือระบุว่ารุ่น Coder เป็นตัวเลือกที่ดีในทุกระดับ RAM
หากเครื่องมี RAM น้อยกว่าที่ระบุในตาราง Strata จะสลับไปใช้โหมด Low RAM ให้โดยอัตโนมัติ แต่ต้องแลกกับความเร็วที่ช้าลง และจะยิ่งช้ามากถ้าการ์ดจอมีแรมน้อย
ส่วนเครื่องที่ทรัพยากรจำกัดจริงๆ ยังมีรุ่น Gyro-S ให้เลือก ซึ่งใช้หน่วยความจำรวมเพียง 27.6GB แต่คุณภาพคำตอบด้อยกว่า IQ2_XS และตอนนี้ยังไม่รองรับ Intel Arc กับ Mac
ดูรายละเอียดของทุกขนาดและขนาดไฟล์เพิ่มเติมได้ที่ MODELS.md
Expert 24,576 ตัว แต่เรียกใช้งานจริงทีละ 10 ตัว
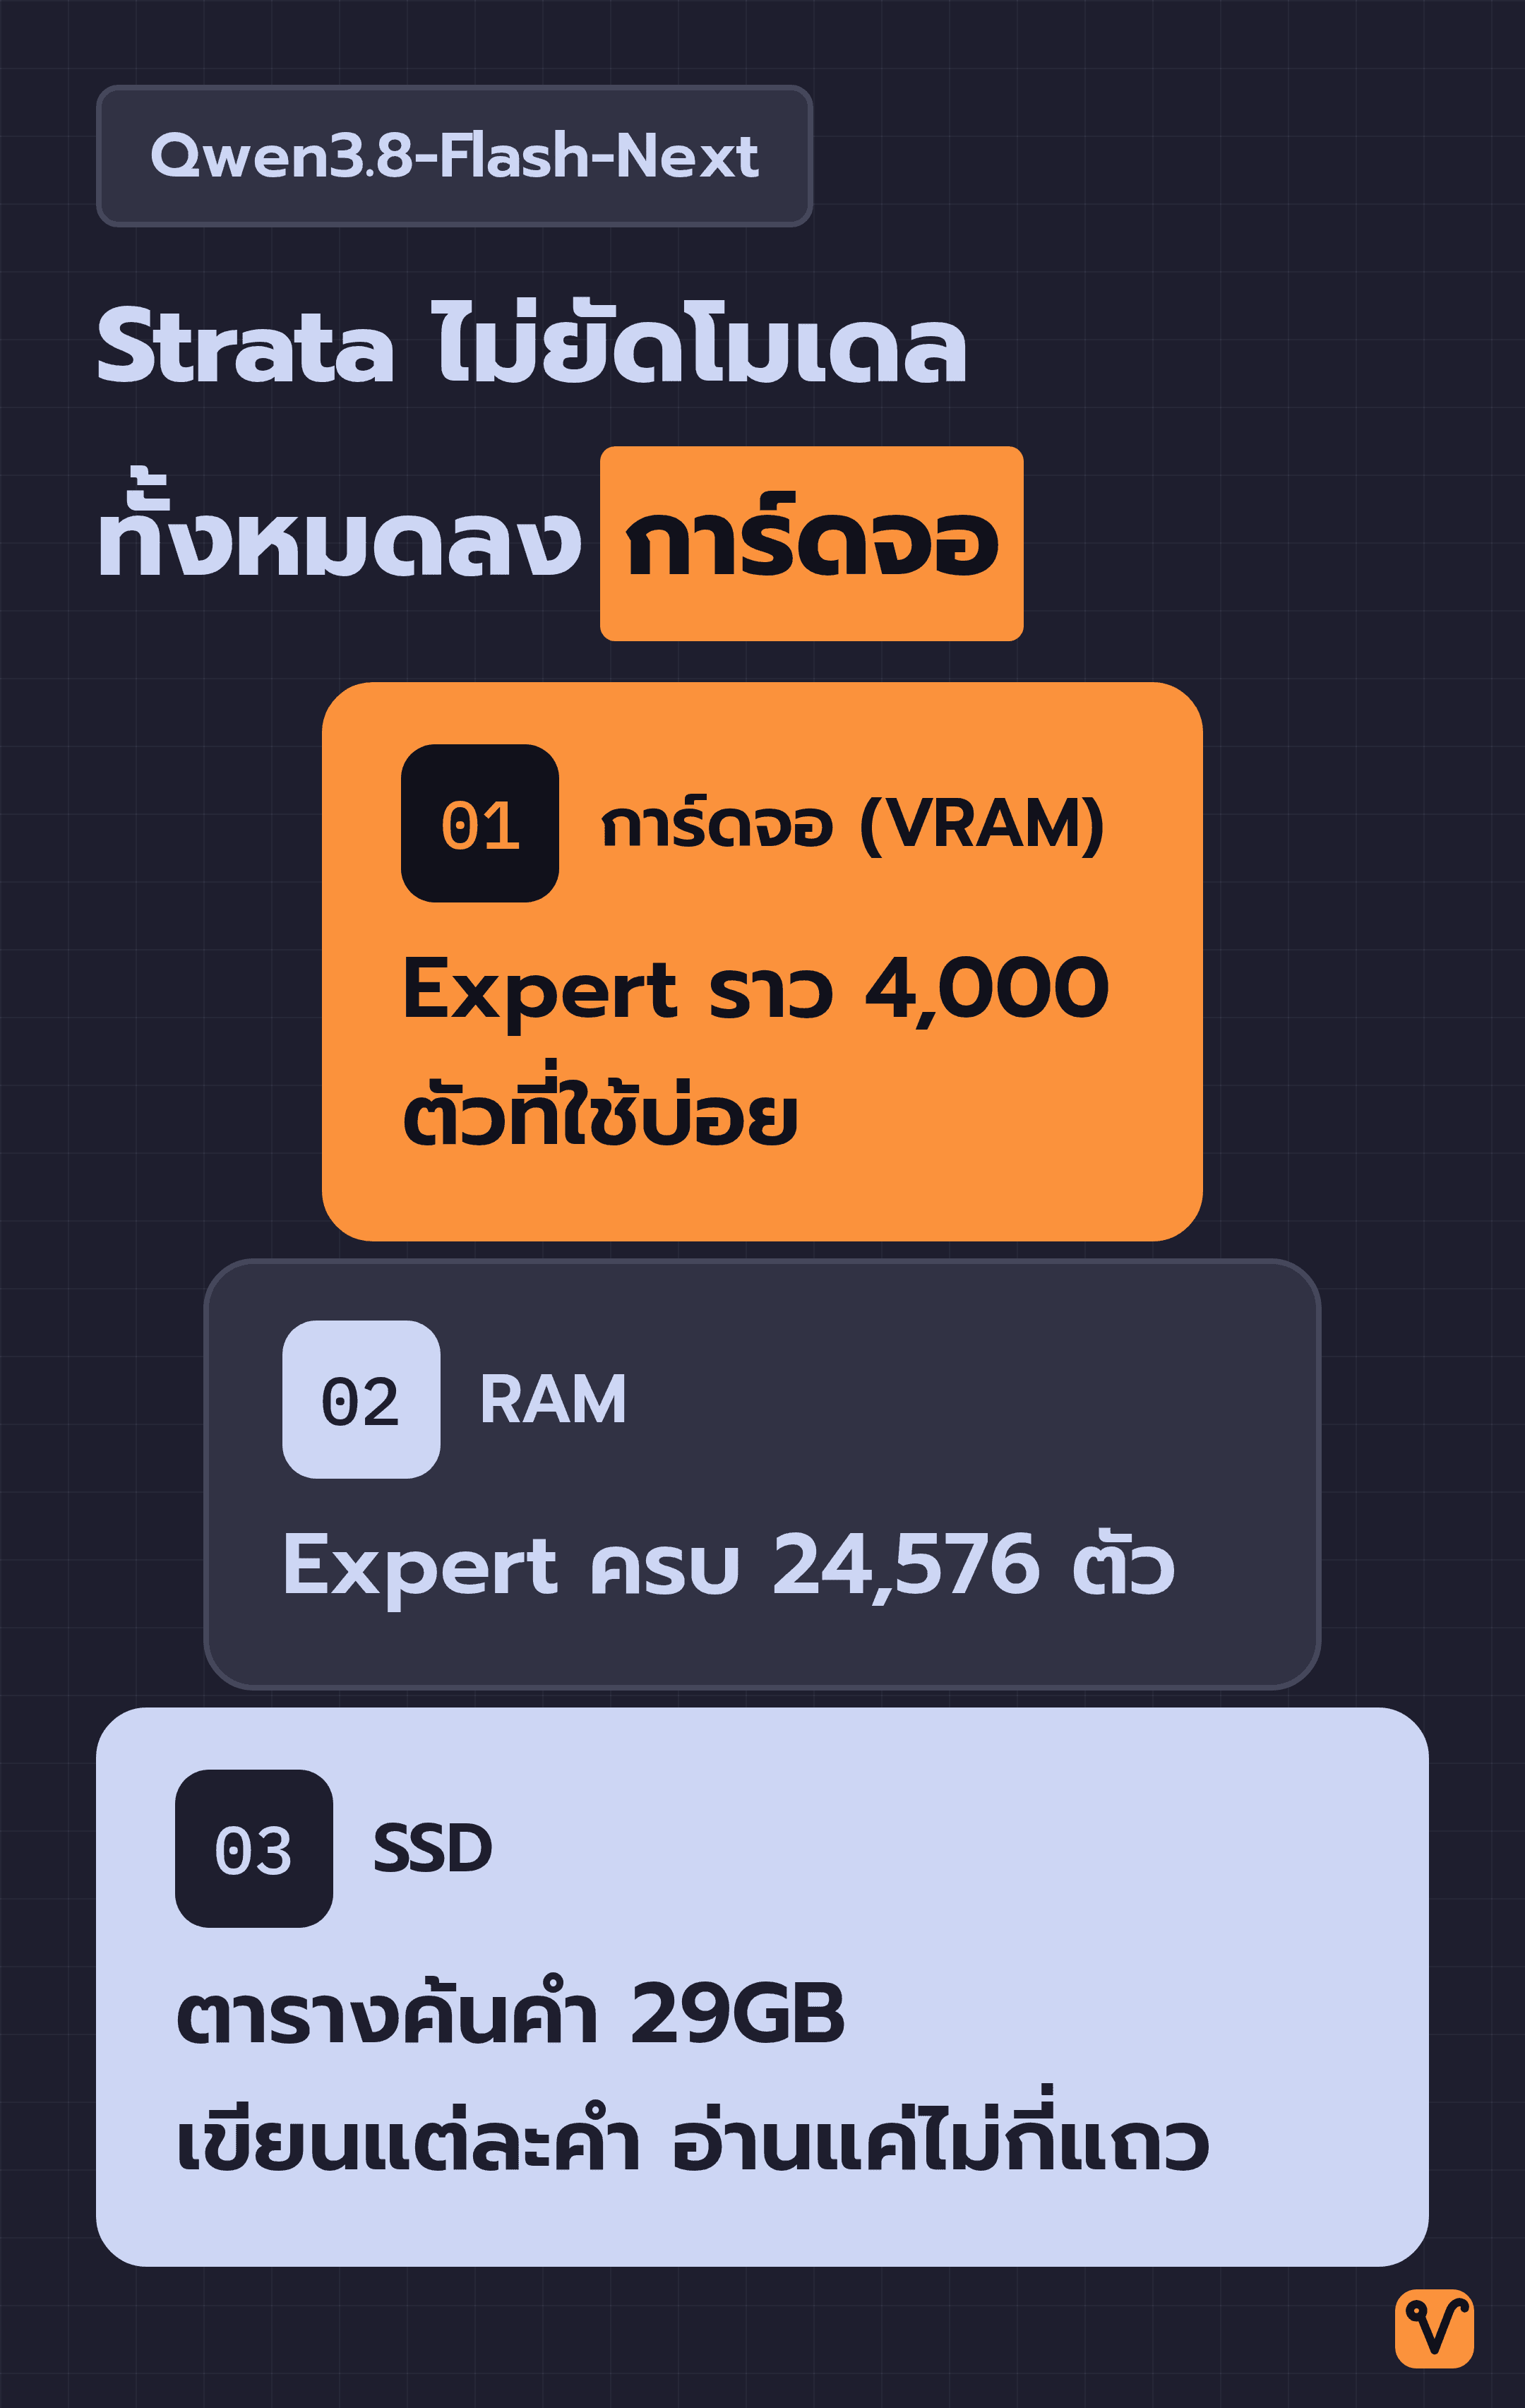
โมเดล AI ระดับเซิร์ฟเวอร์รันบนคอมเกมมิ่งที่บ้านได้ ก็เพราะสถาปัตยกรรมภายในของ Qwen3.8-Flash-Next เอง
โครงสร้างภายในโมเดลแบ่งการทำงานออกเป็นส่วนย่อยที่เรียกว่า Expert มากถึง 24,576 ตัว แต่ทุกครั้งที่โมเดลสร้างคำตอบขึ้นมาทีละคำ จะเลือกดึงมาใช้งานเพียงรอบละ 10 ตัวเท่านั้น
เท่ากับว่าในแต่ละจังหวะการประมวลผล จะมี Expert ที่ทำงานจริงไม่ถึง 1 ใน 2,000 ส่วนของ Expert ทั้งหมดด้วยซ้ำ
ด้วยเหตุนี้ Strata จึงไม่จำเป็นต้องยัดโมเดลทั้งหมดลงในการ์ดจอ แต่ใช้วิธีกระจายข้อมูลไปจัดเก็บไว้ 3 ส่วนแทน:
- การ์ดจอ (VRAM): เก็บ Expert ราว 4,000 ตัวที่เรียกใช้งานบ่อยที่สุด
- RAM ของเครื่อง: เก็บ Expert ครบทั้ง 24,576 ตัว ถ้าต้องใช้ Expert ตัวที่ไม่ได้อยู่บนการ์ดจอ ตัว CPU จะดึงข้อมูลจาก RAM ขึ้นมาป้อนให้ทันที ระหว่างนั้นการ์ดจอก็ทำงานส่วนอื่นต่อได้โดยไม่ต้องหยุดรอ
- SSD: เก็บตารางค้นคำขนาด 29GB เนื่องจากในแต่ละคำที่เขียน โมเดลจะอ่านข้อมูลจากตารางนี้แค่ไม่กี่แถว จึงดึงตรงจาก SSD ได้ทันทีโดยไม่ต้องโหลดทั้งก้อนไปกินพื้นที่บน RAM
นอกจากนี้ยังมีเทคนิคเร่งความเร็วที่เรียกว่า Speculative Decoding ซึ่งใช้โมเดลขนาดเล็กช่วยเดาคำถัดไปล่วงหน้าทีละหลายคำ แล้วส่งให้โมเดลใหญ่ตรวจพร้อมกันในรอบเดียว และเก็บไว้เฉพาะคำที่เดาถูก
ใน README ระบุว่าเทคนิคนี้ช่วยให้ได้ "คำตอบเดิม แต่ตอบกลับเร็วขึ้น 1.6–1.8 เท่า"
นั่นหมายความว่าตัวช่วยเดานี้ไม่ได้ทำให้คุณภาพคำตอบเปลี่ยนไป เพราะหากเดาผิด โมเดลใหญ่ก็จะตัดทิ้งไปเอง สิ่งที่ได้กลับมาคือช่วยประหยัดเวลาขึ้นอย่างเห็นได้ชัด
อย่างไรก็ตาม สิ่งที่ต้องเข้าใจให้ตรงกันคือ Strata ช่วยลดการใช้หน่วยความจำขณะทำงานเท่านั้น แต่ไม่ได้ลดขนาดไฟล์ลง
ขนาดไฟล์โมเดลที่ต้องดาวน์โหลดจึงยังคงอยู่ที่ประมาณ 70GB เพราะยังต้องเก็บ Expert ทุกตัวไว้ในเครื่องให้ครบถ้วน
RTX 5070 ตอบได้เร็ว 53-94 token ต่อวินาที
การวัดความเร็วของ Strata จะมีตัวเลขให้ดู 2 ค่าหลักๆ คือ ความเร็วในการเขียนคำตอบ หรือ Generation และความเร็วในการประมวลผลข้อความที่เราส่งเข้าไป หรือ Prompt Processing
ทั้งสองค่าวัดเป็น token ต่อวินาที ซึ่ง token คือหน่วยย่อยของคำที่โมเดลใช้ประมวลผล เทียบได้ราว 3 ใน 4 ของคำภาษาอังกฤษหนึ่งคำ
ใน README ระบุว่า ความเร็วเพียงแค่ 60 token ต่อวินาที ก็พิมพ์ออกมาเร็วกว่าที่สายตาคนทั่วไปจะอ่านทันแล้ว
ผลการทดสอบใน README บันทึกไว้บน 2 สเปกเครื่อง ได้แก่:
- เครื่องแรก: การ์ดจอ RTX 5070 12GB + CPU Ryzen 5 7600 + RAM 64GB
- เครื่องที่สอง: การ์ดจอ RX 9070 XT 16GB + CPU Ryzen 9 3900X + RAM 47GB
| ขนาด | RTX 5070 (เขียน / อ่าน) | RX 9070 XT (เขียน / อ่าน) |
|---|---|---|
| Q2_0 | 94 / 2,650 | 60 / 1,160 |
| IQ2_XS | 79 / 2,090 | 52 / 1,110 |
| IQ3_XXS | 62 / 1,750 | - |
| IQ3_S | 53 / 1,620 | - |
| Coder | 55 / 2,180 | 44 / 1,420 |
(ช่องที่มีเครื่องหมายขีด - หมายถึงขนาดที่ไม่ได้ทดสอบบนเครื่องนั้น)
ความเร็วในการอ่าน Prompt นั้นสำคัญมากสำหรับ Coding Agent อย่าง Claude Code เพราะงานเขียนโค้ดมักต้องส่งข้อมูลบริบทขนาดใหญ่เข้าไป ทั้งเนื้อหาไฟล์โค้ดยาวๆ และประวัติการแชตก้อนใหญ่
ในการใช้งานจริง README แนะนำให้กะเวลาไว้ว่า ในข้อความแรกของการสนทนา ตัว Strata ต้องอ่านและประมวลผลข้อความทั้งหมด ซึ่งอาจใช้เวลาราว 1 นาทีต่อ 30,000 token แต่พอพ้นข้อความแรกไปแล้ว ข้อความถัดๆ ไปจะเริ่มตอบกลับได้ภายในเพียงไม่กี่วินาที
ความเร็วตอนอ่านข้อความแรกนี้ช้ากว่าตัวเลขในตารางทดสอบพอสมควร จึงเหมาะจะใช้ความเร็วนี้กะเวลารอก่อนส่งงานชิ้นแรก
นอกจากนี้ README ยังระบุว่าเวอร์ชันของระบบประมวลผลหลักอย่าง Engine ที่ใช้ทดสอบในแต่ละตัวเลข บันทึกแยกไว้ในหน้า DETAILS.md ดังนั้นตัวเลขที่ได้จากโปรแกรมเวอร์ชันล่าสุดจึงอาจไม่ตรงกับตารางนี้เป๊ะๆ
ส่วนตัวเลขของการ์ด RTX 3090 24GB ที่ README เขียนไว้ว่าน่าจะได้ราว 100–140 token ต่อวินาทีนั้น เป็นเพียงค่าที่ผู้พัฒนาประเมินไว้ ไม่ใช่ผลการทดสอบจริง
ติดตั้ง Strata ได้ 3 วิธี
ก่อนเริ่มต้นติดตั้ง ควรเตรียมอินเทอร์เน็ตและเผื่อเวลาไว้พอสมควร เนื่องจากไฟล์โมเดลมีขนาดราว 70GB หากใช้อินเทอร์เน็ตความเร็ว 100 Mbit/s จะใช้เวลาดาวน์โหลดประมาณ 1.5–2 ชั่วโมง แต่ถ้าการเชื่อมต่อหลุดไประหว่างทาง ระบบก็ดาวน์โหลดต่อจากจุดเดิมได้ทันที
การติดตั้งทั้ง 3 รูปแบบจะได้ Engine ตัวเดียวกันและโมเดลชุดเดียวกัน ต่างกันแค่ความสะดวกในการใช้งานเท่านั้น
ทางที่ 1: ติดตั้งผ่านแอป Strata (GUI)
วิธีนี้เหมาะกับคนที่อยากติดตั้งโปรแกรมแล้วเปิดใช้ได้ทันที ดาวน์โหลดไฟล์ติดตั้งที่ตรงกับระบบปฏิบัติการและการ์ดจอของคุณได้จาก หน้า Release ของ Strata 0.2.1
สำหรับผู้ใช้ Windows ตอนนี้ไฟล์ติดตั้งยังไม่ได้เซ็นรับรองด้วยลายเซ็นดิจิทัลหรือ Code-sign ถ้าเปิดขึ้นมาแล้วเจอหน้าต่างเตือน "Windows protected your PC" ให้กดที่ More info แล้วเลือก Run anyway
เมื่อเปิดแอปขึ้นมาครั้งแรก โปรแกรมจะตรวจสอบสเปกเครื่องให้อัตโนมัติ พร้อมแนะนำขนาดโมเดลที่เหมาะสม จากนั้นเพียงกดปุ่มติดตั้ง ตัวแอปก็จะเริ่มดาวน์โหลดไฟล์ทันที
ในแอปมีหน้าแชตที่ทำงานกับโฟลเดอร์ในเครื่องได้โดยตรง และมีหน้าดูการทำงานของ GPU, CPU และ RAM แบบเรียลไทม์
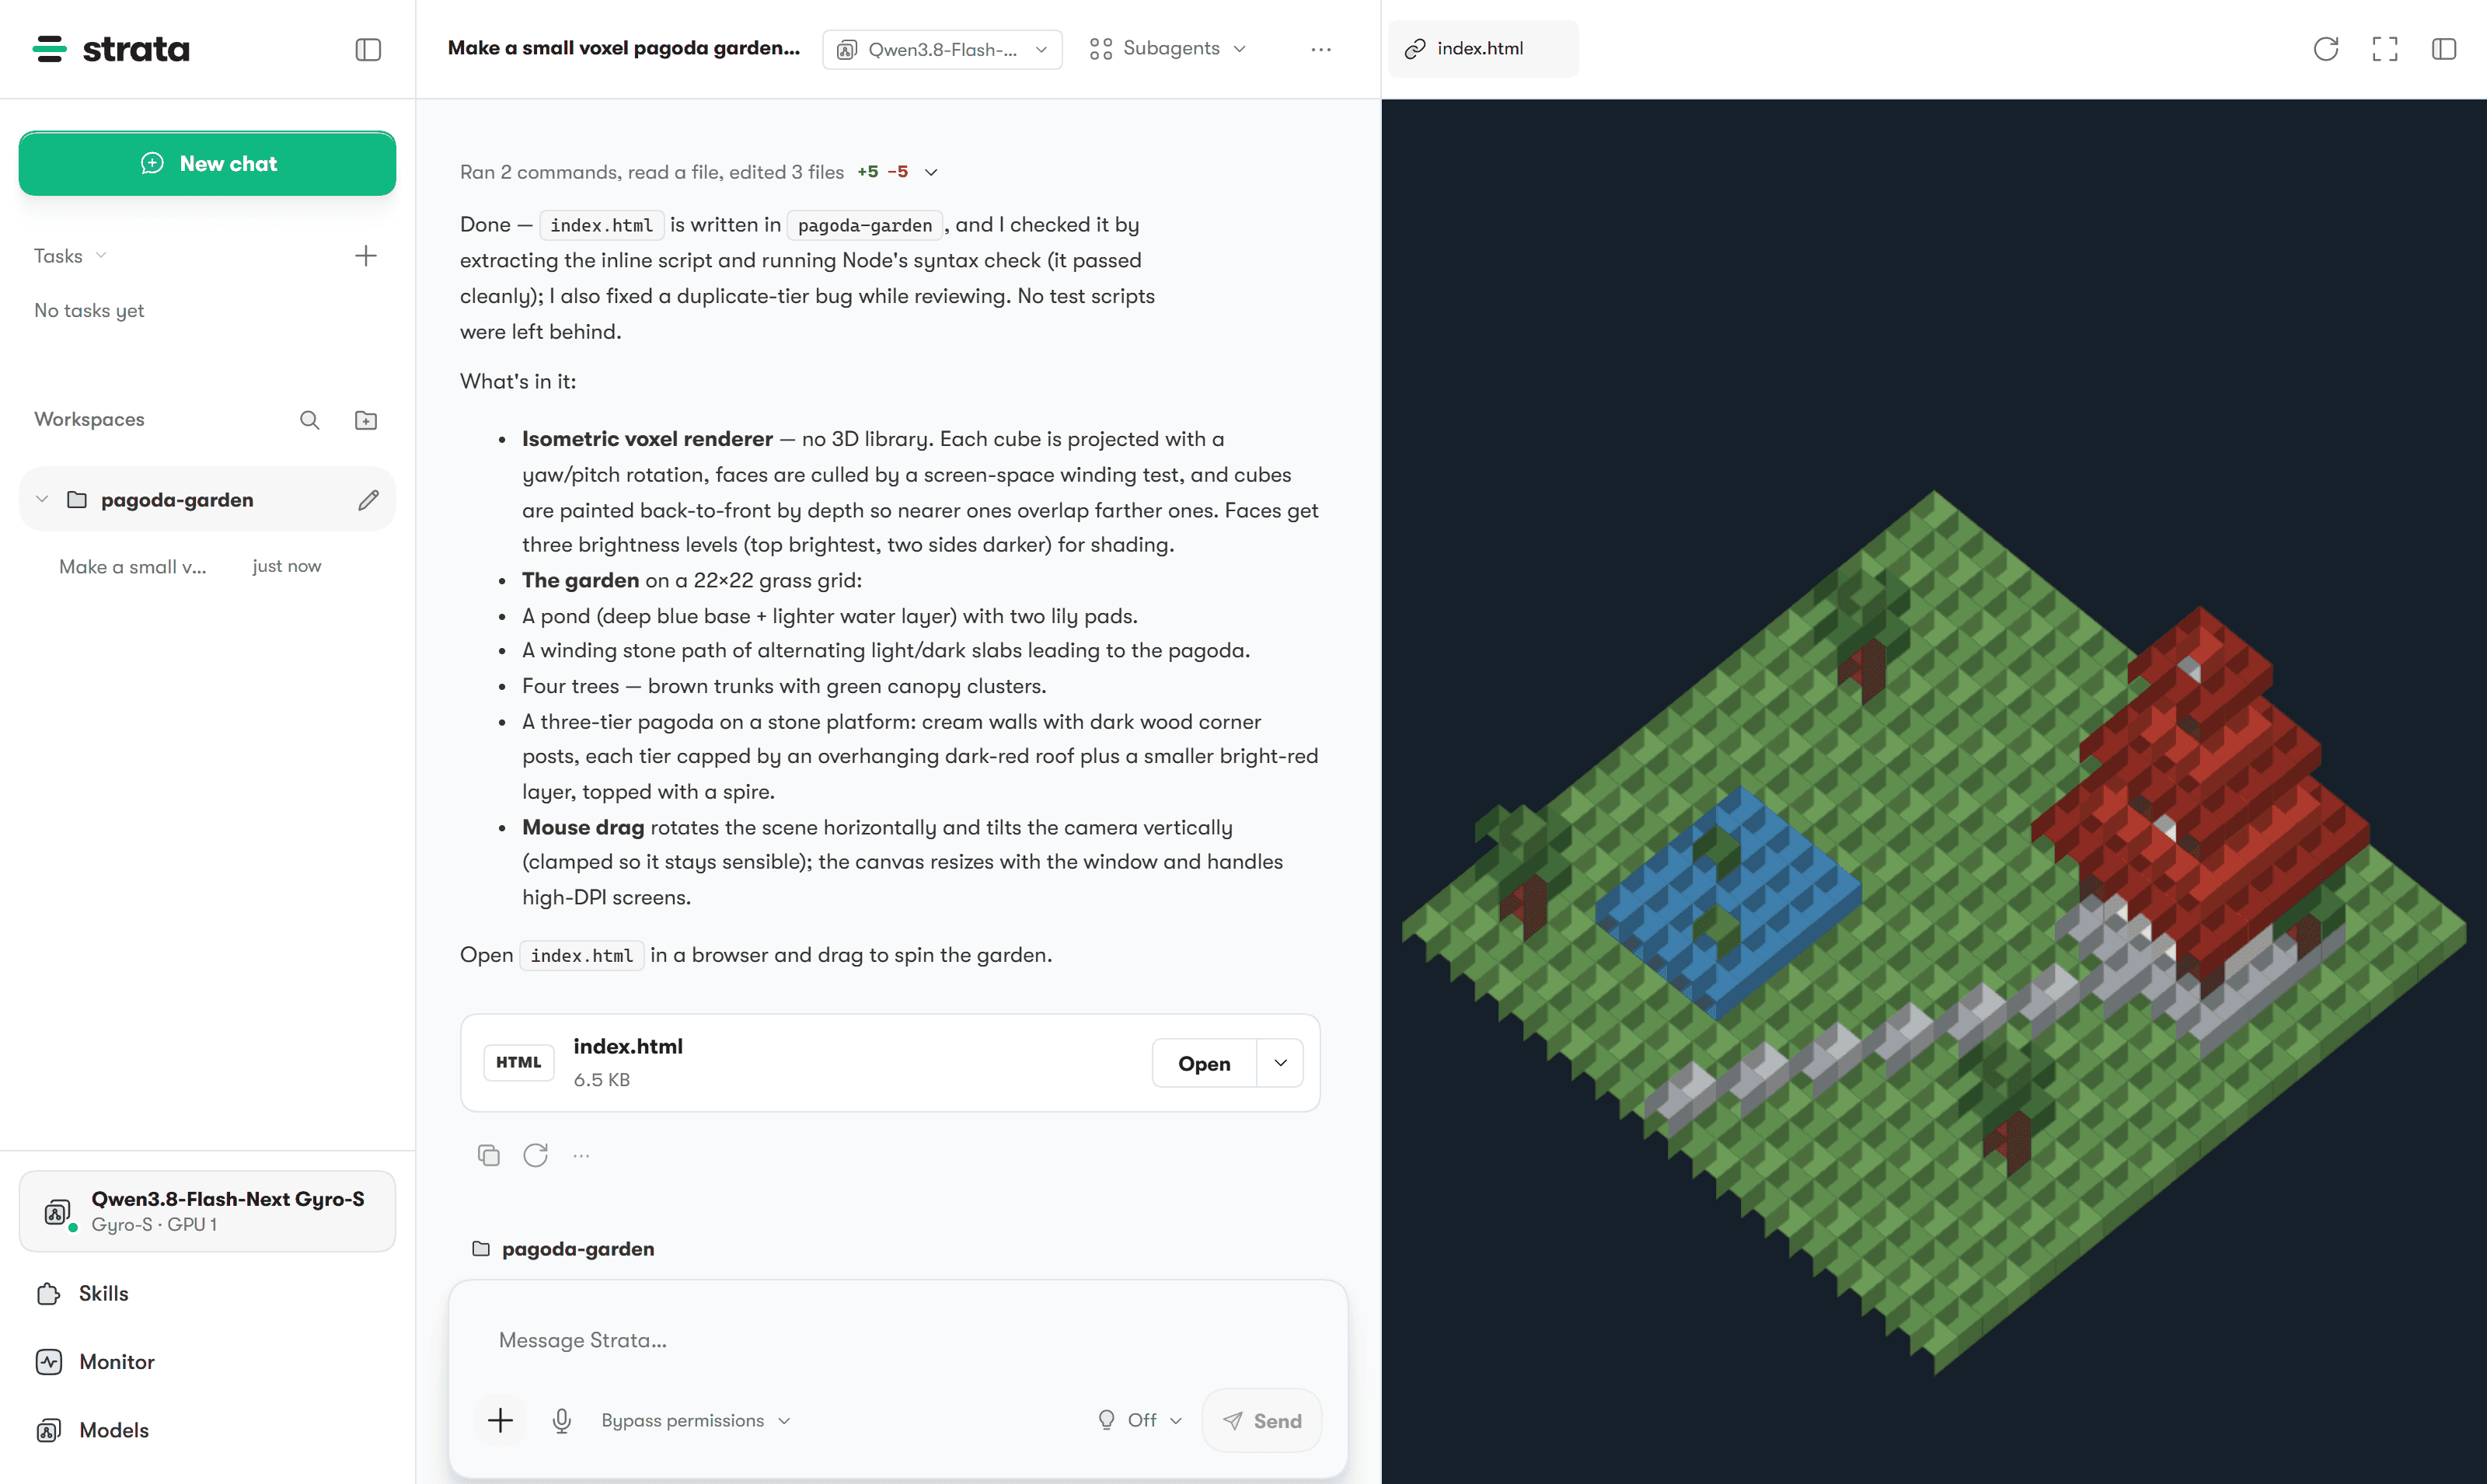
ข้อควรระวังคือ ถ้าปิดหน้าต่างแอป ตัว Strata และ Engine ประมวลผลเบื้องหลังจะหยุดทำงานทันที
ทางที่ 2: ติดตั้งด้วยคำสั่งบรรทัดเดียวใน Terminal
วิธีนี้เหมาะกับผู้ที่คุ้นเคยกับการใช้ Terminal อยู่แล้ว หรือต้องการเปิด Strata ให้ทำงานเป็นเซิร์ฟเวอร์เบื้องหลัง เพื่อให้สคริปต์หรือเครื่องมือ AI ตัวอื่นเรียกใช้งานได้สะดวก
สำหรับ Linux และ macOS ให้รันคำสั่งนี้:
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh | shสำหรับ Windows ให้รันคำสั่งนี้ใน PowerShell:
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iexสคริปต์จะตรวจสอบความพร้อมของระบบและติดตั้งคำสั่ง strata ลงในโฟลเดอร์ของผู้ใช้ให้ทันที โดยไม่จำเป็นต้องใช้สิทธิ์ Administrator
หากใช้ Windows แนะนำให้เปิดหน้าต่าง Terminal ขึ้นมาใหม่หนึ่งครั้ง แล้วรันคำสั่ง:
strata launchระบบจะถามการตั้งค่าทีละข้อ ตั้งแต่ขนาดโมเดล, ความยาวบริบท, การเปิดฟังก์ชันอ่านรูปภาพ ไปจนถึงสิทธิ์ว่าใครเชื่อมต่อเข้ามาได้บ้าง จากนั้นจึงดาวน์โหลด Engine และโมเดลเพื่อเริ่มให้บริการทันที
อย่างไรก็ตาม การดึงสคริปต์จากอินเทอร์เน็ตมารันตรงๆ ก็คือการรันโค้ดที่ยังไม่ได้ตรวจสอบ ถ้าอยากเช็กความปลอดภัยก่อน README แนะนำให้ดาวน์โหลดสคริปต์ลงมาเปิดอ่านก่อน ด้วยคำสั่ง:
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh
sh install.shทางที่ 3: ให้ Claude Code ติดตั้งให้
ถ้าใช้ Claude Code อยู่แล้ว วิธีนี้ง่ายและสะดวกที่สุด แค่วาง Prompt นี้ลงไปได้เลย:
Set up Strata on this PC for me: https://github.com/Niko1221/Strata - follow docs/AI_SETUP.md in that repository.Prompt เดียวกันนี้ยังใช้กับผู้ช่วยเขียนโค้ดตัวอื่นอย่าง Cursor, Codex และ GitHub Copilot ได้ด้วย
ตัว AI Agent จะเข้าไปทำตามขั้นตอนใน AI_SETUP.md ให้ทั้งหมด ตั้งแต่เช็กสเปกการ์ดจอ, RAM, พื้นที่ว่างในดิสก์ จากนั้นเลือกขนาดโมเดลที่เหมาะสม จัดการติดตั้ง เปิดเซิร์ฟเวอร์ และบอกขั้นตอนการเชื่อมต่อไปยังแอปต่างๆ ให้ครบถ้วน
ข้อควรระวัง: ไม่ว่าจะติดตั้งด้วยวิธีไหน ตอนที่โมเดลเริ่มทำงาน เครื่องอาจหน่วงหรือค้างไปราว 1–3 นาที เพราะ Strata ต้องโหลดข้อมูลขนาด 35–55GB เข้าไปพักไว้ใน RAM และการเปิดใช้งานครั้งแรกจะใช้เวลานานที่สุด
หากเห็นเครื่องนิ่งไปในช่วงนี้ ให้รอจนกว่าระบบจะโหลดข้อมูลเสร็จสมบูรณ์
วิธีเชื่อมต่อ Claude Code เข้ากับ Strata บน localhost
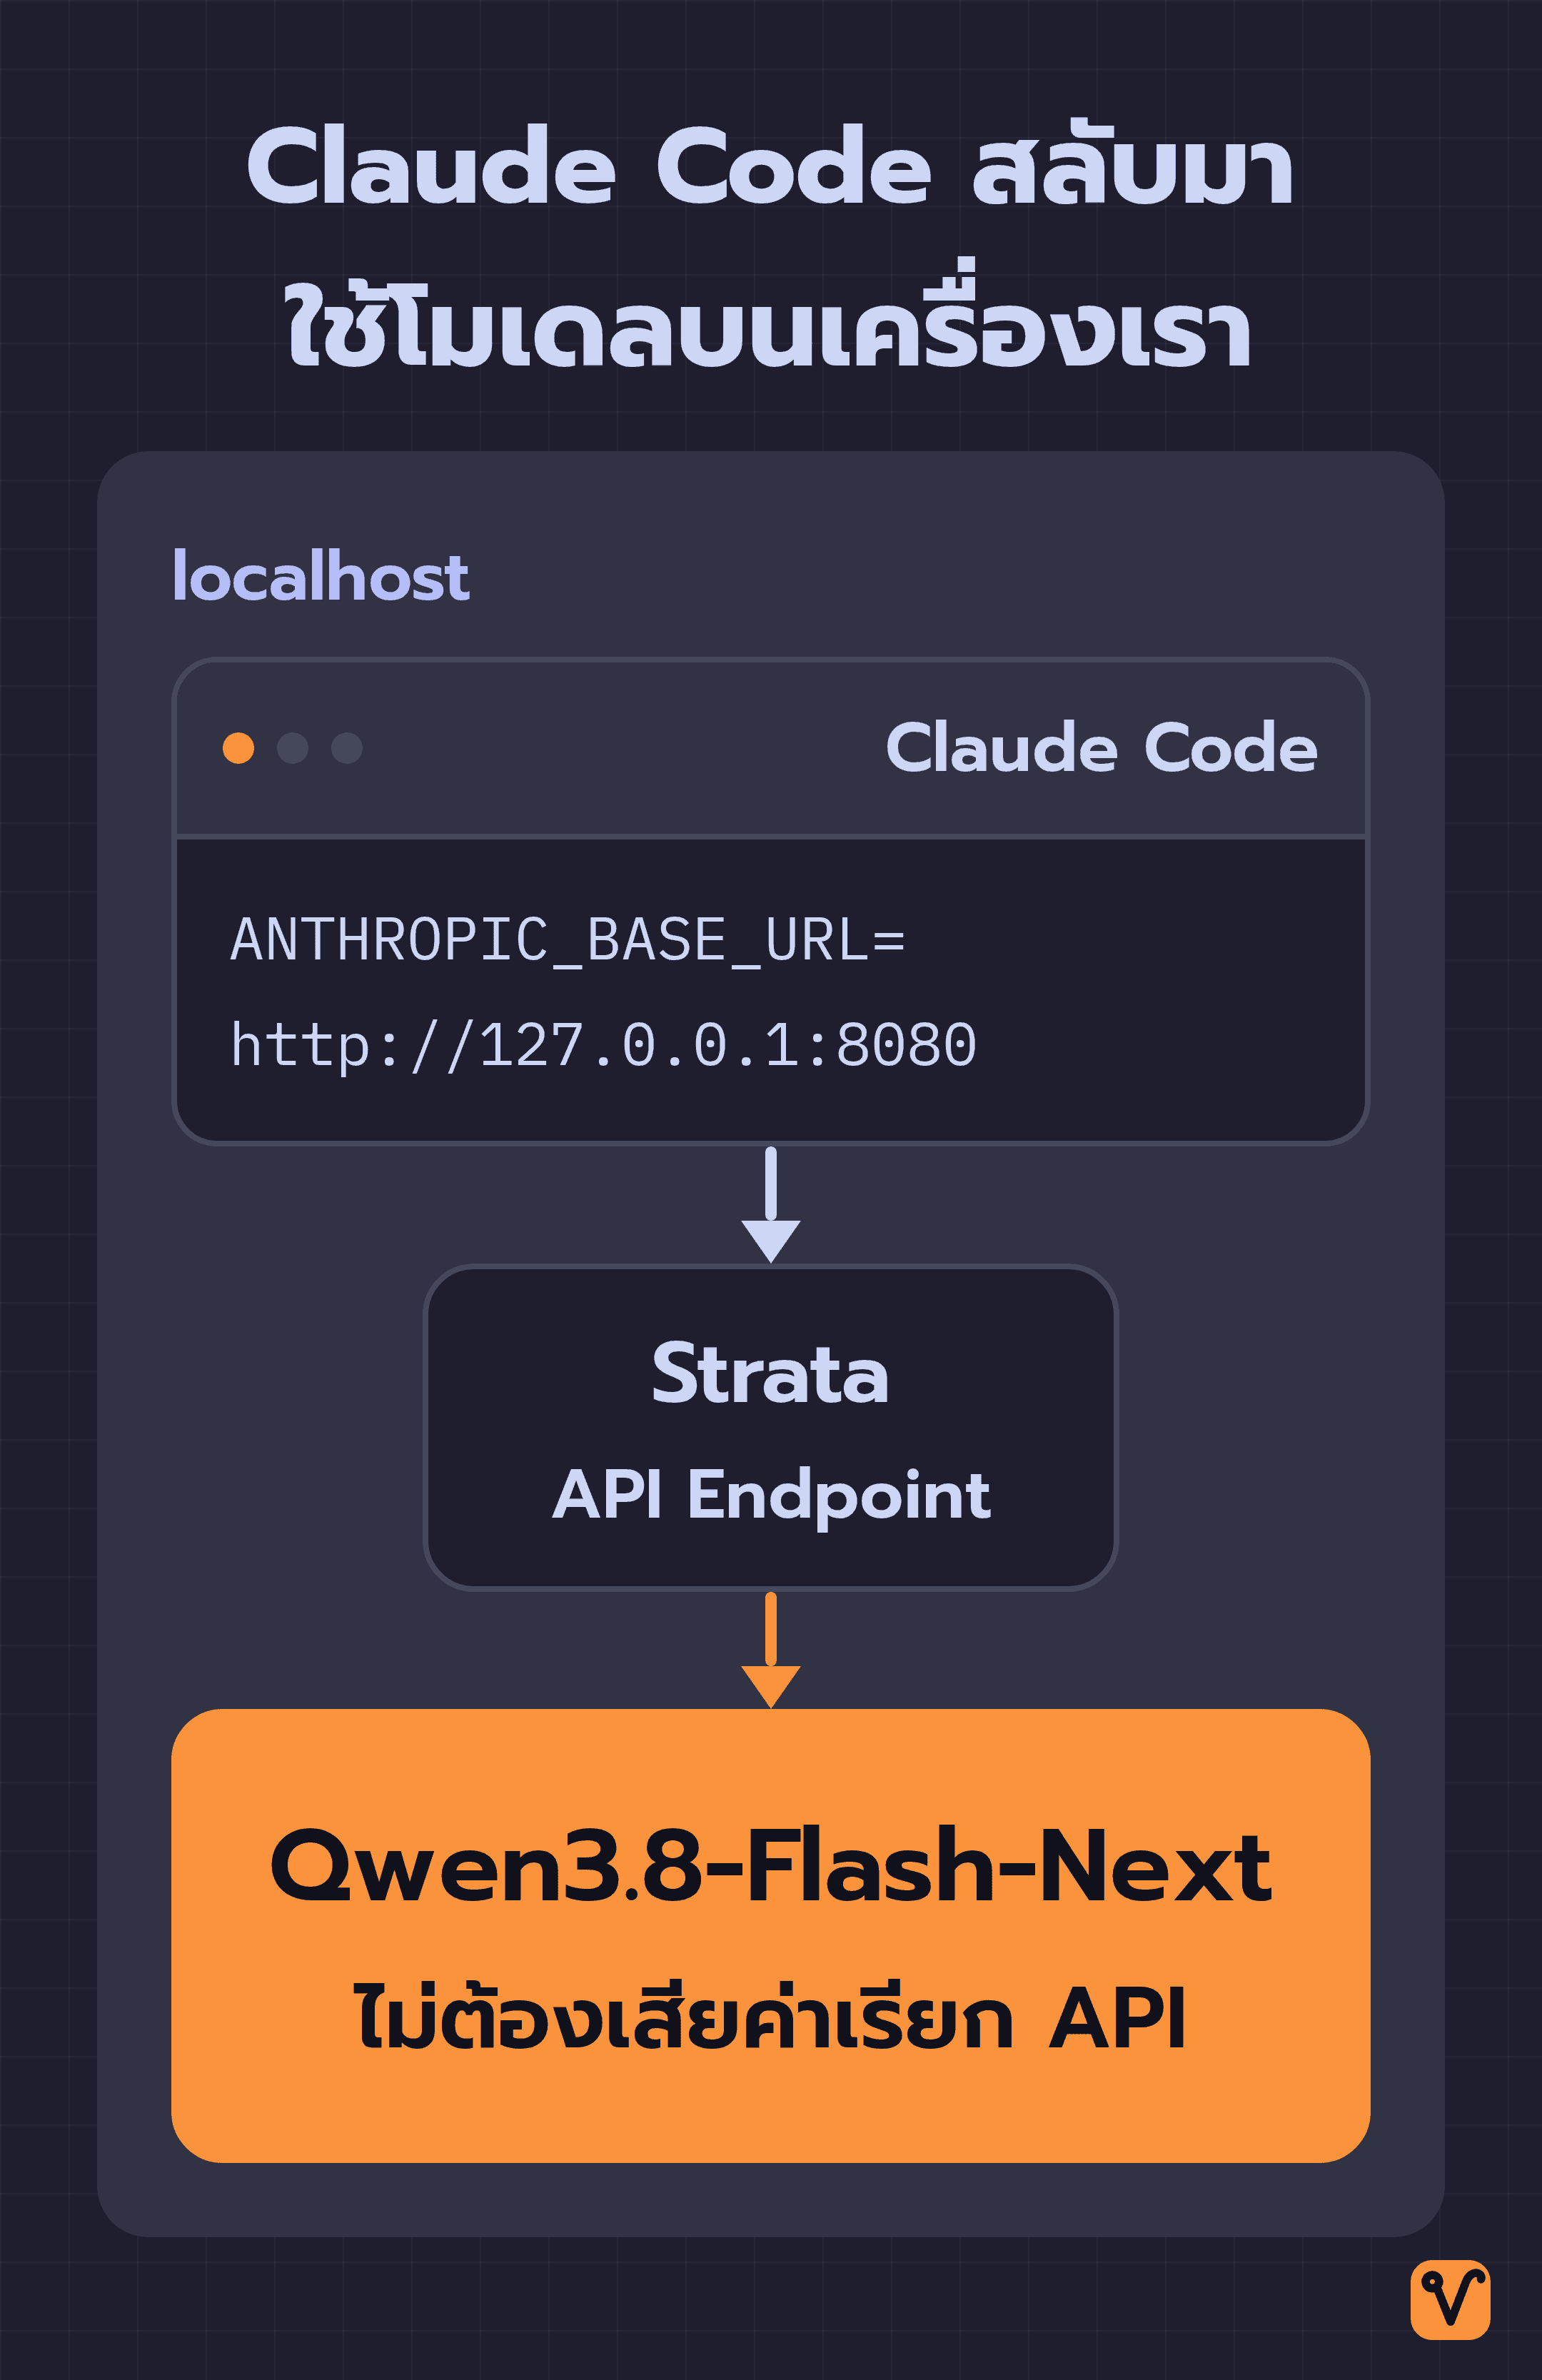
เมื่อ Strata เริ่มทำงาน ระบบจะเปิด API Endpoint ไว้ที่ localhost บนเครื่องของเราทันที Endpoint นี้เป็นช่องทางเชื่อมต่อที่รองรับทั้งรูปแบบของ OpenAI และ Anthropic
Claude Code จึงคุยกับ Strata ได้เหมือนคุยกับ API ปกติ แค่ตั้ง Environment Variable หรือตัวแปรระบบ 3 ตัวนี้ก่อนเปิด Claude Code:
ANTHROPIC_BASE_URL=http://127.0.0.1:8080
ANTHROPIC_MODEL=<ชื่อโมเดล Claude ที่ Claude Code รู้จัก>
ANTHROPIC_AUTH_TOKEN=<ใส่อะไรก็ได้>ANTHROPIC_BASE_URL: กำหนดให้ชี้มาที่ Strata บนเครื่องเราเอง จุดสำคัญคือไม่ต้องใส่/v1ต่อท้าย เพราะ Claude Code จะเติม/v1/messagesเข้าไปให้อัตโนมัติANTHROPIC_MODEL: ใส่ชื่อโมเดล Claude รุ่นใดก็ได้ที่ Claude Code รู้จัก เพื่อให้โปรแกรมเริ่มต้นทำงานได้ ส่วน Strata จะไม่สนใจชื่อนี้ และใช้โมเดลในเครื่องอยู่แล้วANTHROPIC_AUTH_TOKEN: ใส่ข้อความอะไรก็ได้ หรือถ้าตั้ง API Key ไว้ ก็ใส่ Key นั้น
หากใครเคยตั้งค่าตามบทความ พา Claude Code ไปวิ่งผ่าน OpenRouter มาก่อน จะคุ้นเคยกับขั้นตอนนี้ดี ต่างกันแค่รอบนี้ปลายทางอยู่ที่เครื่องของเราเอง
แต่ยังมีวิธีที่ง่ายกว่านั้น คือให้ Strata ตั้งค่าให้อัตโนมัติด้วยคำสั่งเหล่านี้:
strata connect
strata connect <app> --write
strata connect <app> --checkคำสั่งแรกจะแสดงรายชื่อแอปพลิเคชันที่รองรับ เช่น Claude Code, Codex CLI, OpenCode หรือ Hermes Agent จากนั้นให้นำชื่อแอปจากรายการนี้ไปใส่แทน <app>
คำสั่งที่สองจะเขียนไฟล์ตั้งค่าให้แอปนั้นอัตโนมัติ โดยถามยืนยันก่อน และสำรองไฟล์เดิมไว้ให้เสมอ ส่วนคำสั่งที่สามจะส่ง Prompt และลองเรียกใช้เครื่องมือภายนอกหรือ Tool Call แบบเดียวกับที่แอปนั้นใช้งานจริง เพื่อเช็กว่าการเชื่อมต่อทำงานได้สมบูรณ์หรือไม่
เรื่องความเป็นส่วนตัว README ระบุไว้อย่างชัดเจนว่าระบบเป็นแบบ No Telemetry ไม่มีการเก็บหรือส่งข้อมูลการใช้งานใดๆ ออกไปภายนอก
มีเพียงฟีเจอร์เดียวเท่านั้นที่ส่งข้อมูลออกสู่อินเทอร์เน็ต คือระบบค้นหาข้อมูลผ่านเว็บ ซึ่งจะส่งเฉพาะข้อความคำค้นหาไปยัง DuckDuckGo หรือ Bing เท่านั้น และไม่ต้องใช้บัญชีผู้ใช้งานใดๆ
Qwen3.8-Flash-Next ยังตามหลัง Opus 5.5 แต่ปิดงานจริงได้
แม้ Strata จะยืนยันได้ว่าคอมพิวเตอร์ของเรารันโมเดลนี้ไหว แต่โมเดลเก่งพอจะใช้แทนโมเดลเรือธงของ Anthropic อย่าง Opus 5.5 ในงานจริงได้แค่ไหน ยังต้องดูจากผลการทดสอบ
ข้อมูลเปรียบเทียบชุดหนึ่งมาจากกระทู้ใน r/LocalLLaMA ชุมชนผู้ใช้งาน Local LLM บน Reddit
ข้อควรทราบก่อนดูตัวเลขคือ ผู้โพสต์ไม่ได้รันผ่าน Strata แต่ใช้ Halogen รัน Qwen3.8-Flash-Next บนโน้ตบุ๊กที่ใช้ชิป AMD Strix Halo โดย Halogen เป็นโปรแกรมรันโมเดลอีกตัวหนึ่ง ผลการทดสอบนี้จึงสะท้อนความสามารถของตัวโมเดลเอง ไม่เกี่ยวกับความเร็วหรือประสิทธิภาพของ Strata
โจทย์ที่ใช้ทดสอบเป็นฟีเจอร์จริงจากแผนงานของโปรเจกต์ LlamaStash คือให้ llama-server บันทึก KV Cache หรือข้อมูลบริบทที่ประมวลผลไปแล้วเก็บไว้ก่อนปิดโมเดล แล้วดึงกลับมาใช้ใหม่เมื่อเปิดโมเดลขึ้นมาอีกครั้ง
การทดสอบแบ่งเป็น 6 รูปแบบ โดยจับคู่ Coding Agent, ตัวโมเดล และระดับ Effort ต่างกันไป ซึ่ง Effort คือค่าที่กำหนดว่าโมเดลจะคิดวิเคราะห์ลึกแค่ไหนก่อนตอบ
แต่ละรูปแบบจะทดสอบซ้ำ 2 รอบ ทำให้ได้รายการเสนอแก้ไขโค้ดอย่าง Pull Request หรือ PR ออกมาทั้งหมด 12 รายการ
แต่ละ PR มีคะแนนเต็ม 8 คะแนน มาจากคำถามรีวิวโค้ด 7 ข้อ ร่วมกับผลทดสอบอัตโนมัติผ่านระบบ CI ส่วนกรรมการให้คะแนนคือโมเดล AI 3 ตัว ได้แก่ Opus 5.5, Flash-Next และ Kimi K3
| ชุดที่ใช้ | คะแนน | เวลา | ค่า API |
|---|---|---|---|
| Claude Code + Opus 5.5 (medium) | 78% | 23.4 นาที | $6.52 |
| Claude Code + Flash-Next (medium) | 69% | 45.3 นาที | $0.32 |
| Claude Code + Opus 5.5 (xhigh) | 87% | 43.5 นาที | $17.78 |
สองแถวบนเทียบกันได้ตรงๆ เพราะตั้ง Effort ไว้ที่ระดับ Medium เท่ากัน ส่วนแถวล่างคือผลของ Opus 5.5 ที่ปรับ Effort ขึ้นไปที่ระดับ xhigh เพื่อให้เห็นเพดานความสามารถ
คะแนนในตารางเป็นค่าเฉลี่ยจากการทดสอบทั้ง 2 รอบ ส่วนตัวเลขเวลาและค่าใช้จ่ายบันทึกมาจากการทดสอบในรอบที่สอง
เมื่อตั้งค่า Effort เท่ากัน Opus ทำคะแนนได้สูงกว่า แต่ก็ต้องพิจารณาด้วยว่าผลนี้มาจากโจทย์เพียงข้อเดียว และตัว Flash-Next เองก็เป็นหนึ่งในกรรมการร่วมให้คะแนนด้วย
สำหรับตัวเลขค่าใช้จ่าย $0.32 นั้น เป็นการคำนวณเปรียบเทียบตามราคา API ของ Qwen3.8-Flash บน QwenCloud แต่ในการใช้งานจริงบนเครื่องตัวเอง จะมีเพียงต้นทุนค่าไฟเท่านั้น
PR ทั้ง 12 รายการผ่านการทดสอบจริงตั้งแต่ต้นจนจบแบบ End-to-End ได้ทั้งหมด แสดงว่าทุกรูปแบบพัฒนาฟีเจอร์นี้ออกมาใช้งานได้จริง
ผู้โพสต์สรุปว่า สิ่งที่ทำให้ผลต่างกันจริงๆ คือการรับมือ Edge Case หรือกรณีพิเศษที่เกิดขึ้นได้ยาก, ความครอบคลุมของชุดทดสอบ และความสมบูรณ์ของเอกสารประกอบ
ในด้านความเร็ว เมื่อตั้งค่า Effort เท่ากัน Flash-Next จะใช้เวลาในการทำงานนานกว่า Opus ประมาณ 1.1–2.1 เท่า
นอกจากนี้ ตัว Coding Agent ที่นำมาใช้งานร่วมกันก็มีผลต่อผลลัพธ์เช่นกัน เพราะเมื่อใช้ Flash-Next ผ่าน Claude Code PR ผ่าน CI ได้ครบทั้ง 4 รอบ แต่พอเปลี่ยนไปใช้ Pi ซึ่งเป็นโปรแกรมช่วยเขียนโค้ดอีกตัวหนึ่ง โค้ดกลับผ่าน CI เพียง 1 ใน 4 รอบเท่านั้น ทั้งที่คะแนนรีวิวจากคำถามได้เท่ากัน
ฝั่งความคิดเห็นใต้กระทู้ มีคนที่รันชุดวัดผลโมเดลบนเครื่องตัวเองเตือนว่า ผลจากโจทย์เพียงข้อเดียวแกว่งได้ โมเดลเดิมเมื่อรันซ้ำอาจผ่านหรือตกต่างกันในแต่ละรอบ และผลการทดสอบผ่าน CI อาจขยับเปลี่ยนไปได้หากรันใหม่
ผู้ใช้อีกรายระบุว่า โมเดลขนาดนี้เมื่อรันบนเครื่องตัวเองยังเขียนเอกสารประกอบได้แย่มาก ทำให้เขายังคงต้องพึ่งพา Opus สำหรับงานเขียนเอกสารทางเทคนิคอยู่
ผู้โพสต์เองยอมรับว่าในแง่ความสามารถ ทั้งสองโมเดลยังอยู่คนละระดับกัน แต่สรุปภาพรวมไว้ว่า Opus ยังเป็นผู้นำ ขณะที่ Flash-Next ซึ่งรันบนโน้ตบุ๊กของเขาตามมาติดๆ โดยเสียแค่ค่าไฟเท่านั้น
ในการใช้งานจริงจึงแนะนำให้เลือกตามลักษณะงาน ถ้าเป็นงานที่ต้องดักจับ Edge Case อย่างละเอียด มีชุดทดสอบครอบคลุม และต้องการเอกสารครบถ้วน Opus 5.5 ยังทำได้ดีกว่าในผลชุดนี้ แต่ต้องแลกกับค่า API ที่สูงกว่า ส่วนงานที่รอได้นั้น Flash-Next บนเครื่องตัวเองก็ปิดงานได้เช่นกัน โดยแลกกับเวลาที่นานขึ้น
กระทู้ที่เตือนว่าอย่าเพิ่งอัปเกรด Strata
อีกกระทู้หนึ่งในชุมชนเดียวกันตั้งหัวข้อเตือนไว้ตรงๆ ว่า "อย่าเพิ่งอัปเกรด Strata มี Breaking Changes ครั้งใหญ่" ซึ่งหมายถึงการเปลี่ยนแปลงที่ทำให้ระบบเดิมพัง
เจ้าของกระทู้ซึ่งใช้งานทั้งบน Windows และ Linux เล่าว่า ในเวอร์ชันใหม่เพิ่มเงื่อนไขและขั้นตอนเปิดเซิร์ฟเวอร์ที่ไม่จำเป็นเข้ามามากมาย
ขณะที่หน้า Web UI ก็ดูจะหันไปเน้นแอปพลิเคชันเดสก์ท็อปมากกว่าเดิม เขาจึงแนะนำว่าอย่างน้อยที่สุดควรสำรองข้อมูลและการตั้งค่าเดิมไว้ก่อนอัปเกรด
ความคิดเห็นใต้กระทู้ยังเล่าถึงปัญหาอื่นๆ ที่พบเจอหลังจากอัปเกรดอีกหลายจุด เช่น:
- การเชื่อมต่อผ่าน Proxy เข้ามายังเครื่องที่รัน Strata ใช้งานไม่ได้แล้ว และเจ้าของคอมเมนต์ระบุว่าลองแก้อย่างไรก็ไม่หาย
- ชื่อโมเดลเปลี่ยน ทำให้แอปพลิเคชันภายนอกที่เคยเชื่อมต่ออยู่เกิดปัญหาและต้องตามไปแก้ไขชื่อโมเดลใหม่
- เครื่องที่ติดตั้งการ์ดจอ 2 ใบทำงานช้าลง และใช้เวลานานกว่าระบบจะกลับมาเปิดใช้งานการ์ดทั้งสองใบได้พร้อมกัน
- ขณะที่ผู้ใช้อีกรายระบุว่า สิ่งเดียวที่มีปัญหาสำหรับเขาคือระบบบังคับให้ต้องใช้ API Key เมื่อเชื่อมต่อจากเครื่องอื่นในวงแลนเดียวกัน ซึ่งเขามองว่าเป็นเรื่องความปลอดภัยพื้นฐานที่ควรมีอยู่แล้ว
มีผู้ใช้งานเข้ามาถามว่าเวอร์ชันนี้เป็นเพียงรุ่น Beta หรือไม่ พร้อมแนบลิงก์ไปยังหน้า Strata 0.2.0-beta
ส่วนอีกคนแนะนำให้ใช้เวอร์ชัน 0.1.45 ต่อไปก่อน เพราะเขามองว่าเวอร์ชัน 0.1 คือตัว Engine ล้วนๆ ขณะที่ 0.2 คือเปลือกที่เอามาครอบทับไว้แบบลวกๆ
มีคอมเมนต์หนึ่งสรุปสถานการณ์นี้ไว้สั้นๆ ว่า "Vibe coding giveth, and vibe coding taketh away" แปลได้ว่าแนวทางการเขียนโค้ดด้วย AI อย่าง Vibe Coding ให้ได้ ก็เอาคืนได้เหมือนกัน
อย่างไรก็ดี มีเสียงท้วงติงเช่นกันว่าโปรเจกต์นี้พัฒนาโดยนักพัฒนาเพียงคนเดียว ไม่ควรไปตำหนิเขา หากใครกังวลก็คัดลอกโค้ดแยกออกไปพัฒนาต่อเอง หรือส่งโค้ดเข้ามาช่วยแก้ไขได้
ทางฝั่งทีมพัฒนา Strata เอง ในหน้า Release ของเวอร์ชัน 0.2.1 ระบุว่า ได้แก้ไขปัญหาโปรแกรมปิดตัวเองกะทันหัน, ปัญหาดาวน์โหลดค้าง และบั๊กการเลือกการ์ดจอที่มีรายงานในรุ่น 0.2.0-beta เรียบร้อยแล้ว นอกจากนี้ยังยกเลิกการเขียนทับค่า Engine ที่ผู้ใช้ตั้งค่าไว้เองอีกด้วย
หลังจากนั้นยังมีแพตช์ย่อยปล่อยตามออกมาอีก 4 รุ่น ตั้งแต่ 0.2.1.1 ถึง 0.2.1.4 ในช่วงวันที่ 20–21 ตุลาคมที่ผ่านมา
สำหรับโปรเจกต์ที่อัปเดตรวดเร็วเช่นนี้ แนะนำให้เลือกอัปเกรดตามความพร้อมและความจำเป็นในการใช้งานของตัวเอง โดยไม่จำเป็นต้องรีบตามอัปเดตทุกรุ่นย่อย:
- สำรองไฟล์การตั้งค่าเดิมเก็บไว้ก่อนอัปเกรดทุกครั้ง
- จดบันทึกเลขเวอร์ชันที่ใช้งานได้ดีเอาไว้ ไม่ต้องรีบตามรุ่นใหม่ทันที
- ใช้ค่าเริ่มต้นที่เปิดให้เชื่อมต่อเฉพาะจากเครื่องตัวเอง (
--access local) หากจำเป็นต้องให้เครื่องอื่นในวงแลนเชื่อมต่อเข้ามา ให้สั่งรันด้วยstrata launch --access lanซึ่งระบบจะสร้าง Key ยาวแบบสุ่มให้โดยอัตโนมัติ - หากมีการเชื่อมต่อผ่าน Proxy หรือมีสคริปต์ที่เรียกใช้งานชื่อโมเดลเดิม ให้ตรวจสอบทั้ง 2 จุดนี้เป็นพิเศษ เพราะมีผู้ใช้รายงานปัญหาเรื่องนี้ไว้ในกระทู้
- หลังการอัปเกรด ให้รันคำสั่ง
strata connect <app> --checkเสมอ เพื่อให้มั่นใจว่าแอปพลิเคชันยังเชื่อมต่อกับระบบได้สมบูรณ์
สุดท้ายแล้ว คำถามเรื่องค่าใช้จ่ายด้าน AI ในแต่ละเดือน อาจไม่ใช่ว่าเราต้องเตรียมเงินไว้จ่ายค่าบริการเท่าไหร่ แต่เป็นการ์ดจอที่เราซื้อมาเล่นเกมนี้ ช่วยเราแบ่งเบางานและประหยัดค่าใช้จ่ายไปได้มากแค่ไหนแล้ว
ที่มา:
- โปรเจกต์ Strata บน GitHub
- เอกสารทางการของ Strata
- เอกสารทางการของ Strata
- บทความ Do not upgrade Strata, tons of breaking changes จาก r/LocalLLaMA
- บทความ Qwen3.8-Flash-Next vs Opus 5.5 six-way benchmark จาก r/LocalLLaMA
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
สร้าง Claude Skill แบบไม่ต้องรู้โค้ด คู่มือสร้าง Claude Skill ของคุณเองด้วยการคุยกับ Claude Code เป็นภาษาไทย
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin