แกะ yomiyasu มาทำสกิลเกลาภาษาไทยที่ AI เขียน: สกิลญี่ปุ่นที่เลิกแบนคำ แล้วหันมาแก้โครงสร้างประโยค
yomiyasu คือสกิลเกลาภาษาญี่ปุ่นที่ AI เขียน เลิกแบนคำแล้วหันมาแก้โครงประโยคให้ชัดว่าใครทำอะไร กฎ สคริปต์ตรวจ และชุดทดสอบ นำมาเป็นต้นแบบทำสกิลภาษาไทยได้
เขียนถูกหลักไวยากรณ์ทุกคำ แต่อ่านไปแค่สองบรรทัดก็รู้ทันทีว่า AI เขียน นี่คือปัญหาที่นักพัฒนาชาวญี่ปุ่นคนหนึ่งพยายามแก้ในภาษาของเขา ผ่านโปรเจกต์โอเพนซอร์สสำหรับเกลาสำนวนชื่อ yomiyasu
ถ้าคุณใช้ AI ช่วยเขียนอีเมล โพสต์ หรือรายงานภาษาไทยอยู่เป็นประจำ ก็น่าจะคุ้นเคยกับอาการที่อ่านแล้วรู้สึกแปร่งๆ แบบนี้ดี
yomiyasu พัฒนาขึ้นมาในรูปแบบ Agent Skill หรือชุดไฟล์สกิลที่โหลดเข้าเครื่องมือ AI สายโค้ดอย่าง Claude Code, Codex หรือ Cursor เพื่อให้ AI อ่านและทำความเข้าใจกฎเกณฑ์ต่างๆ ก่อนลงมือเกลางานเขียนจริง
โค้ดทั้งหมดเปิดเป็นโอเพนซอร์สอยู่ในคลังโค้ด nanaism/yomiyasu บน GitHub ผู้พัฒนาคือคุณ 大賀 愛一郎 (Oga Aiichiro) จากสตาร์ตอัป ALGO ARTIS หน้าแนะนำโปรเจกต์ระบุไว้ชัดเจนว่านี่เป็นงานส่วนตัว ไม่ใช่ผลิตภัณฑ์ทางการของบริษัท
สิ่งที่ทำให้มันแตกต่างจากพรอมต์หรือสกิลปรับสำนวนทั่วไป คือผู้สร้างเลิกใช้วิธีแบนคำ แต่เปลี่ยนมาบังคับให้ทุกประโยคบอกชัดเจนว่า «ใครทำอะไรกับอะไร» โดยมีเงื่อนไขสำคัญคือ ห้ามเปลี่ยนความหมายเดิม และห้ามเติมข้อมูลที่ต้นฉบับไม่มีเข้าไปเด็ดขาด
แม้กฎและเกณฑ์ตัวเลขต่างๆ ในโปรเจกต์จะออกแบบมาสำหรับภาษาญี่ปุ่น แต่โครงสร้างการทำงานทั้งชุด ตั้งแต่ไฟล์กฎ แฟ้มอ้างอิง สคริปต์ตรวจ ไปจนถึงชุดทดสอบ ล้วนถอดมาเป็นพิมพ์เขียวเพื่อสร้างสกิลเกลาภาษาไทยของเราเองได้สบายๆ
ทำไมสั่งแบนคำแล้ว งานเขียนก็ยังดูออกว่าเป็น AI
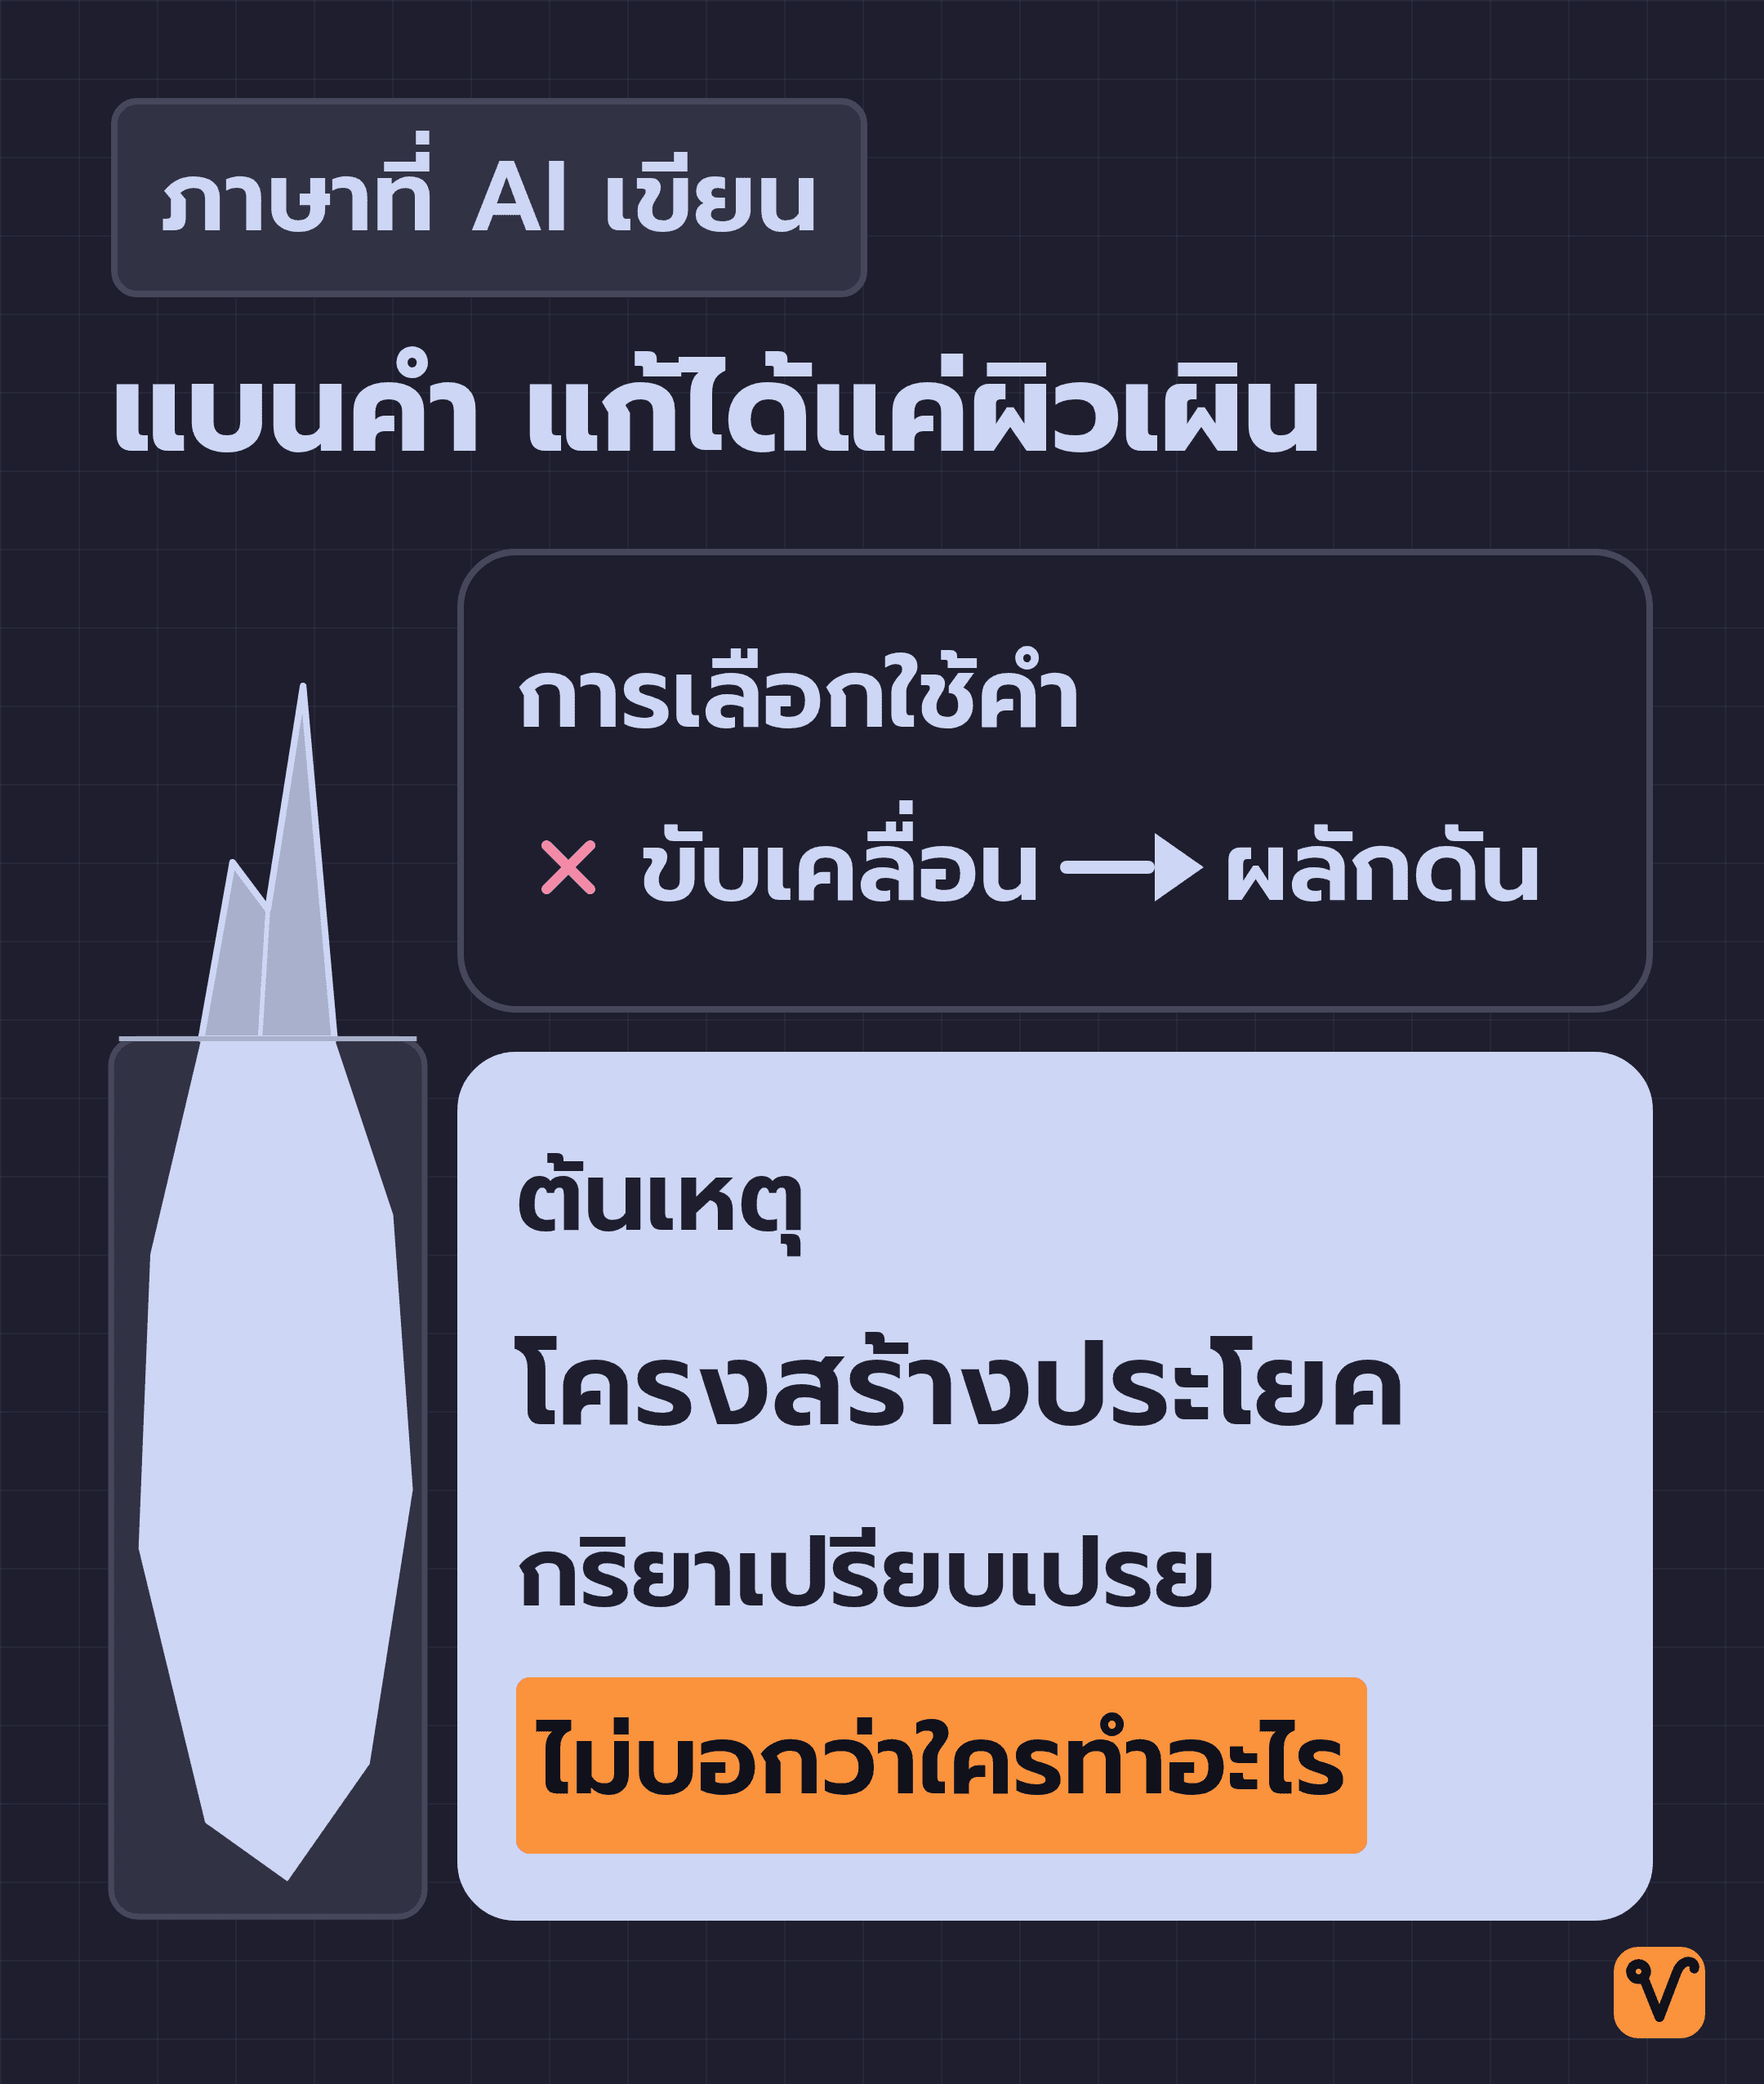
README หรือหน้าแนะนำโปรเจกต์ของ yomiyasu สรุปข้อจำกัดของวิธีแก้ปัญหาแบบเดิมไว้ 4 ข้อ ถ้าลองเทียบกับภาษาไทยที่เราเจอจาก AI อยู่เป็นประจำ จะเห็นว่าตรงกันชัดเจนมาก
ข้อแรก การแบนคำแก้ปัญหาได้แค่ผิวเผิน ผู้สร้างยกตัวอย่างคำภาษาญี่ปุ่นที่แปลได้ประมาณ «สัมผัส» หรือ «ความประณีต» พอเราสั่งห้ามคำพวกนี้ AI ก็แค่เลี่ยงไปหยิบคำกำกวมคำอื่นมาใช้แทน แต่โครงสร้างประโยคที่แปลกๆ ก็ยังคงอยู่ครบ ถ้าคุณเคยสั่งห้ามใช้คำว่า «ขับเคลื่อน» แล้วในร่างใหม่ AI เปลี่ยนไปใช้คำว่า «ผลักดัน» ในตำแหน่งเดิมเป๊ะ นั่นคืออาการเดียวกัน
ข้อสอง การใส่กฎการเขียนมากเกินไป พอเรายัดคำสั่งเข้าไปเยอะๆ โมเดลจะพยายามทำตามจนเกินพอดี กลายเป็นแต่งคำใหม่ขึ้นมาเอง หรือใช้สำนวนเว่อร์เกินจริง คำสั่งยอดฮิตที่ขอให้เขียน «สนุก กระชับ มีพลัง และเป็นกันเอง» พร้อมกันทีเดียว มักจะได้ข้อความประดิดประดอยที่ไม่มีใครเขาพูดกันในชีวิตจริง
ข้อสามเป็นแกนหลักของ yomiyasu นั่นคือประโยคที่ไม่ยอมบอกว่าใครทำอะไร แต่ชอบเอาสิ่งของหรือแนวคิดนามธรรมมาตั้งเป็นประธาน แล้วจับคู่กับคำกริยาเชิงเปรียบเปรย เช่น พัง ล้มเหลว หรือได้ผล ตัวอย่างในแคตตาล็อกของ yomiyasu คือประโยคทำนองว่า «ข้อมูลพังทลายอย่างเงียบๆ» ซึ่งคนอ่านต้องมานั่งเดาต่อเองว่าใครทำ พังแบบไหน และเงียบในความหมายอะไร ฉบับแก้ไขจึงปรับให้ตรงไปตรงมาว่า «ข้อมูลผิดเพี้ยนไปโดยไม่มีใครสังเกตเห็น»
ประโยคภาษาไทยที่เราเจอบ่อยอย่าง «กลยุทธ์นี้จะพาแบรนด์ก้าวไปอีกขั้น» ก็เป็นแบบเดียวกันเป๊ะ เพราะยกให้กลยุทธ์กลายเป็นประธานของประโยค ส่วนคนที่ต้องเป็นฝ่ายลงมือทำจริงๆ กลับหายไป
ข้อสี่ คือใส่ตัวหนากับหัวข้อย่อยเต็มไปหมด แต่เนื้อหาสำคัญอย่างขั้นตอนการทำงานหรือกลไกของโค้ดกลับเขียนไว้ลอยๆ ทำให้สาระจริงในเนื้อหาเบาบางลง เหมือนรายงานที่ทำตัวหนาแทบทุกย่อหน้า แต่อ่านจบแล้วก็ยังไม่รู้ว่าตกลงต้องเริ่มต้นทำอะไรก่อน
พออ่านครบทั้งสี่ข้อ จะเห็นว่าการไล่แก้ทีละคำแก้ปัญหาไม่ถึงต้นเหตุ ผู้สร้างจึงเลือกแก้ที่โครงสร้างประโยคแทน โดยยึดหลักว่า «ประโยคต้องระบุชัดเจนว่าใครทำอะไรให้จบในตัว» แนวคิดนี้มาจากงานวิจัยและเอกสารอ้างอิงที่ชี้ว่า ภาษา AI อ่านยากเพราะโครงสร้างประโยคที่พังและการใช้ประธานที่ไม่มีชีวิต มากกว่าเพราะการเลือกใช้คำ
กฎสูงสุดของ yomiyasu คือห้ามเปลี่ยนความหมายเดิม
ก่อนที่ AI จะเริ่มแก้คำไหน ไฟล์ SKILL.md ซึ่งเป็นกฎหลักของ yomiyasu จะสั่งให้มันล็อก 4 องค์ประกอบสำคัญของประโยคเดิมไว้ก่อนเสมอ:
- ใจความสำคัญที่ประโยคต้องการสื่อ
- น้ำหนักของเนื้อหา ว่าเรื่องไหนสำคัญกว่าเรื่องไหน
- ระดับความมั่นใจในการยืนยัน เช่น ฟันธง คาดเดา หรือแค่เป็นไปได้
- หน้าที่ของประโยค ว่ากำลังอธิบาย ร้องขอ วางแผน หรือบอกความรู้สึก
เมื่อเกลาเสร็จแล้ว ทั้ง 4 อย่างนี้ต้องคงเดิมไม่คลาดเคลื่อน กฎข้ออื่นๆ ในสกิลจะนำมาใช้ได้ก็ต่อเมื่อไม่กระทบกับ 4 ข้อนี้เท่านั้น
เรื่องระดับความมั่นใจในการยืนยันเป็นตัวอย่างที่เห็นภาพง่ายที่สุด เช่น ถ้าร่างเดิมเขียนว่า «ระบบนี้น่าจะช่วยลดเวลาทำงานได้» แล้วเราเกลาจนเหลือ «ระบบนี้ช่วยลดเวลาทำงาน» แม้ประโยคจะสั้นและลื่นขึ้นก็จริง แต่ระดับความมั่นใจเปลี่ยนจาก 'คาดเดา' กลายเป็น 'ฟันธง' ซึ่งตามกฎของ yomiyasu ถือว่าแก้ผิด
กฎเหล็กที่บังคับใช้คู่กันคือ ห้ามเติมข้อมูลเข้าไปเองเด็ดขาด ทั้งตัวผู้กระทำ เหตุผล เงื่อนไข ตัวเลข หรืออารมณ์ความรู้สึกที่ไม่มีในต้นฉบับ รวมถึงห้ามเปลี่ยนคำอธิบายกว้างๆ ให้กลายเป็นข้อเท็จจริงที่เจาะจงเกินกว่าที่ระบุไว้
ถ้าข้อมูลในต้นฉบับไม่พอจะเขียนให้ชัดเจน สกิลจะเลือกเขียนประโยคกลางๆ ที่ยังรักษาใจความเดิมไว้ โดยไม่แทรกโน้ตหรือคำถามเข้ามาขัดจังหวะกลางเนื้อหา แล้วค่อยรวบคำถามถึงผู้เขียนไว้ท้ายงาน ไม่เกิน 2 ข้อ
กฎสองข้อนี้คือหัวใจสำคัญที่ป้องกันไม่ให้ AI แต่งเรื่องเพิ่มขึ้นมาเอง ส่วนแนวทางการเกลาภาษาทั้งหมด เอกสาร README สรุปไว้ 7 ข้อ ดังนี้:
- ความสัมพันธ์ระหว่างประธานกับกริยา คำขยายกับสิ่งที่ถูกขยาย รวมถึงเงื่อนไข ข้อยกเว้น ตัวเลข และลำดับขั้นตอน ต้องยังโยงถึงกันได้ถูกต้องเหมือนเดิมหลังเกลาเสร็จ และจะเติมผู้กระทำลงในประโยคได้เฉพาะกรณีที่ต้นฉบับระบุไว้ชัดเจนเท่านั้น
- รักษาระดับภาษาและหน้าที่ของประโยคตามเดิม แก้เฉพาะคำลงท้ายที่ไม่ตรงกับหน้าที่ของประโยค และไม่สลับคำลงท้ายเล่นเพียงเพื่อให้ดูหลากหลาย
- เลิกเขียนให้เครื่องมือหรือแนวคิดนามธรรมมีความรู้สึก ความตั้งใจ หรืออารมณ์เหมือนคน
- เปลี่ยนคำกริยาเชิงเปรียบเปรยให้เป็นคำตรงไปตรงมา โดยยังคงความหมายเดิมไว้ครบถ้วน
- ตัดคำเกริ่นนำทิ้งได้เฉพาะเมื่อตัดแล้วไม่กระทบต่อใจความสำคัญและน้ำหนักของประโยค
- ไม่เติมข้อมูลเอง และเลี่ยงการใช้คำศัพท์ที่ใหญ่โตเกินบทบาทจริง เช่น การเรียกกฎธรรมดาว่า «พันธสัญญา»
- ควบคุมความยาวของประโยคและลดการใช้เครื่องหมายตกแต่ง โดยเป้าหมายในภาษาญี่ปุ่นกำหนดไว้ที่ 30-45 ตัวอักษรต่อประโยค
กฎข้อสามเป็นจุดที่หลายคนมักพลาด เพราะประธานที่เป็นสิ่งของไม่ได้ผิดเสมอไป ประโยคอย่าง «สคริปต์จะตรวจสอบไฟล์ทุกครั้งที่มีการบันทึก» เป็นการบอกการทำงานจริงของเครื่องมือ ประโยคแบบนี้ yomiyasu ให้เก็บไว้ได้ตามปกติ สิ่งที่ต้องแก้คือประโยคที่แต่งให้สิ่งของมีความรู้สึกหรือความตั้งใจเหมือนมนุษย์ต่างหาก
ตัวอย่างก่อนและหลังแก้จาก README
ตัวอย่างแรกใน README เป็นเนื้อหาเรื่อง Design System ซึ่งเป็นชุดมาตรฐานสำหรับออกแบบปุ่มและหน้าจอที่ทีมใช้ร่วมกัน เนื้อหาด้านล่างนี้สรุปใจความสำคัญจากต้นฉบับภาษาญี่ปุ่น:
ร่างเดิมเปิดด้วยการประกาศว่า สิ่งสำคัญคือ «ธรรมาภิบาลในฐานะระบบปฏิบัติการหรือ OS สำหรับการตัดสินใจขององค์กร» แล้วตามด้วยประโยคทำนองว่า «ถ้าดูแค่ฝั่งเดียว มาตรฐานการใช้งานของทุกคนอย่าง Accessibility ของอีกฝั่งจะพังทลายอย่างเงียบๆ» และ «พอมี Design System เป็นฐาน ความประณีตของ Dev จะก้าวไปอีกขั้น» ก่อนจะปิดท้ายด้วยหัวข้อย่อยระบุข้อดีว่า «ไม่ต้องละลายเวลาทิ้ง»
ฉบับแก้ไขเปลี่ยนมาบอกตรงๆ ว่าทำอะไรเพื่อเป้าหมายอะไร โดยอธิบายว่า การนำ Design System มาใช้ก็เพื่อลดภาระการสร้างปุ่มและช่องกรอกข้อมูลซ้ำๆ ตั้งแต่ศูนย์ แล้วเอาแรงไปโฟกัสกับการออกแบบโครงสร้างข้อมูลของทั้งหน้าแทน ถ้าทีมกำหนดหน้าตาและข้อกำหนดด้าน Accessibility ของชิ้นส่วนแต่ละชิ้นไว้ล่วงหน้า ดีไซเนอร์และโปรแกรมเมอร์ก็จะทำงานร่วมกันได้อย่างราบรื่น งานออกแบบไม่ได้หายไปไหน เพียงแต่เวลาที่เคยหมดไปกับการสร้างชิ้นส่วนพื้นฐาน จะย้ายไปใช้กับการตรวจสอบการใช้งานจริงและพัฒนาคุณภาพของงานแทน
README อธิบายว่าการเกลารอบนี้เปลี่ยน 3 จุดสำคัญ ได้แก่ เปลี่ยนคำกริยาเปรียบเปรยอย่าง «พังทลายอย่างเงียบๆ» หรือ «ละลายเวลา» ให้เป็นการกระทำจริงที่จับต้องได้ ตัดคำกำกวมอย่าง «OS สำหรับการตัดสินใจ» หรือ «ความประณีต» ทิ้งแล้วใส่เนื้องานจริงแทน และเปลี่ยนตัวหนากับหัวข้อย่อยที่มากเกินไปให้เป็นความเรียงที่อ่านต่อเนื่องได้ลื่นไหล
แกะ yomiyasu ทีละชั้น ตั้งแต่ SKILL.md ถึงชุดทดสอบ
yomiyasu แบ่งการทำงานออกเป็น 4 ชั้น แต่ละชั้นดูแลคนละเรื่อง:
| ชั้น | ไฟล์ | หน้าที่ |
|---|---|---|
| กฎหลัก | SKILL.md | กำหนดกฎสูงสุด ขั้นตอนทำงาน 4 ขั้น และรูปแบบคำตอบ |
| แฟ้มอ้างอิง | slop-catalog.md · domains/ · gemini-syntax.md | แคตตาล็อกเจ็ดหมวด คู่มือแยกตามประเภทงาน และหลักแปลงโครงสร้างไวยากรณ์ |
| สคริปต์ตรวจ | yomiyasu_lint.py · yomiyasu_diff.py | นับสิ่งที่เครื่องตรวจนับได้ และเครื่องมือเทียบข้อความก่อนกับหลังแก้ |
| ชุดทดสอบ | tests/corpus/ · tests/fixtures/ | คลังข้อความคนและข้อความ AI สำหรับวัดผล พร้อมเคสทดสอบซ้ำ 50 เคส |
SKILL.md แบ่งงานเป็นสี่ขั้น
นอกจากข้อกำหนดเรื่องกฎแล้ว SKILL.md ยังกำหนดลำดับการทำงานที่ AI ต้องทำตาม 4 ขั้นตอน:
- ทำความเข้าใจบริบท: ตัดสินว่าร่างงานเขียนจัดอยู่ในกลุ่มไหนระหว่าง Tech (งานเทคนิค) Business (งานธุรกิจ) หรือ Essay (ความเรียงทั่วไป) จากนั้นจับใจความทีละย่อหน้า แล้วจดองค์ประกอบความหมายทั้ง 4 ด้านไว้ใช้เองภายใน โดยไม่แสดงในคำตอบสุดท้าย
- เขียนใหม่ตามกฎ: เกลาประโยคใหม่ตามกฎเกณฑ์โดยรักษาความหมายเดิมไว้ครบถ้วน
- รัน Lint ซึ่งเป็นสคริปต์ตรวจร่าง: ตรวจข้อความตามกฎตายตัว โดยถือว่าผลการตรวจเป็นเพียงตัวสะกิดให้กลับไปทบทวน ไม่ใช่รายการที่ต้องไล่แก้ตามแบบอัตโนมัติ
- รัน Diff เทียบผลลัพธ์: เทียบข้อความร่างเดิมกับร่างแก้ไขรอบเดียวแล้วจบ ไม่วนลูปแก้ซ้ำ และหากรัน Python ไม่ได้ ก็ใช้วิธีตรวจทานด้วยสายตาตามเกณฑ์เดียวกันแทน
เวลาใช้งานในโหมดสนทนาโต้ตอบ คำตอบจะแบ่งออกเป็น 4 ส่วน ได้แก่ ข้อความที่เขียนใหม่, จุดที่เปลี่ยน (คัดเฉพาะจุดที่อาจกระทบต่อความหมาย ไม่เกิน 5 ข้อ พร้อมเหตุผลสั้นๆ), จุดที่ยังดูเป็น AI แต่ตั้งใจเก็บไว้ตามเดิม, และคำถามถึงผู้เขียนไม่เกิน 2 ข้อ (สองส่วนหลังจะแสดงเฉพาะเมื่อจำเป็นเท่านั้น และหากผู้ใช้สั่งว่าต้องการเฉพาะเนื้อความ สกิลก็จะส่งกลับมาแค่นั้น)
การบอกจุดที่เปลี่ยนและจุดที่ตั้งใจเก็บไว้ ช่วยให้ผู้เขียนตรวจงานของสกิลซ้ำได้อย่างสบายใจ เพราะเห็นชัดเจนทั้งสิ่งที่ AI แก้ไข และสิ่งที่มันตัดสินใจไม่แตะต้อง
แฟ้มอ้างอิงที่ไม่ใช่แค่รายการคำต้องห้าม
ไฟล์ slop-catalog.md รวบรวมคำและโครงสร้างประโยคที่ไม่เป็นธรรมชาติไว้ 7 หมวด ได้แก่:
- กริยาเชิงเปรียบเปรย
- โครงสร้างประโยคที่แปลตรงตัวจากภาษาอังกฤษ
- คำศัพท์ที่คนเริ่มใช้กันเกร่อในบทความสายเทคของญี่ปุ่นช่วงปี 2026
- ศัพท์หรูหราที่ทำให้เรื่องเล็กๆ ดูยิ่งใหญ่เกินจริง
- คำที่ดูเป็นรูปธรรมแต่ความหมายแท้จริงกำกวม
- คำเกริ่นนำและคำปิดท้ายสำเร็จรูป
- ภาษาทางการแข็งๆ และวลีสูตรสำเร็จ
จุดที่ชวนสับสนคือ หน้าตาของไฟล์นี้ดูคล้ายกับบัญชีดำคำต้องห้าม แต่ในไฟล์เขียนกำกับไว้ชัดเจนว่า นี่ไม่ใช่ตารางค้นหาและแทนที่คำแบบอัตโนมัติ และไม่ได้สั่งห้ามคำไหนแบบเหมารวม คำแนะนำในนั้นจะใช้ได้ก็ต่อเมื่อความหมายยังคงเดิมเท่านั้น หากเปลี่ยนแล้วความหมายเพี้ยนไป ก็ให้คงคำเดิมไว้ และถ้าเป็นสำนวนที่มนุษย์ใช้เขียนกันเป็นปกติก่อนยุค AI ก็สามารถใช้ต่อไปได้
แม้แต่คำปิดท้ายสำเร็จรูป เกณฑ์ตัดทิ้งก็คือมันไม่ได้บอกอะไรใหม่กับผู้อ่าน แค่ฟังดูเป็น AI ยังไม่พอจะตัดออก ตัวอย่างในไฟล์คือประโยคปิดท้ายทำนองว่า «เป็นอย่างไรกันบ้าง» ซึ่งคนเขียนบทความเชิงพาณิชย์ใช้กันมานานตั้งแต่ก่อนมี AI แล้ว
สำหรับคู่มือแยกตามประเภทงาน มี 3 รูปแบบ:
- Tech สำหรับบทความเทคนิค: เน้นดึงขั้นตอนการทำงานและกลไกเชิงลึกกลับมา แล้วลดการใช้หัวข้อย่อย
- Business สำหรับงานธุรกิจและข้อเสนอ: ตัดคำเปรียบเปรยทิ้ง ระบุขอบเขตงานและผู้รับผิดชอบให้ชัดเจน
- Essay สำหรับบล็อกส่วนตัวและความเรียง: ไม่พยายามสรุปบทเรียนชีวิตให้ยิ่งใหญ่ และเก็บความรู้สึกจริงของผู้เขียนไว้
ผู้ใช้สามารถเลือกประเภทงานได้ง่ายๆ ด้วยคำสั่งธรรมดา เช่น «เกลาให้เหมาะกับบทความเทค» แต่ถ้าไม่ได้ระบุ สกิลจะวิเคราะห์และเลือกรูปแบบจากเนื้อหาให้เอง
สคริปต์ตรวจสองตัวกับชุดทดสอบ
สคริปต์ทั้งสองตัวเขียนด้วยไลบรารีมาตรฐานของ Python ล้วนๆ จึงไม่ต้องติดตั้งอะไรเพิ่ม
yomiyasu_lint.py: ทำหน้าที่นับค่าต่างๆ ที่เครื่องสามารถวัดได้ เช่น คำกริยาเปรียบเปรยที่ไม่เป็นธรรมชาติ ความถี่ของการใช้ตัวหนา สัดส่วนหัวข้อย่อย การใช้อีโมจิ การใส่เครื่องหมายโคลอนท้ายประโยค และการใช้รูปประโยคลงท้ายซ้ำๆ ติดกัน ตัวอย่างรายงานใน README แสดงว่ามีการใช้ตัวหนา 1.4 ครั้งต่อ 1,000 ตัวอักษร ซึ่งผ่านเกณฑ์แนะนำที่ไม่เกิน 2.0 (และจะแจ้งเตือนเมื่อเกิน 3.0) ถ้าใส่ตัวเลือก--strictสคริปต์จะให้ผลไม่ผ่านทันทีที่มีคำเตือน จึงนำไปผูกเข้ากับระบบตรวจสอบอัตโนมัติได้ง่ายyomiyasu_diff.py: เทียบร่างก่อนกับหลังแก้แบบประโยคต่อประโยค เพื่อดูว่ามีคำไหนเพิ่มขึ้นหรือหายไปบ้าง โดยเฉพาะคำที่บอกชนิดของประโยค เช่น คำบอกเล่า การคาดเดา การแสดงความเห็น การเปรียบเทียบ หรือคำขอร้อง/คำสั่ง หากคำบอกการคาดเดาหายไปหลังการเกลา สคริปต์ก็จะไฮไลต์ประโยคนั้นขึ้นมาเตือนทันที แต่ README ก็ยอมรับตรงๆ ว่า สคริปต์ diff ไม่ได้ตัดสินแทนเราว่าความหมายยังเหมือนเดิมหรือไม่ และอาจตรวจคลาดเคลื่อนได้ถ้าเขียนประโยคใหม่แทบทั้งหมดหรือสลับลำดับประโยค
ชุดทดสอบแบ่งออกเป็น 2 ส่วน คือ tests/corpus/ สำหรับเก็บข้อความจริงที่คนเขียนกับข้อความที่ AI เขียนไว้ใช้วัดผล และ tests/fixtures/ ที่เก็บกรณีทดสอบซ้ำไว้อีก 50 กรณี เพื่อป้องกันไม่ให้การแก้กฎรอบใหม่ไปทำให้การทำงานเดิมพัง
คะแนนสูงไม่ได้แปลว่าคนเขียนจริง
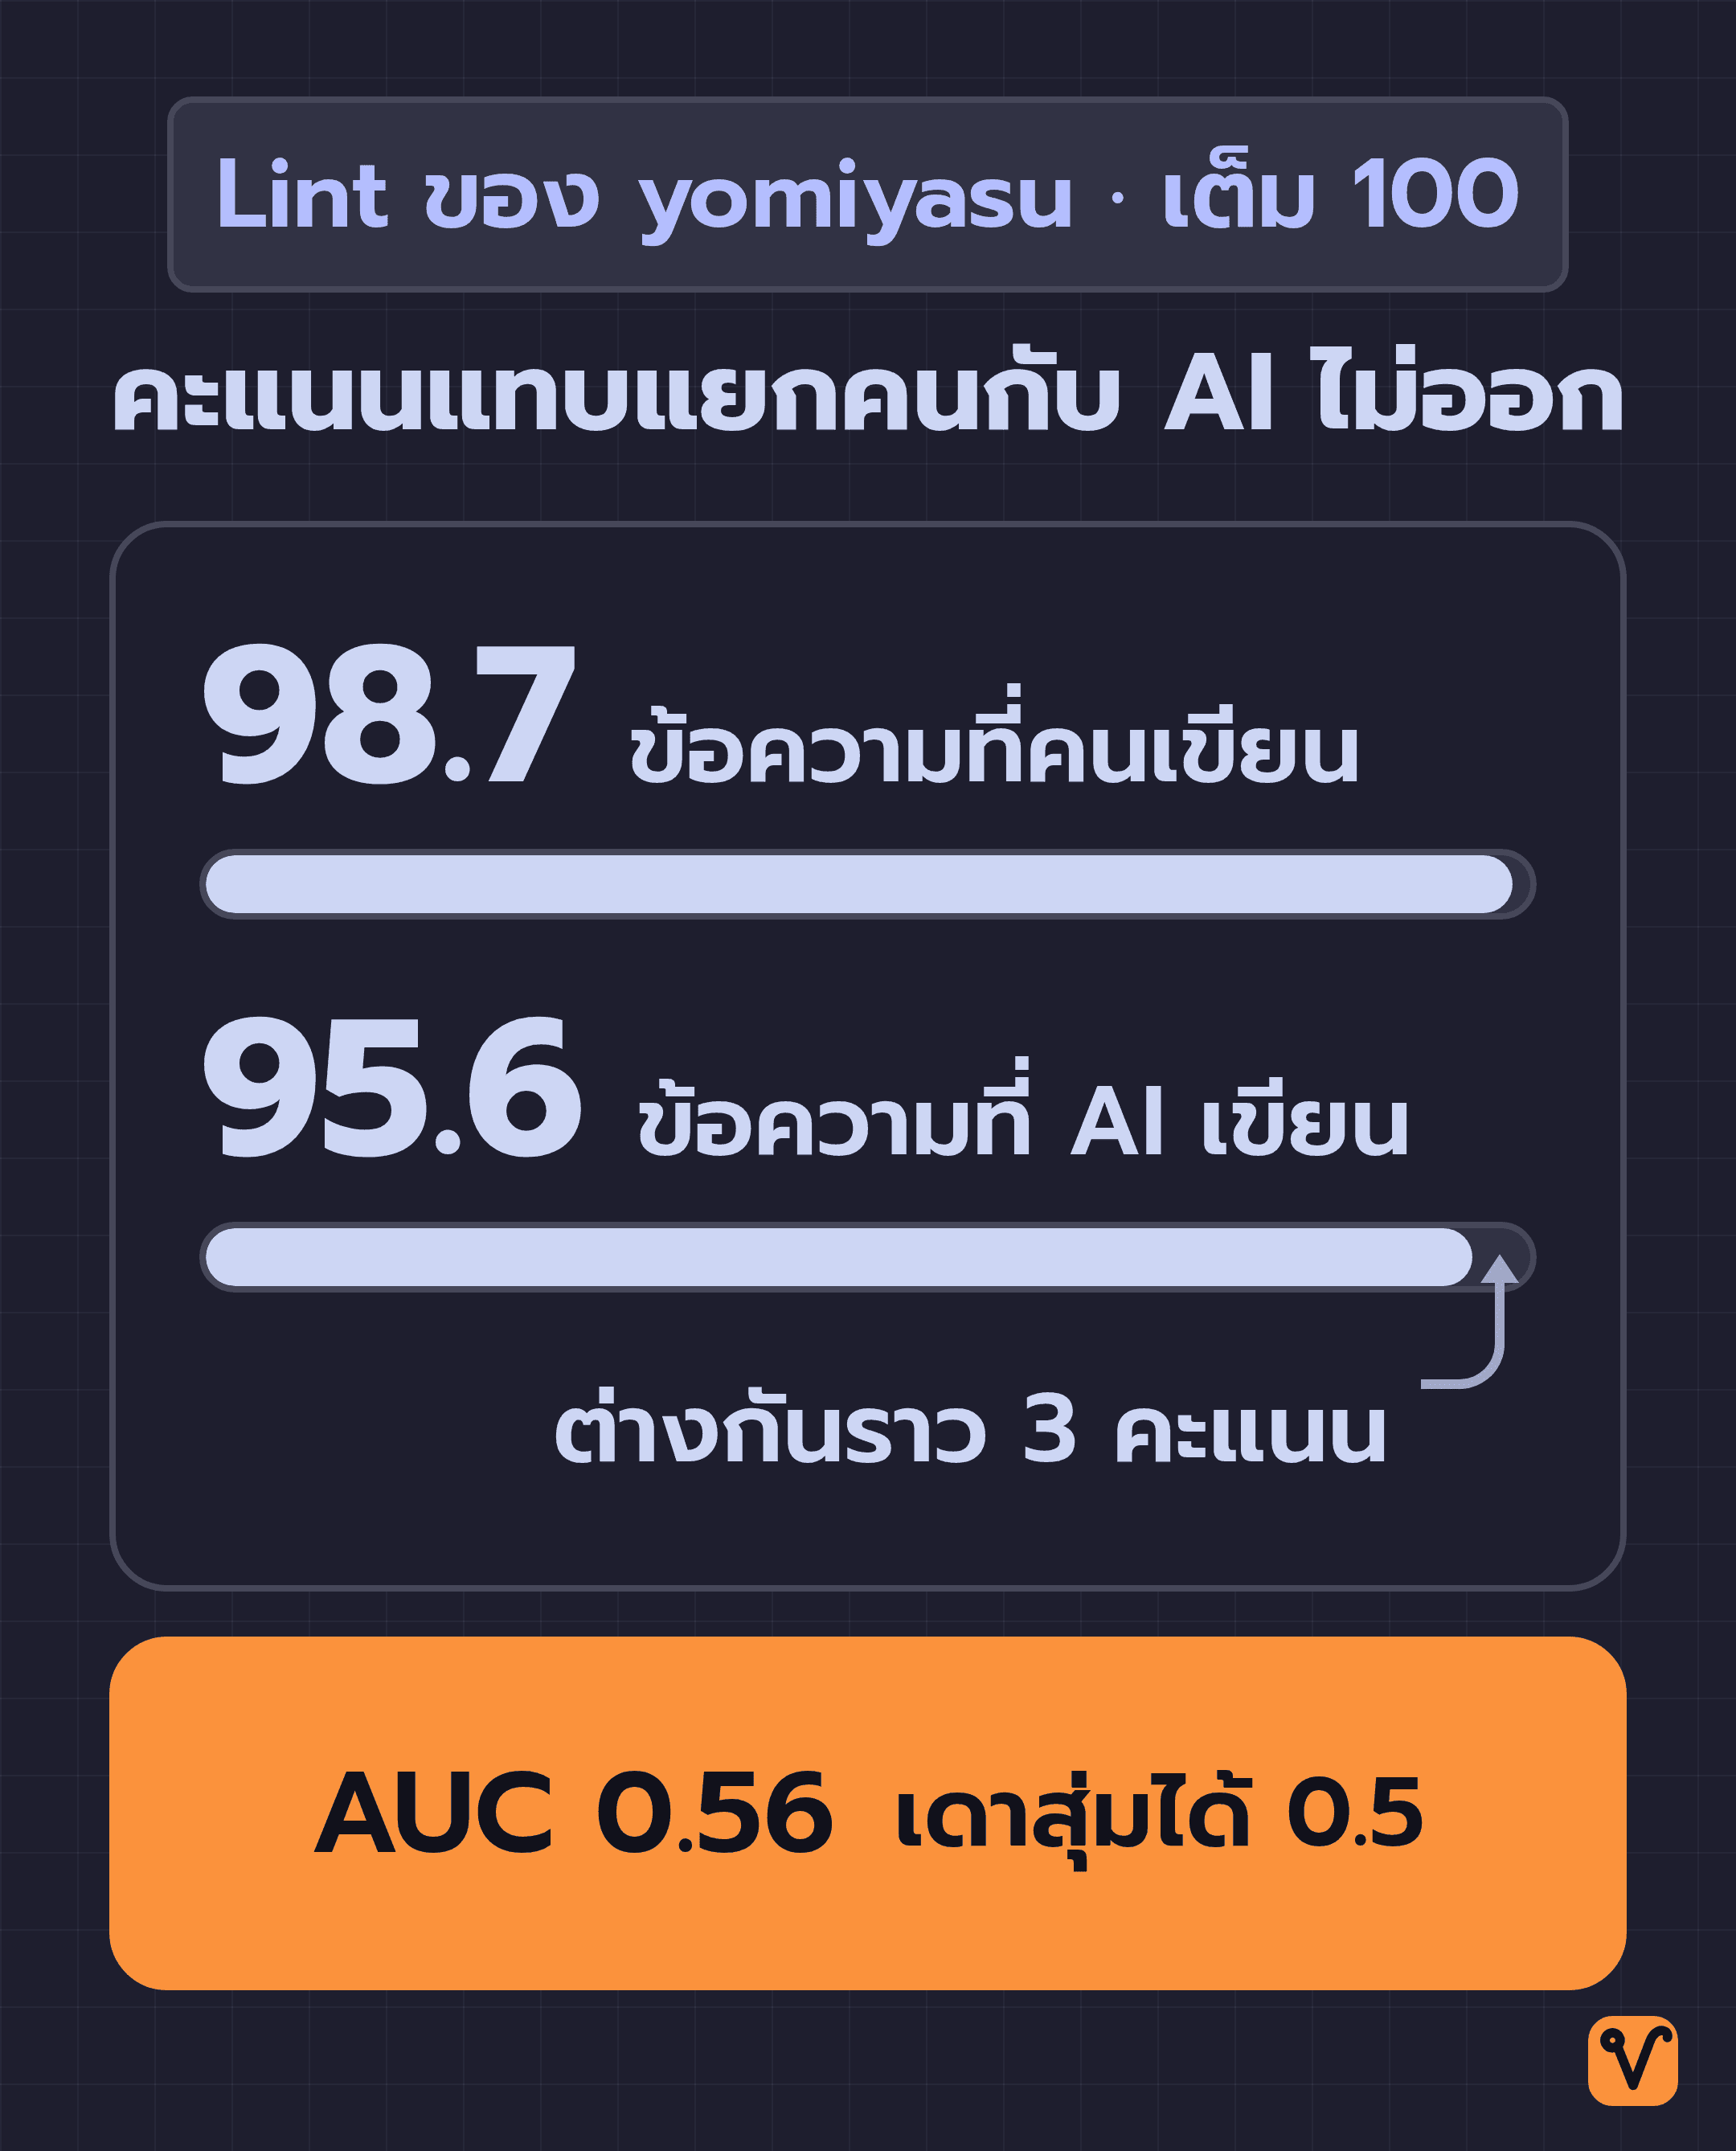
ผู้สร้างนำสคริปต์ Lint ไปวัดผลกับชุดข้อความจริงใน tests/corpus/ แล้วเปิดเผยผลไว้ใน README อย่างตรงไปตรงมา ส่วนรายละเอียดขั้นตอนการวัด ผู้สร้างอธิบายไว้ละเอียดใน บทความบน Zenn
สคริปต์ Lint ให้คะแนนเต็ม 100 คะแนน โดยข้อความที่คนเขียนจริง 16 ชิ้นได้คะแนนเฉลี่ย 98.7 ส่วนข้อความที่ AI เขียน 26 ชิ้นได้คะแนนเฉลี่ย 95.6 ต่างกันเพียงราวๆ 3 คะแนนเท่านั้น
AUC คือค่าสถิติที่บอกว่าคะแนนแยกสองกลุ่มนี้ออกจากกันได้ดีแค่ไหน (ถ้าได้ 0.5 แปลว่าไม่ต่างจากการเดาสุ่ม และถ้าได้ 1.0 คือแยกได้ขาดจากกันอย่างสมบูรณ์) ผลปรากฏว่า Lint ได้ค่า AUC เพียง 0.56
ลองนึกภาพว่าเราหยิบข้อความที่คนเขียนกับข้อความที่ AI เขียนมาวางคู่กัน แล้วให้ Lint ทายว่าชิ้นไหนคนเขียน โอกาสที่มันจะทายถูกแทบไม่ต่างจากการโยนเหรียญหัวก้อย ยิ่งถ้าตัดตัวอย่าง 2 ชิ้นที่จงใจยัดสำนวน AI แบบล้นๆ ออกไป แล้ววัดเฉพาะข้อความ 24 ชิ้นที่โมเดลเขียนขึ้นมาเองตามธรรมชาติ ค่า AUC จะยิ่งลดลงเหลือเพียง 0.53
README จึงสรุปไว้อย่างชัดเจนว่า คะแนนสูงไม่ใช่หลักฐานว่าคนเป็นคนเขียน พร้อมย้ำว่า Lint เป็นเพียงเครื่องมือช่วยหาจุดบกพร่องที่มักมองข้ามเวลาเกลาข้อความ ไม่ใช่โปรแกรมตรวจจับว่า AI เขียนหรือไม่ เพราะ "ความอ่านง่าย" กับ "การดูออกว่าใครเป็นคนเขียน" เป็นคนละเรื่องกัน และ yomiyasu สร้างขึ้นมาเพื่อตอบโจทย์เฉพาะเรื่องแรกเท่านั้น
ให้ AI อ่าน yomiyasu ก่อนเขียน ได้อะไรและเสียอะไร
นอกจากใช้เกลาร่างที่เขียนเสร็จแล้ว เรายังใช้ yomiyasu ได้อีกแบบ คือป้อนสกิลนี้ให้ AI อ่านเป็นแนวทางตั้งแต่ก่อนลงมือเขียน README สรุปผลการทดสอบไว้จาก บทความของ ai-garage ที่ให้ Claude Opus 5.5 เขียนเนื้อหาจากบันทึกสั้น 8 ชุด แล้วเทียบวิธีสั่งเขียน 4 รูปแบบ
ข้อดีเห็นได้ชัดเจน: ข้อความที่ให้ AI อ่าน yomiyasu ก่อนเขียน โดนท้วงว่าเติมเนื้อหาที่ไม่มีในบันทึกเดิมเพียงแค่ 2 ครั้ง ขณะที่การสั่งให้เขียนเฉยๆ โดยไม่กำหนดกฎเกณฑ์ พบการแต่งเรื่องเพิ่มสูงถึง 60 ครั้ง
ข้อเสียก็ชัดเจนพอกัน: ข้อความที่ได้ยาวเฉลี่ยเพียง 356 ตัวอักษร ทั้งที่สั่งไว้ประมาณ 500 ตัวอักษร คะแนนความอ่านง่ายก็ต่ำที่สุดใน 4 วิธี แถมยังใช้เวลาและค่าใช้จ่ายเพิ่มขึ้นราว 4 เท่า ยิ่งเป็นงานประเภทความเรียง ข้อความที่เขียนด้วยวิธีนี้ได้คะแนนรั้งท้ายครบทั้ง 8 ครั้ง
แต่ก่อนจะหยิบตัวเลขชุดนี้ไปอ้างอิง ต้องรู้ไว้ด้วยว่า AI เป็นผู้ให้คะแนน กลุ่มตัวอย่างในแต่ละประเภทยังมีน้อย และเป็นผลจากการทดสอบเพียงชุดเดียวเท่านั้น
บทความของ ai-garage สรุปว่า วิธีนี้เหมาะกับงานที่ตัวเลข วันที่ และเงื่อนไขต้องตรงตามความเป็นจริงอย่างเคร่งครัด เช่น อีเมลเสนอขาย รายงานสรุปปัญหาของระบบ หรือคู่มือขั้นตอนการทำงาน ส่วนงานอ่านเพลินๆ อย่างความเรียงหรือประกาศทั่วไป การสั่งให้เขียนตามปกติ หรือเพิ่มคำสั่งสั้นๆ ไปประโยคเดียว ให้ผลลัพธ์ที่น่าอ่านกว่า
จะใช้หรือไม่จึงขึ้นอยู่กับงานตรงหน้า ถ้าข้อมูลผิดแม้แต่จุดเดียวก็สร้างความเสียหายร้ายแรง เวลาและค่าใช้จ่ายที่เพิ่มขึ้นก็คุ้มค่า แต่ถ้างานนั้นต้องการลีลาการเล่าที่ชวนติดตาม สกิลแบบนี้อาจทำให้ภาษาแข็งทื่อจนเกินไป
ถอดโครง yomiyasu มาทำสกิลเกลาภาษาไทย
ถ้าต้องการนำแนวคิดนี้มาสร้างเป็นสกิลเกลาภาษาไทยไว้ใช้เอง เราแนะนำให้เดินตามโครงสร้างของ yomiyasu ทีละขั้นตอนดังนี้:
-
ตั้งกฎสูงสุดสองข้อไว้เป็นด่านแรกเสมอ: คือ 'การรักษาองค์ประกอบความหมายเดิมทั้งสี่ด้าน' และ 'ห้ามเติมข้อมูลใหม่เข้าไปเอง' โดยเขียนไว้บนสุดของไฟล์ SKILL.md และระบุชัดเจนว่ากฎข้ออื่นๆ ทั้งหมดจะใช้ได้ภายใต้กรอบนี้เท่านั้น เพราะถ้าเราตั้งแค่กฎเรื่องสำนวน AI อาจตีความคำสั่งเกินเลยจนแต่งสำนวนประดิดประดอยเว่อร์วังออกมาแทน อย่างที่ README เล่าไว้ในข้อจำกัดข้อที่สอง
-
ทำแคตตาล็อกภาษาไทยตาม 7 หมวดเดียวกัน: รวบรวมตัวอย่างจากข้อความจริงที่ AI เขียนให้คุณ ไม่ใช่นั่งเทียนเขียนรายการคำต้องห้ามขึ้นมาเอง ลองเริ่มจากเปิดดู ร่องรอยที่ฟ้องว่างานเขียนชิ้นไหน AI ช่วยเขียน แล้วคัดเฉพาะรูปแบบที่เจอบ่อยในร่างของคุณ โดยบันทึกตัวอย่างเป็นคู่ 'ก่อนแก้' กับ 'หลังแก้' พร้อมเงื่อนไขว่าเมื่อไหร่ควรเก็บคำเดิมไว้ เช่น 3 หมวดตัวอย่างนี้:
- คำเกริ่นและคำปิดสำเร็จรูป: เช่น «หวังว่าบทความนี้จะเป็นประโยชน์» ตัดทิ้งได้ทันทีโดยไม่กระทบใจความ
- โครงสร้างประโยคที่แปลตรงจากภาษาอังกฤษ: เช่น «ระบบนี้ถูกออกแบบมาเพื่อ...» หากต้นฉบับบอกว่าทีมไหนเป็นผู้ออกแบบ ให้เขียนว่า «ทีมออกแบบระบบนี้มาเพื่อ...» แต่ถ้าไม่ได้บอก ก็เขียนตรงๆ ว่า «ระบบนี้ออกแบบมาเพื่อ...» โดยไม่ต้องคาดเดาผู้กระทำขึ้นมาเอง
- คำที่ดูเป็นรูปธรรมแต่ความหมายกำกวม: เช่น «ยกระดับประสบการณ์ลูกค้า» ต้องย้อนกลับไปดูต้นฉบับว่าหมายถึงตอบแชตเร็วขึ้น หรือขั้นตอนสั่งซื้อสั้นลง หากต้นฉบับไม่ได้บอกไว้ ก็ให้คงคำเดิมไว้ก่อนแล้วค่อยถามผู้เขียนเพิ่มเติม
-
แยกคู่มือย่อยตามลักษณะงานที่คุณเขียนจริง: เช่น บทความเทคนิค เอกสารการทำงานทั่วไปกับอีเมล และโพสต์สำหรับโซเชียลมีเดีย เพราะแต่ละงานรับภาษาที่เป็นกันเองได้ไม่เท่ากัน โพสต์โซเชียลอาจใส่อีโมจิได้ แต่รายงานเสนอผู้บริหารไม่ควรมี
-
เขียนสคริปต์ Lint ตรวจเฉพาะสิ่งที่เครื่องวัดค่าได้: เช่น ความถี่ของตัวหนา สัดส่วนหัวข้อย่อย การใช้อีโมจิ และการลงท้ายประโยคด้วยรูปคำซ้ำๆ ติดกัน (เช่น จบด้วยคำว่า «ได้อย่างมีประสิทธิภาพ» สามประโยคติด) ที่สำคัญคือ เกณฑ์ตัวเลขต้องวัดและกำหนดขึ้นใหม่จากข้อความภาษาไทยจริง ห้ามลอกตัวเลขของภาษาญี่ปุ่นอย่าง 'ตัวหนาไม่เกิน 2.0 ครั้งต่อ 1,000 ตัวอักษร' มาใช้โดยตรง เพราะใน README ผู้สร้างก็ระบุชัดเจนว่า ตัวเลขเหล่านั้นเขาตั้งขึ้นมาเอง ไม่ใช่ค่าที่งานวิจัยซึ่งอ้างอิงไว้ยืนยันผล
-
ใช้การตรวจ Diff เพื่อกันไม่ให้สกิลเติมข้อเท็จจริงเอง: เปรียบเทียบข้อความก่อนและหลังเกลาว่า ตัวเลข ชื่อเฉพาะ และวันเวลายังอยู่ครบถ้วนเท่าเดิมไหม พร้อมตรวจดูว่าคำที่บอกเจตนาของประโยคในภาษาไทย เช่น «น่าจะ» «อาจจะ» «ตามรายงาน» «คิดว่า» หรือ «ควร» ยังอยู่ในประโยคเดิมหรือเปล่า
-
เก็บคลังข้อความคนและข้อความ AI ภาษาไทยไว้ทดสอบ: เพื่อใช้ดูว่าเมื่อเราปรับแก้กฎแล้ว สคริปต์ Lint เตือนข้อความที่คนเขียนจริงน้อยลงหรือมากขึ้น ถ้า Lint เตือนข้อความของคนเยอะ แปลว่าเราตั้งกฎตึงเกินไป และต้องยอมรับตั้งแต่แรกว่า คะแนนของ Lint ใช้จับผิด AI ไม่ได้ เหมือนที่ตัวเลขสถิติของ yomiyasu ได้พิสูจน์ไว้
-
กำหนดให้คำตอบรายงานจุดที่แก้ไขเสมอ และถามผู้เขียนเมื่อไม่แน่ใจ: สามารถยืมรูปแบบคำตอบ 4 ส่วนของ yomiyasu มาใช้ได้ทันที เพราะถ้าสกิลแก้ไปเงียบๆ ผู้เขียนจะไม่มีทางรู้เลยว่าความหมายตรงไหนคลาดเคลื่อนไปจากเดิม
จุดเริ่มต้นที่ง่ายที่สุดคือการ Fork หรือคัดลอกคลังโค้ดมาเป็นของตัวเอง แล้วนำมาปรับแก้ต่อ เพราะ yomiyasu ใช้สัญญาอนุญาตแบบ MIT License ซึ่งเปิดให้ทำแบบนี้ได้อย่างอิสระ README ยังระบุไว้ด้วยว่า ใครจะนำโปรเจกต์นี้ไปแนะนำหรือเล่าต่อในบทความ วิดีโอ หรือโซเชียลมีเดีย ก็ทำได้ทันทีโดยไม่ต้องขออนุญาตผู้สร้างก่อน
ถ้าใครอยากลองตัวต้นฉบับกับภาษาญี่ปุ่น หรืออยากเปิดดูโครงสร้างไฟล์จริงในเครื่อง ก็ติดตั้งลงเครื่องมืออย่าง Claude Code ได้ด้วยคำสั่งเดียว:
npx skills add nanaism/yomiyasuจากนั้นวางร่างข้อความภาษาญี่ปุ่นแล้วสั่งว่า この文章を読みやすくして。 ซึ่งแปลว่า «ช่วยเกลาข้อความนี้ให้อ่านง่ายขึ้นหน่อย»
ทั้งนี้ แหล่งดาวน์โหลดอย่างเป็นทางการมีเพียงคลังโค้ดบน GitHub นี้แห่งเดียวเท่านั้น และผู้สร้างไม่มีส่วนเกี่ยวข้องกับสื่อการสอนแบบเสียเงิน หรือเหรียญคริปโตใดๆ ที่นำชื่อ yomiyasu ไปแอบอ้าง
ไม่ว่าเราจะเขียนรายการคำต้องห้ามยาวเพิ่มอีกกี่หน้า AI ก็ยังหาคำกำกวมคำใหม่มาแทนที่ได้เสมอ สิ่งที่ช่วยแก้ปัญหานี้ได้จริง จึงไม่ใช่การไล่แบนคำ แต่คือกฎที่บังคับให้ทุกประโยคระบุอย่างชัดเจนว่า «ใครกำลังทำอะไร» และบอกเฉพาะข้อเท็จจริงเท่าที่ต้นฉบับมีอยู่เท่านั้น
ที่มา:
- โปรเจกต์ yomiyasu บน GitHub
- เอกสารทางการของ yomiyasu: SKILL.md
- เอกสารทางการของ yomiyasu: slop-catalog.md
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ