effort ใน Claude Code ไม่ได้ทำให้ Claude ฉลาดขึ้น แต่กำหนดว่าจะตรวจงานละเอียดแค่ไหน
คำสั่ง /effort ใน Claude Code ปรับได้ตั้งแต่ low ถึง max และแต่ละระดับใช้เวลาตรวจงานต่างกันมาก ดูผลทดลองจริงจากโจทย์เดียวกัน พร้อมวิธีเลือกให้เหมาะกับงาน
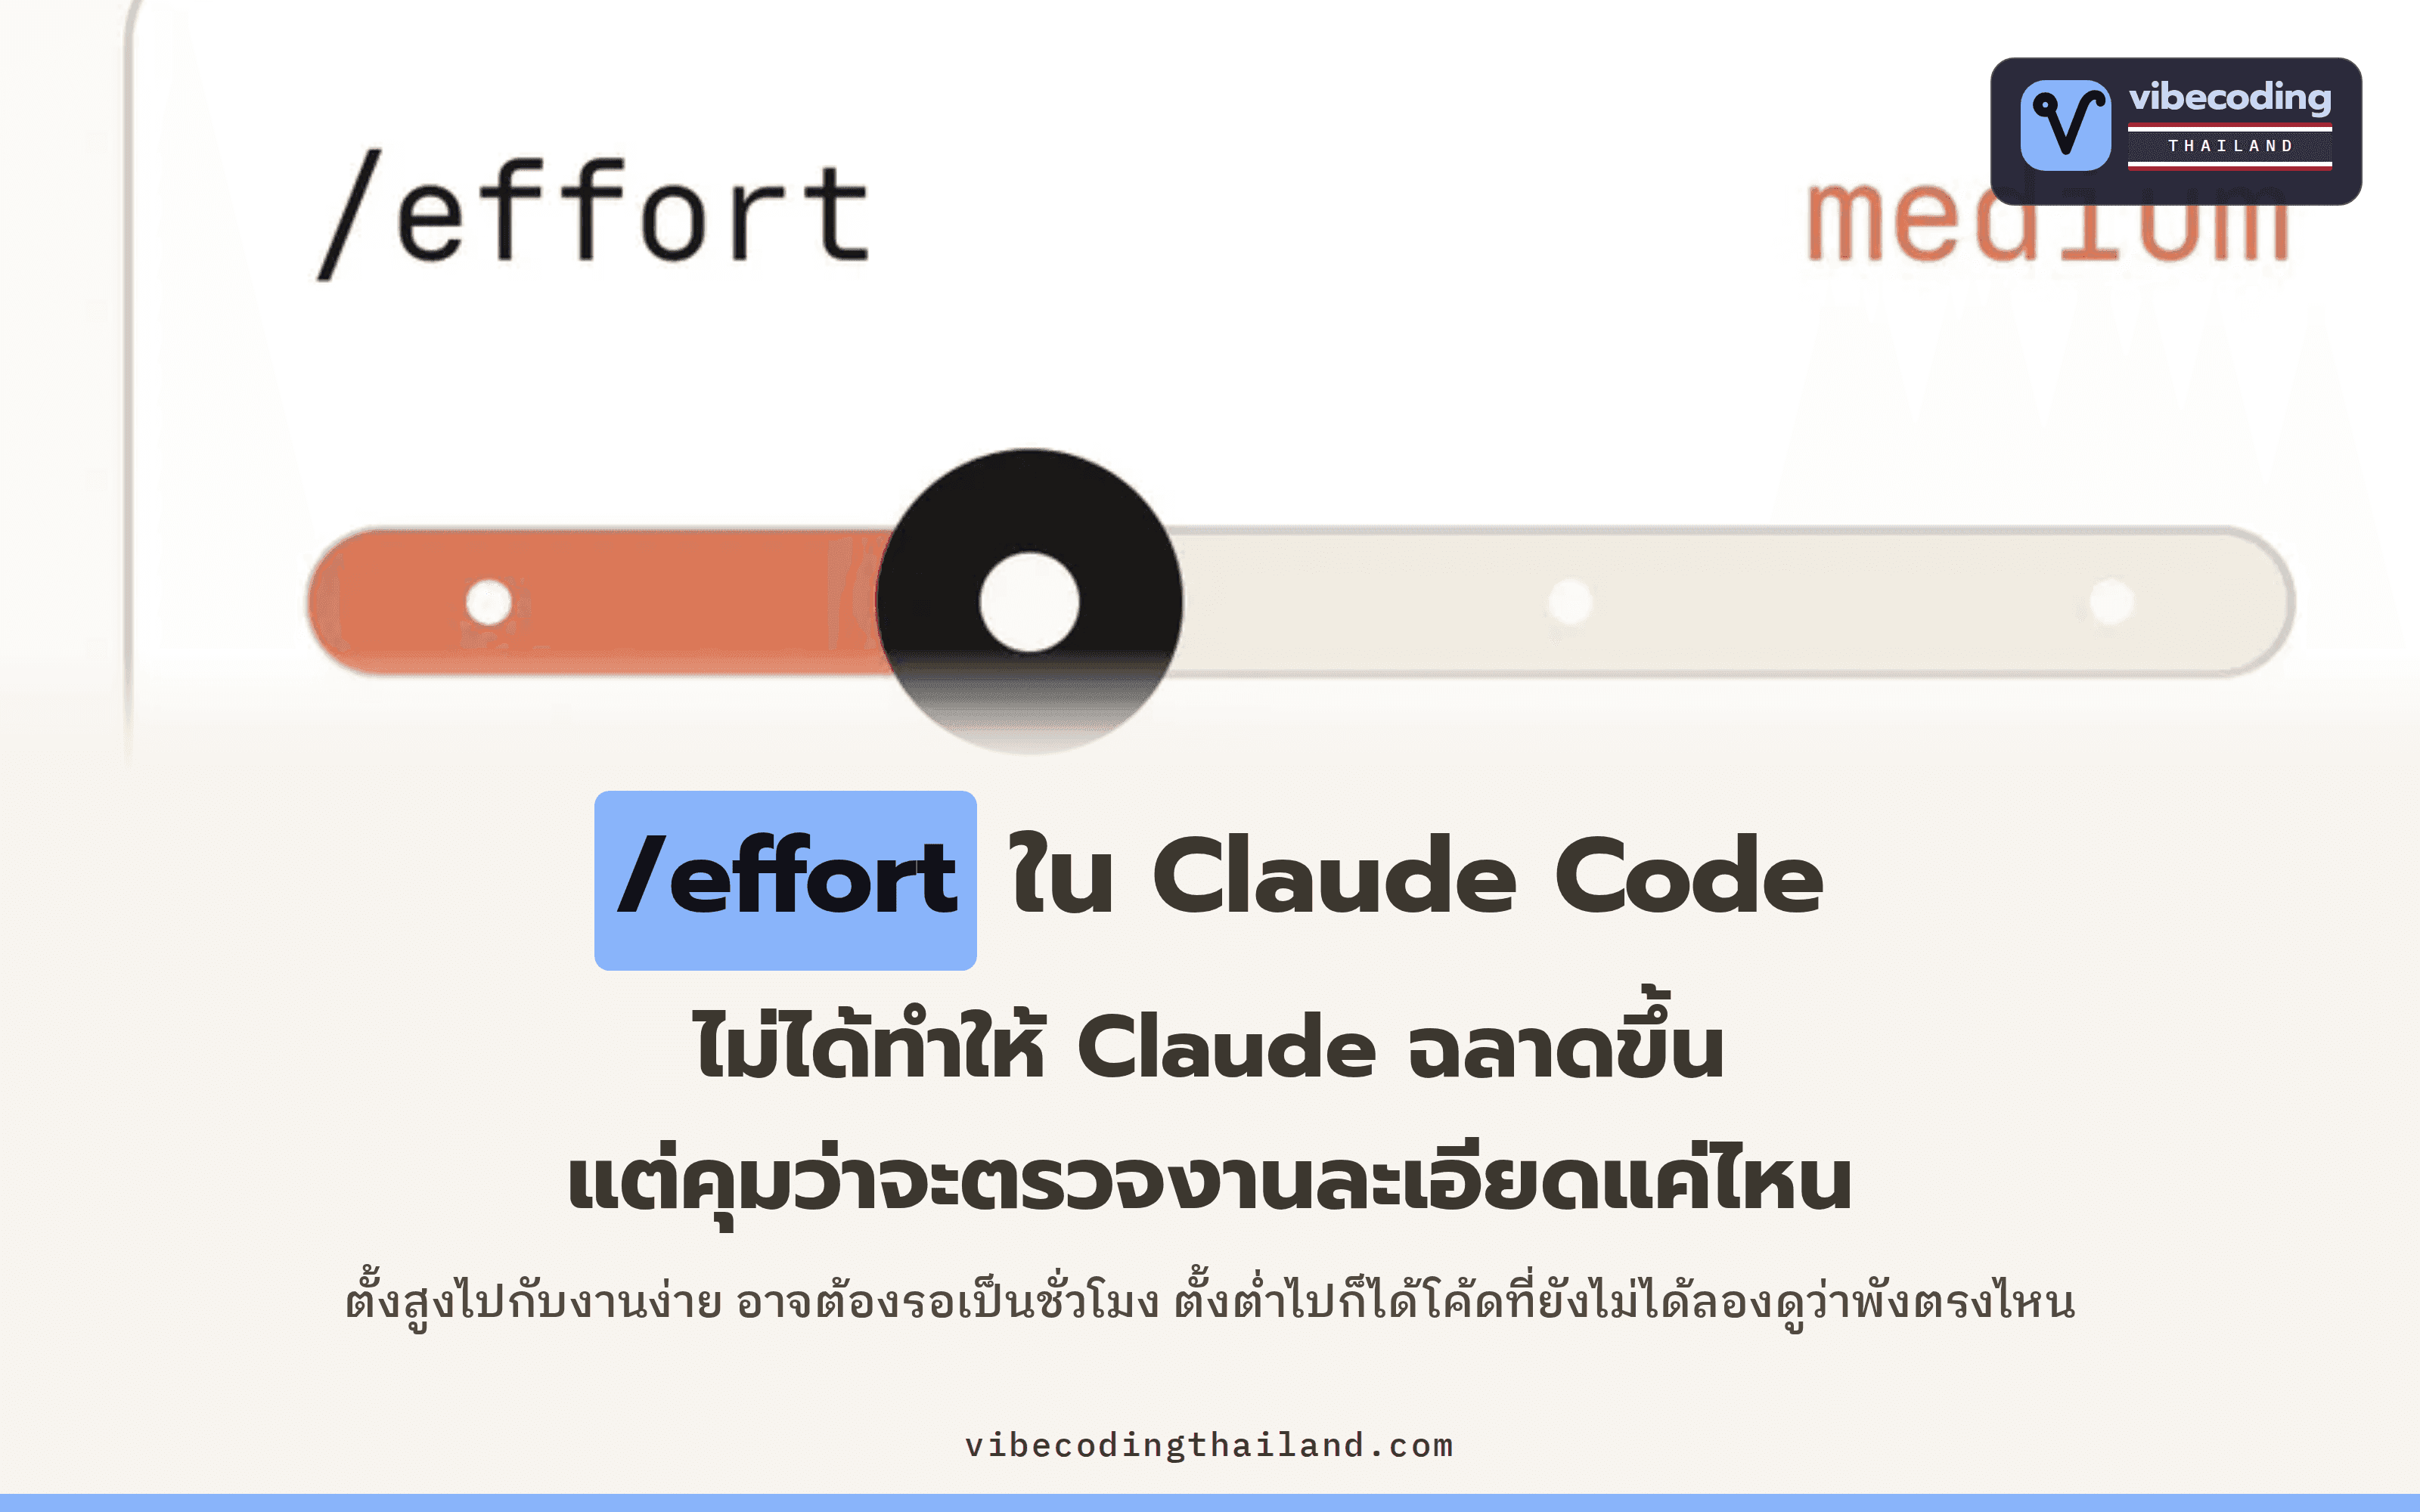
ในเครื่องมือ AI ช่วยเขียนโค้ดอย่าง Claude Code มีคำสั่ง /effort ให้เรากำหนดได้ว่าต้องการให้ Claude ทุ่มเทกับงานนั้นมากน้อยแค่ไหน ปรับได้ตั้งแต่ low medium high ไปจนถึง max
ชื่อ effort ชวนให้คิดว่า ยิ่งตั้งค่าไว้สูง Claude ก็น่าจะยิ่งฉลาดขึ้น แต่ความจริงแล้ว สิ่งที่เปลี่ยนไปไม่ใช่ระดับสติปัญญา แต่เป็น "ความละเอียดในการตรวจทานงาน" ค่านี้เป็นตัวกำหนดว่า Claude จะไล่หา edge case (กรณีพิเศษที่เกิดขึ้นไม่บ่อย แต่ถ้าเกิดแล้วระบบจะพัง) ได้ละเอียดแค่ไหน และจะตัดสินใจเรื่องต่างๆ แทนเรามากเท่าใด
ข้อสรุปนี้มาจากการทดลองของ Thariq (@trq212) ที่สั่งงานเดียวกันซ้ำในแต่ละระดับ effort และวิเคราะห์ผลการทดสอบกับโจทย์ยากๆ อีกหลายร้อยรอบ
การเลือกระดับ effort ให้ถูกต้องจึงสำคัญมาก เพราะถ้าเลือกผิดก็มีสิ่งที่ต้องแลก ถ้าตั้งไว้สูงเกินไปกับงานง่ายๆ เราอาจต้องรอนานเป็นชั่วโมงกับงานที่ระดับต่ำใช้เวลาเพียงไม่กี่นาที แต่ถ้าตั้งไว้ต่ำเกินไปกับงานที่มีจุดบกพร่องซ่อนอยู่ เราก็จะได้โค้ดที่ดูเหมือนเสร็จสมบูรณ์ แต่จริงๆ แล้ว Claude ยังไม่ได้ลองทดสอบเลยว่ามันจะพังตรงไหนบ้าง
effort เหมือนบอกว่ามีเวลาให้กี่ชั่วโมง
effort คือการบอก Claude คร่าวๆ ว่าเราต้องการให้ใช้แรงและเวลาประมวลผลกับงานนี้มากแค่ไหน ลองนึกภาพเหมือนมีคนเอางานชิ้นหนึ่งมาฝากให้คุณช่วยทำ
ถ้าเขาให้เวลาคุณเต็มที่ 12 ชั่วโมง คุณก็คงรู้ทันทีว่าเขาอยากได้งานที่ประณีตและเก็บรายละเอียดครบทุกจุด แต่ถ้าเขาให้เวลาแค่ 1 ชั่วโมง คุณก็ต้องรีบส่งเวอร์ชันที่ดีที่สุดเท่าที่ทำทัน แล้วค่อยมาปรับแก้ร่วมกันทีหลัง หรือในบางครั้ง คุณอาจจะบอกเขาว่างานนี้ต้องขอเวลาอย่างน้อย 3 ชั่วโมง แล้วใช้เวลานั้นทำให้เสร็จเรียบร้อย
Claude ก็มองค่า effort แบบเดียวกัน ไม่ว่าจะตั้งไว้ระดับไหน Claude ก็พยายามทำงานออกมาให้ดีที่สุดเท่าที่ทำได้เสมอ สิ่งที่ต่างกันคือ ยิ่งตั้งระดับไว้สูง Claude ก็ยิ่งตัดสินใจเองมากขึ้นและตรวจงานละเอียดขึ้น ระดับ low จึงเปรียบเหมือนงานที่ได้เวลาทำเพียงชั่วโมงเดียว ส่วน max ก็เหมือนงานที่ได้เวลาทำเต็มที่ 12 ชั่วโมง
สั่งทำแอปเดียวกันด้วย effort สี่ระดับ
วิธีที่จะเห็นผลชัดเจนที่สุด คือการสั่งงานเดิมซ้ำในทุกระดับ แล้วนำผลลัพธ์มาวางเทียบกัน การทดลองชุดนี้ใช้โมเดล Opus 5.5 กับโจทย์สั้นๆ เพียงประโยคเดียวว่า "สร้างแอปบันทึกการออกกำลังกายส่วนตัว" โดยไม่ได้บอกรายละเอียดอื่นเพิ่มเติมเลย
ผลลัพธ์ที่ได้คือ ระดับ low ใช้เวลา 1.5 นาที ได้แอปที่มีเพียงช่องบันทึกข้อมูลกับกราฟแบบเรียบง่าย ขณะที่ระดับ medium ใช้เวลา 4 นาที และระดับ high ใช้เวลา 11 นาที โดยตัวแอปมีรายละเอียดและฟังก์ชันเพิ่มขึ้นในแต่ละขั้น ส่วนระดับ max ใช้เวลาไปถึง 67 นาที และมีตารางไล่เฉดสีแสดงความถี่อย่าง heat chart เพิ่มเข้ามาด้วย
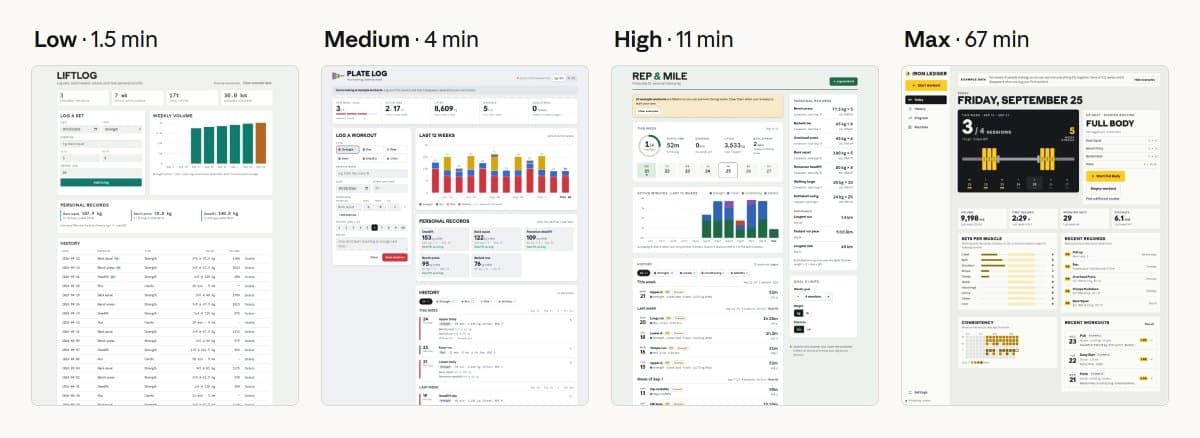
สิ่งที่เปลี่ยนไปตามระดับ effort ในโจทย์นี้ไม่ได้มีแค่ความละเอียดของหน้าตาแอปเท่านั้น แต่ยิ่งตั้งไว้สูง Claude ก็ยิ่งตัดสินใจเรื่องต่างๆ แทนเรามากขึ้นระหว่างทาง ถ้าเราแค่อยากได้โครงสร้างง่ายๆ มาพัฒนาต่อเอง เลือกระดับ low ก็เพียงพอแล้ว แต่ถ้าอยากได้ผลงานที่ Claude ทำให้จนเสร็จสมบูรณ์ในรอบเดียว ค่อยเลือกใช้ max
โจทย์ที่สองเป็นการทดลองกับงานที่มีทิศทางชัดเจนอยู่แล้ว โดยให้ Claude ออกแบบหน้าตั้งค่า /config ใหม่ของ Claude Code ผลปรากฏว่าทุกระดับคิดไอเดียออกมาตรงกัน คือแบ่งเมนูเป็นหมวดย่อยและเพิ่มช่องค้นหาให้ใช้งานสะดวกขึ้น
สิ่งที่ต่างกันคือความเนี้ยบของชิ้นงาน ระดับ low ใช้เวลาราว 1 นาที ได้ภาพร่างที่กดทดลองเล่นได้และสื่อสารไอเดียได้ครบถ้วน แม้หน้าตายังไม่เหมือน Claude Code จริงๆ นัก ส่วนระดับ max ใช้เวลาราว 28 นาที ได้หน้าจอจำลองที่เหมือน Claude Code ตัวจริงมาก พร้อมแผนภาพแสดงขั้นตอนการใช้งานอีกหลายรูปแบบ ในงานนี้ผู้ทดลองเลือกใช้ low เพราะต้องการแค่ดูภาพร่างคร่าวๆ ก่อนว่า Claude คิดไว้อย่างไร
โจทย์ที่สามเป็นการให้สเปกแบบละเอียดครบถ้วน เริ่มจากการให้ Claude สัมภาษณ์ผู้ทดลองเกี่ยวกับแอปออกกำลังกายอย่างเจาะลึก แล้วนำข้อกำหนดที่ได้ไปสั่งให้ Claude ทำในแต่ละระดับ effort คราวนี้ผลงานออกมาใกล้เคียงกันมาก ทั้งหน้าตาแอปและโครงสร้างโค้ด ต่างกันเพียงรายละเอียดปลีกย่อยเล็กๆ น้อยๆ เท่านั้น แม้ว่าเวลาที่ใช้จะยังต่างกันอยู่มาก คือตั้งแต่ 16 นาทีในระดับ low ไปจนถึง 79 นาทีในระดับ max (โดยในระดับ max นั้น Claude ใช้เวลาช่วงหนึ่งไปกับการปรับบางจุดให้เรียบง่ายขึ้น)
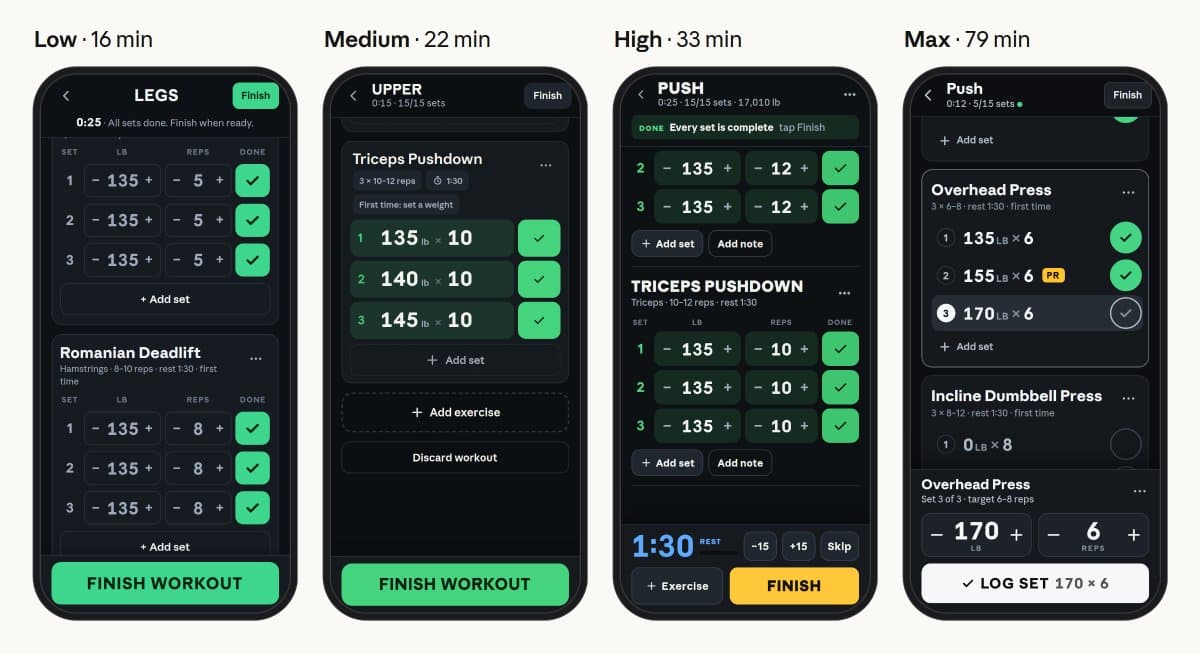
โจทย์ทั้งสามข้อนี้ชี้ให้เห็นตรงกันว่า effort จะส่งผลต่อหน้าตาของงานมากที่สุดในจุดที่เราไม่ได้ระบุไว้ ยิ่งโจทย์เปิดกว้างเท่าไร Claude ในระดับ effort สูงก็ยิ่งต้องคาดเดาและตัดสินใจแทนเรามากขึ้นเท่านั้น แต่เมื่อเราใส่สเปกไว้อย่างละเอียด ผลงานของแต่ละระดับก็ยิ่งใกล้เคียงกัน
เรื่องนี้จึงขึ้นอยู่กับการตัดสินใจของเราเองว่า ต้องการควบคุมงานทีละขั้นตอนมากน้อยแค่ไหน ระดับ low ให้ผลลัพธ์รวดเร็วและได้จุดเริ่มต้นให้เราคุมทิศทางต่อ แต่แลกกับการที่เราต้องคอยสั่งแก้หลายรอบ ส่วน effort ระดับสูงจะจัดการงานให้ได้มากกว่าในรอบเดียว แต่ก็แลกกับการที่ Claude คิดและตัดสินใจหลายอย่างแทนเราไปแล้ว
โจทย์ยากที่ effort ชี้ขาดว่าผ่านหรือตก
การสร้างแอปออกกำลังกายเป็นงานที่ Claude จัดการได้ในทุกระดับ effort อยู่แล้ว แต่ถ้าเป็นงานที่ยากและซับซ้อนมากๆ จน effort กลายเป็นตัวตัดสินว่าจะสำเร็จหรือไม่ล่ะ?
โจทย์ระดับนั้นรวมอยู่ใน Terminal-Bench 3.0 ซึ่งเป็นชุดทดสอบวัดฝีมือ AI ที่เปิดให้คนทั่วไปส่งโจทย์เข้าร่วมได้ โดยแบ่งโจทย์ออกเป็นหมวดความปลอดภัย ฮาร์ดแวร์ ML วิทยาศาสตร์ ซอฟต์แวร์ งานปฏิบัติการ และสื่อ ตัวอย่างเช่น การสร้างเครื่องเล่นเกม 8 บิตให้ลงชิป FPGA ขนาดเล็กได้ หรือการยื่นรายงานสถิติการค้ากับสหภาพยุโรป (EU) ประจำสิ้นเดือนของบริษัทให้ครบทุกขั้นตอน ซึ่งตัวผู้ทดลองเองก็ระบุว่าโจทย์เหล่านี้ซับซ้อนกว่างานทั่วไปที่เขาพบเจอมาก
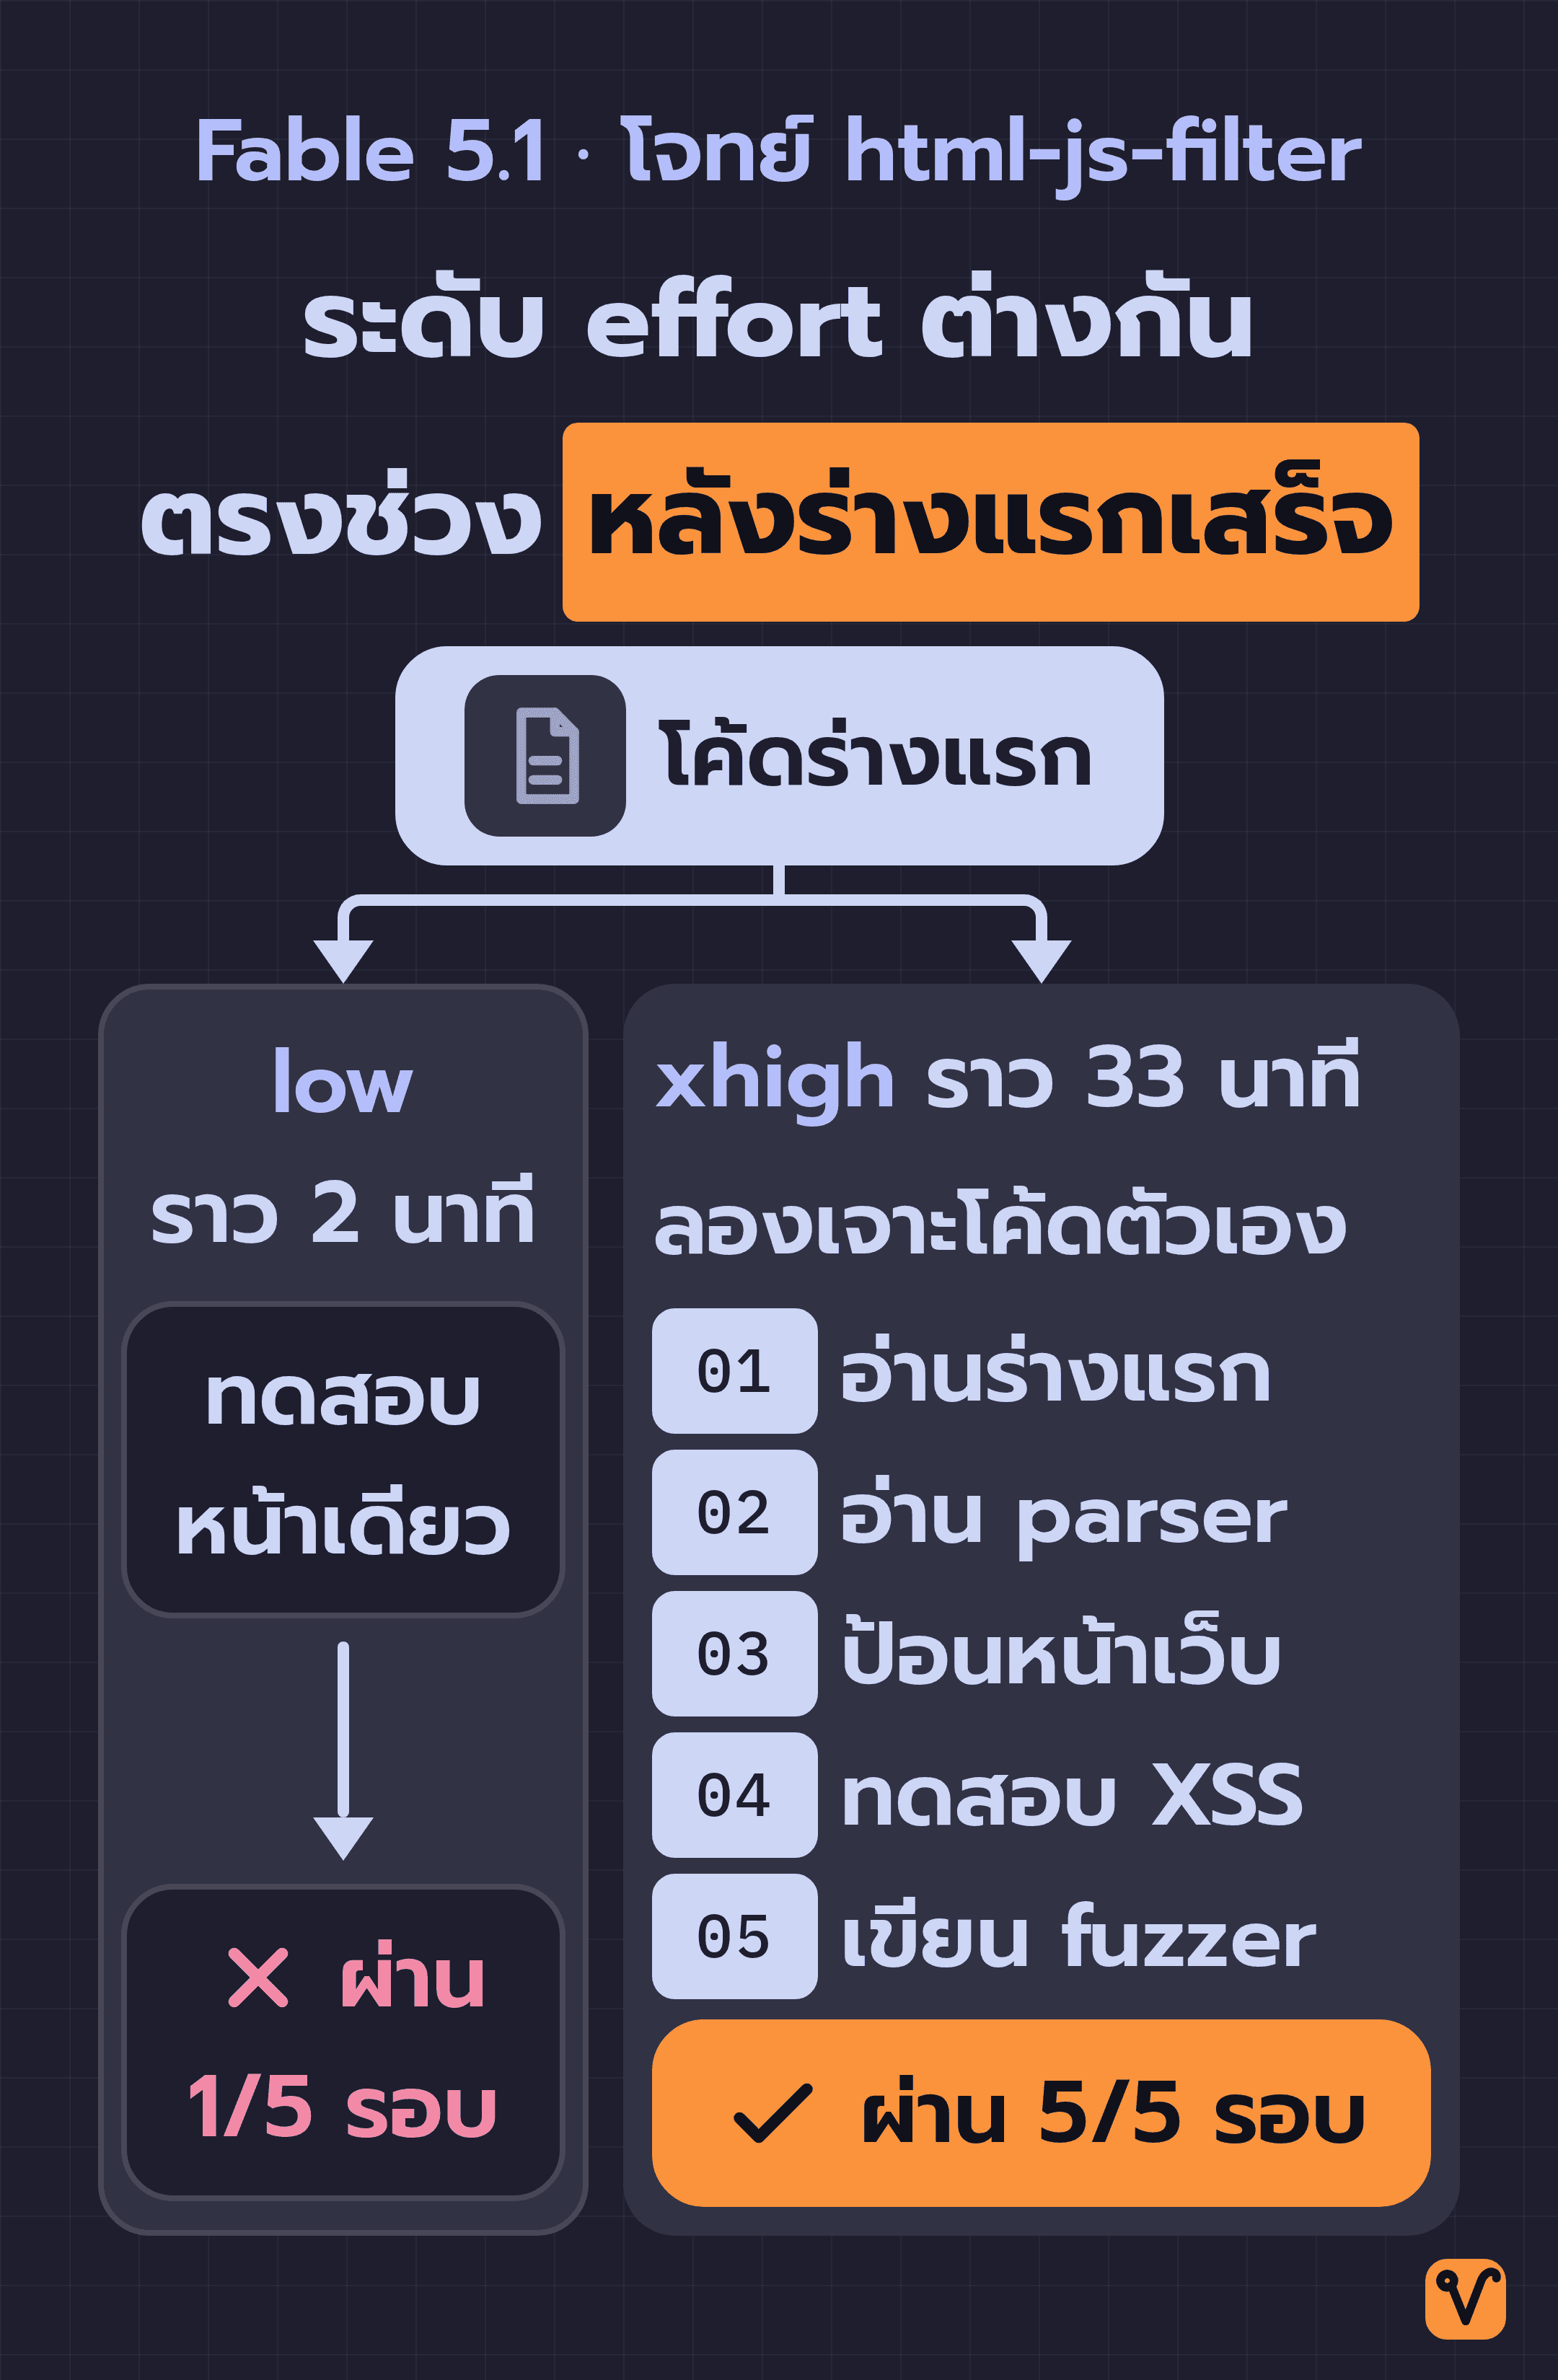
ตัวอย่างที่เห็นภาพชัดที่สุดคือโจทย์ html-js-filter ซึ่งให้เขียนตัวกรองที่คัดโค้ดอันตรายออกจากหน้าเว็บ แบบที่เรียกว่า HTML sanitizer โดยโจทย์กำหนดว่าต้องปิดทุกช่องทางที่อาจถูกแอบฝัง JavaScript เข้ามา และคำว่า "ทุกช่องทาง" นี่เองที่ทำให้โจทย์นี้เต็มไปด้วย edge case
ที่ระดับ low โมเดล Fable 5.1 (อีกโมเดลหนึ่งที่ใช้ใน Claude Code ได้) ทำผ่านเพียง 1 จาก 5 รอบเท่านั้น แต่ละรอบใช้เวลาราว 2 นาที โดยเขียนตัวกรองรวดเดียวจบ แล้วทดสอบกับหน้าเว็บที่เขียนขึ้นเองเพียงหน้าเดียว
แต่พอปรับเป็นระดับ xhigh ซึ่งอยู่ระหว่าง high กับ max และนำมาใช้ทดสอบด้วย โมเดล Fable 5.1 ทำผ่านครบทั้ง 5 รอบ โดยรอบที่ใช้ระดับ xhigh นี้ใช้เวลาราว 33 นาที และเมื่อผู้ทดลองเข้าไปเปิดดูขั้นตอนการทำงานทีละขั้น ก็พบว่าโมเดลทำสิ่งเหล่านี้ด้วยตัวเองทั้งหมด:
- อ่านทบทวนโค้ดร่างแรกของตัวเองเพื่อหาทางเจาะ เหมือนคนที่กำลังพยายามโจมตีระบบ
- เปิดอ่านซอร์สโค้ดของตัวแยกโครงสร้าง HTML อย่าง parser ที่ติดตั้งไว้ เพื่อไล่ค้นหาบั๊ก
- ป้อนหน้าเว็บปกติจำนวนมากเข้าไปทดสอบ เพื่อให้แน่ใจว่าผลลัพธ์ตรงกับต้นฉบับและไม่เผลอตัดโค้ดดีทิ้ง
- รันชุดทดสอบมาตรฐานสำหรับ XSS ซึ่งเป็นการโจมตีด้วยการฝังสคริปต์ลงในหน้าเว็บ
- เขียน fuzzer ขึ้นมาทดสอบเอง คือโปรแกรมที่สุ่มสร้างเอกสารหน้าตาแปลกๆ มายิงใส่ระบบ
ทั้งสองระดับเริ่มจากโค้ดร่างแรกเหมือนกัน ที่ต่างกันคือสิ่งที่ทำหลังร่างแรกเสร็จ ระดับ low หยุดอยู่แค่การทดสอบกับหน้าเว็บหน้าเดียว ส่วนระดับสูงจะทุ่มเวลาไปกับการหาทางทำให้โค้ดของตัวเองพัง
โจทย์อื่นๆ ที่ Opus 5.5 สอบตกทั้ง 5 รอบในระดับ low แต่กลับผ่านเมื่อใช้ effort สูง ก็มีรูปแบบการทำงานเช่นเดียวกัน:
แก้บั๊กจากรายงานโปรแกรมพัง โจทย์ mvcc-lsm-compaction ให้แก้บั๊กในระบบจัดเก็บข้อมูลตามรายงานโปรแกรมพัง โดยต้องไม่ทำให้ส่วน compaction พังเสียหาย ส่วนนี้ทำหน้าที่รวบและบีบอัดไฟล์ข้อมูลให้กระชับ
ในระดับ low Claude ใช้เวลารอบละประมาณ 1 นาที รีบแก้โค้ดทันทีก่อนที่จะ build หรือรันสคริปต์เพื่อทำให้เกิดอาการพังซ้ำ และไม่ได้ตรวจสอบว่าชุดทดสอบใหม่ดักจับบั๊กเดิมได้จริงหรือไม่ ส่วนในระดับ xhigh ซึ่งใช้เวลารอบละประมาณ 11 นาที Claude จะจำลองอาการพังให้เกิดขึ้นซ้ำก่อน จากนั้นเขียนชุดทดสอบแบบสุ่มเพื่อเทียบกับระบบอ้างอิงที่ไม่บีบอัดไฟล์ แล้วตรวจสอบซ้ำว่าชุดทดสอบต้องไม่ผ่านจริงๆ หากแก้บั๊กไปเพียงครึ่งทาง ผลลัพธ์จึงเปลี่ยนจากผ่าน 0 รอบ เป็นผ่าน 4 จาก 5 รอบ
โปรแกรมแก้โจทย์ linear program โจทย์ cli-2ph-simple ให้เขียนโปรแกรมภาษา Python ทำงานผ่านบรรทัดคำสั่ง เพื่อแก้โจทย์หาค่าที่เหมาะสมที่สุดภายใต้เงื่อนไขหลายข้ออย่าง linear program
ในระดับ low Claude เขียนโค้ดรวดเดียวจบ ทดสอบกับโจทย์ขนาดเล็กเพียงไม่กี่ข้อ แล้วหยุดทำงานเมื่อใช้ไปราว 10k token (token คือหน่วยนับข้อความที่ AI อ่านและเขียน) ข้อความสุดท้ายยังเตือนไว้เองว่าโปรแกรมอาจทำงานช้ากับโจทย์ใหญ่ แต่ก็ไม่ได้ลองทดสอบจริง ส่วนในระดับ high Claude สุ่มสร้างโจทย์ขึ้นมาทดสอบ เทียบคำตอบกับโปรแกรมอีกตัวที่ใช้วิธีไล่ลองทุกทาง และจับเวลากับโจทย์ที่ใหญ่ขึ้น พอเจอกรณีที่รันนานเกินไปหรือทำงานผิดพลาด ก็กลับไปปรับวิธีค้นหาคำตอบใหม่ ผลลัพธ์จึงเพิ่มจาก 0 เป็นผ่านครบ 5 จาก 5 รอบ
วิเคราะห์ข้อมูลโปรตีน โจทย์ gsea-proteomics ให้วิเคราะห์ข้อมูลโปรตีนด้วยวิธี GSEA เพื่อหาว่าวิธีการรักษาแบบใดใน 8 แบบที่ให้ผลลัพธ์ใกล้เคียงกับเนื้อเยื่อเป้าหมายมากที่สุด
ในระดับ low Claude เลือกวิธีเตรียมข้อมูลที่ดูสมเหตุสมผลมาหนึ่งวิธี แล้ววิเคราะห์ตามนั้นจนเสร็จพร้อมรายงานผล แต่ในระดับ high Claude ลองเตรียมข้อมูล 2 วิธี พอสังเกตเห็นว่ารายชื่อการรักษาที่ให้ผลเด่นเปลี่ยนไปตามวิธีเตรียมข้อมูล ก็เจาะหาสาเหตุก่อนตัดสินใจเลือกวิธีที่ถูกต้อง ผลลัพธ์จึงขยับจาก 0 เป็นผ่าน 4 จาก 5 รอบ
ในโจทย์สุดท้ายนี้ ถ้าเรานั่งทำงานอยู่ด้วยกัน Claude อาจเอ่ยปากถามเราตั้งแต่แรกแล้วว่าจะให้เตรียมข้อมูลแบบไหน แต่เมื่อไม่มีใครให้ถาม effort ระดับสูงคือสิ่งที่ทำให้ Claude ตรวจสอบและค้นหาคำตอบด้วยตัวเองจนเจอ
ขั้นตอนที่ระดับ low มองข้ามไปแทบทุกโจทย์ข้างต้น คือ "การพิสูจน์ว่างานใช้งานได้จริงก่อนจะสรุปว่าเสร็จ" ได้แก่ การจำลองบั๊กให้เกิดขึ้นจริงก่อนลงมือแก้, การเทียบผลลัพธ์กับระบบอ้างอิง และการตรวจสอบว่าชุดทดสอบจับข้อผิดพลาดได้จริง ขั้นตอนเหล่านี้ต้องใช้เวลา แต่กับโจทย์ชุดนี้ นี่คือเหตุผลหลักที่เปลี่ยนผลงานจากสอบตกเป็นสอบผ่าน ดังนั้น ครั้งต่อไปที่คุณอ่านข้อความสรุปงานจาก Claude ลองมองหาว่ามี 3 ขั้นตอนนี้อยู่หรือไม่
ไล่ edge case ได้ แต่แก้การเลือกทางผิดไม่ได้

ผลรวมทั้งชุดก็ยืนยันไปในทางเดียวกัน เมื่อเทียบ Fable 5.1 ระดับ low กับ max ฝั่งละ 370 รอบ จำนวนรอบที่ผ่านเพิ่มขึ้นจาก 140 เป็น 214 รอบ
รอบที่ไม่ผ่านเพราะมองข้ามบางกรณี ลดลงจาก 59 เหลือ 24 รอบ โดยกลุ่มที่ลดลงมากที่สุดคือบั๊กที่ชุดทดสอบของตัวเองตรวจไม่เจอ ซึ่งลดลงจาก 40 เหลือเพียง 14 รอบ
แต่รอบที่ไม่ผ่านเพราะตัดสินใจผิดทาง กลับลดลงเพียงเล็กน้อย จาก 133 เหลือ 107 รอบเท่านั้น ในกลุ่มนี้มีข้อผิดพลาด 2 รูปแบบที่ฟังดูคล้ายกันแต่ให้ผลต่างกัน แบบแรกคือการอ่านข้อกำหนดตกหล่น ซึ่งลดลงจาก 45 เหลือ 26 รอบ ส่วนแบบที่สองคือการเลือกความหมายผิดในโจทย์ที่ตีความได้หลายทาง กลับเพิ่มขึ้นจาก 25 เป็น 47 รอบ
effort ระดับสูงจึงช่วยดักจับข้อผิดพลาดระหว่างทางได้ดี แต่ไม่ได้ช่วยแก้ปัญหาเมื่อ Claude เลือกแนวทางผิดมาตั้งแต่ต้น ถ้าเป็นงานที่เสี่ยงจะตีความผิดพลาด วิธีแก้ที่ตรงจุดกว่าคือการระบุโจทย์และเงื่อนไขให้ชัดเจนก่อนเริ่มต้น ไม่ใช่การเร่งระดับ effort ให้สูงขึ้น
งานแต่ละหมวดหมู่ก็ได้ประโยชน์จาก effort ไม่เท่ากัน เมื่อดูอัตราการทำงานผ่านของ Fable 5.1 จากระดับ low ไปจนถึงระดับสูงสุดแยกตามหมวด พบว่าหมวดฮาร์ดแวร์ขยับมากที่สุด จาก 34% เป็น 75% หมวดความปลอดภัยทำคะแนนขึ้นไปได้สูงสุด จาก 64% เป็น 87% ขณะที่หมวดซอฟต์แวร์ขยับขึ้นจาก 43% เป็น 56%
ส่วนหมวดงานปฏิบัติการกลับให้ผลลัพธ์ตรงกันข้าม งานในหมวดนี้เป็นงานประเภทปฏิบัติตามกฎระเบียบ เช่น การยื่นรายงานสถิติการค้า หมวดนี้ผ่านเพียง 12% ในระดับ low และแม้จะดัน effort ไปสูงสุด ก็ขึ้นมาได้เพียง 22% เท่านั้น ตัวชี้วัดว่า effort คุ้มค่าหรือไม่จึงไม่ได้อยู่ที่ความยากของงานเพียงอย่างเดียว แต่งานที่ใช้ effort แล้วคุ้มอย่างชัดเจน คืองานที่การตรวจสอบและไล่ทดสอบกรณีต่างๆ มีประโยชน์อย่างยิ่ง เช่น งานฮาร์ดแวร์ การตรวจทานโค้ด และงานด้านความปลอดภัย
ดูกราฟแบบ interactive ของผลการทดสอบชุดนี้ได้ที่หน้า Using Claude Code: Spending your effort
ตั้ง max จ่าย token ราวสามเท่า
ความละเอียดรอบคอบทั้งหมดนี้ย่อมมีสิ่งที่ต้องแลก โดยในระดับ low โมเดล Fable 5.1 มีค่ามัธยฐานการใช้ token อยู่ที่ประมาณ 73k ต่อรอบ ส่วนที่ระดับ max ใช้สูงถึงประมาณ 222k ต่อรอบ หรือราว 3 เท่า
อีกทางเลือกหนึ่งที่ช่วยประหยัด token ได้มากกว่า คือการเปลี่ยนโมเดล ในกราฟคะแนนของ Terminal-Bench 3.0 แต่ละโมเดลจะเป็นเส้นที่ค่อยๆ ไต่สูงขึ้นตามระดับ effort โดยเส้นของ Opus 5.5 อยู่เหนือทุกโมเดลในทุกระดับ และ Opus 5.5 ระดับ high ทำคะแนนได้ใกล้เคียงกับ Fable 5.1 ระดับ max แต่ใช้ token น้อยกว่าราวครึ่งหนึ่ง
จุดนี้แสดงให้เห็นว่า โมเดลกับ effort level เป็นการตัดสินใจ 2 เรื่องที่แยกจากกัน โดยโมเดลเป็นตัวกำหนดว่าเส้นคะแนนความสามารถจะอยู่สูงแค่ไหน ส่วน effort เป็นตัวกำหนดว่าเราต้องการขยับไปอยู่จุดไหนบนเส้นคะแนนนั้น
สูตรเลือก /effort ให้ตรงงาน
เกณฑ์ในการเลือกระดับ effort ที่ผู้ทดลองใช้จริง สรุปได้ดังนี้:
| คำสั่ง | ใช้เมื่อ | ตัวอย่างงาน |
|---|---|---|
/effort low | อยากได้คำตอบเร็ว และต้องการคุมทิศทางงานเองทีละขั้น | ร่างไอเดีย ระดมความคิด แก้ไขจุดเล็กๆ |
/effort medium | งานเขียนโปรแกรมทั่วไปในชีวิตประจำวัน | การพัฒนาฟีเจอร์ใหม่ |
/effort high | งานที่ต้องตรวจสอบอย่างจริงจัง หรือมี edge case ซ่อนอยู่ | แก้บั๊กในโค้ดเดิมที่ใช้งานอยู่ ไล่ทดสอบ edge case |
/effort max | ปล่อยให้ Claude รับโจทย์ยากไปจัดการเองตั้งแต่ต้นจนจบ | สร้างแอปพร้อมระบบตรวจสอบครบทุกขั้น ค้นหาช่องโหว่ความปลอดภัยในซอฟต์แวร์สำคัญ |
สำหรับการพัฒนาฟีเจอร์ใหม่ ผู้ทดลองใช้วงจรการทำงาน 4 ขั้นตอนที่เขาพบว่าได้ผลดีเป็นพิเศษ:
- ส่งสเปกให้ Claude แล้วให้ Claude สัมภาษณ์เรากลับ เพื่อหาว่ายังมีรายละเอียดตรงไหนตกหล่นอีกบ้าง
- เริ่มลงมือเขียนโค้ดด้วย
/effort low - ตรวจสอบว่า Claude เข้าใจแก่นของงานถูกต้องหรือไม่ ถ้ายังไม่ตรงจุดก็ปรับแก้ต่อในระดับ low
- สลับเป็น
/effort highเพื่อให้ Claude ตรวจทานและรันทดสอบระบบอย่างละเอียด
เราสลับระดับ effort ระหว่างการสนทนาได้ทันทีด้วยคำสั่ง /effort โดยโมเดลรุ่นใหม่เปลี่ยนระดับได้โดยไม่ทำให้ข้อมูลบริบทการสนทนาก่อนหน้าที่ระบบบันทึกไว้อย่าง prompt cache เสียไป
วงจรการทำงานนี้ใช้จุดเด่นของ effort ได้ตรงกับที่ผลการทดสอบข้างต้นชี้ไว้ ช่วงแรกที่สร้างชิ้นงานเราใช้ low เพื่อให้เห็นผลงานเร็วและยังคุมทิศทางงานได้ ส่วนช่วงตรวจทานเราใช้ high เพราะการไล่เก็บ edge case คือจุดที่ใช้ effort แล้วคุ้มที่สุด
ขั้นตอนแรกอาจดูเหมือนเสียเวลา แต่แท้จริงแล้วคือการปิดช่องว่างไม่ให้ Claude ต้องคาดเดาไปเอง เพราะถ้าเราข้ามขั้นตอนนี้ไป Claude ก็ต้องเดาความต้องการเอาเอง และยิ่งตั้งระดับ effort ไว้สูง Claude ก็ยิ่งตัดสินใจแทนเราไปไกลขึ้น
ก่อนจะพิมพ์คำสั่ง /effort ในครั้งต่อไป อย่าถามแค่ว่างานนี้ยากแค่ไหน แต่ให้ถามว่างานนี้ยังมีจุดที่อาจพังโดยที่ยังไม่มีใครเคยลองทดสอบอยู่อีกกี่จุด
ที่มา: บทความ Using Claude Code: Spending Your Effort จาก Thariq (@trq212)
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ