เลิกชน Usage Limit ของ Claude Code: สิ่งที่ Brad ปรับใน setup จนใช้ได้ทั้งวัน
Brad จากช่อง AI & Automation สรุปว่าปัญหา Claude Code ชน usage limit เร็ว ไม่ใช่เรื่องโควต้า แต่เป็นเรื่อง context hygiene ของ setup ที่บวมเงียบ ๆ บทความนี้สรุปวิธีตัด context แฝง 50,000+ โทเค็น ตั้ง settings.json ให้ถูก และวินัยรายวัน 4 ข้อที่ช่วยให้ใช้ Claude Code ได้ตลอดวัน
Brad เจ้าของช่อง Brad | AI & Automation เคยเจอปัญหาชน Usage Limit ของ Claude Code แทบทุกวัน จนกระทั่งตัดสินใจรื้อระบบการตั้งค่าใหม่ทั้งหมด ทำให้สามารถใช้งานต่อเนื่องได้ตลอดวันโดยไม่ชนลิมิตอีกเลยหลายสัปดาห์ติดต่อกัน
ในคลิป "I Stopped Hitting Claude Code Usage Limits (Here's How)" Brad ได้อธิบายว่า ต้นตอที่แท้จริงไม่ใช่เพราะ Anthropic ให้โควต้าน้อยเกินไป แต่เป็นเรื่อง Context Hygiene หรือสุขอนามัยของ Context Window ในระบบที่เรามองข้ามไป การมีข้อมูลแฝงบวมขึ้นเงียบๆ ทำให้ทุกข้อความที่เราพิมพ์ส่งไปต้องจ่ายภาษี Token มหาศาลโดยไม่รู้ตัว
ทำไม Claude Code ถึงชน Limit ไว: ปัญหา Context Hygiene ที่ถูกมองข้าม
ทุกครั้งที่เราส่งข้อความใหม่เข้าไป Claude Code จะอ่าน ประวัติการสนทนาทั้งหมดในเซสชันนั้นซ้ำตั้งแต่ข้อความแรก ไม่ใช่แค่อ่านข้อความล่าสุด ส่งผลให้ข้อความที่ 30 ในเซสชันมีต้นทุน Token สูงกว่าข้อความแรกหลายสิบเท่า เพราะต้องแบกประวัติทั้งหมดกลับเข้าไปประมวลผลซ้ำ ขณะเดียวกัน ไฟล์ CLAUDE.md, MCP Server ทุกตัว และ Skill ทุกตัวที่ติดตั้งไว้ จะถูก Preload เข้าสู่ Context Window ตั้งแต่วินาทีแรกที่เปิดเซสชัน ก่อนที่เราจะเริ่มพิมพ์คำสั่งแรกด้วยซ้ำ
นอกจากจะเปลือง Token และชน Limit เร็วแล้ว Context ที่บวมเกินไปยังทำให้คุณภาพของคำตอบแย่ลง (Context Degradation) เนื่องจาก LLM มีแนวโน้มจะให้ความสำคัญกับส่วนท้ายของบทสนทนา และอาจมองข้ามข้อกำหนดสำคัญที่อยู่ช่วงต้นไป
วิธีตรวจสอบขนาด Context ฐานของตัวเอง ทำได้โดยเปิดเซสชันใหม่แล้วพิมพ์คำสั่ง /context Claude Code จะแสดงจำนวน Token ที่โหลดรอไว้ ตอนที่ Brad เช็กก่อนปรับแต่ง ตัวเลขพุ่งสูงถึง 50,000+ Token ซึ่งหมายความว่าทุกคำสั่งหลังจากนั้นจะถูกคิด Token ฐานนี้ทบเข้าไปตลอดเวลา
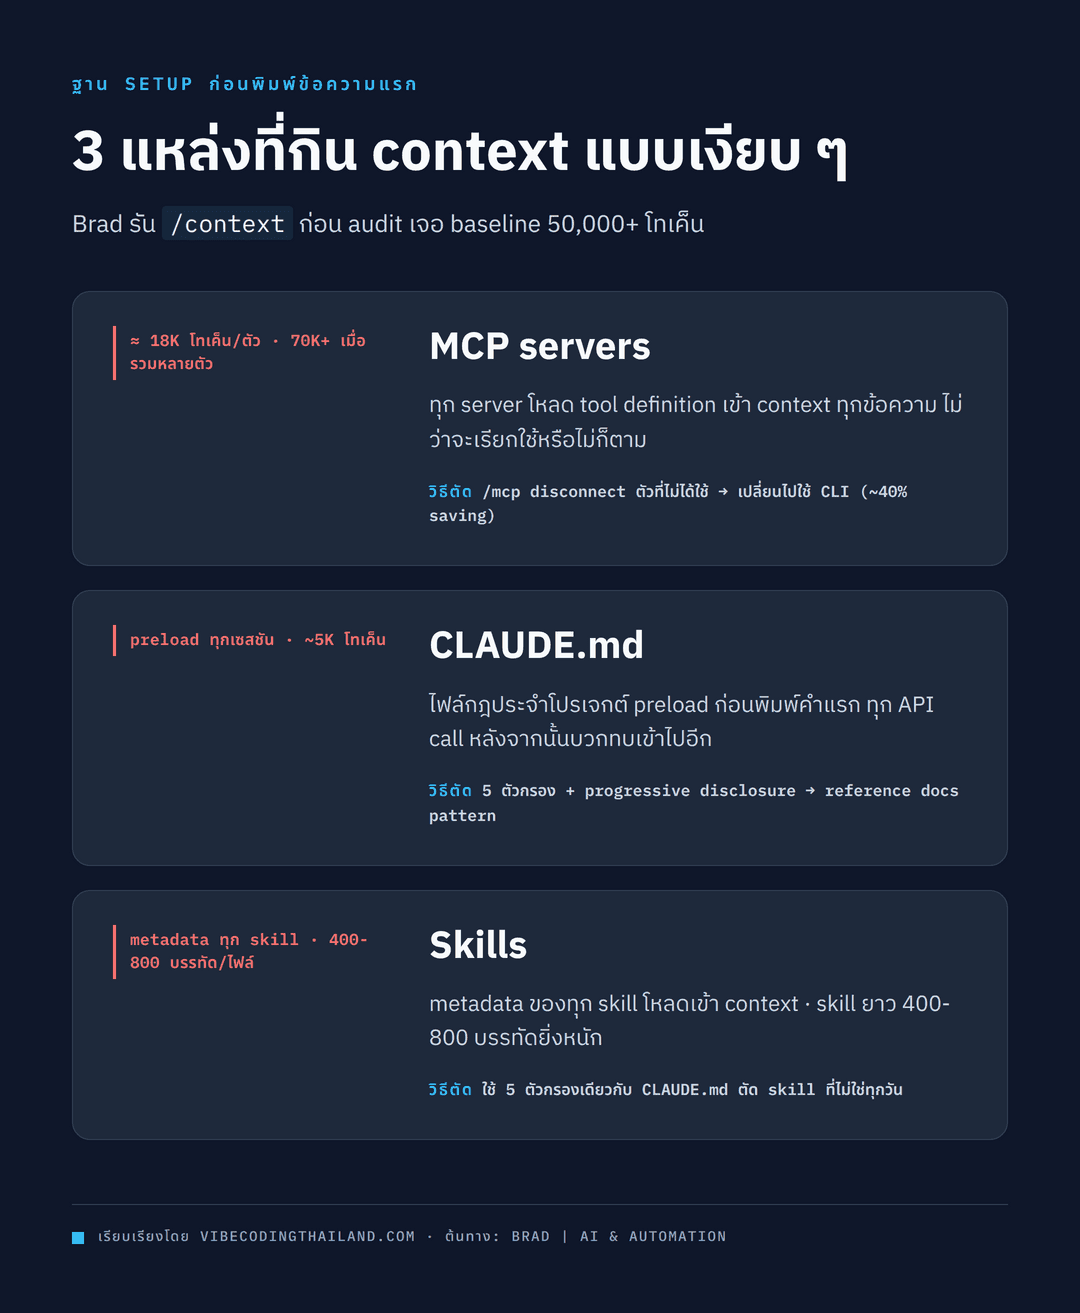
3 แหล่งต้นทุนแฝงที่แอบกิน Token ใน Setup ของคุณ
1. MCP Servers ที่เปิดทิ้งไว้
MCP Server แต่ละตัวจะโหลด Tool Definition ทั้งหมดเข้าสู่ Context ในทุกๆ ข้อความ แม้ว่าเราจะไม่ได้เรียกใช้งานเซิร์ฟเวอร์ตัวนั้นในงานปัจจุบันเลยก็ตาม เซิร์ฟเวอร์หนึ่งตัวอาจใช้ Token ถึง 18,000 Token หากเปิดทิ้งไว้หลายตัว Context ฐานอาจหายไปถึง 70,000 Token ทันที
- วิธีแก้: พิมพ์
/mcpในเซสชัน แล้วสั่ง Disconnect หรือตัดการเชื่อมต่อเซิร์ฟเวอร์ที่ไม่ได้ใช้ออกไป - เปลี่ยนมาใช้ CLI แทน MCP: คำสั่ง CLI จะเสีย Token เฉพาะตอนที่ Claude รันคำสั่งจริงเท่านั้น ต่างจาก MCP ที่กิน Token รอไว้ตลอดเวลา การเปลี่ยนเครื่องมืออย่าง Playwright หรือ Apify จาก MCP มาเป็น CLI ช่วยประหยัด Token ได้ราว 40%
2. ปรับแต่ง CLAUDE.md ด้วย Progressive Disclosure
ไฟล์ CLAUDE.md ถูกโหลดเข้าสู่ Context ทุกครั้งที่เปิดใช้งาน ให้ตรวจสอบ 3 จุดสำคัญ:
- ตัดกฎที่ขัดแย้งกันเอง: เช่น สั่งให้ "ตอบสั้นกระชับ" ในข้อหนึ่ง แต่ระบุ "อธิบายเหตุผลและรายละเอียดเชิงลึกทุกครั้ง" ในอีกข้อหนึ่ง ทำให้โมเดลสับสนและเพิ่มขนาดไฟล์โดยเปล่าประโยชน์
- คัดกรองด้วย 5 ตัวกรองของ Brad:
- เป็นสิ่งที่ Claude รู้อยู่แล้วตามธรรมชาติโดยไม่ต้องสั่งหรือไม่?
- ขัดแย้งกับกฎข้ออื่นหรือไม่?
- ซ้ำซ้อนกับข้อที่มีอยู่แล้วหรือไม่?
- เป็น Band-aid ที่เขียนขึ้นเพื่อแก้ความผิดพลาดเพียงครั้งเดียวหรือไม่?
- คลุมเครือเกินไปหรือไม่? (เช่น "ตอบให้ดูเป็นธรรมชาติ" หรือ "ใช้โทนที่ดี") หากเข้าข่ายข้อใดข้อหนึ่ง ให้ตัดทิ้งทันที
- ใช้เทคนิค Progressive Disclosure: เก็บเฉพาะกฎส่วนกลางที่ใช้กับทุกงานไว้ใน
CLAUDE.mdหลัก (เช่น Style Guide หรือภาพรวมโปรเจกต์) ส่วนคู่มือเฉพาะทาง เช่น API Conventions หรือ Testing Guidelines ให้แยกออกเป็นไฟล์ย่อย เช่นAPI-standards.mdแล้วใส่ Pointer ไว้อ้างอิงบรรทัดเดียวในCLAUDE.mdเพื่อให้ Claude โหลดมาอ่านเฉพาะตอนที่ต้องทำงานนั้นจริงๆ
3. คัดกรอง Skills ที่ติดตั้งไว้
Metadata ของทุก Skill จะถูกโหลดเข้า Context เสมอ หากติดตั้ง Skill จากภายนอกที่มีขนาดยาว 400 ถึง 800 บรรทัดไว้จำนวนมาก Context จะถูกใช้ไปโดยไม่จำเป็น ยิ่งมีคำสั่งเยอะ โมเดลจะยิ่งเริ่มละเลยกฎบางข้อเพราะมีสิ่งดึงความสนใจมากเกินไป ให้ใช้ตัวกรอง 5 ข้อเดียวกันนี้คัดเลือกเฉพาะ Skill ที่จำเป็นต่อโปรเจกต์เท่านั้น
ปรับจูน settings.json ให้ทันสมัย
การตั้งค่าบางอย่างใน settings.json มีผลต่อประสิทธิภาพของ Context Window โดยตรง:
- autoCompactPercentage: ค่าเริ่มต้นจะเริ่มบีบอัด Context เมื่อใช้ไปประมาณ 83% แต่คุณภาพคำตอบมักเริ่มลดลงก่อนหน้านั้น แนะนำให้ตั้งค่าเป็น
75เพื่อให้ระบบทำ Auto-compact เร็วขึ้นก่อนที่ความจำจะแน่นเกินไป - BASH_MAX_OUTPUT_LENGTH: เมื่อรันคำสั่ง Shell ที่มีผลลัพธ์ยาว ค่าเริ่มต้นอาจตัดข้อความทิ้ง ทำให้ Claude ต้องสั่งรันซ้ำและเสีย Token เพิ่ม สามารถตั้งค่า Environment Variable
BASH_MAX_OUTPUT_LENGTH=150000เพื่อให้รับข้อมูลได้ยาวขึ้นในรอบเดียว - File Permissions (Deny Rules): กำหนด Deny Rules ใน
settings.jsonเพื่อป้องกันไม่ให้ Claude เสียเวลาเข้าไปอ่านโฟลเดอร์ที่ไม่จำเป็น เช่นnode_modules,dist, โฟลเดอร์ build หรือ lock files คล้ายกับการทำงานของ.gitignore
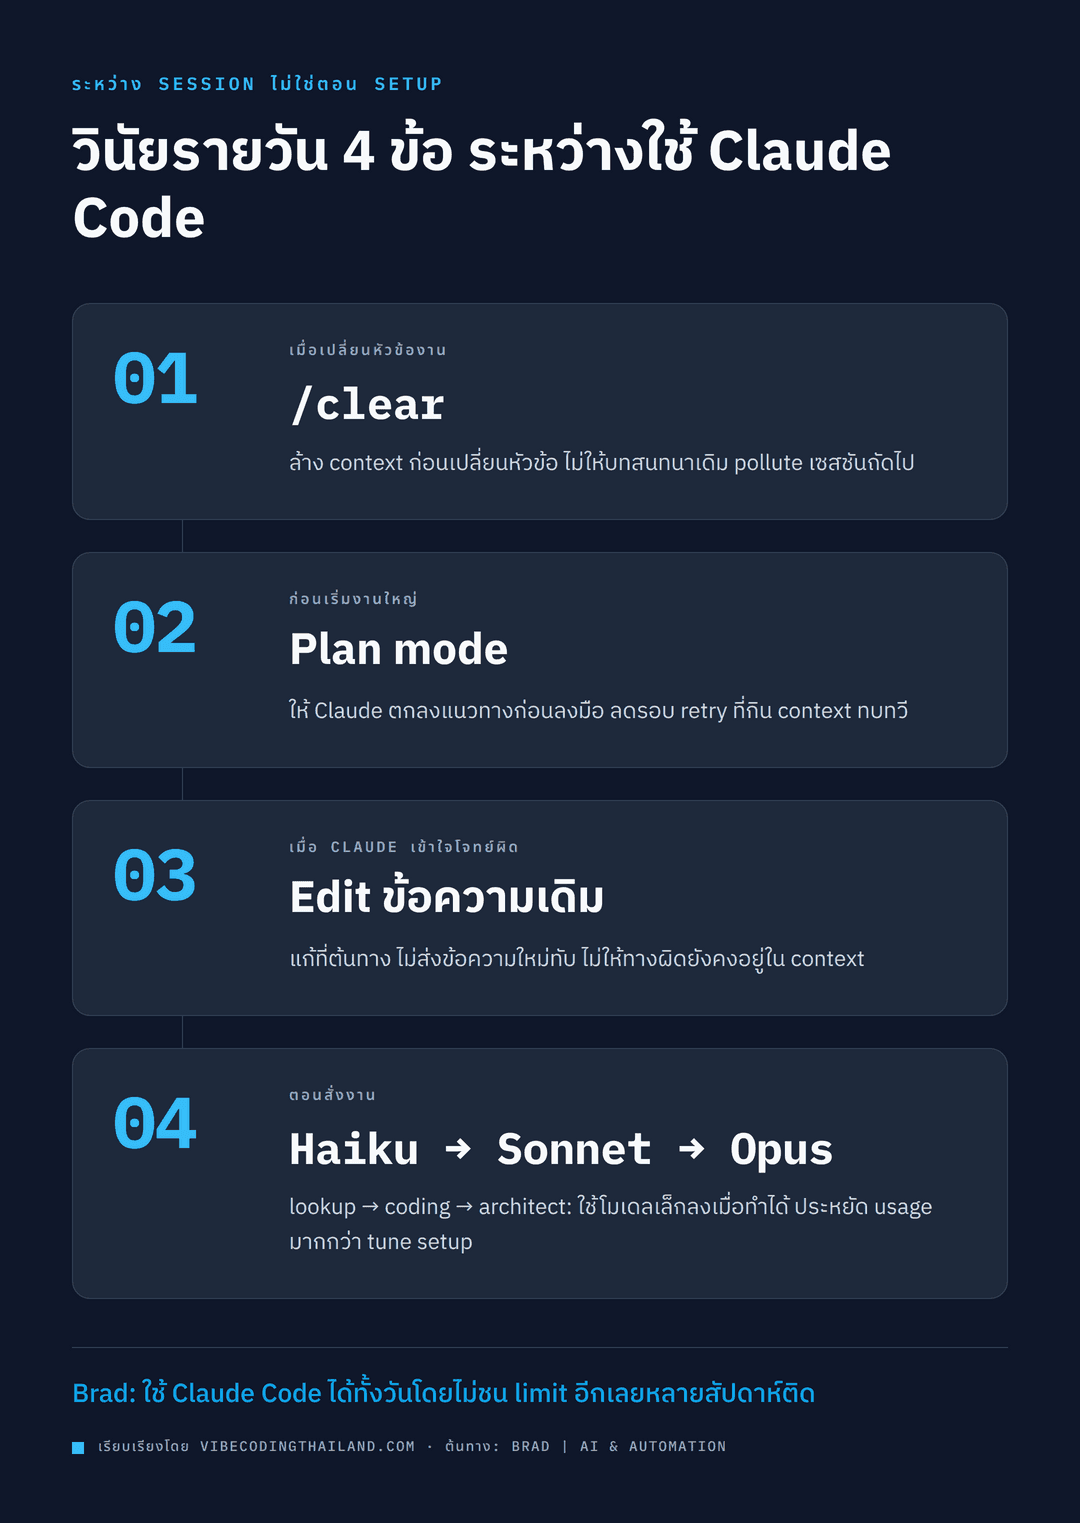
4 วินัยรายวันที่ช่วยประหยัด Token ได้มากกว่าการปรับ Setup
นอกจากการตั้งค่าระบบแล้ว วินัยในการใช้งานประจำวันคือปัจจัยสำคัญที่สุด:
- เริ่มเซสชันใหม่เมื่อเปลี่ยนโจทย์ (
/clear): เมื่อทำงานหนึ่งเสร็จแล้วจะย้ายไปทำอีกเรื่อง ให้พิมพ์คำสั่ง/clearเสมอ เพื่อไม่ให้ข้อความใหม่ต้องแบกรับประวัติบทสนทนาของงานก่อนหน้า - ใช้ Plan Mode กับงานใหญ่: ความผิดพลาดที่เปลือง Token ที่สุดคือการปล่อยให้ AI เขียนโค้ดผิดทิศทางไปหลายร้อยบรรทัดแล้วต้องลบทิ้ง การเปิด Plan Mode ช่วยบังคับให้ Claude วางแผนและถามคำถามจนชัดเจนก่อนเริ่มเขียนโค้ดจริง
- แก้ไขข้อความเดิม แทนการพิมพ์ตอบแก้ซ้ำๆ: หาก Claude เข้าใจโจทย์ผิด ให้กดแก้ไขข้อความเดิม (Edit Message) แล้วส่งใหม่ การพิมพ์ตอบแก้ไปเรื่อยๆ จะทำให้ Context สะสมทั้งคำตอบที่ผิดและคำตอบที่ถูก ซึ่งรบกวนความแม่นยำในการทำงาน
- เลือกโมเดลให้เหมาะกับระดับของงาน:
- Haiku: เหมาะกับ Sub-agent, งาน Formatting, งานสคริปต์ขนาดเล็ก หรือ Lookup ทั่วไป
- Sonnet: เหมาะกับงาน Coding ทั่วไปในชีวิตประจำวัน
- Opus: ใช้สำหรับงานวางสถาปัตยกรรมระดับลึก หรืองาน Logic ที่ซับซ้อนสูง
เช็กลิสต์สรุปก่อนนำไปปรับใช้จริง
| หมวดหมู่ | สิ่งที่ควรทำ | คำสั่ง / ค่าที่แนะนำ |
|---|---|---|
| ตรวจสอบ Baseline | ดูขนาด Context ฐานก่อนเริ่มพิมพ์ข้อความแรก | /context |
| MCP | ปลดการเชื่อมต่อ Server ที่ไม่ได้ใช้ในเซสชัน | /mcp แล้วเลือก Disconnect |
| MCP | สลับมาใช้ CLI แทน MCP ในเครื่องมือที่รองรับ | ใช้ Playwright หรือ Apify ผ่าน CLI |
| CLAUDE.md | กรองกฎที่ไม่จำเป็นออก | ตัดข้อความที่เป็น Default, ขัดแย้ง, ซ้ำซ้อน, Band-aid หรือคลุมเครือ |
| CLAUDE.md | ใช้ Progressive Disclosure | แยกคู่มือเฉพาะทางเป็นไฟล์ย่อย แล้วใส่ Pointer อ้างอิง |
| Skills | คัดกรอง Skill ที่ติดตั้งไว้ | ลบ Skill ยาวที่ไม่ได้ใช้งานเป็นประจำ |
| settings.json | สั่ง Auto-compact ให้เร็วขึ้น | autoCompactPercentage: 75 |
| settings.json | เพิ่มขีดจำกัดความยาว Bash Output | BASH_MAX_OUTPUT_LENGTH=150000 |
| settings.json | บล็อกโฟลเดอร์ขยะ | เพิ่ม Deny Rule สำหรับ node_modules, dist, Lock files |
| วินัยการใช้งาน | เคลียร์เซสชันเมื่อเปลี่ยนงาน | /clear |
| วินัยการใช้งาน | วางแผนก่อนเริ่มงานใหญ่ | ใช้งาน Plan Mode |
| วินัยการใช้งาน | แก้ไขข้อความเดิมเมื่อตอบผิด | Edit Previous Message แทนการพิมพ์ Reply แก้ |
| วินัยการใช้งาน | กระจายงานตามระดับโมเดล | Haiku สำหรับงานย่อย, Sonnet สำหรับงานหลัก, Opus สำหรับงานสถาปัตยกรรม |
ปัญหา Usage Limit ของ Claude Code แก้ไขได้ด้วยการจัดระเบียบ Context Hygiene อย่างสม่ำเสมอ การปรับปรุงระบบควบคู่ไปกับวินัยการใช้งานประจำวัน จะช่วยให้สามารถใช้งาน Claude Code ได้อย่างราบรื่นและมีประสิทธิภาพตลอดทั้งวัน
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Vibe Coding สำหรับคนไม่ใช่โปรแกรมเมอร์ ใช้ Claude Code สร้าง landing page, mini app และ prototype จริงโดยไม่ต้องเขียนโค้ด
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ