ระบบ memory ของ Claude Code ที่ Karpathy ทำ viral 18 ล้านวิว และจุดที่มันพังตอน scale
ช่อง Jack Roberts สรุประบบ memory แบบ Claude Code + Obsidian ที่ Andrej Karpathy ทำ viral กว่า 18 ล้านวิว ซึ่งทำงานเป็น personal Wikipedia ที่ LLM ดูแลเอง 1 source อัปเดต 10-15 หน้าในรอบเดียว พร้อมเปิด 5 จุดที่ระบบพังตอน scale และทางแก้เป็นสถาปัตยกรรม 4 ชั้น
กระแสไวรัลกว่า 18 ล้านวิวจากโพสต์ของ Andrej Karpathy (ผู้ร่วมก่อตั้ง OpenAI) ที่หยิบยกไอเดียการต่อ Claude Code เข้ากับ Obsidian เพื่อสร้างระบบความจำถาวร กลายเป็นหัวข้อที่พูดถึงกันอย่างมากในหมู่นักพัฒนา
ช่อง Jack Roberts ได้นำแนวคิดนี้มาทดลองและวิเคราะห์เชิงลึก โดยชี้ให้เห็นว่าระบบนี้ช่วยแก้ปัญหาเรื่อง Context Loss และอาการหลอน (Hallucination) ของ LLM ได้จริง แต่ในขณะที่คอนเทนต์ส่วนใหญ่ในโซเชียลมัวแต่ตื่นเต้นกับภาพกราฟสวยหรูใน Obsidian (Graph View) กลับแทบไม่มีใครพูดถึงข้อจำกัดร้ายแรงเมื่อระบบต้องขยายขนาด (Scale) บทความนี้จะพาไปเจาะลึกทั้งกลไกการทำงาน จุดเปราะบางที่ทำให้ระบบพัง และทางออกด้วยสถาปัตยกรรม 4 ชั้นที่ใช้งานได้จริงในระยะยาว
1. Obsidian Memory System คืออะไร
แนวคิดของ Karpathy คือการเปลี่ยน LLM ให้ทำหน้าที่เป็นบรรณาธิการดูแล สารานุกรมส่วนตัว (Personal Wikipedia) แทนที่จะใช้ระบบ Retrieval แบบเดิมที่ต้องไปควานหาเอกสารดิบใหม่ทุกครั้ง
สถาปัตยกรรมนี้ไม่ได้พึ่งพาฐานข้อมูลที่ซับซ้อน แต่ทำงานผ่าน 3 องค์ประกอบหลักในรูปแบบไฟล์ Markdown:
- Raw Sources Folder: โฟลเดอร์เก็บข้อมูลดิบ เช่น บทความ ไฟล์ PDF สรุปบทสนทนา หรือ Transcript จาก YouTube
- Wiki Folder: โฟลเดอร์สรุปความรู้ที่ Claude เขียนและจัดหมวดหมู่ขึ้นมาเอง
- Schema Rulebook (CLAUDE.md): ไฟล์กำหนดกฎเกณฑ์และเวิร์กโฟลว์ เพื่อเปลี่ยน Claude จากผู้ตอบคำถามธรรมดา ให้กลายเป็นผู้ดูแลคลังความรู้อย่างมีแบบแผน
Obsidian ในที่นี้ทำหน้าที่เพียงหน้าต่างแสดงผลเชิงภาพ (Visual Interface) เท่านั้น หัวใจหลักคือโครงสร้างโฟลเดอร์และไฟล์ Markdown ซึ่งคุณสามารถนำไปรันบน Cursor, Antigravity หรือเทอร์มินัลใดๆ ก็ได้
2. Compounding Effect และ 3 คำสั่งหลัก
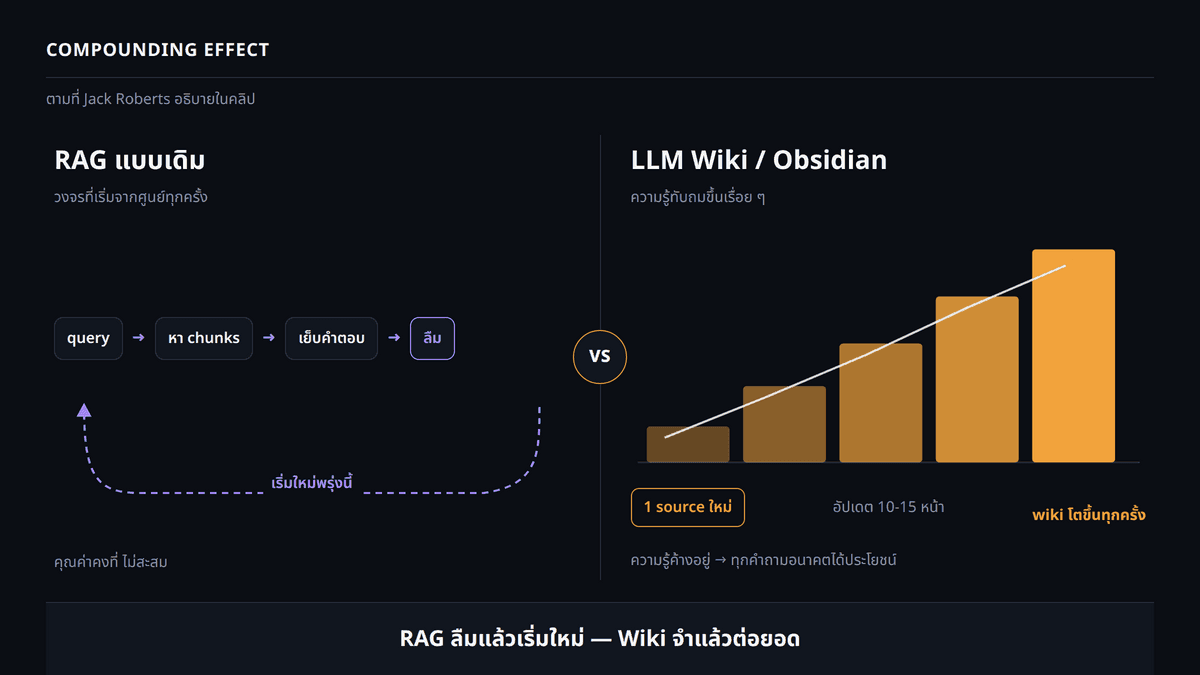
ความแตกต่างสำคัญระหว่างระบบนี้กับ RAG ดั้งเดิม คือการสะสมคุณค่าแบบทบต้น (Compounding Effect):
- Traditional RAG: รับคำสั่ง ค้นหา Chunks ประกอบคำตอบ แล้วลืม ทุกครั้งที่ถามใหม่ต้องเริ่มนับหนึ่งใหม่เสมอ
- LLM Wiki: เมื่อป้อนแหล่งข้อมูลใหม่เข้าไป 1 ชิ้น Claude จะเปิดอ่านและวิ่งไปอัปเดตไฟล์ Markdown ที่เกี่ยวข้องในคลังพร้อมกัน 10 ถึง 15 หน้า ความรู้ใหม่จะถูกเชื่อมโยงและคงอยู่ตลอดไป
เวิร์กโฟลว์หลักประกอบด้วย 3 กระบวนการ:
- Ingest: การป้อนข้อมูลดิบเข้าสู่คลัง
- Query: การค้นหาคำตอบโดยให้ Claude วิ่งสำรวจสารบัญและเนื้อหาใน Markdown
- Linting: การให้ AI ทำความสะอาดคลังความรู้ ค้นหาข้อมูลที่ขัดแย้งกัน และปรับปรุงเนื้อหาให้ทันสมัยทุกๆ 2 ถึง 3 สัปดาห์
3. ขั้นตอนการเริ่มต้นใช้งาน
Jack Roberts สรุปแนวทางการสร้างระบบไว้อย่างกระชับ:
- โฟกัสทีละโดเมน: เริ่มต้นสร้าง Vault สำหรับหัวข้อเฉพาะ เช่น โปรเจกต์หนึ่งงาน หนังสือหนึ่งเล่ม หรือหัวข้องานวิจัยหนึ่งเรื่อง อย่าเพิ่งนำทุกเรื่องในชีวิตมารวมกันในที่เดียว
- สร้าง Rulebook ร่วมกับ AI: ในเซสชันแรก ให้กำหนดเป้าหมายและเขียนกฎเกณฑ์การบันทึกลงในไฟล์
CLAUDE.mdให้ชัดเจน - ต่อท่อส่งข้อมูล: ติดตั้ง Obsidian Web Clipper เพื่อดึงเนื้อหาจากเว็บไซต์และบทความต่างๆ เข้ามาเก็บเป็นไฟล์ดิบในเครื่องโดยตรง
4. จุดที่ระบบพังเมื่อต้อง Scale
แม้ระบบนี้จะให้ความรู้สึกเหมือนเวทมนตร์เมื่อมีไฟล์เพียง 100 หน้า แต่ Jack Roberts เตือนว่าเมื่อขยายไปถึง 10,000 หน้า ระบบจะเริ่มพังทลายลงด้วย 5 สาเหตุสำคัญ:
- ค่าใช้จ่าย Token พุ่งสูง: ไฟล์
index.mdและCLAUDE.mdจะบวมขึ้นเรื่อยๆ การสั่งให้ Claude อ่านสารบัญทั้งหมดก่อนตอบคำถามจะผลาญ Token มหาศาลในทุกรอบ - ขาด Semantic Search: ระบบไล่ตามหัวข้อโฟลเดอร์ ไม่ได้ค้นหาตามความหมายเชิงลึก (Vector Similarity)
- ปัญหา Context Window ล้น: เมื่อคลังข้อมูลใหญ่เกินไป จะไม่สามารถยัดบริบททั้งหมดลงในรอบการคิดของโมเดลได้
- ความล่าช้าในการ Ingest: การให้ LLM อ่านและสรุปข้อมูลดิบขนาดใหญ่ (เช่น วิดีโอ Transcript นับร้อยไฟล์) กินเวลาและเปลืองพลังประมวลผลโดยไม่จำเป็น
- Obsidian มีต้นทุนแบบ Linear: ยิ่งข้อมูลเยอะ ต้นทุนยิ่งสูงขึ้น ต่างจาก Vector Database ที่มีต้นทุนการดึงข้อมูลคงที่
5. ทางแก้และสถาปัตยกรรม Memory 4 ชั้นที่แท้จริง
เพื่อสร้างระบบความจำระยะยาวที่รองรับข้อมูลมหาศาลได้อย่างยั่งยืน Jack Roberts เสนอให้แบ่งบทบาทหน้าที่ออกเป็น 4 ชั้น:
- CLAUDE.md (Identity & Rules): เปรียบเหมือนบัตรประจำตัว ทำหน้าที่บอกบทบาทและกฎเกณฑ์ที่ไม่เปลี่ยนแปลง
- Obsidian (Reasoning & Workshop): พื้นที่ทำงานหลักสำหรับโปรเจกต์ที่กำลังทำอยู่ (Active Projects) ข้อสรุปการตัดสินใจ และงานที่ต้องใช้ความสามารถในการให้เหตุผลข้ามความสัมพันธ์ของกราฟ
- Vector Database / Pinecone (Warehouse Archive): โกดังเก็บข้อมูลดิบขนาดใหญ่ เช่น Transcript หนังสือ เอกสารอ้างอิงเก่า ที่ต้องการดึงข้อมูลแบบ Exact Match ด้วยต้นทุน Embedding ที่ถูกกว่า 100 เท่า
- NotebookLM (Deep Dive Research): เครื่องมือช่วยสังเคราะห์และวิจัยข้อมูลเฉพาะทาง ก่อนจะคัดเฉพาะสาระสำคัญส่งกลับมาเก็บในระบบความจำถาวร
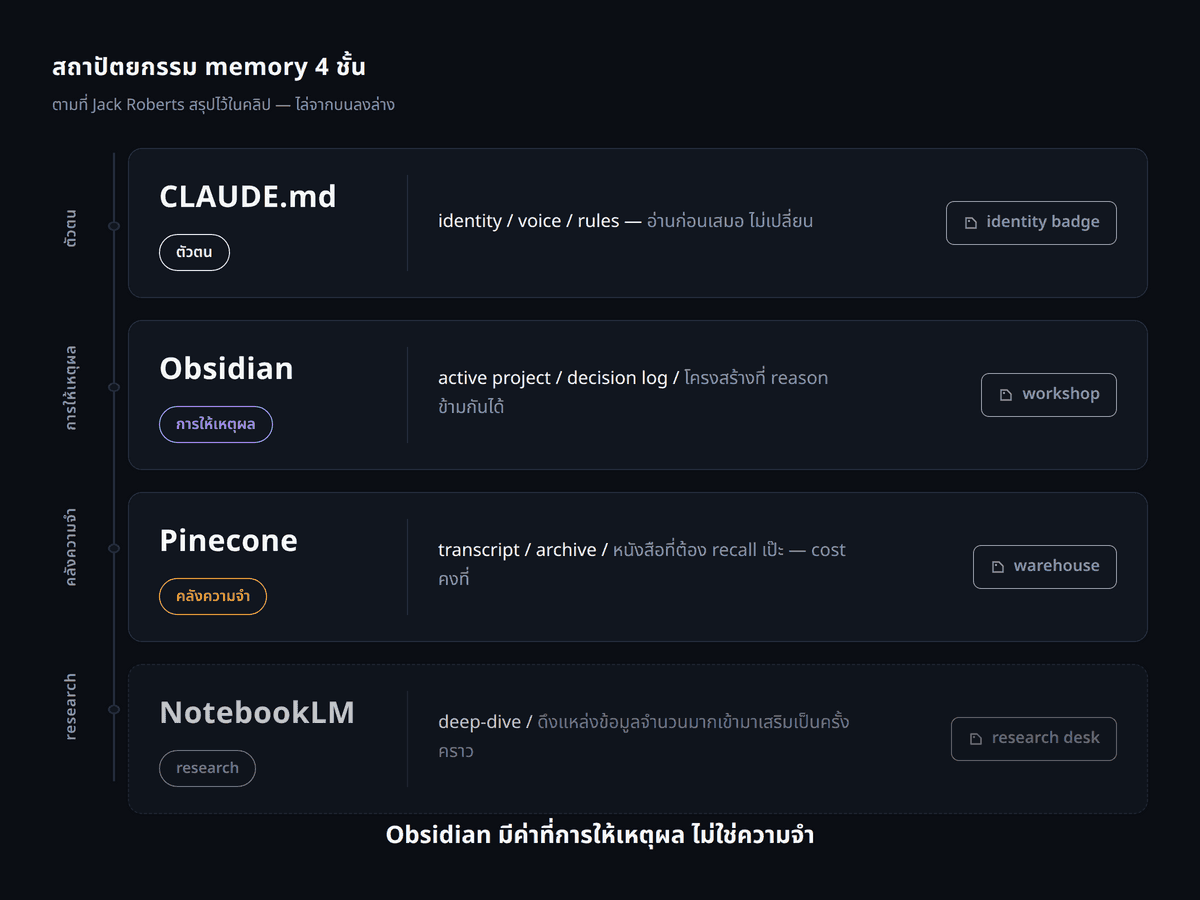
Obsidian โดดเด่นด้าน การให้เหตุผลเชิงโครงสร้าง (Reasoning) แต่ไม่ได้เหมาะกับการเป็นโกดังเก็บข้อมูลดิบทั้งหมด การผสมผสานความฉลาดของ Claude เข้ากับความจุของ Vector Database จึงเป็นคำตอบของการสร้างระบบ Second Brain ที่แท้จริง
ดูคลิปเต็มของ Jack Roberts: https://www.youtube.com/watch?v=eglVxLaWRUU
อ่านฉบับเต็มที่: https://vibecodingthailand.com/blog/claude-code-obsidian-memory
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin