rea-video แกะคลิปทีละช็อตว่าถ่ายจริง เจนด้วย AI หรือเขียนโค้ด พร้อมบอกมุมกล้อง แสง พรอมต์ และแผนทำคลิปใหม่ สั่งผ่าน Claude Code ได้
rea-video แกะคลิปทีละช็อตว่าถ่ายจริง เจนด้วย AI หรือเขียนโค้ด แล้ววางแผนว่าอะไรต้องถ่ายเอง อะไรให้ AI ทำ คนทำคลิปจึงประเมินขั้นตอนและต้นทุนได้ก่อนลงมือ
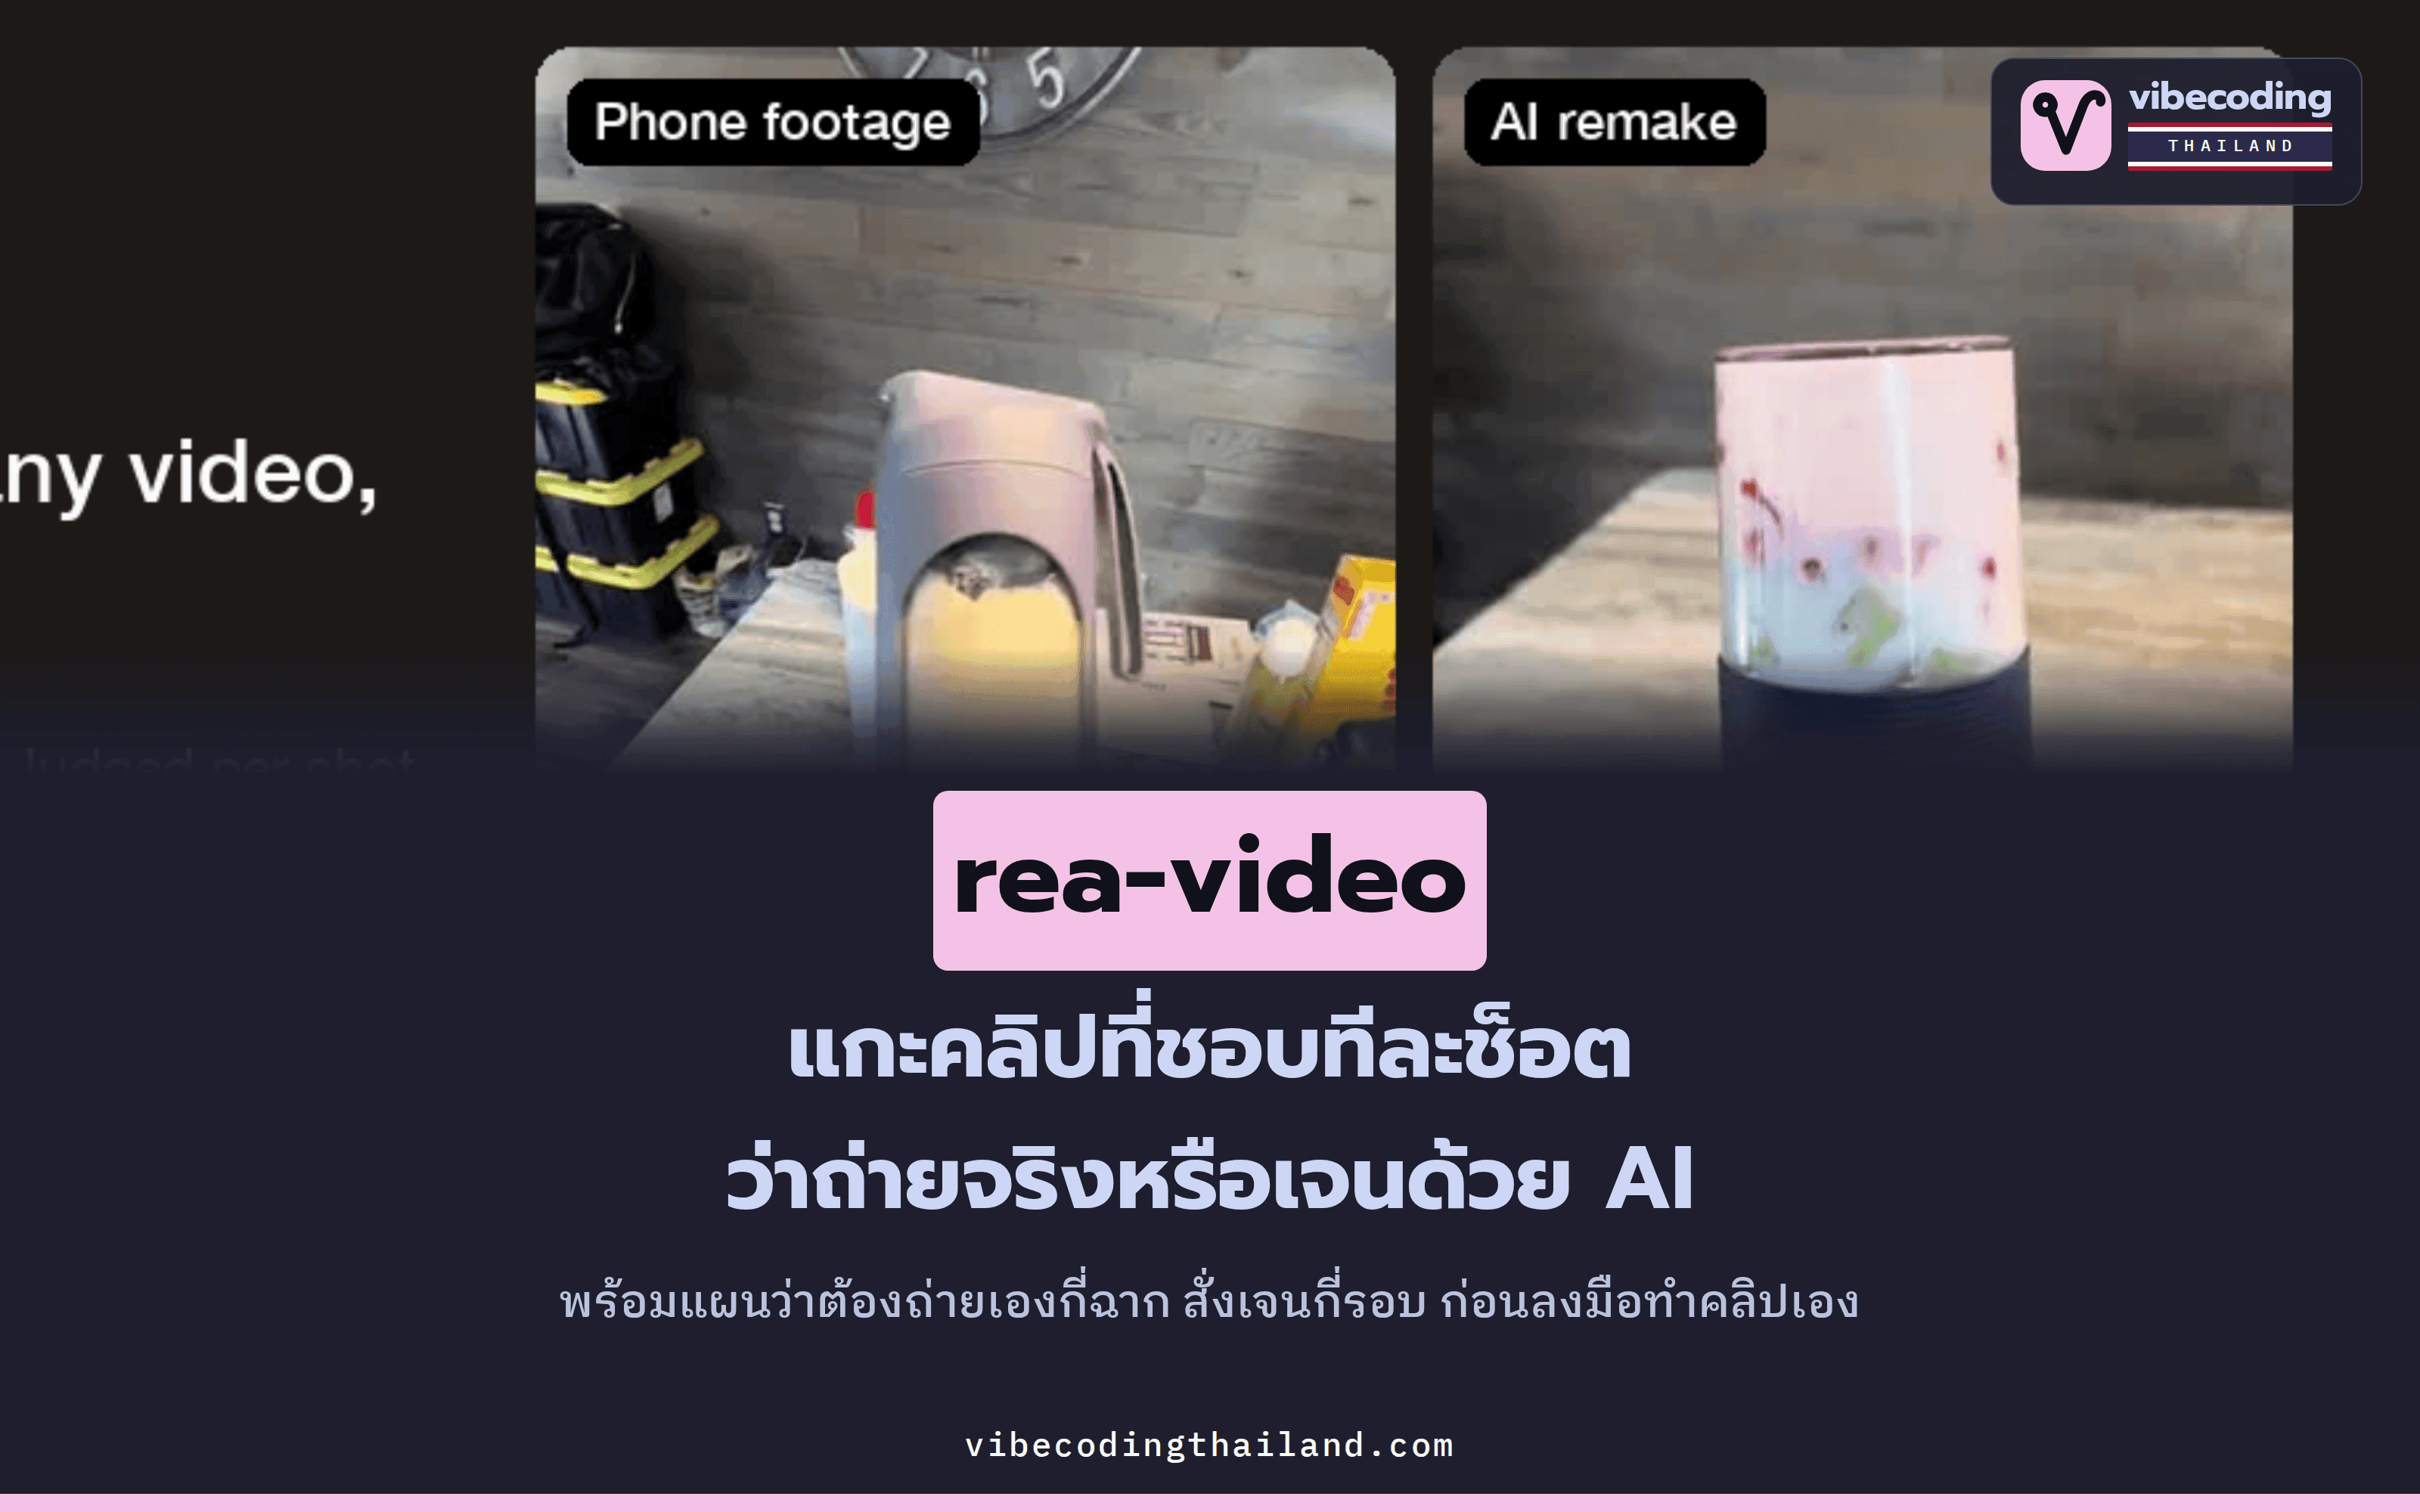
rea-video เป็นเครื่องมือช่วยแกะโครงสร้างคลิปทีละช็อต หน้า GitHub ของโปรเจกต์เปิดมาด้วยการเทียบโฆษณาสองคลิปคู่กัน คลิปซ้ายคือโฆษณาบน TikTok ที่ถ่ายทำด้วยมือถือจริง ส่วนคลิปขวาคือคลิปที่มีคนนำไปทำใหม่ด้วย AI เพื่อเปลี่ยนเป็นสินค้าอีกตัวหนึ่ง
ผลการวิเคราะห์ของ rea-video ระบุว่า คลิปทางซ้ายเป็นคลิปที่ถ่ายจริงทั้งหมด ใช้เพียงฉากเดียวและตั้งกล้องสลับ 2 มุม ส่วนคลิปทางขวาสร้างด้วย AI ทั้งเรื่อง โดยทั้ง 8 ช็อตในคลิป สั่งเจนแค่ 3 รอบก็ได้ครบทั้งหมด
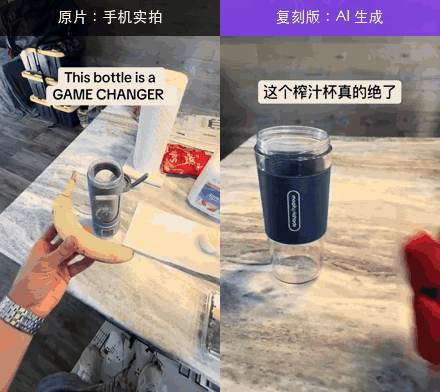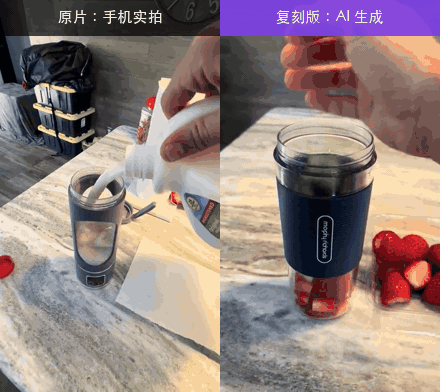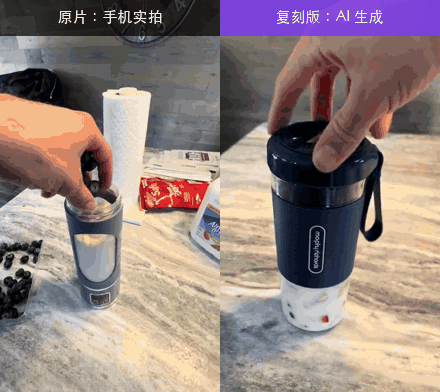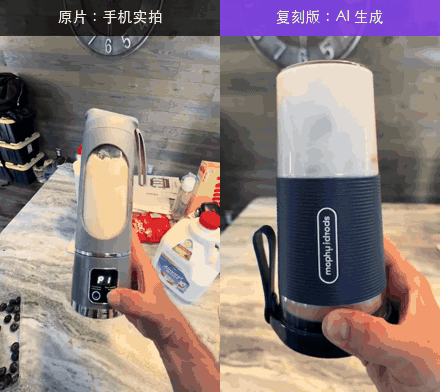
ข้อมูลเชิงลึกแบบนี้ช่วยตอบคำถามสำคัญที่คนทำคลิปอยากรู้ก่อนลงมือทำจริง ว่าวิดีโอแบบที่เราชอบต้องตั้งกล้องถ่ายเองกี่ฉาก ต้องเสียเงินสั่งเจน AI กี่ครั้ง หรือมีส่วนไหนที่เขียนโค้ดขึ้นมาแทนได้บ้าง โดย rea-video แกะข้อมูลพวกนี้ออกมาได้ทีละช็อต ตั้งแต่มุมกล้อง การจัดแสง ข้อความพรอมต์ ซับไตเติล จังหวะการตัดต่อ ไปจนถึงเสียงประกอบ พร้อมสรุปเป็นแผนงานที่ชัดเจนว่า ส่วนไหนต้องถ่ายเอง ส่วนไหนให้ AI ทำ และส่วนไหนควรเขียนโค้ด
โปรเจกต์นี้พัฒนาโดย JuneYaooo เปิดเป็นโอเพนซอร์สภายใต้สัญญาอนุญาตแบบ Apache-2.0 (ณ วันที่ 8 พฤศจิกายน 2026 มีผู้กดดาวบน GitHub แล้วราว 3,700 ดวง) สั่งงานผ่าน Coding Agent หรือ AI ผู้ช่วยเขียนโค้ดที่รันคำสั่งบนเครื่องของเราได้อย่าง Claude Code หรือ Codex โดยผลลัพธ์ที่ได้จะเป็นรายงานการวิเคราะห์และแผนการทำงานอย่างละเอียด ไม่ใช่ไฟล์วิดีโอที่ตัดต่อเสร็จแล้ว
วิธีวิเคราะห์ของ rea-video แยกตามประเภทคลิป
รายงานจะเริ่มต้นด้วยการระบุประเภทของแต่ละช็อตก่อนเสมอ เพราะวิดีโอแต่ละประเภทต้องใช้ข้อมูลสำหรับนำไปสร้างใหม่ไม่เหมือนกัน เช่น ช็อตที่ถ่ายจริงต้องรู้ตำแหน่งมุมกล้องและการจัดไฟ ส่วนช็อตที่ใช้ AI ต้องรู้ข้อความพรอมต์ที่ใช้สั่งงาน
| ชนิดคลิป | ตัวอย่าง | สิ่งที่รายงานบอก |
|---|---|---|
| ถ่ายจริง | พูดหน้ากล้อง ถ่ายบนโต๊ะ ถือสินค้าโชว์ vlog | ฉากที่ใช้ มุมกล้อง ขนาดภาพ ทิศทางการเคลื่อนกล้อง การจัดแสง (แยก 12 รูปแบบพร้อมอุปกรณ์ที่ต้องใช้) และโทนสีภาพ |
| คลิป AI | เจนจากข้อความหรือภาพ ซีรีส์สั้น MV ที่สร้างด้วย AI | หลักฐานที่ชี้ว่าเป็น AI, พรอมต์ที่แกะออกมาทีละช็อต, วิธีจัดกลุ่มช็อตเพื่อสั่งเจนเป็นรอบๆ และโมเดลที่แนะนำให้ใช้ |
| อวตาร | ภาพคนขยับปากพูดตามเสียง | ช็อตไหนที่ใช้อวตาร และต้องเตรียมรูปภาพบุคคลกับไฟล์เสียงแบบไหน |
| 3D และแอนิเมชัน | วิดีโออธิบายที่ทำใน Blender หรือ C4D แอนิเมชันสินค้า สต็อปโมชัน | แนะนำว่าควรใช้โมเดล AI เจนขึ้นมา หรือเขียนโค้ดเรนเดอร์เป็น 3D |
| ข้อความและ UI | ข้อความเคลื่อนไหว เดโมหน้าแอป กราฟ การ์ดสไลด์ | ดึงข้อความ เลย์เอาต์ และจังหวะการเคลื่อนไหว เพื่อนำไปสร้างใหม่ด้วยเครื่องมือที่สร้างวิดีโอจากโค้ดอย่าง Remotion |
| อัดหน้าจอ | คลิปสอนใช้งานโปรแกรม เดโมเว็บไซต์ | ระบุช่วงที่เป็นหน้าจอจริงที่เราต้องกดบันทึกวิดีโอเอง |
| คลิปผสม | มีทั้งตัวละคร AI กราฟิก UI จากโค้ด และภาพอัดหน้าจอ | วิเคราะห์แยกเป็นช็อตๆ แล้วจัดวางกลับลงไทม์ไลน์ตามเดิม |
นอกจากตัวภาพแล้ว rea-video ยังช่วยแกะองค์ประกอบอื่นในคลิปให้อย่างละเอียด:
- ซับไตเติลและข้อความบนจอ: ระบุเวลาที่ข้อความแต่ละบรรทัดปรากฏและหายไป พร้อมสี ขอบตัวอักษร และลูกเล่นตอนแสดงผล และส่งออกเป็นไฟล์ซับไตเติลแบบ SRT หรือ ASS ไปใช้ต่อได้ทันที
- สติกเกอร์ อีโมจิ และภาพกราฟิกซ้อน: ระบุตำแหน่งบนหน้าจอและระยะเวลาที่แสดง
- จังหวะการตัดต่อ: มาร์กตำแหน่งรอยต่อของแต่ละคัต ความเร็วในการเปลี่ยนภาพ และตรวจเช็กว่าตัดตรงกับจังหวะบีตของเพลงหรือไม่
- เสียง: แยกแยะว่าเป็นเสียงคนพูดจริงหรือเสียงพากย์ AI, เพลงประกอบสร้างด้วย AI หรือมาจากคลังเพลง, ระบุความเร็วเพลงด้วยจำนวนจังหวะต่อนาทีหรือค่า BPM และตำแหน่งที่เสียงเอฟเฟกต์แต่ละตัวดังขึ้น
- วัตถุดิบที่ต้องเตรียมเพิ่ม: ลิสต์สิ่งที่ต้องหาหรือทำขึ้นมาเอง เช่น คลิปอัดหน้าจอ ภาพแคปหน้าจอ และรูปสินค้าจริง
rea-video แยกคลิปถ่ายจริงกับ AI ด้วยหลักฐาน 3 ชั้น
ก่อนสรุปผล rea-video จะตัดคลิปแบ่งออกเป็นช็อตๆ แล้วแยกแทร็กเสียงออกเป็น 3 ส่วน คือ เสียงพูด เพลงประกอบ และเสียงเอฟเฟกต์ จากนั้นจะเริ่มตรวจสอบหลักฐาน 3 ระดับ:
- ระดับไฟล์: ตรวจเช็กจังหวะเฟรมเรต, ตรวจหา Noise ซึ่งเป็นสัญญาณรบกวนหรือเกรนภาพธรรมชาติที่กล้องจริงทิ้งไว้, สังเกตลักษณะการเคลื่อนภาพว่าทั้งภาพเลื่อนไปพร้อมกันเป็นแผ่นเดียวหรือไม่ รวมถึงค้นหาข้อมูลกำกับไฟล์อย่างแท็ก AIGC ที่ระบุว่าสร้างด้วย AI
- ระดับภาพ: สังเกตจุดที่ AI มักทำผิดพลาด เช่น รูปร่างนิ้วมือ ตัวหนังสือที่ปรากฏในฉาก และดูว่าการเคลื่อนไหวเป็นไปตามหลักฟิสิกส์จริงหรือไม่
- ระดับเสียง: วัดความเร็ว BPM คีย์ดนตรี และแยกแยะว่าเป็นเสียงร้องหรือเสียงพูด
ในขั้นตอนการตัดสิน หลักฐานเชิงเทคนิคที่วัดค่าได้อย่างแท็ก AIGC หรือจังหวะเฟรม จะมีน้ำหนักมากกว่าการมองด้วยสายตาว่า 'ดูเหมือน AI' ถ้าหลักฐานในช็อตไหนขัดแย้งกันเอง ระบบจะส่งช็อตนั้นไปให้ Agent ช่วยเปิดดูภาพเพื่อตัดสินซ้ำอีกครั้ง
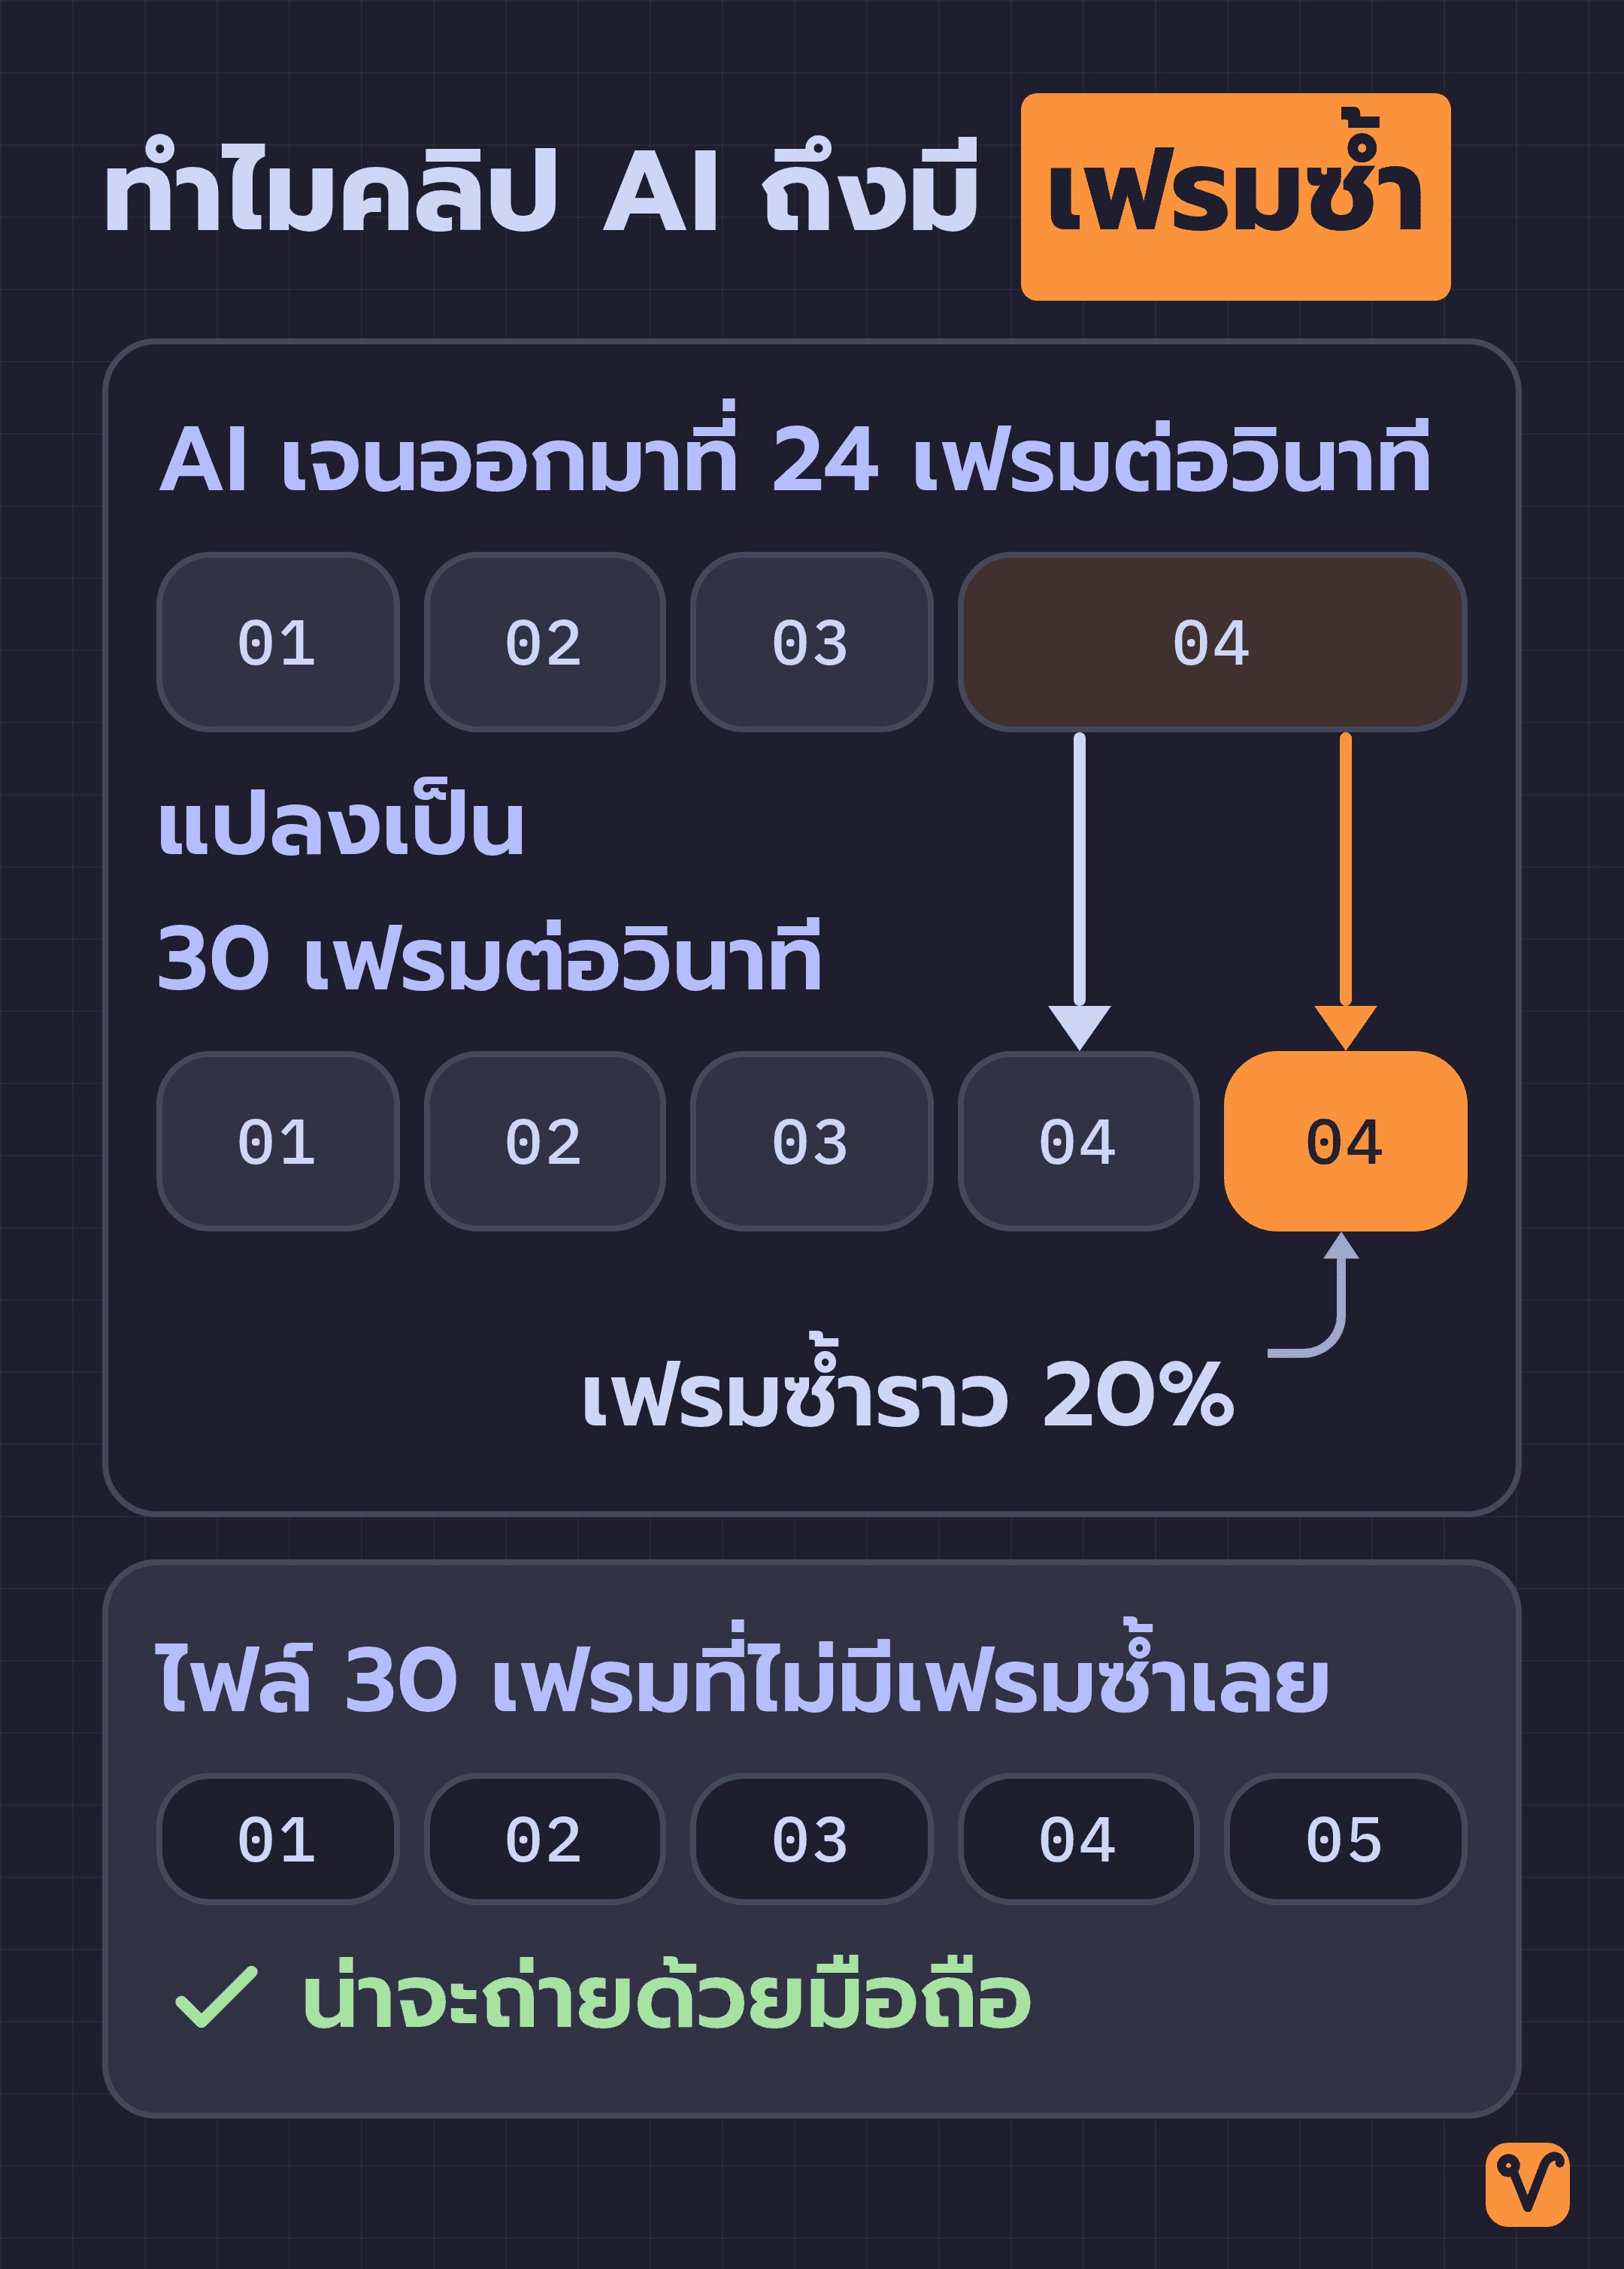
หลักฐานที่เห็นได้ชัดเจนที่สุดคือเรื่อง 'จังหวะเฟรม' โดยปกติโมเดล AI มักจะเจนวิดีโอออกมาที่ 24 เฟรมต่อวินาที เมื่อนำมาแปลงเป็น 30 เฟรมต่อวินาที จะเกิดเฟรมซ้ำขึ้นราว 20% ของวิดีโอ rea-video จึงตั้งกฎว่า ถ้าไฟล์ 30 เฟรมไม่มีเฟรมซ้ำเลย และมีสัดส่วนของช็อตที่ดูเหมือนถ่ายจริงเกิน 70% ขึ้นไป ระบบจะให้น้ำหนักว่าคลิปนี้น่าจะถ่ายทำด้วยมือถือโดยตรง
จุดที่ชวนพลาดคือเรื่อง Noise ในตอนแรก rea-video กำหนดว่าถ้าภาพเนียนกริบไม่มี Noise เลย นั่นคือสัญญาณของคลิป AI แต่ในความเป็นจริง เมื่อนำคลิปไปอัปโหลดขึ้นโซเชียลมีเดีย การบีบอัดไฟล์ของแพลตฟอร์มก็ทำให้ Noise ธรรมชาติหายไปได้เช่นกัน ปัจจุบันระบบจึงแก้ไขกฎว่า ถ้าตรวจพบแท็กว่าคลิปผ่านการบีบอัดไฟล์จากแพลตฟอร์มมา จะไม่นับภาพที่ไม่มี Noise เป็นหลักฐานว่าสร้างด้วย AI อีกต่อไป
หลังจากตัดสินครบทุกช็อตแล้ว ระบบจะวางแผนสร้างคลิปขึ้นมาใหม่ โดยจัดกลุ่มช็อตเข้าด้วยกันตามขีดจำกัดจริงของโมเดล AI แต่ละตัว เช่น โมเดลนั้นเจนได้ยาวสุดกี่วินาที สั่งเจนหลายช็อตพร้อมกันในรอบเดียวได้หรือไม่ และป้อนภาพอ้างอิงได้กี่ภาพ ซึ่งข้อมูล '8 ช็อตสั่งเจนแค่ 3 รอบ' ในคลิปตัวอย่างตอนต้น ก็มาจากการคำนวณในขั้นตอนนี้
ตัวอย่าง 2 คลิปที่ต้องให้ Agent ช่วยตัดสินซ้ำ
ในเอกสาร README ของ rea-video มีตัวอย่างรายงานการวิเคราะห์ทั้งหมด 6 คลิป ซึ่งมี 2 คลิปที่แสดงให้เห็นชัดเจนว่า ทำไมการมี Agent คอยเปิดดูภาพจริงซ้ำจึงเป็นเรื่องสำคัญ:
- คลิปแกะกล่องสินค้า ความยาว 72 วินาที: คลิปนี้ถ่ายทำจริงทั้งคลิป โดยวางมือถือถ่ายจากด้านบนลงมาบนพรมผืนเดียว ใช้กล้องมุมเดียวตลอด และไม่มีเสียงบรรยาย แต่เนื่องจากไฟล์นี้ผ่านการบีบอัดของแพลตฟอร์มมาแล้ว โหมดเครื่องมือล้วนแบบออฟไลน์จึงเข้าใจผิดว่ามีส่วนที่เป็น AI ถึง 35% ส่วนเมื่อให้ Agent ช่วยเปิดดูเฟรมภาพซ้ำ ผลการประเมินก็กลับมาถูกต้องว่าเป็นคลิปถ่ายจริงถึง 97%
- มิวสิควิดีโอ ความยาว 165 วินาที รวม 86 ช็อต: rea-video ตรวจพบว่าเพลงประกอบสร้างด้วย AI ซึ่งก็แต่งด้วย Suno จริงๆ ส่วนเรื่องภาพ Vision Model ซึ่งเป็นโมเดล AI สำหรับตรวจดูภาพ ตอนแรกมองว่าบางช็อตเป็นละครที่ใช้คนแสดงจริง ทว่า Agent สังเกตเห็นว่าตัวอักษรบนม้วนกระดาษในฉากดูคล้ายภาษาจีน แต่ไม่ใช่คำที่มีความหมายจริง ซึ่งเป็นความผิดพลาดเฉพาะตัวของ AI ทำให้ Agent แก้ผลตัดสินของช็อตเหล่านั้นเป็นคลิป AI ได้อย่างถูกต้อง
เจาะลึกคลิปขายของ: ถ่ายจริง 75% ผสม AI 25%
อีกหนึ่งตัวอย่างในรายงานคือคลิปขายของแนวตั้งความยาวประมาณ 58 วินาที ครีเอเตอร์พูดหน้ากล้อง และใช้กล้องถ่ายหน้าจอมือถือเครื่องจริงด้วยตัวเอง จากนั้นนำคลิปตัวเองพร้อมรูปสินค้า 2 รูปไปป้อนให้แอปเจนวิดีโออย่าง Jimeng สร้างฉากที่มีคนโชว์สินค้าขึ้นมา
รายงานฉบับเต็มแบ่งคลิปนี้ออกเป็น 21 ช็อต สรุปว่าเป็นช็อตถ่ายจริง 15 ช็อต (ถ่าย 2 ฉาก สลับ 4 มุมกล้อง) และเป็นช็อต AI อีก 6 ช็อต เมื่อคิดสัดส่วนตามเวลาจะเป็นถ่ายจริง 75% และ AI 25%
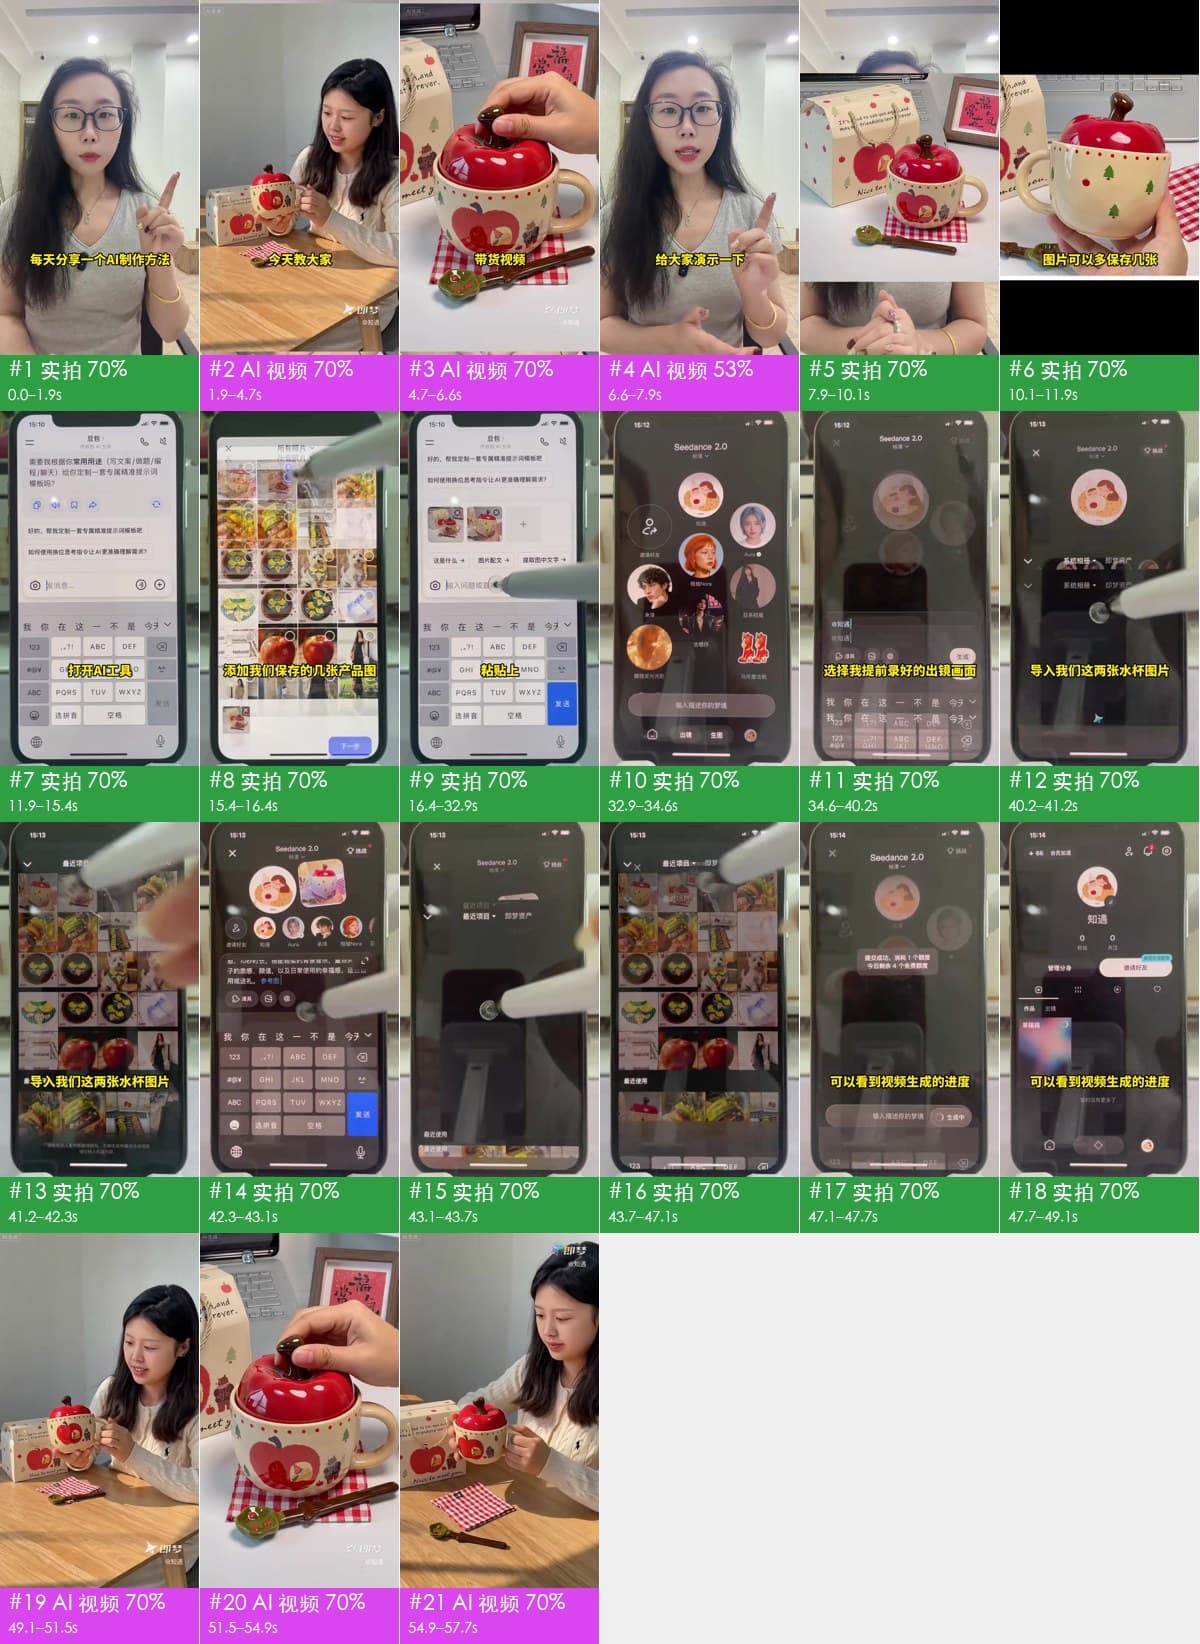
หลักฐานที่ชี้ชัดว่า 6 ช็อตนั้นเป็น AI ได้แก่ ป้ายข้อความ "AI生成" (สร้างด้วย AI) ที่มุมซ้ายบน, ลายน้ำของ Jimeng ที่มุมขวาล่าง และตัวหนังสือภาษาอังกฤษบนกล่องของขวัญ ซึ่งระบบอ่านข้อความจากภาพออกมาได้ว่า I+'s aod to see you agay พอดูออกว่าพยายามเขียนคำอวยพร แต่สะกดผิดเพี้ยนไปทั้งประโยค
ในแผนงานสร้างส่วนที่เป็น AI ขึ้นมาใหม่ ระบบแนะนำให้แยกการเจนทั้ง 6 ช็อตออกเป็น 6 ครั้งผ่านโมเดล Seedance 2.5 โดยในแต่ละรอบจะมีภาพอ้างอิงตัวละคร, คลิปช่วงเดิมสำหรับใช้เป็นต้นแบบการเคลื่อนไหว, พรอมต์สร้างภาพเฟรมแรก และพรอมต์วิดีโอทั้งภาษาจีนและอังกฤษ นอกจากนี้ยังมีคำแนะนำกำกับไว้ด้วย เช่น ช็อตที่ 2 แนะนำให้สั่งเจนยาว 4 วินาทีแล้วค่อยตัดทอนเหลือ 2.8 วินาที เพราะช็อตที่สั้นมากๆ ถ้าสั่งเจนเดี่ยวๆ ภาพมักจะไม่นิ่ง
ส่วนแผนงานสำหรับช็อตถ่ายจริง รายงานระบุให้ใช้แสงนุ่มที่ส่องมาจากทิศทางเดียวกับกล้อง พร้อมแนะนำวิธีจัดไฟแบบง่ายๆ เช่น นั่งหันหน้าเข้าหาหน้าต่าง, ใช้ไฟวงแหวน หรือตั้งโคมไฟ Softbox ขนาดใหญ่ไว้ด้านหลังกล้อง
ด้านเสียง รายงานบอกว่าเพลงประกอบมาจากคลังเพลง ความเร็วอยู่ที่ 114.8 BPM คีย์ F major มีจุดใส่เสียงเอฟเฟกต์ 31 จุด และมีซับไตเติลรวม 300 รายการ
อย่างไรก็ตาม ในภาพรวมทั้งคลิป รายงานประเมินระดับความมั่นใจไว้ที่ 70% แม้รอบนี้จะใช้ทั้งการตรวจไฟล์ ใช้ Gemini ช่วยดูภาพ และให้ Agent ช่วยตรวจเช็กครบทั้ง 21 ช็อตแล้วก็ตาม โดยในบรรทัดสรุปยังระบุไว้ชัดเจนว่า หลักฐานการแยกช็อตถ่ายจริงกับ AI ยังไม่พอ ต้องรอยืนยัน
rea-video แม่นแค่ไหน และใครเป็นคนทดสอบ
ตัวเลขความแม่นยำที่ระบุใน README คำนวณจากเปอร์เซ็นต์ที่ rea-video วิเคราะห์วิธีสร้างของแต่ละช็อตได้ถูกต้อง โดยถ่วงน้ำหนักตามความยาวของช็อต (ช็อตที่ยาวกว่าจะมีผลต่อคะแนนมากกว่าช็อตสั้น)
ผู้พัฒนาแบ่งชุดข้อมูลทดสอบออกเป็นหลายกลุ่ม ได้แก่ ชุดปรับจูนที่ใช้ตอนออกแบบและตั้งกฎ กับชุดทดสอบ Holdout ซึ่งกันไว้ใช้ทดสอบโดยไม่เคยนำมาตั้งกฎมาก่อน (แบ่งเป็นชุด 9 คลิป และ 7 คลิป) ส่วนคอลัมน์ขวาสุดคือคลิปที่ส่งผ่าน WeChat จนผ่านการบีบอัดไฟล์ซ้ำ
| ชุดปรับจูน (15 คลิป) | ชุด Holdout (9 / 7 คลิป) | คลิปบีบอัดซ้ำจาก WeChat (10 คลิป) | |
|---|---|---|---|
| เครื่องมือล้วน (ออฟไลน์ ฟรี) | 98.3% | 99.6% / 98.9% | 88.6% |
| เสริม Vision Model (Gemini) | - | 99.6% / 99.8% | 99.6% |
| เสริมให้ Agent ช่วยดูภาพ | - | 99.6% / 99.8% | 100% |
ผลการทดสอบชี้ว่า ถ้าเป็นไฟล์ต้นฉบับ แค่โหมดเครื่องมือล้วนที่ทำงานแบบออฟไลน์ก็แม่นยำเกิน 98% แล้ว แต่เมื่อเจอกับคลิปที่ผ่านการบีบอัดซ้ำ ความแม่นยำจะลดลงเหลือ 88.6% เพราะหลักฐานด้าน Noise หายไปกับการบีบอัดข้อมูล จึงต้องใช้ Vision Model หรือให้ Agent ช่วยดูภาพ ความแม่นยำถึงจะกลับขึ้นมาแตะ 99-100%
จุดที่อาจทำให้เข้าใจผิดได้ง่ายคือ ระดับความมั่นใจ 70% ในรายงานคลิปขายของกับตัวเลขความแม่นยำ 98-99% ในตารางนี้เป็นคนละเรื่องกัน โดย 70% คือความมั่นใจที่ระบบประเมินให้เฉพาะคลิปนั้น ส่วนตัวเลขในตารางคือสถิติที่ผู้พัฒนาทดสอบย้อนหลังกับชุดคลิปที่รู้เฉลยอยู่แล้ว
ทั้งนี้ ก่อนจะเชื่อตัวเลขความแม่นยำในตาราง ผู้พัฒนาได้บันทึกข้อจำกัดสำคัญไว้ใน eval/RESULTS.md ซึ่งเราควรรู้ไว้ก่อน:
- ทดสอบเองกับคลิปจำนวนน้อย: ผู้พัฒนาเป็นคนทดสอบเองทั้งหมด และคลิปแต่ละชุดมีจำนวนไม่เกิน 15 คลิป
- ชุดทดสอบ Holdout ชุดแรกไม่ได้เป็นอิสระจริง: ในชุด 9 คลิป ระบบวิเคราะห์พลาดไป 2 จุดในการรันครั้งแรก ผู้พัฒนาจึงนำจุดที่พลาดไปใช้เพิ่มกฎเรื่องเฟรมเรต ส่วนชุด 7 คลิปคือชุดที่นำมารันหลังจากปรับกฎจนลงตัวแล้ว
- ชุดคลิปจาก WeChat เป็นชุดที่ใช้ปรับปรุงระบบ: ผู้พัฒนาปรับแก้กฎหลังจากได้ดูคลิปชุดนี้ไปแล้ว
- การวิเคราะห์เสียงยังไม่แม่นยำ: ในโหมดเครื่องมือล้วน เสียงที่ระบบชี้ว่าเป็นเสียงเอฟเฟกต์ มีที่ถูกจริงเพียงประมาณ 1 ใน 5 เท่านั้น ส่วนที่มาของเพลงตอบถูก 2 ใน 5 และระบบยังแยกเพลงที่ AI เจนออกจากเพลงในคลังด้วยสัญญาณเสียงไม่ได้
- มีคลิปถ่ายจริงในชุดทดสอบเพียง 3 คลิป: ทั้งหมดเป็นคลิปที่ถ่ายด้วยมือถือ 60 เฟรมจาก Douyin หรือ TikTok เวอร์ชันจีน
เริ่มใช้งาน rea-video ด้วยคำสั่งเดียวใน Claude Code
สิ่งที่ต้องเตรียมไว้ในเครื่องมี 3 อย่าง:
- Coding Agent ที่รันคำสั่ง Terminal ได้: เช่น Claude Code หรือ Codex
- ffmpeg: โปรแกรมจัดการไฟล์วิดีโอและเสียงผ่านคำสั่ง
- Python เวอร์ชัน 3.10 ขึ้นไป
เมื่อพร้อมแล้ว ให้สั่งงาน Agent ด้วยข้อความนี้เพียงประโยคเดียว (โดยเปลี่ยนพาธท้ายประโยคให้เป็นที่อยู่ไฟล์วิดีโอในเครื่องของเรา):
Install https://github.com/JuneYaooo/rea-video, then break down this video: /path/to/video.mp4
ตัว Agent จะติดตั้งเครื่องมือ ศึกษาคู่มือการใช้งาน และลงมือแกะโครงสร้างคลิปให้จนเสร็จเรียบร้อย โดยสิ่งที่เราจะได้กลับมามี 3 อย่าง:
- สรุปสั้นๆ บรรทัดเดียว: เช่น
41% AI video + 59% code UI, 8 s of real screen recording, library music at 122 BPMซึ่งบอกทันทีว่าคลิปนี้ประกอบด้วยวิดีโอ AI 41%, ส่วนกราฟิก UI จากโค้ด 59%, มีภาพอัดหน้าจอจริง 8 วินาที และใช้เพลงจากคลังเพลงที่จังหวะ 122 BPM - แผนงานสร้างซ้ำ: จัดกลุ่มงานออกเป็น 3 ส่วนชัดเจน คือ ส่วนที่ต้องถ่ายเอง, ส่วนที่ต้องสั่ง AI เจน และส่วนที่ต้องเขียนโค้ด
- ไฟล์รายงาน report.html: แสดงภาพนิ่งของทุกช็อตอย่างละเอียด พร้อมหลักฐานการวิเคราะห์, พรอมต์ที่แกะได้, โน้ตกำกับมุมกล้องและการจัดแสง รวมถึงข้อมูลการแยกแทร็กเสียง
หากต้องการติดตั้งด้วยตัวเองทีละขั้นตอน ใน README มีชุดคำสั่งไว้ดังนี้:
brew install ffmpeg
git clone https://github.com/JuneYaooo/rea-video && cd rea-video
bash scripts/install_skill.sh
rea-video --help(ถ้าเป็น Linux ที่ใช้ apt ให้เปลี่ยนคำสั่งบรรทัดแรกเป็น sudo apt install ffmpeg) สคริปต์ install_skill.sh จะติดตั้งตัวโปรแกรม พร้อมผูก Skill หรือคู่มือการใช้งานเข้ากับโฟลเดอร์ของ Claude Code, Codex และ Agent อื่นๆ โดยอัตโนมัติ
สิ่งที่ต้องพิจารณาต่อคือ จำเป็นต้องเพิ่ม Vision Model หรือไม่? ถ้าใช้โหมดเครื่องมือล้วน ตัวโปรแกรมจะทำงานแบบออฟไลน์และฟรีทั้งหมด ซึ่งแม่นยำเพียงพออยู่แล้วสำหรับไฟล์ต้นฉบับที่ไม่ได้ผ่านการบีบอัด
แต่ถ้าต้องวิเคราะห์คลิปที่ดาวน์โหลดมาจากแพลตฟอร์มโซเชียลมีเดีย แนะนำให้เชื่อมต่อ Vision Model อย่าง Gemini หรือ Doubao เพิ่มเติม โดยระบุ API Endpoint และ API Key ให้กับ Agent ซึ่งจะมีค่าใช้จ่ายตามอัตราให้บริการของโมเดลนั้น สิ่งที่ได้เพิ่มคือความแม่นยำในการแยกแยะคลิปถ่ายจริง, วิดีโอ AI หรือแอนิเมชัน 3D รวมถึงได้พรอมต์ที่ถอดออกมาครบทุกช็อต แต่ถ้าไม่ได้เชื่อมต่อไว้ แล้ว Agent ของเราเปิดดูภาพได้ ก็จะช่วยเปิดดูภาพช็อตที่ไม่มั่นใจให้เอง
ถ้าไม่มีทั้งสองอย่างและนำไปใช้กับคลิปจากแพลตฟอร์ม ผลลัพธ์ก็อาจคลาดเคลื่อนเหมือนกรณีคลิปแกะกล่องข้างต้น ที่ระบบตัดสินว่าคลิปถ่ายจริงทั้งเรื่องเป็น AI ไปถึง 35%
ด้วยเหตุนี้ คลิปตัวอย่างในโฟลเดอร์ docs/cases/videos/ ของโปรเจกต์เอง ก็ผ่านการบีบอัดเพื่อลดขนาดไฟล์จนแท็กของ TikTok และ Douyin หายไป ถ้านำมารันทดสอบเองโดยไม่เปิดใช้ Vision Model ผลการวิเคราะห์จึงอาจไม่ตรงกับรายงานตัวอย่าง
ทั้งนี้ ตัวรายงานหลักเลือกส่งออกเป็นภาษาอังกฤษหรือภาษาจีนได้ ส่วนเอกสารคู่มือของโปรเจกต์ปัจจุบันยังเป็นภาษาจีน แต่เราสั่งให้ Agent ช่วยอ่านทำความเข้าใจและสรุปรายงานเป็นภาษาไทยได้ทันที
ขั้นตอนนำรายงานไปสร้างคลิปใหม่ของตัวเอง
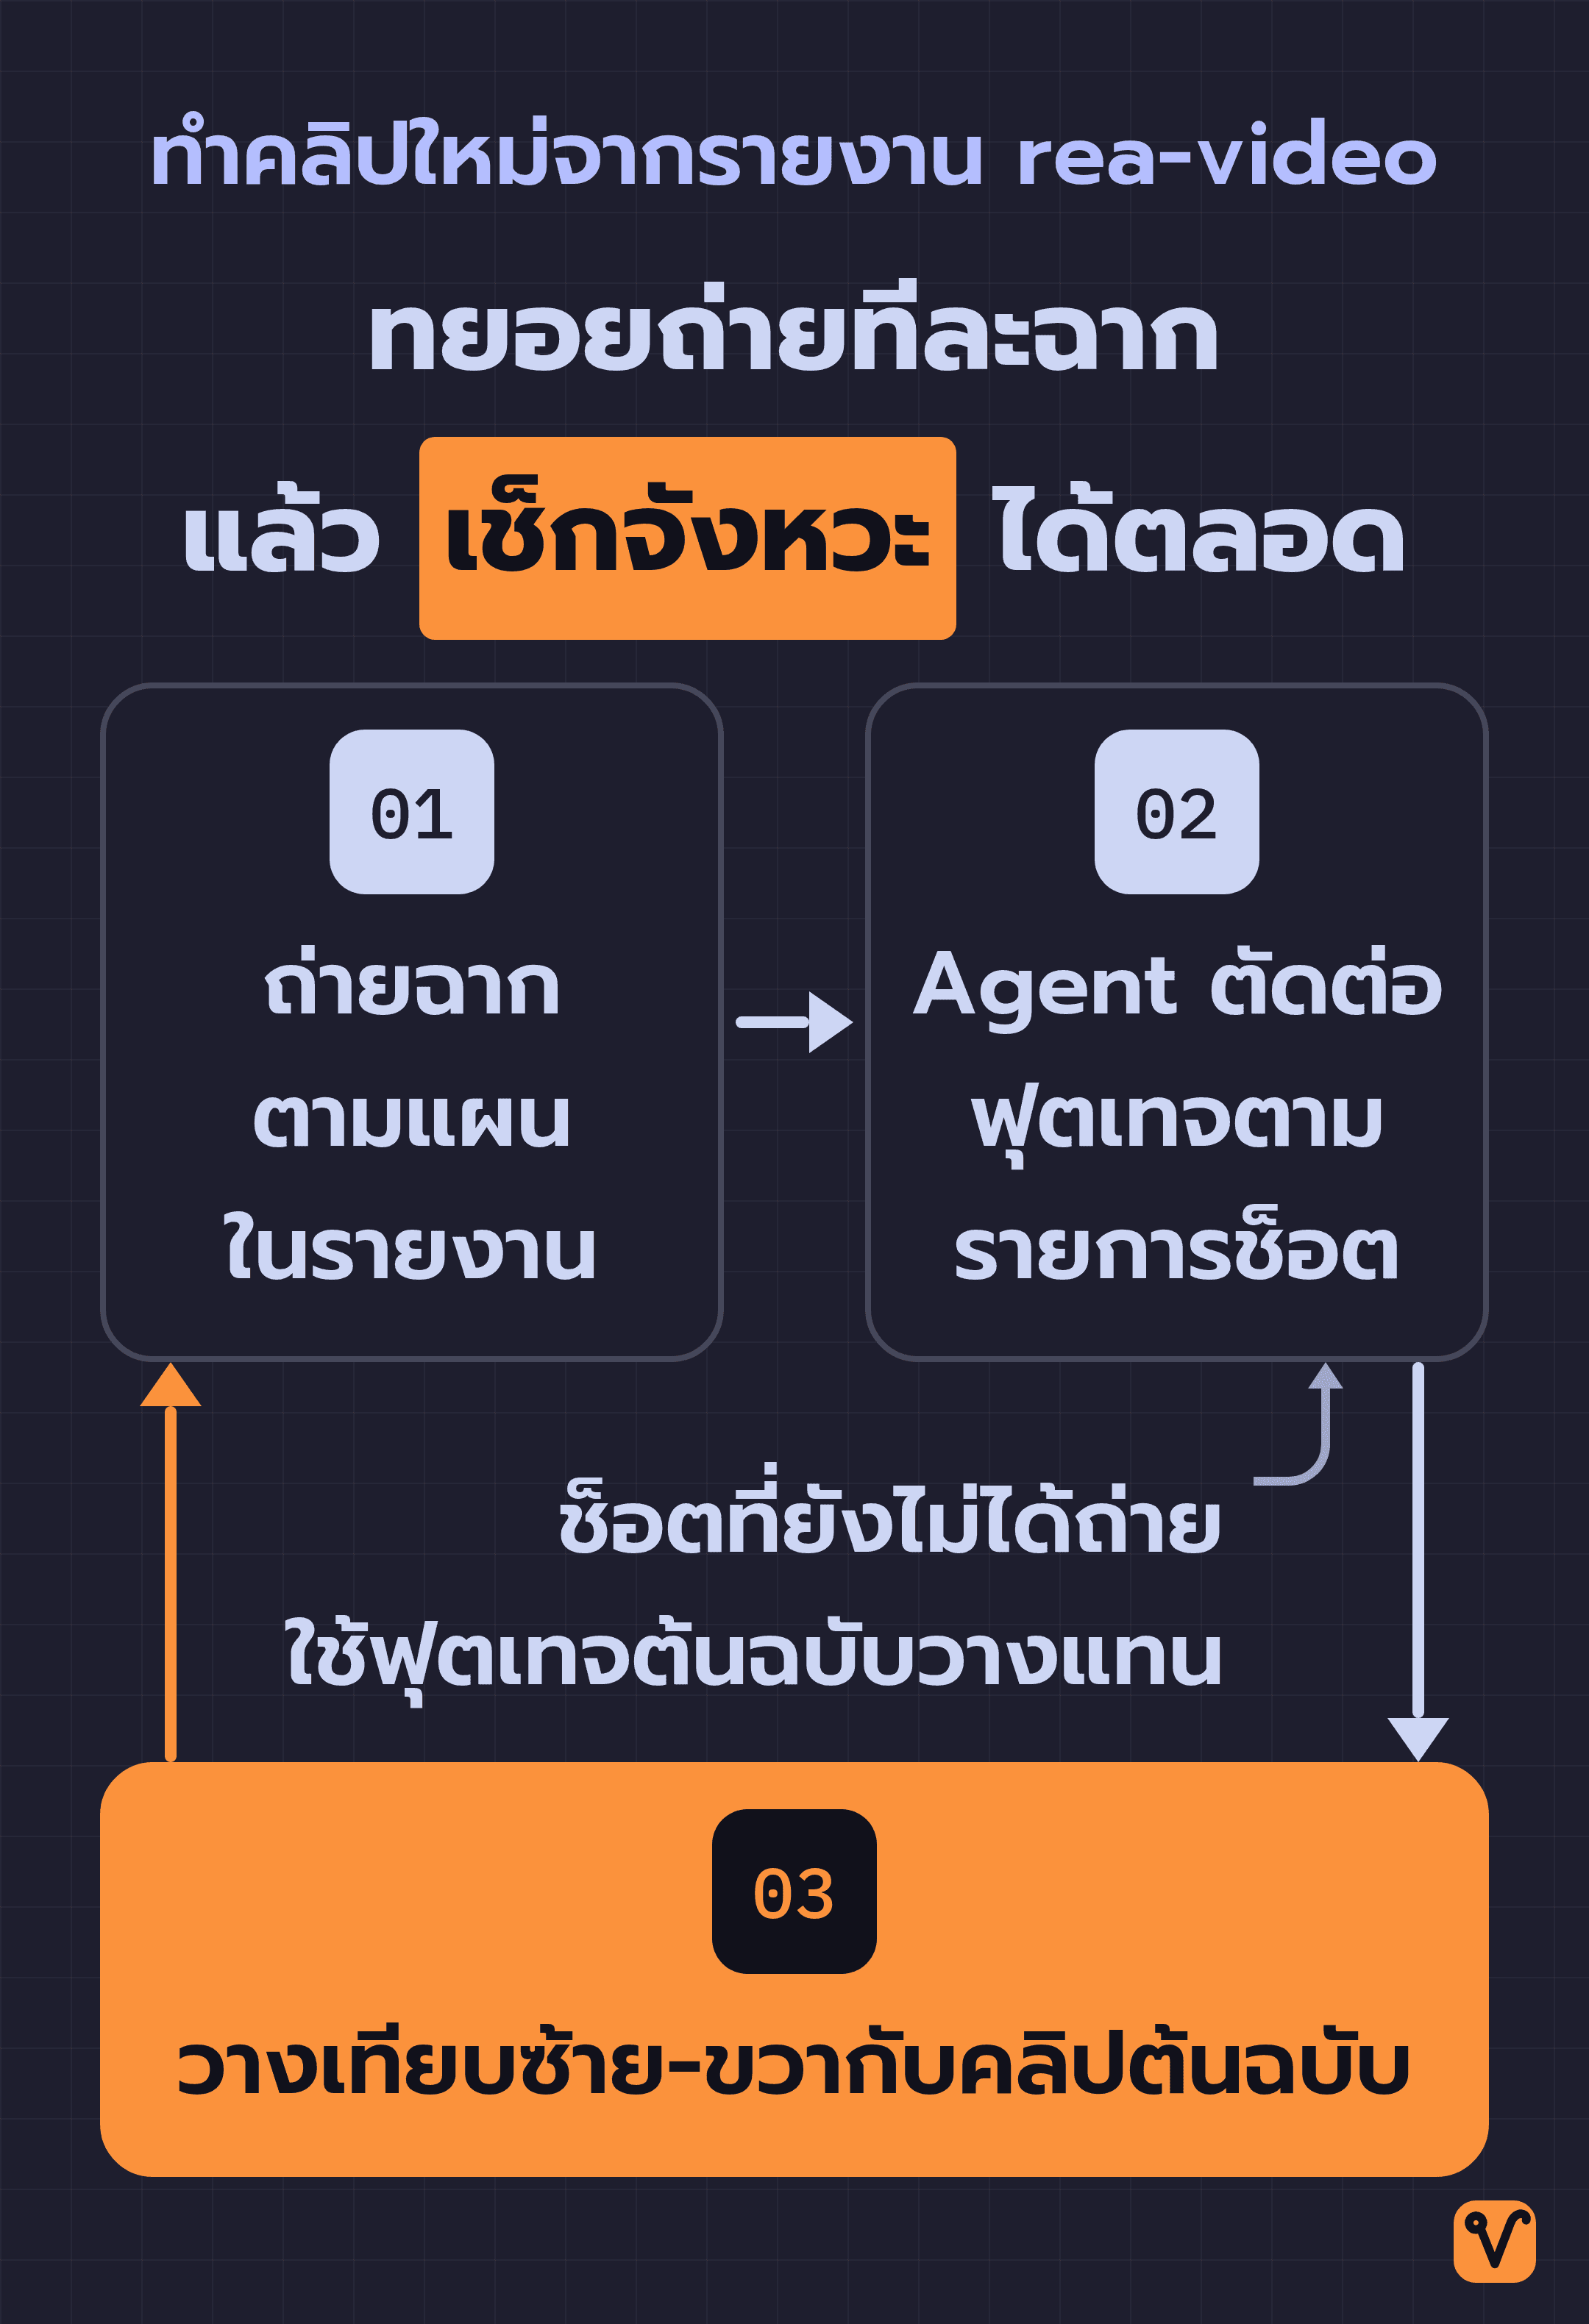
ในวิดีโอคลิปหนึ่งมักมีช็อตหลายประเภทรวมกัน ซึ่งแต่ละประเภทมีขั้นตอนการผลิตแตกต่างกัน เอกสาร docs/replicate.md จึงแนะนำให้แยกทำทีละประเภท แล้วค่อยให้ Agent ช่วยประกอบกลับเข้าด้วยกันตามไทม์ไลน์เดิม:
ช็อตถ่ายจริง ลงมือถ่ายทำตามแผน: รายงานจะสรุปให้เสร็จสรรพว่าคลิปนี้มีกี่ฉาก แต่ละฉากต้องตั้งกล้องกี่มุม ควรถ่ายมุมไหนก่อน ใช้ขนาดภาพแบบไหน (ถือกล้องถ่ายหรือใช้ขาตั้ง) ทิศทางแสงหลักมาจากทางไหน ต้องใช้ไฟเสริมหรือไม่ และต้องใช้อุปกรณ์อะไรบ้าง โดยช็อตที่ใช้ฉากเดียวกัน รายงานจะจัดกลุ่มให้ถ่ายรวดเดียวจบ แม้ในคลิปจริงช็อตเหล่านั้นจะอยู่คนละช่วงกันก็ตาม
เมื่อถ่ายเสร็จแล้ว ให้ส่งไฟล์ฟุตเทจให้ Agent พร้อมสั่งว่า "ตัดฟุตเทจที่ถ่ายมาลงตามรายการช็อต" ตัว Agent จะตัดคลิปให้ตรงตามตำแหน่งและความยาวของแต่ละช็อต ประกอบกลับลงไทม์ไลน์ และทำคลิปเปรียบเทียบซ้าย-ขวาคู่กับต้นฉบับให้ทันที ส่วนช็อตไหนที่ยังไม่ได้ถ่าย ระบบจะใช้ฟุตเทจต้นฉบับวางแทนไว้ก่อน ทำให้เราทยอยถ่ายทีละฉากแล้วเช็กจังหวะได้ตลอดเวลา
ช็อต AI สั่งเจนตามรอบที่แนะนำ: รายงานจะรวมช็อตต่อเนื่องที่อยู่ในฉากเดียวกันให้สั่งเจนในรอบเดียว พร้อมระบุชื่อโมเดลที่แนะนำ, ภาพอ้างอิงที่ต้องเตรียม (เช่น ภาพคนหรือสินค้า), ชุดพรอมต์แบบหลายช็อตทั้งภาษาจีนและอังกฤษ รวมถึงวิธีเชื่อมฉากให้ต่อเนื่องจากรอบก่อนหน้า
การลงมือทำมี 2 ทางเลือก:
- ทำด้วยตัวเอง: นำพรอมต์และภาพอ้างอิงไปป้อนในแพลตฟอร์มอย่าง Jimeng หรือ Kling จากนั้นส่งคลิปที่ได้ให้ Agent นำไปวางลงไทม์ไลน์
- ทำแบบอัตโนมัติ: ใช้เครื่องมือเสริมชื่อ capsule-cinema ที่ต่อ API เรียกโมเดลเจนวิดีโอและวางคลิปลงไทม์ไลน์ให้อัตโนมัติ เพียงสั่ง Agent ว่า "ใช้ capsule-cinema ทำช็อต AI ใหม่" ตัวระบบจะซ้อมรันให้ดูก่อนฟรีหนึ่งรอบ เมื่อเรากดยืนยันจึงจะเริ่มเรียกโมเดลจริงที่เสียค่าบริการ
ข้อสังเกตคือ ระบบอัตโนมัติในปัจจุบันยังเป็นการสั่งเจนทีละช็อต ขณะที่การนำชุดพรอมต์ไปสั่งเจนหลายช็อตด้วยตัวเอง จะช่วยประหยัดโควตาและต้นทุนค่าเจนได้มากกว่า
ช็อตข้อความและ UI ให้ Agent ช่วยเขียนโค้ด: รายงานจะให้ข้อมูลทั้งข้อความ เลย์เอาต์ และจังหวะการเคลื่อนไหวของแต่ละช่วง งานส่วนนี้นำไปสร้างต่อได้ด้วย Remotion โดยสั่ง Agent ว่า "เขียนโปรเจกต์ Remotion ตามรายงาน" ข้อดีคือถ้าภายหลังต้องการแก้ข้อความ ก็แก้เพียงแค่ไฟล์ข้อมูลโดยไม่ต้องรื้อโค้ดใหม่ทั้งหมด
ตัว rea-video ไม่ได้สร้างโปรเจกต์โค้ดนี้ให้โดยตรง แต่เป็นตัว Agent ที่เขียนขึ้นมาตามรายงาน สำหรับใครที่อยากเห็นตัวอย่างว่า Agent ทำคลิปบน Remotion ได้ละเอียดแค่ไหน ดูเพิ่มเติมได้ที่บทความ video-shotcraft ที่ให้ Claude Code ทำคลิปโปรโมตสินค้า
ช็อตเสียง แยกทำ 3 แทร็ก: เสียงบรรยายมีสคริปต์ถอดไว้ให้ในรายงาน จะเลือกอัดเสียงตัวเองหรือใช้ระบบสังเคราะห์เสียงพูดก็ได้ ส่วนเพลงประกอบหาได้จากคลังเพลงตามค่า BPM, คีย์ และแนวเพลงที่ระบุ หรือจะสั่งเจนใหม่ด้วย Suno ก็ได้เช่นกัน จากนั้นค่อยวางเสียงเอฟเฟกต์ตามตารางเวลาที่บันทึกไว้ในรายงาน
เปรียบเทียบ rea-video กับ Hypit: เลือกใช้ตัวไหนดี
Hypit เป็นเครื่องมือที่เน้นป้อนคลิปต้นแบบแล้วโคลนออกมาเป็นคลิปใหม่ให้ทันที โดย Agent ของ Hypit จะแคปเฟรมภาพมาวิเคราะห์ แล้วสั่งโมเดลเจนวิดีโอ (เช่น Seedance, PixVerse, MiniMax หรือ Wan) สร้างฟุตเทจใหม่ขึ้นมาแทนที่ พร้อมเรนเดอร์ซับไตเติลและโมชันกราฟิกด้วย HTML
อย่างไรก็ตาม Hypit ไม่ได้ลงลึกว่าคลิปต้นฉบับผลิตขึ้นมาอย่างไร แม้ต้นฉบับจะเป็นคลิปถ่ายจริง ระบบก็ยังพยายามนำไปแปลงเป็นวิดีโอ AI ทำให้ไม่มีข้อมูลเรื่องการตั้งมุมกล้องหรือการจัดไฟ ในเอกสาร README ของ rea-video จึงเปรียบเทียบไว้ว่า Hypit จะเหมาะมากกับคลิปแนวพูดตามบท เช่น พอดแคสต์หรือคลิปสัมภาษณ์ แต่จะไม่เหมาะกับคลิปที่ต้องตัดต่อตรงตามจังหวะเพลง, คลิปโชว์กราฟิกสินค้า หรือคลิปสั้นแนวภาพยนตร์
ข้อสรุปง่ายๆ คือ ถ้าต้องการสร้างคลิปที่คล้ายกันออกมาอย่างรวดเร็ว ให้เลือกใช้ Hypit แต่ถ้าต้องการถอดรหัสว่าคลิปต้นฉบับผลิตขึ้นมาอย่างไร เพื่อนำมาวางแผนทำซ้ำอย่างประหยัดและถูกต้อง ให้เลือกใช้ rea-video (และนำทั้งสองตัวมาใช้งานร่วมกันได้) ใครที่สนใจรายละเอียดของ Hypit อ่านต่อได้ที่ บทความ Hypit แกะโครงคลิปไวรัล
นำคลิปของคนอื่นมาทำซ้ำได้หรือไม่
คำถามนี้ระบุไว้ชัดเจนในหมวดคำถามที่พบบ่อยของ README ซึ่งผู้พัฒนาตอบสั้นๆ ทันทีว่า "No." (ไม่ได้) พร้อมอธิบายว่า จุดประสงค์ของ rea-video คือการถอดรหัสเพื่อเรียนรู้โครงเรื่อง จังหวะการตัดต่อ และเทคนิคการถ่ายทำ เพื่อให้เรานำไอเดียเหล่านั้นไปสร้างสรรค์ผลงานชิ้นใหม่ด้วยทรัพยากรที่เรามีสิทธิ์ใช้งานอย่างถูกต้อง
เอกสารเน้นย้ำว่า ห้ามนำฟุตเทจเดิม, เพลง, ตัวละคร หรือใบหน้าของบุคคลอื่นมาใช้ซ้ำ และต้องปฏิบัติตามกฎของแต่ละแพลตฟอร์ม รวมถึงข้อกำหนดเรื่องการติดป้ายระบุเนื้อหา AI ในพื้นที่ที่เรานำไปเผยแพร่
นอกจากนี้ เราขอแนะนำเพิ่มเติมว่า อย่าใช้ผลการวิเคราะห์จาก rea-video ไปกล่าวหาใครว่าใช้ AI สร้างผลงาน เพราะรายงานของเครื่องมือนี้เป็นการ 'ประเมินจากหลักฐานทางเทคนิค' ไม่ใช่คำตัดสินเด็ดขาด แม้แต่ในรายงานคลิปขายของตัวอย่างข้างต้น ตัวรายงานเองก็ยังเขียนไว้ว่าหลักฐานยังไม่พอ ต้องรอยืนยัน
เริ่มต้นทดลองจากคลิปที่เรามีเฉลยอยู่แล้ว
วิธีเริ่มต้นทดลองใช้งาน rea-video ให้เห็นภาพและได้ประโยชน์ที่สุด คือการนำคลิปของตัวเราเองมาทดสอบ โดยใช้ไฟล์ต้นฉบับที่ยังไม่ผ่านการบีบอัดของแพลตฟอร์มใดๆ เพราะโหมดใช้งานฟรีแบบออฟไลน์อ่านไฟล์ประเภทนี้ได้แม่นยำสูง
เนื่องจากเราเป็นคนที่รู้เบื้องหลังการถ่ายทำดีที่สุดว่า คลิปนั้นถ่ายทำกี่ฉาก ตั้งกล้องกี่มุม และมีช็อตไหนที่ใช้ AI เจนขึ้นมาบ้าง เมื่อระบบประมวลผลรายงานออกมา เราจะเทียบได้ทันทีว่าผลวิเคราะห์ตรงกับที่เราทำจริงแค่ไหน ก่อนจะนำเครื่องมือนี้ไปใช้แกะคลิปอ้างอิงที่เราอยากเรียนรู้
เพราะเครื่องมือที่วิเคราะห์คลิปที่เราทำเองได้อย่างถูกต้อง คือเครื่องมือที่เราจะมั่นใจได้มากที่สุดเมื่อต้องนำไปใช้วิเคราะห์ผลงานของคนอื่น
ที่มา:
- โปรเจกต์ rea-video บน GitHub
- เอกสารทางการของ rea-video eval results (eval/RESULTS.md)
- เอกสารทางการของ rea-video: remaking a video from the report (docs/replicate.md)
- เอกสารทางการของ rea-video sample report: ai_daihuo (report_en.md)
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
สร้าง Claude Skill แบบไม่ต้องรู้โค้ด คู่มือสร้าง Claude Skill ของคุณเองด้วยการคุยกับ Claude Code เป็นภาษาไทย
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ