ก่อนจ่ายเงินซื้อการ์ดจอหรือ Mac มารัน AI เอง เปิด Llmspeed เว็บจำลองความเร็วที่ชี้ว่าบน Mac mini เครื่องเดียวกัน โมเดลขนาดใกล้กันอาจเร็วต่างกันถึง 7 เท่า
Llmspeed ให้เลือกการ์ดจอหรือ Mac คู่กับโมเดล AI แล้วจำลองให้เห็นว่าตอบได้เร็วแค่ไหนก่อนซื้อ ตัวเลขบนเว็บยังชี้ว่าการเลือกโมเดลสำคัญไม่แพ้การเลือกเครื่อง
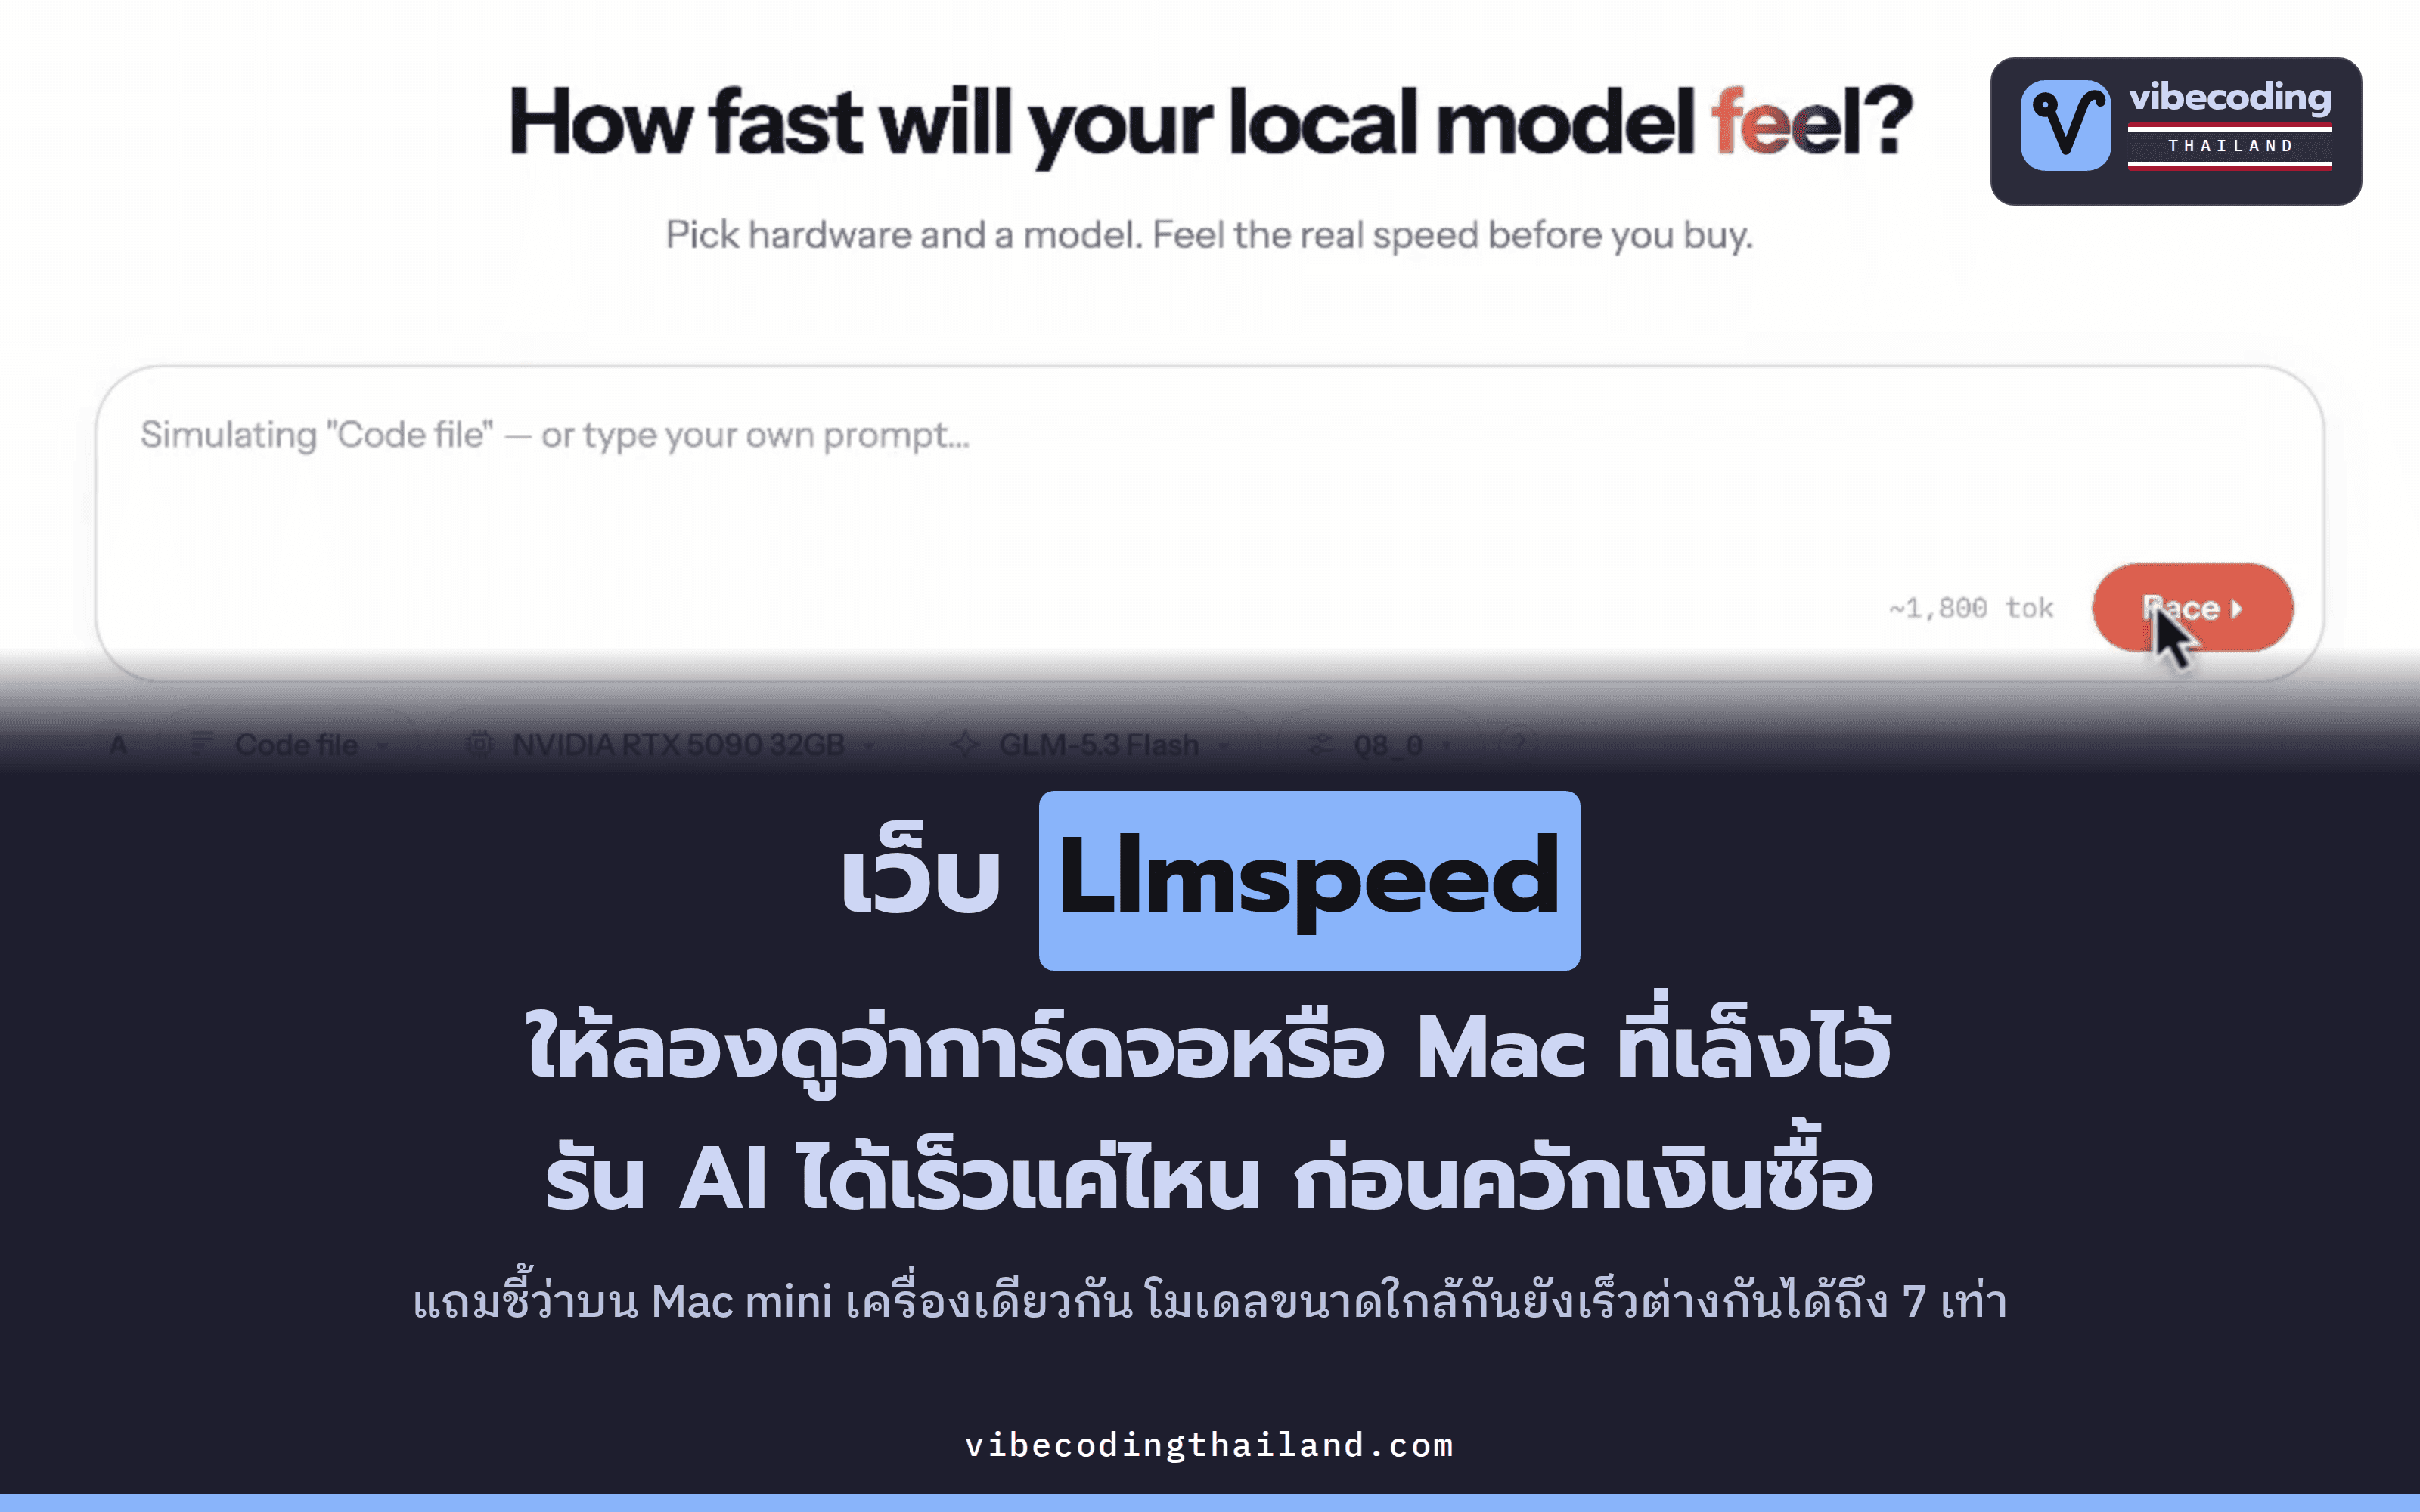
ถ้าคุณกำลังจะซื้อการ์ดจอหรือ Mac เพื่อนำมารัน AI ในเครื่องตัวเอง ลองแวะดูเว็บ Llmspeed ก่อนตัดสินใจจ่ายเงิน เว็บนี้สร้างขึ้นเพื่อจำลองความเร็วในการรัน AI บนฮาร์ดแวร์แต่ละรุ่นให้เห็นภาพชัดๆ
ปกติหน้าสเปกของเครื่องจะบอกแค่ว่ามีหน่วยความจำกี่ GB หรือมีอัตราความเร็วในการดึงข้อมูลออกจากหน่วยความจำอย่างแบนด์วิดท์กี่ GB/s แต่ไม่มีบรรทัดไหนบอกว่าพอพิมพ์ถามไปแล้วจะต้องนั่งรอกี่วินาที หรือคำตอบจะทยอยพิมพ์ออกมาเร็วแค่ไหน ซึ่ง Llmspeed เข้ามาช่วยตอบคำถามตรงนี้ได้ทันที แค่เลือกเครื่อง เลือกโมเดล แล้วระบบจะจำลองให้เห็นคำตอบพิมพ์ออกมาบนหน้าจอด้วยความเร็วที่ประเมินไว้ รวมถึงจำลองระยะเวลาที่หน้าจอนิ่งรอก่อนที่คำแรกจะโผล่ขึ้นมาด้วย
เว็บนี้เป็นโปรเจกต์โอเพนซอร์สของ Albin Östman ที่เปิดซอร์สโค้ดไว้บน GitHub ภายใต้สัญญาอนุญาตแบบ MIT ซึ่งเปิดให้ทุกคนนำไปใช้งานหรือแก้ไขต่อยอดได้ฟรี
ประโยชน์ของเว็บนี้ไม่ได้มีแค่การเปรียบเทียบสเปกเครื่องเท่านั้น แต่ตัวเลขบนเว็บยังชี้ให้เห็นชัดเจนว่า การเลือกโมเดลสำคัญไม่แพ้การเลือกเครื่องเลย
Llmspeed ให้ดูคำตอบไหลก่อนตัดสินใจซื้อเครื่อง
วิธีใช้งานบนหน้าเว็บมีเพียง 3 ขั้นตอนง่ายๆ คือ เลือกฮาร์ดแวร์ ทั้งการ์ดจอ Mac หรือ CPU เลือกโมเดลที่ต้องการ แล้วกด Run จากนั้นหน้าเว็บจะจำลองการรอคำแรกตามความยาวของพรอมต์ หรือข้อความคำถามที่เราป้อนเข้าไป แล้วทยอยพิมพ์คำตอบออกมาทีละคำตามความเร็วที่ประเมินไว้
ข้างๆ ช่องเลือกโมเดล จะมีตัวเลือก quantization หรือระดับการบีบอัดโมเดลให้มีขนาดไฟล์เล็กลง ยิ่งบีบอัดมาก ตัวโมเดลก็จะยิ่งกินหน่วยความจำน้อยลงและรันได้เร็วขึ้น แต่ก็แลกกับคุณภาพของคำตอบที่อาจลดลงไปบ้าง โดยระดับที่พบได้บ่อยที่สุดบนเว็บคือ Q4_K_M
ใต้ช่องจำลองข้อความ จะมีตัวเลขสำคัญ 2 ค่าที่ควรอ่านให้เป็น:
- token ต่อวินาที หรือ tok/s คือความเร็วในการสร้างคำตอบโดยนับจาก token ซึ่งเป็นชิ้นส่วนคำย่อยๆ ที่โมเดลทยอยพิมพ์ออกมาทีละคำ
- เวลารอคำแรก คือช่วงเวลาที่หน้าจอนิ่งไปหลังจากเรากดส่งคำถาม ก่อนที่คำแรกจะเริ่มโผล่ขึ้นมาบนจอ
ถ้าดูแค่ตัวเลข tok/s ในตารางสเปก เราอาจจะนึกภาพไม่ออกว่าเร็วหรือช้าแค่ไหน แต่พอได้เห็นข้อความค่อยๆ พิมพ์ออกมาบนหน้าจอจริงๆ จะรู้ได้ทันทีว่าความเร็วระดับนั้นเราทนรอไหวหรือไม่
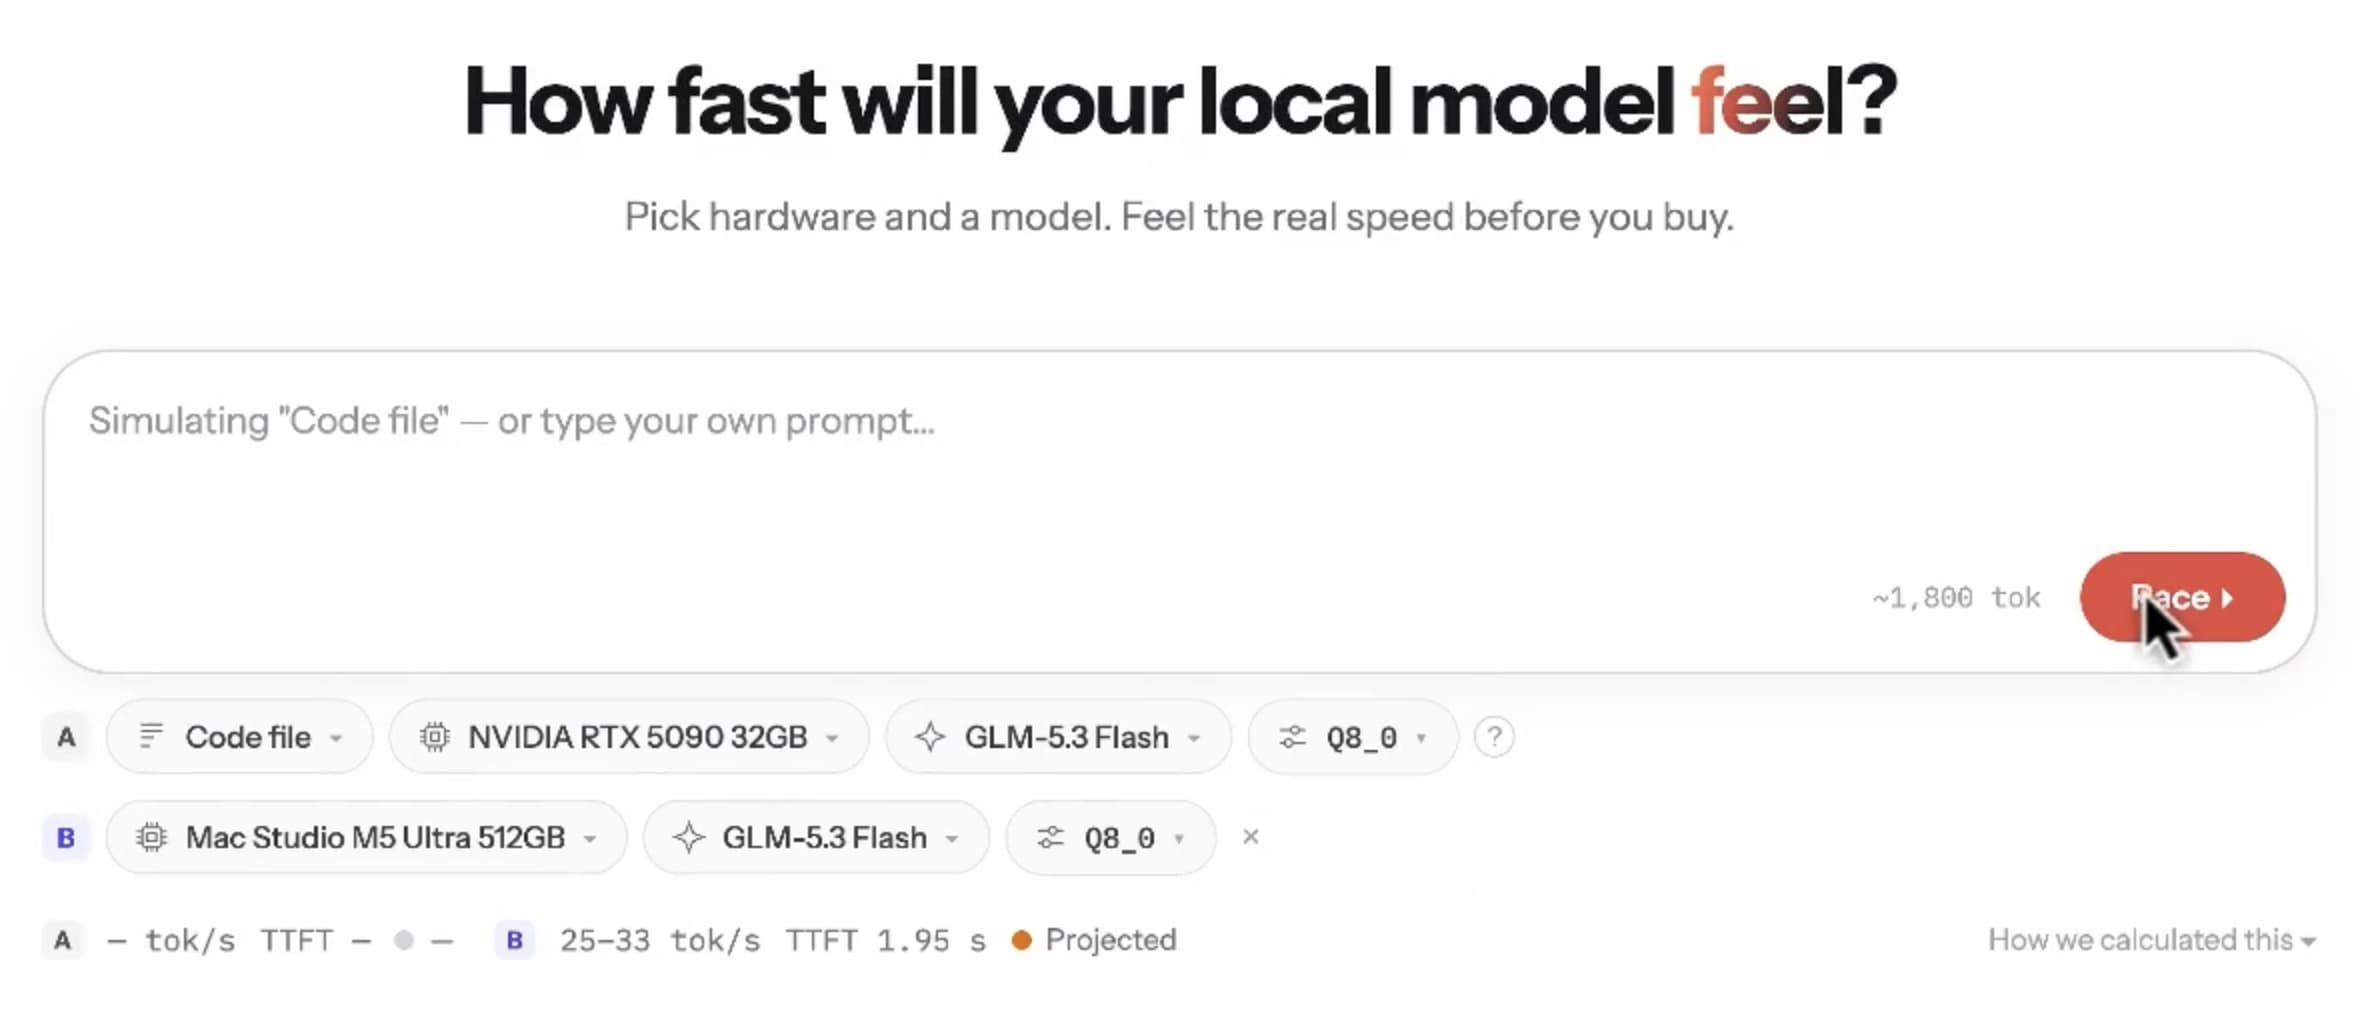
ถ้าคุณกำลังลังเลระหว่างสองเครื่อง ปุ่ม + Race a config จะเปิดโหมด Race เพื่อนำอีกเครื่องมาวางเปรียบเทียบข้างกัน แล้วสั่งให้ทั้งสองฝั่งพิมพ์คำตอบแข่งกันได้ ใน README บน GitHub มีตัวอย่างการจับคู่แข่งระหว่าง RTX 5090 กับ Mac Studio M5 Ultra 512GB บนโมเดล GLM-5.3 Flash ซึ่งผลลัพธ์คือฝั่ง RTX 5090 โหลดโมเดลไม่ขึ้นเลย
อีกเรื่องที่เว็บบอกให้รู้ทันที คือโมเดลนั้นจุลงเครื่องได้หรือไม่ โดยแบ่งสถานะตามระดับ quantization ออกเป็น 3 แบบ:
- Fits จุลงเครื่องได้ทั้งตัว โมเดลอยู่ในหน่วยความจำของการ์ดจอหรือ Mac ได้ครบทั้งหมด
- Partial offload จุได้ไม่หมด ต้องแบ่งบางส่วนไปฝากไว้ในแรมของเครื่อง แม้จะยังรันได้ แต่ส่วนที่ล้นไปแรมเครื่องจะทำงานช้าลงมาก
- Won't run รันไม่ได้เลยบนเครื่องนั้น เพราะหน่วยความจำไม่เพียงพอ
ข้อมูลทั้งหมดนี้ครอบคลุมการ์ดจอ Mac และ CPU รวม 30 รายการ พร้อมโมเดลยอดนิยมอีก 15 ตัว ถ้าเราตั้งค่าสเปกหรือจับคู่แข่งรุ่นไหนไว้ ก็คัดลอกลิงก์ส่งต่อให้คนอื่นเปิดดูผลลัพธ์แบบเดียวกันได้ทันที
เทียบความเร็ว 3 เครื่องต่างระดับบน Gemma 4 26B A4B
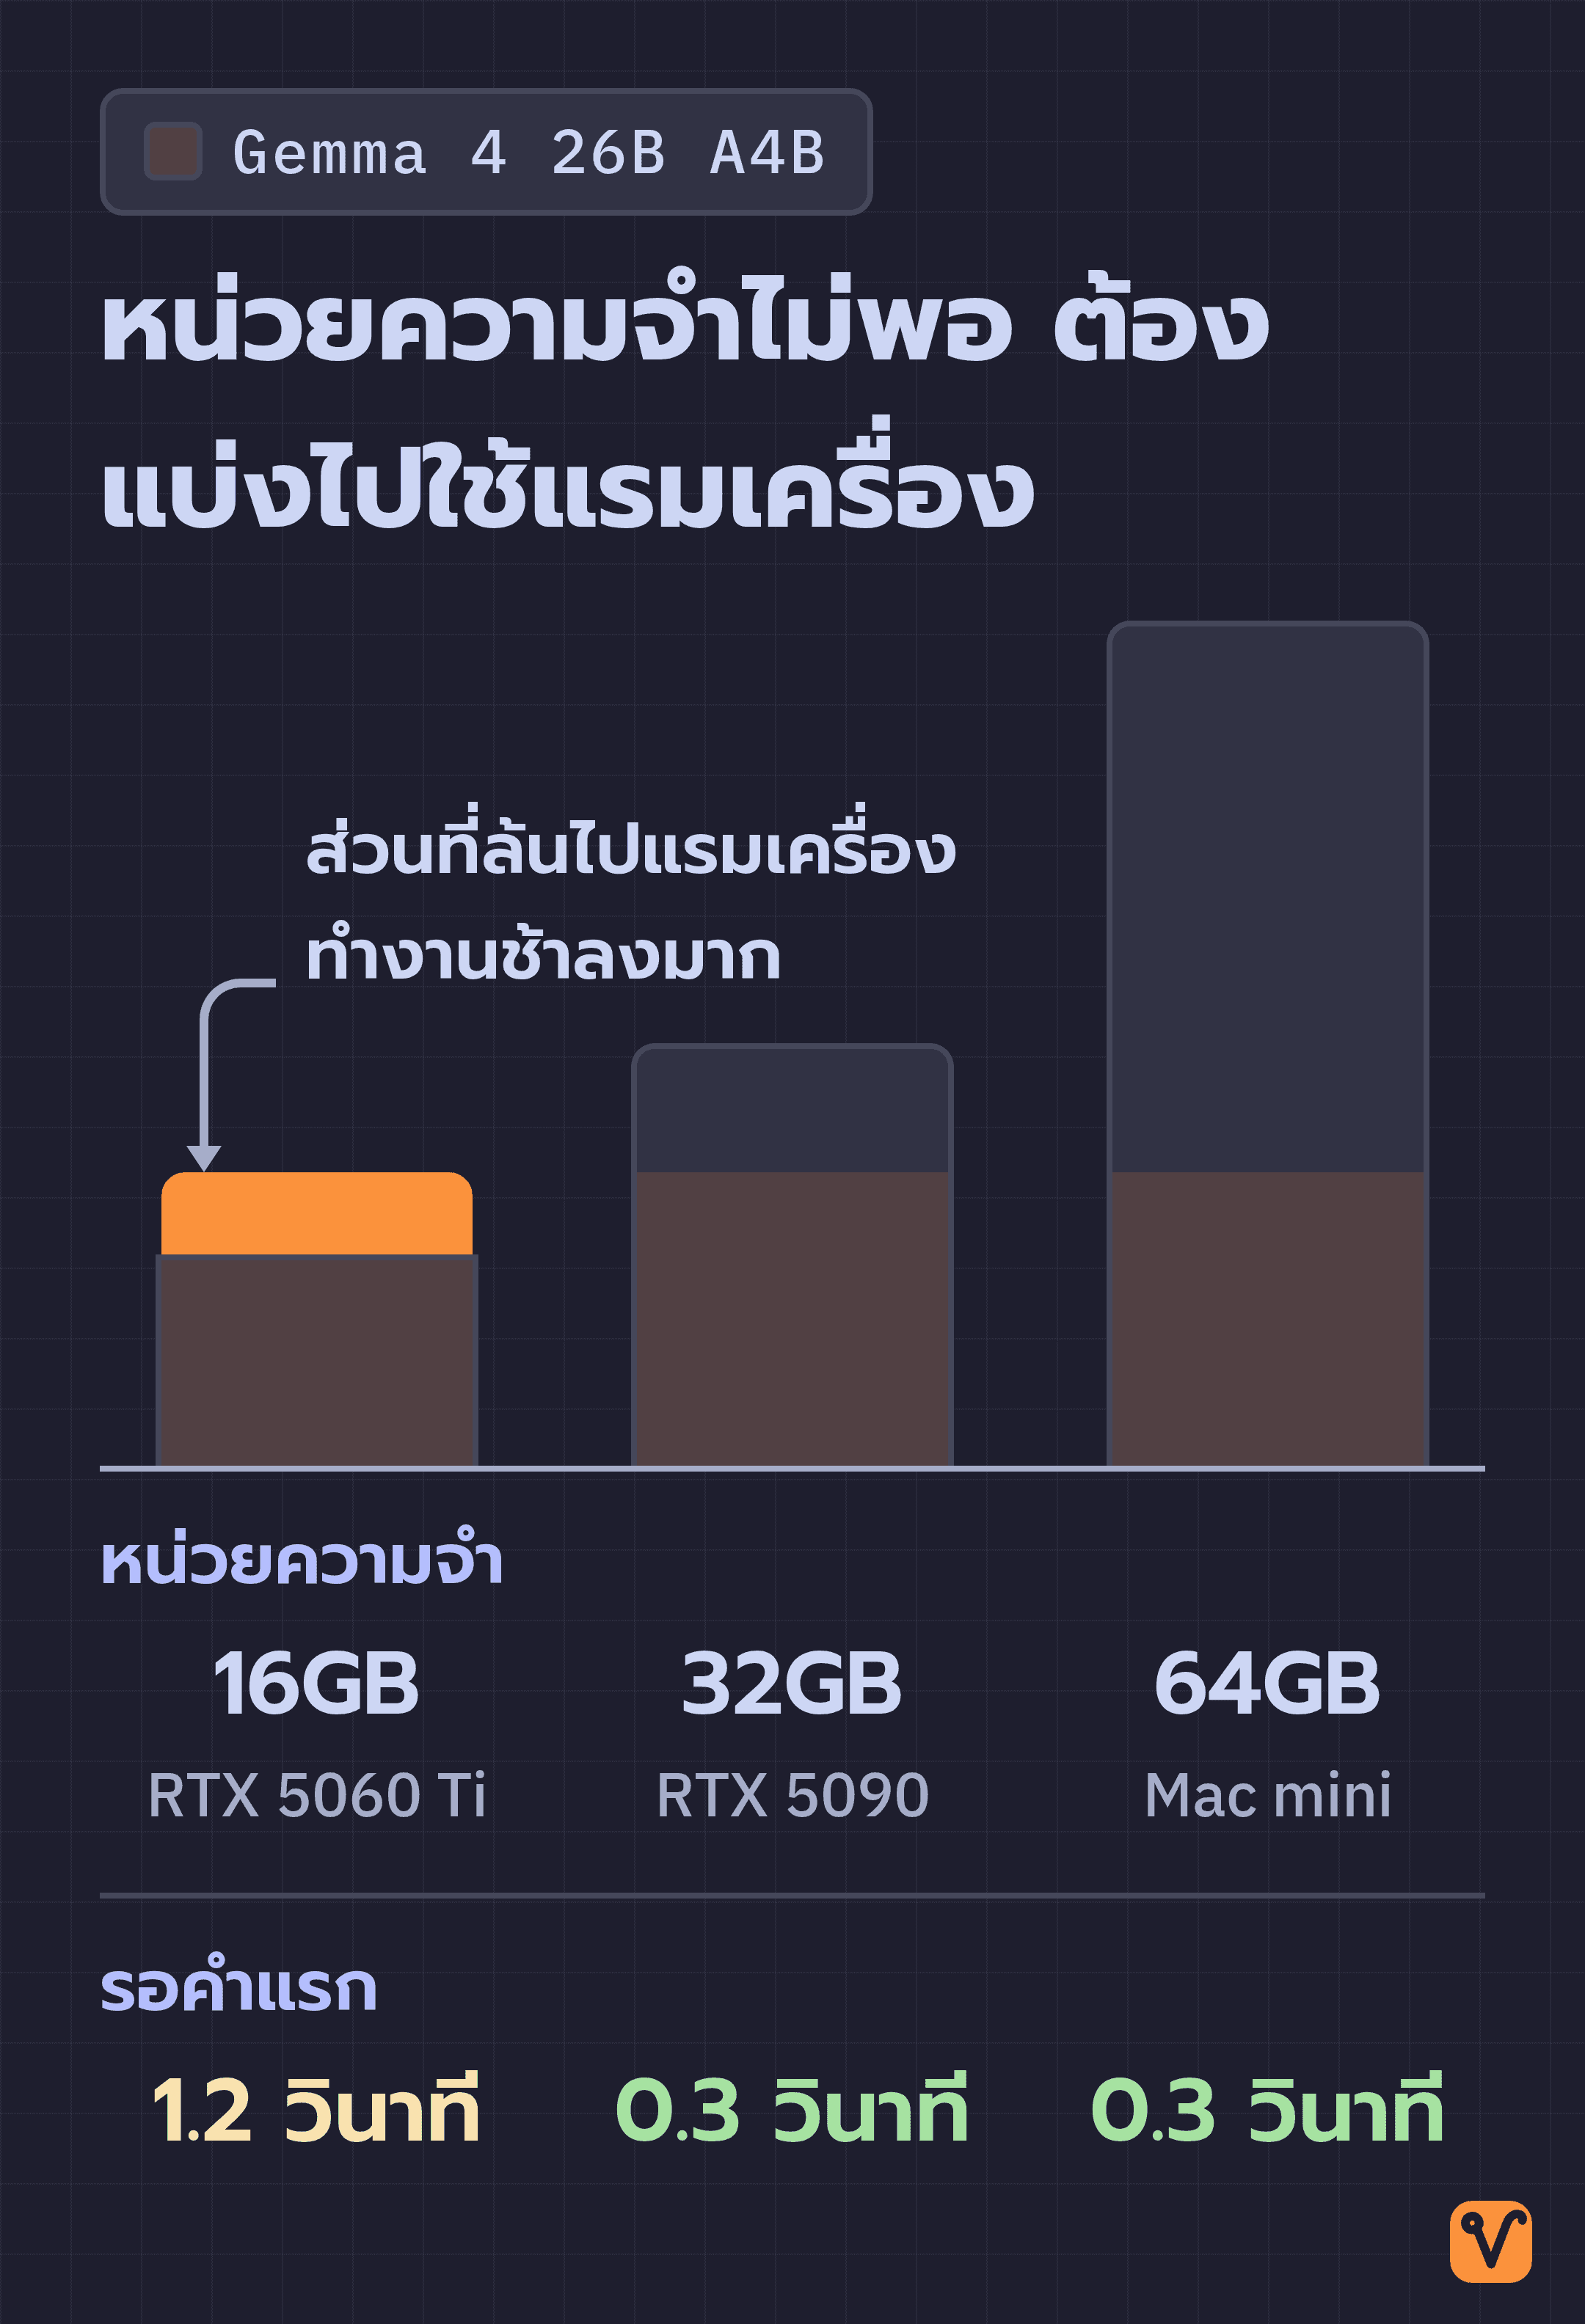
ถ้าลองล็อกโมเดล Gemma 4 26B A4B ไว้เป็นตัวหลัก เพื่อดูว่าเครื่อง 3 ระดับทำความเร็วต่างกันแค่ไหน ตารางหน้า Gemma 4 26B A4B ของ Llmspeed ได้รวบรวมความเร็วของโมเดลนี้บนทุกเครื่องที่รองรับไว้ โดยใช้ระดับ quantization ที่ดีที่สุดที่เครื่องนั้นรันไหว ซึ่งในตารางนี้คือ Q4_K_M ทุกแถว
ตัวเลขในตารางนี้อ้างอิงจากการส่งพรอมต์สั้นบนเครื่องเดี่ยว และตัวเลขทั้งหมดในบทความนี้เป็นค่าที่แสดงบนหน้าเว็บ ณ วันที่ 19 ตุลาคม 2026 เนื่องจากข้อมูลในเว็บอัปเดตอยู่เรื่อยๆ ถ้าเปิดดูในวันอื่น ตัวเลขอาจเปลี่ยนแปลงไปได้
| เครื่อง | หน่วยความจำ | ความเร็ว | รอคำแรก |
|---|---|---|---|
| RTX 5060 Ti 16GB (การ์ดจอรุ่นกลาง) | Partial offload ต้องแบ่งไปใช้แรมเครื่อง | 53 tok/s | 1.2 วินาที |
| Mac mini M5 Pro 64GB | Fits ลงได้ทั้งตัว | 66 tok/s | 0.3 วินาที |
| RTX 5090 32GB | Fits ลงได้ทั้งตัว | 313 tok/s | 0.3 วินาที |
จุดที่ชวนพลาดอยู่ที่สองแถวแรก ถ้าดูเฉพาะความเร็ว 53 กับ 66 tok/s อาจคิดว่าไม่ได้ต่างกันมาก แต่เพราะ RTX 5060 Ti มีหน่วยความจำ 16GB จึงจุโมเดลนี้ไม่พอและต้องแบ่งบางส่วนไปฝากไว้ในแรมเครื่อง ทำให้ต้องรอคำแรกนานถึง 1.2 วินาที ซึ่งช้ากว่า Mac mini ราวๆ 4 เท่า
ผลกระทบจากหน่วยความจำไม่พอเห็นได้ชัดเจนทั่วทั้งตาราง เพราะการ์ดจอที่มีหน่วยความจำ 12–16GB ทุกรุ่นจะขึ้นสถานะ Partial offload และต้องรอคำแรกนาน 1.2 วินาทีเท่ากันหมด ขณะที่เครื่องที่จุโมเดลได้ครบทั้งตัวจะใช้เวลารอเพียง 0.3–0.4 วินาทีเท่านั้น
ส่วน RTX 5090 จุโมเดลได้ครบทั้งตัว และทำความเร็วได้สูงถึง 313 tok/s ซึ่งเร็วกว่า Mac mini ประมาณ 4.7 เท่า นอกจากนี้ ในตารางเดียวกันยังมีเครื่องอื่นให้เปรียบเทียบ เช่น MacBook M4 Pro 24GB ทำได้ 58 tok/s และ RTX 3090 24GB ทำได้ 163 tok/s โดยทั้งสองเครื่องนี้มีหน่วยความจำพอจุโมเดลนี้ได้ทั้งตัวเช่นกัน
บน Mac mini เครื่องเดียวกัน โมเดลต่างกัน ความเร็วต่างกันถึง 7 เท่า
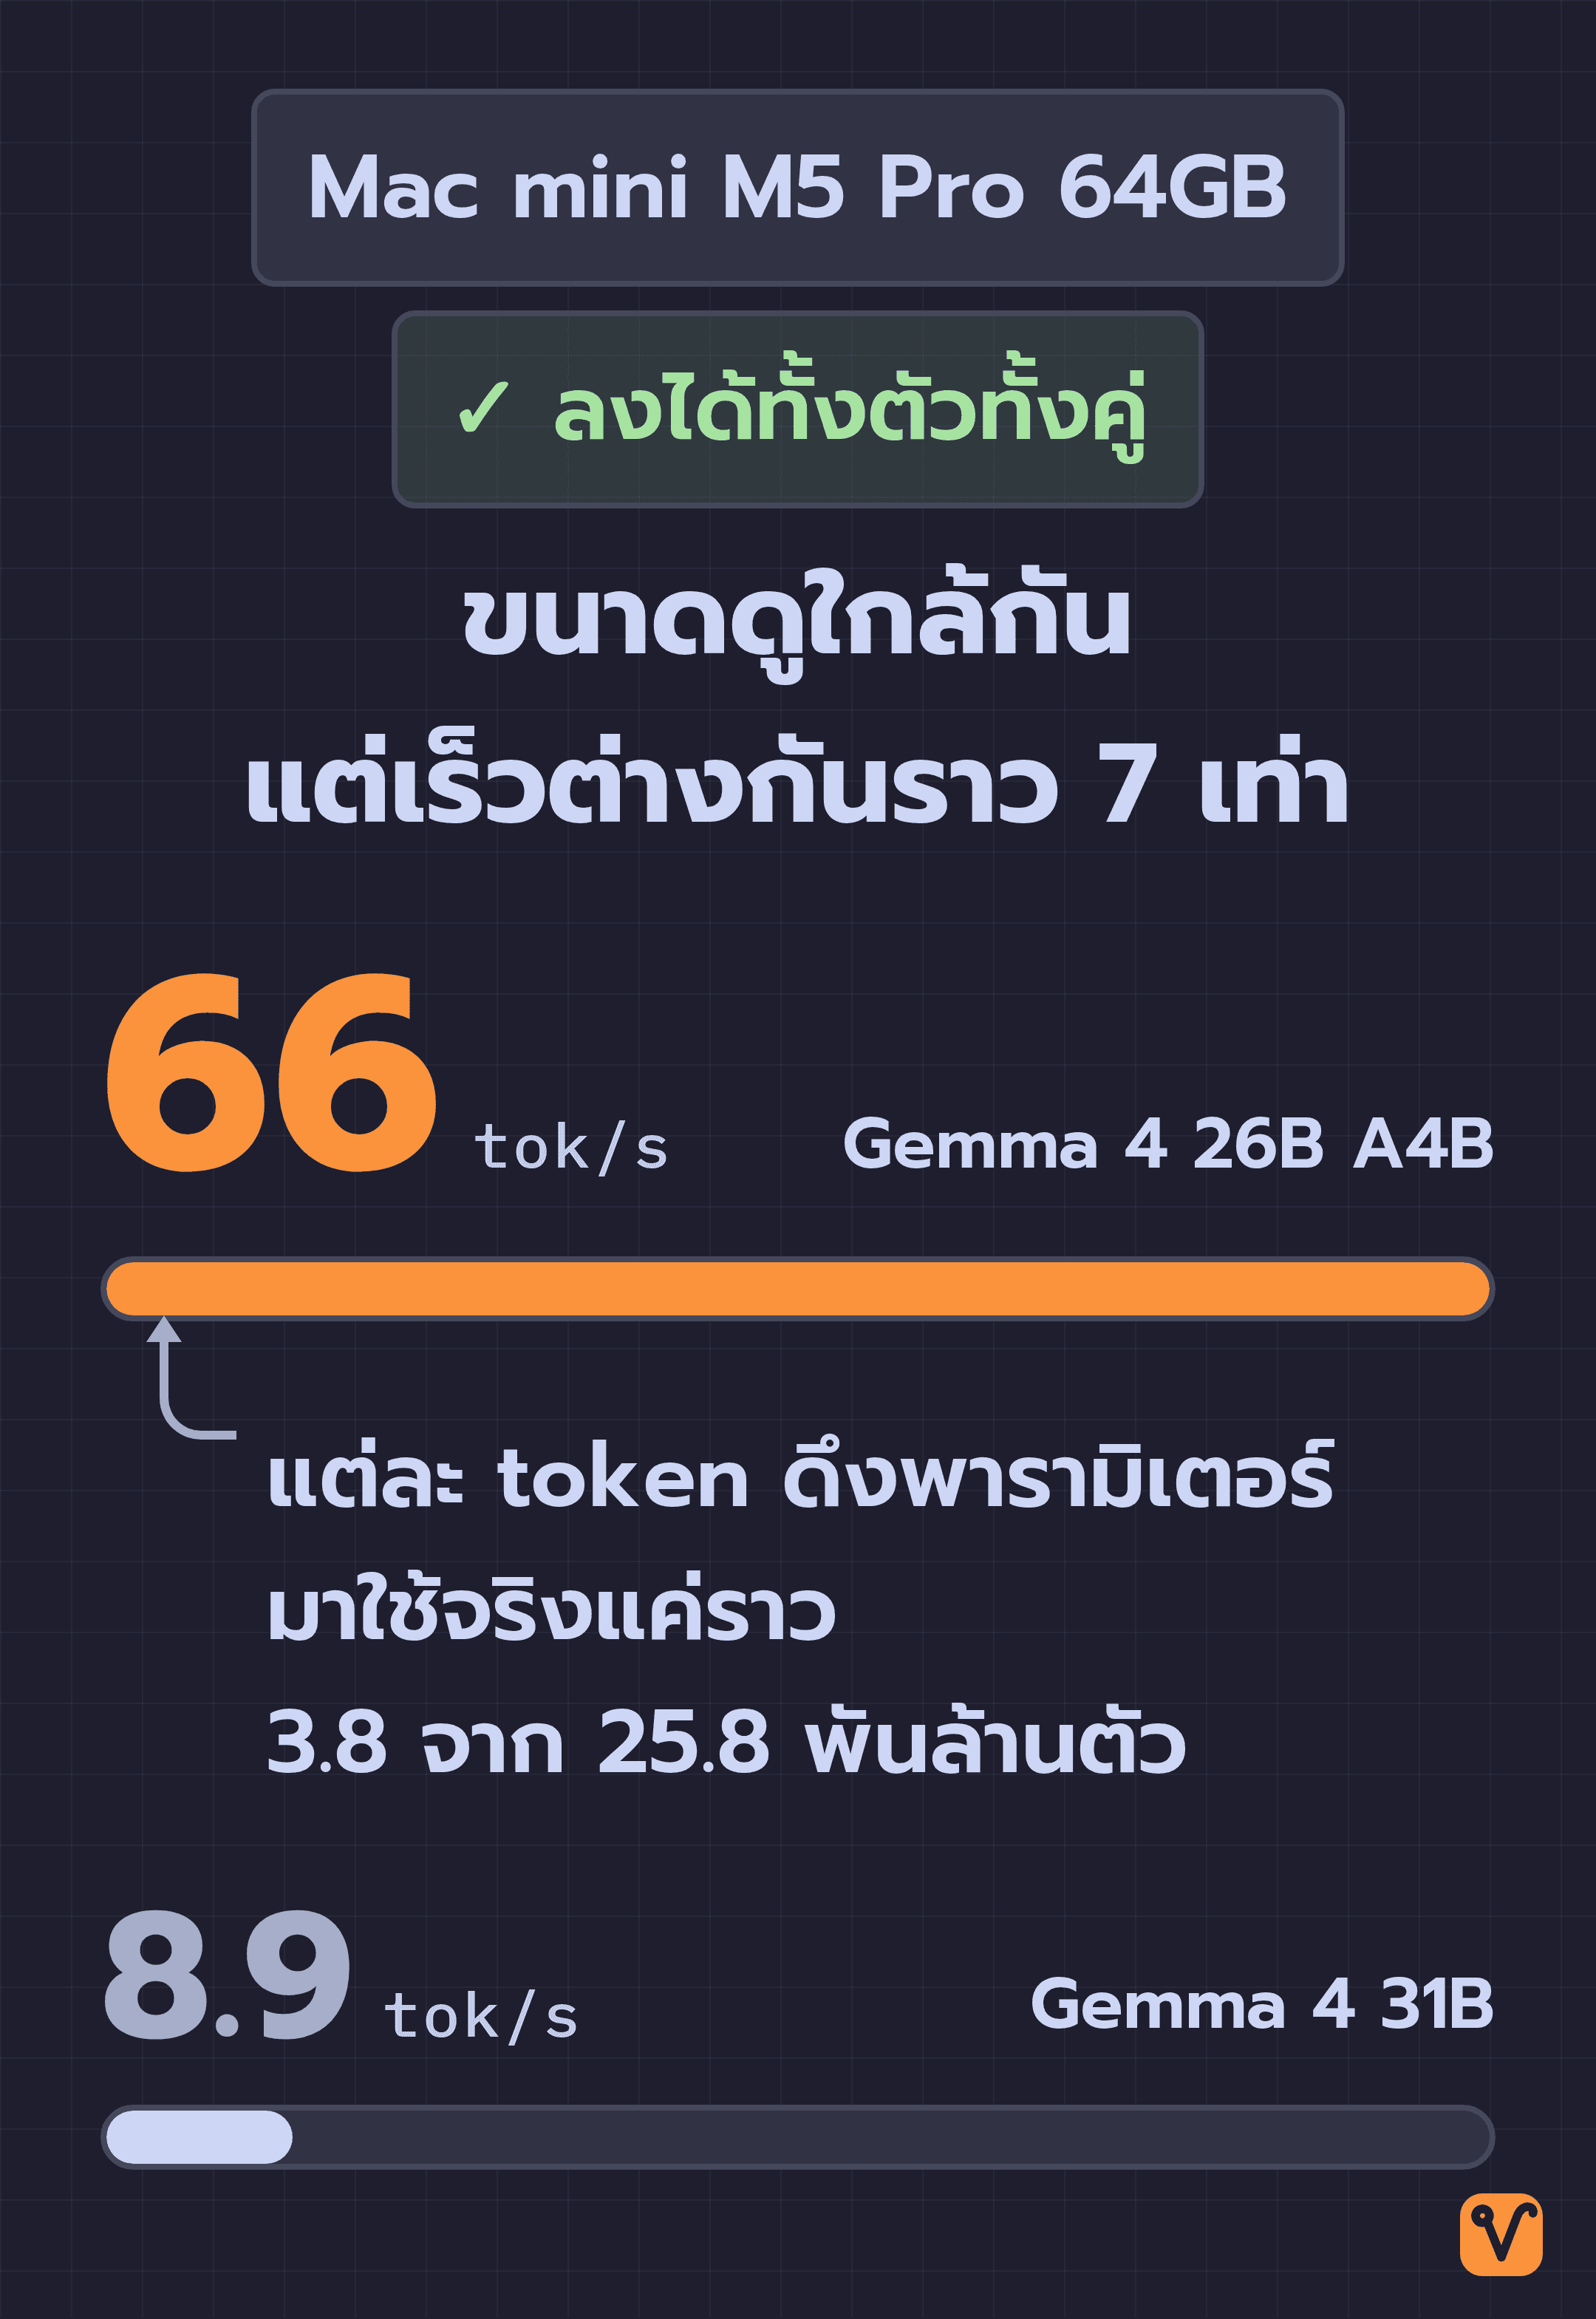
คราวนี้ลองสลับมุมมอง โดยล็อกสเปกเครื่องเดิมไว้แล้วเปลี่ยนโมเดลดูบ้าง หน้า Mac mini M5 Pro 64GB ของ Llmspeed รวบรวมความเร็วของทั้ง 15 โมเดลบนเครื่องนี้ไว้ในตารางเดียว
สองแถวที่ควรดูคู่กันคือ Gemma 4 26B A4B ที่ทำความเร็วได้ 66 tok/s กับ Gemma 4 31B ที่ทำได้เพียง 8.9 tok/s ทั้งสองตัวรันระดับ Q4_K_M เหมือนกันและจุลงเครื่อง Mac mini เดียวกันได้ครบ แต่โมเดลแรกกลับเร็วกว่าราว 7 เท่า
หากดูเพียงชื่อรุ่น ทั้งสองตัวนี้ดูเหมือนจะมีขนาดใกล้เคียงกัน เพราะตัวเลขในชื่อรุ่นบอกถึงจำนวนพารามิเตอร์ หรือชุดตัวเลขที่โมเดลใช้ประมวลผล ในระดับหลายหมื่นล้าน แต่ความเร็วไม่ได้ขึ้นอยู่กับขนาดรวมของพารามิเตอร์ทั้งหมดเพียงอย่างเดียว แต่อยู่ที่ว่าในแต่ละ token โมเดลต้องเรียกใช้พารามิเตอร์มากน้อยแค่ไหน
นั่นเพราะ Gemma 4 26B A4B เป็นโมเดลที่ใช้โครงสร้างแบบ Mixture of Experts หรือ MoE ซึ่งแบ่งการทำงานภายในออกเป็นหลายส่วน และในการพิมพ์แต่ละ token จะเลือกเรียกใช้เพียงบางส่วนเท่านั้น ข้อมูลบนหน้าระบุว่า ทั้งโมเดลมีพารามิเตอร์รวมราว 25.8 พันล้านตัว แต่ดึงมาใช้จริงต่อหนึ่ง token เพียงราว 3.8 พันล้านตัวเท่านั้น
README ของ Llmspeed อธิบายเพิ่มเติมว่าทำไมพารามิเตอร์ส่วนที่เรียกใช้จริงจึงสำคัญ นั่นเพราะความเร็วตอนพิมพ์คำตอบขึ้นอยู่กับแบนด์วิดท์ของหน่วยความจำ และทุกๆ token ที่สร้างขึ้น เครื่องจะต้องอ่านข้อมูลพารามิเตอร์ส่วนที่ใช้งานผ่านหน่วยความจำหนึ่งรอบเสมอ โมเดลประเภท MoE จึงนับเฉพาะส่วนที่เรียกใช้งานจริงมาคำนวณความเร็ว
ในหน้าเว็บของ Mac mini ก็ระบุไว้ว่า แบนด์วิดท์ 307 GB/s ของเครื่องนี้คือปัจจัยหลักที่กำหนดความเร็ว สำหรับภาพรวมว่าหน่วยความจำและแบนด์วิดท์ส่งผลต่อการรันโมเดล AI ในเครื่องอย่างไร เราได้อธิบายไว้แล้วในบทความเรื่อง Mac mini กับการรัน AI ในเครื่อง
ถ้าอยากเห็นอีกตัวอย่างว่าตัวเลขในชื่อรุ่นทำให้เข้าใจผิดได้มากแค่ไหน ในตารางเดียวกันยังมีอีกคู่ คือ Qwen 3.5/3.6 35B A3B ที่ทำได้ 89 tok/s กับ Qwen 3.6/3.8 27B ที่ทำได้เพียง 9.7 tok/s กลายเป็นว่าโมเดลที่ตัวเลขพารามิเตอร์รวมในชื่อมากกว่ากลับรันได้เร็วกว่าหลายเท่าตัว
ยิ่งไปกว่านั้น ไม่ใช่ทุกโมเดลจะรันบนเครื่องนี้ได้ เพราะบน Mac mini เครื่องเดียวกัน ทั้ง Qwen 3.8 Flash-Next, DeepSeek V4.1 Flash และ GPT-OSS 120B ต่างขึ้นสถานะ Won't run ทั้งหมด ใครที่กำลังเล็ง Qwen 3.8 Flash-Next ไว้ สามารถอ่านเพิ่มเติมได้ในการรัน Qwen3.8-Flash-Next ในเครื่อง
ตรงนี้จึงเป็นจุดที่ต้องคิดให้ดีก่อนตัดสินใจ ถ้ารู้ล่วงหน้าว่าจะใช้โมเดลตัวไหน เครื่องที่ต้องซื้อจริงอาจเล็กกว่าหรือสเปกต่ำกว่าที่คิด แต่ถ้าด่วนตัดสินใจเลือกเครื่องไปก่อน โมเดลที่ตั้งใจจะใช้จริงๆ อาจรันไม่ขึ้นเลยบนเครื่องนั้น
ป้าย Measured, Derived, Projected บอกระดับความน่าเชื่อถือของตัวเลข
ตัวเลขความเร็วบน Llmspeed ไม่ได้มาจากการวัดจริงบนเครื่องครบทุกคู่ ทุกค่าที่ประเมินจึงมีป้ายกำกับบอกที่มาของข้อมูลไว้ เพื่อให้เรารู้ว่าควรเชื่อถือตัวเลขนั้นได้มากน้อยแค่ไหน:
- Measured วัดจริงบนเครื่อง ด้วยโมเดลและระดับ quantization ชุดนั้นโดยตรง
- Derived คำนวณประมาณการจากผลการวัดจริงของชุดสเปกที่ใกล้เคียงกัน
- Projected คำนวณจากสเปกทางทฤษฎีของเครื่อง เช่น อุปกรณ์ที่เปิดตัวแล้วแต่ยังไม่วางจำหน่ายจริง
ผลการทดสอบจริงที่นำมาใช้นั้น รวบรวมมาจากชุมชนคนรันโมเดลเอง เช่น กลุ่ม r/LocalLLaMA, เว็บไซต์ localscore.ai และกระทู้ของโปรแกรมรันโมเดลบนเครื่องอย่าง llama.cpp
จุดที่พลาดได้ง่ายคือ ป้ายกำกับเหล่านี้ไม่ได้แสดงอยู่ในตารางรวมด้านล่าง แต่จะปรากฏอยู่ข้างตัวเลขเฉพาะชุดเครื่องและโมเดลที่เราเลือกไว้ในช่องด้านบนเท่านั้น หากอยากรู้ว่าตัวเลขในแถวไหนเชื่อถือได้แค่ไหน เราต้องเลือกชุดนั้นขึ้นมาดูด้วยตัวเอง
ค่าเริ่มต้นของทั้งสองหน้าแสดงให้เห็นความแตกต่างนี้ได้ชัดเจน โดยหน้า Mac mini ที่ตั้งค่าเริ่มต้นเป็น Llama 3.1 8B จะขึ้นป้าย Measured พร้อมช่วงความเร็วแคบๆ ที่ 40–50 tok/s ส่วนหน้า Gemma 4 26B A4B ที่ตั้งค่าเริ่มต้นไว้กับ RTX 3090 จะขึ้นป้าย Derived พร้อมช่วงความเร็วกว้างถึง 79–248 tok/s ซึ่งช่วงตัวเลขของ Derived ในตัวอย่างนี้กว้างกว่า Measured มาก
README ยังระบุเพิ่มเติมว่า ปัจจุบันเว็บยังไม่รองรับการจำลองกรณีที่ต่อการ์ดจอหลายใบ และชี้แจงตรงๆ ว่าตัวเลขทั้งหมดเป็นเพียงค่าประเมิน ไม่ใช่การรับประกันผลการทำงาน
เพราะในการใช้งานจริง ตัวเลขความเร็วจริงขยับขึ้นลงได้อีก 10–30% ตามปัจจัยแวดล้อม เช่น เวอร์ชันของไดรเวอร์ เวอร์ชันโปรแกรม การตั้งค่าอย่าง Flash Attention หรือ Power Limit รวมถึงความร้อนของเครื่อง
เสียงสะท้อนจากผู้ใช้จริงในกระทู้ Show HN
ตอนที่ Llmspeed เปิดตัวในกระทู้ Show HN บนเว็บบอร์ด Hacker News ผู้ใช้งานที่มีเครื่องจริงต่างเข้ามาแชร์ผลการใช้งานของตัวเองไว้มากมาย แม้ทั้งหมดจะเป็นความเห็นส่วนตัวไม่ใช่ผลทดสอบทางการ แต่ก็ช่วยให้เห็นว่าตัวเลขบนเว็บอาจคลาดเคลื่อนจากความเป็นจริงในแง่ไหนบ้าง:
- บางคนทำความเร็วได้ดีกว่าที่เว็บบอก หลังปรับแต่งระบบเพิ่มเติม เช่น ใช้ llama.cpp เวอร์ชันปรับแต่งพิเศษ หรือเทคนิคเร่งความเร็วอื่นๆ (ถ้าสนใจแนวทางนี้ มีวิธีเร่ง LLM ในเครื่องโดยไม่ต้องเปลี่ยนการ์ดให้อ่านต่อ)
- บางคนมองว่าตัวเลขสูงสุดของช่วงดูดีเกินจริง เมื่อเทียบกับความเร็วที่ตัวเองรันได้จริงบนการ์ดรุ่นเดียวกัน
- งานเขียนโค้ดด้วย Agent หรือระบบ AI ผู้ช่วย ช้ากว่าที่เว็บบอกมาก เพราะตัวระบบทำงานต่อเนื่องหลายขั้นตอน และมักส่งพรอมต์ยาวหลายหมื่น token ทำให้พิมพ์ตอบช้าลง และต้องรอนานขึ้นมากก่อนคำแรกจะโผล่ขึ้นมา
- บางคู่ที่เว็บขึ้นสถานะ Won't run กลับรันได้จริง โดยอาศัยการตั้งค่าใน llama.cpp เพื่อแบ่งบางชั้นประมวลผลของโมเดลไปทำงานบน CPU แทน
ถ้างานของคุณคือให้ Agent เขียนโค้ดตลอดทั้งวัน ขอแนะนำให้ใช้ตัวเลขบนเว็บเพื่อดูว่าแต่ละเครื่องเร็วกว่ากันกี่เท่า มากกว่าจะปักใจเชื่อว่าจะได้ความเร็วตามนั้นในการทำงานจริงทุกวัน
เช็กลิสต์ Llmspeed 5 ข้อก่อนตัดสินใจจ่ายเงิน
- เลือกโมเดลที่จะใช้จริงก่อนเลือกเครื่อง: แล้วเปิดหน้าของโมเดลนั้น ดูว่ามีเครื่องไหนรองรับได้บ้าง
- ดูสถานะหน่วยความจำ: ตรวจสอบว่าขึ้น Fits, Partial offload หรือ Won't run
- ดูเวลารอคำแรกด้วย: อย่าดูแค่ตัวเลข token ต่อวินาที
- เช็กป้าย Measured, Derived, Projected ก่อนปักใจเชื่อ: โดยเลือกชุดนั้นในช่องด้านบนเพื่อให้ป้ายปรากฏ
- ใช้โหมด Race เปรียบเทียบสองเครื่องที่กำลังลังเล: แล้วคัดลอกลิงก์ส่งให้เพื่อนเปิดดูผลลัพธ์แบบเดียวกัน
ใครที่มีเครื่องอยู่แล้ว ช่วยส่งผลการวัดจริงเข้าไปยังเว็บได้ด้วย ใน README ระบุว่าผลการทดสอบจริงจากผู้ใช้คือสิ่งที่โปรเจกต์ต้องการมากที่สุด เริ่มจากรันคำสั่ง llama-bench ซึ่งเป็นเครื่องมือวัดความเร็วของ llama.cpp บนเครื่องของคุณ:
llama-bench -m your-model.gguf -p 512 -n 128ก่อนรัน ให้เปลี่ยน your-model.gguf เป็นชื่อไฟล์โมเดลของคุณ ผลลัพธ์ที่ต้องบันทึกมี 2 ค่า คือ tg128 สำหรับความเร็วตอนพิมพ์คำตอบ และ pp512 สำหรับความเร็วตอนอ่านพรอมต์
เสร็จแล้วเปิด Pull Request บน GitHub เพื่อเพิ่มแถวข้อมูลผลทดสอบของคุณลงในไฟล์ benchmarks/submissions.csv พร้อมแนบผลลัพธ์ฉบับเต็มของ llama-bench ไว้ในคำอธิบายของ PR หรือถ้าคุณใช้โปรแกรมอื่นอย่าง MLX หรือ vLLM ก็สามารถส่งผลได้เช่นกัน เพียงระบุชื่อโปรแกรมลงในช่อง engine_version
คำถามที่ว่าเครื่องไหนแรงที่สุด ตารางของ Llmspeed ตอบให้เห็นตั้งแต่แถวแรกอยู่แล้ว แต่คำถามสำคัญที่เหลือให้เราตอบตัวเองก่อนจ่ายเงิน คือเครื่องไหนที่เพียงพอสำหรับโมเดลที่เราจะใช้งานจริง
ที่มา:
- โปรเจกต์ Llmspeed บน GitHub
- เอกสารทางการของ Llmspeed
- บทความ Show HN: Llmspeed – feel how fast a local LLM runs before you buy the hardware จาก Hacker News
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
สร้าง Claude Skill แบบไม่ต้องรู้โค้ด คู่มือสร้าง Claude Skill ของคุณเองด้วยการคุยกับ Claude Code เป็นภาษาไทย
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin