Muse Spark API บน Meta Model API มีสองราคา โดย contributor tier คิดค่า input $0.10 แทน $1.25 ต่อล้าน token แลกกับการยอมให้ Meta เอาข้อมูลไปเทรน
Muse Spark API บน Meta Model API มีรุ่น -contributor ที่ถูกกว่า standard หลายเท่า แลกกับการให้ Meta เอาข้อมูลไปเทรน จะเลือกรุ่นไหน ตอบได้ด้วยคำถามข้อเดียว
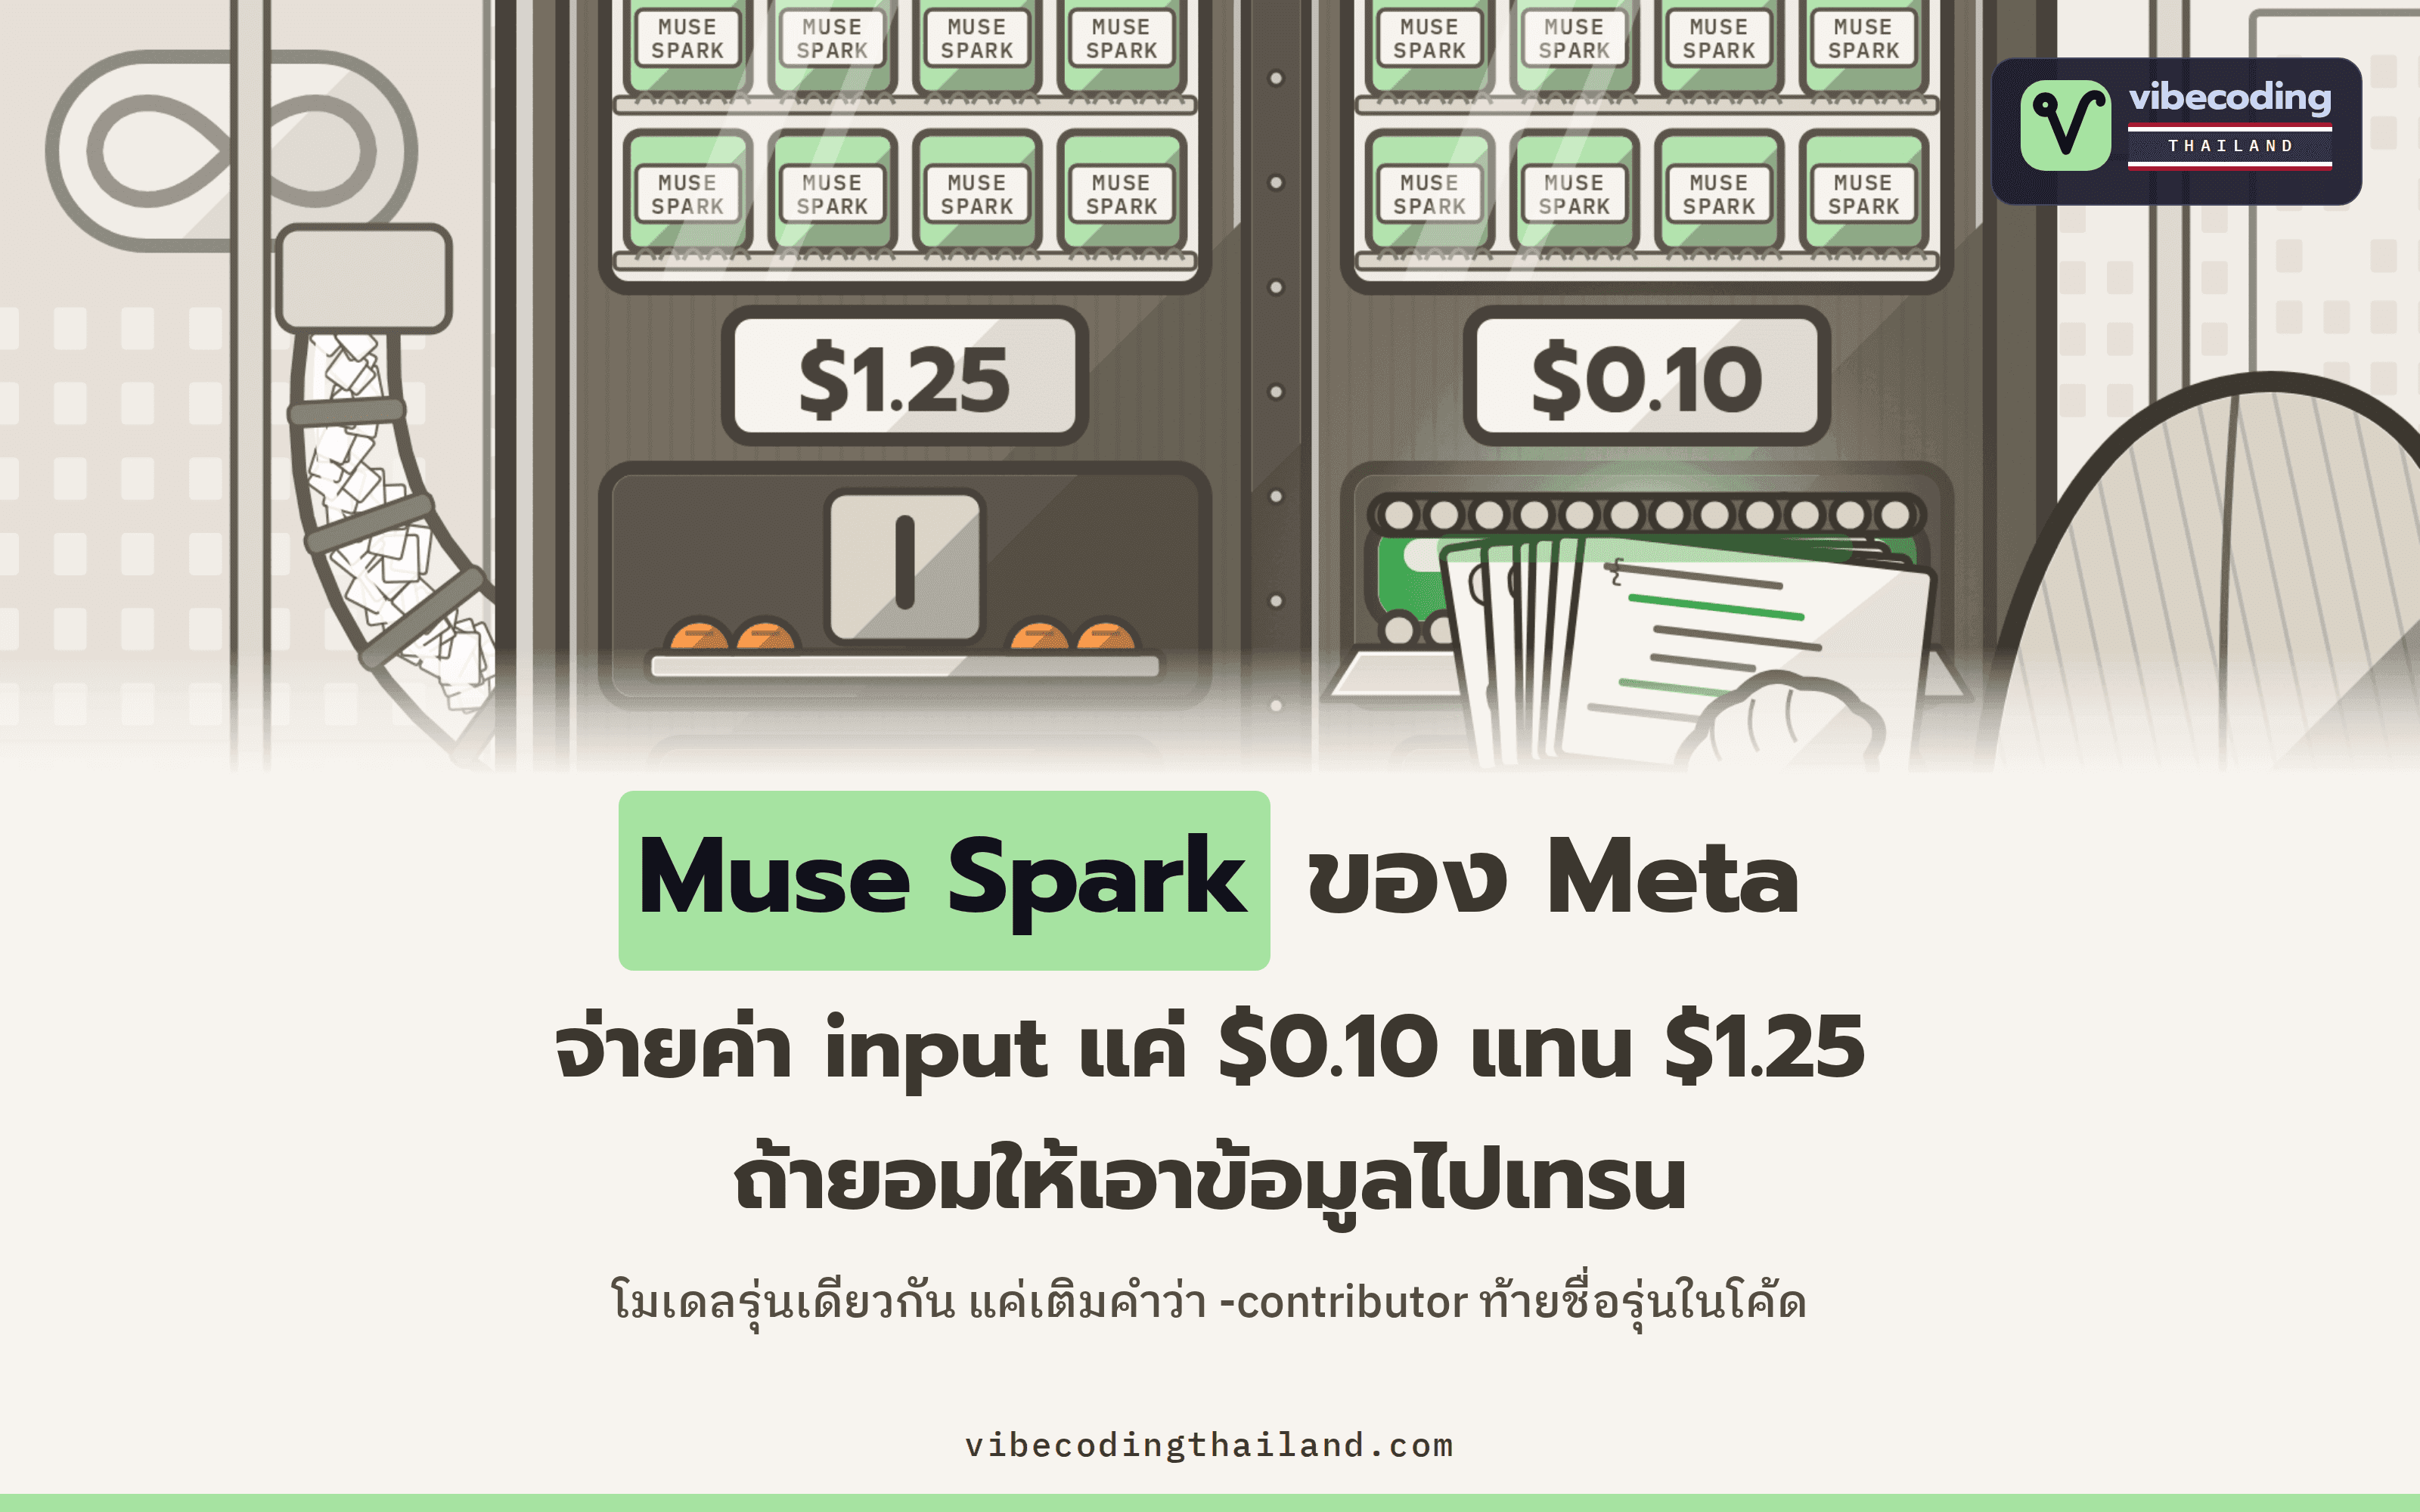
Muse Spark โมเดลจาก Meta สำหรับงานระบบอัตโนมัติอย่าง AI Agent และงานเขียนโค้ด มีราคาให้เลือก 2 รูปแบบทั้งที่เป็นโมเดลตัวเดียวกัน โดยหน้าเอกสารของ Meta Model API แพลตฟอร์มสำหรับเรียกใช้โมเดล ระบุราคาไว้ 2 ชุดชัดเจน
สำหรับคนที่กำลังพัฒนาแอปหรือทำโปรเจกต์ส่วนตัวแล้วอยากได้โมเดลความสามารถสูงแต่งบมีจำกัด พอเข้าไปดูราคาของ Muse Spark 1.3 จะพบว่าระบบคิดเงินตามจำนวน token ซึ่งเป็นหน่วยนับปริมาณข้อความ โดยแบ่งออกเป็น 2 ราคา
ราคาชุดแรกคิดค่าส่งข้อความเข้าหรือ input อยู่ที่ $1.25 ต่อ 1 ล้าน token ขณะที่ชุดที่สองคิดเพียง $0.10 หรือถูกลงถึง 12.5 เท่า ส่วนฝั่งข้อความตอบกลับอย่าง output ชุดแรกคิด $4.25 ส่วนชุดที่สองคิดเพียง $0.20 หรือถูกลงราว 21 เท่า
ชื่อของทั้งสองชุดต่างกันแค่คำลงท้าย โดยรุ่นที่ราคาถูกกว่าจะใช้ Model ID หรือรหัสระบุชื่อโมเดลในโค้ดว่า muse-spark-1.3-contributor ส่วนต่างราคาที่ลดลงไปมหาศาลนี้ Meta แลกมาด้วยเงื่อนไขสำคัญ นั่นคือสิทธิ์ในการนำข้อความคำสั่งอย่าง prompt และคำตอบที่ได้ ไปใช้เทรนโมเดลรุ่นต่อไปของ Meta
การเลือกว่าจะใช้ราคาชุดไหนจึงไม่มีปุ่มให้กดเลือกในหน้าตั้งค่า แต่อยู่ที่ตัวอักษรไม่กี่ตัวในโค้ด คำถามสำคัญในการตัดสินใจจึงไม่ใช่งบประมาณ แต่เป็นคำถามว่า ข้อมูลที่เราส่งเข้าไปนั้น เรามีสิทธิ์อนุญาตให้คนอื่นนำไปเทรนโมเดลหรือไม่
ราคา 2 รูปแบบบน Meta Model API ส่วนต่างที่จ่ายด้วยข้อมูล
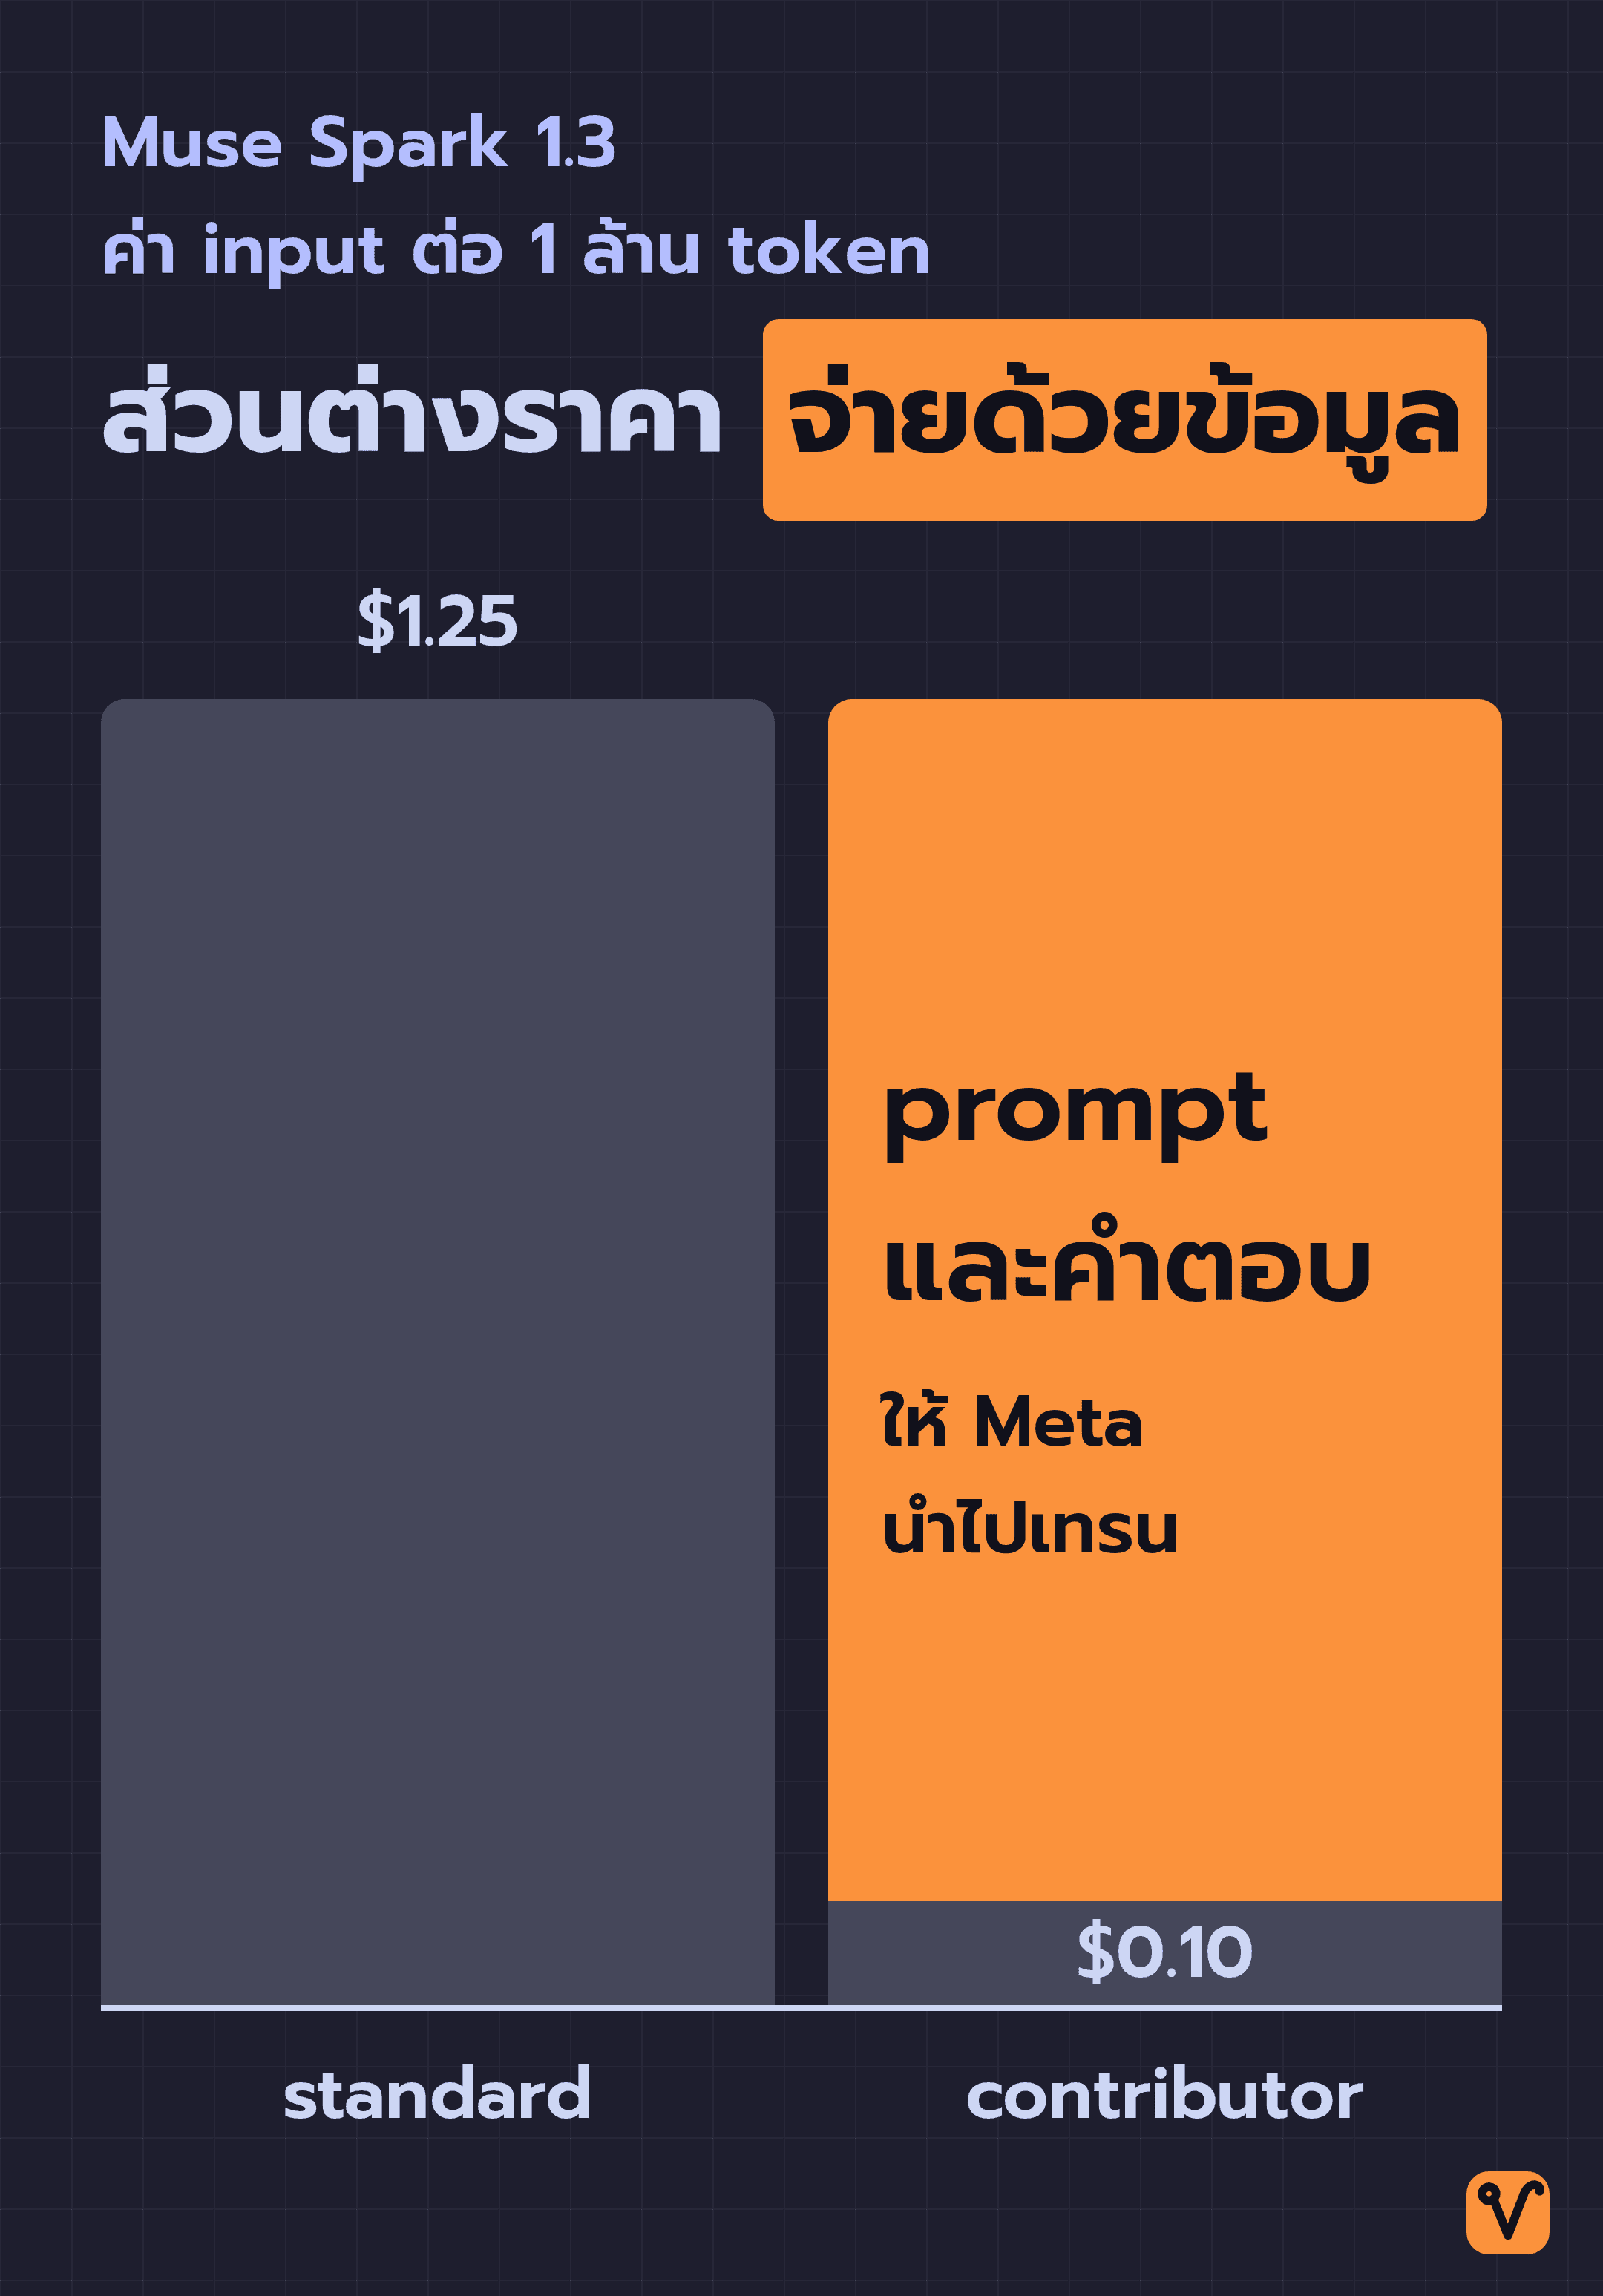
Meta แบ่งระดับราคาหรือ tier ออกเป็น 2 ระดับ คือ standard ซึ่งเป็นราคาปกติ และ contributor ซึ่งเป็นราคาประหยัด โดยตัวเลขค่าบริการทั้งหมดคิดต่อ 1 ล้าน token ดังนี้
| ต่อ 1 ล้าน token | standard | contributor | ส่วนต่าง |
|---|---|---|---|
| input | $1.25 | $0.10 | ถูกลง 12.5 เท่า |
| output | $4.25 | $0.20 | ถูกลงราว 21 เท่า |
| cached input | $0.15 | $0.002 | ถูกลง 75 เท่า |
แถวสุดท้ายคือจุดที่ราคาต่างกันมากที่สุด นั่นคือค่า cached input ซึ่งใช้กับ prompt ส่วนที่ซ้ำเดิมและตรงกับ prompt cache โดยระบบจะคิดราคา cached input แทนราคา input ปกติ
Meta อธิบาย contributor tier ไว้ชัดเจนว่า เป็นราคาต่อ token ที่ลดลงอย่างมาก แลกกับการยินยอมให้ Meta นำ prompt และคำตอบของโมเดลไปเทรนโมเดลรุ่นต่อไป ส่วนฝั่ง standard tier ระบุไว้สั้นๆ ว่า Meta จะไม่นำ prompt และคำตอบไปเทรนโมเดล
จุดที่ชวนสับสนคือคำว่า contributor ไม่ได้หมายถึงโมเดลคนละตัว เพราะ muse-spark-1.3-contributor คือ Muse Spark 1.3 รุ่นเดียวกับ muse-spark-1.3 เพียงแต่อยู่คนละ tier โดยมีราคา เพดานการใช้งาน และเงื่อนไขเรื่องการเทรนต่างกัน
ปัจจุบัน contributor tier มีให้เลือกใช้เพียง 2 รุ่น คือ muse-spark-1.3-contributor และ muse-spark-1.2-contributor ส่วนรุ่นเก่าอย่าง 1.1 มีเฉพาะ standard tier เท่านั้น
Meta วาง contributor tier ไว้สำหรับงานสร้างระบบต้นแบบ การทดสอบเชื่อมต่อระบบ และการขยายการทดลองสำหรับงานที่ยอมรับการนำข้อมูลไปเทรนได้
ข้อจำกัดอื่นที่ไม่ได้อยู่ในตารางราคา
นอกจากเรื่องราคาแล้ว อีกจุดที่ต่างกันคือ Rate Limit ซึ่งเป็นเพดานการใช้งานต่อนาที โดย contributor tier ส่ง request หรือคำขอไปที่ API ได้ 100 ครั้งต่อนาที ส่วน standard tier ทำได้ถึง 3,000 ครั้งต่อนาที
ส่วนเพดานจำนวน token ต่อนาทีต่างกันไม่มากนัก โดย contributor อยู่ที่ 3 ล้าน token ต่อนาที และ standard อยู่ที่ 4 ล้าน token ต่อนาที
โควตา 100 ครั้งต่อนาที คิดเฉลี่ยแล้วไม่ถึง 2 ครั้งต่อวินาที ถ้าใช้คนเดียวเพื่อทดสอบระบบทั่วไปอาจเพียงพอ แต่ถ้านำไปใช้กับ AI Agent ที่ต้องเรียกโมเดลวนซ้ำหลายรอบในงานเดียว หรือเริ่มมีผู้ใช้หลายคนพร้อมกัน ก็มีโอกาสชนเพดาน Rate Limit ได้เร็วกว่าที่คิด
จุดที่พลาดง่ายคือ เพดานนี้คิดรวมทั้งทีม ไม่ได้แยกนับตาม API key ต่อให้ทีมสร้าง key ไว้หลายอัน ทุก request และทุก token จากทุก key ก็นับรวมเข้าโควตาก้อนเดียวกัน การแจก key ให้เพื่อนร่วมทีมคนละอันจึงไม่ได้ช่วยขยายเพดานการใช้งานเลย
ความต่างข้อถัดมาอยู่ที่ Reasoning Effort ซึ่งเป็นระดับความลึกที่เปิดให้โมเดลคิดก่อนตอบ โดย Muse Spark 1.3 มีระดับสูงสุดคือ max สำหรับงานที่ต้องคิดวิเคราะห์ยาวๆ แต่ระดับนี้เปิดให้ใช้เฉพาะบน standard tier เท่านั้น
อีกข้อที่ต้องระวังคือ บล็อกเปิดตัว Muse Code เครื่องมือช่วยเขียนโค้ดของ Meta ระบุว่า contributor tier เปิดให้ใช้เฉพาะในบางประเทศ ก่อนจะวางแผนงบประมาณทั้งโปรเจกต์ด้วยราคานี้ จึงควรเข้าไปตรวจสอบในบัญชีของตัวเองก่อนว่าเรียกใช้รุ่นนี้ได้จริงหรือไม่
สำหรับคนที่ใช้ Muse Code ควรรู้ไว้ว่า ค่าเริ่มต้นของเครื่องมือนี้ทำงานบน contributor tier โดยระบบจะจำกัดการใช้งานด้วยจำนวน token สะสมในช่วง 5 ชั่วโมงล่าสุดแบบนับต่อเนื่อง แทนการนับจำนวน request หมายความว่าถ้ายังไม่ได้เปลี่ยนรุ่น โค้ดที่ส่งผ่าน Muse Code ก็อยู่บน tier ที่ Meta ระบุว่าอาจนำข้อมูลไปใช้ปรับปรุงผลิตภัณฑ์ของตัวเอง
เลือก contributor tier หรือ standard ตอบได้ด้วยคำถามเดียว
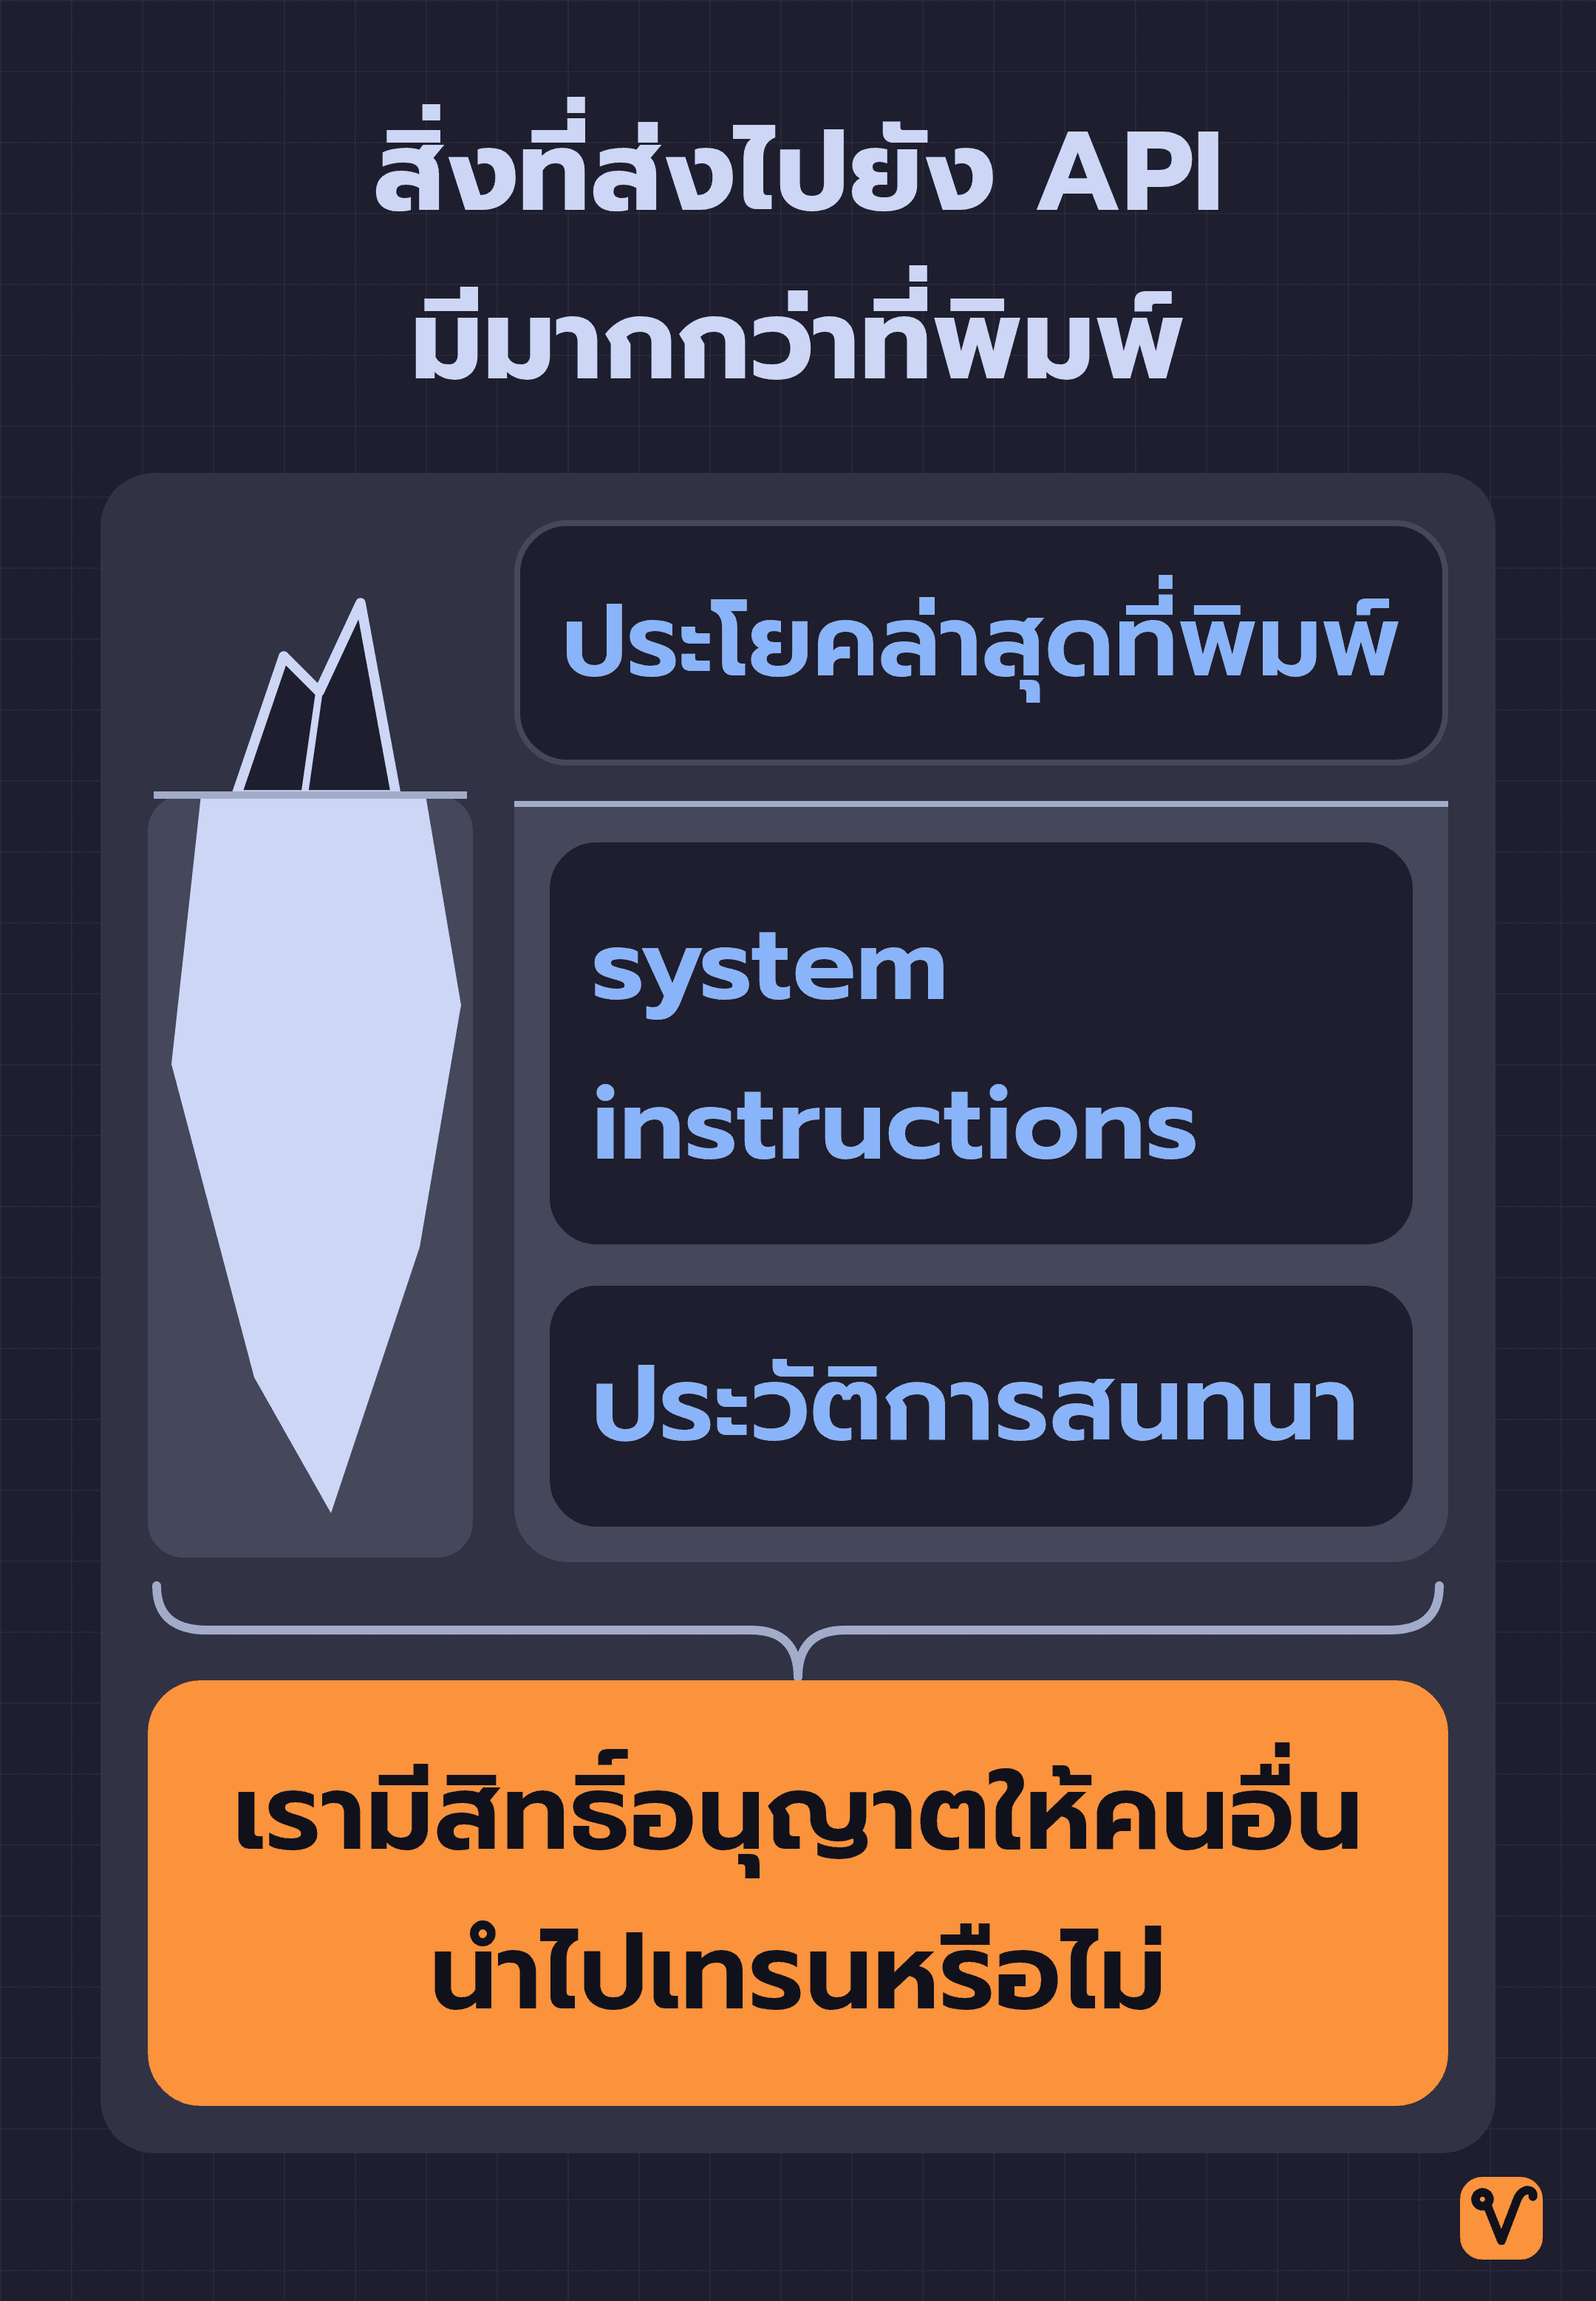
ถ้าตัดเรื่องราคาออกไป การเลือกว่าจะใช้ tier ไหน เหลือคำถามสำคัญเพียงข้อเดียว คือเรามีสิทธิ์อนุญาตให้คนอื่นนำข้อมูลชิ้นนี้ไปเทรนโมเดลหรือไม่
ถ้าข้อมูลนั้นเป็นกรรมสิทธิ์ของเราเองโดยสมบูรณ์ก็ตัดสินใจได้ง่ายมาก เช่น โค้ดโอเพนซอร์สส่วนตัว งานเขียนเล่นฝึกฝีมือ หรือข้อมูลทดสอบที่แต่งขึ้นมาเอง ข้อมูลกลุ่มนี้ส่งเข้า contributor tier ได้เลย เพราะเราเป็นเจ้าของสิทธิ์ที่อนุญาตด้วยตัวเอง
ในทางกลับกัน ข้อมูลที่เราถืออยู่เพื่อใช้งานโดยไม่ได้เป็นเจ้าของสิทธิ์ที่แท้จริง จะต้องใช้ standard tier เท่านั้น ได้แก่
- โค้ดของลูกค้าหรือของบริษัท เราได้รับมาเพื่อทำงานให้ ไม่ได้รับสิทธิ์นำไปส่งต่อหรืออนุญาตให้คนอื่นนำไปเทรน
- ข้อมูลส่วนบุคคลของผู้ใช้งาน เจ้าของข้อมูลที่แท้จริงคือผู้ใช้แต่ละคน ไม่ใช่เรา
- ข้อมูลที่มี API key หรือรหัสผ่านปนอยู่ เช่น บันทึกการทำงานของระบบ หรือไฟล์ตั้งค่าที่คัดลอกมาทั้งไฟล์
ข้อมูลทั้ง 3 กลุ่มนี้ใช้ contributor tier ไม่ได้เด็ดขาด เพราะเราไม่มีสิทธิ์ส่งต่อตั้งแต่แรก และไม่ว่าราคาจะถูกลงแค่ไหน ก็เปลี่ยนคำตอบข้อนี้ไม่ได้
สิ่งที่ต้องไม่ลืมคือ ข้อมูลที่ส่งไปยัง API ไม่ได้มีแค่ประโยคล่าสุดที่เราพิมพ์ เอกสารค่าบริการของ Meta ระบุชัดเจนว่า input ของแต่ละ request นับรวม system instructions ซึ่งเป็นชุดคำสั่งตั้งต้นของระบบ และประวัติการสนทนาด้วย คำถามเรื่องสิทธิ์ในการใช้ข้อมูลจึงต้องครอบคลุมทุกอย่างที่ส่งไปพร้อมกับ request
เมื่อตอบคำถามนี้ได้ ต้นทุนและเงื่อนไขของแต่ละฝั่งจะชัดเจนทันที ถ้าเลือก contributor จะได้ราคาที่ถูกกว่าหลายเท่า แลกกับเพดาน 100 request ต่อนาทีและข้อมูลที่ Meta นำไปเทรนได้ แต่ถ้าเลือก standard แม้ต้องจ่ายราคาเต็ม ก็จะได้เพดานการใช้งานที่สูงกว่ามาก พร้อมคำยืนยันว่า Meta จะไม่นำข้อมูลของเราไปเทรน
สำหรับองค์กรที่ต้องการให้ Meta ไม่เก็บข้อมูลไว้เลย บล็อกเปิดตัว Muse Code ของ Meta เมื่อเดือนสิงหาคม 2026 ระบุว่าเริ่มเปิดรับคำขอนโยบายไม่เก็บข้อมูลอย่าง Zero Data Retention ผ่านฝ่ายขายแล้ว
เรียกใช้ Muse Spark API ด้วยโค้ดเดิม
โค้ดที่เขียนด้วย OpenAI SDK หรือ Anthropic SDK สามารถย้ายมาใช้ Muse Spark ได้ โดยเปลี่ยนแค่ base URL กับ key ซึ่งฝั่ง OpenAI SDK มีจุดที่ต้องแก้เพียง 3 จุด
จุดแรกคือเปลี่ยน Base URL เป็น https://api.meta.ai/v1 จุดที่สองคือดึง API key จากตัวแปรสภาพแวดล้อมชื่อ MODEL_API_KEY และจุดสุดท้ายคือระบุ Model ID ที่ต้องการ
ตัวอย่างโค้ดภาษา Python จากหน้า Quickstart ของ Meta เป็นดังนี้
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.meta.ai/v1",
    api_key=os.environ["MODEL_API_KEY"],
)

response = client.responses.create(
    model="muse-spark-1.3",
    input="What is the capital of France?",
)

print(response.model_dump_json(indent=2))จากโค้ดด้านบน บรรทัด base_url จะส่งคำขอไปยังเซิร์ฟเวอร์ของ Meta แทน OpenAI ส่วน api_key ต้องส่งเข้าไปตรงๆ แบบนี้ เพราะ OpenAI SDK จะไม่อ่านตัวแปร MODEL_API_KEY ให้อัตโนมัติ
บรรทัดที่สำคัญที่สุดคือ model="muse-spark-1.3" เพราะนี่คือจุดสลับ tier เพียงจุดเดียว ถ้าเปลี่ยนเป็น muse-spark-1.3-contributor เมื่อไร request นั้นจะคิดราคาแบบ contributor ทันที และ Meta จะมีสิทธิ์นำข้อมูลไปเทรนโมเดล โดยไม่มีสวิตช์หรือการตั้งค่าอื่นให้กดอีก
ด้วยเหตุนี้ เราจึงควรเก็บ Model ID ไว้ที่เดียว เช่น ในตัวแปรสภาพแวดล้อม หรือไฟล์ตั้งค่ากลางของแอป อย่าพิมพ์ค่าฝังตายตัวไว้ตามไฟล์ต่างๆ เพราะถ้าฝังไว้หลายจุด วันที่ต้องย้ายไป standard ก็ต้องตามแก้ทุกจุด และจุดที่ตกหล่นก็จะยังคงส่งข้อมูลเข้า contributor tier ต่อไปเงียบๆ
การพิมพ์ Model ID ผิดยังสังเกตได้ง่ายกว่า เพราะ API จะตอบกลับเป็น 404 model_not_found ให้รู้ตัวทันที แต่จุดที่ลืมแก้ ระบบยังทำงานได้ตามปกติทุกอย่าง ทำให้เราไม่รู้ตัวเลยว่ากำลังส่งข้อมูลออกไป
สำหรับเครื่องมือที่มีช่องให้ใส่ Base URL เช่น LangChain, LlamaIndex, Vercel AI SDK และ Continue ก็ใช้วิธีเดียวกันตามที่หน้า Quickstart แนะนำ คือใส่ https://api.meta.ai/v1 แล้วเลือก Model ID
สำหรับ Claude Code โปรแกรมช่วยเขียนโค้ดของ Anthropic ที่เชื่อมต่อผ่าน Messages API ตัวโปรแกรมจะชี้ไปที่ https://api.meta.ai พร้อมใส่ MODEL_API_KEY จุดนี้มีโอกาสพลาดได้ง่าย เพราะ URL ที่ Claude Code ใช้นั้น ไม่มี /v1 ต่อท้าย ต่างจาก URL ที่ใช้กับ OpenAI SDK และเครื่องมือในย่อหน้าก่อน
ขณะที่ OpenCode โปรแกรมช่วยเขียนโค้ดด้วย AI บน terminal ก็มีตัวอย่างไฟล์ตั้งค่าแบบละเอียดอยู่ใน Quickstart โดยบรรทัดสำคัญที่ห้ามลืมใส่คือ "include": ["reasoning.encrypted_content"] ค่านี้จะช่วยให้โมเดลจำลำดับความคิดจากรอบก่อนหน้ามาคิดต่อในรอบถัดไปได้ ถ้าไม่ใส่ไว้ โมเดลจะเริ่มคิดใหม่ทุกรอบ และอาจหลุดบริบทในงานที่มีหลายขั้นตอนต่อเนื่อง
Token ภาษาไทยกับการประเมินงบประมาณก่อนเริ่มใช้จริง
เรื่องที่คนใช้ภาษาไทยควรรู้คือ เอกสารคิดค่าบริการของ Meta ระบุว่า 1 token เทียบเท่ากับตัวอักษรภาษาอังกฤษประมาณ 3-4 ตัว แต่สำหรับภาษาอื่นๆ และโค้ด มักใช้จำนวน token ต่อคำมากกว่าภาษาอังกฤษ
ดังนั้น งานแบบเดียวกันถ้าสั่งเป็นภาษาไทย จึงอาจมีค่าใช้จ่ายสูงกว่าตอนสั่งเป็นภาษาอังกฤษ ก่อนจะประเมินงบประมาณ แนะนำให้ลองส่ง request ตัวอย่างด้วยภาษาจริงที่แอปต้องใช้ แล้วเข้าไปดูในหน้า Usage Dashboard ว่าใช้ token ไปเท่าไร อย่าเพิ่งประเมินงบโดยอิงจากตัวเลขของภาษาอังกฤษ
นอกจากนี้ ยังมีอีก 4 เรื่องที่จะช่วยให้คุมงบประมาณได้อยู่หมัด ไม่บานปลายในภายหลัง
- ไม่มีค่าบริการเพิ่มเมื่อ Context ยาว: คิดค่าบริการในอัตราเดิมเสมอ ไม่ว่า Context Window จะว่างหรือใกล้เต็มความจุ
- Web Search คิดเพิ่ม $2.50 ต่อการค้นหา 1,000 ครั้ง: เป็นค่าค้นหาเว็บที่บวกเพิ่มจากค่า token ปกติของ request นั้น
- Steering Context ฟรี ไม่คิดเงิน: ข้อความคำสั่งตั้งต้นสั้นๆ ที่ Meta แทรกเข้าไปในทุก prompt จะไม่นับรวมใน token ที่นำมาคิดเงิน
- รอบตัดบัตรมี 2 เงื่อนไข: ระบบจะตัดเงินจากบัตรเมื่อยอดค้างชำระถึงเกณฑ์ที่บัญชีกำหนดไว้ หรือตัดรอบในวันที่ 1 ของทุกเดือน
ถ้าใช้จนเกินเพดาน Rate Limit API จะตอบกลับเป็นสถานะ HTTP 429 วิธีรับมือที่ Meta แนะนำคือการเว้นระยะเวลารอแบบ Exponential Backoff with Jitter โดยเริ่มจากการรอน้อยๆ เช่น 500 มิลลิวินาที แล้วค่อยๆ เพิ่มเวลารอเป็นสองเท่าทุกครั้งที่ยังติดเพดาน พร้อมสุ่มเวลาเพิ่มอีกเล็กน้อย เพื่อป้องกันไม่ให้คำขอจากหลายฝั่งยิงกลับมาพร้อมกันในจังหวะเดียว
แต่วิธีที่ดีกว่าคือการป้องกันไม่ให้ชนเพดานตั้งแต่แรก ในทุก response ที่ส่งสำเร็จจะมี header กลุ่ม x-ratelimit-* แนบกลับมาด้วย สองค่าที่ควรจับตาคือ x-ratelimit-remaining-tokens ซึ่งบอกจำนวน token ที่ยังเหลืออยู่ก่อนถึงเพดาน และ x-ratelimit-remaining-requests ที่บอกจำนวน request ที่เหลือในรอบเวลานั้น เราอ่านค่าทั้งสองนี้เพื่อชะลอการส่งคำขอก่อนจะชนเพดานได้ ซึ่งสำคัญอย่างยิ่งสำหรับ contributor tier ที่มีโควตาจำกัดเพียง 100 request ต่อนาที
เริ่มที่ -contributor แล้วค่อยเปลี่ยนก่อนเจอข้อมูลจริง
แนวทางปฏิบัติที่เริ่มได้ทันทีคือ สร้างระบบต้นแบบบน muse-spark-1.3-contributor โดยใช้ข้อมูลจำลองทั้งหมด ทั้งชื่อลูกค้าปลอม ข้อมูลทดสอบที่แต่งขึ้นเอง หรือโค้ดตัวอย่าง ซึ่งช่วงนี้ราคาจะถูกและคุ้มค่าที่สุด เพราะยังไม่มีข้อมูลจริงของใครให้ต้องกังวล
จากนั้นให้เปลี่ยน Model ID ในไฟล์ตั้งค่าจุดเดียวนั้นเป็น muse-spark-1.3 ก่อนข้อมูลจริงชิ้นแรกจะเข้าระบบ
วันที่เราต้องเปลี่ยนมาใช้ standard tier จึงไม่ใช่วันที่บิลแพงขึ้น แต่เป็นวันที่ข้อมูลชิ้นแรกที่ไม่ใช่ของเราเข้ามาในระบบ
ที่มา: เอกสารทางการของ Meta Model API
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin