งานวิจัย SkillSeek ลองให้ AI agent ใช้ skill ครบ 192 ตัว ได้คะแนนแทบเท่าตอนไม่ใส่สักตัว แต่เปลือง token เพิ่ม 59%
งานวิจัย SkillSeek วัดว่า AI agent ควรเลือก skill ยังไง วิธีค้นมาตรฐานที่ไม่เสีย token ให้โมเดลภาษา เลือกได้ใกล้เคียงกับให้ AI ค้นเอง แต่จ่ายราวครึ่งเดียว
skill หรือชุดคำสั่งที่สอนงานเฉพาะทางให้ระบบผู้ช่วยอัตโนมัติอย่าง AI agent ตอนนี้นับรวมกันได้ 238,180 ตัวแล้ว แต่ในการทดลองของงานวิจัย SkillSeek การคัด skill ที่ตรงกับงานมาให้แค่ 1 ถึง 3 ตัว ช่วย agent ได้มากกว่าการใส่ไปทั้งหมด
ถ้าคุณเป็นคนหนึ่งที่ติดตั้ง skill ใน Claude Code หรือ Codex โปรแกรมช่วยเขียนโค้ดด้วย AI ไว้เป็นสิบหรือเป็นร้อยตัว งานวิจัยนี้น่าจะเป็นเหตุผลที่ดีให้คุณกลับไปเช็กรายการ skill เหล่านั้นอีกครั้ง
งานวิจัย SkillSeek จัดทำโดย Guanqun Yang, Wenlong Zhang, Tian Shi และ Ping Wang จาก Stevens Institute of Technology เผยแพร่บน arXiv เมื่อวันที่ 30 กันยายน 2026 และได้รับเลือกให้ตีพิมพ์ในงานประชุมวิชาการ AACL-IJCNLP 2026 โดยผู้เขียนหลักยังได้สรุปประเด็นสำคัญด้วยภาษาที่เข้าใจง่ายไว้บน Hugging Face Papers
ในเมื่อใครๆ ก็สร้าง skill ขึ้นมาได้ คลัง skill จึงเติบโตอย่างรวดเร็ว ปัญหาในตอนนี้จึงกลายเป็นการเลือกว่าจะหยิบตัวไหนมาใช้ งานวิจัยชิ้นนี้ตั้งใจตอบคำถามสำคัญ 2 ข้อ ข้อแรกคือ ถ้าเราไม่เลือกเลย แต่ใส่ skill ทั้งหมดลงไปพร้อมกัน ผลลัพธ์จะเป็นอย่างไร และข้อสองคือ ถ้าจำเป็นต้องเลือก เราควรให้ AI ค้นหาเอง หรือใช้วิธีค้นหาแบบมาตรฐานที่ไม่ต้องจ่าย token หรือหน่วยนับข้อความที่ใช้คิดเงินจริง ให้โมเดลภาษาดีกว่ากัน?
ใส่ skill ครบ 192 ตัว แต่คะแนนแทบไม่ขยับ
วิธีที่ดูง่ายที่สุดคือไม่ต้องเลือกอะไรเลย เพราะโมเดลภาษาในปัจจุบันมี context window หรือพื้นที่รับข้อความกว้างพอที่จะใส่ skill ทั้งหมดลงไปได้พร้อมกัน ผู้เขียนจึงลองทำแบบนั้นในการทดลองนำร่อง ซึ่งแยกไว้ในภาคผนวก F ของรายงานวิจัย
การทดสอบนี้ใช้ชุดโจทย์จาก SkillsBench จำนวน 89 งาน ซึ่งแต่ละงานมีชุดทดสอบอัตโนมัติคอยวัดผล โดยใช้คลัง skill 192 ตัว ให้ agent ทำทุกงานซ้ำ 3 รอบใน 3 เงื่อนไข แล้วนับจำนวน token ที่ใช้ต่อรอบ
| เงื่อนไข | คะแนน | token ต่อรอบ |
|---|---|---|
| ไม่ใส่ skill เลย | 38.4% | 268K |
| ใส่ครบทั้ง 192 ตัว | 38.7% | 426K (+59%) |
| ใส่เฉพาะตัวที่ตรงงาน 1 ถึง 3 ตัว | 48.4% | 314K (+17%) |
ผลคือการใส่ skill ครบทั้ง 192 ตัวแทบไม่ได้ช่วยให้คะแนนดีขึ้นเลย (ขยับจาก 38.4% เป็น 38.7%) แต่กลับเปลือง token เพิ่มขึ้นถึง 59% ต่อรอบ ในทางกลับกัน การเลือกใส่เฉพาะ skill ที่ตรงกับงาน 1 ถึง 3 ตัว ช่วยดันคะแนนขึ้นไปถึง 48.4% โดยใช้ token เพิ่มขึ้นเพียง 17% เท่านั้น
มีข้อควรระวังในการอ่านตัวเลขนี้ คือคะแนนในตารางเป็นคะแนนเฉลี่ยจากชุดทดสอบของทั้ง 89 งาน งานไหนทำสำเร็จบางส่วนก็ได้คะแนนตามสัดส่วน จึงไม่ได้หมายความว่า agent ทำงานสำเร็จ 38.4% ของจำนวนงานทั้งหมด
ผู้เขียนระบุเองว่า การทดลองนี้เป็นเพียงหลักฐานสนับสนุนเบื้องต้น ไม่ใช่ข้อสรุปหลัก เพราะเป็นการทดลองนำร่องที่ทำก่อนการทดลองใหญ่ และใช้โมเดล gpt-oss-120b เพียงตัวเดียว นอกจากนี้ ผู้เขียนยังยอมรับว่าโมเดลรุ่นที่เก่งกว่านี้อาจจัดการกับ skill ทั้งหมดได้ดีกว่า
อย่างไรก็ตาม แนวโน้มเดียวกันนี้ก็ปรากฏในตัวเลขของ SkillsBench ที่งานวิจัยนำมาอ้างอิงด้วย คือใส่ skill ที่เกี่ยวข้อง 1 ตัว คะแนนเพิ่มขึ้น 17.8% ใส่ 2 ถึง 3 ตัว คะแนนเพิ่มขึ้น 18.6% แต่พอใส่ตั้งแต่ 4 ตัวขึ้นไป ส่วนที่เพิ่มขึ้นกลับเหลือเพียง 5.9%
แปลว่าแค่ skill เกี่ยวข้องยังไม่พอ แต่ตัวที่เลือกมาต้องตรงกับเนื้องานจริงๆ และต้องไม่ใส่มากเกินความจำเป็น
คอขวดเปลี่ยนจากการมี skill มาอยู่ที่การเลือกใช้
ยิ่งมี skill ให้เลือกเยอะ การเลือกตัวที่เหมาะสมก็ยิ่งยากขึ้น ตัวเลขที่สะท้อนปัญหานี้ได้ชัดเจนมาจากงานวิจัยของ Liu และคณะ ที่งานชิ้นนี้นำมาเปรียบเทียบ
ในการทดลองนั้น โมเดล Claude Opus 4.6 ทำคะแนนได้ 51.2% เมื่อได้ skill ที่คัดมาตรงกับงานเรียบร้อยแล้ว แต่คะแนนกลับลดลงเหลือ 40.1% เมื่อต้องค้นหา skill เองจากคลังที่มีอยู่ราว 34,000 ตัว ทั้งที่เป็นโมเดลตัวเดิม จุดต่างเพียงอย่างเดียวคือมี skill ที่คัดมาให้พร้อมใช้ หรือต้องไปงมหาเองจากคลังขนาดใหญ่
ทางแก้ที่งานวิจัยสายนี้นิยมใช้คือ ให้ AI ค้นหาเอง โดยตัว AI จะเขียนคำค้นหาใหม่ ไล่ดูตัวเลือกที่พบ แล้วนำข้อมูลมาประกอบกันเป็น skill ใหม่สำหรับงานนั้นโดยเฉพาะ
วิธีนี้ได้ผลจริง เพราะในงานของ Liu และคณะ ช่วยดึงคะแนนของ Claude Opus 4.6 กลับขึ้นมาเป็น 48.2% ได้ แต่ข้อเสียคือ ทุกงานจะต้องจ่าย token ให้ AI ค้นหาก่อนรอบหนึ่งเสมอ แม้จะเป็นงานง่ายๆ ที่ไม่จำเป็นต้องค้นหาแบบนี้เลยก็ตาม
งานวิจัยชิ้นนี้จึงตั้งคำถามตรงๆ ว่า ถ้าเราเปลี่ยนไปใช้วิธีค้นหาแบบมาตรฐานที่ไม่ต้องจ่าย token ให้โมเดลภาษา ผลลัพธ์จะด้อยกว่ากันแค่ไหน?
BM25 วิธีค้นหายุค 1990s ที่ตามทันการให้ AI ค้นเอง
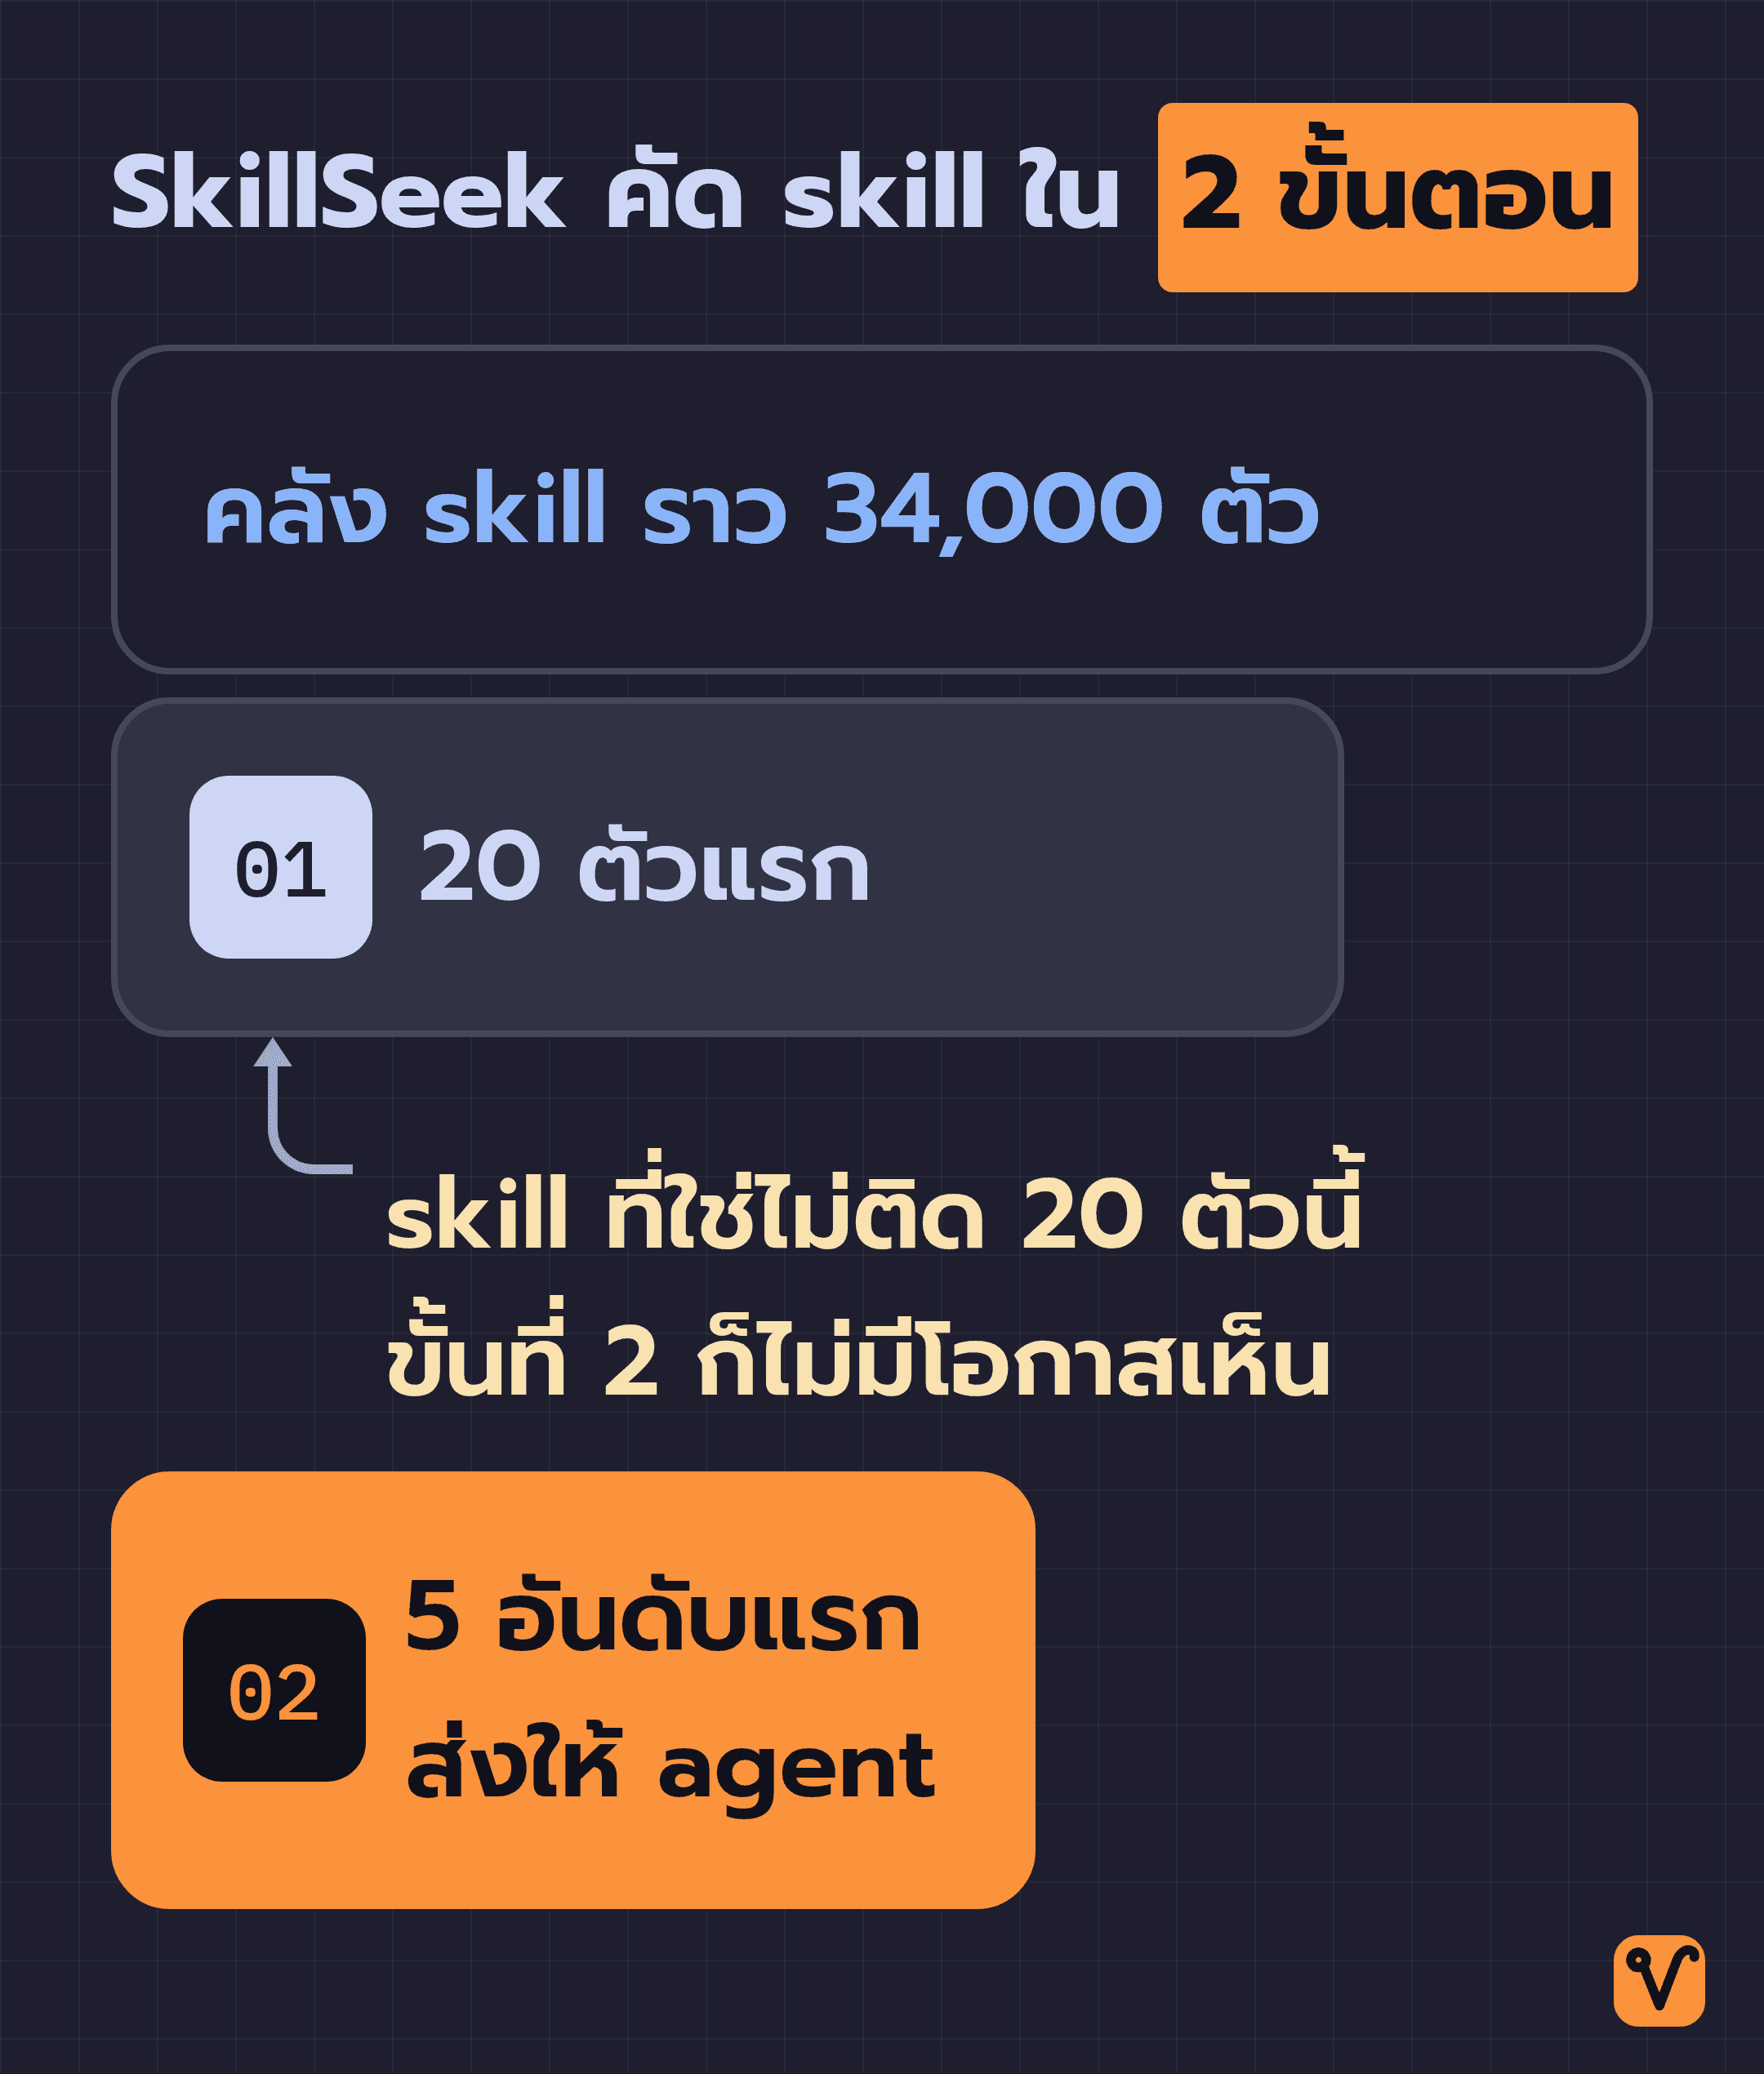
การทดลองหลักเปรียบเทียบวิธีเลือก skill ทั้งหมด 11 วิธี ใน 4 สถานการณ์ โดยจับคู่คลัง skill 2 ขนาดกับโมเดล 2 ตัว คลังขนาดเล็กมี 192 ตัว (คัดมาแล้วว่ามีตัวที่ตรงกับงาน) ส่วนคลังขนาดใหญ่มีราว 34,000 ตัวจากตลาด skill จริง โมเดลที่ใช้คือ Qwen3.5-397B-A17B และ MiniMax-M2.7 ทุกสถานการณ์ใช้ 89 งานจาก SkillsBench และใช้ชุดทดสอบเดิมตัดสินผล
หนึ่งใน 11 วิธีนั้นคือ BM25 วิธีค้นหาด้วยการจับคู่คำสำคัญตั้งแต่ยุค 1990 ระบบนี้ไม่มี AI อยู่ข้างในเลย โดยจะให้คะแนน skill แต่ละตัวว่าตรงกับคำค้นหาแค่ไหน คล้ายกับการกด Ctrl+F หาคำในคำอธิบายของทุก skill แล้วเรียงตัวที่เจอคำตรงกันมากที่สุดขึ้นมาก่อน
อีกวิธีคือ SkillSeek ระบบค้นหาที่ผู้เขียนพัฒนาขึ้นจากวิธีค้นหามาตรฐานของงาน Information Retrieval โดยทำงาน 2 ขั้นตอน เมื่อ agent ส่งคำค้นหามาเป็นภาษาทั่วไป ขั้นแรกระบบจะนำคำค้นหาไปเทียบความหมายกับชื่อ คำอธิบาย และแท็กสรุปของ skill ทั้งหมดอย่างรวดเร็ว แล้วคัดเลือกไว้ 20 ตัวแรก
จากนั้นในขั้นตอนที่สอง ระบบจะใช้โมเดลจัดอันดับขนาดเล็ก อ่านรายละเอียดของ skill ทั้ง 20 ตัวคู่กับคำค้นหาอย่างละเอียด แล้วส่ง 5 อันดับแรกกลับไปให้ agent โดย agent จะดึงเนื้อหาฉบับเต็มของ skill มาอ่านก็ต่อเมื่อต้องการใช้งานจริงเท่านั้น
ระบบทั้งหมดเชื่อมต่อเข้ากับ agent ผ่าน MCP มาตรฐานกลางสำหรับเชื่อมเครื่องมือภายนอกเข้ากับ AI โดย agent จะมองเห็นเครื่องมือ 3 ตัว คือ skill_lookup สำหรับค้นหา, skill_load สำหรับโหลดเนื้อหาฉบับเต็ม และ skill_list สำหรับดูรายชื่อพร้อมคำอธิบายทั้งหมด
| สถานการณ์ | BM25 | ให้ AI ค้นเอง |
|---|---|---|
| คลังเล็ก 192 ตัว · Qwen3.5 | 43.0% | 39.7% |
| คลังเล็ก 192 ตัว · MiniMax | 38.7% | 34.4% |
| คลังใหญ่ 34,000 ตัว · MiniMax | 34.6% | 32.9% |
| คลังใหญ่ 34,000 ตัว · Qwen3.5 | 42.0% | 44.2% |
ผลปรากฏว่า BM25 ทำคะแนนได้สูงกว่าการให้ AI ค้นหาเองถึง 3 ใน 4 สถานการณ์ มีเพียงแถวสุดท้ายแถวเดียวที่การให้ AI ค้นหาเองนำอยู่เล็กน้อยที่ 44.2% ต่อ 42.0% แต่ในแถวเดียวกันนั้น SkillSeek รุ่นที่ใช้โมเดลจัดอันดับขนาดเล็กก็ทำได้ 44.2% เท่ากันพอดี
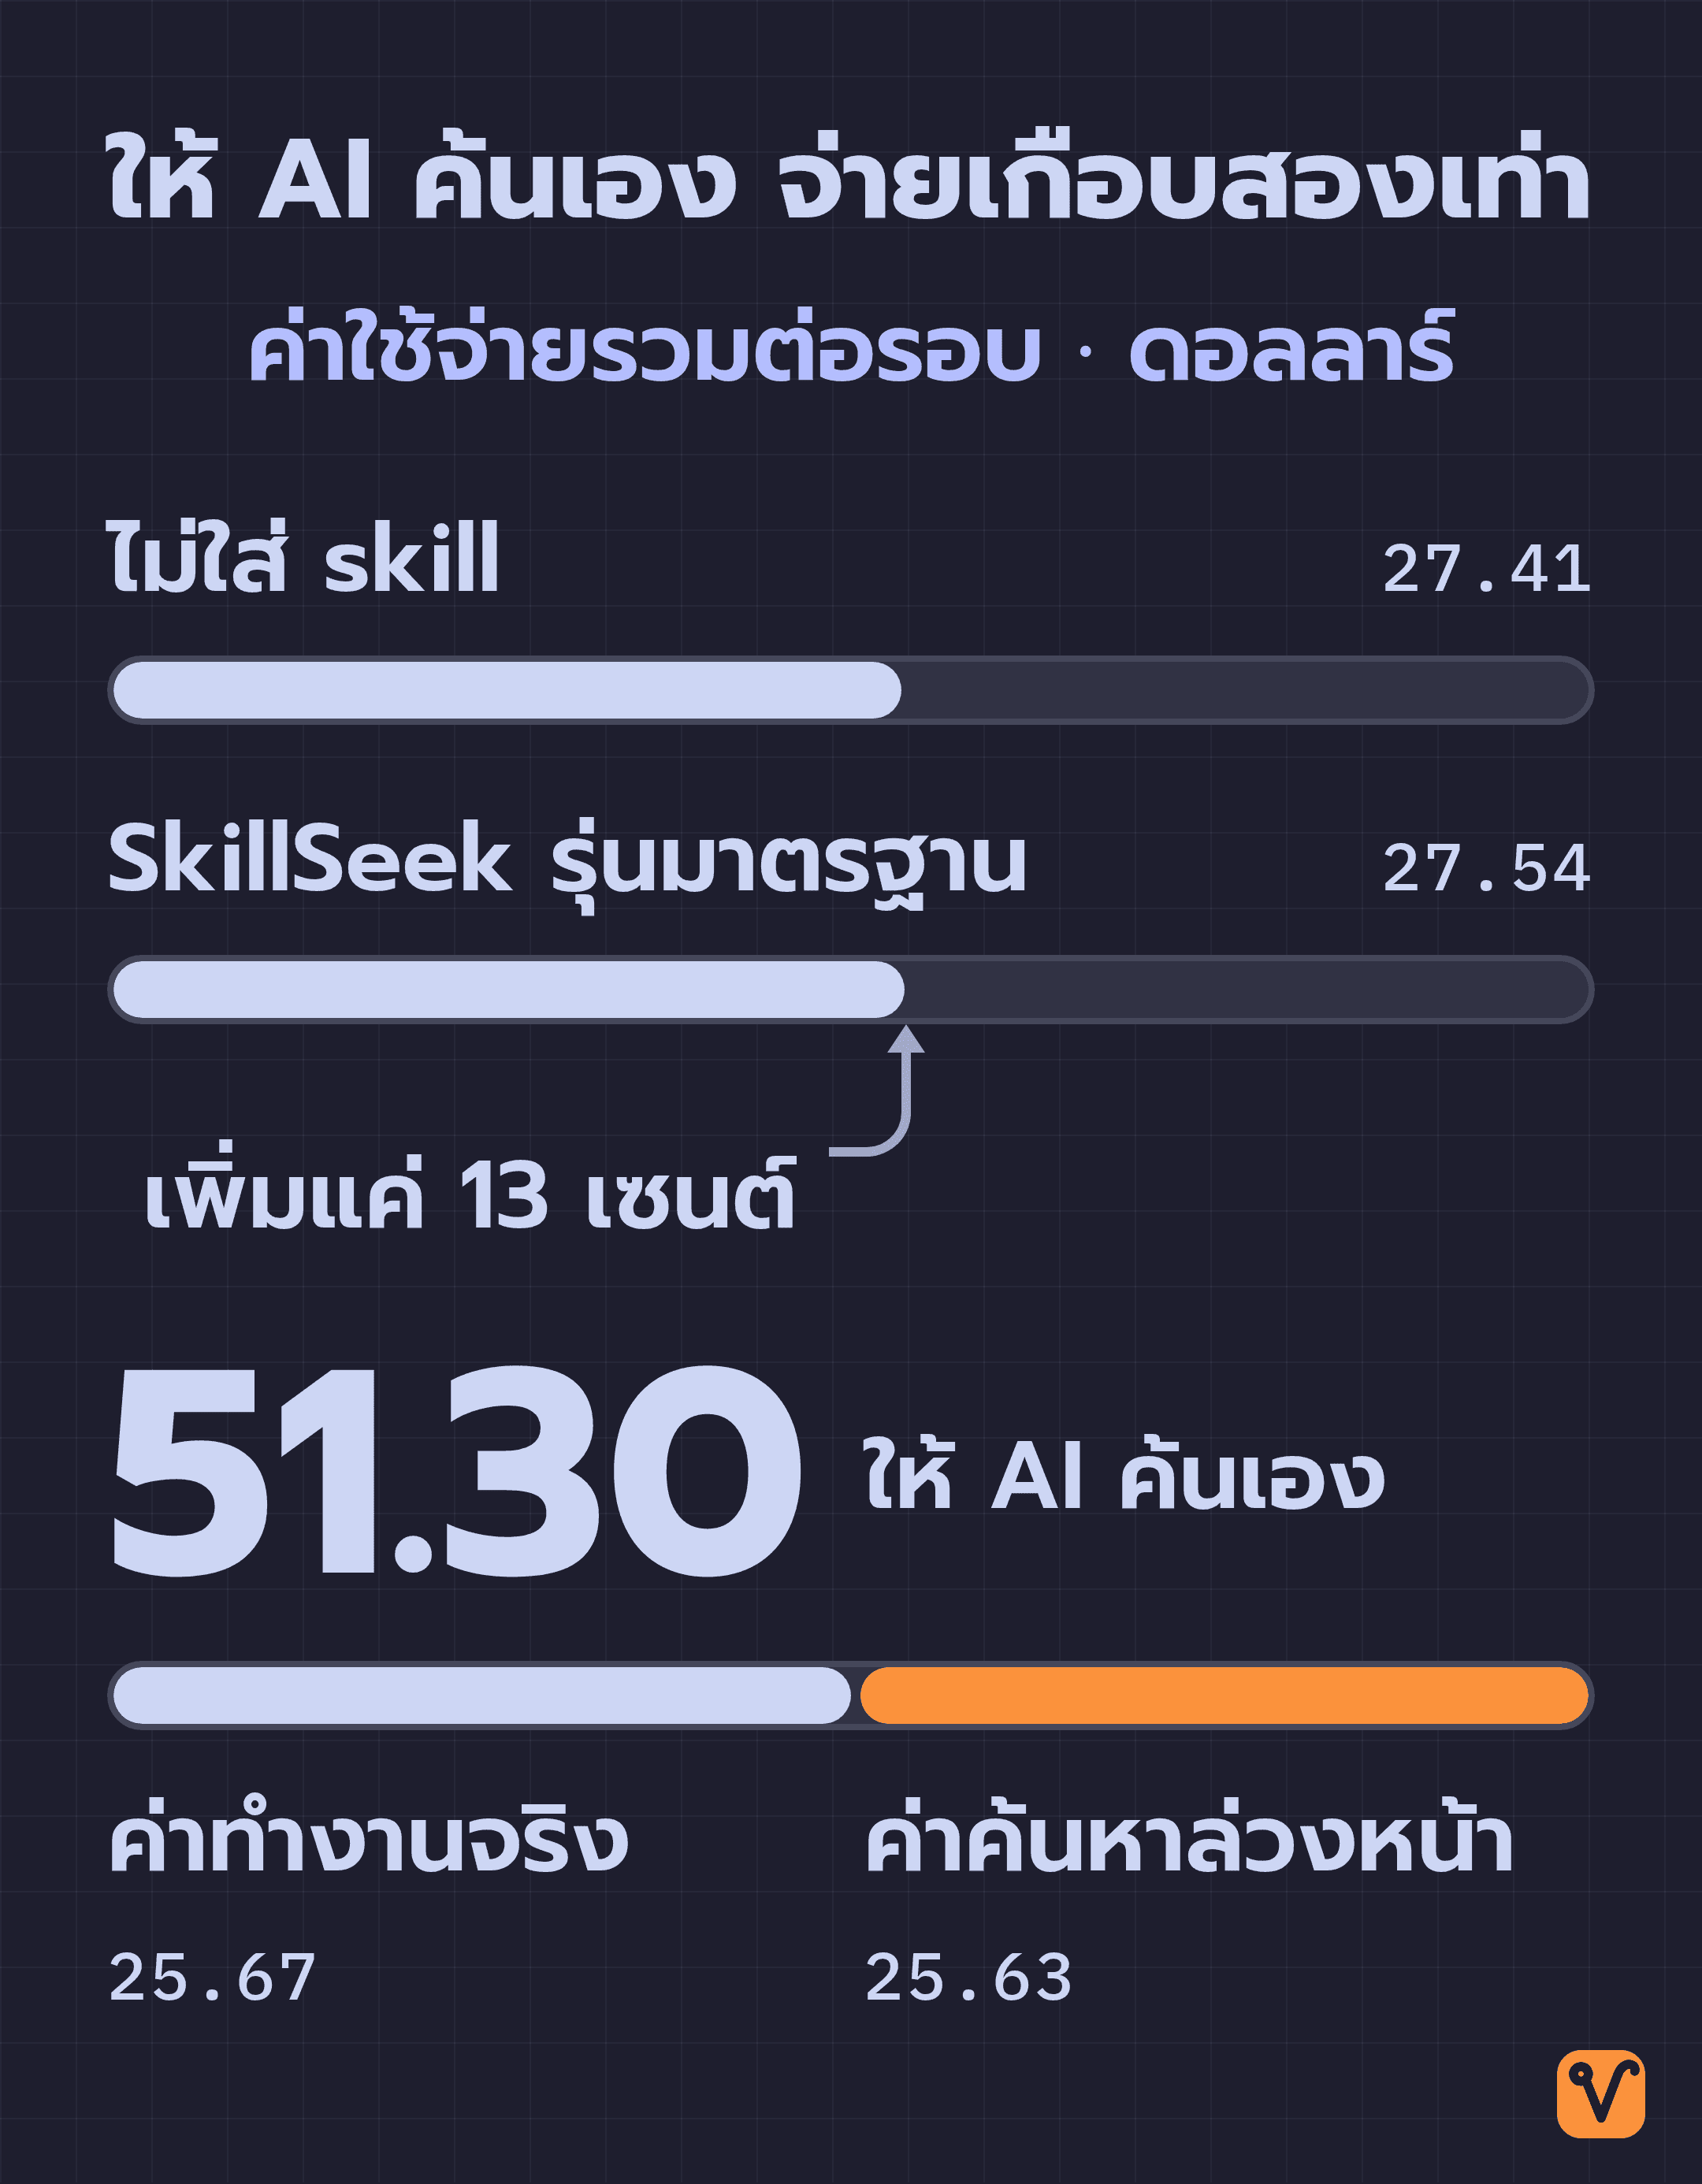
สิ่งที่ต่างกันอย่างเห็นได้ชัดคือค่าใช้จ่าย ในรอบที่ไม่ใส่ skill เลย ค่าใช้จ่ายรวมอยู่ที่ 27.41 ดอลลาร์ ถ้าใช้ SkillSeek รุ่นมาตรฐาน ค่าใช้จ่ายจะอยู่ที่ 27.54 ดอลลาร์ หรือเพิ่มขึ้นเพียง 13 เซนต์เท่านั้น ขณะที่การให้ AI ค้นหาเอง ค่าใช้จ่ายพุ่งไปถึง 51.30 ดอลลาร์ หรือเกือบสองเท่า
เมื่อแยกค่าใช้จ่าย 51.30 ดอลลาร์ของการให้ AI ค้นหาเองออกมาดู จะพบว่าเป็นค่า token ที่ AI ใช้ค้นหาและปรับแต่ง skill ล่วงหน้าถึง 25.63 ดอลลาร์ ส่วนอีก 25.67 ดอลลาร์เป็นค่าทำงานจริง
SkillSeek แทบไม่เพิ่มค่าใช้จ่ายเลย เพราะระบบทำงานบน CPU ใช้เวลาค้นหาประมาณ 1.1 วินาทีต่อครั้ง และไม่เสีย token ของโมเดลภาษาเลยแม้แต่น้อย
จุดนี้อาจทำให้สับสนได้ เพราะในงานวิจัยมี SkillSeek หลายรุ่น โดยรุ่นที่ทำคะแนนได้ 44.2% ในแถวสุดท้าย คือรุ่นที่ใช้ Qwen3-Reranker-0.6B เป็นโมเดลจัดอันดับ ส่วนรุ่นมาตรฐานที่เสียค่าใช้จ่าย 27.54 ดอลลาร์ทำคะแนนในแถวนั้นได้ต่ำกว่า คือเพิ่มคะแนนจากตอนไม่ใส่ skill ได้ 5.7% ขณะที่การให้ AI ค้นเองเพิ่มได้ 9.0% ถึงอย่างนั้น ทั้งสองรุ่นก็ทำงานบน CPU และไม่ใช้ token ของโมเดลภาษาเหมือนกัน
สถานการณ์ไหนที่การให้ AI ค้นเองคุ้มค่ากับเงินที่จ่าย
ผู้เขียนย้ำในบทความสรุปว่า ไม่ได้มองว่าการให้ AI ค้นหาเองเป็นเรื่องที่ผิด เพียงแต่ควรเป็นทางเลือกสำรอง ส่วนวิธีที่ควรลองใช้ก่อนคือวิธีค้นหาแบบมาตรฐาน
ข้อดีของการให้ AI ค้นหาเองนั้นมีอยู่จริง และจะเห็นประโยชน์ชัดเจนใน 2 กรณี
กรณีแรก คืองานที่จำเป็นต้องผสมผสานหลาย skill เข้าด้วยกัน ตัวอย่างที่งานวิจัยยกมาจากงานของ Liu และคณะ คือการแบ่งก้อนข้อมูลตัวเลขอย่าง tensor ไปรันบน GPU หลายตัว ตอนนั้น agent ค้นเจอ skill ที่เกี่ยวข้องแค่บางส่วน 2 ตัว ได้แก่ torch-tensor-parallel กับ pytorch-research แล้วนำมารวมกันเป็น skill ใหม่ขึ้นมา ซึ่งไม่มี skill ตัวไหนทำได้ด้วยตัวเอง ลำพังระบบค้นหาแบบมาตรฐานทำแบบนี้ไม่ได้ เพราะทำได้แค่หยิบ skill ที่มีอยู่แล้วมาจัดเรียงเท่านั้น
กรณีที่สอง คือคลัง skill มีขนาดใหญ่มาก ระบบค้นหาแบบ 2 ขั้นตอนมีจุดอ่อนอยู่ที่ขั้นตอนแรก ถ้าขั้นตอนแรกคัดเลือก skill ที่ถูกต้องไม่ติด 1 ใน 20 ตัวแรก ต่อให้โมเดลจัดอันดับในขั้นตอนที่สองจะเก่งแค่ไหน ก็ไม่มีโอกาสได้เห็น skill นั้นเลย ผู้เขียนชี้ว่าข้อจำกัดตรงนี้คือจุดที่การให้ AI ค้นหาเองเริ่มคุ้มค่ากับเงินที่จ่าย และช่วยอธิบายผลการทดสอบในคลังขนาด 34,000 ตัว
สำหรับคนที่กำลังพัฒนา agent หรือสร้าง harness โครงสร้างโปรแกรมห่อหุ้มโมเดลเพื่อให้ทำงานเป็น agent ได้ขึ้นมาเอง แนวทางจึงค่อนข้างชัดเจน คือเริ่มต้นด้วยวิธีค้นหาแบบมาตรฐานที่แทบไม่เสียเงินเพิ่ม แล้วค่อยเปิดให้ AI ค้นหาเองเมื่อคลัง skill มีขนาดใหญ่มากจนระบบขั้นแรกหาไม่เจอ หรือเมื่องานนั้นซับซ้อนจนต้องผสม skill หลายตัวเข้าด้วยกัน
แต่ละทางมีสิ่งที่ต้องแลกต่างกัน วิธีค้นหาแบบมาตรฐานผสม skill ไม่ได้ ส่วนการให้ AI ค้นหาเองต้องจ่าย token ในทุกงาน แม้งานนั้นไม่ต้องผสมอะไรเลย ค่าใช้จ่ายรวมต่อรอบจึงสูงเกือบสองเท่า
ข้อจำกัดที่ทีมวิจัยระบุไว้เอง
รายงานวิจัยระบุข้อจำกัดไว้หลายข้อ เป็นเรื่องที่ควรรู้ก่อนนำตัวเลขเหล่านี้ไปใช้อ้างอิง
- ผลลัพธ์ทั้งหมดมาจาก 89 งานของ SkillsBench บน harness โอเพนซอร์สเพียงตัวเดียวคือ OpenHands และทดสอบกับโมเดล 2 ตัวร่วมกับคลัง skill 2 ขนาดเท่านั้น ผู้เขียนจึงไม่ได้อ้างว่าวิธีค้นหาแบบมาตรฐานจะเป็นตัวเลือกแรกที่ดีสำหรับงานทุกประเภท
- การทดลองหลักรันเพียงรอบเดียวในแต่ละเงื่อนไข ผู้เขียนลองรันซ้ำในสถานการณ์หนึ่งจำนวน 3 รอบแล้วพบว่าผลคะแนนแกว่งประมาณ 1% จึงถือว่าส่วนต่างของคะแนนที่ต่ำกว่า 2% เป็นเพียงความผันผวนจากการรันแต่ละครั้ง
- ในฝั่งโมเดล MiniMax-M2.7 การทดสอบล่มไปราวครึ่งหนึ่งเนื่องจากปัญหาเครือข่ายหรือหมดเวลา ซึ่งระบบนับเป็นศูนย์ ผู้เขียนจึงใช้ผลของ Qwen3.5 เป็นตัวชี้วัดหลัก
- ระบบให้ AI ค้นหาเองที่นำมาใช้เปรียบเทียบ เขียนขึ้นใหม่ตามแนวคิดของ Liu และคณะ และส่วนที่ต่างจากต้นฉบับทำให้ทำงานได้จำกัดกว่าเดิม ผู้เขียนยอมรับว่าข้อนี้อาจทำให้ผลด้านความแม่นยำเอื้อประโยชน์ให้ SkillSeek แต่ด้านราคาจะกลับกัน เพราะถ้าใส่ความสามารถเดิมกลับเข้าไปครบ ค่าใช้จ่ายจะสูงกว่า 51.30 ดอลลาร์อย่างแน่นอน
ผู้เขียนสรุปผลหลักเพียงว่า ทั้งสองฝั่งทำคะแนนได้สูสีกันในการทดลองนี้ และไม่ได้อ้างว่าวิธีไหนเป็นผู้ชนะ
ตัว SkillSeek เองเป็นโค้ดที่มากับงานวิจัย ทีมวิจัยเปิดไว้ที่ guanqun-yang/SkillSeek บน GitHub พร้อมสคริปต์สำหรับรันซ้ำเพื่อสร้างตัวเลขทุกตัวในรายงานวิจัย ทั้งนี้ ผู้เขียนเตือนไว้ด้วยว่า ระบบทำหน้าที่แค่จัดอันดับ skill ตามความเกี่ยวข้องเท่านั้น ไม่ได้ตรวจความปลอดภัยของ skill ที่หยิบมา ถ้ามี skill ที่แฝงคำสั่งอันตรายอยู่ในคลัง ก็อาจติดอันดับขึ้นมาปะปนกับ skill ทั่วไปได้
สิ่งที่ควรรู้ก่อนติดตั้ง skill ตัวต่อไปใน Claude Code
จุดสำคัญที่ต้องแยกให้ชัดเจนก่อนนำผลวิจัยไปใช้ คือรายงานฉบับนี้ไม่ได้ทดสอบบน Claude Code หรือ Codex เลย เนื่องจากทั้งคู่เป็นระบบปิด ทำให้มองไม่เห็นกระบวนการค้นหาและเรียกใช้ skill ข้างใน
ตัวเลข token ที่เพิ่มขึ้น 59% พร้อมคะแนนที่แทบไม่ขยับในการทดลองนำร่องนั้น เกิดจากการใส่ skill ทั้งหมดลงใน context window ผ่าน OpenHands ร่วมกับโมเดล gpt-oss-120b จึงไม่ได้เป็นตัววัดว่าการติดตั้ง skill ไว้จำนวนมากใน Claude Code ของคุณจะเปลือง token หรือฉุดคะแนนลงมากน้อยแค่ไหน
สิ่งที่เรานำมาปรับใช้ได้จริงจึงเป็น 'หลักการ' ไม่ใช่ตัวเลขสถิติ หลักข้อแรก สิ่งที่ช่วยงานได้จริงคือ skill ที่ตรงกับงาน ไม่ใช่จำนวน skill ที่เราติดตั้งไว้
หลักข้อที่สองคือ agent เลือก skill จากคำอธิบาย ซึ่งมาตรฐาน Agent Skills ของ Anthropic ออกแบบมาให้ agent อ่านเฉพาะข้อมูลสรุปสั้นๆ ราว 30 token ของแต่ละ skill ตอนเริ่มงานเท่านั้น แล้วค่อยเปิดอ่านเนื้อหาฉบับเต็มเมื่อเห็นว่า skill นั้นเกี่ยวข้องกับงาน
ผลการทดลองของระบบค้นหาในงานวิจัยก็ไปทางเดียวกัน ชื่อและคำอธิบายสั้นๆ คือข้อมูลหลักที่ใช้แยก skill แต่ละตัวออกจากกัน เมื่อผู้เขียนลองนำเนื้อหาทั้งหมดในไฟล์ SKILL.md ไปรวมในข้อความที่ใช้ค้นหา คะแนนกลับลดลงไป 3.2% เพราะรายละเอียดการทำงานเชิงลึกกลายเป็นสัญญาณรบกวนที่ทำให้ระบบค้นหาสับสน
ผู้เขียนยังไล่ดูงานที่คะแนนเปลี่ยนมากที่สุดในคลังขนาดใหญ่ 34,000 ตัวกับโมเดล MiniMax งานที่ SkillSeek ช่วยได้มากที่สุดคืองานที่ชื่อและคำอธิบายของ skill ที่ใช่ตรงกับคำค้นของ agent ส่วนงานที่คะแนนตกมากที่สุดคืองานที่มี skill คำอธิบายใกล้เคียงกันอีกตัวอยู่ในคลัง แล้วโมเดลจัดอันดับหยิบตัวนั้นไปแทน
จากหลักการทั้งสองข้อนี้ จึงมีคำแนะนำ 3 ข้อสำหรับคนที่ติดตั้ง skill ไว้จำนวนมาก:
- ตรวจดูรายการ skill แล้วลบตัวที่ไม่ได้ใช้ออก: skill ที่ไม่เคยตรงกับงานไหนเลยก็ไม่ได้ช่วยอะไร การลบออกทำให้รายการที่ agent ต้องเลือกสั้นลง
- หลีกเลี่ยง skill ที่มีหน้าที่ซ้ำซ้อนกัน: ถ้ามี skill 2 ตัวที่ทำงานคล้ายกันและคำอธิบายใกล้เคียงกัน ให้เก็บไว้เพียงตัวเดียว เพราะงานที่ระบบค้นหาในงานวิจัยพลาดหนักที่สุด คืองานที่มี skill คำอธิบายใกล้เคียงกันอยู่ในคลัง
- เขียนคำอธิบายด้วยคำเดียวกับที่ใช้สั่งงานจริง: ถ้าคุณสั่งงานว่า 'สรุปรายงานการประชุม' แต่คำอธิบายของ skill เขียนว่า 'จัดการเอกสาร' คำสองชุดนี้แทบไม่มีคำสำคัญที่ตรงกันเลย ผลการทดสอบของ BM25 แสดงให้เห็นแล้วว่า แค่การจับคู่คำสำคัญธรรมดาก็ให้ผลลัพธ์สูสีกับการให้ AI ค้นเอง คำอธิบายที่ใช้คำเดียวกับคำสั่งงานจริงจึงน่าจะช่วยให้ agent เจอ skill ที่ใช่ได้ง่ายขึ้น
คำแนะนำข้อที่สามนี้ยังใช้ได้ดีกับคนที่พัฒนา skill แจกด้วยเช่นกัน ถ้าอยากให้ agent ของคนอื่นหยิบ skill ของคุณไปใช้งาน คำอธิบายจะต้องใช้ถ้อยคำเดียวกับที่ผู้ใช้ทั่วไปใช้สั่งงาน ไม่ใช่คำศัพท์เฉพาะทางที่ผู้พัฒนาใช้เรียกฟีเจอร์ของตัวเอง
ในยุคที่ใครๆ ก็สร้าง skill ขึ้นมาได้ สิ่งที่มีค่ามากกว่าจึงไม่ใช่การสะสม skill ให้มีเยอะกว่าคนอื่น แต่เป็นการรู้ว่างานตรงหน้าต้องหยิบตัวไหนมาใช้ต่างหาก
ที่มา:
- บทความ SkillSeek: Revisiting Agent Skill Retrieval at Marketplace Scale จาก Guanqun Yang, Wenlong Zhang, Tian Shi, Ping Wang
- บทความ Paper page - SkillSeek: Revisiting Agent Skill Retrieval at Marketplace Scale จาก Guanqun Yang, Wenlong Zhang, Tian Shi, Ping Wang
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ