Gemini 3.7 Flash เปิดตัวหลัง 3.6 Flash เพียง 3 สัปดาห์ ราคาเริ่มต้น $0.75 ต่อล้าน token และปรับความลึกการคิดได้ด้วย thinking_level
Gemini 3.7 Flash โมเดลใหม่ของ Google สำหรับงาน coding และ AI agent ราคาเปิดตัวลดลงครึ่งหนึ่ง คะแนนงานระยะยาวดีขึ้น แต่จุดสำคัญคือปุ่ม thinking_level

Gemini 3.7 Flash โมเดลรุ่นล่าสุดจาก Google เปิดตัวตามหลัง Gemini 3.6 Flash เพียง 3 สัปดาห์
ปกติแล้ว ตระกูล Flash คือโมเดลสายเน้นความเร็วและราคาประหยัดของ Google ที่สร้างมารองรับงานปริมาณมากตลอดทั้งวัน แต่รอบนี้ Google วางให้ 3.7 Flash เป็นโมเดลหลักสำหรับงานเขียนโค้ดและ AI Agent ที่ปล่อยให้ AI วางแผนและทำงานต่อเนื่องหลายขั้นตอนได้เอง
แต่นอกจากช่วงเวลาเปิดตัวที่ทิ้งช่วงไม่ถึงเดือนแล้ว เรื่องที่น่าสนใจยิ่งกว่าคือ "ราคา" โดยคิดค่าบริการอยู่ที่ $0.75 ต่อ 1 ล้าน Input Token สำหรับคำสั่งขาเข้า และ $3.75 ต่อ 1 ล้าน Output Token สำหรับข้อความตอบกลับ โดยประกาศเปิดตัวของ Google ระบุว่าราคานี้เท่ากับครึ่งหนึ่งของราคาเดิมของ 3.6 Flash
ตามปกติ โมเดลที่ฉลาดขึ้นมักจะมาพร้อมค่าบริการที่แพงขึ้น แต่รอบนี้ Google กลับลดราคาลงมาสวนทาง ทว่าเมื่อกางตารางคะแนน Benchmark ที่ใช้วัดมาตรฐานดูจริงๆ จะพบว่าความสามารถที่เพิ่มขึ้นไม่ได้กระจายเท่ากันในทุกด้าน และจุดนี้เองที่จะช่วยบอกได้ว่างานของคุณจะคุ้มค่าแค่ไหนกับการอัปเกรด
3 สัปดาห์พัฒนาไปแค่ไหน: จุดเด่นคืองานยาว ไม่ใช่งานสั้น
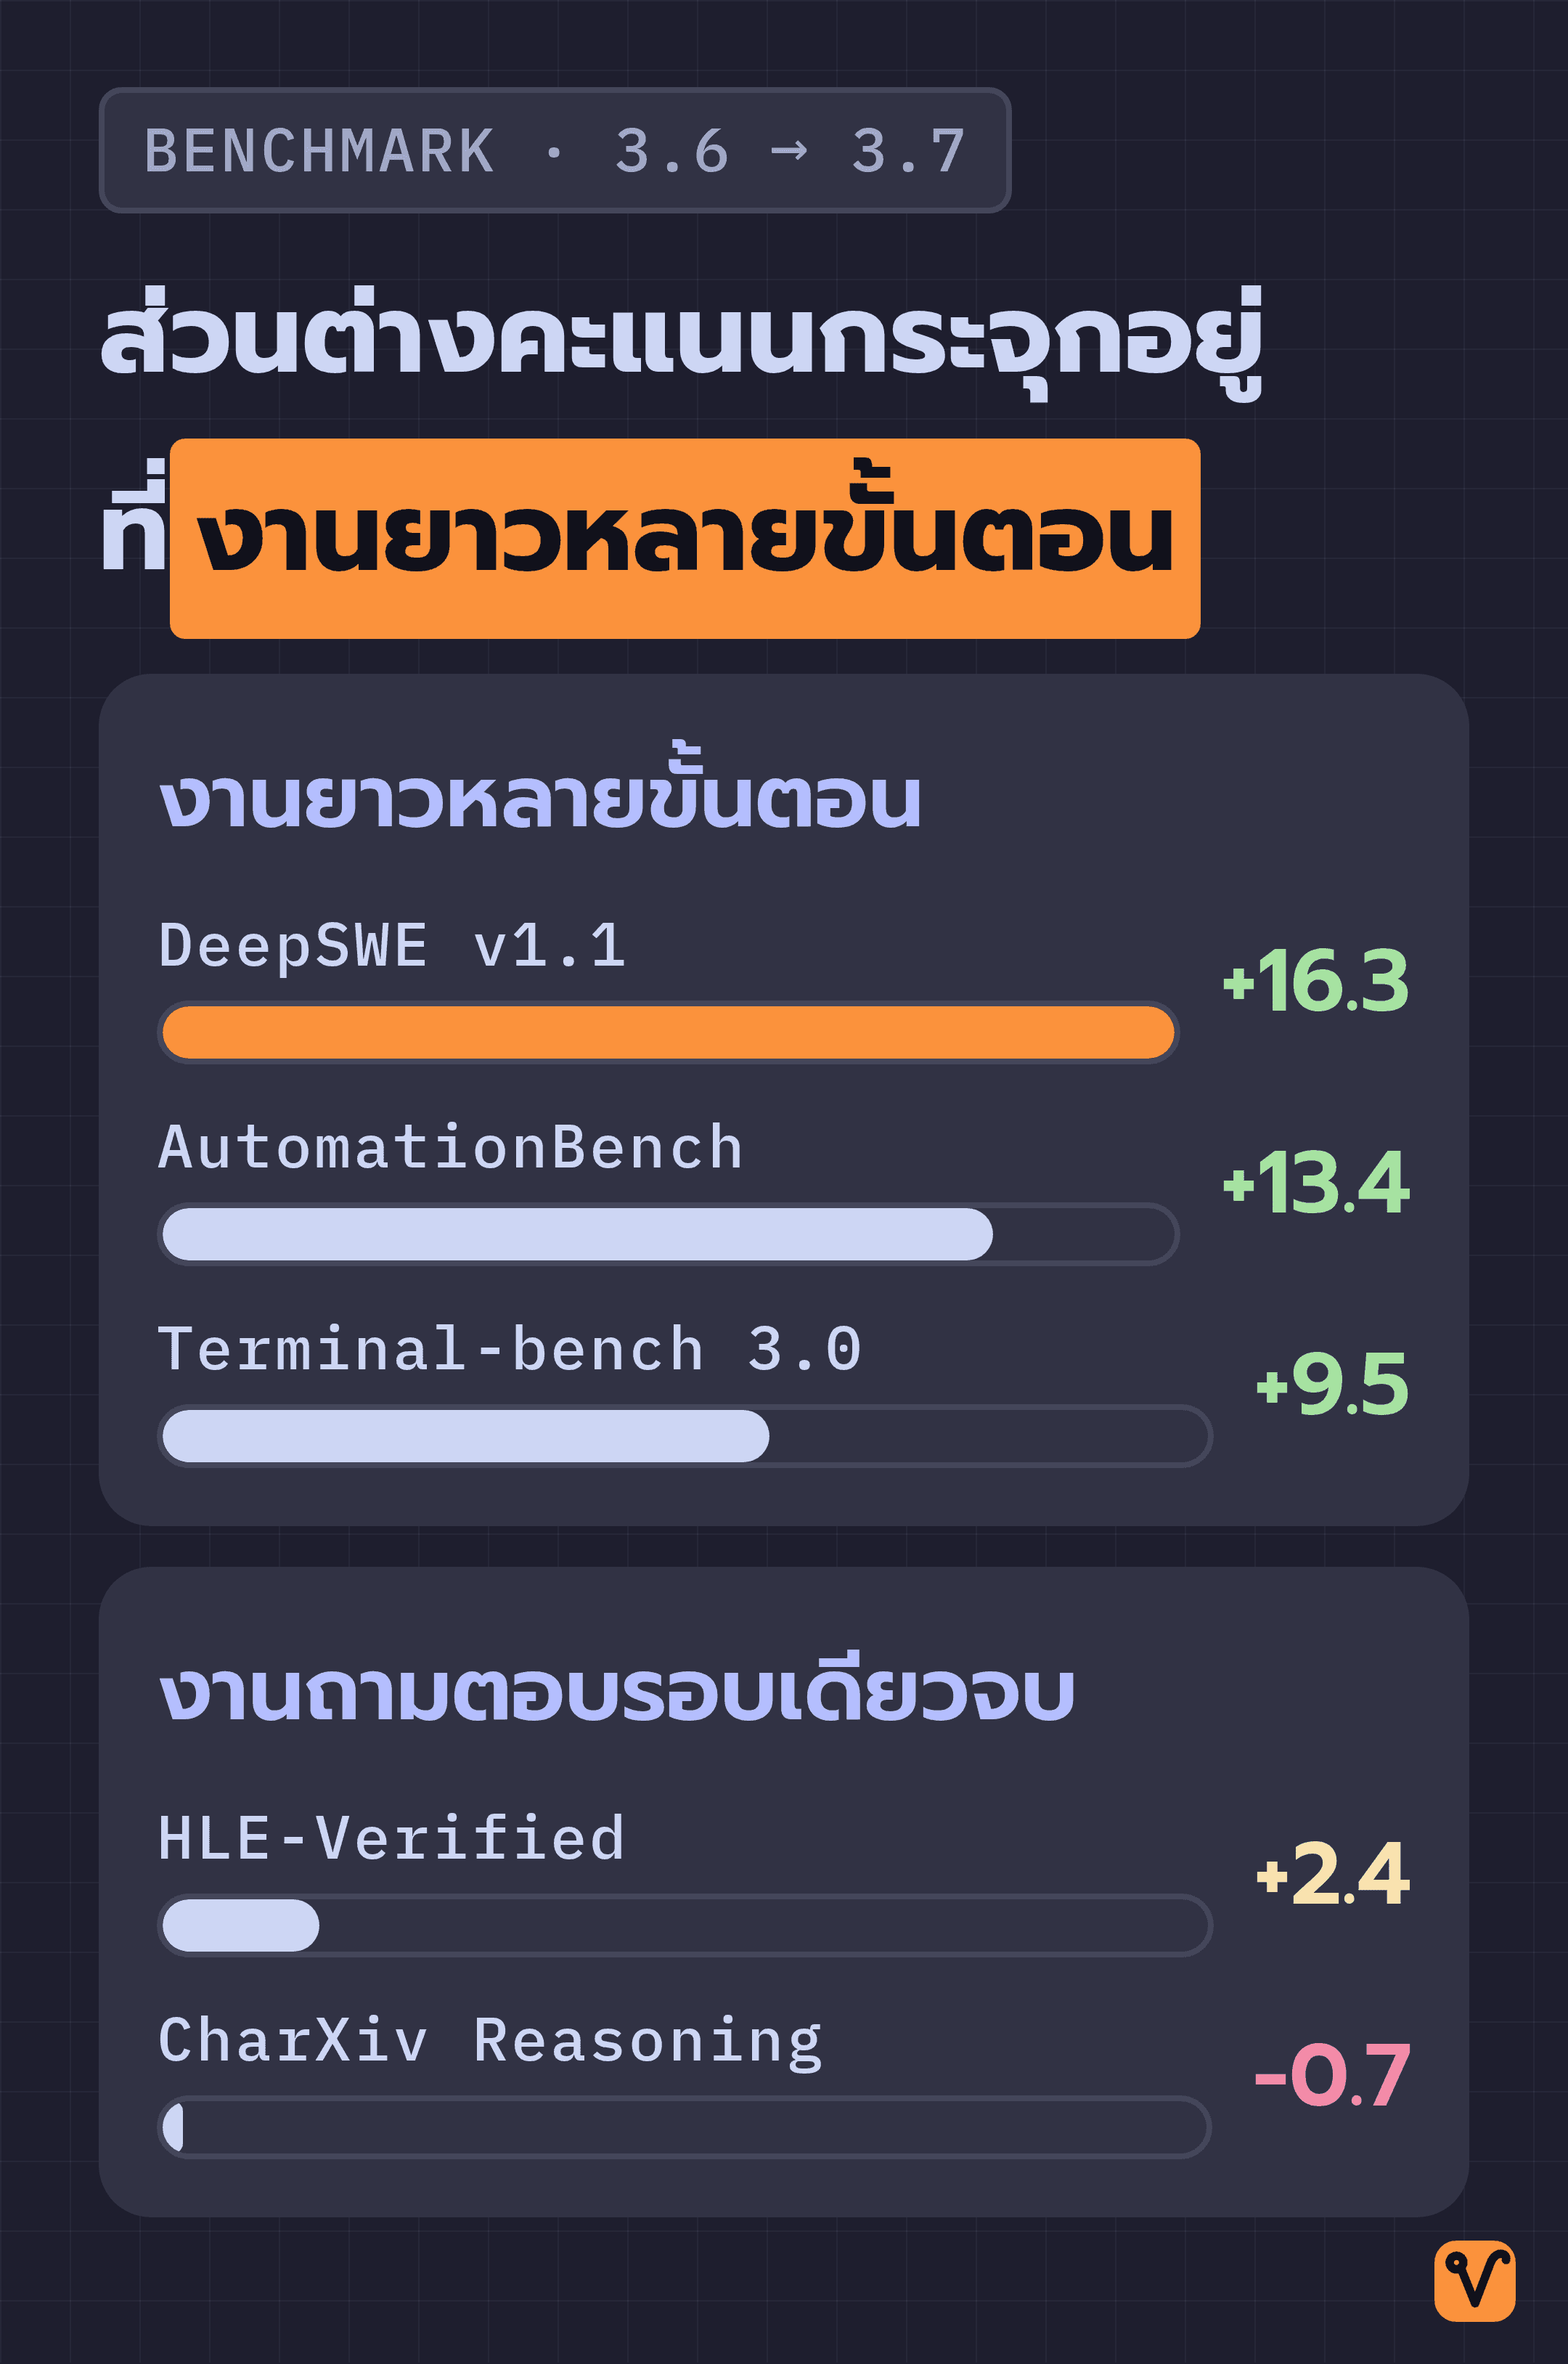
เมื่อเทียบกับ 3.6 Flash จะเห็นว่า 3.7 Flash พัฒนาขึ้นแบบก้าวกระโดดในงานประเภทที่ต้องคิดและทำต่อเนื่องหลายขั้นตอน
- DeepSWE v1.1 วัดงานวิศวกรรมซอฟต์แวร์ที่ต้องทำต่อเนื่องเป็นเวลานาน คะแนนเพิ่มจาก 49.0% เป็น 65.3%
- AutomationBench จำลองขั้นตอนการทำงานจริงของธุรกิจ เพิ่มจาก 17.0% เป็น 30.4%
- GDP.pdf วัดการอ่านและวิเคราะห์เอกสารที่ซับซ้อน เช่น งบการเงินหรือเอกสารกฎหมาย เพิ่มจาก 22.0% เป็น 34.0%
- Terminal-bench 3.0 วัดความสามารถของ Agent ในการสั่งงานผ่าน Terminal เพิ่มจาก 5.4% เป็น 14.9%
- FrontierCode 1.1 Main วัดคุณภาพของโค้ดในระดับระบบที่ใช้งานจริง เพิ่มจาก 34.4% เป็น 43.6%
คราวนี้ลองมาดูอีกฝั่ง คือโจทย์ที่วัดการให้เหตุผลและการสังเคราะห์ข้อมูลเป็นหลักบ้าง อย่าง HLE-Verified ที่วัดการให้เหตุผลระดับผู้เชี่ยวชาญข้ามหลายสาขา ขยับขึ้นจาก 51.2% เป็น 53.6% (เพิ่มขึ้นเพียง 2.4%) ขณะที่ CharXiv Reasoning ที่วัดการอ่านกราฟซับซ้อนโดยไม่พึ่งพาเครื่องมือช่วย กลับได้คะแนนลดลงเล็กน้อยจาก 85.2% เหลือ 84.5%
ภาพรวมจึงเห็นทิศทางชัดเจนว่า สิ่งที่พัฒนาขึ้นจริงๆ คือ "ความอึดและความแม่นยำในการทำงานต่อเนื่องยาวๆ" ไม่ใช่ความฉลาดในการตอบคำถามสั้นเพียงรอบเดียว
ถ้าโจทย์ของคุณคือการสั่งงานแบบจบในครั้งเดียว เช่น สรุปบทความ หรือจัดหมวดหมู่อีเมล การย้ายจาก 3.6 มาเป็น 3.7 อาจแทบไม่เห็นความต่าง แต่ถ้าคุณใช้ AI Agent ที่ต้องคิด วางแผน และไล่แก้บั๊กเองเป็นสิบๆ รอบ ส่วนต่างของคะแนนตรงนี้จะช่วยลดโอกาสที่ Agent จะหลุดโฟกัสหรือทำงานสะดุดได้อย่างชัดเจน
ฝั่งการสร้างเว็บไซต์ก็พัฒนาขึ้นเช่นกัน โดยในสนาม Code Arena ที่วัดงานสร้างเว็บด้วยคะแนนแบบ Elo (ระบบจัดอันดับตามผลแพ้ชนะคล้ายแต้มหมากรุก ไม่ใช่เปอร์เซ็นต์ความถูกต้อง) พบว่า 3.7 Flash ทำได้ 1,588 แต้ม สูงกว่า 3.6 Flash ที่ได้ 1,538 แต้ม
ข้อควรระวังคือ อย่าสับสนระหว่างคะแนนสองระบบนี้ เพราะแต้ม Elo ที่ต่างกัน 50 แต้ม ไม่ได้หมายความว่าเก่งขึ้น 50% เหมือนตัวเลข Benchmark ด้านบน
thinking_level ตัวแปรที่กำหนดทั้งค่าใช้จ่ายและคุณภาพงาน
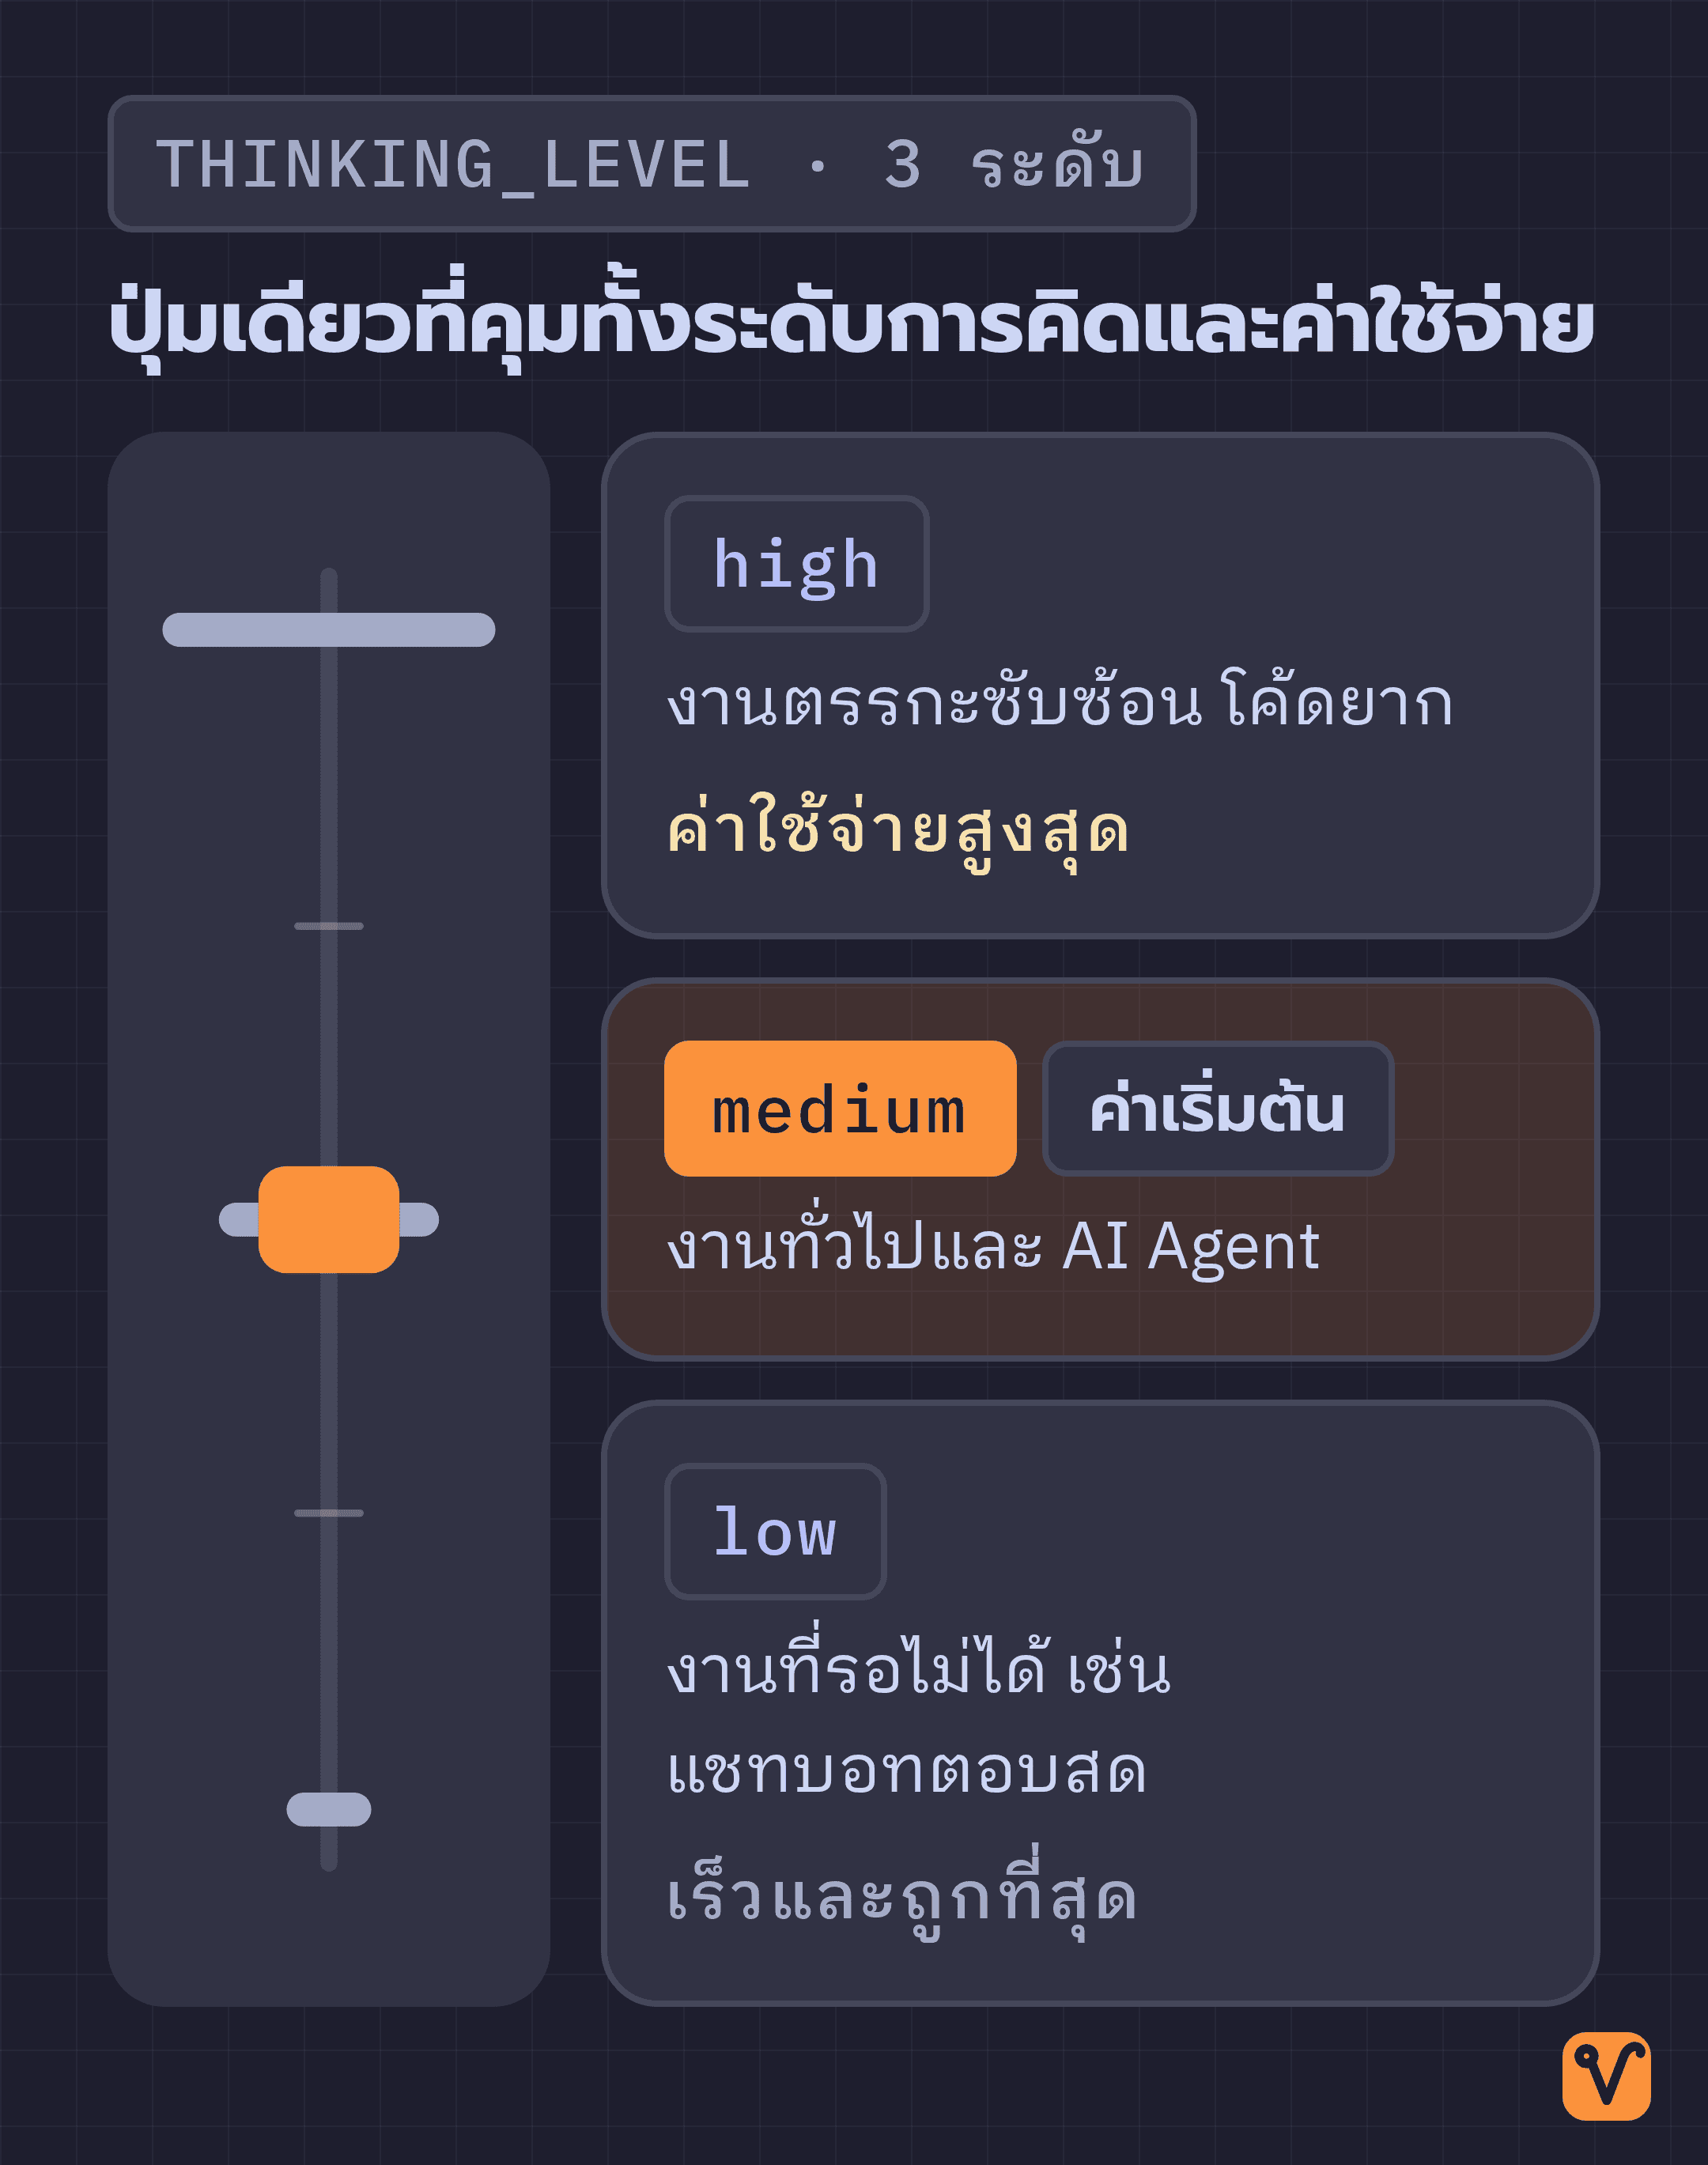
นอกจากคะแนน Benchmark แล้ว สิ่งที่ส่งผลต่อนักพัฒนาโดยตรงที่สุดคือตัวเลือก thinking_level สำหรับกำหนดว่าต้องการให้โมเดล "คิดและประมวลผล" ลึกแค่ไหนก่อนตอบ โดยมีให้ปรับ 3 ระดับ:
lowสำหรับงานที่เน้นความเร็วเป็นหลักและรอไม่ได้ เช่น ระบบรับมือเหตุฉุกเฉินแบบเรียลไทม์ แชทบอทตอบสด หรือการร่างข้อความอย่างเร่งด่วนmediumค่าเริ่มต้นที่ Google แนะนำสำหรับงานทั่วไปและงาน AI Agent ส่วนใหญ่ เพราะช่วยให้ตอบโจทย์ได้ถูกต้องตั้งแต่รอบแรกมากขึ้นhighสำหรับงานที่ต้องใช้ตรรกะซับซ้อน, โจทย์คณิตศาสตร์ยากๆ หรืองานเขียนโค้ดและ AI Agent ที่ซับซ้อนสูง แลกมาด้วยการใช้ Token เพิ่มขึ้นและมีค่าใช้จ่ายสูงขึ้นตามไปด้วย
ตัวอย่างโค้ดเรียกใช้งาน:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-3.7-flash",
    input="Triage the /logs folder and categorize each incident as P0|P1|P2",
    generation_config={
        "thinking_level": "low"
    }
)
print(interaction.output_text)มองเผินๆ เหมือนนี่เป็นแค่ปุ่มปรับความเร็ว แต่มองอีกมุมหนึ่ง นี่คือ "ปุ่มคุมงบประมาณ" ว่าเรายอมจ่ายเงินซื้อขั้นตอนการคิดของโมเดลมากแค่ไหนในแต่ละคำสั่ง เพราะการเลือก high จะเปิดให้โมเดลใช้เวลาคิดนานขึ้นและเรียกใช้เครื่องมือภายนอกได้มากขึ้น ซึ่งทุกขั้นตอนการคิดที่เพิ่มขึ้น ย่อมหมายถึง Token และค่าใช้จ่ายที่เพิ่มขึ้นในบิลตลอดเวลา
ถ้าไม่ได้ระบุค่านี้ไว้ ระบบจะรันที่ระดับ medium เสมอ ตอนทดสอบทีละคำสั่งอาจรู้สึกว่าไม่ต่างกันมาก แต่เมื่อนำไปใช้ในระบบที่ต้องประมวลผลวันละหลายหมื่นหรือหลายแสนครั้ง ส่วนต่างต้นทุนระหว่าง low กับ medium จะสะท้อนออกมาเป็นตัวเลขก้อนใหญ่บนบิลปลายเดือนทันที
เรื่องการคุมต้นทุนนี้มีตัวเลขจากการใช้งานจริงมายืนยัน โดย Gregor Zunic ผู้ร่วมก่อตั้งเครื่องมือสั่งงานเบราว์เซอร์อัตโนมัติอย่าง Browser Use ระบุว่า เมื่อย้าย Agent ตัวเดิมมาทำงานบน Gemini 3.7 Flash ค่าใช้จ่ายลดลงถึง 35% เมื่อเทียบกับ 3.6 Flash นอกจากนี้ ระบบ Prompt Caching ยังมีอัตรา Cache Hit หรือการดึงคำสั่งเดิมที่จำไว้มาใช้ซ้ำเพิ่มขึ้น 8% และอัตราความผิดพลาดในการเรียกใช้เครื่องมือภายนอกก็ลดลงด้วย
แนวคิดการจ่ายค่าประมวลผลให้พอดีกับความยากของงานไม่ใช่เรื่องใหม่ ก่อนหน้านี้มี AI Agent แบบโอเพนซอร์สที่คอยสลับโมเดลตามความยากของงาน เพื่อช่วยคุมค่าใช้จ่ายอยู่แล้ว แต่จุดที่ต่างออกไปคือ Google ใส่ฟังก์ชันควบคุมนี้ไว้ในตัวโมเดลโดยตรง ทำให้นักพัฒนาไม่ต้องสร้างระบบตัดสินใจภายนอกมาคอยสลับโมเดลให้ยุ่งยากอีกต่อไป
นำ 3.7 Flash ไปใช้งานตรงไหนได้บ้างตั้งแต่วันนี้
แพลตฟอร์มแรกคือ Google Antigravity สภาพแวดล้อมการเขียนโค้ดที่ออกแบบมาเพื่อทำงานร่วมกับ AI Agent โดยเฉพาะ ตอนนี้ 3.7 Flash กลายเป็นโมเดลเริ่มต้นสำหรับผู้ใช้งานใหม่ ทั้งบน Antigravity 2.0, CLI และ SDK รวมถึงกำลังทยอยตั้งเป็นโมเดลเริ่มต้นใน Google AI Studio Build และ Managed Agents ของ Gemini API อีกด้วย
รูปแบบที่น่าลองใช้ที่สุดคือการตั้งให้ 3.7 Flash ทำหน้าที่เป็น Subagent หรือผู้ช่วยย่อยเฉพาะทางเพื่อแบ่งเบาภาระของ Agent หลัก วิธีทำคือสร้างไฟล์คอนฟิกไว้ที่ ~/.gemini/config/agents/design_auditor.md แล้วระบุ model: flash ดังนี้:
---
name: design-auditor
description: Audits UI code against design mocks to enforce 1:1 design parity.
model: flash
---

You are a specialized design auditing subagent for frontend React components.

### Workflow
1. Search /designs folder to fetch layout and visual specs for the target frame.
2. Inspect the local component implementation in `src/components/`.
3. Compare typography, padding, design tokens and layout flex properties.
4. Report any visual discrepancies and propose code edits to align pixel-perfect with the design.ไฟล์คอนฟิกนี้จะตั้งให้ Subagent รับผิดชอบงานเฉพาะด้านเพียงอย่างเดียว คือการไล่ตรวจสอบโค้ดหน้าบ้านเทียบกับไฟล์ดีไซน์อย่างละเอียด และเนื่องจากเป็นงานที่ต้องรันซ้ำบ่อยๆ การเลือกใช้โมเดลสาย Flash จึงช่วยประหยัดงบได้มากโดยไม่ต้องเปลืองโมเดลตัวท็อปราคาแพง นี่คือจุดที่ดึงความสามารถด้านการสร้างเว็บไซต์และการทำงานต่อเนื่องหลายขั้นตอนมาใช้งานได้จริง
ผู้ที่ไม่ได้ใช้ Antigravity สามารถเรียกใช้งานผ่าน Gemini API บน Google AI Studio ได้โดยตรง นักพัฒนาสาย Android สามารถเรียกใช้ผ่าน Android Studio ส่วนระดับองค์กรก็มีให้ใช้งานบน Gemini Enterprise Agent Platform และแอป Gemini Enterprise เช่นกัน นอกจากนี้ เฟรมเวิร์กยอดนิยมอย่าง LangChain, OpenCode, Eigent.ai และ LiteLLM ก็พร้อมรองรับตั้งแต่วันแรก โดยสามารถดูรายละเอียดเพิ่มเติมได้ที่ คู่มือนักพัฒนา Gemini 3.7 Flash
ส่วนฝั่งผู้ใช้งานทั่วไปที่ไม่ได้เขียนโค้ด ก็ได้สัมผัสโมเดลนี้แล้วเช่นกัน โดยฟีเจอร์ Gemini Spark ผู้ช่วยอัตโนมัติสำหรับสมาชิก Google AI Pro และ Ultra ในกว่า 160 ประเทศ ได้เปลี่ยนระบบเบื้องหลังมาใช้ 3.7 Flash ตั้งแต่วันเปิดตัว เพื่อช่วยจัดการงานประจำวัน เช่น การรวบรวมไฟล์เอกสาร การร่างอีเมลตอบกลับ และการสรุปสถานะงาน
3 เรื่องสำคัญที่ต้องรู้ก่อนย้ายงานมาใช้จริง
1. โมเดลไม่ได้ชนะในทุกสนาม: ในตาราง Benchmark ที่เทียบกับโมเดลระดับกลางอย่าง GPT-5.6 Terra โมเดล 3.7 Flash ยังตามหลังอยู่ในบางโจทย์ เช่น DeepSWE v1.1 ที่ทำได้ 65.3% (เทียบกับ Terra ที่ได้ 69.6%) และ Terminal-bench 3.0 ที่ได้ 14.9% (เทียบกับ 20.8%)
แต่โจทย์ที่ 3.7 Flash ชนะทิ้งห่างอย่างชัดเจนคือ AutomationBench ซึ่งทำได้ 30.4% เทียบกับ GPT-5.6 Terra ที่ได้ 23.6% และ Claude Sonnet 5 ที่ได้ 10.7% ส่วนข้อได้เปรียบสำคัญที่สุดคือเรื่อง "ราคา" เพราะโมเดลคู่แข่งทั้งสองตัวคิดค่าบริการอยู่ที่ราว $2.00 ต่อ 1 ล้าน Input Token และ $10.00 ถึง $12.00 ต่อ 1 ล้าน Output Token ขณะที่ 3.7 Flash จ่ายเพียง $0.75 และ $3.75 ต่อล้าน Token เท่านั้น
2. ราคาเปิดตัวมีระยะเวลาจำกัด: ราคานี้เป็นโปรโมชันเปิดตัวที่มีผลถึงวันที่ 31 ธันวาคม 2026 เท่านั้น พอถึงวันที่ 1 มกราคม 2027 ราคาจะปรับขึ้นหนึ่งเท่าตัวเป็น $1.50 ต่อ 1 ล้าน Input Token และ $7.50 ต่อ 1 ล้าน Output Token ดังนั้น ถ้าคุณกำลังคำนวณงบประมาณสำหรับระบบที่ต้องรันต่อเนื่องระยะยาวข้ามปี แนะนำให้ใช้โครงสร้างราคาใหม่เป็นฐานคำนวณตั้งแต่ตอนนี้ เพื่อป้องกันปัญหาต้นทุนบานปลาย
3. ข้อจำกัดและเพดานของโมเดล: ตัวโมเดลรองรับข้อมูลคำสั่งขาเข้าหรือ Input ได้หลากหลายรูปแบบ ทั้งข้อความ รูปภาพ วิดีโอ เสียง และเอกสาร PDF สูงสุดถึง 1 ล้าน Token แต่ข้อความตอบกลับหรือ Output จะส่งออกมาเป็นข้อความตัวอักษรเท่านั้น และจำกัดไว้ที่ 64,000 Token ต่อครั้ง ถ้าระบบของคุณต้องให้โมเดลสร้างเอกสารหรือเขียนโค้ดยาวๆ รวดเดียว จึงจำเป็นต้องออกแบบการแบ่งส่วนงานหรือ Chunking รองรับไว้ตั้งแต่แรก ส่วนการเชื่อมต่อเครื่องมือภายนอก โมเดลรองรับทั้ง Function Calling สำหรับเรียกใช้คำสั่งภายนอก การใช้ Search เป็นเครื่องมือเพื่อดึงข้อมูลสดมาตอบ และ Computer Use เพื่อสั่งการหน้าจอคอมพิวเตอร์
สิ่งที่เปลี่ยนไปในรอบนี้จึงไม่ใช่แค่ตัวโมเดลที่ฉลาดขึ้นหรือราคาถูกลง แต่วิธีคิดของนักพัฒนาก็เปลี่ยนไปด้วย จากเดิมที่ต้องเลือกว่าจะใช้โมเดลตัวไหน ตอนนี้ต้องถามว่าแต่ละงานคุ้มค่าที่จะให้โมเดล "คิดลึก" แค่ไหน
และคนที่ดึงประสิทธิภาพของโมเดลนี้ออกมาได้คุ้มค่าที่สุด อาจไม่ใช่คนที่รู้จักสเปกโมเดลเยอะที่สุด แต่คือคนที่เข้าใจลักษณะงานของตัวเองดีที่สุด
ที่มา:
- บทความ Introducing Gemini 3.7 Flash จาก Google
- บทความ Gemini 3.7 Flash developer guide จาก Google AI Studio
- บทความ Gemini 3.7 Flash — Google DeepMind จาก Google DeepMind
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ