OpenAI ออกคู่มือ GPT-6 เอง งานไหนควรใช้ Astra, GPT-6.1 Sol หรือ Luna และทำไมสั่งละเอียดเกินไปอาจได้ผลแย่ลง
คู่มือ GPT-6 ของ OpenAI บอกว่างานไหนควรใช้ Astra, GPT-6.1 Sol หรือ Luna และควรตั้งระดับความคิดแค่ไหน อีกเรื่องคือคำสั่งที่ละเอียดเกินไปอาจทำให้ได้ผลแย่ลง
การส่งทุกงานให้โมเดล AI อย่าง GPT-6 Astra รุ่นที่ฉลาดที่สุด แล้วเปิดระดับความคิด reasoning effort ไว้สูงสุด อาจฟังดูเป็นวิธีที่ปลอดภัยและไม่มีทางพลาด
แต่คู่มือการเลือกใช้โมเดลตระกูล GPT-6 ที่ OpenAI เผยแพร่ออกมาเองกลับไม่ได้แนะนำแบบนั้น คู่มือมองว่าการเลือกรุ่นโมเดลและระดับความคิดเป็นการชั่งน้ำหนักระหว่างความฉลาดกับต้นทุน ถ้าต้องการความฉลาดเพิ่มขึ้น ก็ต้องแลกกับค่าใช้จ่ายที่สูงขึ้น
คำถามแรกในการทำงานจึงไม่ใช่ "รุ่นไหนเก่งที่สุด" แต่คือ "งานตรงหน้าต้องใช้ความฉลาดระดับไหน"
คู่มือฉบับนี้เขียนขึ้นสำหรับผู้ใช้งาน 2 กลุ่มหลัก กลุ่มแรกคือคนที่เรียกใช้ GPT-6 ผ่าน API ช่องทางเชื่อมต่อสำหรับนักพัฒนา โดยระบบจะคิดค่าบริการตามจำนวน token หรือหน่วยนับปริมาณข้อความทั้งขาเข้าและขาออก ส่วนกลุ่มที่สองคือคนที่ใช้เครื่องมือช่วยเขียนโค้ดอย่าง Codex
ถ้าคุณต้องจ่ายค่า API ทุกเดือน การจับคู่รุ่นโมเดลให้ตรงกับลักษณะงานคือจุดแรกที่จะช่วยประหยัดต้นทุนได้อย่างเห็นผล
อีกประเด็นสำคัญที่คู่มือเน้นย้ำ ซึ่งอาจขัดกับความเคยชินเดิม คือเรื่อง "การเขียนพรอมต์สั่งงานละเอียดทีละขั้นตอน" เพราะสำหรับโมเดลรุ่นนี้ การสั่งงานละเอียดเกินไปอาจทำให้ผลลัพธ์แย่ลงกว่าเดิม
Astra, GPT-6.1 Sol และ Luna: 3 รุ่นสำหรับงาน 3 รูปแบบ
GPT-6 ไม่ได้มีเพียงรุ่นเดียว โดยคู่มือแบ่งโมเดลในตระกูลนี้ออกเป็น 3 รุ่นตามลักษณะการใช้งาน:
| รุ่น | เหมาะกับงานแบบไหน |
|---|---|
| GPT-6 Astra | งานที่ต้องใช้เหตุผลขั้นสูง งานยากที่สุด และต้องการความฉลาดเต็มพิกัด |
| GPT-6.1 Sol | งานเขียนโค้ดที่ซับซ้อน งานค้นคว้าวิจัย และฟีเจอร์ computer use ที่ให้โมเดลดูหน้าจอ คลิก และกรอกข้อมูลแทนเรา |
| GPT-6 Luna | งานเฉพาะทางที่ต้องประมวลผลปริมาณมาก หรืองานประจำที่ทำซ้ำๆ โดยมีเป้าหมายชัดเจน เช่น ดึงข้อมูลจากใบแจ้งหนี้ คัดแยกหมวดหมู่คำขอ หรือสรุปข้อมูลตามโครงสร้างที่กำหนด |
จุดหนึ่งที่อาจทำให้สับสนได้ง่ายคือการตั้งชื่อรุ่น เพราะ Sol ใช้เลข 6.1 ขณะที่ Astra กับ Luna ใช้เลข 6 นอกจากนี้ชื่อ Sol เองก็เคยมีรุ่นก่อนหน้าอย่าง GPT-5.6 Sol มาแล้ว เวลาค้นหาเอกสารหรือตรวจสอบราคา จึงต้องดูเลขเวอร์ชันให้ครบถ้วน
สำหรับรายละเอียดช่วงเปิดตัวของ Astra และ Sol สามารถอ่านย้อนหลังได้ที่ GPT-6 Astra และ GPT-6.1 Sol ส่วนรุ่นที่น่าทำความรู้จักเพิ่มคือ Luna
ลองนึกภาพงานที่มีใบแจ้งหนี้กองโต แล้วเราต้องดึงเลขที่เอกสารกับยอดเงินรวมออกมาใส่ตาราง ซึ่งทุกใบต้องการข้อมูลชุดเดียวกัน และตรวจเช็กผลลัพธ์ได้ทันทีว่าถูกหรือผิด อีกตัวอย่างคืองานคัดแยกข้อความคำขอของลูกค้าเข้าหมวดหมู่ที่ตั้งไว้ล่วงหน้าโดยไม่ต้องคิดหมวดใหม่
คู่มือวางตำแหน่งของ Luna ไว้สำหรับงานที่มีเป้าหมายชัดเจนแบบนี้ ถ้าคิดตามหลักการชั่งน้ำหนักระหว่างความฉลาดกับต้นทุน การส่งงานประเภทนี้ให้ Astra ทำ ก็อาจเป็นการจ่ายค่าความฉลาดส่วนเกินที่งานไม่จำเป็นต้องใช้เลย
สำหรับราคาต่อ token ของแต่ละรุ่น คู่มือแนะนำให้เข้าไปดูโดยตรงที่หน้าเปรียบเทียบราคาโมเดล ก่อนตัดสินใจเลือกใช้
หลักการเลือกรุ่นจึงเริ่มต้นจากคำถามง่ายๆ เพียงข้อเดียวว่า "งานนี้มีคำตอบที่ตรวจเช็กได้ชัดเจน และต้องทำซ้ำเป็นประจำใช่หรือไม่" ถ้าใช่ ให้ลองใช้ Luna ดูก่อน แต่ถ้าเป็นงานโค้ดซับซ้อน งานวิจัย หรือต้องให้โมเดลควบคุมหน้าจอ ให้ขยับไปใช้ GPT-6.1 Sol แล้วเก็บ Astra ไว้สำหรับงานยากๆ ที่ต้องใช้การคิดวิเคราะห์ขั้นสูงสุดจริงๆ
เลือกระดับความคิด Low ถึง Max ให้พอดีกับงาน
การเลือกรุ่นโมเดลกับระดับความคิด reasoning effort เป็นคนละส่วนกัน เมื่อเลือกรุ่นได้แล้ว เรายังต้องกำหนดต่อว่าจะให้โมเดลใช้เวลาและกระบวนการคิดกับงานชิ้นนั้นมากน้อยแค่ไหน
สำหรับการใช้งานผ่าน API คู่มือยกตัวอย่างงานที่เหมาะกับแต่ละระดับไว้ดังนี้:
- Low: เหมาะกับงานประจำทั่วไป เช่น การดึงข้อเท็จจริงออกจากเอกสาร หรือการแก้โค้ดจุดเล็กๆ
- Medium: เหมาะกับงานที่ต้องใช้การตัดสินใจและวิจารณญาณ เช่น การวางแผนฟีเจอร์ หรือการเปรียบเทียบทางเลือกต่างๆ
- High: เหมาะกับงานแก้บักยากๆ งานวิเคราะห์เชิงลึก หรือการตรวจทานงานอย่างละเอียด
- Extra high และ Max: แนะนำให้ลองเปิดใช้เฉพาะในรุ่นที่รองรับ และใช้เมื่อระดับ High ยังเอาไม่อยู่จริงๆ โดยควรใช้ก็ต่อเมื่อผลลัพธ์ที่ดีขึ้นคุ้มค่ากับเวลาและค่าใช้จ่ายที่เพิ่มขึ้น
สองขั้นบนสุดจึงเป็นขั้นที่เปิดทีหลัง ไม่ใช่เปิดไว้ก่อน คือต้องลอง High แล้วเห็นว่ายังไม่พอ จึงค่อยขยับไป Extra high หรือ Max
ส่วนฝั่ง Codex คู่มือแนะนำให้เริ่มต้นจากระดับความคิดเริ่มต้นของรุ่นนั้นๆ ก่อน แล้วค่อยปรับลดลงเมื่อเป็นงานง่าย หรือปรับเพิ่มขึ้นเมื่อต้องวิเคราะห์งานที่ซับซ้อนมาก
Fast mode และ Ultrafast จ่ายเพิ่มเพื่อความเร็ว ส่วน Prompt Caching ช่วยลดค่าใช้จ่าย
นอกจากรุ่นโมเดลและระดับความคิดแล้ว อีกปัจจัยสำคัญที่คู่มือพูดถึงคือเรื่องความเร็ว ซึ่งความเร็วที่เพิ่มขึ้นย่อมมีต้นทุนที่ต้องจ่ายเพิ่มอย่างแน่นอน
โหมดประมวลผลความเร็วสูงอย่าง Fast mode ใน API เหมาะกับงานที่ต้องการการตอบสนองรวดเร็วทันใจ เช่น แอปพลิเคชันแชตหรือเครื่องมือช่วยเขียนโค้ด โหมดนี้จะช่วยให้โมเดลตอบกลับเร็วขึ้นและมีความหน่วงสม่ำเสมอ แลกกับราคาต่อ token ที่สูงกว่าการประมวลผลแบบมาตรฐาน
ส่วน Ultrafast โหมดเร่งความเร็วขั้นสุด สามารถใช้งานได้ทั้งใน Codex และ API เหมาะสำหรับจังหวะที่ความเร็วส่งผลต่อประสิทธิภาพการทำงานจริงและคุ้มที่จะจ่ายเพิ่ม เช่น ในช่วงที่กำลังแก้โค้ดและต้องทดสอบซ้ำๆ อย่างต่อเนื่อง โดยคู่มือระบุว่า GPT-6 Astra รองรับโหมดนี้
จุดสำคัญที่ต้องทำความเข้าใจคือ Ultrafast ไม่ได้เร็วขึ้นเพราะโมเดลคิดน้อยลง แต่เป็นการเร่งความเร็วในการสร้างข้อความตอบกลับ โดยไม่ได้ลดระดับความคิดที่เราตั้งค่าไว้เลย
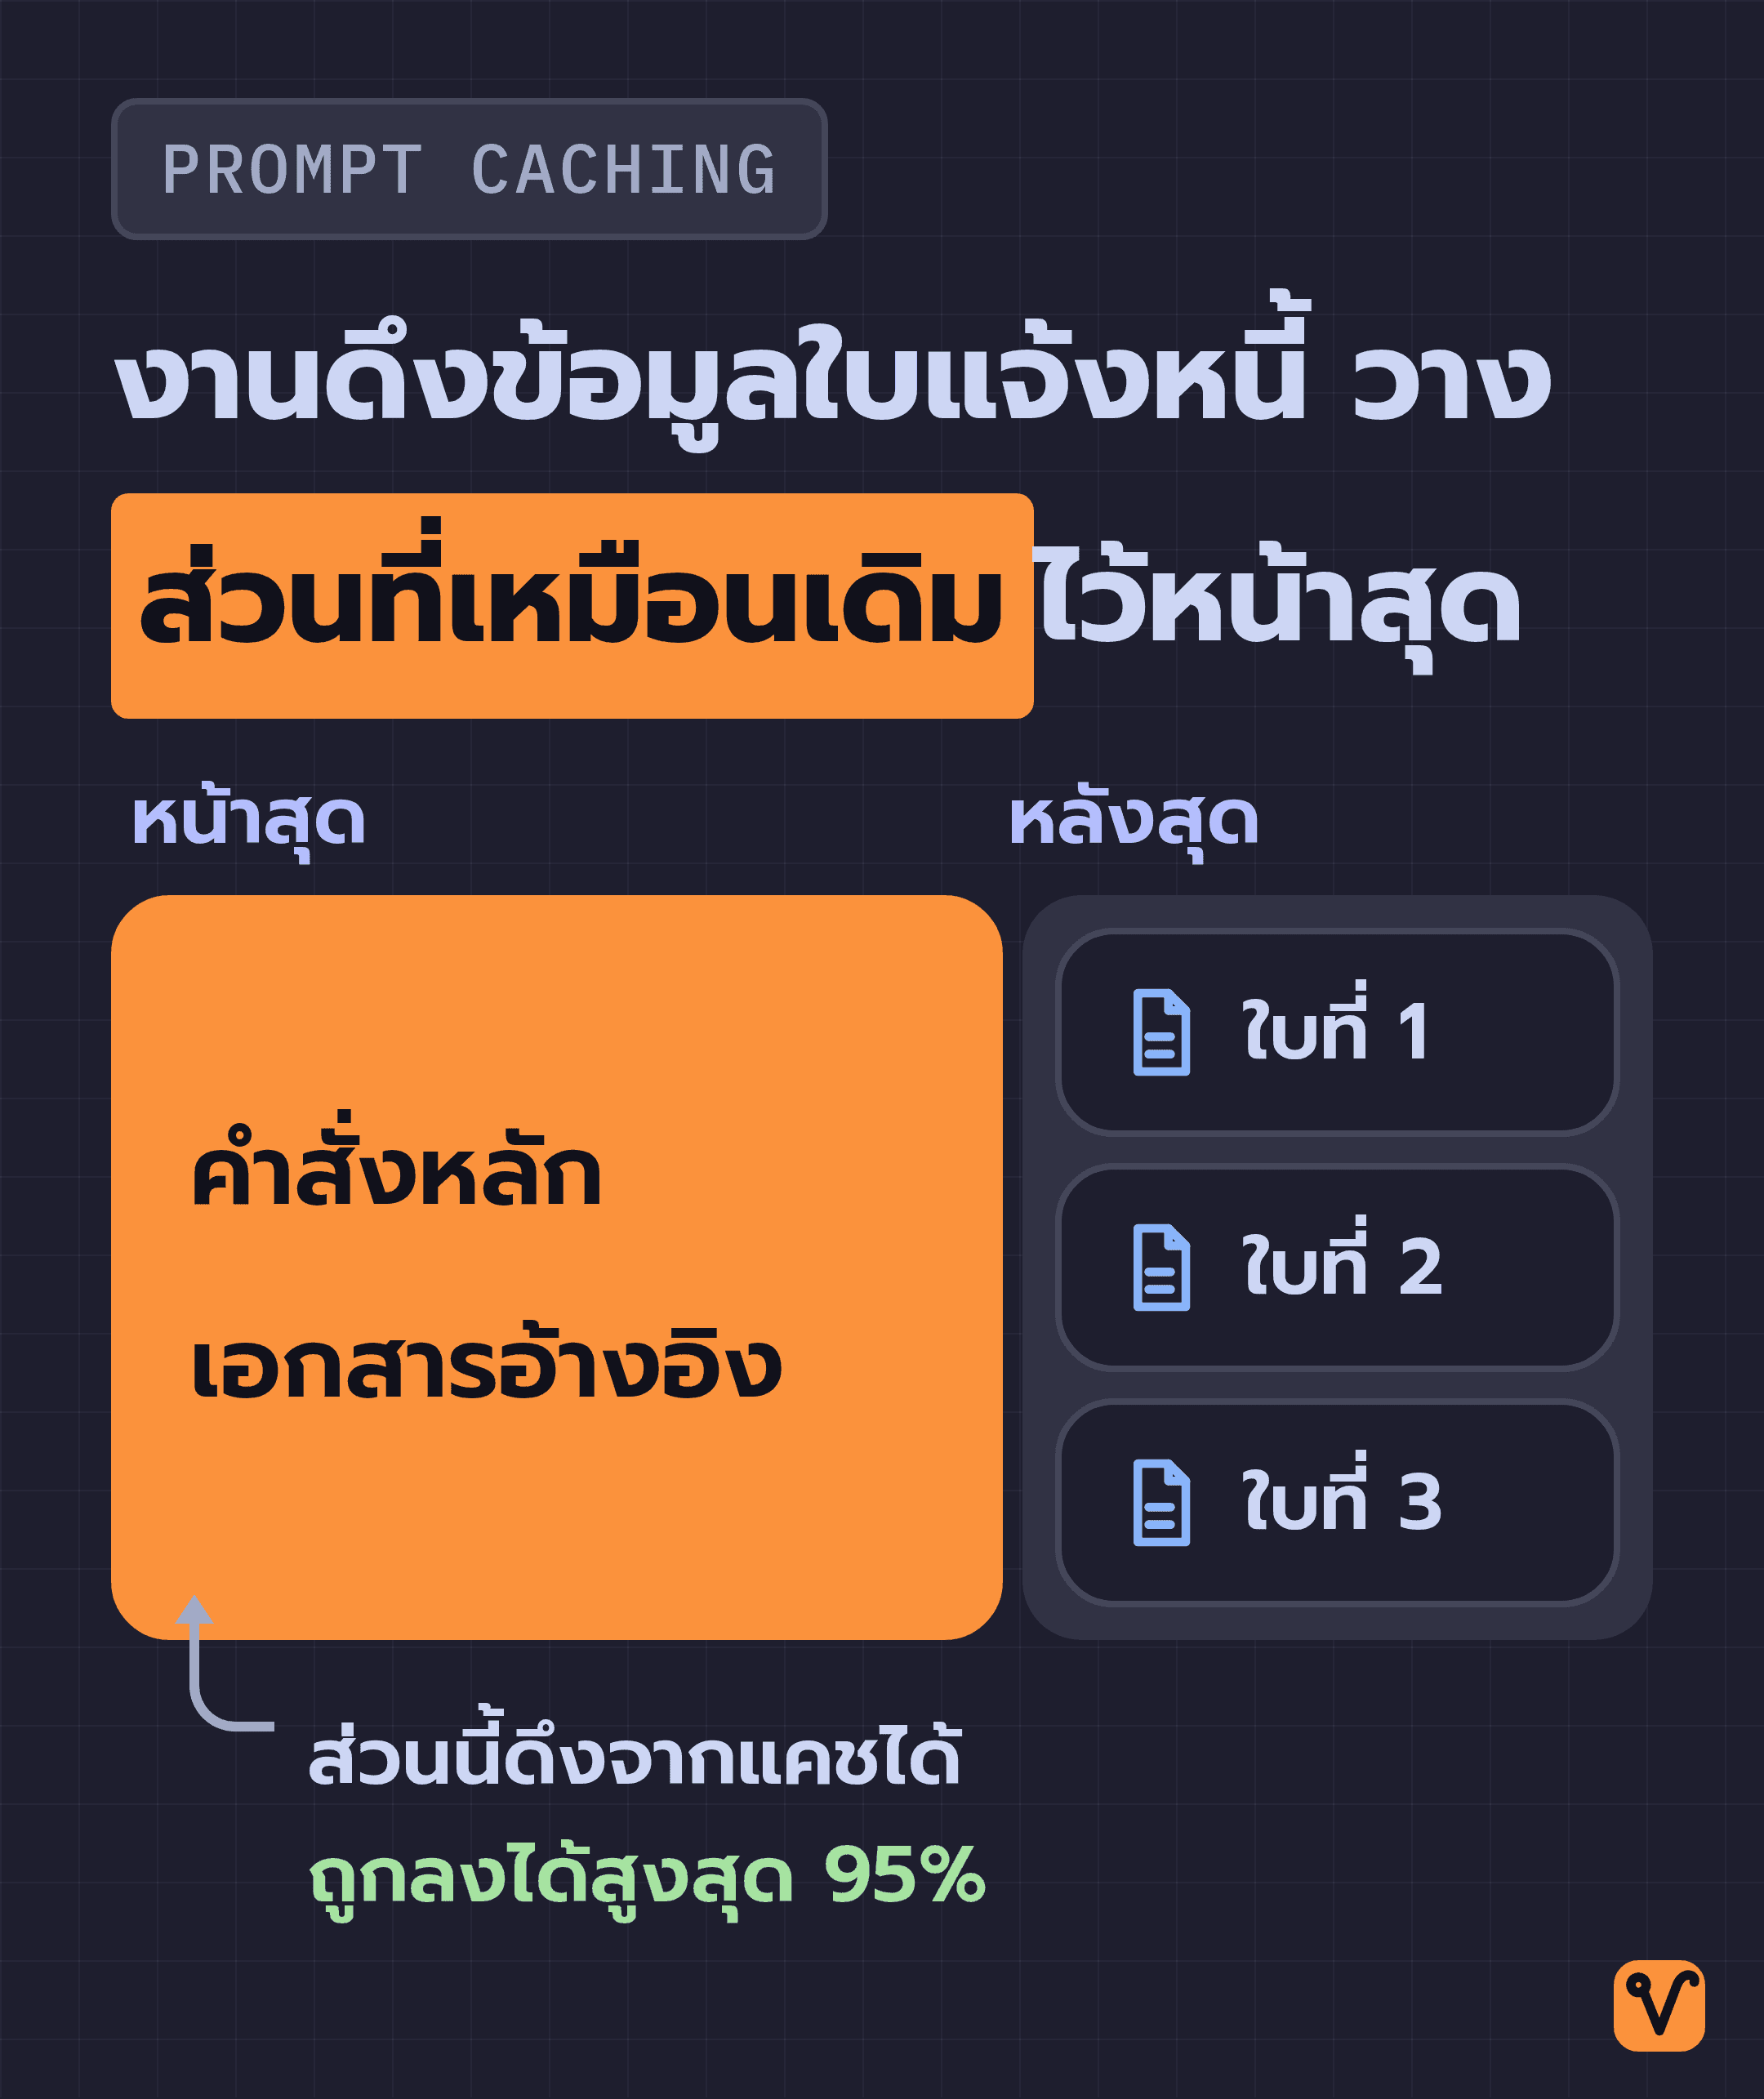
ส่วนฟีเจอร์หลักที่จะช่วยลดค่าใช้จ่ายลงได้อย่างมากคือ prompt caching หรือการนำบริบทเดิมที่ต้องส่งซ้ำๆ กลับมาใช้ใหม่
token ขาเข้าที่ดึงมาจากแคช มีราคาถูกกว่า token ขาเข้าปกติสูงสุดถึง 95% ขึ้นอยู่กับแต่ละรุ่น
สิ่งที่คู่มือแนะนำเพื่อให้แคชทำงานได้เต็มประสิทธิภาพ คือการจัดลำดับเนื้อหาในพรอมต์ โดยวางคำสั่งที่ไม่เคยเปลี่ยนและเอกสารอ้างอิงไว้ด้านหน้าสุด แล้ววางรายละเอียดที่เปลี่ยนไปตามแต่ละงานไว้ด้านหลังสุด นอกจากนี้ ข้อกำหนดรายการเครื่องมืออย่าง tool definitions ที่ส่งให้โมเดลก็ต้องจัดให้เหมือนเดิมทุกครั้ง
ถ้าเป็นงานดึงข้อมูลจากใบแจ้งหนี้ การจัดลำดับตามคำแนะนำนี้จะเป็นดังนี้:
- คำสั่งหลักที่ระบุว่าต้องดึงฟิลด์อะไรและส่งออกในรูปแบบไหน (ส่วนนี้เหมือนเดิมทุกใบ)
- เอกสารอ้างอิง กฎเกณฑ์ หรือตัวอย่างที่ใช้เทียบ (ส่วนนี้เหมือนเดิมทุกใบ)
- ข้อมูลเนื้อหาของใบแจ้งหนี้ใบที่กำลังประมวลผล (ส่วนนี้เปลี่ยนไปในแต่ละครั้ง)
อย่างไรก็ตาม เวลาประเมินค่าใช้จ่ายรวมของทั้งระบบ คู่มือเตือนว่าอย่าดูแค่ส่วนลดจากการอ่านแคช แต่ต้องคำนวณต้นทุนการเขียนแคชครั้งแรก (cache write) และอัตราค่าบริการของงานที่ส่งข้อความยาวมาก (ถ้ามี) รวมเข้าไปด้วยเสมอ
กำหนดผลลัพธ์ปลายทางที่ต้องการ แทนการสั่งงานทีละขั้นตอน
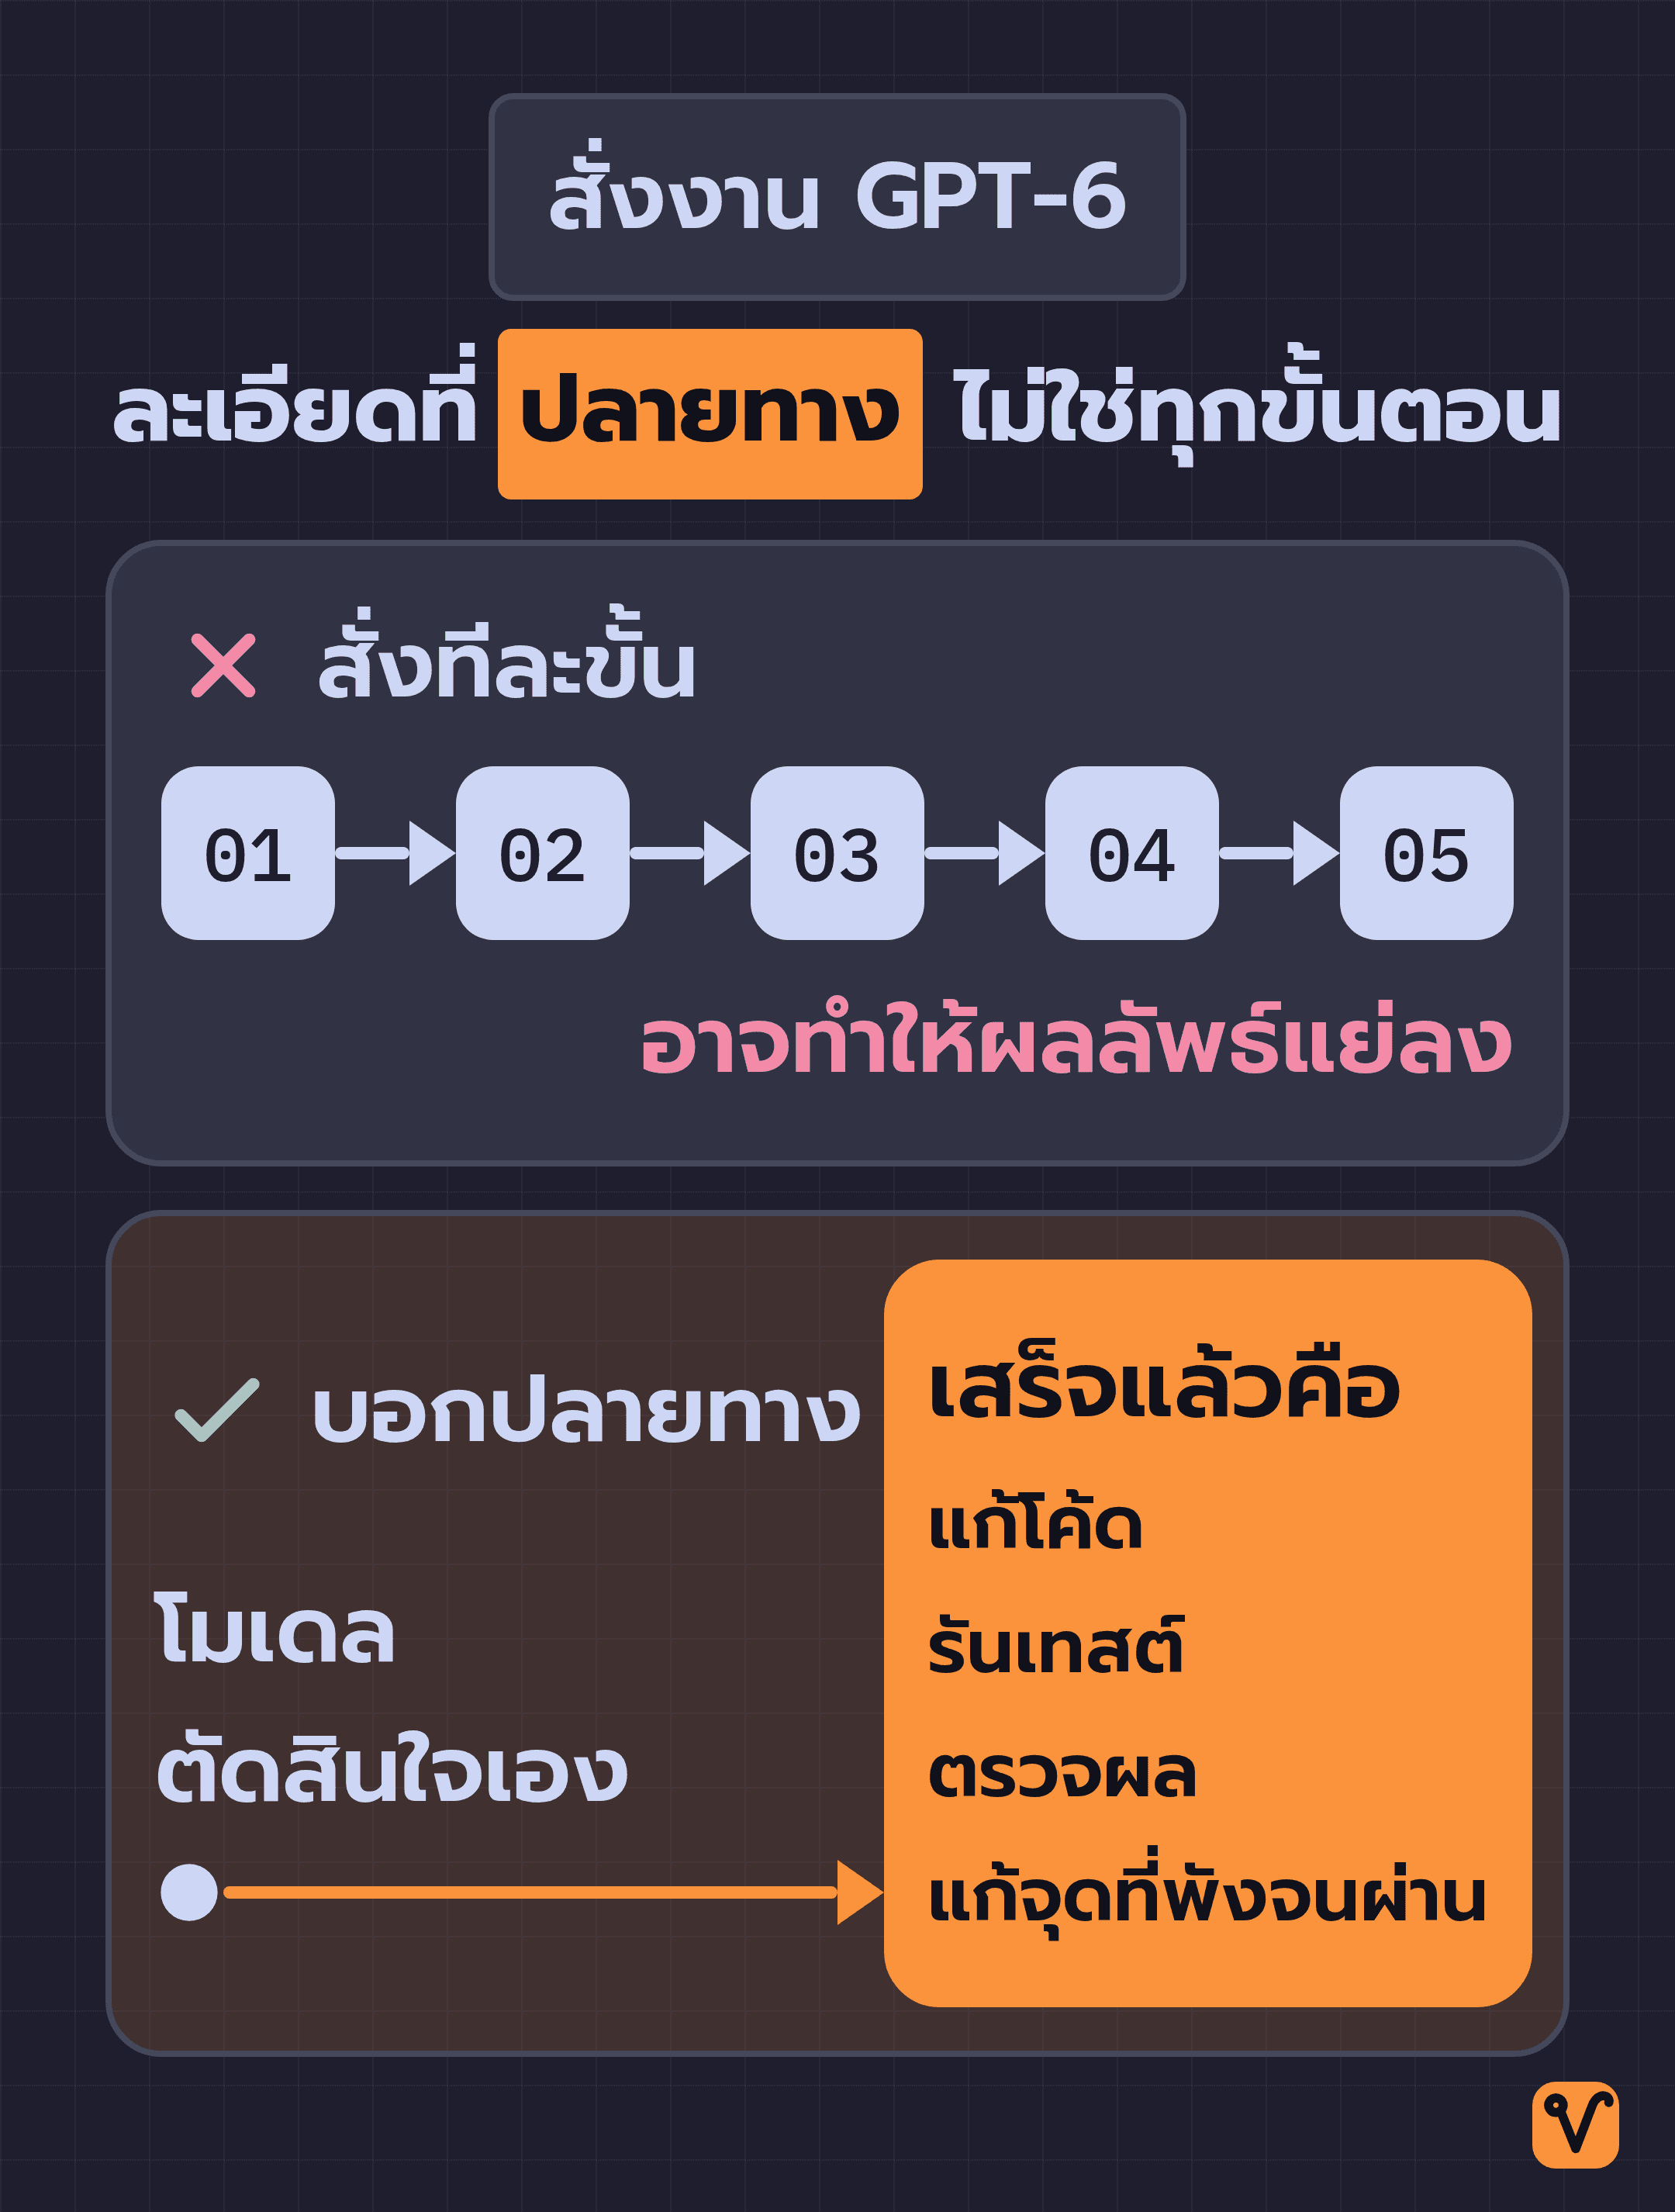
สำหรับ GPT-6 การเขียนคำสั่งที่ละเอียดยิบในทุกขั้นตอน ไม่ได้แปลว่าจะได้ผลลัพธ์ที่ดีกว่าเสมอไป
เนื้อหาส่วนนี้คู่มือสรุปมาจากบทความบนบล็อก OpenAI Developers ที่อธิบายว่า โมเดลรุ่นนี้เข้าใจความต้องการที่ละเอียดอ่อนและบริบทที่กำกวมได้ดีขึ้นมาก คำสั่งที่ลงลึกทุกขั้นตอนที่เคยช่วยให้โมเดลรุ่นเก่าทำงานได้ดี จึงอาจกลายเป็นข้อจำกัดและทำให้ผลลัพธ์แย่ลง
ตัวอย่างที่บทความยกขึ้นมาคือชุดคำสั่งสำเร็จรูปอย่าง skill ที่บันทึกเป็นไฟล์ไว้ให้โมเดลหยิบไปใช้ โดยมักเขียนล็อกขั้นตอนตายตัวไว้ทั้งหมด
จุดที่ต้องแยกให้ออกคือ การสั่งงานให้น้อยลงไม่ได้หมายถึงการสั่งงานแบบลอยๆ หรือคลุมเครือ สิ่งที่ควรตัดออกคือขั้นตอนย่อยว่าโมเดลต้องทำอะไรก่อนหลัง แต่สิ่งที่ต้องระบุให้ชัดเจนขึ้นคือ "เป้าหมายปลายทาง" ว่าเมื่องานเสร็จแล้ว ผลงานที่ถูกต้องจะต้องมีหน้าตาเป็นอย่างไร
คู่มือแนะนำให้เริ่มต้นจากการกำหนดโจทย์ให้ชัด บอกผลลัพธ์ที่ต้องการ ระบุว่าทำให้ใคร มีบริบทและข้อจำกัดอะไรบ้าง และแค่ไหนถึงนับว่างานเสร็จสมบูรณ์ จากนั้นให้ระบุอีก 3 เรื่องสำคัญให้ชัดเจน:
ขีดเส้นให้ชัดว่าอะไรทำได้เลย อะไรต้องถามก่อน
ควรกำหนดให้ชัดเจนว่าเรื่องไหนที่โมเดลทำต่อได้ทันที และแบบไหนที่ต้องขออนุมัติก่อน แทนการใช้กฎเหมารวมอย่าง "ให้ถามก่อนทุกครั้ง" ตัวอย่างในคู่มือระบุว่า โมเดลตัดสินใจเลือกรูปแบบการจัดโครงสร้างสรุปได้เอง แต่ถ้าจะปรับเปลี่ยนขอบเขตของโปรเจกต์ ต้องหยุดถามก่อนเสมอ
เรื่องนี้สำคัญเป็นพิเศษสำหรับ GPT-6 Astra เพราะบทความระบุว่า Astra ตีความคำสั่งจำกัดขอบเขตอย่างเคร่งครัดมาก ถ้าคุณเคยชินกับการเขียนคำสั่งเข้มงวดให้โมเดลหยุดถามบ่อยๆ เพราะกลัวทำเกินขอบเขตเหมือนในรุ่นก่อน คำสั่งเดิมเหล่านั้นอาจทำให้ Astra หยุดชะงักในจุดที่คุณอยากให้โมเดลลุยต่อเองได้เลย
นิยามคำว่า "งานเสร็จ" ให้ครบถ้วน
คู่มือแนะนำให้นิยามคำว่า "งานเสร็จ" ให้ครอบคลุม ตั้งแต่การลงมือแก้ไขโค้ด การรันคำสั่งทดสอบจริง การตรวจผลลัพธ์ ไปจนถึงการตามแก้จุดที่พังจนผ่าน พร้อมทั้งระบุไว้ด้วยว่าการตัดสินใจเรื่องใดบ้างที่ต้องรอให้คุณเป็นคนตรวจทาน
ถ้าไม่กำหนดนิยามนี้ไว้ล่วงหน้า Astra อาจทำงานเสร็จเพียงรอบแรกแล้วหยุดเพื่อขอให้คุณตรวจ ทั้งที่ยังมีงานส่วนอื่นที่ต้องทำต่อ บทความอธิบายว่า Astra ทำงานได้อย่างรอบคอบ แต่อาจลังเลมากกว่า GPT-5.6 Sol ว่าควรทำต่อถึงขั้นไหน
ในทางกลับกัน ถ้าเราสั่งกำชับไว้ว่าให้หยุดรอตรวจหลังจากทำรอบแรกเสร็จ โมเดลก็จะหยุดทำงานเร็วตามนั้น ดังนั้นจึงควรถามตัวเองก่อนเสมอว่า ในจุดนั้นจำเป็นต้องให้เราตัดสินใจจริงๆ หรือไม่
กำหนดรูปแบบผลลัพธ์ที่พร้อมใช้งาน
คู่มือยกตัวอย่างว่า ควรกำหนดให้ผลงานใช้ภาษาที่เข้าใจง่าย มีรายละเอียดเชิงเทคนิคในระดับที่พอดีกับคนอ่าน และสรุปส่งงานสั้นๆ ว่าได้แก้ไขอะไรไปบ้าง ตรวจสอบอะไรแล้ว และมีเรื่องใดที่ยังต้องติดตามต่อ
ถ้านำหลักการทั้งหมดนี้มาเขียนเป็นคำสั่งสำหรับงานแก้ไขฟอร์ม จะได้พรอมต์ที่มีโครงสร้างประมาณนี้:
งาน: เพิ่มการตรวจอีเมลซ้ำในฟอร์มสมัครสมาชิก
ทำให้ใคร: ทีมที่ดูแลระบบสมัครสมาชิก
บริบท: ตอนนี้อีเมลเดียวกันสมัครซ้ำได้
ตัดสินใจเองได้: วิธีเขียนโค้ดและการจัดไฟล์
ต้องถามก่อน: การเปลี่ยนโครงสร้างฐานข้อมูล
เสร็จแล้วคือ: แก้โค้ด รันเทสต์ที่เกี่ยวข้อง ตรวจผล และแก้ส่วนที่พังจนผ่าน
ส่งงาน: สรุปสั้นๆ ว่าเปลี่ยนอะไร ตรวจอะไรแล้ว อะไรยังต้องดูต่อจะเห็นได้ว่าไม่มีบรรทัดไหนเลยที่ต้องคอยสั่งว่าให้เปิดไฟล์ใดก่อน หรือต้องเขียนโค้ดแต่ละขั้นอย่างไร เพราะเราปล่อยให้โมเดลตัดสินใจเรื่องเหล่านั้นเอง
ทบทวน AGENTS.md และ Skill ที่เคยเขียนไว้ให้โมเดลรุ่นก่อน
คำสั่งต่างๆ ที่เราเคยเขียนสะสมไว้ตั้งแต่ตอนใช้โมเดลรุ่นก่อน ไม่ได้มีอยู่แค่ในพรอมต์ประจำวันเท่านั้น แต่ส่วนหนึ่งอยู่ใน AGENTS.md ไฟล์คำสั่งที่โมเดลจะอ่านทุกครั้งเมื่อเริ่มทำงานในโปรเจกต์ และอีกส่วนหนึ่งอยู่ในไฟล์ skill ที่บันทึกไว้ในรูปแบบ Markdown พร้อมไฟล์ประกอบหรือสคริปต์
บทความเดียวกันชี้ว่า คำสั่งหลายอย่างที่เคยจำเป็นสำหรับโมเดลรุ่นเก่า อาจกลายเป็นตัวถ่วงเมื่อเปลี่ยนมาใช้ Astra:
- คำสั่งบังคับรันเทสต์: โมเดลรุ่นก่อนมักต้องคอยสั่งย้ำให้รันเทสต์และตรวจงานตัวเอง แต่ Astra ตรวจสอบความถูกต้องของงานเองอยู่แล้ว คำสั่งเดิมจึงอาจทำให้โมเดลรันเทสต์บ่อยเกินความจำเป็น
- คำสั่งให้อ่านเอกสารทุกครั้งก่อนลงมือแก้: การบังคับให้อ่านเอกสารจำนวนมากหรือทำความเข้าใจแผนผังทั้งโปรเจกต์ก่อนเริ่มงาน เกินความจำเป็นสำหรับงานเล็กๆ เช่น การแก้คำผิดเพียงจุดเดียว เพราะ Astra สามารถค้นหาและเลือกอ่านเฉพาะเอกสารที่เกี่ยวข้องได้เอง การชี้เป้าไปยังเอกสารยังมีประโยชน์ แต่ควรชี้เฉพาะเมื่อเอกสารนั้นเกี่ยวกับงานจริงๆ
- คำอธิบาย skill ที่ยาวเกินไป: โมเดลต้องอ่านชื่อและคำอธิบายของทุก skill เพื่อเลือกว่าจะหยิบตัวไหนมาใช้ เมื่อมีจำนวน skill มากขึ้น Codex จะย่อคำอธิบายลงเพื่อให้พอดีกับพื้นที่บริบท ทำให้โมเดลเห็นข้อมูลของแต่ละตัวน้อยลง
คำอธิบายของแต่ละ skill จึงควรเขียนให้สั้นกระชับที่สุด แต่ระบุให้ชัดเจนว่าต้องเรียกใช้ในสถานการณ์ใด ถ้าเขียนคำอธิบายกว้างเกินไป โมเดลอาจหยิบ skill สำหรับงานปรับเปลี่ยนโครงสร้างฐานข้อมูล (database migration) ไปใช้ทุกครั้งที่งานแตะเรื่องฐานข้อมูล ทั้งที่ควรเรียกใช้เฉพาะตอนปรับโครงสร้างฐานข้อมูลจริงๆ เท่านั้น
ส่วน skill ที่มีหลายขั้นตอน ควรออกแบบให้ไฟล์หลักทำหน้าที่เป็นเพียงตัวชี้ทางไปยังเอกสารย่อยและสคริปต์ เพื่อให้โมเดลอ่านเฉพาะส่วนที่ต้องใช้ในเวลานั้น โดยไม่เสียพื้นที่บริบทไปกับคำแนะนำที่ไม่เกี่ยวข้องกับงานตรงหน้า
นอกจากนี้ เรายังสามารถใช้ AGENTS.md เพื่อให้สิทธิ์ล่วงหน้ากับขั้นตอนที่รู้แน่ชัดอยู่แล้วว่าปลอดภัย ซึ่งช่วยเพิ่มความมั่นใจให้ Astra เดินหน้าทำงานต่อได้ทันที โดยบทความยกตัวอย่างข้อความนี้ไว้:
The local tests use disposable fixtures and have no production access. Run them, fix failures caused by the requested change, and rerun affected tests without asking for approval at each step.ใจความสำคัญคือ ระบุชัดเจนว่าชุดทดสอบในเครื่องใช้ข้อมูลจำลองที่ลบสร้างใหม่ได้และไม่มีสิทธิ์เข้าถึงระบบจริง จึงอนุญาตให้รันเทสต์ แก้ไขจุดที่พังจากงานที่สั่ง และรันเทสต์ซ้ำได้ทันทีโดยไม่ต้องคอยขออนุมัติในทุกขั้นตอน ซึ่งการบอกเหตุผลว่าทำไมถึงปลอดภัยตั้งแต่ประโยคแรก จะช่วยให้ขอบเขตของสิทธิ์ชัดเจนในตัวเอง
อีกเรื่องที่ต้องระวังคือ skill ที่อยู่ในโปรเจกต์มักแชร์ร่วมกับทีม ซึ่งเพื่อนร่วมทีมคนอื่นอาจใช้โมเดลต่างรุ่นกัน บทความจึงเตือนว่าคำสั่งที่ช่วยให้ Sol หรือ Luna ทำงานได้ดี อาจกลายเป็นกรอบที่จำกัดความสามารถของ Astra มากเกินไป ดังนั้นก่อนเขียนคำสั่งทิ้งไว้ในระบบ จึงต้องตัดสินใจให้ชัดเจนก่อนว่าจะเขียนขึ้นเพื่อให้โมเดลรุ่นใดอ่าน
ควบคุมงานระยะยาวหลายชั่วโมงถึงหลายวันด้วย Steering และ Subagent
คู่มือระบุว่าโมเดลตระกูล GPT-6 สามารถรับงานระยะยาวที่ต้องทำต่อเนื่องหลายชั่วโมงหรือหลายวันได้ โดยเครื่องมือสำหรับควบคุมงานระยะยาวแบ่งออกตามช่องทางการใช้งานดังนี้:
ฝั่ง API มีฟีเจอร์หลัก 3 รูปแบบ:
- Mid-turn steering: การส่งคำสั่งผ่าน Responses WebSocket API เข้าไปปรับเปลี่ยนทิศทางระหว่างที่โมเดลกำลังประมวลผล คำสั่งใหม่จะเข้าคิวไว้ โดยไม่ยกเลิกเครื่องมือที่กำลังรันอยู่ และไม่ย้อนงานส่วนที่ทำเสร็จไปแล้ว
- Asynchronous tool calling: ระหว่างที่ระบบกำลังรันงานที่ใช้เวลานาน เช่น การรันชุดทดสอบ โมเดลสามารถสลับไปทำงานส่วนอื่นที่ยังไม่ต้องรอผลลัพธ์นั้นได้ทันที และจะหยุดรอให้ผลกลับมาก่อนก็ต่อเมื่องานชิ้นนั้นจำเป็นต้องใช้ผลลัพธ์จากการทดสอบจริงๆ
- การแตกงานให้ subagent: GPT-6.1 Sol สามารถแบ่งงานย่อยที่ไม่ขึ้นต่อกัน ส่งต่อให้ AI ผู้ช่วยตัวย่อยอย่าง subagent แยกกันไปทำได้ผ่าน Responses API เช่น มอบหมายให้แต่ละตัวแยกไปสำรวจโค้ดคนละจุด แล้วนำผลลัพธ์กลับมารวมเป็นคำตอบเดียว ทั้งนี้ ความสามารถในการใช้ AI หลายตัวร่วมกัน หรือ multi-agent นี้ ยังอยู่ในช่วงทดลองใช้งาน
ฝั่ง Codex: เมื่อทำงานร่วมกับ GPT-6 Astra ตัว Codex สามารถถามคำถามกลับมาระหว่างทำงานได้ คู่มือแนะนำให้เราเลือกตอบเฉพาะคำถามที่มีผลต่อขั้นตอนถัดไป พร้อมทั้งบอกโมเดลว่ามีงานส่วนไหนบ้างที่ทำต่อได้เลยระหว่างที่เรากำลังตัดสินใจ ถ้าเราจำเป็นต้องลุกออกจากหน้าจอ ควรบอกล่วงหน้าไว้ให้ชัดว่างานไหนให้ทำต่อได้ทันที และงานไหนที่ต้องหยุดรอคำตอบจากเรา
นอกจากนี้ ถ้าเป้าหมายของงานเปลี่ยนไประหว่างทาง เราก็สามารถส่งข้อมูลใหม่เข้าไปปรับทิศทางการทำงานของ Codex ได้ทันที โดยระบุให้ชัดเจนว่ามีอะไรที่ต้องแก้ไข และมีอะไรที่ต้องการให้คงไว้ตามเดิม
เริ่มต้นปรับใช้จากงานจริงที่มีอยู่ตอนนี้
การปรับเปลี่ยนไม่จำเป็นต้องรื้อระบบใหม่ทั้งหมด แต่เริ่มจากการไล่ดูงาน AI ที่ใช้อยู่จริงทีละงาน แล้วลองจัดใหม่แบบนี้:
- งานทำซ้ำที่มีเป้าหมายชัดเจน: เช่น การดึงฟิลด์ข้อมูลหรือการคัดแยกหมวดหมู่ข้อความ ให้ลองเปลี่ยนมาใช้ Luna ที่ระดับความคิด Low
- งานที่ต้องใช้การตัดสินใจ: ให้เริ่มต้นทดลองที่ระดับความคิด Medium
- งานดีบักยาก วิเคราะห์เชิงลึก หรือรีวิวละเอียด: ใช้ระดับ High
- Extra high และ Max: เปิดเฉพาะเมื่อ High ยังเอาไม่อยู่ และเก็บไว้ใช้ต่อเมื่อทดสอบแล้วเห็นว่าคุ้มกับเวลาและค่าใช้จ่ายที่เพิ่ม
- คำสั่งเดิมที่เขียนขั้นตอนละเอียดยาวเหยียด: ให้เปลี่ยนมานิยามผลลัพธ์ปลายทางที่ต้องการให้ชัดเจนแทน
คำว่า "คุ้มค่า" วัดผลได้อย่างเป็นรูปธรรม โดยคู่มือแนะนำให้นำงานตัวแทนที่สะท้อนการทำงานจริงมารันทดสอบก่อนนำไปใช้จริง แล้วประเมินผลใน 3 ด้าน คือ งานสำเร็จตามเป้าหรือไม่ ใช้เวลาไปเท่าไร และมีค่าใช้จ่ายเฉลี่ยต่องานที่สำเร็จเป็นเท่าใด ซึ่งตัวชี้วัดสุดท้ายนี้สำคัญมากในการเปรียบเทียบรุ่นโมเดล เพราะถึงแม้โมเดลจะมีราคาต่อ token ถูกกว่า แต่ถ้าต้องรันแก้ซ้ำหลายรอบกว่างานจะผ่าน ต้นทุนรวมก็อาจไม่ได้ถูกกว่าจริง
สำหรับไฟล์ AGENTS.md และ skill เดิมที่มีอยู่ บทความแนะนำว่าไม่จำเป็นต้องไล่ตรวจเองทั้งหมด แต่สามารถสั่งให้ Astra ช่วยตรวจสอบและปรับแก้ตามหลักการในบทความได้เลย
ถ้าคุณใช้ Claude Code อยู่ ก็มีรูปแบบการเลือกรุ่นโมเดลและปรับระดับความคิด หรือ effort level คล้ายกัน สามารถอ่านเพิ่มเติมได้ที่ โมเดลกับ effort level ใน Claude Code
การเลือกโมเดลที่สเปกแรงเกินความจำเป็น กับการเขียนคำสั่งที่ละเอียดยิบจนเกินไป ล้วนเกิดจากความเคยชินเดียวกันคือ "การเผื่อไว้ก่อน" แต่ข้อแรกทำให้เราต้องเสียเงินเพิ่ม ส่วนข้อหลัง เราอาจต้องแลกด้วยคุณภาพของงานที่ลดลงแทน
ที่มา:
- เอกสารทางการของ GPT-6
- เอกสารทางการของ GPT-6 Astra
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin