Ollama 0.35 รันโมเดลตัดสินใจแบบ Jev บนเครื่องเราได้แล้ว ไม่เสียค่าใช้จ่ายต่อครั้ง และตามตารางของ Ollama ตัวท็อปอย่าง nimble แม่นยำ 75.7% ใกล้เคียง Jev ตัวจริงที่ 76.0%
Ollama 0.35 รองรับโมเดลตัดสินใจสไตล์ Jev บนเครื่องตัวเองแล้ว คำขอเดียวตอบได้หลายคำถามพร้อมกัน แต่ละคำตอบมีความน่าจะเป็นกำกับ และไม่เสียค่าใช้จ่ายต่อครั้ง
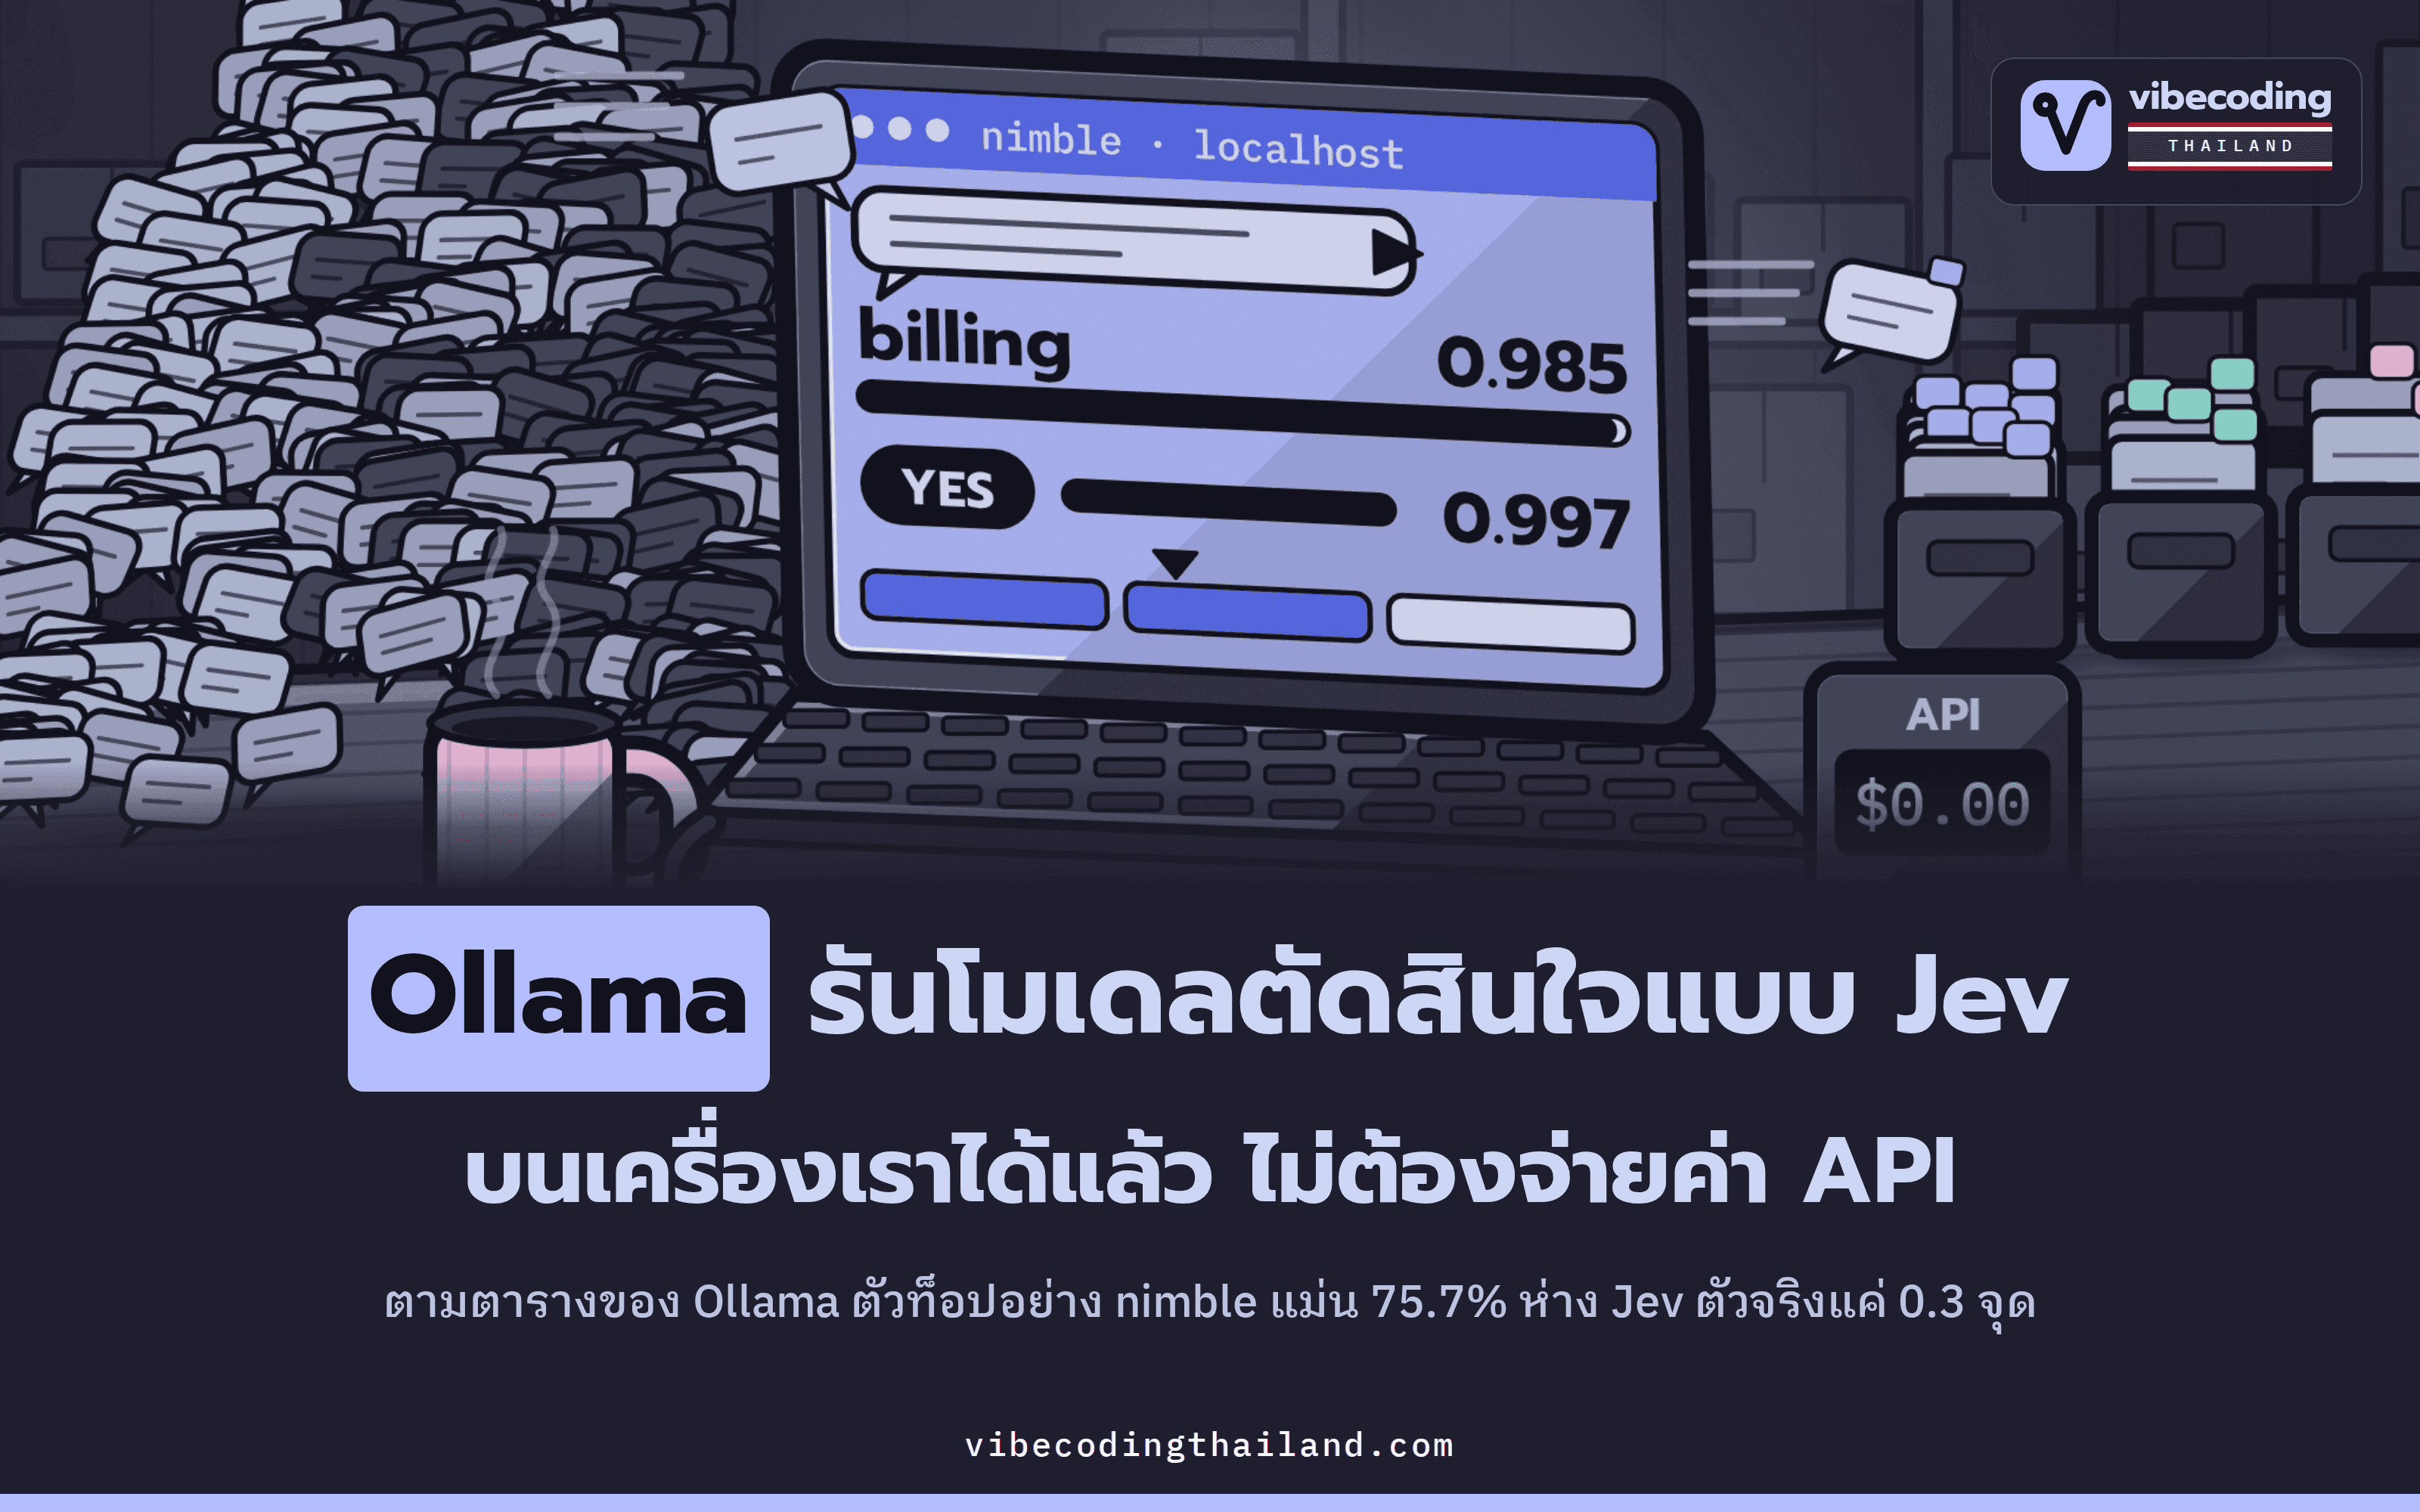
Ollama เครื่องมือรันโมเดล AI ในเครื่อง ออกอัปเดตเวอร์ชัน 0.35 พร้อมรองรับโมเดลรูปแบบใหม่ ที่ไม่ได้มีไว้แชตโต้ตอบ แต่สร้างมาเพื่อ "ช่วยตัดสินใจ" โดยเฉพาะ
ลองนึกภาพระบบตอบแชตของร้านค้าออนไลน์ เวลาลูกค้าพิมพ์ข้อความเข้ามาหนึ่งเรื่อง เรามักต้องตอบคำถามพื้นฐานหลายข้อก่อนส่งต่อ เช่น เรื่องนี้ควรส่งให้ทีมไหนดูแล ลูกค้าต้องการขอเงินคืนใช่ไหม และด่วนระดับไหน คำถามพวกนี้ไม่จำเป็นต้องใช้คำตอบยาวๆ แต่ต้องคัดกรองซ้ำๆ แบบนี้กับทุกข้อความที่ส่งเข้ามา
ในตัวอย่างของ Ollama เมื่อลูกค้าส่งข้อความว่าโดนตัดเงินซ้ำสองรอบและขอเงินคืนส่วนเกิน ตัวโมเดลตอบคำถามครบทั้ง 3 ข้อได้จากการส่งคำขอเพียงครั้งเดียว ได้แก่ ควรส่งให้ทีม billing (ความน่าจะเป็น 0.985 จาก 1) ลูกค้าขอเงินคืนจริง (0.997) และประเมินระดับความด่วนมาให้พร้อม โดยทั้งหมดประมวลผลบนเครื่องเราเอง ข้อความของลูกค้าจึงไม่ต้องส่งออกไปภายนอก
Ollama ประกาศฟีเจอร์นี้ในบล็อกทางการเมื่อวันที่ 29 กันยายน 2026 โดยเรียกว่า decision models หรือโมเดลตัดสินใจ ซึ่งพัฒนาขึ้นโดยมีต้นแบบมาจาก Jev ของบริษัท TypeSafe
จุดที่ต้องทำความเข้าใจให้ชัดเจนคือ โมเดลที่รันจริงบน Ollama ไม่ใช่ตัว Jev ของ TypeSafe โดยตรง แต่เป็นโมเดล 3 ตัวที่ทำงานสไตล์เดียวกันและรับคำขอในรูปแบบเดียวกัน ได้แก่ nimble จากบริษัท Bespoke Labs รวมถึง tev1 และ tev1:0.8b จากบริษัท Together AI
จุดเด่นสำคัญที่ Ollama ชูคือ ใช้งานได้โดยไม่มีค่าใช้จ่ายเพิ่ม และตอบสนองได้เร็วขึ้น เพราะไม่ต้องส่งข้อมูลผ่านอินเทอร์เน็ตไปเซิร์ฟเวอร์ภายนอก
โมเดลตัดสินใจ: ส่งข้อความชุดเดียว ตอบได้หลายคำถามพร้อมกัน
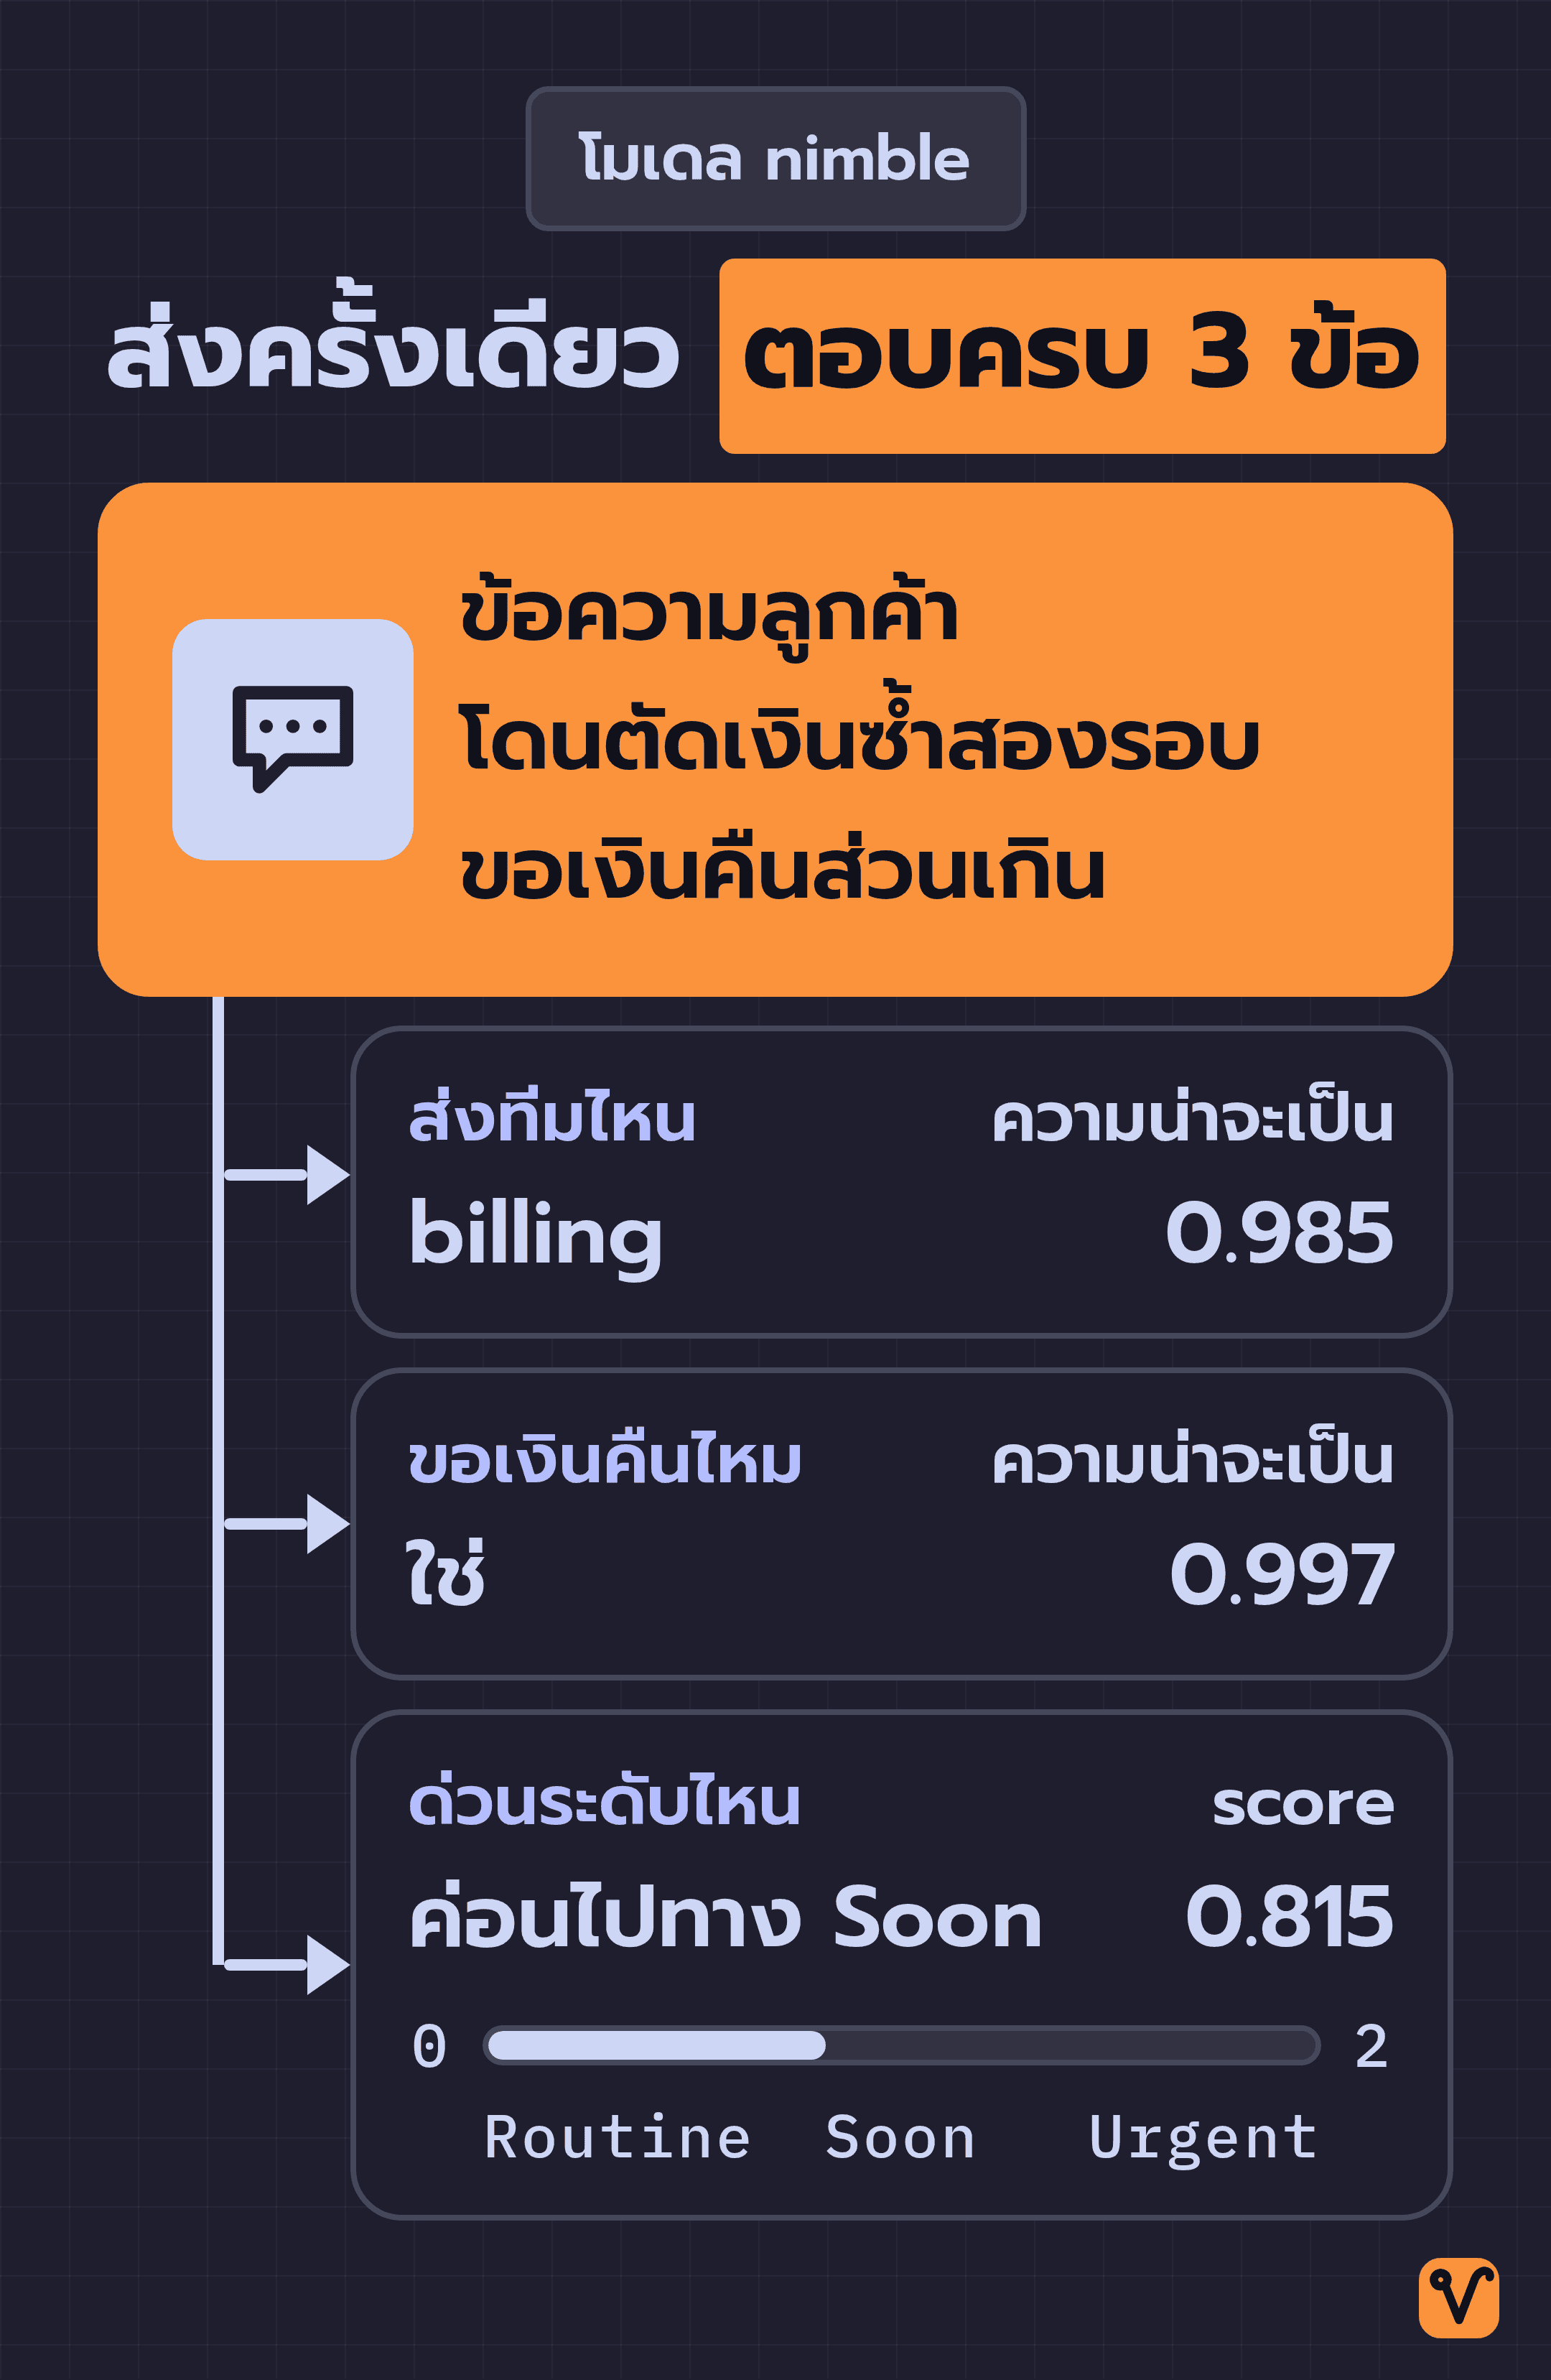
โมเดลกลุ่มนี้จะไม่ตอบกลับมาเป็นประโยคยาวๆ แต่จะเลือกคำตอบจากตัวเลือกที่เราเตรียมไว้ พร้อมบอกความน่าจะเป็นของแต่ละตัวเลือกกลับมา (ใครที่อยากศึกษาที่มาและแนวคิดต้นแบบ อ่านเพิ่มเติมได้ที่ บทความเรื่อง Jev ของ TypeSafe)
สำหรับการใช้งานบน Ollama คำขอทั้งหมดจะส่งไปที่เอนด์พอยต์ /v1/systemone ซึ่งเปิดขึ้นมารับงานตัดสินใจโดยเฉพาะ คำขอประกอบด้วย 2 ส่วนหลัก คือ state ที่เป็นข้อความหรือบริบทที่ต้องการให้โมเดลช่วยตัดสินใจ และ questions คือชุดคำถามที่ตั้งชื่อได้เอง โดยส่งได้ตั้งแต่ 1 ถึง 64 ข้อต่อหนึ่งคำขอ
ประเภทของคำถามแบ่งออกเป็น 3 แบบ:
choice: เลือก 1 คำตอบจากตัวเลือกที่กำหนดไว้ เช่น ข้อความนี้ควรส่งให้ทีมไหนnoul: คำถามแบบใช่หรือไม่ใช่ (สะกดชื่อตามเอกสารของ Ollama) โดยจะตอบกลับมาเป็นค่าความน่าจะเป็นที่คำตอบคือ "ใช่"score: ให้คะแนนเป็นระดับตามที่เรากำหนด โดยเรียงลำดับจากน้อยไปมากและเริ่มนับจาก 0 เช่น Routine, Soon, Urgent
ตัวอย่างจริงของ Ollama ส่งคำขอด้วยคำสั่ง curl โดยใส่ข้อความของลูกค้าไว้ใน state และตั้งคำถามไว้ 3 ข้อ ได้แก่ team, refund และ urgency:
curl http://localhost:11434/v1/systemone -d '{
  "model": "nimble",
  "state": {
    "ticket": "I was charged twice. Please refund the extra payment."
  },
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "billing": "Payments and refunds",
        "technical": "Bugs and integrations",
        "other": "None of the above"
      }
    },
    "refund": {
      "type": "noul",
      "instructions": "Does the customer explicitly ask for a refund?"
    },
    "urgency": {
      "type": "score",
      "instructions": "How urgent is this ticket?",
      "criteria": ["Routine", "Soon", "Urgent"]
    }
  }
}'อีกเหตุผลหนึ่งที่โมเดลกลุ่มนี้ประมวลผลได้เร็วมาก คือตัวโมเดลไม่ต้องเสียเวลาคิดหาเหตุผลก่อนตอบ โดย nimble จะอ่านพรอมต์หนึ่งรอบต่อหนึ่งคำถาม แล้วประเมินคะแนนตัวเลือกที่เป็นไปได้ออกมาทันทีโดยไม่เขียนคำอธิบายเพิ่มเติม และเราก็ไม่ต้องเขียนพรอมต์เอง เพราะ Ollama จะนำข้อมูลจาก state และ questions ไปประกอบเป็นพรอมต์ให้ทั้งหมด
วิธีอ่านผลลัพธ์: ระวังจุดสับสนระหว่าง score กับความน่าจะเป็น

ผลลัพธ์ที่ตอบกลับมาจากคำขอข้างต้นจะมีหน้าตาดังนี้:
{
  "model": "nimble",
  "answers": {
    "team": {
      "type": "choice",
      "choice": "billing",
      "probabilities": {"billing": 0.985, "technical": 0.012, "other": 0.003},
      "confidence": 0.922
    },
    "refund": {"type": "noul", "noul": 0.997},
    "urgency": {
      "type": "score",
      "score": 0.815,
      "legend": {"0": "Routine", "1": "Soon", "2": "Urgent"},
      "probabilities": {"0": 0.378, "1": 0.429, "2": 0.193},
      "confidence": 0.046
    }
  },
  "usage": {"input_tokens": 841, "output_tokens": 4}
}ถ้าดูบรรทัด usage ด้านล่างสุด จะเห็นว่าโมเดลอ่านข้อมูลเข้าไป 841 token (token คือหน่วยนับปริมาณข้อความของ AI) แต่เขียนผลลัพธ์ออกมาเพียง 4 token เท่านั้น แปลว่าโมเดลตอบคำถามครบทั้ง 3 ข้อได้โดยแทบไม่ต้องเสียเวลาสร้างข้อความตอบกลับเลย
team เป็นคำถามที่อ่านค่าง่ายที่สุด โมเดลเลือกตัวเลือก billing พร้อมแนบความน่าจะเป็นของทุกตัวเลือกมาให้ด้วย คือ billing 0.985, technical 0.012 และ other 0.003
refund เป็นคำถามแบบ noul ได้ค่า 0.997 ซึ่งหมายถึงความน่าจะเป็นที่คำตอบคือ "ใช่" แสดงว่าโมเดลมั่นใจเกือบเต็มร้อยว่าลูกค้าต้องการขอคืนเงินแน่นอน
urgency คือจุดที่อ่านผิดได้ง่ายที่สุด ค่า score 0.815 อาจดูเหมือนค่าความน่าจะเป็น แต่ความจริงคือระดับคะแนนเฉลี่ยที่ถ่วงน้ำหนักด้วยความน่าจะเป็น โดยคำถามนี้มี 3 ระดับ คือ Routine (0), Soon (1) และ Urgent (2) วิธีคิดคือนำระดับคะแนนแต่ละขั้นมาคูณกับความน่าจะเป็นของระดับนั้น แล้วนำผลลัพธ์มาบวกกัน: 0 × 0.378 + 1 × 0.429 + 2 × 0.193 = 0.815 ตัวเลขนี้จึงบอกว่า ระดับความด่วนอยู่ก้ำกึ่งระหว่าง Routine (0) กับ Soon (1) โดยค่อนไปทาง Soon มากกว่า
อีกค่าหนึ่งที่ต้องทำความเข้าใจคือ confidence ซึ่งมีค่าตั้งแต่ 0 ถึง 1 เพื่อบอกว่าความน่าจะเป็นเทไปอยู่ที่ตัวเลือกใดตัวเลือกหนึ่งมากน้อยแค่ไหน ไม่ใช่โอกาสที่คำตอบจะถูกต้อง
เมื่อลองเทียบ 2 ข้อในผลลัพธ์ชุดเดียวกัน: ข้อ team ได้ค่า confidence สูงถึง 0.922 เพราะความน่าจะเป็นเทไปที่ billing เกือบทั้งหมด ผลลัพธ์จึงชัดเจนมาก ส่วนข้อ urgency ได้ค่า confidence เพียง 0.046 เพราะความน่าจะเป็นกระจายไปทั้ง 3 ระดับแบบค่อนข้างเท่าๆ กัน จะเห็นว่าจากข้อความเดียวกัน โมเดลฟันธงเรื่องทีมได้อย่างมั่นใจ แต่กลับไม่ชัดเจนเรื่องระดับความด่วน ซึ่งก็สมเหตุสมผล เพราะในข้อความของลูกค้าไม่ได้มีคำไหนที่ระบุเรื่องความรีบด่วนเลย
เปรียบเทียบ nimble กับ tev1 เลือกรุ่นไหนให้เหมาะกับงาน
โมเดลทั้ง 3 ตัวนี้แตกต่างกันทั้งในแง่ขนาดไฟล์ ความแม่นยำ และความยาวข้อความที่รองรับ โดยตัวเลขท้ายชื่ออย่าง 9B หรือ 0.8B หมายถึงจำนวนพารามิเตอร์ระดับพันล้าน ตารางด้านล่างนี้รวบรวมข้อมูลมาจากหน้าทางการของ nimble และ tev1 บนเว็บไซต์ Ollama:
| โมเดล | ขนาดไฟล์ | ความแม่นยำเฉลี่ย | ความยาวข้อความที่รองรับ |
|---|---|---|---|
| nimble (9B, Bespoke Labs) | ประมาณ 9.3–9.5 GB | 75.7% | 8,192 token |
| tev1 (4B, Together AI) | ประมาณ 4.4–4.5 GB | 73.3% | ประมาณ 2,000 token |
| tev1:0.8b (0.8B, Together AI) | ประมาณ 797–812 MB | 63.5% | ประมาณ 2,000 token |
ตัวเลขความแม่นยำในตารางเป็นค่าเฉลี่ยจาก ชุดทดสอบสาธารณะของ Bespoke Labs รวม 13 ชุด ซึ่งใช้เฉลยที่มนุษย์เป็นผู้ประเมิน รวมการตัดสินใจทั้งหมด 3,880 ครั้ง ในชุดทดสอบเดียวกันนี้ Jev 1.13 ตัวจริงของ TypeSafe ทำคะแนนได้ 76.0% ซึ่งยังแม่นยำกว่า nimble อยู่นิดหน่อย ทั้งนี้ ตัวเลขของ nimble และ tev1 มาจากการทดสอบบน Ollama ส่วนตัวเลขของ Jev มาจากการทดสอบของ Bespoke Labs ผ่าน API ของ TypeSafe
ช่องสุดท้ายเรื่องความยาวข้อความหรือ context คือจุดที่เข้าใจผิดได้ง่ายที่สุด แม้บนหน้าโมเดลจะระบุไว้ว่ารองรับ context ได้ถึง 256K แต่หมายเหตุในหน้านั้นระบุเงื่อนไขการใช้งานจริงไว้ชัดเจนว่า พรอมต์ของ nimble ควรยาวไม่เกิน 8,192 token และพรอมต์ที่สั้นกว่าจะผ่านการทดสอบมาครอบคลุมกว่า ส่วน tev1 รองรับการทำงานจริงอยู่ที่ประมาณ 2,000 token
ที่สำคัญคือ พื้นที่ context มักจะเต็มเร็วกว่าที่เราประเมินไว้ เพราะในทางปฏิบัติ พรอมต์ของแต่ละคำถามจะต้องพ่วงทั้งข้อความเต็มและคำถามทั้งชุดเข้าไปด้วย ถ้าเราต้องการส่งประวัติการคุยยาวๆ ให้ tev1 จึงจำเป็นต้องตัดทอนข้อความให้สั้นลงก่อนเสมอ ซึ่งหน้าโมเดลของ tev1 เองก็แนะนำให้ส่งเฉพาะข้อความสั้นๆ เข้ามาเช่นกัน
การเลือกรุ่นจึงเป็นการชั่งน้ำหนักระหว่างทรัพยากรเครื่องกับความแม่นยำ: ถ้าเครื่องมีแรมหรือหน่วยความจำจำกัด แนะนำให้เริ่มจาก tev1:0.8b ซึ่งเป็นรุ่นไฟล์เล็กที่ออกแบบมาสำหรับกรณีนี้โดยเฉพาะ แต่หากมีข้อความขนาดยาว หรือเน้นความแม่นยำสูงสุด nimble จะเป็นตัวเลือกที่ตอบโจทย์ที่สุด ส่วน tev1 รุ่น 4B จะอยู่ตรงกลางระหว่างสองรุ่นนี้
ติดตั้งโมเดลด้วย ollama pull แล้วเริ่มใช้งานผ่าน /v1/systemone
ดาวน์โหลดโมเดลลงเครื่องได้ง่ายๆ ด้วยคำสั่ง ollama pull nimble (ถ้าต้องการใช้ตระกูล tev1 ให้สั่ง ollama pull tev1:4b หรือ ollama pull tev1:0.8b) ดาวน์โหลดเสร็จแล้วเรียกใช้งานได้ 2 ช่องทาง:
ช่องทางแรกคือ ส่งคำขอผ่าน curl ตามตัวอย่างข้างต้น ซึ่งเรียกใช้งานได้ทันทีเพราะ URL ชี้ไปที่ Ollama บนเครื่องเราอยู่แล้ว
ช่องทางที่สองคือ เรียกผ่าน typesafe-sdk ซึ่งเป็น SDK ภาษา Python ทางการของ TypeSafe โดยกำหนดค่าให้ชี้มาทำงานร่วมกับ Ollama ในเครื่องแทน ติดตั้งและตั้งค่าตัวแปร environment ตามตัวอย่างของ Ollama ได้ดังนี้:
uv add typesafe-sdk # or: pip install typesafe-sdk
export TYPESAFE_BASE_URL=http://localhost:11434
export TYPESAFE_API_KEY=ollama
export TYPESAFE_DEFAULT_MODEL=nimbleTYPESAFE_BASE_URL: กำหนดให้ SDK ชี้มาที่ Ollama บนเครื่องเราTYPESAFE_API_KEY: ใส่ไว้เนื่องจากตัว SDK บังคับให้ต้องมีค่า API Key แต่ฝั่ง Ollama ไม่ได้ตรวจสอบค่านี้ จะใส่ค่าอะไรก็ได้TYPESAFE_DEFAULT_MODEL: ระบุโมเดลตั้งต้นที่ต้องการใช้งาน
จากนั้นในโค้ด Python ให้เรียกใช้คำสั่ง client.system_one(state=..., questions=...) โดยส่งข้อความและคำถามรูปแบบเดียวกับคำสั่ง curl ในตัวอย่างของ Ollama ผลลัพธ์ที่ได้คือ billing, 0.997 และ 0.815 ตรงกับคำตอบก่อนหน้านี้ทุกประการ
วิธีนี้เหมาะเป็นพิเศษสำหรับคนที่เคยเขียนโค้ดเรียกใช้งาน Jev ผ่าน SDK ตัวนี้อยู่แล้ว เพราะ /v1/systemone ใช้ API แบบเดียวกับ Jev และ SDK ตัวเดิมชี้มาที่ Ollama ได้ด้วยตัวแปรชุดนี้
สิ่งสำคัญที่ต่างจากโมเดลอื่นบน Ollama คือ แม้จะใช้คำสั่ง ollama pull ดึงโมเดลลงมาได้ตามปกติ แต่งานตัดสินใจยังไม่สามารถสั่งรันผ่านคำสั่งทั่วไปอย่าง ollama run ได้ และยังไม่รองรับในไลบรารี Python หรือ JavaScript ของ Ollama โดยตรง ในตอนนี้จึงต้องเรียกผ่าน HTTP API หรือ SDK ของ TypeSafe เท่านั้น นอกจากนี้ หน้าโมเดลของ tev1 ยังเตือนไว้ว่า ถ้านำโมเดลนี้ไปแชตคุยเหมือนโมเดลทั่วไป ตัวโมเดลมักจะตอบกลับมาเป็นประโยคยาวๆ งานตัดสินใจจึงต้องส่งผ่านเอนด์พอยต์ /v1/systemone เสมอ
ตัวอย่างการใช้งานจริง: คัด Ticket, เลือกโมเดล และดักตรวจคำสั่งก่อน Agent รัน
ตัวอย่างงานจริงที่ Ollama นำเสนอ ใช้โครงสร้างคำขอเดียวกันนี้ได้ทันที เพียงเปลี่ยนเนื้อหาใน state และปรับคำถามให้ตรงกับงาน:
คัดแยก Ticket แจ้งปัญหา ตัวอย่างคือเมื่อมีข้อความแจ้งปัญหาเข้ามาว่า "หน้าชำระเงินขึ้น Error 500 มาตั้งแต่ 9 โมงเช้า" เราสามารถใช้คำถามแบบ choice เพียงข้อเดียวเพื่อถามว่าเคสนี้ควรส่งให้ฝ่าย billing, bug หรือ account โดยในตัวอย่างนี้ใส่คำอธิบายของแต่ละตัวเลือกเป็น null เพื่อให้โมเดลตีความจากชื่อตัวเลือกเอง (จุดนี้ต้องระวังอย่าสะกดสลับกับ noul เพราะ null หมายถึงไม่มีคำอธิบาย ไม่ใช่ชนิดของคำถาม)
เลือกขนาดโมเดลให้เหมาะกับงาน หรือ Model Routing ใช้ตัดสินใจว่าพรอมต์นี้ควรส่งไปให้โมเดลขนาดเล็กหรือขนาดใหญ่จัดการ ในตัวอย่างของ Ollama ใช้พรอมต์ที่ขอให้ออกแบบโครงสร้างฐานข้อมูลระบบบัญชีการชำระเงิน ฟีเจอร์นี้มีประโยชน์มากสำหรับคนที่พัฒนาระบบ AI Agent หรือผู้ช่วยอัตโนมัติที่ต้องจ่ายค่า API ทุกครั้งที่เรียกใช้งาน โดยเราสามารถส่งงานง่ายๆ ไปให้โมเดลตัวเล็กช่วยประหยัดค่าใช้จ่าย แล้วเก็บโมเดลตัวใหญ่ไว้เฉพาะงานที่ซับซ้อนจริงๆ
ตรวจความปลอดภัยก่อน Agent รันคำสั่ง สมมติว่า Agent กำลังจะสั่งรันคำสั่งอันตรายอย่าง rm -rf ~ ซึ่งจะลบไฟล์ทั้งหมดในโฟลเดอร์ผู้ใช้ ตัวอย่างของ Ollama ได้ส่งคำสั่งนั้นเข้าไปใน state แล้วถามด้วยคำถามแบบ noul ว่าคำสั่งนี้สร้างความเสียหายได้หรือไม่ เพื่อตรวจสอบความปลอดภัยก่อนอนุญาตให้รันคำสั่งจริง
ประมวลผลและตัดสินใจแบบเรียลไทม์ ในเดโมที่ให้ nimble เล่นเกม Pac-Man โมเดลใช้เวลาประมวลผลเฉลี่ยเพียง 91 มิลลิวินาที หรือไม่ถึง 0.1 วินาทีต่อการตัดสินใจหนึ่งครั้ง ทาง Ollama ระบุว่าความเร็วระดับนี้เพียงพอที่จะนำไปใช้กับเกมหรือการคัดกรองเนื้อหาแบบเรียลไทม์ได้ ทั้งนี้ ตัวเลข 91 มิลลิวินาทีนี้วัดจากการทดสอบบนเครื่องที่ใช้ชิป Apple M5 Max ถ้าใช้งานบนคอมพิวเตอร์สเปกอื่น จึงควรทดสอบความเร็วบนเครื่องตัวเองก่อนนำไปขึ้นระบบที่ต้องตอบสนองทันที
ก่อนนำไปใช้จริง ควรทดสอบกับข้อความภาษาไทยของตัวเอง
ตัวอย่างทั้งหมดข้างต้นเป็นข้อความภาษาอังกฤษ แต่ในฝั่ง tev1 ทาง Together AI ผู้พัฒนาได้ระบุไว้เองว่า ยังไม่ได้ทดสอบโมเดลกับภาษาอื่นนอกจากภาษาอังกฤษอย่างเต็มรูปแบบ ดังนั้น ธุรกิจหรือร้านค้าที่ลูกค้าพิมพ์ข้อความภาษาไทยเข้ามา จึงจำเป็นต้องนำข้อความจริงในงานของตัวเองมาทดสอบก่อนเสมอ เพื่อดูว่าคำตอบที่ได้ตรงกับเกณฑ์ที่ทีมงานเคยตัดสินใจไว้หรือไม่
อีกจุดสำคัญคือ ค่าความน่าจะเป็น 0.9 ไม่ได้หมายความว่าโมเดลจะตอบถูก 90% กับข้อมูลจริงของเราเสมอไป ซึ่งหน้าเอกสารของ nimble ก็เตือนไว้ตรงๆ และแนะนำให้เราทดสอบหาเกณฑ์ที่เหมาะสมกับข้อมูลของตัวเองก่อน ถ้าคิดจะตั้งระบบให้ส่งเคสต่อไปทีม billing อัตโนมัติเมื่อความน่าจะเป็นสูงกว่า 0.9 เกณฑ์ 0.9 นั้นต้องผ่านการทดสอบกับข้อความเก่าที่รู้คำตอบที่ถูกต้องอยู่แล้วก่อนเท่านั้น
นอกจากนี้ โมเดลยังมีโอกาสตอบผิดได้เสมอ หน้าเอกสารของ tev1 จึงเตือนว่า ไม่ควรใช้โมเดลนี้เป็นระบบป้องกันเพียงชั้นเดียวในการตัดสินใจที่อาจสร้างความเสียหายรุนแรง เช่น การอนุมัติคืนเงิน หรือการปล่อยให้ Agent รันคำสั่งลบไฟล์ แต่ควรมีระบบตรวจสอบอีกชั้น เช่น ให้คนเป็นผู้กดยืนยันก่อนเสมอ
สุดท้ายคือ ตัวโมเดลจะประเมินคะแนนของแต่ละคำถามแยกกันอย่างอิสระ ถ้างานของเรามีเงื่อนไขว่าคำตอบแต่ละข้อต้องสอดคล้องกัน โค้ดของเราต้องเป็นฝ่ายตรวจสอบตรรกะนั้นเอง เช่น ถ้าลูกค้าขอคืนเงิน แต่ผลการเลือกทีมกลับไม่ได้เลือกทีม billing
เริ่มต้นง่ายๆ ด้วย tev1:0.8b โมเดลขนาดเล็กที่สุด
ถ้าต้องการเริ่มต้นทดสอบกับงานของตัวเองโดยใช้ทรัพยากรเครื่องน้อยที่สุด แนะนำให้ทำตามขั้นตอนดังนี้:
- อัปเดต Ollama ให้เป็นเวอร์ชัน 0.35 ขึ้นไป จาก หน้าดาวน์โหลดของ Ollama
- ดาวน์โหลดโมเดลรุ่นเล็กที่สุดลงเครื่องด้วยคำสั่ง
ollama pull tev1:0.8b - เลือกข้อความจริงจากงานของตัวเองมา 1 ข้อความ ตั้งคำถาม 3 ข้อที่งานนั้นต้องการคำตอบจริง แล้วส่งคำขอผ่าน curl ตามตัวอย่างข้างต้น โดยเปลี่ยนชื่อโมเดลเป็น
"model": "tev1:0.8b" - ถ้าข้อความมีโอกาสไม่ตรงกับตัวเลือกใดๆ เลย ให้เพิ่มตัวเลือกสำรองอย่าง
noneเข้าไปด้วยตามคำแนะนำของ tev1 เช่นเดียวกับที่มีตัวเลือกotherในตัวอย่างของ Ollama - เมื่อทดสอบระบบจนลงตัวแล้ว และต้องการความแม่นยำที่สูงขึ้น ค่อยขยับไปใช้งานโมเดลขนาดใหญ่กว่าอย่าง nimble
โมเดลตัดสินใจช่วยคัดกรองและประเมินคำตอบแทนเราได้แทบทุกโจทย์ ยกเว้นโจทย์เดียวที่เราต้องเป็นผู้ตัดสินใจเอง คือระดับความมั่นใจเท่าไรที่เรายอมรับได้ เพื่อปล่อยให้ระบบทำงานอัตโนมัติ
ที่มา:
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
ChatGPT Work ฉบับเข้าใจง่าย มอบงานให้ AI ทำจนจบ ตั้งแต่งานแรกจนถึงงานอัตโนมัติ พร้อม workflow ใช้ได้จริง 8 แบบ
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin