SkillSeek งานวิจัยใหม่พบว่า ใส่สกิลให้ AI agent ครบ 192 ตัว คะแนนแทบไม่ต่างจากไม่ใส่เลย แต่ใช้ token เพิ่ม 59%
SkillSeek คืองานวิจัยการเลือกสกิลให้ AI agent จากคลังที่โตเกิน 230,000 ตัว ผลคือ search engine ธรรมดาเลือกได้ดีพอๆ กับให้ AI หาเอง แต่ค่ารันถูกลงเกือบครึ่ง
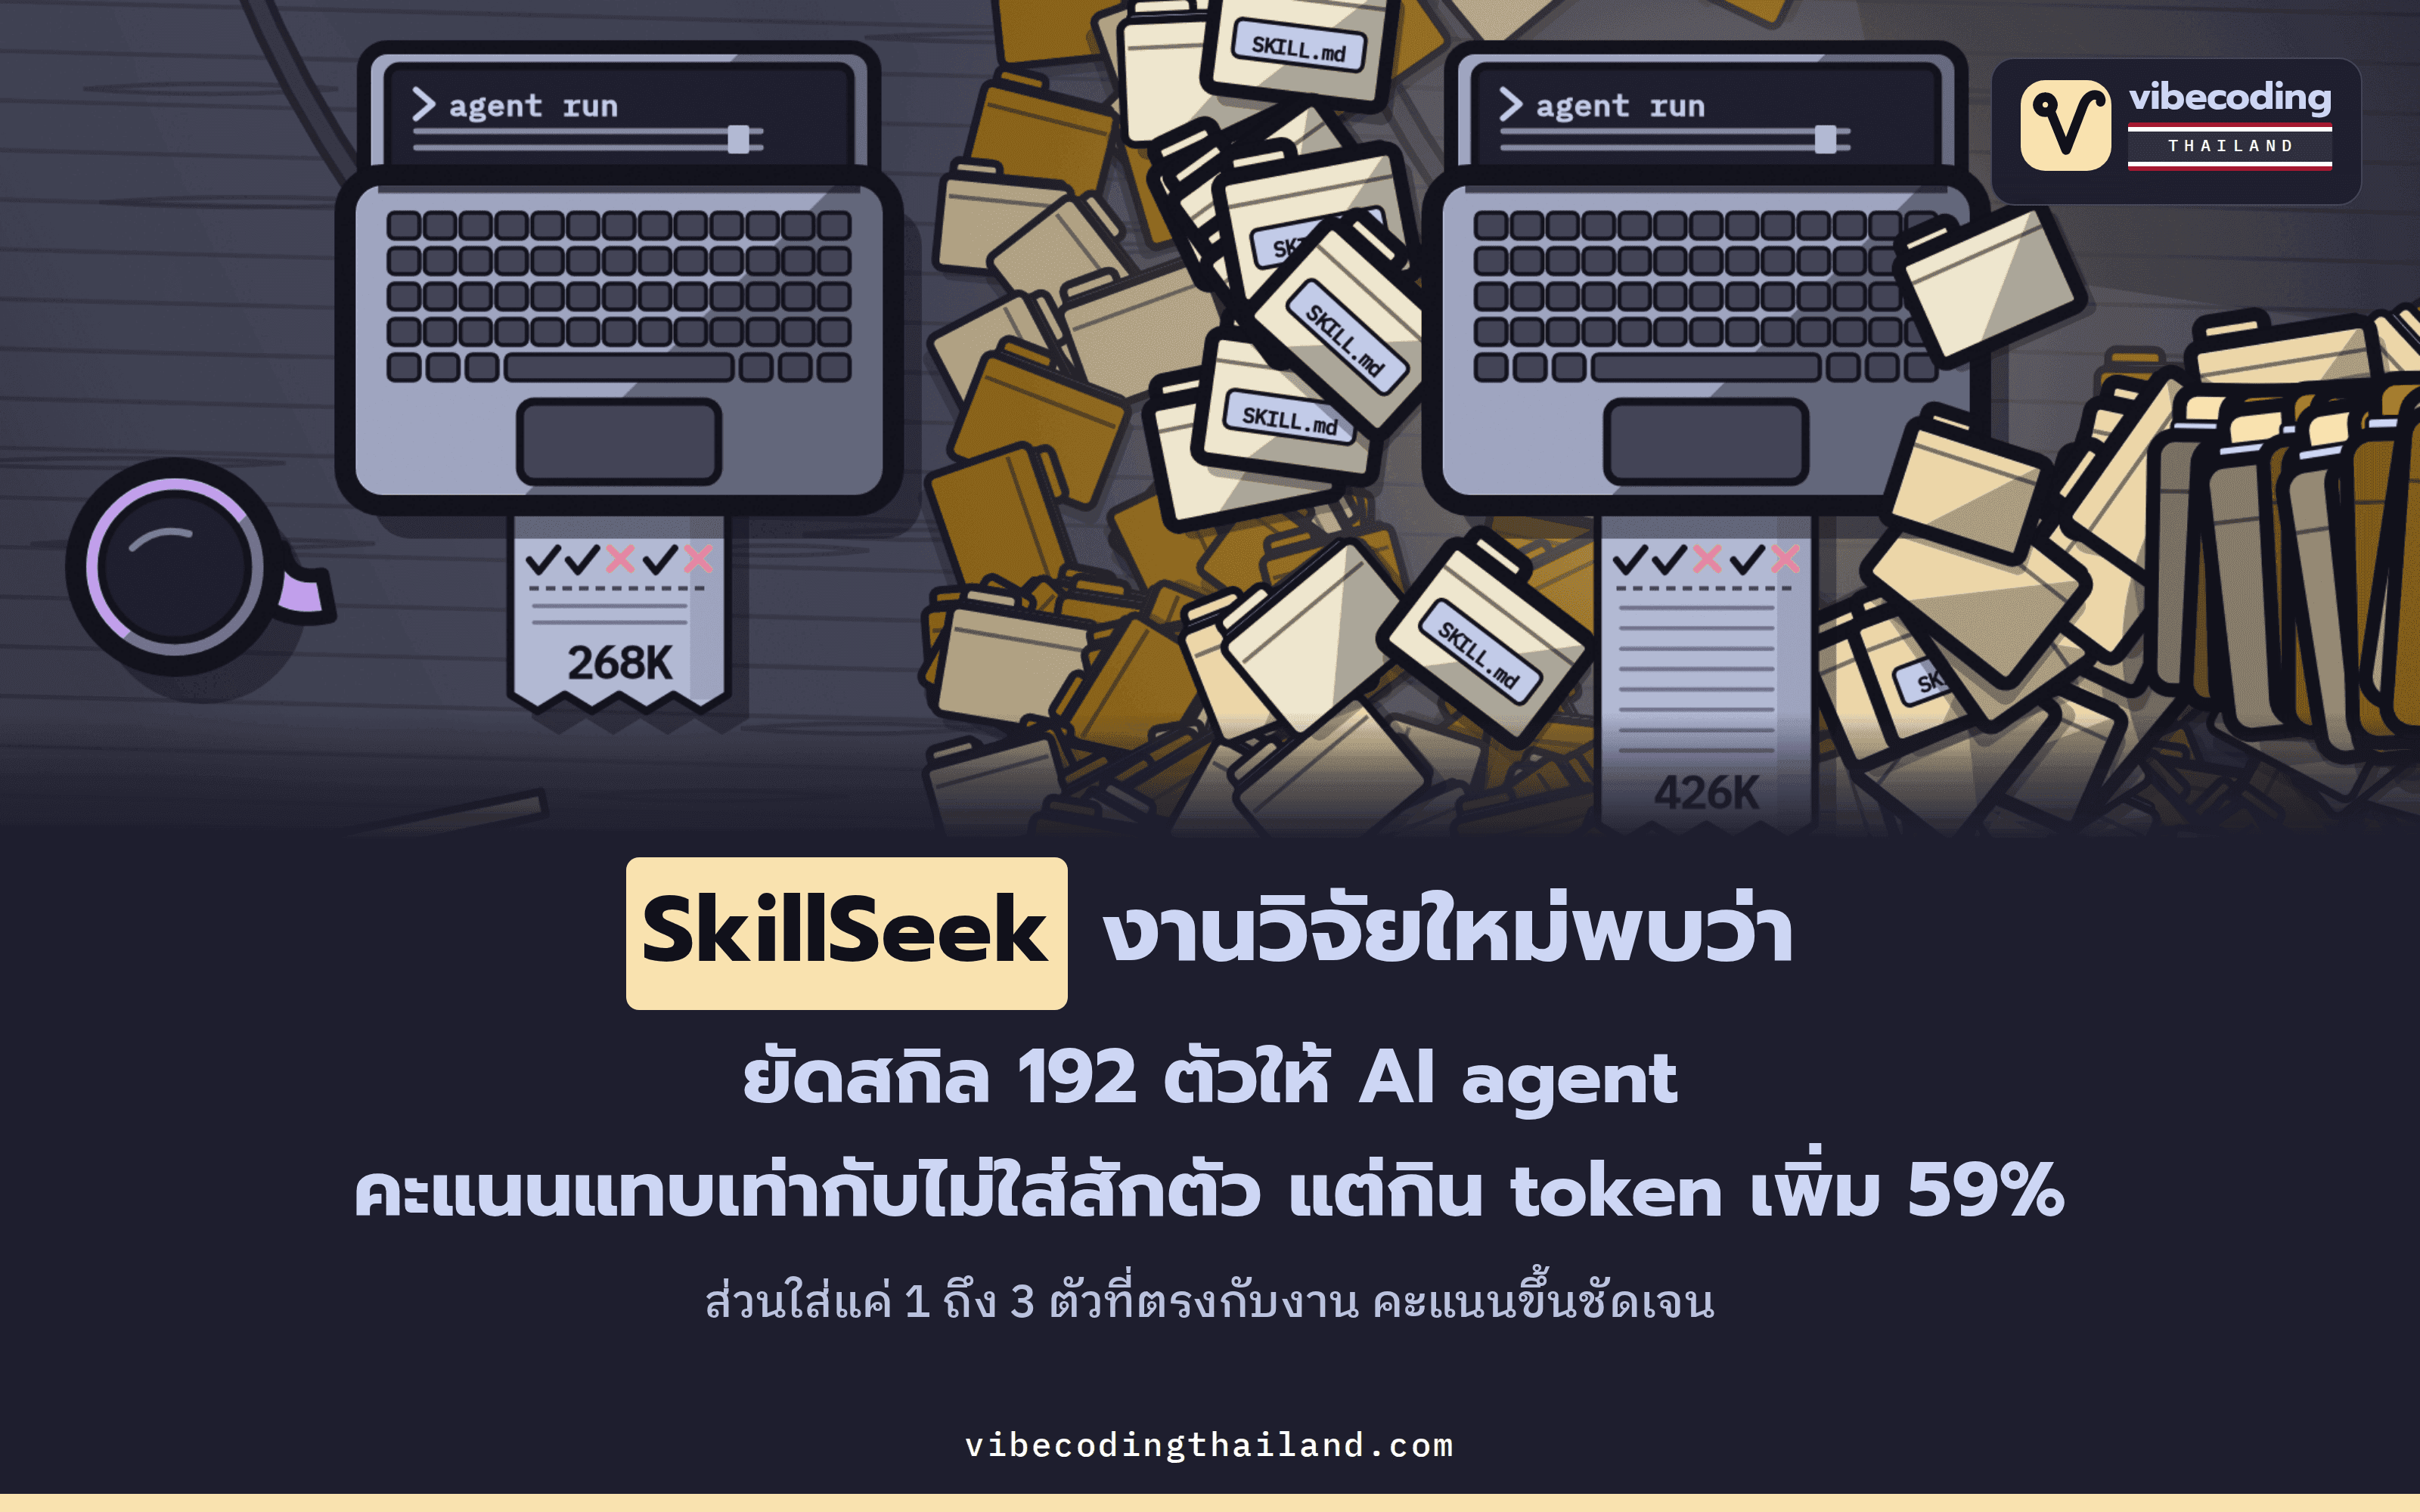
งานวิจัย SkillSeek ทดลองใส่สกิล หรือชุดคำสั่งสอนงานเฉพาะทาง เช่น การเทียบข้อมูลระหว่างไฟล์ PDF กับ Excel ให้กับโปรแกรมผู้ช่วยอัตโนมัติอย่าง AI agent ครบทั้ง 192 ตัว แล้วพบว่าคะแนนการทำงานแทบไม่ต่างจากตอนไม่ใส่เลยแม้แต่ตัวเดียว แต่สิ่งที่พุ่งสูงขึ้นอย่างเห็นได้ชัดคือปริมาณ token ซึ่งเป็นหน่วยนับข้อความสำหรับคำนวณค่าบริการ โดยเพิ่มขึ้นถึง 59%
ตัวเลขนี้มาจากการทดลองนำร่องของทีมวิจัยผู้พัฒนา SkillSeek ได้แก่ Guanqun Yang, Wenlong Zhang, Tian Shi และ Ping Wang ซึ่งเพิ่งเผยแพร่ผลงานบนหน้า Hugging Face Papers เมื่อวันที่ 30 กันยายนที่ผ่านมา ในรอบนี้ทีมวิจัยให้โมเดล gpt-oss-120b ทำงานทั้งหมด 89 งาน และให้คะแนนแต่ละงานตามสัดส่วนของเกณฑ์ทดสอบที่ผ่าน ตั้งแต่ 0 ถึง 1
| รูปแบบการทดลอง | คะแนน | token เฉลี่ยต่อรอบ |
|---|---|---|
| ไม่ใส่สกิลเลย | 0.384 | 268K |
| ใส่ครบทั้ง 192 ตัว | 0.387 | 426K (เพิ่ม 59%) |
| คัดเลือก 1 ถึง 3 ตัวที่ตรงกับงาน | 0.484 | 314K (เพิ่ม 17%) |
แถวสุดท้ายคือชุดสกิล 1 ถึง 3 ตัวที่มีคนคัดไว้ล่วงหน้าให้ตรงกับแต่ละงาน ไม่ได้มาจากระบบค้นหาใดๆ จึงใช้ดูว่าถ้า Agent ได้สกิลที่ตรงกับงานจริงๆ จะทำคะแนนได้ดีที่สุดแค่ไหน
ถ้าคุณติดตั้งสกิลให้ Agent ไว้หลายสิบตัว เพราะคิดว่ายิ่งมีเยอะจะยิ่งเก่งขึ้น ผลการทดลองนี้น่าจะทำให้ต้องคิดใหม่ เพราะคำถามสำคัญกลายเป็นว่า ใครควรเป็นคนเลือกสกิล และควรเลือกด้วยวิธีไหน ซึ่งงานวิจัย SkillSeek มีคำตอบให้ทั้งสองข้อ
Agent Skills โหลดข้อมูลทีละชั้น แต่เมื่อคลังใหญ่เกินไป Agent ก็รับไม่ไหว
ระบบสกิลที่ใช้ในการทดลองนี้อิงจากระบบ Agent Skills ของบริษัทพัฒนา AI อย่าง Anthropic โดยแต่ละสกิลจะจัดเก็บเป็นโฟลเดอร์ที่มีไฟล์ SKILL.md เป็นหลัก ภายในไฟล์จะเขียนขั้นตอนและวิธีทำงานเรื่องหนึ่งไว้ให้ Agent ทำตาม
ตามปกติแล้ว Agent จะไม่ได้อ่านเนื้อหาทั้งหมดของทุกสกิลตั้งแต่แรก แต่ใช้วิธีโหลดข้อมูลเป็นลำดับขั้น ตอนเริ่มงาน Agent จะเห็นเพียงชื่อและคำอธิบายสั้นๆ ของแต่ละสกิล ซึ่งยาวประมาณ 30 token เมื่อเห็นว่าสกิลไหนตรงกับงานตรงหน้า จึงค่อยเปิดไฟล์ SKILL.md เพื่ออ่านเนื้อหาฉบับเต็ม ส่วนสคริปต์หรือไฟล์เสริมในโฟลเดอร์จะเปิดใช้เฉพาะตอนที่จำเป็นจริงๆ เท่านั้น
แต่ปัญหาคือ คลังสกิลสาธารณะในปัจจุบันเติบโตเร็วมาก ทีมวิจัย SkillSeek รวบรวมสถิติจากหลายแหล่ง พบว่าจำนวนสกิลเพิ่มขึ้นจาก 47,150 ตัว เป็น 55,315 ตัว แล้วพุ่งทะลุ 118,000 ตัว จนการสำรวจรอบล่าสุดนับได้ถึง 238,180 ตัวบนแพลตฟอร์มแจกสกิลหลักๆ
แน่นอนว่าไม่มี AI agent ตัวไหนอ่านคลังสกิลขนาดใหญ่ระดับนี้ไหว จึงต้องมีระบบคอยคัดเลือกล่วงหน้าว่าจะให้ Agent มองเห็นสกิลใดบ้าง คำถามสำคัญจึงเปลี่ยนจาก 'จะเขียนสกิลอย่างไร' มาเป็น 'จะเลือกสกิลไหนให้ Agent เห็น'
แล้วควรให้ Agent เห็นสกิลกี่ตัวถึงจะดีที่สุด? คำตอบอยู่ในงานวิจัย SkillsBench ซึ่งเป็นชุดทดสอบวัดประสิทธิภาพของ Agent และเป็นที่มาของโจทย์ทดสอบ 89 งานที่ SkillSeek นำมาใช้ทดลอง
ทีมงาน SkillsBench รายงานว่า หากใส่สกิลที่ตรงกับงาน 1 ตัว ประสิทธิภาพของ Agent จะเพิ่มขึ้น 17.8% หากใส่ 2 ถึง 3 ตัว จะเพิ่มขึ้น 18.6% แต่ถ้าใส่ตั้งแต่ 4 ตัวขึ้นไป ประสิทธิภาพกลับเพิ่มขึ้นเพียง 5.9% เท่านั้น
แม้ตัวเลขชุดนี้จะเป็นผลการทดลองของฝั่ง SkillsBench เอง ไม่ใช่ของ SkillSeek แต่เมื่อนำมาดูประกอบกัน งานวิจัยทั้งสองก็ชี้ไปที่ข้อสรุปเดียวกัน นั่นคือ ระบบคัดเลือกสกิลต้องเลือกให้ตรงกับงานจริงๆ เพราะการหยิบมาเผื่อหลายๆ ตัว กลับให้ผลลัพธ์ที่แย่ลง
ให้ AI ค้นหาเอง หรือใช้ระบบค้นหาแบบ Search Engine
แนวทางที่งานวิจัยก่อนหน้านี้เลือกใช้ คือการให้ AI วนค้นหาด้วยตัวเอง ในขั้นตอนนี้ โมเดลภาษาขนาดใหญ่อย่าง LLM ที่ทำหน้าที่เป็นสมองของ Agent จะคอยเขียนคำค้นหาใหม่ ไล่ดูสกิลที่ค้นเจอ แล้วนำมาประกอบเป็นสกิลใหม่สำหรับงานนั้น โดยทุกขั้นตอนต้องเรียกใช้ LLM อยู่ตลอด ทำให้เสียค่า token เพิ่มขึ้นทุกครั้งที่มีงานใหม่เข้ามา
ข้อดีของวิธีนี้มีอยู่จริง เช่น ในโจทย์งานหนึ่งที่ต้องแบ่งข้อมูลไปคำนวณบน GPU หลายตัว Agent สามารถหยิบสกิลสองตัวที่เกี่ยวข้องกันเพียงบางส่วน แล้วนำมารวมกันจนเกิดเป็นวิธีแก้ปัญหาใหม่ที่ไม่มีอยู่ในสกิลใดสกิลหนึ่ง ซึ่งระบบค้นหาแบบกำหนดสูตรตายตัวทำแบบนี้ไม่ได้
แต่สำหรับ SkillSeek ทีมวิจัยเลือกแนวทางที่ต่างออกไป โดยหันมาใช้สถาปัตยกรรมเดียวกับ Search Engine ทั่วไป และแบ่งการค้นหาออกเป็นสองชั้น:
- ชั้นแรก: ใช้โมเดลขนาดเล็กประเมินและให้คะแนนสกิลทุกตัวในคลังว่าเข้ากับงานแค่ไหน แล้วคัดเลือกมา 20 ตัว
- ชั้นที่สอง: ใช้โมเดลขนาดเล็กอีกตัวมาจัดอันดับสกิล 20 ตัวนั้นใหม่ เพื่อให้ได้ตัวที่ตรงกับงานที่สุด
เมื่อผ่านทั้งสองชั้นแล้ว Agent จึงหยิบเฉพาะสกิลอันดับบนสุดเพียงไม่กี่ตัวไปใช้งาน
ในเชิงเทคนิค ชั้นแรกใช้โมเดลค้นหาแบบ bi-encoder รุ่น BGE-base ขนาด 110 ล้านพารามิเตอร์ ส่วนชั้นที่สองใช้ reranker ซึ่งเป็นโมเดลจัดอันดับความเกี่ยวข้อง รุ่น bge-reranker-v2-m3 ขนาด 568 ล้านพารามิเตอร์ ทั้งกระบวนการไม่ต้องเรียกใช้ LLM เลยแม้แต่ครั้งเดียว ทำงานบน CPU ได้ และโดยทั่วไปใช้เวลาค้นหาราว 1.1 วินาทีต่อครั้ง
สิ่งที่ต้องทำความเข้าใจคือ การไม่เรียกใช้ LLM ไม่ได้แปลว่าไม่ได้ใช้โมเดล AI เลย แต่ทั้งสองชั้นนี้เป็นโมเดลขนาดเล็กที่ทำหน้าที่ประเมินและให้คะแนนเท่านั้น ไม่ได้เขียนข้อความใหม่ออกมา จึงไม่กิน token ของ LLM หลัก
นอกจากนี้ ทีมวิจัยยังนำ BM25 มาทดสอบเปรียบเทียบด้วย ซึ่งเป็นวิธีค้นหาพื้นฐานแบบจับคู่คำตรงตัวที่ใช้กันมาตั้งแต่ยุค 1990 รวมแล้วการทดลองหลักวัดผลวิธีเลือกสกิลทั้งหมด 11 วิธี
คะแนนไม่ต่างกัน แต่ค่าใช้จ่ายลดลงเกือบครึ่ง
การทดลองหลักใช้โจทย์ 89 งานชุดเดียวกับรอบนำร่อง โดยทีมวิจัยทดสอบบนคลังสกิล 2 ขนาด ได้แก่ คลังสกิล 192 ตัวที่ผ่านการคัดสรรมาแล้ว และคลังสกิลขนาดใหญ่ในตลาดราว 34,000 ตัว พร้อมสลับทดสอบกับโมเดล 2 ตัว คือ Qwen3.5-397B-A17B และ MiniMax-M2.7 รวมเป็นเงื่อนไขการทดสอบทั้งหมด 4 รูปแบบ
ผลปรากฏว่า BM25 ซึ่งเป็นวิธีค้นหาที่เรียบง่ายที่สุด กลับทำคะแนนได้เท่ากันหรือสูงกว่าการปล่อยให้ AI ค้นหาเองถึง 3 ใน 4 เงื่อนไข
| เงื่อนไขการทดสอบ | BM25 | ให้ AI ค้นหาเอง |
|---|---|---|
| คลัง 192 ตัว ร่วมกับ Qwen3.5 | 0.430 | 0.397 |
| คลัง 192 ตัว ร่วมกับ MiniMax | 0.387 | 0.344 |
| คลัง 34,000 ตัว ร่วมกับ MiniMax | 0.346 | 0.329 |
| คลัง 34,000 ตัว ร่วมกับ Qwen3.5 | 0.420 | 0.442 |
แถวล่างสุดเป็นเงื่อนไขเดียวที่การให้ AI ค้นหาเองทำคะแนนได้ดีกว่า แต่ระบบ SkillSeek รุ่นที่ใช้ reranker ขนาดเล็กอย่าง Qwen3-Reranker-0.6B ก็ทำคะแนนได้ 0.442 เท่ากันพอดี
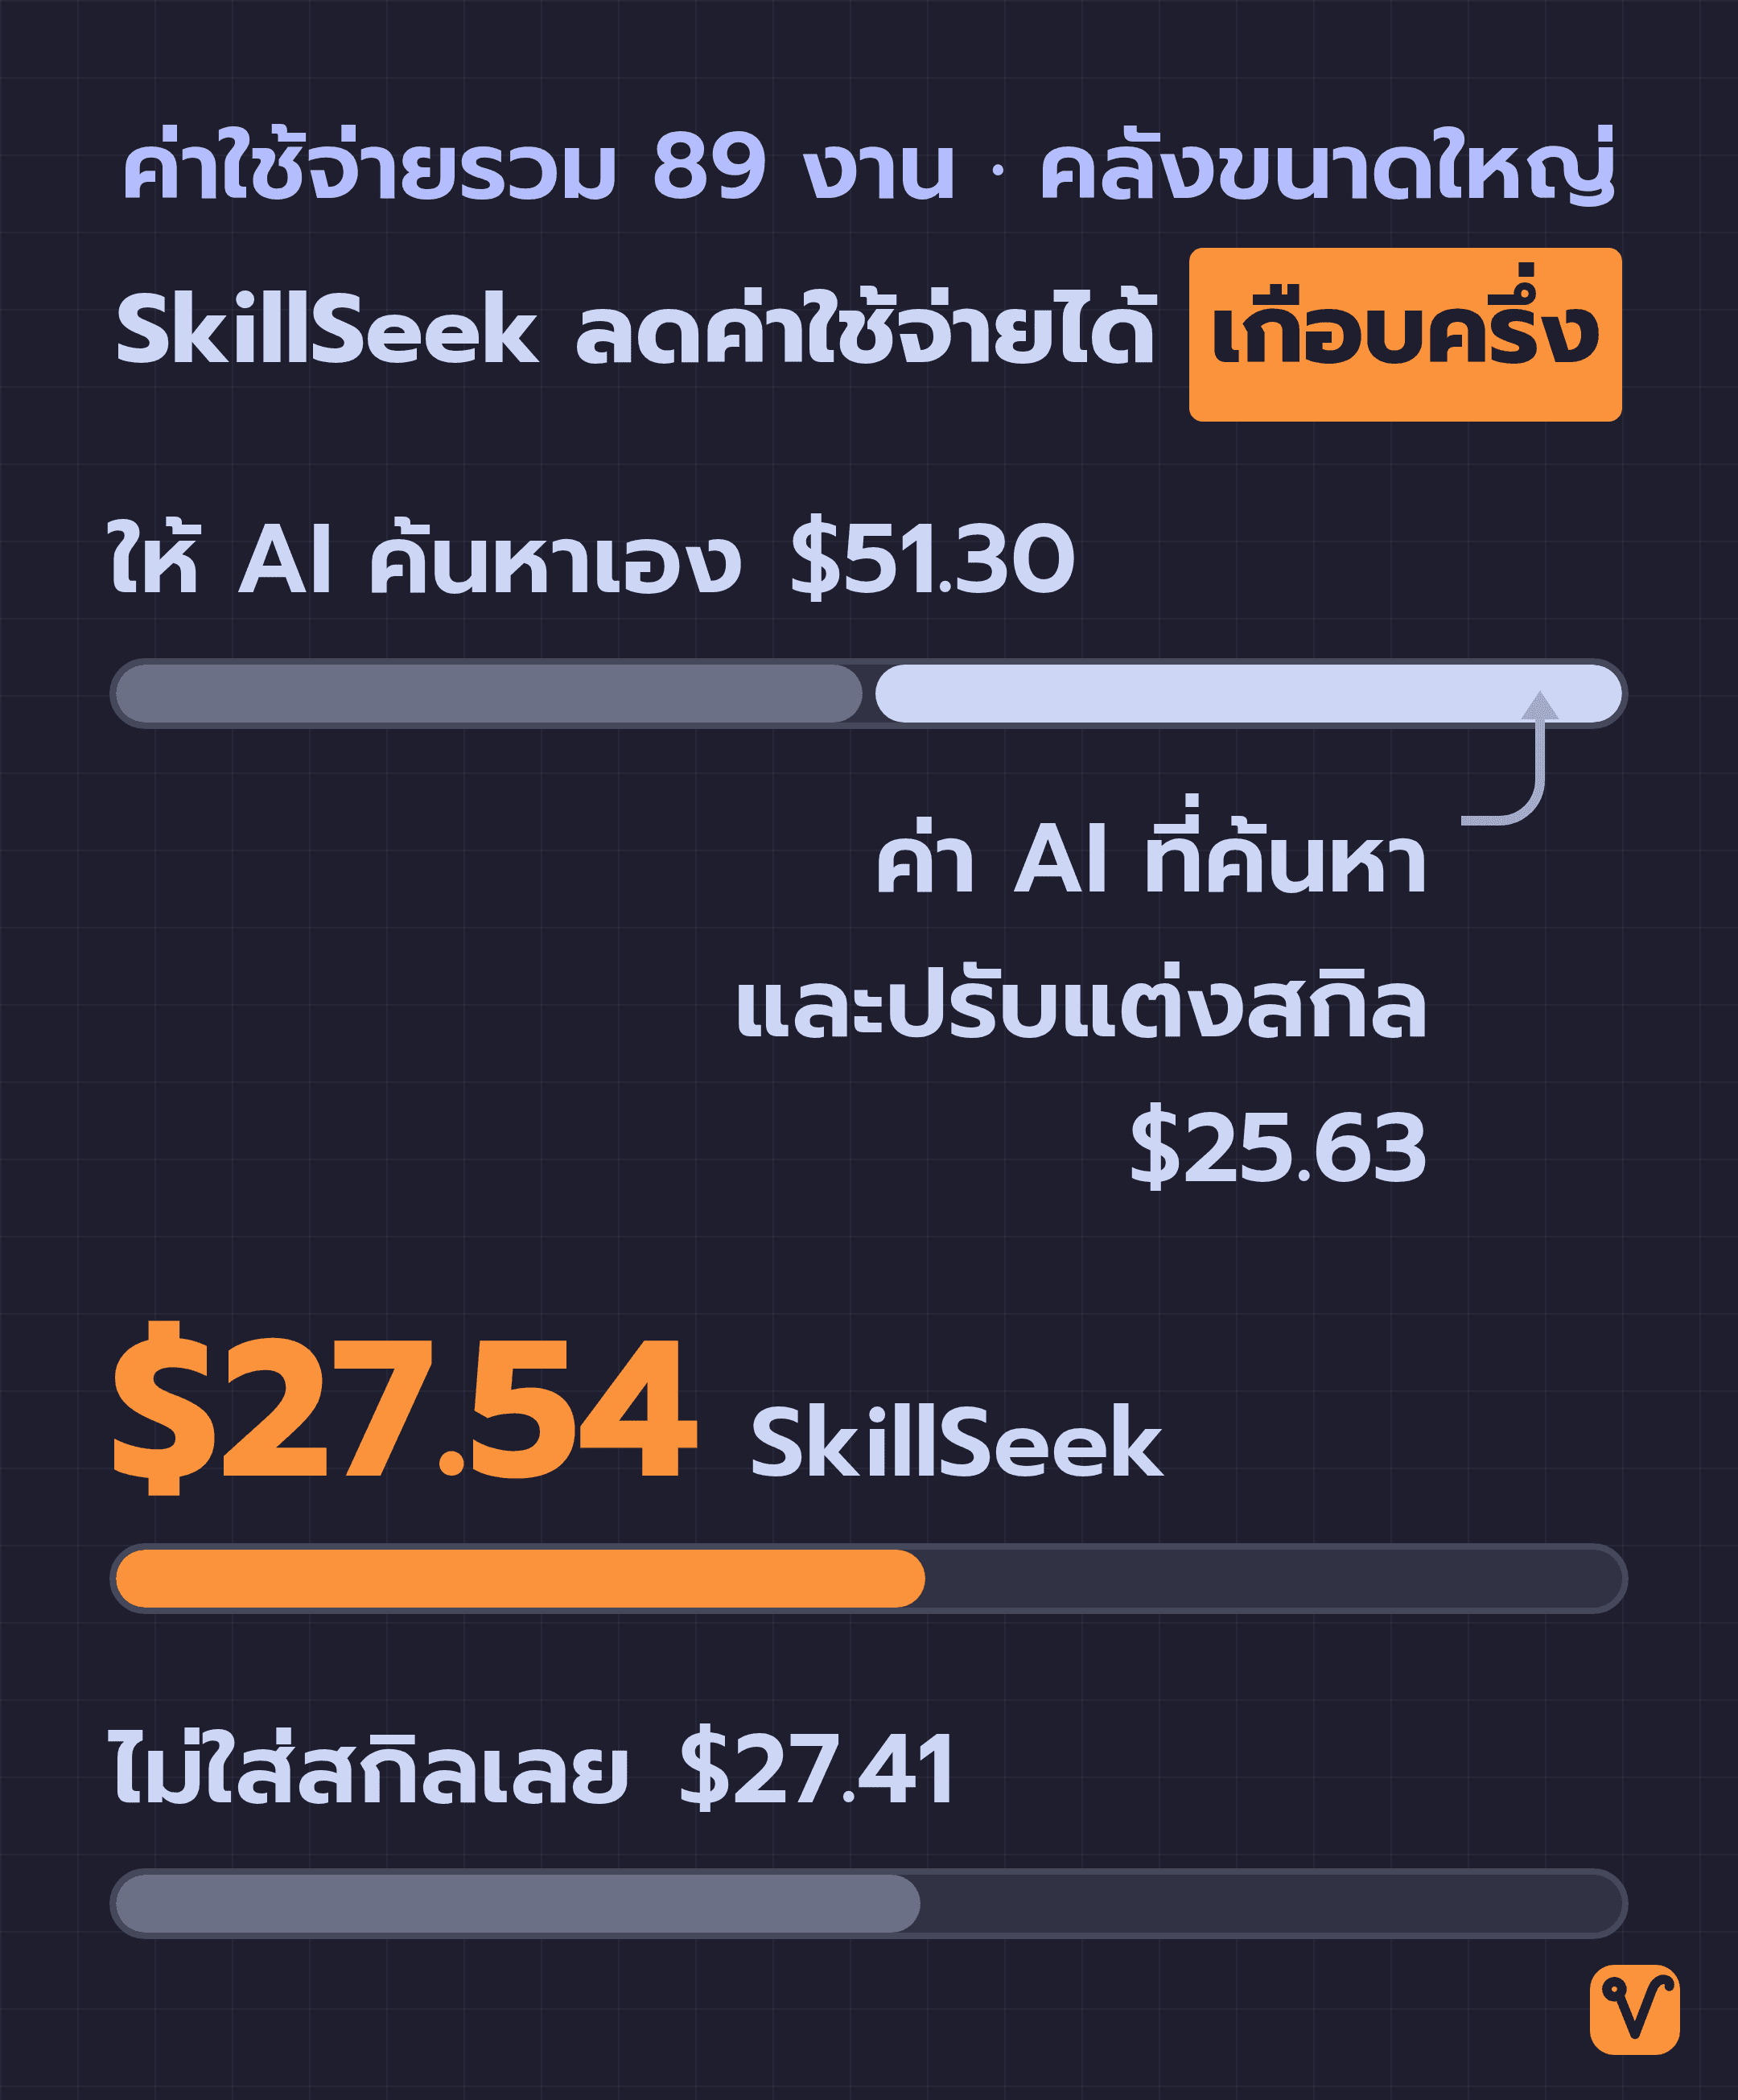
ที่ต่างกันชัดกว่าคือค่าใช้จ่าย ถ้ารันการทดลองครบทั้ง 89 งานบนคลังขนาดใหญ่ การปล่อยให้ AI ค้นหาเองมีค่าใช้จ่ายรวม 51.30 ดอลลาร์ ขณะที่ใช้ SkillSeek จ่ายเพียง 27.54 ดอลลาร์ ใกล้เคียงกับตอนไม่ใส่สกิลอะไรเลย ซึ่งจ่ายไป 27.41 ดอลลาร์
ค่าใช้จ่าย 51.30 ดอลลาร์นั้นแบ่งออกเป็นสองก้อนเกือบเท่าๆ กัน โดยก้อนแรก 25.67 ดอลลาร์เป็นค่า Agent ที่ลงมือทำงานจริง และอีก 25.63 ดอลลาร์เป็นค่า AI ที่ทำหน้าที่ค้นหาและปรับแต่งสกิล
ข้อควรระวังคือ ตัวเลขค่าใช้จ่ายทั้งหมดนี้เป็นยอดรวมของการทดลองทั้ง 89 งานตามเงื่อนไขของงานวิจัย ไม่ใช่ราคาที่ผู้ใช้ต้องจ่ายต่องาน
แม้ตัวเลขประสิทธิภาพจะออกมาดูดี แต่ทีมวิจัยก็ระบุว่านี่เป็นเพียงผลลัพธ์ที่อยู่ในระดับใกล้เคียงกันเท่านั้น และไม่ได้ยืนยันว่าฝั่งไหนเหนือกว่า เนื่องจากแต่ละเงื่อนไขรันการทดสอบเพียงรอบเดียว และหากคะแนนต่างกันน้อยกว่า 2% ผู้วิจัยจะถือว่าอยู่ในกรอบความคลาดเคลื่อนทางสถิติ
คลังเล็กใช้ตัวค้นหาเบาๆ คลังใหญ่ค่อยจ่ายเพิ่ม
ผลการทดลองไม่ได้ออกมาเหมือนกันในทุกขนาดคลัง สำหรับคลังขนาดเล็ก 192 ตัวที่คัดสรรมาอย่างดี วิธีที่เรียบง่ายกลับเป็นฝ่ายนำ โดย BM25 ทำคะแนนได้ดีที่สุดเมื่อใช้ร่วมกับ MiniMax และระบบค้นหา 2 ชั้นของ SkillSeek ได้คะแนนสูงสุดเมื่อใช้ร่วมกับ Qwen3.5 แต่เมื่อเป็นคลังขนาดใหญ่ระดับ 34,000 ตัว วิธีที่หนักกว่าอย่างการให้ AI ค้นหาเองจึงเริ่มไล่ตามทัน
ทีมวิจัยอธิบายว่า คอขวดสำคัญอยู่ที่ขั้นตอนการค้นหาชั้นแรก หากเป็นคลังขนาดใหญ่แล้ว สกิล 20 ตัวที่คัดเลือกมาในรอบแรกไม่มีสกิลที่ตรงกับงานติดมาด้วยเลย ชั้นที่สองจะจัดอันดับเก่งแค่ไหนก็เลือกสกิลที่ถูกต้องไม่ได้ นี่จึงเป็นจุดที่การปล่อยให้ AI ค้นหาเองเริ่มคุ้มเงินที่จ่าย เพราะ AI คิดและเขียนคำค้นหาใหม่ได้
หลายคนอาจคิดว่างั้นก็แก้ปัญหาง่ายๆ ด้วยการให้ชั้นแรกคัดเลือกสกิลออกมาให้มากขึ้น แต่ผลการทดลองออกมาตรงกันข้าม เมื่อเพิ่มจำนวนสกิลที่คัดเลือกเป็น 2 เท่าหรือ 5 เท่า คะแนนกลับลดลง 3.5% ถึง 4.5% เพราะตัวเลือกที่ไม่เกี่ยวข้องจำนวนมากจะเข้าไปรบกวนการเลือกอันดับหนึ่งของชั้นที่สอง
ข้อแนะนำจากทีมวิจัยจึงชัดเจน คือควรเริ่มจากวิธีค้นหามาตรฐานที่ประหยัดและรวดเร็วก่อน แล้วเก็บการให้ AI ค้นหาเองไว้เป็นทางเลือกสำรองสำหรับงานที่ระบบทั่วไปหาไม่เจอ หากคุณดูแลคลังสกิลส่วนตัวที่มีเพียงไม่กี่ร้อยตัว การใช้ระบบค้นหาแบบเบาๆ ก็เพียงพอแล้ว แต่ถ้าต้องเลือกจากคลังในตลาดที่มีเป็นหมื่นตัว การยอมจ่ายเพิ่มเพื่อให้ AI ช่วยค้นหาก็อาจคุ้มค่ากว่า
คำอธิบายสกิลสำคัญกว่าเนื้อหาข้างใน
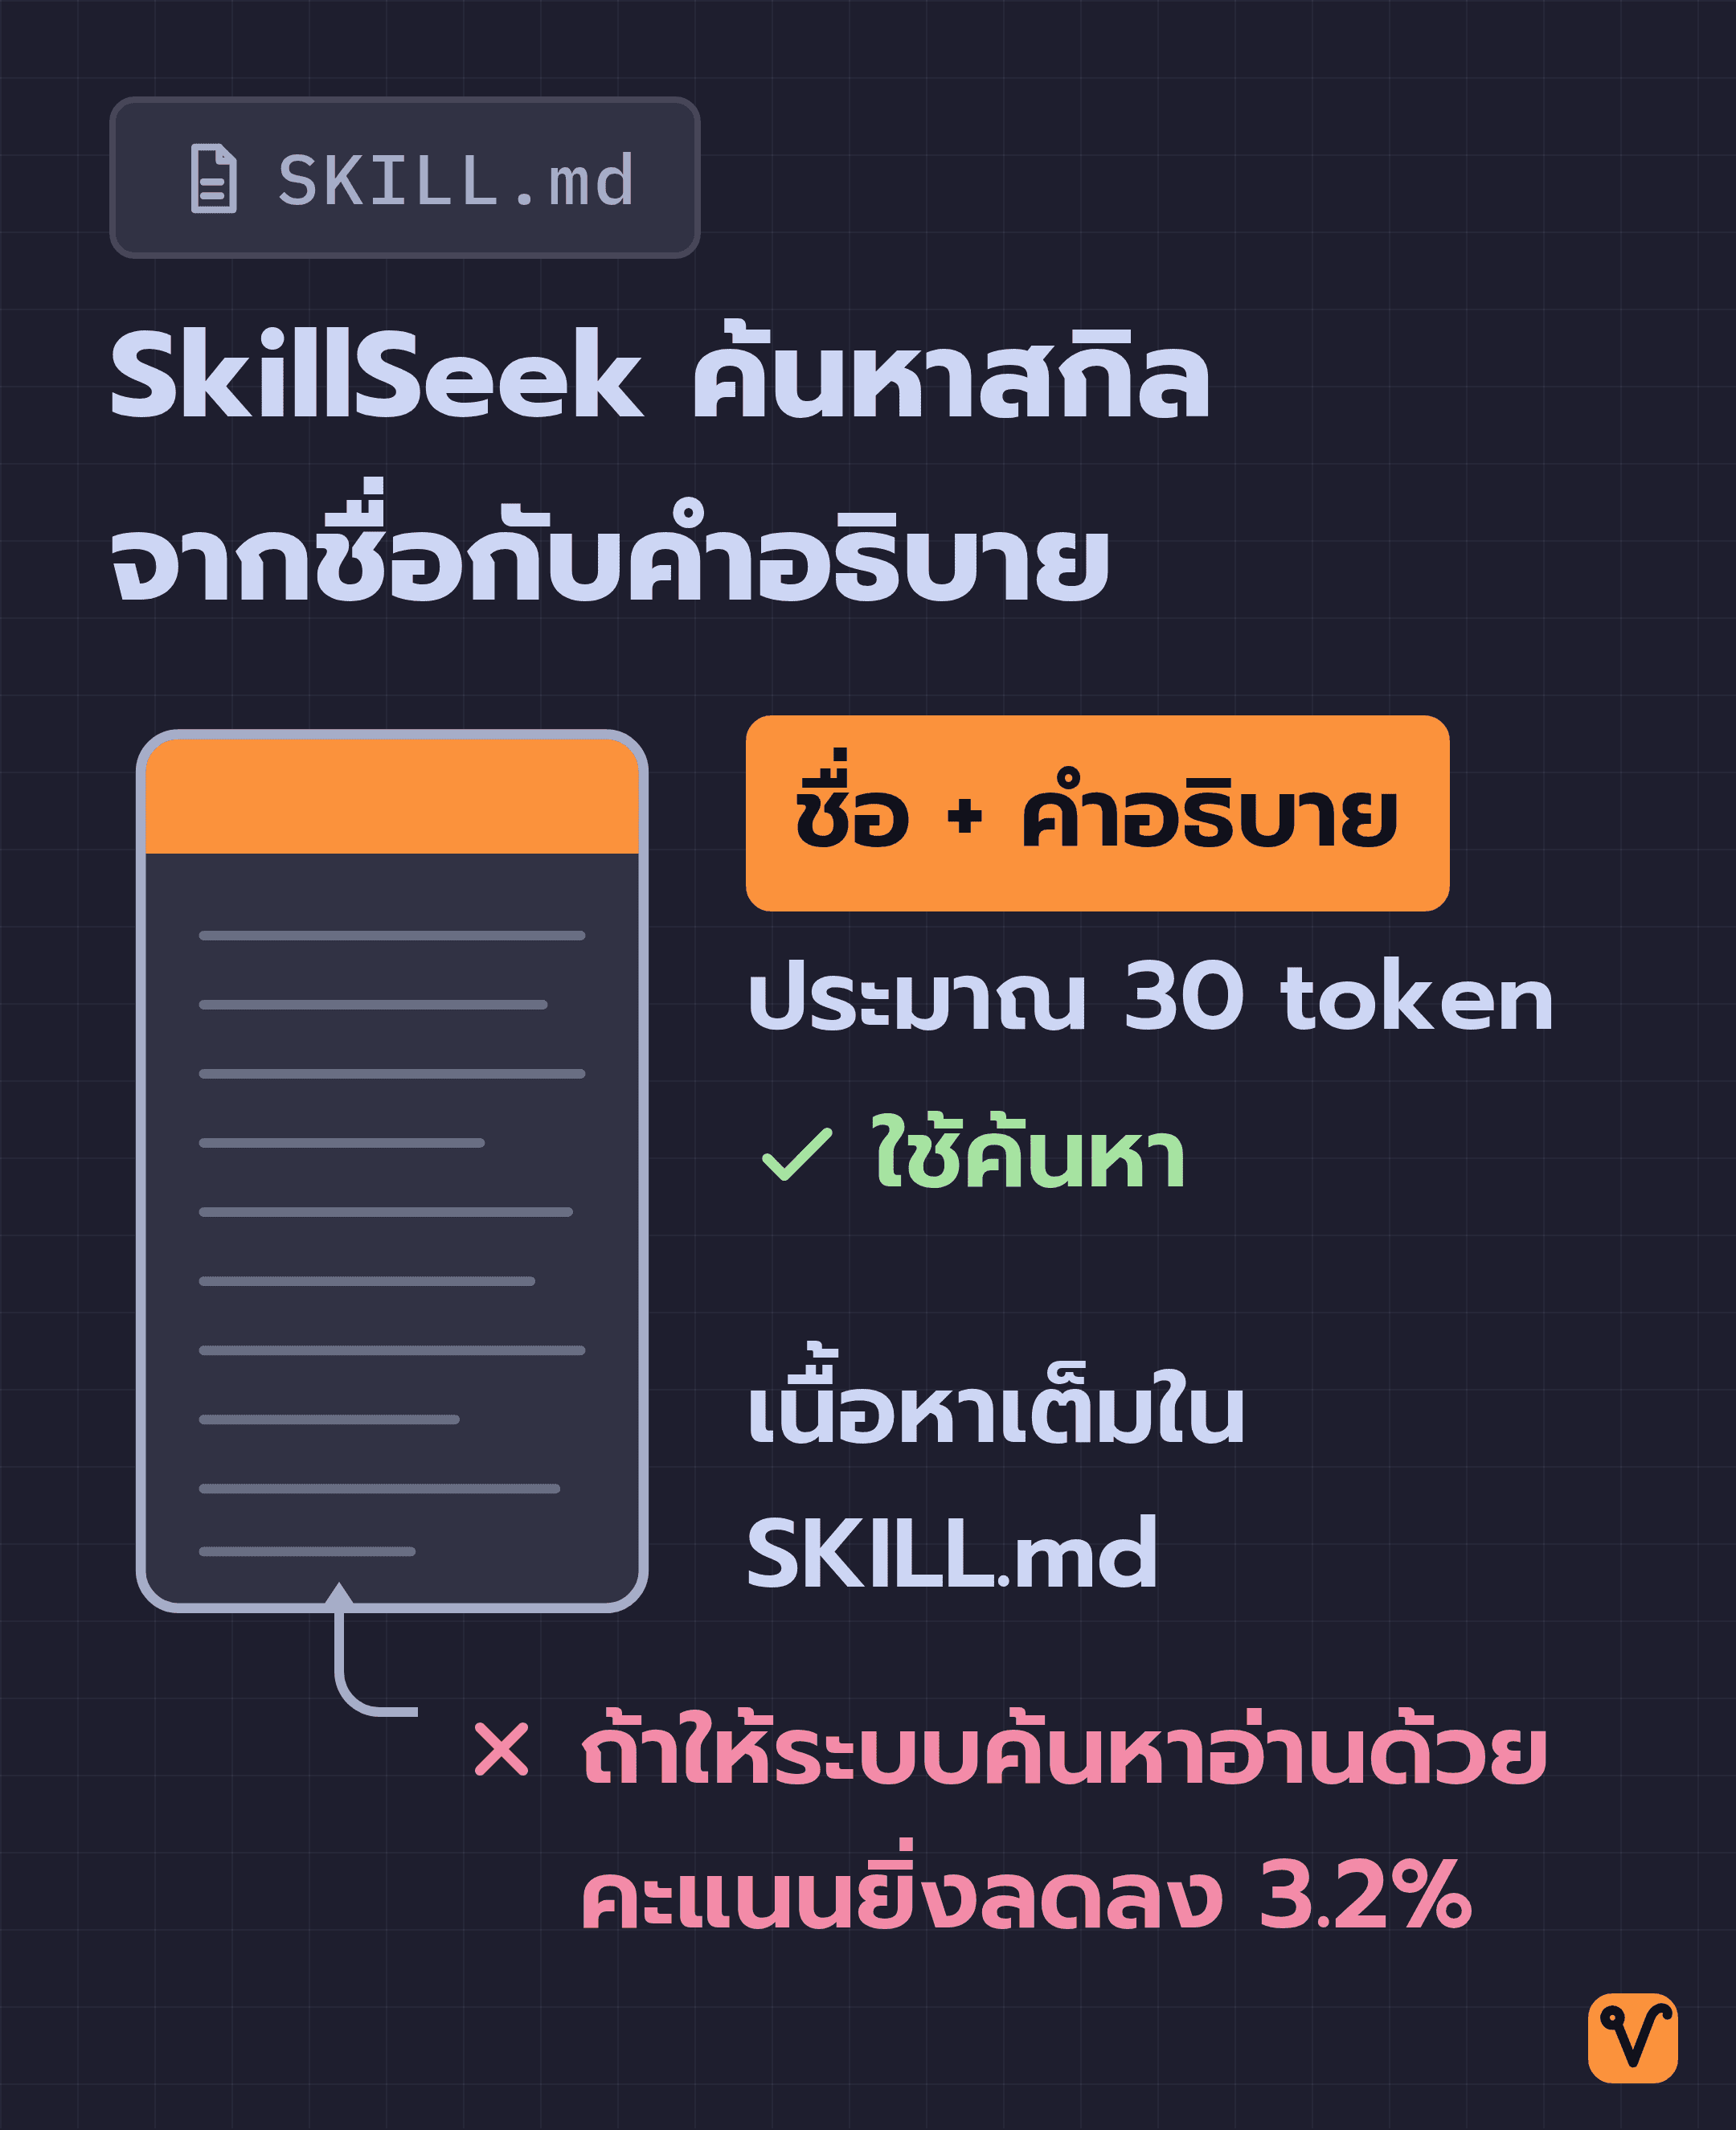
ข้อมูลที่ SkillSeek นำมาใช้ค้นหามีเพียง 3 ส่วน ได้แก่ ชื่อสกิล คำอธิบาย และโปรไฟล์สรุปสั้นๆ เท่านั้น โดยไม่ได้นำเนื้อหาทั้งหมดในไฟล์ SKILL.md มาค้นหาด้วย ส่วนเนื้อหาฉบับเต็มจะเปิดอ่านก็ต่อเมื่อ Agent ร้องขอเท่านั้น
โปรไฟล์สรุปนี้ประกอบด้วยประโยคสั้นๆ เพียงประโยคเดียวที่ระบุว่าสกิลนี้ทำอะไรได้ พร้อมแท็กกำกับอีก 4 ตัว โดยตัวแรกระบุประเภทไฟล์ ตัวที่สองระบุหน้าที่หลัก และอีกสองตัวเป็นแท็กเสริม โดยโปรไฟล์เหล่านี้สร้างขึ้นด้วย LLM เพียงครั้งเดียวตอนเตรียมคลังสกิล ทำให้ในขั้นตอนการค้นหาจริงไม่ต้องเรียกใช้ LLM อีกเลย
ตัวอย่างเช่น สกิล pdf-excel-diff ที่ใช้เปรียบเทียบข้อมูลระหว่างไฟล์ PDF กับ Excel จะมีแท็กกำกับว่า pdf, compare, excel และ xlsx ซึ่งแท็กเหล่านี้คือคีย์เวิร์ดตรงตัวที่โมเดลจัดอันดับในชั้นที่สองใช้จับคู่กับงาน
ในการทดลองเวอร์ชันก่อนหน้านี้ ทีมวิจัยเคยปล่อยให้ AI ตั้งแท็กเองอย่างอิสระ ผลที่ได้กลับเป็นคำกว้างๆ เช่น file comparison หรือ tabular data โดยไม่มีคำเฉพาะเจาะจงอย่าง excel หรือ xlsx เลย ส่งผลให้สกิลที่ตรงกับงานจริงตกจากอันดับหนึ่งลงไปอยู่อันดับสองหรือสาม แค่ตกไปขั้นเดียวก็ส่งผลมากแล้ว เพราะในการทดลอง Agent หยิบสกิลอันดับหนึ่งไปใช้ทันทีถึงราว 65% ของงานทั้งหมด
เรื่องที่น่าแปลกใจและอาจสวนทางกับที่หลายคนคิด คือการนำเนื้อหาข้างในมาช่วยค้นหา ถ้าค้นหาด้วยชื่อและคำอธิบายเปล่าๆ โดยไม่มีโปรไฟล์ช่วย คะแนนจะต่ำกว่าแบบมีโปรไฟล์อยู่ 2.2% แต่เมื่อทีมวิจัยลองใส่เนื้อหาทั้งหมดของไฟล์ SKILL.md เพิ่มเข้าไปให้ระบบค้นหาอ่าน คะแนนกลับยิ่งลดลงไปอีก 3.2% ทีมวิจัยอธิบายว่า รายละเอียดและขั้นตอนการทำงานในเนื้อหาจะเข้าไปบดบังชื่อและคำอธิบาย ซึ่งเป็นส่วนสำคัญที่บอกว่าสกิลนี้แตกต่างจากตัวอื่นอย่างไร
เรื่องนี้สอดคล้องกับรูปแบบการทำงานของ Agent Skills อยู่แล้ว เพราะทั้งระบบค้นหาของ SkillSeek และตัว Agent ตอนเริ่มงาน ต่างเริ่มต้นทำความรู้จักสกิลผ่านชื่อและคำอธิบายสั้นๆ ก่อนจะเปิดอ่านเนื้อหาเต็มเสมอ
สิ่งที่คนสร้างสกิลนำไปปรับใช้ได้ทันที คือการเขียนคำอธิบายในช่อง description ให้ระบุประเภทไฟล์และหน้าที่หลักด้วยคำที่เจาะจงและตรงไปตรงมา ลองดูตัวอย่างเปรียบเทียบนี้:
# ก่อน
description: Helps review documents and tabular data

# หลัง
description: Compare a PDF against an Excel (.xlsx) sheet and list the values that do not matchคำอธิบายแบบแรกไม่มีชื่อประเภทไฟล์เลยแม้แต่คำเดียว ขณะที่แบบหลังระบุทั้ง PDF, Excel และ .xlsx ไว้อย่างชัดเจน พร้อมบอกหน้าที่หลักว่า compare ถ้าใครยังไม่เคยเขียนสกิลมาก่อน ก็เริ่มต้นเรียนรู้ได้จากคู่มือสร้างสกิลให้ Claude ตั้งแต่ศูนย์
เชื่อมต่อ SkillSeek เข้ากับ Claude Code ผ่าน MCP
สำหรับใครที่ดูแลคลังสกิลขนาดใหญ่ สามารถนำระบบค้นหานี้ไปใช้งานได้ทันที เพราะทีมวิจัยเปิดโค้ดไว้ใน repo SkillSeek บน GitHub โดยระบบทำงานผ่านโปรโตคอล MCP ซึ่งเป็นมาตรฐานกลางที่ช่วยให้ AI agent เรียกใช้เครื่องมือภายนอกได้ ทำให้ Agent ที่รองรับ MCP สามารถเชื่อมต่อและใช้งาน SkillSeek ได้โดยตรง ไม่ต้องแก้ไขโค้ดเดิม
เริ่มต้นติดตั้งบนเครื่องที่มี Python 3.12:
git clone https://github.com/guanqun-yang/SkillSeek && cd SkillSeek
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txtจากนั้นเพิ่ม SkillSeek เข้าไปใน Claude Code โดยเปลี่ยน /path/to/skills เป็นโฟลเดอร์ที่เก็บสกิลของคุณ และเปลี่ยน /path/to/SkillSeek เป็นโฟลเดอร์ที่โคลนโค้ดลงมาเมื่อสักครู่:
claude mcp add skillseek \
-e SKILLS_DIR=/path/to/skills -e MCP_TEXT_VARIANT=baseline \
-- /path/to/SkillSeek/.venv/bin/python /path/to/SkillSeek/mcp_server/skills_mcp.pyเมื่อตั้งค่าเสร็จแล้ว SkillSeek จะอ่านไฟล์ SKILL.md ของทุกสกิลในโฟลเดอร์นั้น แล้วนำชื่อและคำอธิบายมาใช้ค้นหา หลังจากเชื่อมต่อแล้ว Agent จะมองเห็นเครื่องมือเพิ่มขึ้นมา 3 ตัว ได้แก่:
skill_lookup(query, k)– ค้นหาสกิลที่ตรงกับงาน ถ้า Agent ไม่ได้ระบุจำนวน จะส่งผลลัพธ์กลับมา 3 ตัวskill_load(name)– เปิดอ่านเนื้อหาฉบับเต็มของไฟล์ SKILL.md ทีละสกิลskill_list()– แสดงรายชื่อและคำอธิบายของทุกสกิลที่มีในคลัง
เครื่องมือทั้งสามตัวนี้ทำงานเป็นลำดับขั้นเช่นเดียวกับ Agent Skills นั่นคือ ค้นหาจากชื่อและคำอธิบายก่อน แล้วค่อยเปิดเนื้อหาเต็มของสกิลที่เลือกใช้งาน
สำหรับคลังสกิลขนาดใหญ่ เอกสารในคลังโค้ดแนะนำว่าการสร้างโปรไฟล์กำกับสกิลมักช่วยให้ค้นหาได้แม่นยำยิ่งขึ้น โดยมีสคริปต์ให้ LLM สร้างโปรไฟล์ให้คลังของคุณโดยอัตโนมัติ แต่ต้องใช้รหัสเชื่อมต่ออย่าง API key ของผู้ให้บริการ LLM
อย่างไรก็ตาม จุดที่ควรรู้ก่อนนำไปใช้งานจริง คือโค้ดชุดนี้พัฒนาขึ้นเพื่องานวิจัย ตอนนี้คลังโค้ดเพิ่งอัปโหลดขึ้นมาครั้งเดียว และยังไม่มีเวอร์ชันที่ปล่อยออกมาอย่างเป็นทางการ
เริ่มต้นปรับใช้จากสกิลที่มีอยู่แล้ว
แม้จะยังไม่ได้ติดตั้งเครื่องมือค้นหาอะไรเพิ่ม คุณก็นำข้อค้นพบจากงานวิจัยนี้ไปปรับใช้กับคลังสกิลของตัวเองได้ทันที:
- เปิดดูรายชื่อสกิลที่ติดตั้งไว้ทั้งหมดในปัจจุบัน
- นึกถึงงานที่คุณทำบ่อยที่สุด แล้วสำรวจว่ามีสกิลไหนที่ Agent เรียกใช้งานจริงๆ บ้าง ถ้าต้องการตรวจสอบอย่างชัดเจนว่า Agent เรียกใช้ตัวไหนบ้าง เราเคยเขียนวิธีเช็กสกิลที่ลงไว้เฉยๆไว้แล้ว
- เก็บไว้เฉพาะสกิลที่ตรงกับลักษณะงานเหล่านั้น และนำตัวที่ไม่จำเป็นออก
- เขียนคำอธิบายใหม่ให้สกิลที่สร้างเอง โดยระบุประเภทไฟล์และหน้าที่หลักด้วยคำที่เจาะจง ตรงไปตรงมา
สุดท้ายแล้ว คำถามสำคัญที่สุดสำหรับคลังสกิลของคุณจึงเหลือเพียงข้อเดียว นั่นคือ เมื่อมีงานเข้ามา Agent หยิบสกิลที่ถูกต้องมาใช้ได้ตั้งแต่ครั้งแรกหรือไม่
ที่มา:
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
NotebookLM ฉบับเข้าใจง่าย โยนเอกสารให้ AI อ่าน แล้วได้สรุป พอดแคสต์ และคลังความรู้ส่วนตัว
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
สร้าง AI Automation Pipeline ทุกแบบ ด้วย Agents และ Skills
ปูจากพื้นฐาน prompt, context และ cost ไปจนปั้น Skill สั่ง Agent กับ Sub-agent แล้วต่อทุกอย่างเป็น pipeline อัตโนมัติที่ออกแบบเองได้ ดูฟรี 7 บทก่อนตัดสินใจ