Claude Haiku 5.5 ราคาเริ่มต้นลดลงมาเท่า GPT-6 Luna แต่คะแนนด้านการควบคุมคอมพิวเตอร์พุ่งจาก 15.7% เป็น 72.4% ตามตารางของ Anthropic และสมาชิก Max กับ Team ได้เครดิต API ทุกเดือน
Claude Haiku 5.5 คิดค่า API เริ่มต้นเท่า GPT-6 Luna แต่คะแนนทิ้งห่าง Haiku 4.5 งานสรุป คัดแยก และตอบแชตที่เรียก AI ซ้ำทั้งวัน จึงถูกลงโดยไม่ต้องลดสเปกโมเดล
บริษัทพัฒนา AI อย่าง Anthropic เปิดตัว Claude Haiku 5.5 เมื่อวันที่ 7 ตุลาคม 2026 โดยเป็นโมเดลน้องเล็กสุดในตระกูล Claude 5.5 ต่อจากรุ่นพี่อย่าง Claude Opus 5.5 และ Claude Sonnet 5.5 ที่ปล่อยออกมาก่อนหน้านี้
จุดเด่นของ Haiku 5.5 คือออกแบบมาเพื่องานที่ต้องเรียกใช้ AI ซ้ำๆ วันละเป็นพันครั้งโดยเฉพาะ ทั้งแชตบอตตอบลูกค้าตลอดทั้งวัน ระบบสรุปเอกสารทุกฉบับที่ส่งเข้ามา และระบบ Agent ที่ทำงานหลายขั้นตอนต่อเนื่องกันได้เองเพื่อคอยคัดแยกอีเมลทีละฉบับ
งานเหล่านี้ในแต่ละรอบไม่ได้ซับซ้อนมาก แต่ทุกครั้งที่เรียกใช้งาน ระบบจะคิดค่าบริการตาม Token ซึ่งเป็นหน่วยย่อยของข้อความที่โมเดลใช้อ่านและเขียนตอบกลับ เมื่อนำมาคูณกับจำนวนครั้งที่เรียกใช้วันละหลายพันรอบ ต้นทุนต่อ Token จึงกลายเป็นตัวตัดสินว่า งานไหนคุ้มค่าที่จะนำ AI มาช่วยทำ
ก่อนหน้านี้ Haiku 4.5 คิดค่าบริการข้อความขาเข้า 1 ดอลลาร์ และขาออก 5 ดอลลาร์ต่อ 1 ล้าน Token ซึ่งแพงกว่า GPT-6 Luna ของ OpenAI ที่เพิ่งเปิดตัวเมื่อเดือนก่อนถึง 10 เท่า ด้าน Simon Willison นักพัฒนาที่เขียนบล็อกทดสอบ Haiku 5.5 ตั้งแต่วันเปิดตัว ก็ชี้ประเด็นนี้เช่นกันว่า Haiku 4.5 ที่เปิดตัวมาเกือบปีก่อนเริ่มล้าสมัยและแพงเกินไปแล้วเมื่อเทียบกับคู่แข่ง
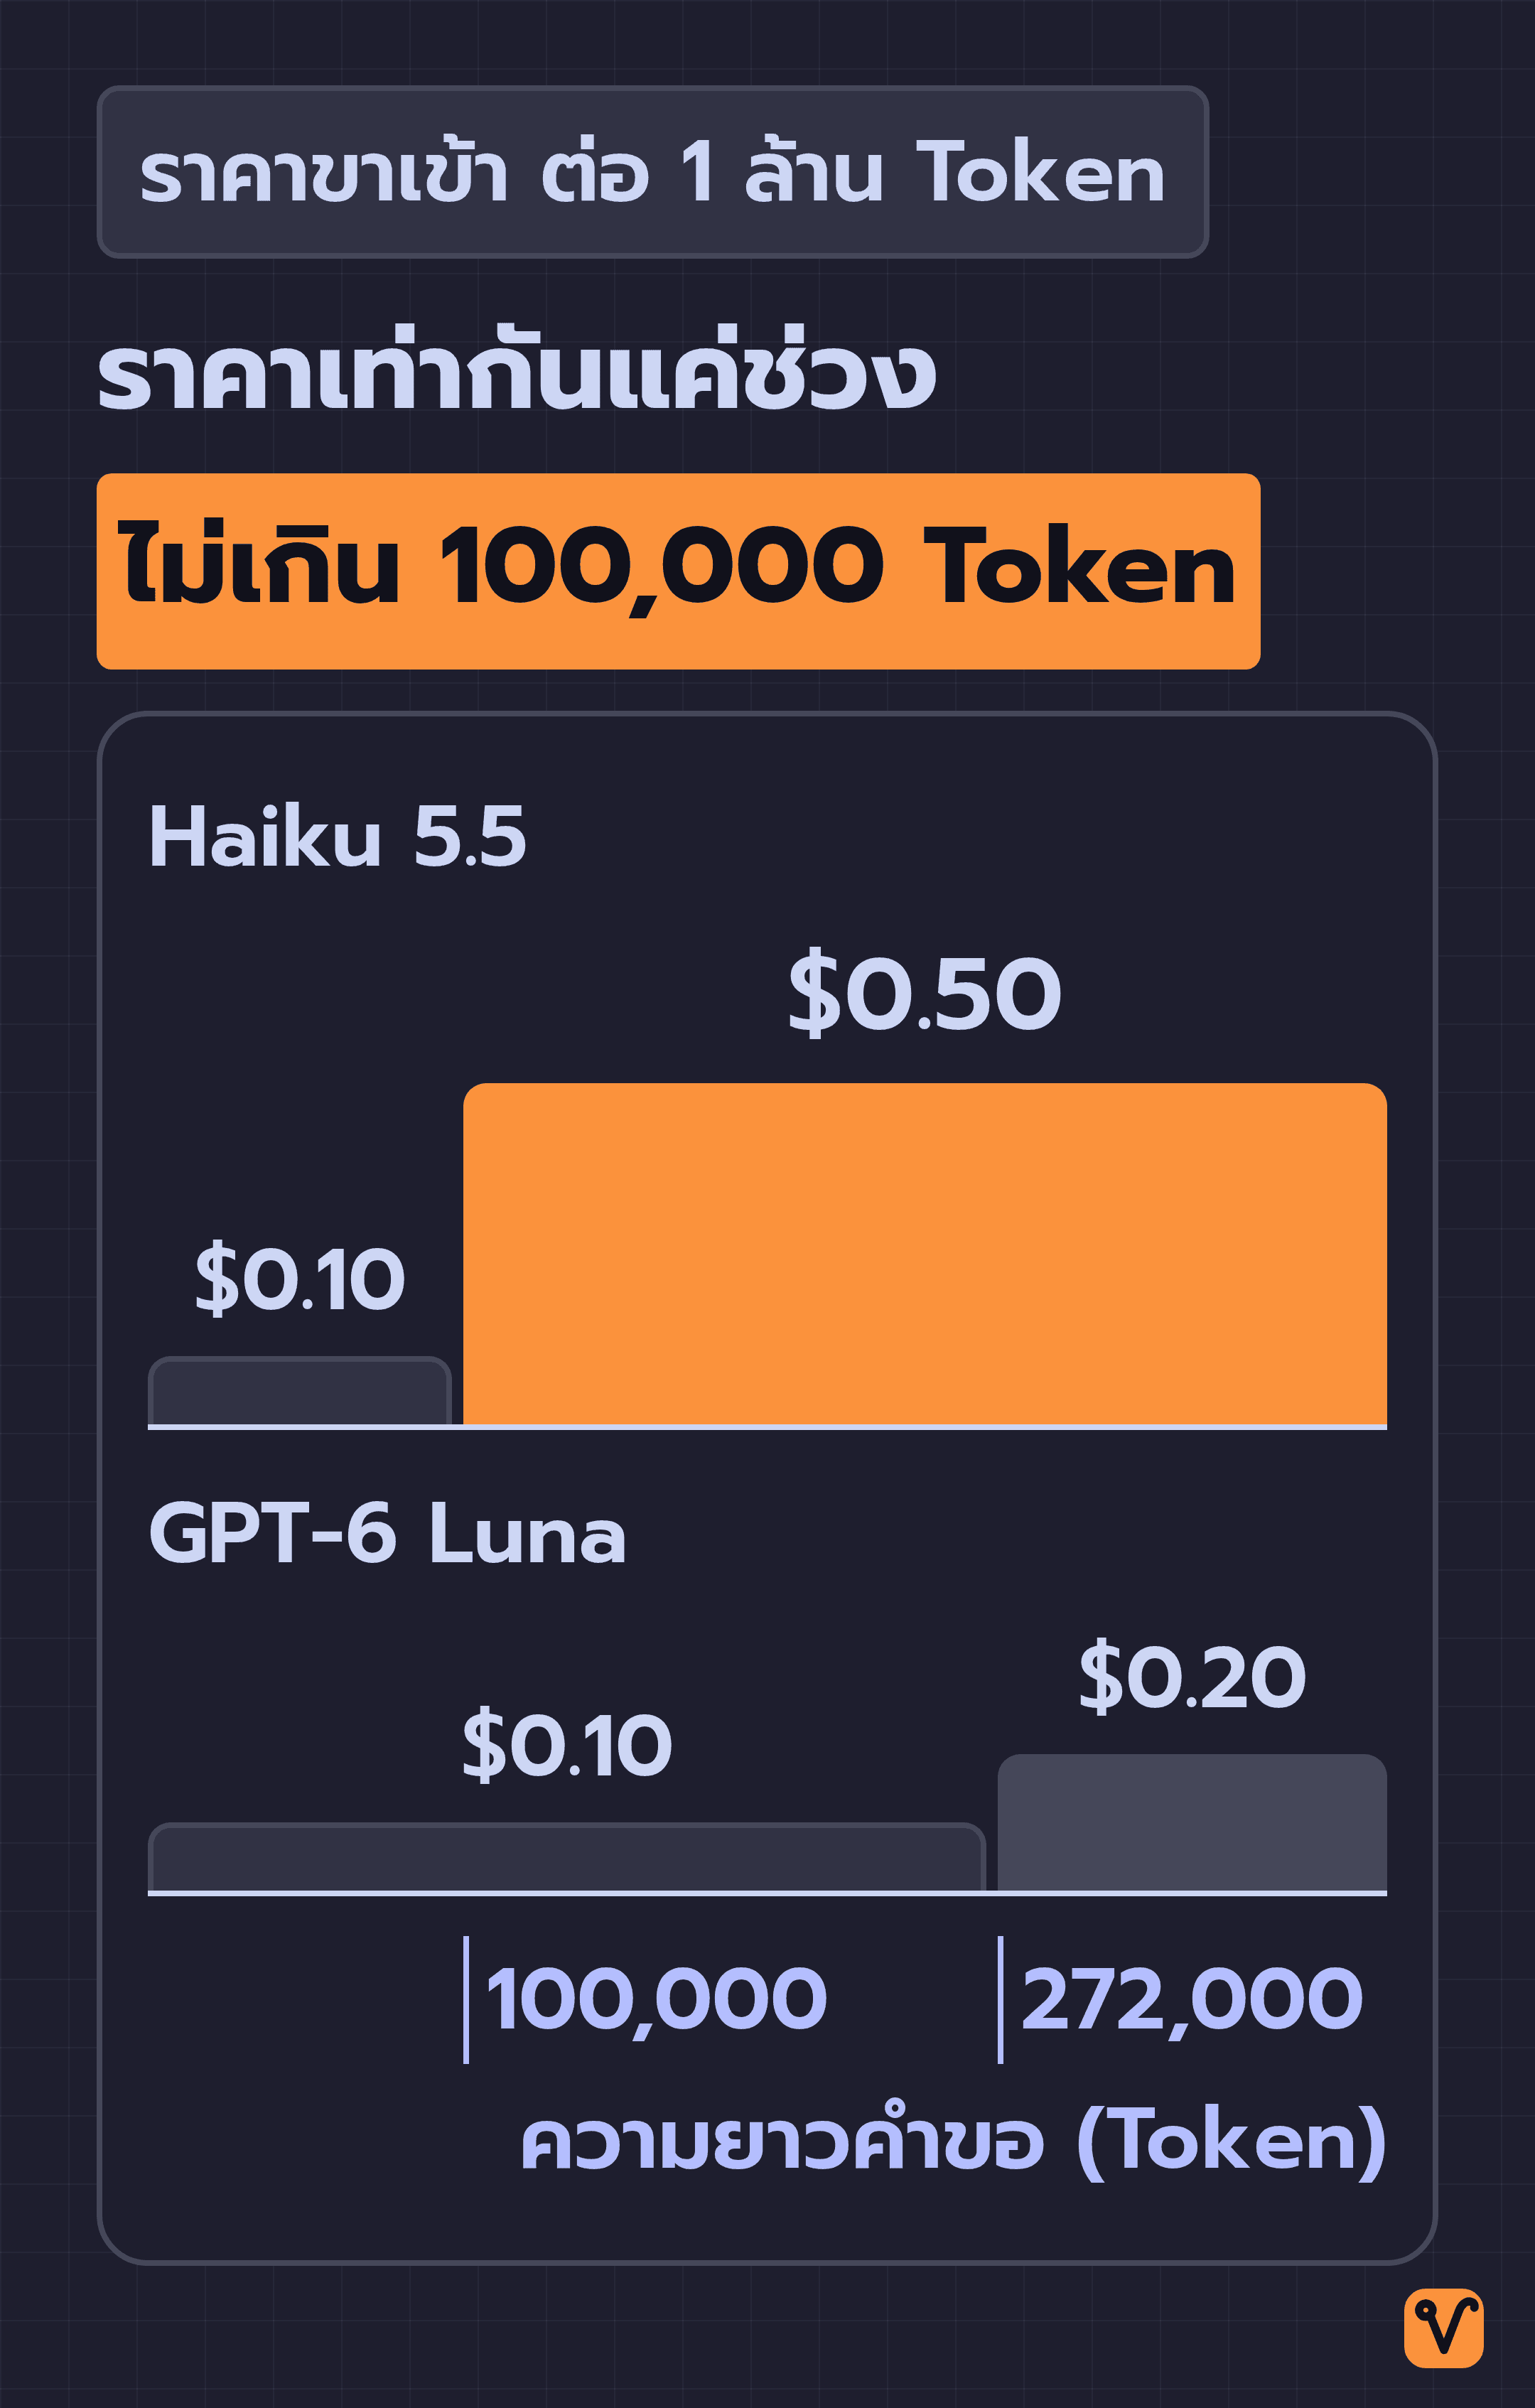
Haiku 5.5 จึงเข้ามาปิดช่องว่างนี้ด้วยการปรับราคาลงมาชนกับ GPT-6 Luna พอดี โดยคิดค่าบริการขาเข้าเพียง 0.10 ดอลลาร์ และขาออก 0.50 ดอลลาร์ต่อ 1 ล้าน Token สำหรับข้อความคำสั่งอย่าง Prompt ที่ยาวไม่เกิน 100,000 Token
แต่เมื่อราคาถูกลงขนาดนี้ คำถามสำคัญที่หลายคนสงสัยก็คือ ความสามารถของมันจะลดลงตามราคาไปด้วยหรือไม่
Haiku 5.5 ราคาถูกลง แต่ไม่ได้เก่งน้อยลง
Anthropic นิยาม Haiku 5.5 ว่าเป็นโมเดลขนาดเล็กที่ถูกที่สุด เร็วที่สุด และเก่งที่สุดเท่าที่บริษัทเคยทำมา แต่สำหรับเรื่องความเร็ว Anthropic ระบุเงื่อนไขไว้เองว่า เป็นการเทียบความเร็วปกติของแต่ละรุ่นเท่านั้น เพราะถ้าเทียบกับ Opus ในโหมดเร่งความเร็ว Opus ก็ยังทำงานได้เร็วกว่า
ส่วนเรื่องความสามารถ Anthropic เปิดเผยตารางผลการทดสอบมาตรฐานอย่างเบนช์มาร์กออกมาให้เห็นชัดเจน โดยตัวเลขทั้งหมดในตารางนี้ Anthropic วัดผลและรายงานเอง:
| ชุดทดสอบ (วัดอะไร) | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (งานความรู้แบบมืออาชีพ) | 1620 | 735 | 1437 | 1840 |
| OSWorld 2.1 (ใช้คอมพิวเตอร์ทำงานหลายขั้น) | 72.4% | 15.7% | 48.9% | 83.9% |
| Terminal-Bench 4.0 (เขียนโค้ดแบบ agent) | 39.2% | 0.0% | 16.4% | 70.6% |
| Chartography (อ่านกราฟ) | 46.4% | 6.4% | 29.1% | 61.6% |
เมื่อเทียบกับ Haiku 4.5 จะเห็นว่าตัวเลขขยับสูงขึ้นอย่างชัดเจนในทุกการทดสอบ โดยเฉพาะคะแนนการสั่งงานคอมพิวเตอร์หลายขั้นตอนบนชุดทดสอบ OSWorld 2.1 ที่พุ่งขึ้นจาก 15.7% เป็น 72.4% ส่วนงานเขียนโค้ดแบบ Agent บนชุดทดสอบ Terminal-Bench 4.0 รุ่นเก่าทำคะแนนได้ 0.0% แต่ตอนนี้ Haiku 5.5 ทำได้ถึง 39.2%
ถ้าเทียบกับ GPT-6 Luna ที่ราคาเริ่มต้นเท่ากัน Haiku 5.5 ก็ทำคะแนนนำได้ทั้ง 4 การทดสอบ แต่เมื่อนำไปเทียบกับรุ่นพี่อย่าง Sonnet 5.5 Haiku 5.5 ยังคงตามหลังอยู่ทุกด้าน โดยเฉพาะงานเขียนโค้ด Terminal-Bench ที่ยังห่างกันชัดเจนระหว่าง 39.2% กับ 70.6%
อีกหนึ่งฟีเจอร์ใหม่คือ Haiku 5.5 เป็นโมเดลรุ่นแรกในตระกูล Haiku ที่เปิดให้ปรับระดับการคิดหรือ effort ได้ ทำให้เรากำหนดได้ว่าจะให้โมเดลใช้เวลาคิดไตร่ตรองก่อนตอบมากน้อยแค่ไหน ถ้าต้องการประหยัดต้นทุนก็ตั้งไว้ที่ระดับต่ำ แต่ถ้าต้องการคำตอบที่ละเอียดและฉลาดขึ้นก็ปรับระดับให้สูงขึ้นได้
ราคา Haiku 5.5 ถูกลง 90% หรือ 75% กันแน่
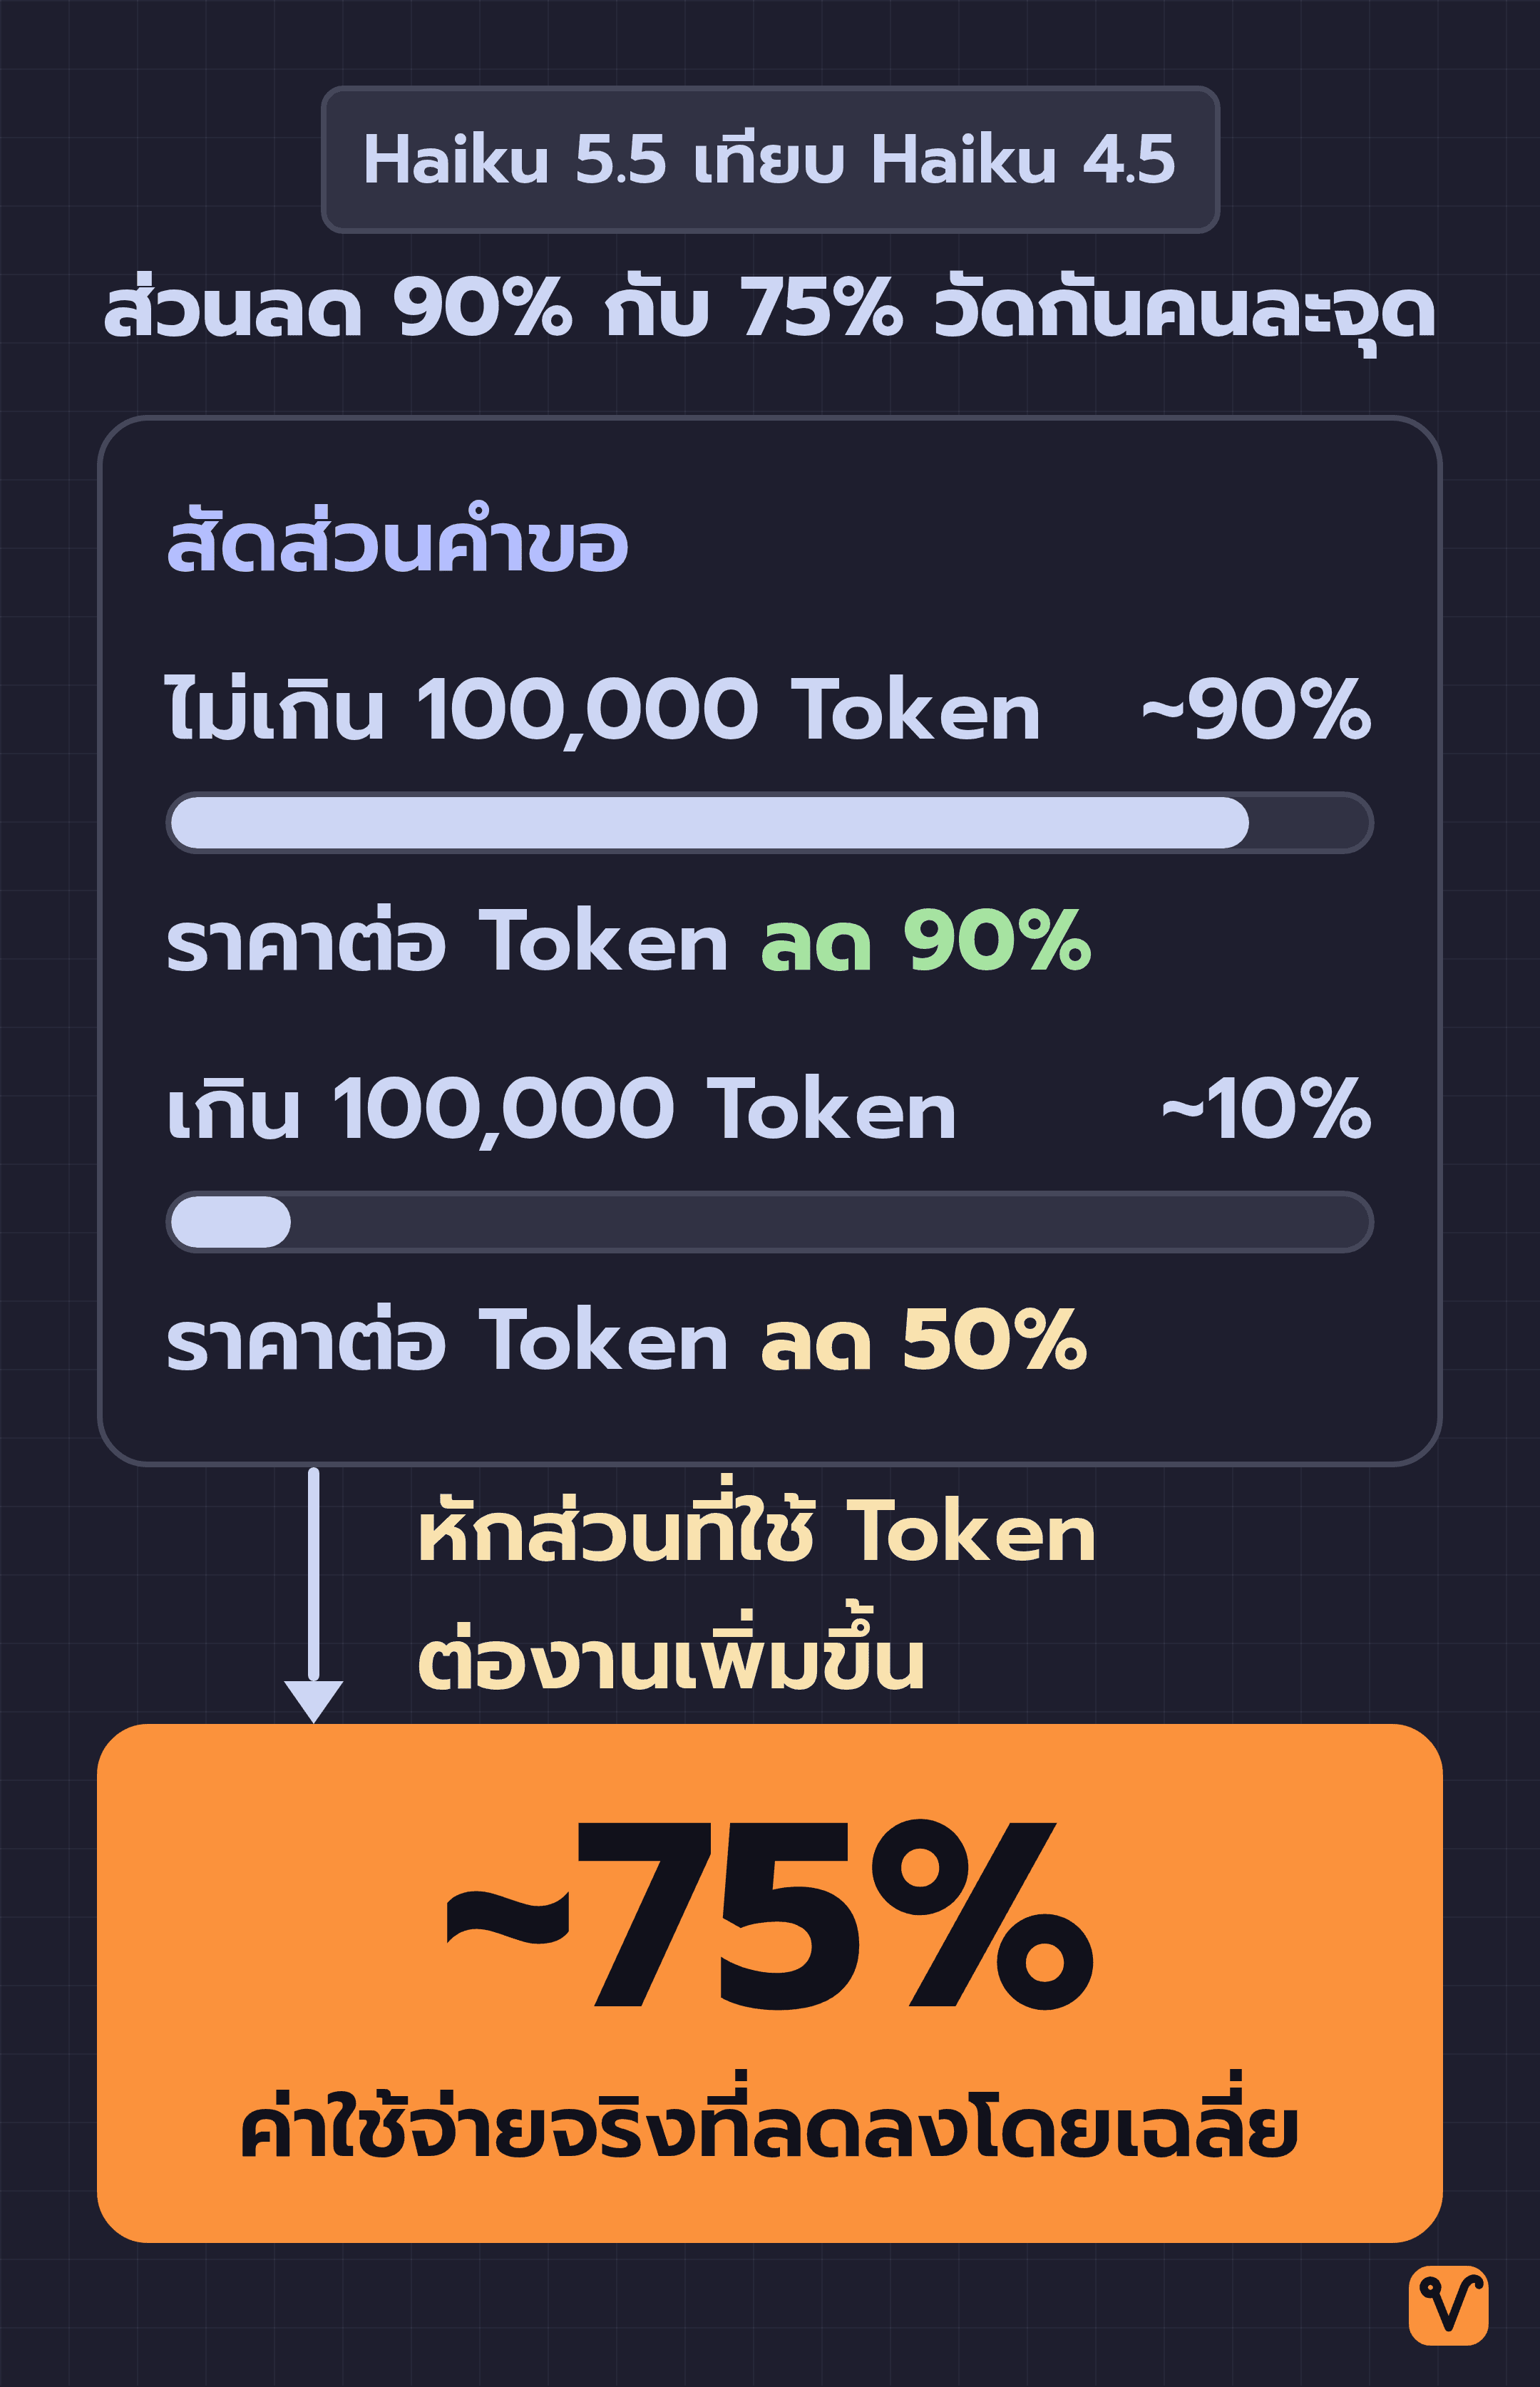
ทั้งสองตัวเลขนี้มาจาก Anthropic และถูกต้องทั้งคู่ เพียงแต่วัดกันคนละจุด
ก่อนอื่นต้องแยกให้ชัดเจนว่า ราคาที่พูดถึงทั้งหมดนี้เป็นค่าบริการเชื่อมต่อระบบอย่าง API สำหรับให้นักพัฒนาเรียกใช้งาน ซึ่งคิดตามจำนวน Token ที่ใช้จริง ไม่ใช่ค่าสมาชิกรายเดือนของแพ็กเกจแชตอย่าง Pro หรือ Max
| ราคาต่อล้าน token | Haiku 5.5 (ไม่เกิน / เกิน 100,000 token) | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|
| ขาเข้า | $0.10 / $0.50 | $1.00 | $2.00 |
| ขาออก | $0.50 / $2.50 | $5.00 | $10.00 |
| cache read | $0.01 / $0.05 | $0.10 | $0.10 |
| cache write | $0.125 / $0.625 | $1.25 | $2.50 |
Cache Read และ Cache Write คือค่าบริการอ่านและบันทึกส่วนของ Prompt ที่ระบบจำไว้ในแคชเพื่อนำมาใช้ซ้ำ เช่น คำสั่งตั้งต้นของบอตอย่าง System Prompt ที่ต้องส่งไปเหมือนเดิมทุกครั้ง
ตัวเลข 90% คือส่วนลดราคาต่อ Token สำหรับคำขอที่ยาวไม่เกิน 100,000 Token เห็นได้ชัดจากราคาขาเข้าที่ลดลงจาก 1.00 ดอลลาร์ เหลือเพียง 0.10 ดอลลาร์ แต่ถ้าคำขอนั้นยาวเกิน 100,000 Token ส่วนลดจะลดลงเหลือ 50%
ส่วนตัวเลข 75% คือค่าเฉลี่ยที่ผู้ใช้งานจะประหยัดได้จริง ซึ่ง Anthropic คำนวณจากสถิติการใช้งานจริงบน Haiku 4.5 โดยพบว่าคำขอประมาณ 90% เป็นงานที่ยาวไม่เกิน 100,000 Token ตรงนี้ต้องระวังอย่าสับสนระหว่างสัดส่วนคำขอ 90% กับตัวเลขส่วนลด 90% เมื่อนำอัตราส่วนลดของทั้งสองช่วงความยาวมาเฉลี่ยตามสัดส่วนนี้ และหักลบกับการที่ Haiku 5.5 ใช้จำนวน Token ต่องานเพิ่มขึ้นเล็กน้อย ค่าใช้จ่ายจริงโดยเฉลี่ยจึงลดลงอยู่ที่ประมาณ 75%
ดังนั้น ส่วนลดที่คุณจะได้รับจริงจึงขึ้นอยู่กับความยาวคำขอในระบบของคุณ ถ้าเป็นงานสั้นอย่างการตอบแชตหรือคัดแยกข้อความ ค่าใช้จ่ายก็จะลดลงอย่างเต็มที่ แต่ถ้าเป็นงานที่ต้องแนบเอกสารขนาดยาวทั้งฉบับ ก็มีโอกาสที่คำขอจะยาวเกิน 100,000 Token และขยับไปคิดในเรตราคาที่สูงขึ้น
ราคาเริ่มต้นเท่า Luna แต่บิลจริงขึ้นอยู่กับอีก 3 เรื่อง
ตัวเลขบนตารางราคายังไม่ใช่ยอดบิลจริงที่คุณต้องจ่าย นอกจากประเด็นที่ Haiku 4.5 เริ่มล้าสมัยแล้ว บล็อกทดสอบในวันเปิดตัวยังเตือนถึงต้นทุนแฝงและเงื่อนไขที่ต้องรู้อีก 3 เรื่อง
Tokenizer ตัวใหม่นับข้อความเดิมได้ Token มากขึ้น
Haiku 5.5 เปลี่ยนมาใช้ Tokenizer ตัวใหม่ ซึ่งเป็นระบบตัดข้อความเป็น Token ก่อนส่งให้โมเดล เจ้าของบล็อกนำ Prompt ขนาดยาวชุดเดียวกันมาทดลองนับ แล้วพบว่า Haiku 5.5 นับ Token ออกมาได้มากกว่า Haiku 4.5 ถึงประมาณ 1.25 เท่า เขาจึงมองว่าส่วนนี้เป็นต้นทุนแฝงที่เพิ่มขึ้นมา
เรื่องนี้ทาง Anthropic เองก็ระบุไว้ในเชิงอรรถเช่นกันว่า Haiku 5.5 จะใช้ Token ต่องานมากขึ้นเล็กน้อย
ถ้าคุณประเมินงบประมาณโดยอ้างอิงจากจำนวน Token เดิมที่เคยใช้บน Haiku 4.5 ยอดประเมินที่ได้จะต่ำกว่าบิลที่ต้องจ่ายจริง โดยคุณสามารถนำ Prompt ของตัวเองไปทดลองนับจำนวน Token ได้ที่ Claude Token Counter ตัวเดียวกับที่เขาใช้นับ
เกิน 100,000 Token เมื่อไร Luna จะคุ้มกว่าทันที
เมื่อคำขอยาวเกิน 100,000 Token ราคาของ Haiku 5.5 จะเพิ่มขึ้นเป็น 5 เท่าทันที โดยขาเข้าจะปรับเป็น 0.50 ดอลลาร์ และขาออกปรับเป็น 2.50 ดอลลาร์ต่อ 1 ล้าน Token ขณะที่ GPT-6 Luna ปรับราคาขึ้นช้ากว่าและน้อยกว่ามาก โดยเริ่มปรับราคาเมื่อคำขอยาวเกิน 272,000 Token และปรับขึ้นเป็นเพียง 0.20 ดอลลาร์สำหรับขาเข้า และ 0.75 ดอลลาร์สำหรับขาออก
ข้อสรุปในบล็อกนี้จึงตรงไปตรงมา ถ้าเป็นงานสั้นที่ไม่เกิน 100,000 Token การเลือก Haiku 5.5 จะคุ้มค่ากว่า เพราะจ่ายในราคาเริ่มต้นเท่ากันแต่ได้คะแนนทดสอบสูงกว่า แต่ถ้าเป็นงานที่ยาวกว่านั้น Luna จะประหยัดกว่ามาก ใครที่ต้องส่งเอกสารขนาดยาวแนบไปเป็นประจำ จึงควรเช็กก่อนว่ามีคำขอที่เกิน 100,000 Token บ่อยแค่ไหน แล้วค่อยตัดสินใจเลือกระหว่างสองตัวนี้
ปิดการคิดไม่ได้ แต่เลือกปรับระดับได้
Haiku 5.5 ปิดระบบคิดไตร่ตรองก่อนตอบอย่าง Reasoning ไม่ได้ โดยระบบจะตั้งค่าเริ่มต้นมาให้ที่ระดับ medium แต่ผู้ใช้สามารถเลือกปรับระดับได้ตั้งแต่ low, medium, high, xhigh ไปจนถึง max
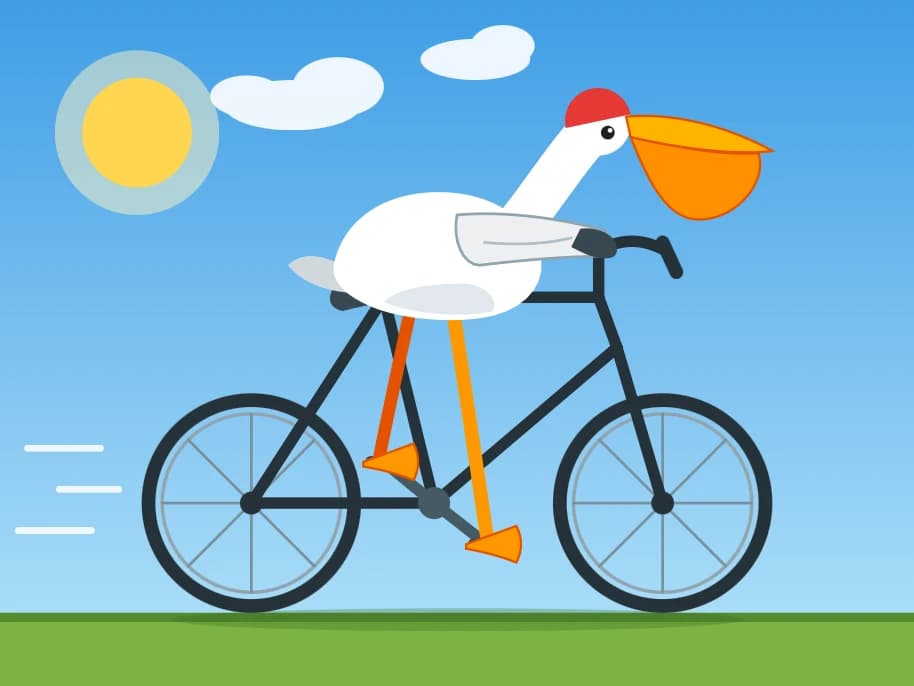
การทดสอบที่เห็นภาพชัดเจนที่สุดในบล็อกนี้คือ การสั่งให้โมเดลเขียนโค้ดภาพเวกเตอร์ SVG เป็นรูป "นกกระทุงขี่จักรยาน" ผลปรากฏว่า ที่ระดับ low โมเดลใช้เวลาเพียง 7 วินาทีและเสียค่าใช้จ่าย 0.0936 เซนต์ ส่วนที่ระดับ max โมเดลใช้เวลาคิดนานถึง 5 นาที 9 วินาที และมีค่าใช้จ่ายอยู่ที่ 3.3826 เซนต์
ในแง่คุณภาพ ภาพวาดตั้งแต่ระดับที่สูงกว่า low ขึ้นไปเก็บรายละเอียดโครงสร้างจักรยานได้ดี ต่างจาก Haiku 4.5 รุ่นก่อนที่ยังปรับระดับการคิดไม่ได้ ซึ่งเคยทำโจทย์เดียวกันนี้ด้วยค่าใช้จ่าย 0.7583 เซนต์ แต่วาดรูปนกกระทุงออกมาได้แย่
แม้ค่าใช้จ่ายที่ระดับ max จะไม่ถึง 4 เซนต์ต่อครั้ง แต่เวลาที่ต้องรอคำตอบกลับยืดจาก 7 วินาทีเป็นกว่า 5 นาที เมื่อต้องเรียกใช้งานวันละหลายพันครั้ง ส่วนต่างของค่าใช้จ่ายจึงไม่ใช่เรื่องเล็กอีกต่อไป ดังนั้นงานประเภทที่ลูกค้ารอคำตอบทันที เช่น แชตบอต จึงควรเริ่มตั้งค่าไว้ที่ระดับต่ำก่อน แล้วค่อยขยับระดับขึ้นเมื่อพบว่าคำตอบยังไม่ดีพอ
ให้ Opus คิด แล้วให้ Haiku 5.5 ลงมือ
Anthropic วางตำแหน่ง Haiku 5.5 ไว้สำหรับงานที่มีขอบเขตชัดเจนและต้องทำซ้ำบ่อยๆ โดยยกตัวอย่างงานที่เหมาะสมไว้ ดังนี้:
- สรุปข้อความ และย่อบทสนทนายาวๆ ให้สั้นลงเพื่อนำไปคุยต่อ
- ค้นหาข้อมูลในฐานข้อมูล
- คัดแยกข้อความหรือจัดหมวดหมู่คำขอที่ส่งเข้ามา
- ตอบแชตลูกค้าแบบสดๆ และสั่งเบราว์เซอร์ทำงานแทนมนุษย์ ซึ่งเป็นงานที่ความเร็วสำคัญมาก
- ทำหน้าที่เป็นผู้ช่วยย่อยอย่าง Subagent ที่คอยรับงานจากโมเดลหลักอย่าง Opus 5.5 หรือ Sonnet 5.5 ในงานเขียนโค้ด
ฝั่งผู้ให้บริการคลาวด์อย่าง AWS ก็เปิดให้ใช้งาน Haiku 5.5 บนแพลตฟอร์ม Amazon Bedrock ตั้งแต่วันเดียวกัน และเผยแพร่บล็อกที่อธิบายภาพการทำงานร่วมกันระหว่างโมเดลไว้อย่างชัดเจน:
โมเดลพี่ใหญ่อย่าง Opus 5.5 จะรับหน้าที่วางแผนและตัดสินใจในเรื่องยากๆ เช่น การแตกโจทย์ปัญหาที่ซับซ้อน การไล่หาบั๊กก่อนปล่อยระบบจริง หรือการตรวจความปลอดภัยของโค้ดชุดใหญ่ ส่วน Haiku 5.5 จะทำหน้าที่เป็นทีม Subagent คอยรับงานย่อยที่มีโจทย์ชัดเจนไปจัดการให้เสร็จอย่างรวดเร็ว เช่น การส่งต่อคำขอ การคัดแยกข้อมูล การสรุปเนื้อหา หรือการตามแก้โค้ดจุดเล็กๆ ในหลายไฟล์พร้อมกัน
ด้วยความเร็วและต้นทุนที่ต่ำมาก นักพัฒนาจึงสามารถรัน Haiku ได้หลายตัวพร้อมกัน ส่วน Opus ก็เก็บไว้ใช้เฉพาะงานส่วนที่ยากที่สุดเท่านั้น ถ้าสนใจแนวทางการเชื่อมโมเดลราคาถูกเข้ากับโมเดลราคาแพง สามารถอ่านเพิ่มเติมได้ที่ การทำ Model Cascade เพื่อลดต้นทุน
อย่างไรก็ตาม สำหรับงานเขียนโค้ดสไตล์ Agent ที่ซับซ้อน Anthropic ยืนยันเองว่า Sonnet 5.5 และ Opus 5.5 ยังคงเป็นตัวเลือกที่ดีกว่า ซึ่งคะแนนเบนช์มาร์กข้างต้นก็ชี้ให้เห็นเช่นนั้น โดยคะแนน Terminal-Bench ของ Haiku 5.5 อยู่ที่ 39.2% ขณะที่ Sonnet 5.5 ทำได้ถึง 70.6%
แต่สำหรับใครที่ยังจำเป็นต้องใช้ Sonnet 5.5 ค่าบริการก็ถูกลงในวันเดียวกันด้วย เพราะ Anthropic ปรับลดค่า Cache Read ของ Sonnet 5.5 ลงครึ่งหนึ่ง จาก 0.20 เหลือ 0.10 ดอลลาร์ต่อ 1 ล้าน Token และเนื่องจาก Cache Read คิดเป็นสัดส่วนสูงของ Token ที่โมเดลเรียกใช้ Anthropic จึงระบุว่างานแบบ Agent ส่วนใหญ่บน Sonnet 5.5 จะมีค่าใช้จ่ายลดลงราว 20%
สมาชิก Max และ Team ได้เครดิต API ทุกเดือน
อีกหนึ่งเรื่องที่ Anthropic ประกาศพร้อมกันคือ การมอบเครดิต API รายเดือนให้สมาชิกแพ็กเกจ Max และ Team ไว้เรียกใช้โมเดลบน Claude Platform ที่เป็นบริการเชื่อมต่อระบบสำหรับนักพัฒนา Anthropic ระบุว่าเครดิตนี้มีไว้เปิดโอกาสให้ผู้ใช้ได้ทดลองสร้างเครื่องมือ แอปพลิเคชัน หรือ Agent ที่เรียกใช้งานผ่าน API และใช้ได้กับทุกโมเดล ไม่จำกัดเฉพาะ Haiku 5.5 เท่านั้น
- Max 5x: ได้รับเดือนละ 100 ดอลลาร์
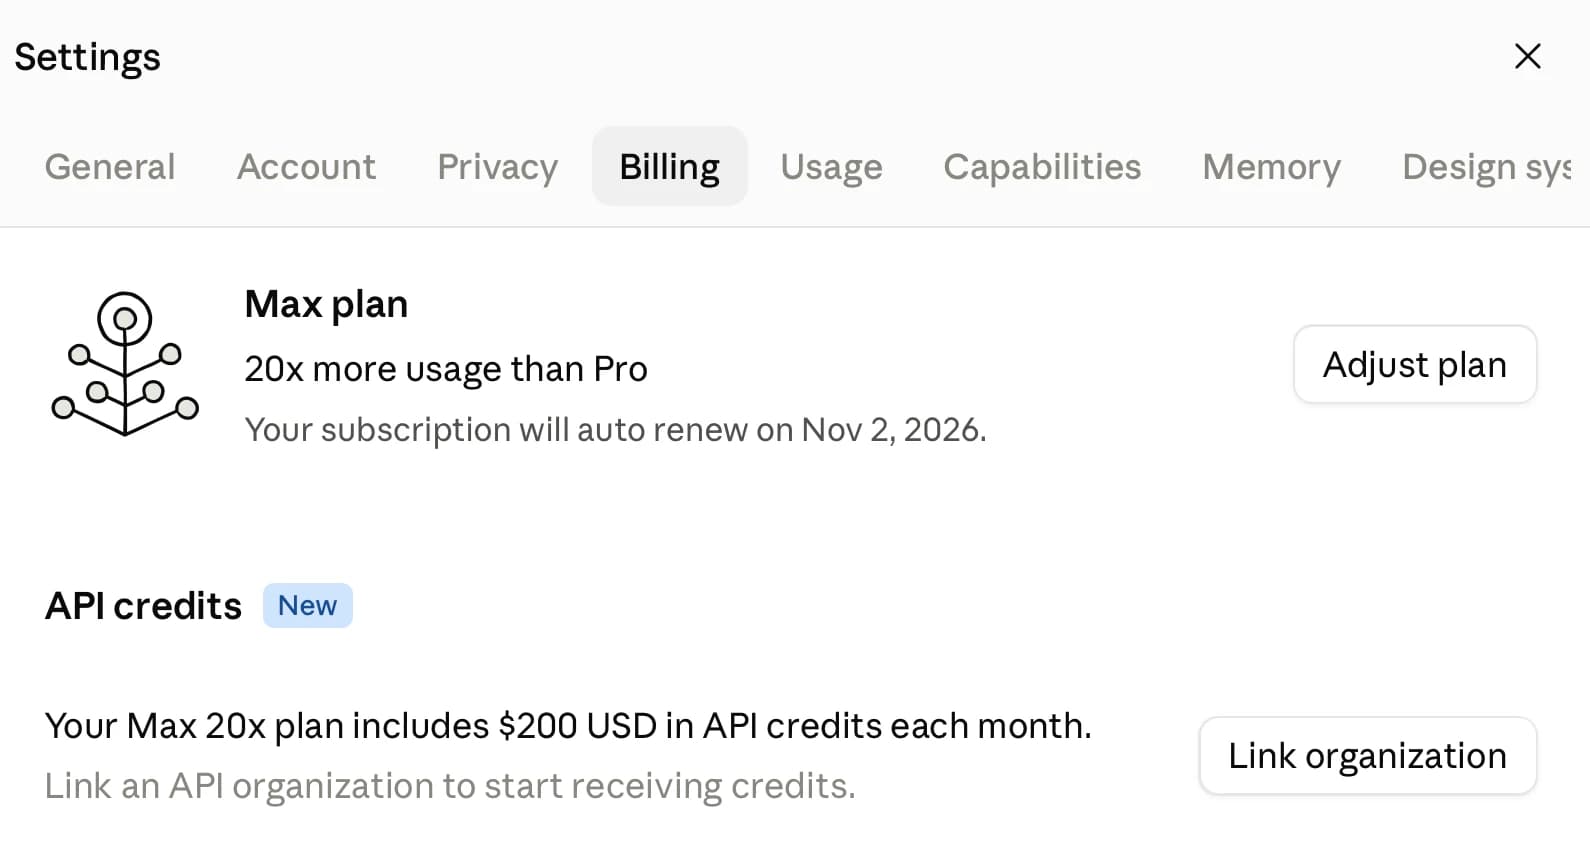
- Max 20x: ได้รับเดือนละ 200 ดอลลาร์
- Team: ได้รับ 20 ดอลลาร์ต่อที่นั่ง Standard และ 100 ดอลลาร์ต่อที่นั่ง Premium (รวมกันทั้งทีมไม่เกิน 500 ดอลลาร์ต่อเดือน)
สำหรับฝั่ง Max ยอดเครดิตนี้จะเท่ากับค่าสมาชิกรายเดือนที่จ่ายอยู่พอดี ส่วนฝั่ง Team ถ้าในทีมมีที่นั่ง Standard 3 ที่นั่ง และ Premium 2 ที่นั่ง ก็จะได้รับเครดิตรวม 260 ดอลลาร์ต่อเดือน
การกดรับสิทธิ์ตาม ศูนย์ช่วยเหลือของ Claude ทำได้ในไม่กี่ขั้นตอน:
- เปิดเว็บไซต์ claude.ai บนเว็บเบราว์เซอร์ (แม้จะสมัครแพ็กเกจผ่านแอปมือถือ ก็ต้องเข้ามากดรับผ่านเว็บบนเบราว์เซอร์เท่านั้น)
- ไปที่ Settings > Billing (ถ้าเป็นเจ้าของทีม ให้ไปที่ Organization settings > Billing)
- ในส่วน API credits ให้กดปุ่ม Link organization
- บนหน้าจัดการระบบอย่าง Claude Console ให้เลือกบัญชีองค์กรที่ต้องการรับเครดิต หรือสร้างองค์กรใหม่ จากนั้นอ่านเงื่อนไขแล้วกดปุ่ม Link organization อีกครั้ง
ทั้งในตอนกดรับและตอนใช้งานจริง คุณไม่จำเป็นต้องผูกบัตรเครดิตไว้กับ Claude Platform โดยเครดิตนี้ใช้ได้กับ Claude API, หน้าเว็บทดลองสั่งงานโมเดลอย่าง Playground ใน Claude Console, Claude Managed Agents และชุดเครื่องมือพัฒนาอย่าง Claude Agent SDK
เครดิตไม่ทบ และใช้กับ Claude Code แบบโต้ตอบไม่ได้
ก่อนกดรับสิทธิ์ มีเงื่อนไขและข้อจำกัดสำคัญที่ควรรู้ เพราะบางข้อถ้าตั้งค่าไปแล้วจะแก้ไขด้วยตัวเองไม่ได้:
- เครดิตไม่ทบไปเดือนหน้า: ถ้าใช้ไม่หมดในรอบบิลนั้น เครดิตที่เหลือจะถูกตัดทิ้งทันทีเมื่อหมดรอบบิล
- ไม่ครอบคลุมทุกแพ็กเกจ: สมาชิกแพ็กเกจ Free, Pro และ Enterprise จะไม่ได้รับเครดิตนี้
- ต้องใช้งานครบ 7 วัน: สมาชิกใหม่ต้องอยู่บนแพ็กเกจ Max หรือ Team ให้ครบ 7 วันก่อน จึงจะสามารถกดรับสิทธิ์ได้
- ผูกได้เพียงองค์กรเดียว: บัญชีสามารถผูกได้แค่บัญชีองค์กรเดียว และไม่สามารถกดยกเลิกหรือเปลี่ยนเองได้ ถ้าต้องการเปลี่ยนจะต้องติดต่อฝ่ายซัพพอร์ตเท่านั้น
- ใช้กับเครื่องมือช่วยเขียนโค้ดอย่าง Claude Code ในโหมดโต้ตอบไม่ได้: ไม่ว่าจะเปิดใช้งานผ่านหน้าต่างคำสั่งอย่าง Terminal, โปรแกรมเขียนโค้ดอย่าง IDE, แอปพลิเคชันบนเดสก์ท็อป หรือบนเว็บ
- ใช้จ่ายค่าบริการส่วนเกินไม่ได้: ไม่ว่าจะใน Claude, Claude Code หรือ Claude Cowork
- ใช้ได้เฉพาะแพลตฟอร์มของ Anthropic โดยตรง: ไม่สามารถนำเครดิตไปใช้กับ Claude บน Amazon Bedrock, Google Cloud Vertex AI หรือ Microsoft Foundry ได้
จุดที่อาจทำให้สับสนคือ การใช้งานผ่านคำสั่ง claude -p เพื่อรัน Claude Code ในโหมดไม่โต้ตอบ รวมถึงการใช้งานผ่าน Agent SDK: ถ้ารันโดยใช้รหัสเชื่อมต่ออย่าง API key จากบัญชีองค์กรที่ผูกรับเครดิตไว้ ระบบจะหักค่าใช้จ่ายจากเครดิตนี้ แต่ถ้าล็อกอินด้วยบัญชีผู้ใช้ของแพ็กเกจ ระบบจะไปตัดโควตาของแพ็กเกจแทน
ข้อดีคือ เมื่อใช้เครดิตจนหมดแล้วจะไม่มีค่าใช้จ่ายแอบแฝงงอกออกมา ถ้าองค์กรไม่ได้ซื้อเครดิตเพิ่มหรือเปิดระบบเติมเงินอัตโนมัติไว้ การเรียกใช้ API จะหยุดลงชั่วคราวและรอจนกว่าเครดิตรอบบิลถัดไปจะเข้า โดยไม่มีการหักเงินเพิ่มจากแพ็กเกจสมาชิกของคุณ
เริ่มจากงานซ้ำที่เสียเงินอยู่ทุกวัน
ปัจจุบัน Haiku 5.5 เปิดให้เรียกใช้งานผ่าน API ได้แล้ว ทั้งบน Claude Platform, AWS, Google Cloud และ Microsoft Azure โดยบน Claude Platform จะใช้ชื่อโมเดลว่า claude-haiku-5-5
ถ้าคุณเป็นสมาชิกแพ็กเกจ Max หรือ Team แนะนำให้เข้าไปกดรับเครดิตก่อนที่รอบบิลนี้จะจบลง จากนั้นลองเปิดหน้า Playground ใน Claude Console เลือกโมเดล claude-haiku-5-5 แล้วนำข้อความจริงจากงานประจำของคุณมาทดสอบดู โดยเริ่มตั้งค่าระดับการคิดไว้ที่ระดับต่ำก่อน
สำหรับใครที่จ่ายค่าบริการ API อยู่แล้ว ลองกลับไปสำรวจดูว่า งานสรุปเนื้อหา คัดแยกข้อมูล หรือตอบแชตตัวไหนที่ยังรันอยู่บน Sonnet แล้วสามารถย้ายมาใช้ Haiku 5.5 ได้บ้าง และคอยคุมความยาวคำขอไม่ให้เกิน 100,000 Token
เพราะจากนี้ไป วิธีคิดในการเลือกโมเดลสำหรับงานที่ต้องทำซ้ำๆ จะเปลี่ยนไปอย่างสิ้นเชิง จากเดิมที่เคยตั้งคำถามว่า "Haiku จะทำงานนี้ไหวไหม?" อาจต้องเปลี่ยนมาถามใหม่ว่า "มีเหตุผลอะไรที่งานนี้ยังต้องยอมจ่ายในราคา Sonnet อยู่อีก"
ที่มา:
- เอกสารทางการของ Claude Haiku 5.5
- บทความ Claude Haiku 5.5 จาก Simon Willison
- บทความ Monthly API credits for Max and Team plans จาก Claude Help Center
- บทความ Introducing Claude Haiku 5.5 on AWS จาก Amazon Web Services
ชอบเรื่องแนวนี้ มีอีบุ๊คฟรีให้อ่านต่อ
Local LLM ฉบับเข้าใจง่าย รัน AI ไว้ในเครื่องตัวเอง ติดตั้ง อัปเดต จัดการ ลบ ครบวงจรด้วย Ollama
กดสมัครแล้วเราจะส่งเทคนิค AI และของแจกใหม่ๆ ให้ทางอีเมล เลิกรับได้ตลอด
Claude Cowork · The Business Playbook
ฉบับภาษาไทย 15 บท เรียนรู้ผ่านโปรเจกต์จำลองต่อเนื่องทั้งเล่ม ตั้งแต่ตั้งค่า Workspace จัดการไฟล์ เชื่อมแอป ตั้งระบบอัตโนมัติ จนถึงสร้าง Plugin